
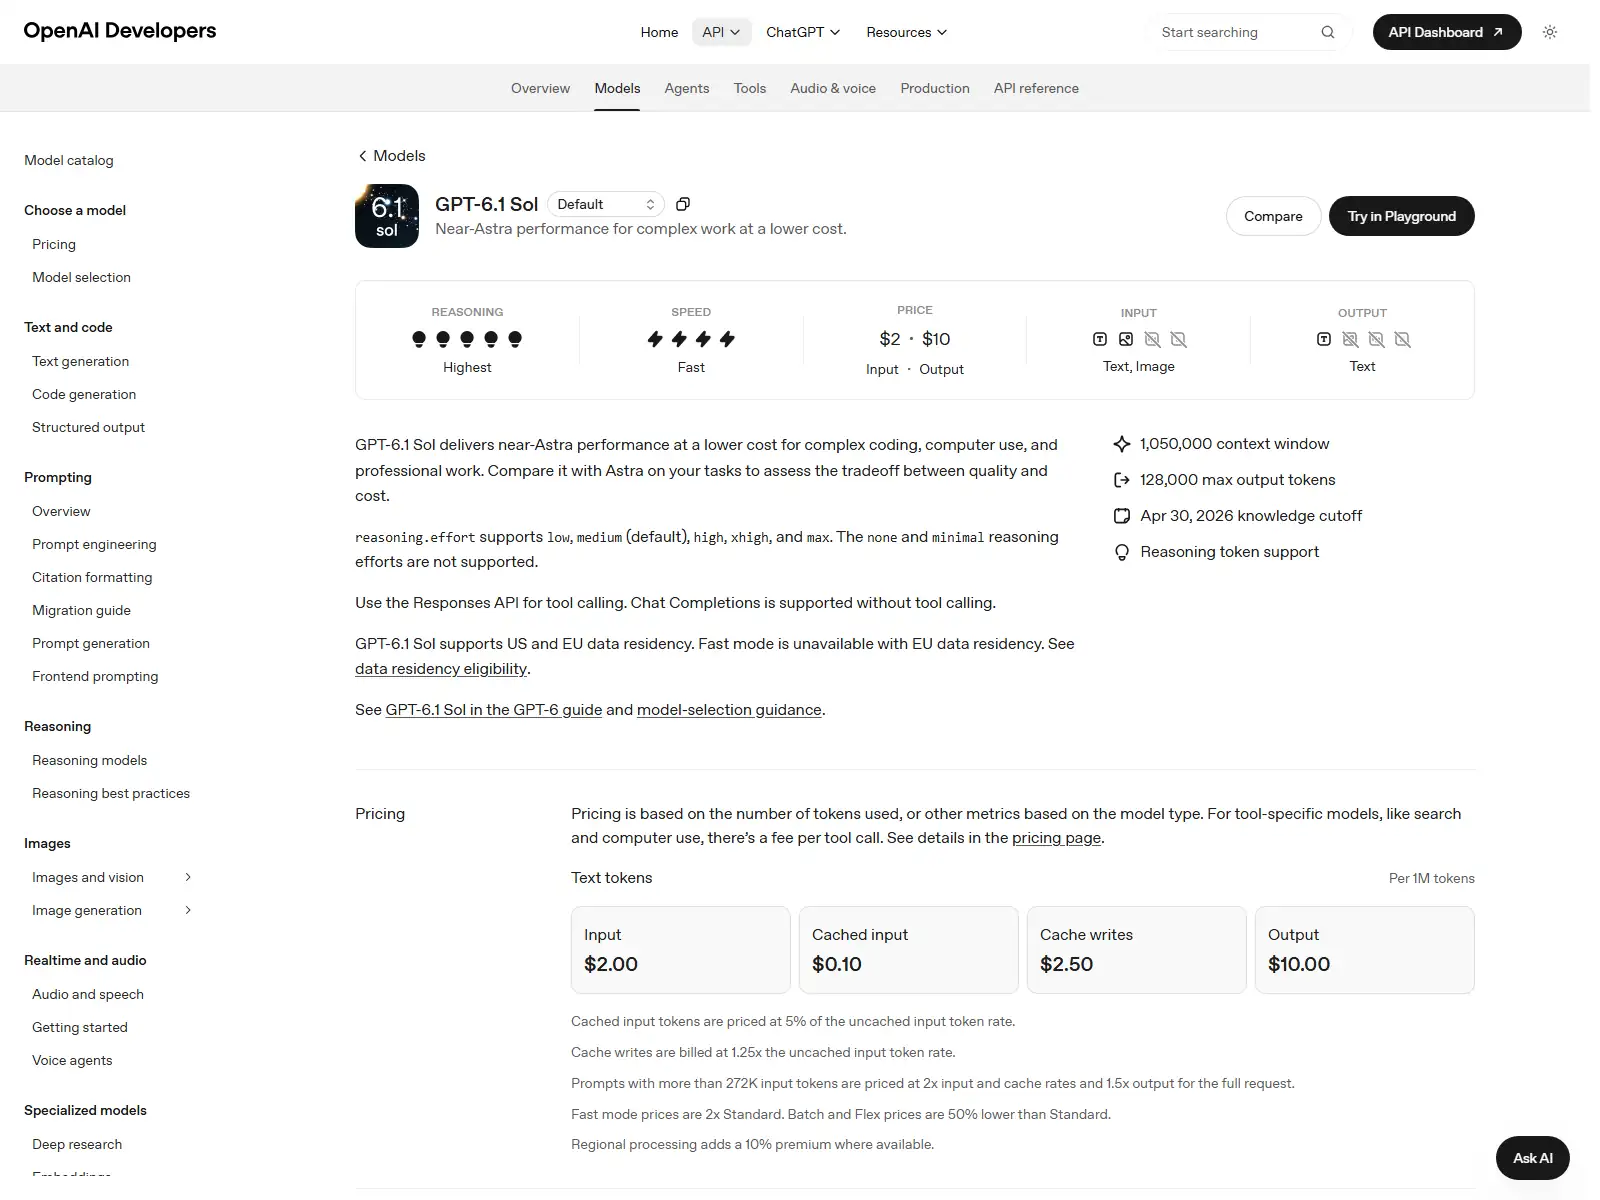
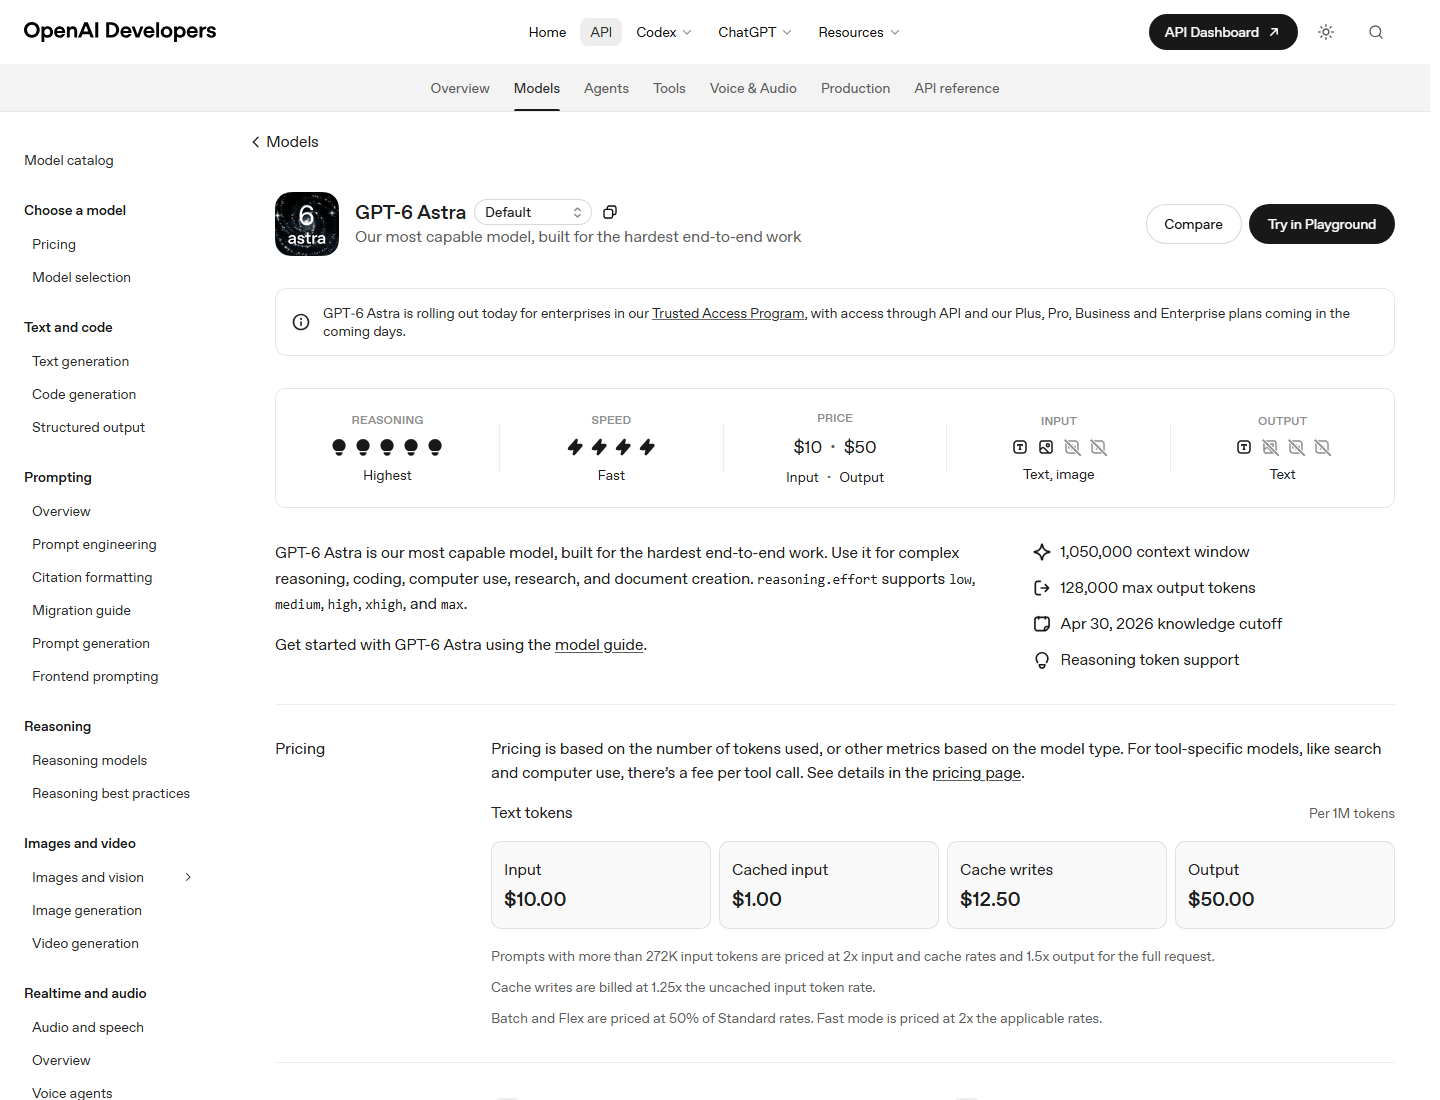
GPT-6.1 Sol rappresenta il valore predefinito; GPT-6 Astra rappresenta il limite massimo di qualità. Entrambe presentano la stessa finestra di contesto da 1.050.000 token, lo stesso limite di output di 128.000 token, input multimodali e un ampio set di strumenti. La differenza decisiva sta nel posizionamento e nel prezzo: Sol costa $2 per milione di token in ingresso e $10 per milione di token in uscita, mentre Astra costa $10 e $50. In altre parole, Astra deve creare un valore aggiunto sufficiente a giustificare un costo in token Standard cinque volte superiore.
Ciò non significa che Sol sia “lo stesso modello a un prezzo inferiore”. OpenAI definisce Astra il proprio modello più performante per i carichi di lavoro end-to-end più impegnativi e descrive Sol come un modello con prestazioni simili a quelle di Astra per attività complesse, ma a un costo inferiore. La scelta giusta è quindi una questione di valutazione, non un esercizio di classificazione dei marchi. Questo confronto si basa sui dati attuali Documentazione di GPT-6.1 Sol, il Pagina del modello GPT-6 Astra, e scenari di costo identici verificati il 9 ottobre 2026.
GPT-6.1 Sol vs GPT-6 Astra: confronto rapido
La tabella semplifica la prima decisione: se non si dispone ancora di dati specifici relativi al compito, Sol merita di essere provato per primo perché mantiene le principali caratteristiche relative all’interfaccia e alla capacità, riducendo al contempo in modo significativo il costo dei token. Astra diventa la scelta razionale quando il lavoro è particolarmente difficile, le conseguenze di una risposta errata sono gravi oppure il suo risultato più affidabile evita diversi cicli di revisione da parte di esseri umani o del modello stesso.
Questo è diverso dal confrontare Sol con un modello piccolo e veloce. Le attuali indicazioni di gamma di OpenAI collocano Sol nella fascia alta, non nella fascia economica. I lettori che devono scegliere tra l’intera gamma possono anche utilizzare il nostro Guida ai migliori modelli di intelligenza artificiale e il Recensione di GPT-6 Luna per capire quando è sufficiente un modello più leggero.
Cosa hanno in comune GPT-6.1 Sol e GPT-6 Astra
Le due pagine ufficiali dei modelli riportano le stesse impostazioni relative alla finestra di contesto, all’input massimo, all’output massimo e alla soglia di conoscenza. Entrambi accettano testo e immagini e generano testo. Nessuna delle due indica audio o video come input o output nativi del modello. Condividono inoltre livelli di sforzo di ragionamento bassi, medi, alti, xalti e massimi, con il livello medio come impostazione predefinita. Tale simmetria semplifica i test A/B, poiché un’applicazione può mantenere costanti la maggior parte dei parametri di richiesta, modificando solo l’ID del modello.
Entrambi i modelli supportano output strutturati, chiamata di funzioni, ricerca sul web, ricerca di file, generazione di immagini, interprete di codice, shell ospitata, applicazione di patch, utilizzo del computer, MCP, competenze e ricerca di strumenti. OpenAI elenca la chiamata di strumenti tramite l’API Responses; Chat Completions è disponibile quando non sono coinvolti strumenti. La messa a punto non è supportata in nessuna delle due pagine dei modelli. Si tratta di dichiarazioni di capacità, non di promesse che i due modelli sceglieranno strumenti con la stessa precisione.
Una finestra di contesto da un milione di token rappresenta una capacità, non un’autorizzazione a ignorare la progettazione del recupero. Le richieste molto lunghe sono più costose, più difficili da debuggare e soggette all’aumento di prezzo oltre i 272K token in ingresso. Il chunking, il recupero, i riassunti e la memorizzazione nella cache dei prompt rimangono importanti. Lo stesso avvertimento vale per il limite massimo di 128K token in uscita: artefatti verificabili più piccoli sono solitamente più sicuri di un’unica risposta di grandi dimensioni.
Prezzi: il divario quintuplo
Alle tariffe standard, GPT-6.1 Sol costa $2 per milione di token di input non memorizzati nella cache, $0,10 per gli input memorizzati nella cache, $2,50 per le scritture nella cache e $10 per gli output. GPT-6 Astra costa rispettivamente $10, $1, $12,50 e $50. Sol è cinque volte più economico per gli input non memorizzati nella cache, le scritture nella cache e gli output; gli input memorizzati nella cache sono dieci volte più economici. I dati attuali provengono direttamente dalle pagine del modello di OpenAI e Documentazione sui prezzi delle API.
Il rapporto indicato non rappresenta l’intero costo. Quando una richiesta supera i 272K token di input, OpenAI applica all’intera richiesta il doppio delle tariffe normali di input e cache e 1,5 volte la tariffa normale di output. I livelli Batch e Flex hanno un prezzo pari a 50% dello Standard, mentre Fast costa il doppio della tariffa applicabile. Astra offre anche un livello Ultrafast. Confronta elementi simili tra loro: una richiesta Sol Batch e una richiesta Astra Fast non rivelano il rapporto modello-prezzo sottostante.
Per un'analisi più dettagliata della fascia di punta, consulta il nostro Guida ai prezzi di GPT-6 Astra. Il precedente Analisi dei prezzi di GPT-6 Sol È utile quando si pianifica una migrazione dalla generazione precedente di Sol, ma le stime di produzione dovrebbero utilizzare l'ID esatto del modello attuale e le tariffe attuali.
Progettazione a lungo termine: stessa capacità, dinamiche economiche diverse
La finestra di contesto identica da 1.050.000 token può far sembrare Sol e Astra intercambiabili per lavori che prevedono un uso intensivo di documenti, ma la capacità è solo il primo vincolo. Una richiesta vicina al limite deve comunque individuare le prove giuste, distinguere le istruzioni dal materiale citato, preservare le relazioni tra molti file e restituire un risultato che una persona o un programma possa verificare. Il modello con il nome più altisonante non elimina la necessità di un’architettura dell’informazione. Organizzate le fonti, contrassegnate i confini e richiedete citazioni che rimandino a identificatori di documenti stabili.
La tariffa ridotta di Sol rende economicamente convenienti gli esperimenti su contesti estesi. Un team può testare diverse strategie di suddivisione in blocchi, soglie di recupero e formati di sintesi al costo di una singola esecuzione di Astra. Questa ricerca più ampia può migliorare il sistema anche se Astra si dimostra vincente in un singolo prompt. Astra risulta più interessante una volta che il flusso di lavoro si è stabilizzato e gli errori irrisolti sono effettivamente limitati dal modello stesso. Nelle prime fasi di sviluppo, destinare l’intero budget a poche chiamate di punta potrebbe produrre un apprendimento inferiore rispetto all’esecuzione di una valutazione Sol rigorosa su molti casi rappresentativi.
La soglia dei 272K merita un monitoraggio specifico. Una richiesta con 271K token in ingresso e una con 273K hanno dimensioni simili, ma la seconda fa rientrare l’intera richiesta nella fascia di costo più alta. Effettuare una stima preliminare dei token e registrare quale fascia è stata utilizzata da ciascun processo. Se un input supera di poco il limite, la rimozione di codice boilerplate duplicato, della cronologia delle conversazioni obsoleta o dei passaggi recuperati di scarso valore può ridurre sensibilmente i costi senza compromettere la qualità. Questa ottimizzazione si applica a entrambi i modelli, sebbene i tassi di base più elevati di Astra rendano gli errori più costosi.
La memorizzazione nella cache dei prompt è particolarmente utile quando un prefisso di grandi dimensioni rimane stabile da una chiamata all’altra. Ne sono un esempio i manuali delle politiche aziendali, gli standard di codifica, un catalogo prodotti o uno schema di strumenti condiviso da molte attività. Inserite per primi i contenuti stabili e poi le istruzioni variabili, quando il comportamento di cache dell’API supporta tale struttura. Successivamente, misurate gli accessi alla cache anziché darli per scontati. Il vantaggio dell’input memorizzato nella cache di Sol è particolarmente significativo, ma un prefisso in costante cambiamento può annullarlo. La progettazione della cache deve essere inclusa nel rapporto di benchmark insieme all’accuratezza e alla latenza.
Per la ricerca e l’analisi dei documenti, utilizzare un flusso di lavoro articolato in fasi: recuperare le prove più probabili, richiedere al modello una mappa strutturata delle prove, convalidare i riferimenti bibliografici e solo allora richiedere la sintesi. Utilizzate Astra quando la sintesi risulta ancora debole nonostante la pipeline delle prove sia solida, oppure quando l’insieme delle fonti contiene contraddizioni insolitamente sottili. Ciò consente di distinguere gli errori di recupero da quelli di ragionamento. Senza tale distinzione, i team spesso finiscono per investire in un modello più potente per compensare un problema evitabile di costruzione del contesto.
Programmazione e uso degli strumenti
Per quanto riguarda la programmazione, la domanda rilevante non è “quale modello è in grado di scrivere codice?”. Entrambi ne sono capaci. La domanda è: in quali casi la capacità aggiuntiva di Astra modifica il risultato? Sol è interessante per le attività comuni relative al repository: implementazione di funzionalità con ambito limitato, diagnosi di bug riproducibili, revisione delle pull request, scrittura di test, trasformazione dei dati ed esecuzione di cicli iterativi di strumenti. Il suo costo inferiore consente un maggior numero di tentativi, più verifiche e set di valutazione più ampi a parità di budget.
È preferibile riservare Astra alle attività in cui prevalgono l’ambiguità e la necessità di coordinamento: una migrazione verso un monorepo sconosciuto, una revisione di un’architettura sensibile dal punto di vista della sicurezza, l’utilizzo di un computer a lungo termine, un porting tra linguaggi diversi particolarmente complesso o un incidente in produzione con prove incomplete. Il modello più avanzato può valere il suo costo aggiuntivo quando un unico piano corretto evita ore di lavoro di rifacimento. Il nostro Il miglior modello di IA per il confronto dei codici spiega perché i test sul repository sono più importanti delle impressioni generiche sulla qualità del codice.
- Funzionalità definite con test di accettazione chiari
- Debug di routine e revisione del codice
- Cicli di agenti ad alto volume
- Bozze di migrazioni e rifattorizzazioni
- Generazione dei test e documentazione
- Errori gravi dopo un tentativo di Sol
- Modifiche alla sicurezza o ai dati ad alto rischio
- Architettura intersistemica ambigua
- Attività prolungate che richiedono l'uso autonomo del computer
- Revisione finale quando gli errori costano caro
Non giudicare nessuno dei due modelli basandoti su un codice che sembra semplicemente plausibile. Fornite a entrambi lo stesso snapshot del repository, le stesse istruzioni, gli stessi strumenti, lo stesso tempo a disposizione e gli stessi test. Registrate la percentuale di successo, le correzioni manuali, gli errori degli strumenti, i token, la latenza e il costo. Un modello che costa cinque volte di più ma dimezza il numero di tentativi falliti può essere giustificato; un modello che migliora lo stile senza migliorare l'accettazione non lo è.
Dati sulle prestazioni: cosa possiamo e cosa non possiamo dedurne
Il posizionamento di OpenAI fornisce la sintesi più solida e difendibile: Astra è il modello più performante per i compiti end-to-end più impegnativi, mentre GPT-6.1 Sol punta a prestazioni vicine a quelle di Astra su compiti complessi a un costo inferiore. Queste affermazioni sostengono un’ipotesi di selezione, non un divario percentuale universale. Nessun singolo benchmark pubblico è in grado di prevedere le prestazioni sui vostri documenti, strumenti, politiche o codice sorgente proprietari.
I video di lancio sono utili per capire come un’azienda presenta un prodotto, ma non costituiscono valutazioni indipendenti. Allo stesso modo, le recensioni dei creator mostrano interfacce reali ed esempi utili, ma ogni recensione riflette una serie specifica di istruzioni, una configurazione degli strumenti e una scadenza di pubblicazione. Considerate una miniatura accattivante o un giudizio a prima vista come uno spunto per il vostro piano di test, non come una prova che Astra o Sol siano i migliori in ogni categoria.
Il video ufficiale OpenAI qui sopra documenta il contesto del lancio di Astra. La pagina indipendente dedicata a Matt Wolfe qui sotto mostra come l’attenzione del pubblico esterno si sia rapidamente concentrata sulla portata dell’uscita. Nessuno dei due screenshot viene utilizzato in questa sede come parametro di riferimento numerico. L’articolo evita intenzionalmente di tradurre l’entusiasmo, le visualizzazioni o il titolo di un creatore in un punteggio di rendimento privo di fondamento.
Un confronto valido si avvale di un set di valutazione privato che rispecchi l’ambiente di produzione. Includere compiti semplici, compiti tipici e casi di errore costosi. Nascondere i risultati quando conta la preferenza umana. Per gli agenti, verificare il completamento e il recupero piuttosto che la prima risposta. OpenAI’s linee guida per la selezione dei modelli raccomanda inoltre di confrontare i modelli su compiti identici e di scegliere il modello più leggero e lo sforzo di ragionamento che consenta di superare la soglia di qualità richiesta.
Come condurre una valutazione imparziale tra Sol e Astra
Inizia definendo la decisione che la valutazione dovrà prendere. “Quale modello è più intelligente?” è una domanda troppo vaga. Una domanda utile è: “Quale modello dovrebbe gestire le revisioni delle pull request per questo repository a un livello di ragionamento medio?” oppure “La sintesi del contratto finale dovrebbe passare da Sol ad Astra?” Stabilisci la famiglia di attività, il livello di servizio, lo sforzo di ragionamento, gli strumenti, il limite di tempo e i criteri di accettazione prima di generare i risultati. Altrimenti, un risultato favorevole potrebbe essere attribuito alla configurazione piuttosto che al modello.
Crea un insieme sufficientemente ampio da includere casi ordinari e casi limite significativi. Venti esempi selezionati con cura possono rivelare errori evidenti, ma una politica di instradamento in produzione di solito richiede di più. Prelevate campioni da lavori reali recenti dopo aver rimosso i dati sensibili, quindi classificate ogni caso in base alla difficoltà e al rischio. Mantenete un insieme di test separato e protetto, in modo che la messa a punto del prompt non porti gradualmente a un sovradattamento agli esempi che tutti hanno già visto. Gestite le versioni del set di dati e del valutatore proprio come fate con il codice dell’applicazione.
Preferire i controlli deterministici ogni volta che l’attività lo consenta. Compilare il codice, eseguire i test, convalidare i file JSON rispetto a uno schema, confrontare i campi estratti con le etichette e verificare i passaggi citati. I valutatori umani dovrebbero concentrarsi su aspetti che l’automazione non riesce a cogliere appieno, quali la chiarezza, la capacità di giudizio e la coerenza di una raccomandazione con il contesto aziendale. Nascondere l’identità del modello e randomizzare l’ordine dei risultati. Se i valutatori sapessero quale risposta proviene da Astra, il prezzo e la reputazione potrebbero influenzare il punteggio senza che nessuno intenda creare un pregiudizio.
Monitorate la gravità, non solo le medie. Dieci vantaggi stilistici minori non dovrebbero prevalere su una raccomandazione critica relativa alla perdita di dati. Definire i casi di veto assoluto, quali citazioni inventate, comandi non sicuri, campi obbligatori mancanti o mancato rispetto di un vincolo legale. Riportare la distribuzione per categoria di difficoltà e di rischio. Sol potrebbe eguagliare Astra nel lavoro normale e rimanere indietro solo nel 5% dei casi più difficili; tale risultato sostiene fortemente l’adozione di un router anziché una migrazione «tutto o niente».
Infine, calcolare l’incertezza e rieseguire i casi instabili. I risultati del modello possono variare, quindi un confronto effettuato una sola volta esalta l’effetto fortuna. Ripetere un sottoinsieme, esaminare le discrepanze tra i valutatori e conservare i risultati grezzi a fini di verifica. La raccomandazione finale dovrebbe indicare la data del test, gli ID dei modelli, le impostazioni, la versione del set di dati, i prezzi utilizzati e le lacune note. Rivedere il tutto dopo un aggiornamento del modello, una modifica del prompt o un cambiamento significativo nel carico di lavoro. La scelta di un modello è una decisione operativa soggetta a revisione, non un trofeo definitivo.
Non lasciare che il valutatore diventi il modello decisionale nascosto. Se un giudice automatizzato preferisce nettamente un risultato, seleziona alcune di quelle decisioni per una revisione da parte di esperti e confronta il giudice con i risultati di accettazione definitivi. Separa la qualità della presentazione dalla correttezza del compito: una spiegazione ben curata può nascondere un requisito non soddisfatto, mentre una risposta concisa potrebbe superare ogni test. Segnalate anche le astensioni e i pareggi invece di imporre a tutti i costi un vincitore. Questi dettagli rendono il risultato meno spettacolare, ma di gran lunga più utile per la definizione del budget e l’instradamento. L’obiettivo è una regola operativa ripetibile che un altro membro del team possa esaminare e riprodurre. Registrate anche i risultati respinti; gli esempi di fallimento spesso spiegano i limiti dell’instradamento in modo più chiaro rispetto a una tabella di punteggi medi.
Esempi di costi reali
Si consideri un'esecuzione dell'agente di codifica con 200.000 token di input non memorizzati nella cache e 20.000 token di output. Sol costa circa $0,60: $0,40 per l'input e $0,20 per l'output. Astra costa circa $3,00: $2,00 più $1,00. Su 10.000 esecuzioni, la differenza è di circa $24.000 al lordo delle commissioni degli strumenti, della memorizzazione nella cache, degli aumenti regionali o degli adeguamenti del livello di servizio.
Consideriamo ora una richiesta a contesto lungo con 300.000 token in ingresso e 30.000 token in uscita. Poiché l’input supera i 272K, all’intera richiesta si applicano le tariffe più elevate. La tariffa effettiva di Sol per l’input diventa $4 per milione e quella per l’output diventa $15, producendo circa $1,65. Per Astra, la tariffa di input diventa $20 e quella di output $75, per un totale di circa $8,25. Il rapporto di cinque a uno rimane invariato, ma il divario in termini assoluti aumenta.
La memorizzazione nella cache può spostare ulteriormente il calcolo verso Sol, poiché la sua velocità di input nella cache è un decimo di quella di Astra. Ciò è rilevante per le istruzioni di sistema stabili, i riferimenti ripetuti di grandi dimensioni e la struttura degli agenti. Tuttavia, le scritture nella cache hanno comunque un costo, e la modifica del prefisso può ridurne il riutilizzo. Effettuare una stima sulla base dei log di utilizzo effettivi, anziché presumere che ogni token riceva la velocità di cache.
Come confrontare i modelli nell'API
Utilizza l'API Responses per le applicazioni che utilizzano strumenti e mantieni identica la configurazione di confronto. Il framework più semplice e funzionale invia lo stesso input a entrambi gli ID dei modelli, registra i metadati delle risposte ed esegue lo stesso valutatore. Non esporre le chiavi API nel codice sorgente; utilizza una variabile d'ambiente e il tuo normale gestore di segreti.
Il campione è volutamente ridotto. Un sistema di produzione dovrebbe salvare gli ID delle richieste, le versioni dei valutatori, i commit del repository, le tracce degli strumenti, il numero di tentativi e i risultati delle verifiche di accettazione. Dovrebbe inoltre calcolare il prezzo in base al livello di servizio e alla fascia di contesto esteso effettivamente utilizzati. Evitate che un modello veda un feedback che l’altro non ha ricevuto, a meno che non stiate testando esplicitamente una sequenza di instradamento.
Una strategia pratica per il routing da Sol ad Astra
Un router a due stadi coglie l’argomento economico più forte a favore di Sol senza fingere che ogni prompt sia uguale all’altro. Invia il traffico normale a Sol con un livello di ragionamento medio. Passa a un livello superiore quando i test deterministici falliscono, il modello segnala un basso livello di affidabilità, l’attività rientra in una categoria ad alto rischio o un operatore umano richiede esplicitamente una revisione da parte di un esperto. Mantieni le regole di escalation trasparenti in modo che i costi non aumentino in modo impercettibile.
Utilizza lo stesso prompt, gli stessi strumenti e gli stessi test di accettazione.
Test, affidabilità, classe di rischio e revisione umana.
Invia ad Astra i lavori che presentano problemi o che comportano un rischio elevato.
Monitorare l'accettazione, le rielaborazioni, la latenza e il costo totale.
Il routing offre inoltre ai team un modo controllato per aggiornare le impostazioni predefinite. Se il tasso di accettazione di Sol migliora in una famiglia di attività, aumentatene la quota. Se Astra previene ripetutamente difetti costosi, indirizzate direttamente quella categoria. Il confronto diventa una politica operativa supportata dai dati, anziché un dibattito una tantum sul modello. Per un riferimento di una generazione precedente, consultate GPT-6 Astra contro GPT-5.6 Sol.
La latenza e l’affidabilità devono essere considerate nella stessa politica di instradamento. Un modello può fornire una risposta più solida, ma rimanere comunque un’impostazione predefinita errata se il suo tempo di risposta interrompe un flusso di lavoro interattivo o se il suo ragionamento più lungo causa il timeout dei processi. Misurate la latenza del primo token, la durata totale, il tempo di recupero dopo un’interruzione dello strumento e il completamento con esito positivo in condizioni di concorrenza realistiche. Successivamente, definire un obiettivo di servizio per ciascuna classe di attività. Sol può gestire il traffico di produzione sensibile al tempo mentre Astra si occupa della revisione asincrona, oppure si può giustificare il contrario se un’attività complessa fallisce sistematicamente prima dell’escalation. La decisione del modello è operativa, non meramente discrezionale.
Chi dovrebbe scegliere Sol e chi dovrebbe scegliere Astra?
Scegli GPT-6.1 Sol per una produzione attenta ai costi
Sol è adatto a team di prodotto, agenzie, ricercatori e sviluppatori che gestiscono volumi considerevoli di lavoro complesso, ma dispongono comunque di criteri di accettazione misurabili. Risulta particolarmente interessante quando l’iterazione fa parte del processo: cicli di “codifica-test-correzione”, revisione di documenti, estrazione con convalida, sintesi di ricerche e agenti interni a più fasi. Il suo prezzo più contenuto consente una maggiore copertura di valutazione e un budget più ampio per i tentativi.
Scegli GPT-6 Astra per i lavori più impegnativi in cui la qualità è fondamentale
Astra è adatta ai team i cui compiti più complessi comportano costi elevati in caso di errore o dispongono di controlli automatizzati poco efficaci. Una decisione architettonica complessa, una revisione finale della sicurezza, un compito di ragionamento scientifico innovativo o una lunga sequenza di elaborazione possono giustificare l’acquisto della versione di punta. Rappresenta inoltre l’opzione predefinita più indicata nelle prime fasi di ricerca, quando il team non sa ancora cosa possa sfuggire a un modello più piccolo e il costo non costituisce un vincolo immediato.
Utilizzarle entrambe quando il livello di difficoltà delle attività varia
La maggior parte dei sistemi maturi non dovrebbe imporre un unico modello a ogni richiesta. Utilizzate Sol per la fascia centrale più ampia e Astra come livello di escalation. Aggiungete Luna o un altro modello più piccolo per la classificazione e la trasformazione prevedibili. Questo approccio a più livelli riflette l’effettiva diversità del carico di lavoro ed è solitamente più economico rispetto alla ricerca di un unico modello definitivo. Il nostro metodologia di collaudo dei modelli offre un utile quadro di riferimento per distinguere le prove verificabili dalle semplici impressioni.
Come utilizzare GPT-6.1 Sol e GPT-6 Astra su GlobalGPT
GlobalGPT offre percorsi di prodotto in tempo reale per entrambi i modelli all’interno di un unico spazio di lavoro multimodello. Apri l’area di lavoro, avvia una nuova conversazione e verifica nel selettore di modelli attuale la disponibilità di GPT-6.1 Sol o GPT-6 Astra. Mantenere entrambi i modelli in un’unica interfaccia è utile per un lavoro esplorativo comparativo, mentre la valutazione tramite API rimane la soluzione migliore per il punteggio automatizzato, la rilevazione esatta dell’utilizzo e i controlli di distribuzione.
Inizia con Sol per il primo passaggio, poi riesegui il prompt più difficile con Astra e confronta cosa è cambiato in modo sostanziale.
Apri GlobalGPTPer approfondire gli aspetti specifici del modello, consulta il nostro Guida illustrata a GPT-6.1 Sol e Recensione della GPT-6 Astra. Quelle pagine trattano ogni modello singolarmente; questa pagina si concentra invece sulla scelta tra i vari modelli in termini di acquisto e instradamento.
Domande frequenti
GPT-6.1 Sol è migliore di GPT-6 Astra?
Non in termini assoluti. OpenAI posiziona GPT-6 Astra come il suo modello più potente e GPT-6.1 Sol come un modello più economico con prestazioni simili a quelle di Astra per attività complesse. Sol rappresenta il miglior rapporto qualità-prezzo quando soddisfa i tuoi standard di qualità; Astra è la scelta più sicura, che privilegia la qualità, per i compiti più impegnativi.
Quanto costa meno GPT-6.1 Sol rispetto a GPT-6 Astra?
Alle tariffe standard, Sol costa $2 per milione di token in ingresso e $10 per milione di token in uscita, contro i $10 e $50 di Astra. Sol risulta quindi cinque volte più economico per input e output non memorizzati nella cache. Il suo prezzo di $0,10 per gli input memorizzati nella cache è pari a un decimo della tariffa di Astra, che è di $1.
GPT-6.1 Sol e GPT-6 Astra hanno la stessa finestra di contesto?
Sì. Il documento OpenAI indica una finestra di contesto di 1.050.000 token, un input massimo di 922.000 e un output massimo di 128.000 per entrambi i modelli. Le richieste con più di 272.000 token in input vengono trasferite integralmente a tariffe per contesti lunghi.
Qual è il modello migliore per la programmazione?
Astra è la scelta ideale in termini di qualità per attività relative al repository particolarmente complesse, ambigue o ad alto rischio. Sol è la soluzione predefinita più pratica per le attività di routine relative alle funzionalità, il debug, le revisioni e i cicli degli agenti, poiché il suo costo inferiore consente un maggior numero di iterazioni. Eseguite entrambi sui test dello stesso repository prima di procedere alla standardizzazione.
Entrambi i modelli supportano gli strumenti e l'inserimento di immagini?
Sì. Nelle pagine ufficiali dedicate ai modelli sono elencati: immissione di testo e immagini, output di testo, output strutturati, chiamata di funzioni, ricerca sul web, ricerca di file, interprete di codice, shell ospitata, applicazione di patch, utilizzo del computer, MCP, competenze e ricerca di strumenti. Per la chiamata degli strumenti è necessario utilizzare l'API Responses.
Quando devo pagare per GPT-6 Astra?
Ricorri ad Astra quando un errore comporta costi elevati, l’attività è davvero all’avanguardia oppure una valutazione comparativa dimostra che la sua qualità superiore riduce le rielaborazioni in misura tale da giustificare un prezzo cinque volte superiore a quello del token. Tra gli esempi figurano migrazioni critiche, utilizzi complessi di sistemi informatici autonomi e la revisione finale di risultati finali di grande importanza.
Quale tipo di ragionamento dovrei scegliere?
Inizia con un livello medio, che è l’impostazione predefinita documentata per entrambi i modelli. Riduci il livello per trasformazioni semplici e aumentalo solo quando la difficoltà dell’attività o il costo degli errori lo richiedono. L’impostazione più efficiente è quella che richiede il minimo sforzo e che supera costantemente i tuoi test di accettazione.
Posso utilizzare GPT-6.1 Sol e GPT-6 Astra su GlobalGPT?
GlobalGPT offre percorsi attivi sia per GPT-6.1 Sol che per GPT-6 Astra nel proprio spazio di lavoro multimodello. La disponibilità può variare a seconda dell'account e dell'interfaccia, pertanto si consiglia di aprire lo spazio di lavoro e verificare il selettore di modelli attuale prima di avviare un flusso di lavoro di produzione.
Dovrei indirizzare ogni prompt verso un unico modello?
Di solito no. Un router semplice può inviare i lavori normali a Sol e inoltrare ad Astra i casi con basso livello di affidabilità, quelli in cui i test hanno dato esito negativo o quelli ad alto rischio. In questo modo si sfrutta gran parte del vantaggio in termini di costi offerto da Sol, riservando Astra alle richieste in cui la capacità marginale ha un valore misurabile.
Verdetto finale
GPT-6.1 Sol dovrebbe essere il primo modello da valutare per i team più attenti ai costi; GPT-6 Astra dovrebbe rimanere l'obiettivo a cui ricorrere per i compiti più impegnativi. Il contesto comune, i limiti di produzione, le modalità operative, i controlli di ragionamento e il catalogo degli strumenti rendono il confronto straordinariamente chiaro. Sol offre il vantaggio economico. Astra vanta il vantaggio ufficiale in termini di capacità.
Il parametro determinante non è solo il prezzo del token o il prestigio del modello. Misurate il costo per risultato accettato in base a vincoli operativi e budget reali. Se Sol supera i test con una percentuale simile, è difficile ignorare le sue velocità di input e output non memorizzate nella cache, cinque volte inferiori. Se Astra previene gli errori, riduce la necessità di revisione da parte di esperti o risolve compiti che Sol non è in grado di affrontare, il sovrapprezzo può essere giustificato. Iniziate con compiti identici, mantenete la valutazione in cieco ove possibile e promuovete solo il modello e lo sforzo di ragionamento che si guadagnano il proprio posto.









