DeepSeek V4.1 Flash è la versione di DeepSeek rilasciata il 10 settembre 2026, che introduce il supporto nativo per l’input di immagini, un ingombro della cache ridotto, punteggi degli agenti segnalati dai fornitori più elevati e tariffe API più basse. È particolarmente indicato per gli sviluppatori che gestiscono agenti con volumi elevati o con un carico di input consistente. L'avvertenza principale: DeepSeek ha eseguito i benchmark pubblicati, mentre V4 Pro continua a primeggiare in alcuni test di ragionamento all'avanguardia.

Che cos’è il firmware DeepSeek V4.1?
DeepSeek V4.1 Flash è un modello multimodale a pesi aperti progettato per la codifica, l'uso di strumenti, la comprensione visiva e i flussi di lavoro degli agenti in contesti estesi. DeepSeek lo ha rilasciato il 10 settembre 2026 e pubblica i pesi come DeepSeek-V4.1-Flash, e rende accessibile il modello ospitato tramite il deepseek-flash Nome dell'API.
Questa versione è importante perché non si limita a modificare i punteggi dei benchmark. Flash è in grado di accettare testo e immagini, offre una finestra di contesto da un milione di token e riduce notevolmente la memoria richiesta per la sua cache chiave-valore. DeepSeek ha inoltre ridotto le tariffe delle API ospitate rispetto al piano V4 Pro in scadenza. Questa combinazione mira a risolvere un vero e proprio collo di bottiglia: mantenere accessibili gli agenti a esecuzione prolungata quando si accumulano prompt, contesto del repository, screenshot e cronologia degli strumenti.
deepseek-flashLa modalità "pensante" è abilitata per impostazione predefinita, sebbene sia disponibile anche la modalità "non pensante". Sono supportati l'output JSON e le chiamate agli strumenti. DeepSeek offre inoltre compatibilità con le API Responses e Anthropic, il che riduce il carico di lavoro di migrazione per le applicazioni già strutturate attorno a tali interfacce.
Cosa c'è di nuovo nella versione DeepSeek V4.1 Flash?
Una dorsale MoE 552B con capacità di calcolo asimmetrica
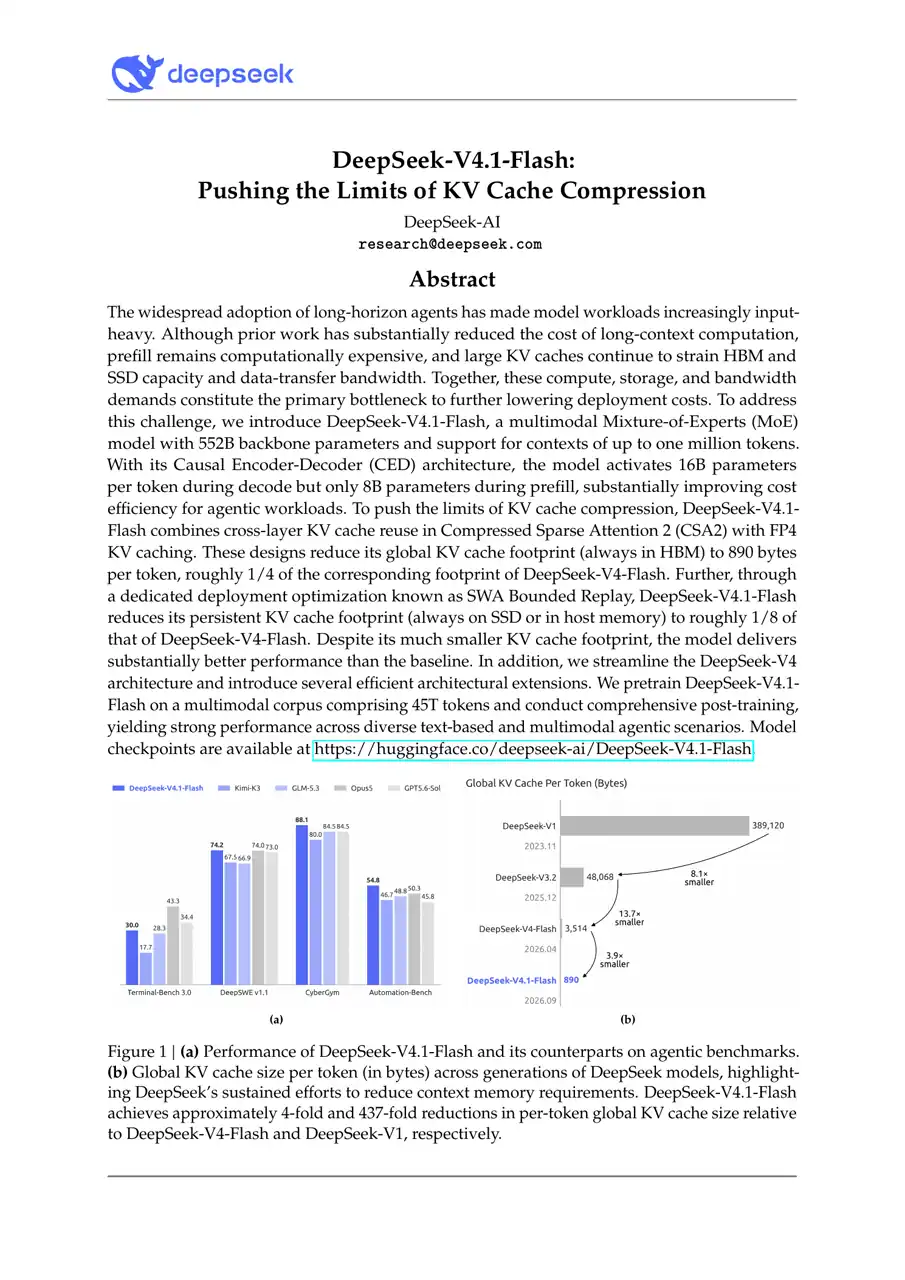
Secondo il Relazione tecnica DeepSeek V4.1, il modello utilizza una struttura di base di tipo “mixture-of-experts” con 552 miliardi di parametri, composta da un encoder causale a 20 livelli e un decoder a 20 livelli. Il numero totale di parametri non corrisponde a quello effettivamente utilizzato per ogni token: DeepSeek riporta circa 8 miliardi di parametri attivi durante la fase di prefill e 16 miliardi durante la decodifica.
Questo design asimmetrico assegna budget di calcolo diversi alle fasi di prefill e generazione. Il prefill è la fase in cui vengono acquisiti il prompt, i documenti, le immagini e la conversazione precedente; la decodifica produce la risposta token per token. Il minor consumo di risorse di calcolo durante il prefill è particolarmente rilevante per i carichi di lavoro su scala di repository e per gli agenti di ricerca, che dedicano gran parte delle risorse alla lettura prima di procedere alla scrittura.
Una cache KV molto più piccola
Il rapporto indica una dimensione globale della cache KV pari a 890 byte per token, pari a circa un quarto della cache di V4 Flash nella memoria ad alta larghezza di banda. Secondo DeepSeek, il fabbisogno di cache persistente è pari a circa un ottavo rispetto alla generazione precedente. In un contesto con un milione di token, si tratta di una caratteristica di implementazione piuttosto che di un dettaglio astratto dell’architettura: la dimensione della cache influisce sul numero di sessioni di lunga durata che un server può gestire e sulla quantità di memoria consumata da ciascuna di esse.
Input di immagini native e pre-addestramento multimodale
La versione 4.1 di Flash supporta le immagini in modo nativo, senza ricorrere a un endpoint separato del marchio Vision. Secondo DeepSeek, il modello è stato preaddestrato su un corpus multimodale di 45 trilioni di token. In pratica, ciò fa sì che screenshot, grafici, tabelle scansionate, stati dell’interfaccia e input di debug visivo facciano parte della stessa conversazione dell’agente insieme al codice e al testo.
Un contesto da 1 milione di token può contenere archivi di grandi dimensioni, insiemi di documenti di lunghezza elevata e cronologie estese degli agenti, nel rispetto del limite combinato di input e output.
I file JPEG, PNG, GIF e WebP possono essere combinati con il testo per l'estrazione di tabelle, l'analisi di screenshot e la risposta visiva alle domande.
Il richiamo tramite tool, l'output JSON strutturato e l'addestramento orientato agli agenti rendono il modello adatto a flussi di lavoro che richiedono di ispezionare, decidere e modificare lo stato.
Benchmark DeepSeek V4.1: cosa rivelano i risultati ufficiali
I punti di forza della versione 4.1 di Flash di DeepSeek si concentrano nei benchmark relativi alla codifica e agli agenti. Il fornitore ha valutato il modello di istruzioni con uno sforzo sperimentale pari a 100, presentato pubblicamente come lo sforzo massimo di ragionamento, utilizzando temperatura=1,0 e top_p=0,95. I test degli agenti di codice hanno utilizzato harness denominati e un contesto di un milione di token; i test degli agenti visivi hanno utilizzato il codice Claude con un contesto di 512K token.
| Punto di riferimento | V4.1 Flash | V4 Pro | V4 Flash | Leader |
|---|---|---|---|---|
| Codeforces valutazione | 3471 | 3348 | 3289 | V4.1 Flash |
| Terminal-Bench 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 risolto | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Banco di automazione Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| Diamante GPQA Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE solo testo Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Fonte: rapporto tecnico DeepSeek V4.1, Tabella 3. All’interno di ciascuna riga, un valore più alto indica un risultato migliore. Codeforces è un punteggio; gli altri valori visualizzati utilizzano le metriche in percentuale specificate nel rapporto. Non confrontare i valori tra le righe.

Questo andamento è utile, ma più limitato rispetto a un'affermazione generica secondo cui si tratterebbe di un “modello migliore”. V4.1 Flash supera V4 Pro nelle cinque righe relative a programmazione, terminali, sicurezza e automazione riportate sopra. V4 Pro rimane in vantaggio su GPQA Diamond e sul sottoinsieme solo testo di “Humanity’s Last Exam”. Gli sviluppatori che desiderano confrontare una rosa più ampia di modelli di codifica possono utilizzare il nostro Guida al miglior modello di IA per la programmazione, ma la valutazione a livello di applicazione rimane comunque più importante di una singola tabella.
Anche lo sforzo di ragionamento influisce sui costi e sui risultati. Nel rapporto di DeepSeek, aumentando lo sforzo sperimentale da 25 a 100, il punteggio di DeepSWE v1.1 è passato da 66,0 a 74,2 e quello di Terminal-Bench 2.1 da 82,4 a 90,6, consumando al contempo circa 2,5 volte più token di output. Le otto configurazioni degli agenti descritte nel rapporto hanno inoltre prodotto risultati sostanzialmente diversi a partire dallo stesso checkpoint; pertanto, la scelta del framework fa parte del sistema oggetto di valutazione.
DeepSeek afferma che la robustezza in presenza di input estremi non è stata caratterizzata in modo completo. Il rapporto sottolinea che gli errori di selezione CSA2 e la ricostruzione approssimativa dello stato tramite l’attenzione a finestra scorrevole potrebbero ridurre le capacità in casi limite al di fuori della suite di test. Riconosce inoltre che permangono delle lacune nei ragionamenti più complessi e nei compiti relativi ai casi limite. Tali precisazioni dovrebbero accompagnare i punteggi principali.
Due attività riproducibili per la valutazione di Flash versione 4.1
I compiti seguenti verificano comportamenti concreti senza presentare come prova un prompt non eseguito. Utilizza il prompt esatto, conserva le impostazioni relative al modello e allo sforzo nel tuo registro e valuta la risposta in base ai criteri elencati. I risultati di una singola esecuzione devono essere riportati come osservazione datata, non come benchmark generale.
Prezzi Flash DeepSeek V4.1
Il sistema tariffario dell'API DeepSeek prevede due fasce tariffarie; tutte le cifre riportate di seguito sono espresse in dollari statunitensi per milione di token. I periodi di picco sono Dalle 01:00 alle 04:00 UTC e dalle 06:00 alle 10:00 UTC, dal lunedì al venerdì. In tutti gli altri casi si tratta di ore non di punta. Gli input memorizzati nella cache, quelli non memorizzati nella cache e gli output vengono fatturati a tariffe diverse.
Tariffe più basse per le API in hosting
- Input memorizzato nella cache
- $0.003
- Dati di input non memorizzati nella cache
- $0.15
- Uscita
- $0.60
Per 1 milione di token; al di fuori delle fasce orarie di punta nei giorni feriali.
Il doppio della tariffa fuori picco
- Input memorizzato nella cache
- $0.006
- Dati di input non memorizzati nella cache
- $0.30
- Uscita
- $1.20
Per 1 milione di token; dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC, nei giorni feriali.
Per fare un semplice esempio aritmetico, una richiesta in orario non di punta con 800.000 token di input non memorizzati nella cache e 20.000 token di output costerebbe circa $0.132: $0,12 per l’input più $0,012 per l’output. Lo stesso numero di token, calcolato alle tariffe di picco, costerebbe circa $0.264. Questo calcolo è puramente illustrativo e non rappresenta una fattura effettiva relativa al carico di lavoro; gli accessi alla cache, i tentativi di ripetizione, i turni degli strumenti e la lunghezza del ragionamento modificano il totale.
L'input memorizzato nella cache è cinquanta volte più economico rispetto a quello non memorizzato in entrambe le tariffe, rendendo i prefissi di prompt stabili e il contesto riutilizzabile economicamente vantaggiosi. La tariffa pubblica dell'API DeepSeek è separata dall'accesso e dalla fatturazione relativi a GlobalGPT. Non interpretare i prezzi di questi token come prezzi relativi all'abbonamento o al credito di GlobalGPT.
API, visione e limiti di DeepSeek V4.1
L'API diretta DeepSeek utilizza deepseek-flash. Gli sviluppatori possono richiamare l'endpoint standard all'indirizzo https://api.deepseek.com, l'API Responses sulla stessa base, oppure la base compatibile con Anthropic all'indirizzo https://api.deepseek.com/anthropic. Gli strumenti di funzione sono supportati in Responses. DeepSeek documenta inoltre il applica_patch strumento personalizzato; gli altri tipi di strumenti integrati in "Responses" vengono ignorati anziché eseguiti.
deepseek-flashModalità "Thinking" attivata; sono disponibili le impostazioni predefinite "basso", "alto" e "massimo" per l'impegno.
Scegli il livello di compatibilità che corrisponde all'applicazione esistente.
Mantenere il totale degli input e degli output all’interno della finestra di contesto di 1 milione di token.
Formati delle immagini e regole di posizionamento
DeepSeek supporta immagini nei formati JPEG, PNG, GIF e WebP. Un'immagine inline può avere una dimensione massima di 32 MiB, mentre un'immagine in file può arrivare fino a 64 MiB. Il limite condiviso documentato consente di includere fino a 600 immagini in una singola richiesta. Tale limite massimo non è da intendersi come raccomandazione: batch di grandi dimensioni aumentano le dimensioni del prompt, la latenza e la difficoltà di risalire all'immagine a cui si riferisce una risposta.
Per l'API delle risposte, il contenuto delle immagini va inserito nei messaggi degli utenti. Le immagini inserite in sistema o assistente i messaggi restituiscono un codice di stato HTTP 400. Il livello di compatibilità non accetta file generici come elementi di input, pertanto le applicazioni dovrebbero attenersi agli schemi di input delle immagini documentati, anziché dare per scontata la completa corrispondenza delle funzionalità delle risposte OpenAI.
Limiti relativi al contesto, all'output e alla concorrenza
Il contesto massimo è di un milione di token, mentre l'output massimo è di 384.000 token. L'input e l'output, considerati complessivamente, devono rientrare nella finestra di contesto. Flash consente 2.500 connessioni simultanee per account; le richieste che superano tale limite ricevono un codice di stato HTTP 429. La pianificazione della capacità dovrebbe quindi tenere traccia dell'occupazione delle connessioni attive e del comportamento di riprova.
DeepSeek V4.1 Flash vs V4 Pro
V4.1 Flash rappresenta l'impostazione predefinita più pratica per agenti di codifica ad alto volume, input visivi e applicazioni con contesti estesi. V4 Pro rimane rilevante come riferimento per il ragionamento durante il breve periodo di transizione, ma non supporta la visione e presenta una concorrenza documentata inferiore. La nostra precedente Recensione del DeepSeek V4 Pro tratta quel punto di controllo secondo i propri criteri; i risultati pratici che ne derivano non dovrebbero essere riclassificati come prove relative alla versione 4.1.
| Fattore determinante | V4.1 Flash | V4 Pro prima della modifica del percorso |
|---|---|---|
| La migliore vestibilità | Agenti, programmazione, input lunghi, visione | Esercizi selezionati di ragionamento di frontiera |
| Immagine in ingresso | Supportato | Non supportato |
| Concorrenza/account | 2.500 connessioni | 500 connessioni |
| Input non memorizzato nella cache fuori dalle ore di punta | $0,15 / 1M | $0,66 / 1M |
| Produzione fuori picco | $0,60 / 1M | $1.98 / 1M |
| Schema ufficiale di valutazione | Contatti visualizzati nelle righe relative agli agenti/codifiche | Link GPQA Diamond e HLE (solo testo) |
I prezzi si riferiscono alle tariffe API DeepSeek, non ai prezzi GlobalGPT. Le tariffe Pro si applicano prima della modifica dell'instradamento annunciata per il 14 settembre.
Con le tariffe fuori picco, l’input non memorizzato nella cache di Flash risulta più economico di circa 77% rispetto alla tariffa Pro indicata, mentre l’output di Flash risulta più economico di circa 70%. Tali percentuali sono calcolate aritmeticamente sulla base del listino ufficiale e non rappresentano risparmi effettivi. I risparmi effettivi dipendono dal riutilizzo della cache, dalla lunghezza dell’output, dai tentativi di esecuzione e dal fatto che il carico di lavoro richieda o meno i risultati più potenti di Pro sulle righe di ragionamento selezionate.
La distinzione più urgente è di natura operativa. DeepSeek sta mantenendo il deepseek-v4-pro nome, modificando temporaneamente il modello sottostante. Un nome API stabile non garantisce un comportamento stabile in uscita. Conservare le risposte rappresentative di V4 Pro, le tracce degli strumenti, la latenza e i casi di errore precedenti al 14 settembre, quindi eseguire la stessa suite di test di accettazione dopo le modifiche al routing. Per il framework di confronto dei checkpoint precedente, consultare DeepSeek V4 Pro vs Flash.
Cosa dicono gli sviluppatori
Le prime reazioni sono positive per quanto riguarda la velocità di elaborazione, l’efficienza della cache e i punteggi degli agenti, ma i dati disponibili sono disomogenei. Alcuni commenti si riferiscono a una versione di anteprima piuttosto che alla versione definitiva, mentre alcune relazioni riportano una sintesi delle dimostrazioni anziché i risultati di test controllati. La discussione pubblica più utile verte quindi su dove effettuare i test, non sul fatto che un singolo dato relativo al giorno del lancio possa determinare la decisione.
L'analisi relativa al lancio raccomanda di mantenere una configurazione di base V4 Pro e di testare il modello Flash appena rilasciato prima della modifica del routing prevista per il 14 settembre. Sottolinea inoltre che i miglioramenti variano a seconda del benchmark, del framework e dell'impostazione dello sforzo.
Leggi l'analisiRiassumendo le dimostrazioni in anteprima presentate al World of AI, la testata ha evidenziato una velocità massima osservata di 427 token al secondo e ha segnalato un eccesso di elaborazione e un comportamento meno accurato nella simulazione fisica. Non si tratta di una garanzia ufficiale di velocità.
Leggi l'articolo di anteprimaNel thread dedicato al lancio, l'utente ha contestato l'invio silenzioso dei flussi di lavoro Pro convalidati a un altro modello e ha sostenuto la necessità di definire un periodo di obsolescenza. Si tratta di un'opinione espressa da un membro della comunità, non di un consenso.
Apri il commentoIl responsabile dei test di penetrazione basati sull’intelligenza artificiale (AI) di Aikido ha segnalato miglioramenti in termini di recall a esecuzione singola, recall pass@3, precisione e percentuale di cache hit in un benchmark sulla sicurezza informatica. Il suo post menziona un endpoint di anteprima in scadenza, pertanto non costituisce una prova valida per il checkpoint finale.
Visualizza il rapporto di anteprimaQueste reazioni evidenziano tre verifiche che vale la pena eseguire in qualsiasi implementazione reale: confrontare la qualità dell’output a un livello di sforzo fisso, verificare se un ragionamento lungo aumenti il costo dell’output e rieseguire i casi di regressione quando un alias modifica il modello alla base di un endpoint. I risultati preliminari relativi alla produttività e alla sicurezza possono guidare la progettazione dei test, ma non dovrebbero essere combinati con la Tabella 3 di DeepSeek come se provenissero da un unico benchmark controllato.
Come accedere alla versione DeepSeek V4.1 Flash
Esistono tre modalità di accesso distinte. Scegli quella più adatta alle tue esigenze: controllo diretto tramite API, pesi self-hosted o un’area di lavoro nel browser che semplifica il cambio di modello. I termini, i prezzi e le responsabilità operative variano a seconda della modalità scelta.
API DeepSeek
Utilizza il sito ufficiale deepseek-flash modello per integrazioni native, Responses o compatibili con Anthropic.
Pesi liberi
Scarica la scheda del modello e i pesi con licenza MIT. Verifica la compatibilità con Serving Stack e i requisiti infrastrutturali prima di procedere.
Apri il repository dei modelliGlobalGPT
Utilizzare la voce dedicata “V4.1 Flash” all’interno di un’area di lavoro multimodello. La fatturazione GlobalGPT è separata dalla tariffa API DeepSeek.
Prova DeepSeek V4.1 Flash
L'API diretta è la scelta più ovvia quando servono controlli programmatici, la rendicontazione dell'utilizzo e l'accesso alle interfacce documentate di DeepSeek. I pesi aperti sono destinati ai team in grado di verificare il supporto all'inferenza e di gestire un modello MoE di dimensioni molto grandi. GlobalGPT rappresenta la soluzione più semplice per l'uso interattivo e i confronti all'interno di un flusso di lavoro con modello di IA "tutto in uno".
Il post ufficiale di lancio di DeepSeek afferma che l'azienda collaborerà con la comunità open source per il supporto all'inferenza ed esplorerà ulteriori opzioni di implementazione. Consideratelo come una dichiarazione relativa alla roadmap, non come una prova che ogni stack di serving locale supporti già in modo efficiente Flash V4.1.
Chi dovrebbe utilizzare la versione DeepSeek V4.1 Flash?
Dare priorità a V4.1 Flash quando prevalgono attività al terminale, navigazione nel repository, automazione, utilizzo di strumenti e prompt lunghi. I punteggi ufficiali degli agenti e i tassi di input più bassi giustificano una fase pilota specifica per quel carico di lavoro.
La possibilità di importare immagini in formato nativo rende Flash l'opzione più pratica rispetto a V4 Pro per screenshot, grafici, tabelle e prove relative all'interfaccia. Verifica l'accuratezza dell'estrazione confrontandola con le risposte note.
V4 Pro è in testa alle righe "solo testo" visualizzate relative a GPQA Diamond e HLE. Confronta i prompt fissi e le impostazioni di sforzo prima di sostituire un flusso di lavoro di ragionamento convalidato.
La licenza MIT è permissiva, ma un backbone 552B MoE non è un modello locale leggero. Verificare l’hardware, la strategia di cache, la quantizzazione e il supporto per il serving.
Per una selezione più ampia dei modelli, il Confronto tra GPT-5.5 e DeepSeek V4 mette a confronto il contesto di un milione di token e la posizione di prezzo con un’altra opzione all’avanguardia. I team che si concentrano sullo stile di produzione del codice possono anche consultare il Test del codice Python: DeepSeek vs ChatGPT. Questi articoli rispondono a domande correlate; nessuno dei due sostituisce la verifica dell’esatto endpoint Flash V4.1 utilizzato in produzione.
Gli utenti comuni che devono scegliere tra diversi ecosistemi potrebbero trovare più ampio il Confronto tra DeepSeek e ChatGPT più utile di una valutazione a livello di architettura. Flash V4.1 dà il meglio di sé quando i suoi vantaggi specifici – input di lunga durata, comprensione delle immagini, strumenti e basso costo per token – si integrano in un flusso di lavoro concreto.
Il verdetto
Le sue tariffe API più basse, il contesto da 1 milione, l’input nativo di immagini, il limite di 2.500 connessioni e i miglioramenti degli agenti segnalati da DeepSeek costituiscono validi motivi per prenderlo in considerazione. Non si tratta di un sostituto universale della versione Pro: la V4 Pro rimane all’avanguardia in determinate aree di ragionamento, i punteggi ottenuti con il massimo sforzo comportano un maggiore utilizzo di token in output e le modifiche all’instradamento degli endpoint possono alterare il comportamento convalidato.
Installazione della versione DeepSeek V4.1 della memoria flash nel modello GlobalGPTInizia con una piccola suite di test di accettazione: un’attività rappresentativa di codifica, un’attività di estrazione basata su immagini, un caso con contesto esteso e un flusso di lavoro basato su strumenti. Definisci l’impostazione di ragionamento, registra il percorso del modello e confronta le modalità di errore e la qualità media. In questo modo otterrai una decisione che potrai difendere senza considerare i benchmark dei fornitori o le reazioni del giorno del lancio come prestazioni garantite dell’applicazione.
Domande frequenti
Che cos’è la versione DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash è un modello multimodale "mixture-of-experts" a pesi liberi, rilasciato il 10 settembre 2026. Supporta l'input di testo e immagini, l'output di testo, una finestra di contesto da un milione di token, le modalità "thinking" e "non-thinking", l'output JSON e le chiamate agli strumenti.
Quanto costa l'API Flash DeepSeek V4.1?
Le tariffe API DeepSeek fuori picco sono pari a $0,003 per ogni milione di token di input memorizzati nella cache, $0,15 per ogni milione di token di input non memorizzati nella cache e $0,60 per ogni milione di token di output. Le tariffe nelle ore di punta sono rispettivamente pari a $0,006, $0,30 e $1,20. Si tratta di prezzi API DeepSeek, non di prezzi GlobalGPT.
Quale nome di modello API devo utilizzare per la memoria Flash DeepSeek V4.1?
Utilizzo deepseek-flash con l'API ufficiale DeepSeek. DeepSeek supporta anche le chiamate all'API Responses all'indirizzo https://api.deepseek.com e chiamate compatibili con Anthropic all'indirizzo https://api.deepseek.com/anthropic.
Quali sono i limiti relativi al contesto, all'output e alla concorrenza?
DeepSeek V4.1 Flash dispone di una finestra di contesto da un milione di token e di un output massimo di 384.000 token; l'input e l'output devono rientrare all'interno del contesto. DeepSeek supporta 2.500 connessioni simultanee per account; superato tale limite, viene restituito il codice di errore HTTP 429.
La versione Flash DeepSeek V4.1 è migliore della V4 Pro?
Dipende dall’attività. Nella tabella fornita dal produttore DeepSeek, V4.1 Flash supera V4 Pro nei benchmark relativi a codifica, terminale, sicurezza e automazione, mentre V4 Pro supera GPQA Diamond e HLE (solo testo). Inoltre, Flash costa meno, supporta la visione artificiale e consente un numero maggiore di connessioni simultanee.
Il firmware DeepSeek V4.1 supporta le immagini?
Sì. Accetta file in formato JPEG, PNG, GIF e WebP e genera testo. DeepSeek supporta documenti con immagini in linea fino a 32 MiB, immagini in file fino a 64 MiB e 600 immagini per richiesta, nel rispetto dei limiti condivisi. Le immagini fornite dall’API nelle risposte devono essere inserite nei messaggi degli utenti.
È possibile scaricare i pesi Flash per DeepSeek V4.1?
Sì. DeepSeek pubblica i pesi del modello DeepSeek-V4.1-Flash su Hugging Face con licenza MIT. La natura permissiva della licenza non elimina tuttavia i requisiti infrastrutturali: i team devono comunque disporre di un software di serving compatibile e di hardware sufficiente per supportare il backbone MoE da 552 miliardi.
Posso utilizzare il firmware DeepSeek V4.1 sul modello GlobalGPT?
Sì. GlobalGPT dispone di una voce Flash dedicata a DeepSeek V4.1 per l'utilizzo tramite browser. L'accesso e la fatturazione sono separati dalla tariffa API diretta di DeepSeek e la disponibilità della piattaforma non verifica in modo indipendente i risultati dei benchmark pubblicati da DeepSeek.