
Risposta rapida: GPT-6 Sol è il modello di codifica complessa e flussi di lavoro agenti di OpenAI. L'API ufficiale indica $2.00 per ogni milione di token in ingresso e $10.00 per ogni milione di token in uscita alle tariffe Standard, con una finestra di contesto di 1,05 milioni di token e un output massimo di 128K. La domanda fondamentale da porsi è se le sue risposte soddisfino i requisiti del vostro compito a un costo totale accettabile.
OpenAI posiziona GPT-6 Sol per attività di codifica complesse e flussi di lavoro basati su agenti. Questa frase rappresenta il posizionamento del fornitore, non un punteggio di qualità misurato. La presente recensione traduce le specifiche pubblicate in decisioni relative all’acquisto e all’architettura, per poi documentare la reazione del pubblico con le relative attribuzioni. Abbiamo inoltre eseguito tre piccoli compiti conservando l’ID del modello, il percorso, il set di prompt, l’output grezzo e l’utilizzo. I risultati dei compiti sono riportati di seguito come un’esecuzione osservata, non come un benchmark ufficiale.
Giudizio a prima vista
Sol è il modello da prendere in considerazione quando il lavoro è realmente complesso, richiede un uso intensivo di strumenti o è incentrato sul codice e si è disposti ad accettare un costo in token più elevato. I dati qui riportati combinano la documentazione ufficiale con il nostro piccolo campione di attività, non un benchmark controllato; pertanto, il verdetto più appropriato è che si tratta di una scelta adeguata, non di una classifica universale.
La distinzione più utile non è semplicemente quella tra “intelligente” e “veloce”, bensì la forma del carico di lavoro. GPT-6 Sol presenta lo stesso contesto di riferimento e gli stessi limiti massimi di output del suo omologo, ma il suo posizionamento e il suo prezzo rendono opportuno un punto operativo diverso. Confrontiamo l’ampio Guida alla scelta dei modelli di intelligenza artificiale e il Il miglior modello di AI per la codifica linee guida da seguire quando l'attività coinvolge più di un fornitore.
GPT-6 Sol in sintesi
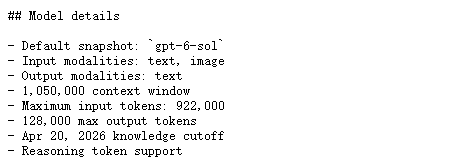
La tabella che segue riporta i dati attuali pagina ufficiale del modello Sol di GPT-6. La capacità del contesto non è la stessa cosa della dimensione consigliata del prompt, e l'input massimo è indipendente dalla finestra di contesto dell'headline.
gpt-6-solEntrambi i modelli correlati supportano, secondo le specifiche documentate, output strutturati, chiamata di funzioni, streaming, memorizzazione temporanea dei prompt, input di immagini, ricerca di file e ricerca sul web. Il comportamento esatto dello strumento dipende comunque dall’endpoint, dall’account e dalla configurazione della richiesta; non si deve dedurre che l’esecuzione dello strumento abbia avuto esito positivo solo sulla base della presenza di una casella di controllo relativa a una determinata funzionalità.
Per quanto riguarda il contesto familiare, il Recensione della GPT-6 Astra mostra come un articolo correlato su GPT-6 distingua tra documentazione del fornitore, percorsi della piattaforma e reazioni attribuite.
Prezzi di GPT-6 Sol e la regola dei 272.000
Alle tariffe standard, il Pagina dei prezzi OpenAI riporta $2.00 di input, $0.20 di input in cache, $2.50 di scritture in cache e $10.00 di output per ogni 1 milione di token. Le scritture in cache sono pari a 1,25 volte l’input non memorizzato in cache. I prezzi per Batch e Flex sono pari a 50% di Standard; la modalità Fast è pari al doppio della tariffa applicabile, mentre l'elaborazione regionale aggiunge 10%, ove disponibile.
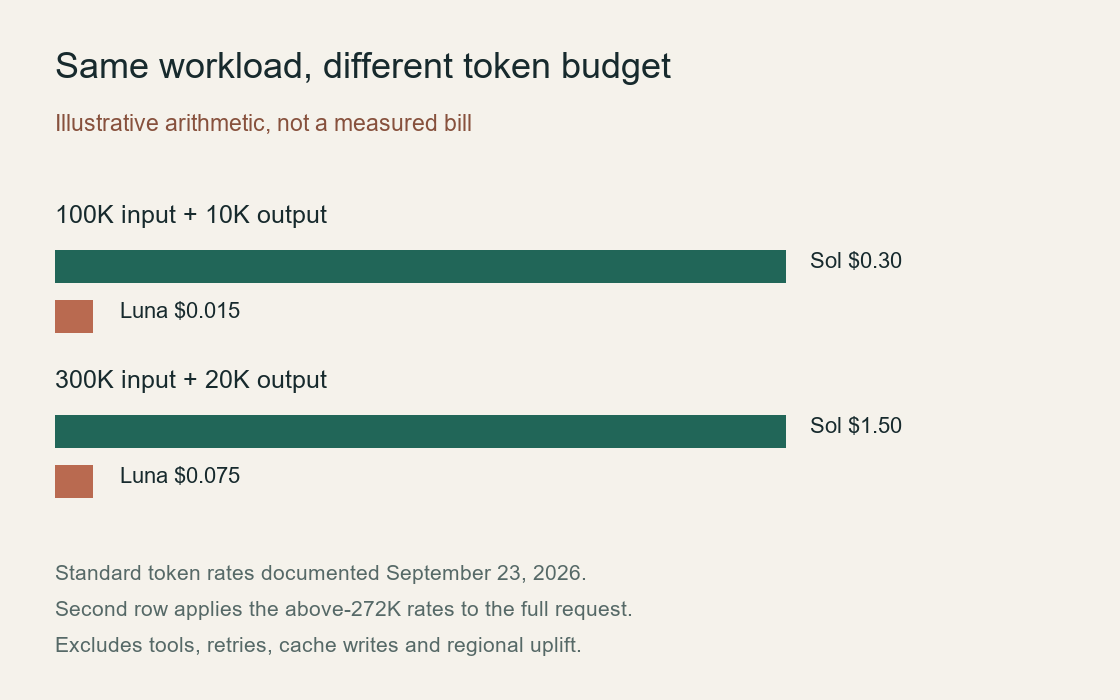
La colonna “contesto lungo” viene calcolata in base alla regola OpenAI: al di sopra dei 272K di input, le velocità di input e di cache raddoppiano e l’output viene moltiplicato per 1,5 per l’intera richiesta. Non si tratta di una fatturazione a tariffa mista. Come riferimento pratico per il budget, 100K di input più 10K di output costano circa $0.30 prima degli strumenti o del sollevamento regionale; un esempio con un input di 300.000 e un output di 20.000 costa circa $1.50 alle tariffe per contesti lunghi.
Una finestra di contesto di grandi dimensioni può essere utile, ma non è facile da riempire. Il recupero dei dati, la selezione dei blocchi, il riutilizzo della cache e i limiti di output contano più della cifra di 1,05 milioni riportata nel titolo. Vedi il Dettagli sui prezzi di GPT-6 Astra per una spiegazione correlata delle soglie di contesto e del funzionamento della cache.
Adattamento, strumenti e limiti dell'API GPT-6 Sol
OpenAI consiglia l'API Responses per gli strumenti integrati e la chiamata di funzioni. Chat Completions supporta la chiamata di funzioni solo quando sforzo_di_ragionamento è impostato su nessuno. Si tratta di un dettaglio di implementazione che vale la pena tenere presente prima della migrazione: una richiesta può essere sintatticamente valida, ma non corrispondere al comportamento dello strumento previsto dall'integrazione attuale.
La tabella dei limiti di velocità attuale riporta i seguenti livelli Standard. RPM indica le richieste al minuto, TPM indica i token al minuto e il valore della coda rappresenta il limite dei token per batch.
Prima di avviare la produzione, verifica il livello esatto, l'endpoint, la modalità di streaming e il contratto dello strumento nel tuo account. Il Guida ai limiti di utilizzo del Codex è un contesto utile per spiegare perché il limite massimo pubblicato di un modello non corrisponde alla quota effettiva di un account.
Cosa suggeriscono le specifiche tecniche di GPT-6 Sol
Questa è una mappa di adattamento, non un punto di riferimento. Utilizza il Guida al flusso di lavoro dei modelli di IA "tutto in uno" quando la vera decisione da prendere è come passare da un modello all’altro all’interno di un unico processo ripetibile, piuttosto che quale singolo modello risulti più convincente.
Nei nostri test: GPT-6 Sol in tre attività pratiche
Il 23 settembre 2026 abbiamo testato una piccola correzione in JavaScript, una nota decisionale di tre righe e l'estrazione di dati JSON. I risultati riportati di seguito sono le risposte complete relative all'ID del modello gpt-6-sol. I tentativi precedenti hanno riscontrato errori temporanei di sovraccarico, pertanto questi risultati non devono essere interpretati come misurazioni di affidabilità ottenute al primo tentativo. Esaminiamo cosa contengono le risposte, cosa può essere riutilizzato dal lettore e cosa rimane ancora da verificare.
Correzione del codice: mantenere lo zero senza riscrivere la funzione
Esamina questa piccola funzione JavaScript come se facesse parte di un repository di produzione. Individua il bug, spiega la modalità di errore e proponi una patch minima, oltre a due test di regressione mirati. Funzione: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }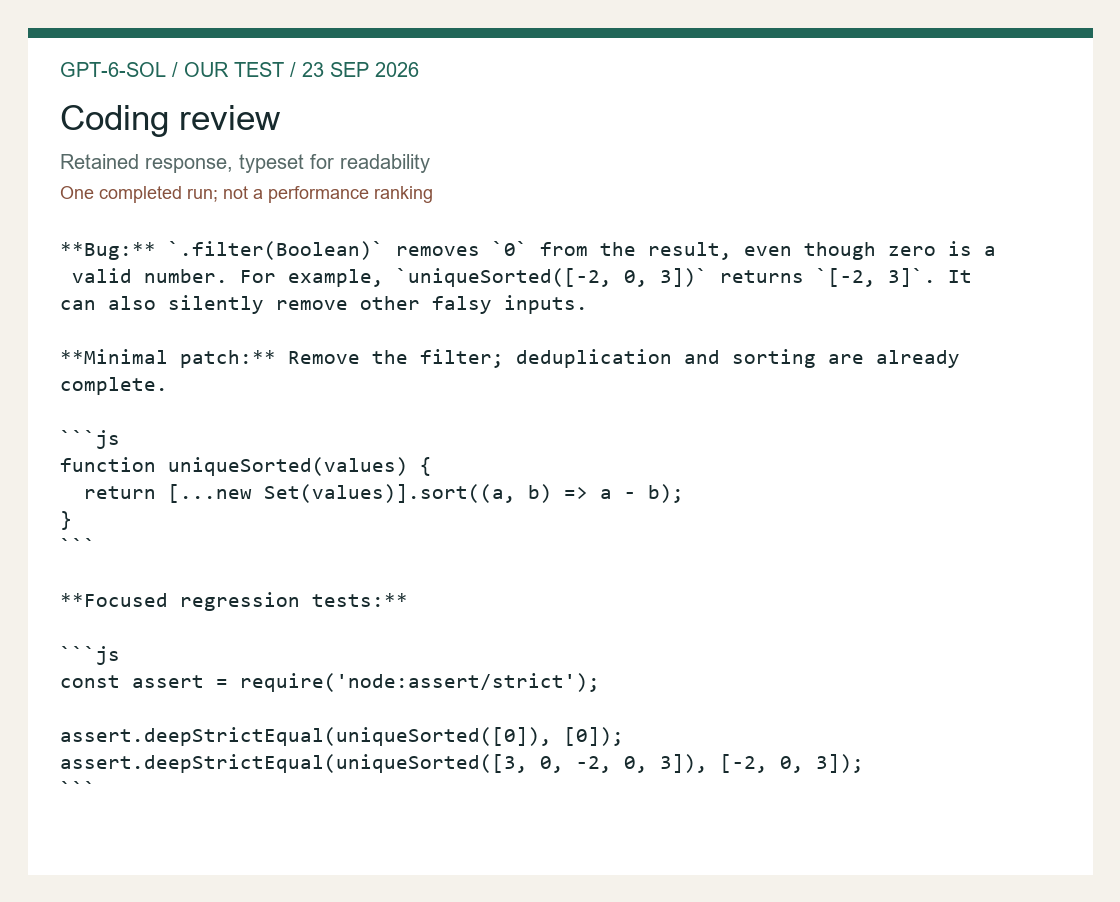
**Bug:** `.filter(Boolean)` rimuove lo `0` dal risultato, anche se lo zero è un numero valido. Ad esempio, `uniqueSorted([-2, 0, 3])` restituisce `[-2, 3]`. Può inoltre rimuovere silenziosamente altri valori falsi.

**Patch minima:** Rimuovere il filtro; la deduplicazione e l’ordinamento sono già completati.

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**Test di regressione mirati:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
Utilizzo segnalato per questa risposta completata: 71 token di input, 409 token di completamento, 480 token in totale. Il conteggio dei caratteri può includere i token di ragionamento; non si tratta semplicemente della lunghezza della risposta visibile.
Sol ha individuato il vero difetto, invece di riscrivere la funzione in base a una preferenza non pertinente. Il risultato finale .filter(Boolean) esclude lo zero perché JavaScript converte lo zero in false. La deduplicazione e l'ordinamento numerico crescente avvengono già prima di quel filtro. Rimuovendo solo il filtro si risolve quindi l'errore evidenziato, lasciando intatto il resto dell'algoritmo. Questo è il tipo di piccola correzione che un revisore può comprendere rapidamente: la spiegazione identifica il valore errato, la modifica agisce sull'operazione responsabile e i test mostrano il comportamento previsto.
Le due asserzioni di regressione svolgono funzioni diverse. Il caso del singleton [0] isola il difetto dello "zero che scompare". Il caso misto combina un numero negativo, lo zero, un numero positivo e valori duplicati, verificando che la deduplicazione e l'ordinamento numerico rimangano inalterati dopo la modifica. Sol ha inoltre incluso require('node:assert/strict'), quindi la dipendenza dell'asserzione è visibile. Questi dettagli rendono la risposta più utile rispetto a una patch accompagnata da un vago consiglio di aggiungere dei test. Tuttavia, non chiariscono ancora in che modo Sol ispezionerebbe un repository, risolverebbe le importazioni tra i file o gestirebbe una build fallita.
Al di là del bug riscontrato, si pone una questione relativa alle specifiche del contratto. Questa funzione dovrebbe accettare solo numeri finiti o valori JavaScript arbitrari? La rimozione del filtro comporta inoltre il mantenimento di altri input falsi qualora gli utenti li inviassero. NaN, zero negativo, infiniti, stringhe numeriche e null richiedono decisioni deliberate a livello di politica. Senza tale politica, non aggiungeremmo silenziosamente coercizioni o validazioni a questa patch. Una correzione minima è preziosa proprio perché separa il difetto confermato da una riprogettazione più ampia.
Sintesi a tre note: mantenere la decisione condizionata
Sintetizza le tre note seguenti in una nota decisionale concisa che includa: decisione, prove, rischi e passo successivo. Nota A: Una finestra di contesto da 1,05 milioni di token può contenere insiemi di dati di origine di grandi dimensioni, ma non rende ogni richiesta economica. Nota B: Oltre i 272.000 token in ingresso, i tassi di input/cache documentati aumentano e l’output viene moltiplicato per l’intera richiesta. Nota C: Il recupero e il riutilizzo della cache possono ridurre il costo dei prompt ripetuti, ma i criteri di accettazione devono comunque essere testati.
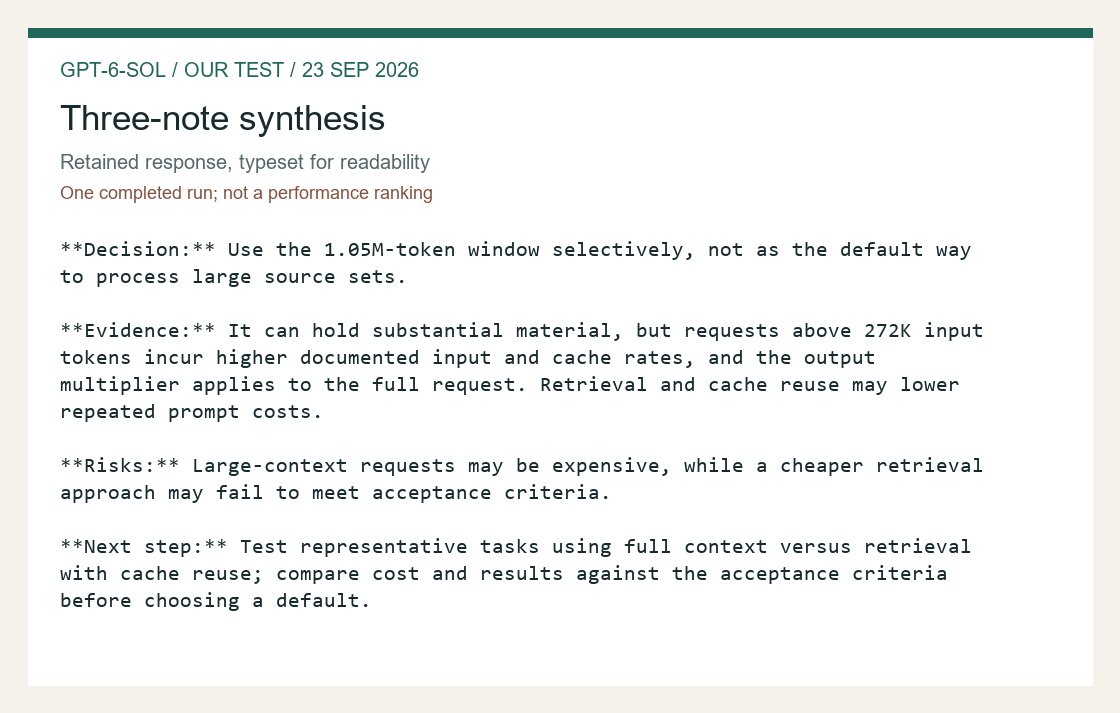
**Decisione:** Utilizzare la finestra da 1,05 milioni di token in modo selettivo, non come metodo predefinito per l'elaborazione di insiemi di dati di origine di grandi dimensioni.

**Prove:** È in grado di contenere una quantità considerevole di materiale, ma le richieste superiori a 272.000 token in ingresso comportano tassi di input e di cache documentati più elevati, e il moltiplicatore di output si applica all’intera richiesta. Il recupero e il riutilizzo della cache possono ridurre i costi dei prompt ripetuti.

**Rischi:** Le richieste con contesti di grandi dimensioni possono risultare costose, mentre un approccio di recupero più economico potrebbe non soddisfare i criteri di accettazione.

**Prossimo passo:** Testare attività rappresentative utilizzando il contesto completo rispetto al recupero con riutilizzo della cache; confrontare costi e risultati con i criteri di accettazione prima di scegliere un’impostazione predefinita.
Utilizzo segnalato per questa risposta completata: 99 token di input, 186 token di completamento, 285 token in totale. Il conteggio dei caratteri può includere i token di ragionamento; non si tratta semplicemente della lunghezza della risposta visibile.
Sol ha organizzato le tre note nelle categorie: decisione, prove, rischi e passo successivo. La sua raccomandazione era di utilizzare in modo selettivo la finestra ampia, valutando il recupero e il riutilizzo della cache in base a criteri di accettazione. Il comportamento utile era il mantenimento della formulazione condizionale: il recupero può ridurre i costi, ma solo un test del carico di lavoro può stabilire se conserva le informazioni necessarie alla decisione. La risposta non ha fornito una percentuale di risparmio, un punteggio di richiamo misurato né una raccomandazione di inviare sempre il contesto massimo.
Questo input era costituito da soli 99 token di prompt riportati. Serve a testare la sintesi di note brevi e la capacità di seguire le istruzioni, non la capacità di recuperare un fatto nascosto tra centinaia di migliaia di token. Le indicazioni sui prezzi erano fornite nelle note; ripeterle correttamente non costituisce una verifica indipendente dei prezzi. Per un vero promemoria di architettura, aggiungeremmo identificatori di origine, un responsabile delle decisioni e un'ipotesi di budget esplicita. Tali aggiunte renderebbero ogni frase verificabile senza fingere che questo breve esercizio abbia messo alla prova l'intera finestra di contesto.
Estrazione JSON: mantenere esplicite le incognite
Estrai i seguenti campi da questa scheda e restituisci solo un JSON valido contenente le chiavi customer, priority, deadline e unknowns. Scheda: Cliente: Northwind Labs. Priorità: alta. Scadenza: 04/10/2026. Il responsabile non è indicato e il budget non è confermato.
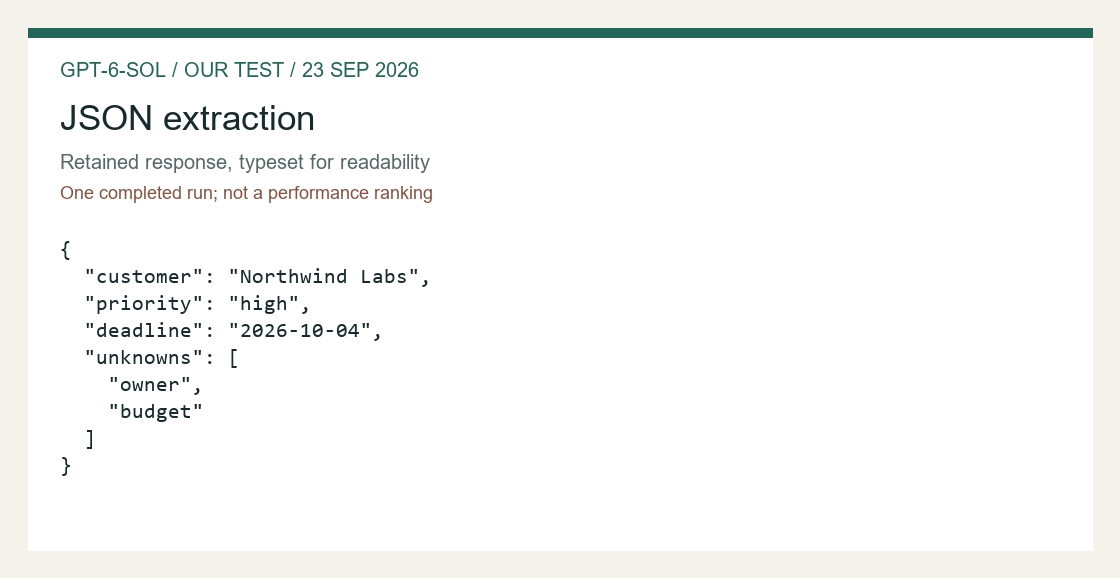
{"cliente":"Northwind Labs","priorità":"alta","scadenza":"04/10/2026","dati mancanti":["responsabile","budget"]}Utilizzo segnalato per questa risposta completata: 64 token di input, 64 token di completamento, 128 token in totale. Il conteggio dei caratteri può includere i token di ragionamento; non si tratta semplicemente della lunghezza della risposta visibile.
Sol ha restituito esattamente i campi richiesti: cliente, priorità, scadenza e incognite. L’elenco delle incognite ha mantenuto i campi relativi al proprietario mancante e al budget non confermato, invece di sostituirli con ipotesi plausibili. Si tratta di un risultato significativo per questo piccolo compito: un sistema a valle è in grado di distinguere una scadenza nota da un’informazione mancante. L’output non conteneva inoltre né delimitatori Markdown né introduzioni esplicative, rendendolo direttamente analizzabile come JSON.
Lo stesso JSON è comparso nel risultato conservato da Luna. In questo caso non si osserva alcun vantaggio in termini di qualità dell’estrazione che giustifichi il pagamento della tariffa più alta di Sol per questo particolare input. Sol potrebbe comunque valere la pena di essere preso in considerazione quando l’estrazione dipende dalla risoluzione di contraddizioni tra diversi documenti, ma si tratta di un’attività diversa. Il nostro punto di partenza pratico sarebbe un percorso di estrazione convalidato e più economico, con un’escalation in caso di prove contrastanti, piuttosto che utilizzare il modello più costoso per ogni record.
Un test di regressione eseguibile per il difetto evidenziato
Quello che segue è un esempio di validazione editoriale, non una risposta aggiuntiva del modello. Viene eseguito localmente in Node.js e non effettua alcuna richiesta al modello. Verifica lo specifico fixture discusso in precedenza; non si tratta di una valutazione generale del modello.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('La patch ha esito positivo; il difetto originale relativo al valore zero viene riprodotto.');
L'asserzione negativa finale conferma che la funzione originale restituisce zero. Ciò conferisce al controllo una sensibilità agli errori: il test non si limita ad accettare la nuova implementazione, ma evidenzia il sintomo che la modifica intende correggere. Il caso dell’array vuoto costituisce un ulteriore controllo redazionale, chiaramente distinto dalle due asserzioni fornite dal modello. Per il codice di produzione, collocare il test accanto alla funzione reale ed eseguire il comando di test effettivo del progetto; copiare una funzione in un file di test separato non permette di individuare errori di integrazione.
In che modo GPT-6 Sol trasforma un flusso di lavoro reale
Le specifiche principali contano solo quando modificano il modo di lavorare di un team. GPT-6 Sol è pensato per la programmazione complessa e i flussi di lavoro basati su agenti, quindi la prima domanda da porsi è se il proprio carico di lavoro tragga vantaggio da questa impostazione. Se ogni richiesta presenta un input breve, un contratto di output ben definito e un test di accettazione chiaro, il modello può essere integrato in una pipeline ripetibile. Se invece l’attività è ambigua, richiede un uso intensivo di strumenti o è suscettibile di necessitare di diversi cicli di correzione, l’orchestrazione circostante è importante tanto quanto il nome del modello.
Per GPT-6 Sol, un modello di produzione efficace consiste in un percorso a due passaggi: in primo luogo, si richiede una risposta concisa che indichi esplicitamente l’incertezza; successivamente, si invia solo la parte contestata o incompleta a un secondo passaggio. Ciò limita lo spreco di token di output e rende visibili gli errori. Inoltre, offre un punto di confronto migliore rispetto a GPT-6 Luna: la questione non è quale nome suoni più efficace, ma quale percorso soddisfi i criteri di accettazione con un minor numero di tentativi.
Un semplice modello di calcolo dei costi prima della spedizione
La tabella dei prezzi ufficiale dovrebbe essere convertita nelle unità effettivamente acquistate dal vostro team: richieste al giorno, token di input medi, quota di prefissi memorizzati nella cache, token di output e percentuale di chiamate che superano i 272.000 token di input. Un foglio di calcolo che riporti solo il prezzo di input indicato nasconde il moltiplicatore legato al contesto a lungo termine e il costo dei tentativi di ripetizione.
Questo calcolo è particolarmente rilevante quando si confrontano GPT-6 Sol e GPT-6 Luna. Una richiesta più economica può rivelarsi costosa se richiede ripetuti cicli di correzione; una richiesta più potente può invece risultare dispendiosa quando l’attività consiste in un’estrazione deterministica. Il punto di riferimento corretto è un piccolo campione del proprio traffico con gli stessi prompt, lo stesso schema e la stessa regola di revisione.
Modalità di guasto da verificare prima dell'adozione
Una pagina di esempio può indicarti quali endpoint e modalità sono documentati, ma non può garantire che la tua applicazione esistente si comporti allo stesso modo dopo la migrazione. Verifica se gli eventi in streaming vengono analizzati correttamente, se le chiamate agli strumenti mantengono lo stato tra un tentativo e l'altro, se l'output strutturato rifiuta i campi non conformi e se la tua pipeline di registrazione registra l'ID del modello e l'impostazione di ragionamento per ogni richiesta.
Proprio questi criteri rendono utili le osservazioni pratiche contenute in questa recensione, senza però trasformarle in una classifica. I nostri tre test dimostrano come il percorso abbia gestito un piccolo difetto nel codice, una nota decisionale e un’estrazione rigorosa di dati JSON. Essi non stabiliscono la latenza, l’affidabilità su larga scala né una classifica universale della qualità.
Un quadro decisionale per team reali
Una revisione del modello è utile quando aiuta qualcuno a prendere una decisione in presenza di vincoli. Per GPT-6 Sol, i vincoli più rilevanti sono la struttura della richiesta, il costo della revisione, la dimensione del contesto, il formato dell’output e le conseguenze di una risposta errata. La descrizione fornita dal fornitore fa riferimento a una codifica complessa e a flussi di lavoro basati su agenti, ma un team deve comunque tradurre tale descrizione in un percorso che possa monitorare. Iniziate descrivendo il compito in una sola frase, specificando l’input che il modello riceverà, l’output che un altro sistema si aspetta e il punto di controllo umano che impedisce un errore non rilevato.
Il primo errore è scegliere un modello da un prompt di demo. Una demo premia la fluidità e nasconde dettagli operativi quali i tentativi di ripetizione, la gestione dei token, le autorizzazioni degli strumenti e gli errori di schema. Un confronto più efficace utilizza tre operazioni rappresentative: una richiesta ordinaria, una richiesta complessa e una richiesta che dovrebbe essere rifiutata o inoltrata a un livello superiore. Il risultato non è un punteggio unico, ma una piccola mappa che indica dove il modello fa risparmiare tempo, dove necessita di supervisione e dove un altro modello — spesso GPT-6 Luna — rappresenta la soluzione più economica o più sicura.
Inizia con il test di accettazione
Scrivi il test di accettazione prima di scrivere il prompt. Per il codice, il test può essere un test unitario superato o una patch che non modifica l’API pubblica. Per l’estrazione, può trattarsi di un JSON valido in cui siano presenti tutte le chiavi richieste e i valori sconosciuti siano conservati in modo esplicito. Per una nota decisionale, può trattarsi di una struttura fissa che includa prove, rischi, responsabile e passo successivo. Il modello può essere valutato solo rispetto a un obiettivo visibile. Senza tale obiettivo, un paragrafo ben redatto può sembrare corretto, pur omettendo silenziosamente l’unico campo necessario al processo a valle.
Un buon test di accettazione è sufficientemente circoscritto da poter essere eseguito automaticamente e sufficientemente significativo da proteggere l’utente. Dovrebbe inoltre rendere evidenti eventuali discrepanze. Se due risultati differiscono, il team dovrebbe essere in grado di individuare un dato mancante, un’ipotesi non supportata, un campo compilato in modo errato o un calcolo errato. Ciò è più utile ai fini dell’azione rispetto all’affermazione che una risposta “sembrava più intelligente”. È anche la differenza tra una revisione che aiuta l’ufficio acquisti e una revisione che si limita a ripetere il linguaggio utilizzato per il lancio.
Utilizza il nome del modello per scegliere un'ipotesi di partenza. Utilizza il test di accettazione per stabilire se l'ipotesi regge il confronto con l'ambiente di produzione.
Progettazione del prompt che corrisponda al profilo del modello
Lo stesso prompt non dovrebbe essere copiato tal quale da un modello all’altro. Il contratto di compito può rimanere invariato, ma la quantità di contesto, le istruzioni di ragionamento e i vincoli sull’output dovrebbero adattarsi al percorso. Per GPT-6 Sol, mantenere le istruzioni di sistema sufficientemente concise da non entrare in competizione con il materiale di partenza. Specificare il ruolo, la regola decisionale, la struttura dell’output richiesta e le condizioni che richiedono un’incognita esplicita o un’escalation.
Per i documenti lunghi, separare l’estrazione dal giudizio. Identificare innanzitutto i passaggi che rispondono alla domanda; poi richiedere la conclusione utilizzando solo quei passaggi e i criteri indicati. Ciò riduce la probabilità che una frase certa venga costruita a partire da un dettaglio distante e irrilevante. Inoltre, rende la finestra di contesto da 1,05 milioni di token uno strumento piuttosto che un’impostazione predefinita. Un contesto ampio è utile quando la relazione tra elementi di prova distanti tra loro è rilevante. È invece uno spreco quando il compito può essere risolto con un pacchetto ridotto e ben selezionato.
Per i flussi di lavoro che utilizzano strumenti, descrivere il confine tra il modello e lo strumento. Il modello dovrebbe stabilire se uno strumento è necessario, fornire argomenti secondo uno schema rigoroso e spiegare come verrà utilizzato il valore restituito. L’applicazione dovrebbe applicare i permessi, convalidare gli argomenti, registrare la chiamata e decidere se una chiamata allo strumento fallita possa essere ripetuta. Considerare il modello come l’intera applicazione rende più difficile il debug e aumenta la portata delle conseguenze di un’ipotesi errata.
Una traccia riutilizzabile in quattro parti
Contesto: Fornisci solo i fatti e i documenti necessari per lo svolgimento dell'incarico. Obiettivo: esprimere la decisione o la trasformazione in una sola frase. Vincoli: specificare il formato, le esclusioni, la gestione dell'incertezza e i limiti dello strumento. Controlla: chiedere al modello di elencare gli input mancanti o le contraddizioni prima che formuli la risposta definitiva. Questa struttura è sufficientemente concisa da consentire chiamate ripetute e sufficientemente esplicita da permettere un confronto tra i vari modelli.
Quando una finestra di contesto di grandi dimensioni è utile
Il titolo “1,05 milioni di token” è facile da ripetere e facile da fraintendere. Una finestra di contesto indica la quantità di materiale che può essere inclusa in una richiesta; non indica però quanta quantità di materiale debba essere inviata, in che misura il modello utilizzerà ogni passaggio, né quale sarà il costo della richiesta. Una richiesta lunga può inoltre rallentare la revisione, poiché il team ha più prove da esaminare e maggiore margine per un sottile conflitto tra le istruzioni.
Utilizza la finestra completa quando l’attività dipende effettivamente da riferimenti distanti: un contratto con definizioni separate dalle eccezioni, un repository in cui interfacce e implementazioni sono molto distanti tra loro, oppure un lungo archivio di ricerca in cui la risposta richiede di ripercorrere una sequenza. Utilizza il recupero quando la domanda è locale, quando l’insieme delle fonti cambia frequentemente o quando desideri una traccia di citazioni compatta. Utilizza la memorizzazione nella cache quando un prefisso stabile viene riutilizzato in molte richieste e la piattaforma fornisce dettagli sufficienti sull’utilizzo per dimostrare che la cache funziona.
La soglia di 272K dovrebbe essere inclusa nel diagramma dell’architettura, non essere una nota a piè di pagina nel paragrafo dedicato ai prezzi. Una richiesta che è sicura al di sotto della soglia può diventare sostanzialmente più costosa al di sopra di essa. I team dovrebbero registrare i token di input, quelli memorizzati nella cache, i token di output, l’ID del modello, le impostazioni di ragionamento e se la richiesta ha superato la soglia. Tale registro supporta un modello di costo reale e consente di individuare un’inflazione accidentale del contesto prima che si trasformi in una sorpresa a fine mese.
Domande sulla migrazione delle API che richiedono una fase di test
Prima di trasferire un’integrazione esistente su GPT-6 Sol, crea un ambiente di test che riproduca un campione ridotto e anonimizzato. Confronta il testo finale, i campi strutturati, le chiamate agli strumenti, i motivi di interruzione e l’utilizzo dei token. Non limitarti a confrontare solo la prima schermata della risposta. Un modello può mantenere la conclusione visibile pur modificando il nome di un campo, omettendo una condizione di errore o restituendo un argomento dello strumento che l’applicazione non è in grado di eseguire in modo sicuro.
Le etichette “Risposte” e “Completamenti chat” non sono intercambiabili in un piano di integrazione. Il supporto degli endpoint, le impostazioni di ragionamento, il comportamento degli strumenti, gli eventi in streaming e gli oggetti di errore influenzano tutti l’adattatore. Fissare l’ID del modello nella configurazione, ma mantenerlo visibile nei log e nei rapporti di test. Quando una richiesta fallisce, il record dovrebbe riportare l’endpoint, il modello, lo sforzo di ragionamento, la versione del prompt, la dimensione della richiesta e la decisione relativa al ritentativo. Queste informazioni consentono a un ingegnere di riprodurre un errore invece di discutere se il modello stesse semplicemente avendo una giornata no.
L’elaborazione in batch modifica l’aspetto economico e il ritmo operativo. Può essere indicata per la classificazione notturna, la preparazione dei documenti o una coda di trasformazioni a bassa urgenza. Non è invece adatta per un’azione interattiva che richiede una risposta rivolta all’utente. Anche le modalità «Fast» e «Regional» modificano il calcolo del prezzo. È opportuno considerarle come scelte di configurazione esplicite e rifletterle nel foglio di lavoro del budget, anziché nasconderle in un’impostazione predefinita.
Riprodurre gli input rappresentativi, verificare la correttezza dell'output strutturato, acquisire gli argomenti degli strumenti, confrontare i motivi di interruzione, misurare l'utilizzo dei token e testare un percorso di errore prima di modificare l'impostazione predefinita in produzione.
Qualità, sicurezza e costi di revisione
Un prezzo del token più basso non implica automaticamente un costo totale inferiore, e un modello più costoso non garantisce automaticamente un risultato aziendale migliore. Il costo totale include i tentativi di ripetizione, la revisione umana, la gestione degli incidenti e il lavoro necessario per riparare i dati a valle. La metrica utile è il costo per risultato accettato, suddiviso per famiglia di attività. Un percorso leggermente più costoso per ogni richiesta può comunque rivelarsi vincente se riduce il lavoro di riparazione su attività ad alto impatto; un percorso molto economico può invece rivelarsi decisamente vincente per l’estrazione deterministica con una solida convalida.
Il rischio dovrebbe essere classificato in base all’azione, non al marchio del modello. Leggere un documento pubblico e redigerne una sintesi è diverso dal modificare la scheda di un cliente, approvare un pagamento, cancellare dati o pubblicare una dichiarazione legale. Le azioni irreversibili devono essere sottoposte a un controllo umano o a una seconda fase di convalida indipendente. Chiedete al modello di identificare le incertezze, ma non considerate mai una frase che suona come un'affermazione certa come un sistema di autorizzazione.
Le questioni relative alla privacy e alla conservazione dei dati devono essere trattate nell’ambito della revisione dell’implementazione. Verificare quali dati vengono inviati, per quanto tempo vengono conservati i log, chi può esaminare i prompt e se la richiesta contiene informazioni riservate o dati personali. Ove possibile, oscurare le informazioni sensibili, ridurre al minimo il contesto e tenere un registro chiaro dei campi che sono stati rimossi. Queste misure di controllo si applicano sia che il modello venga utilizzato tramite un’API ufficiale sia che venga utilizzato tramite un altro canale compatibile.
Come confrontare GPT-6 Sol con GPT-6 Luna
Un confronto equo mantiene costanti il compito e la regola di accettazione, consentendo al contempo a ciascun modello di sfruttare i propri punti di forza documentati. Eseguite lo stesso pacchetto di input, ma registrate se un modello richiede un’impostazione di ragionamento diversa o un endpoint diverso. Segnalare le differenze in modo chiaro: uno potrebbe produrre una patch più completa, un altro potrebbe risultare più economico per estrazioni ripetute e un terzo potrebbe essere più facile da integrare perché il suo contratto dello strumento è compatibile con il vostro adattatore attuale.
Non trasformare un singolo compito portato a termine con successo in una classifica generale. Tre piccoli compiti servono a individuare eventuali problemi nel flusso di lavoro, non a individuare un vincitore assoluto. Ripetete l’attività con diversi input realistici, includete almeno un caso avversario o incompleto e stabilite in anticipo quali siano i criteri di superamento. Se il campione è troppo piccolo per supportare una conclusione, ditelo chiaramente. Questo limite rafforza la fiducia anziché indebolire la valutazione.
Un’introduzione graduale che consenta di tornare indietro sulla decisione
Inizia con il traffico "ombra" o con una coda non critica. Lascia che il nuovo percorso generi un risultato, mentre quello esistente rimane il punto di riferimento. Confronta il tasso di accettazione, il costo dei token, i tempi di revisione e le categorie di errore per un periodo prestabilito. Successivamente, trasferisci una famiglia di attività alla volta, mantenendo un interruttore di rollback e un tag di versione immediato. Un'implementazione graduale trasforma la scelta del modello in una modifica ingegneristica osservabile anziché in una sostituzione da effettuare in un solo giorno.
Durante la fase di implementazione, prestate attenzione ai cambiamenti che non emergono da un semplice tasso di successo: output più lunghi, un maggior numero di richiami agli strumenti, un aumento degli escalation o un numero maggiore di richieste che superano la soglia del contesto lungo. Un modello può sembrare accurato pur consumando più risorse o aumentando il carico di lavoro degli operatori. Impostate degli avvisi per questi aspetti e esaminateli insieme alle persone che gestiscono effettivamente le eccezioni.
Come si presenta il successo
Il successo è un percorso stabile con un costo noto, una modalità di fallimento visibile e un processo di revisione che le persone possono seguire. Non richiede di fingere che il modello sia perfetto. Richiede invece di sapere quali attività gestisce bene, quali necessitano di un percorso alternativo e come interromperlo o correggerlo quando gli input sono incompleti. Questo è lo standard pratico alla base delle osservazioni e della documentazione raccolte in questa revisione.
Cosa possono e cosa non possono rivelarti le reazioni del pubblico
Le fonti riportate di seguito sono incluse a titolo di reazione del pubblico, non come documentazione ufficiale né come prove di riferimento verificate. I loro titoli indicano ciò che ciascun autore ha scelto di testare o spiegare; non costituiscono un risultato rappresentativo dell’intero mercato.
- Nate Herk | Automazione tramite IA: Ho messo a confronto Opus 5.5 e GPT-6 Sol in 10 casi d'uso reali. Considera l'inquadramento e qualsiasi dimostrazione come l'esperienza di quel creatore, non come una regola universale.
- Arena AI: GPT-6 Sol | Prime impressioni. Considera l'inquadramento e qualsiasi dimostrazione come l'esperienza di quel creatore, non come una regola universale.
- Chase AI: Sono arrivati GPT 6 Sol e Luna (e il 50% costa MENO!). Considera l'inquadramento e qualsiasi dimostrazione come l'esperienza di quel creatore, non come una regola universale.
A questo proposito va sottolineata un’altra questione relativa alla denominazione: diversi video pubblici utilizzano i termini “GPT-6” e “GPT-5.6” in modo intercambiabile nei titoli. Quando si riporta un’affermazione, è importante indicare l’ID esatto del modello. Il Confronto tra GPT-6 Astra e GPT-5.6 Sol è un esempio calzante del motivo per cui l'identità del provider, l'etichetta della piattaforma e il percorso dovrebbero essere registrati separatamente.
Come accedere a GPT-6 Sol
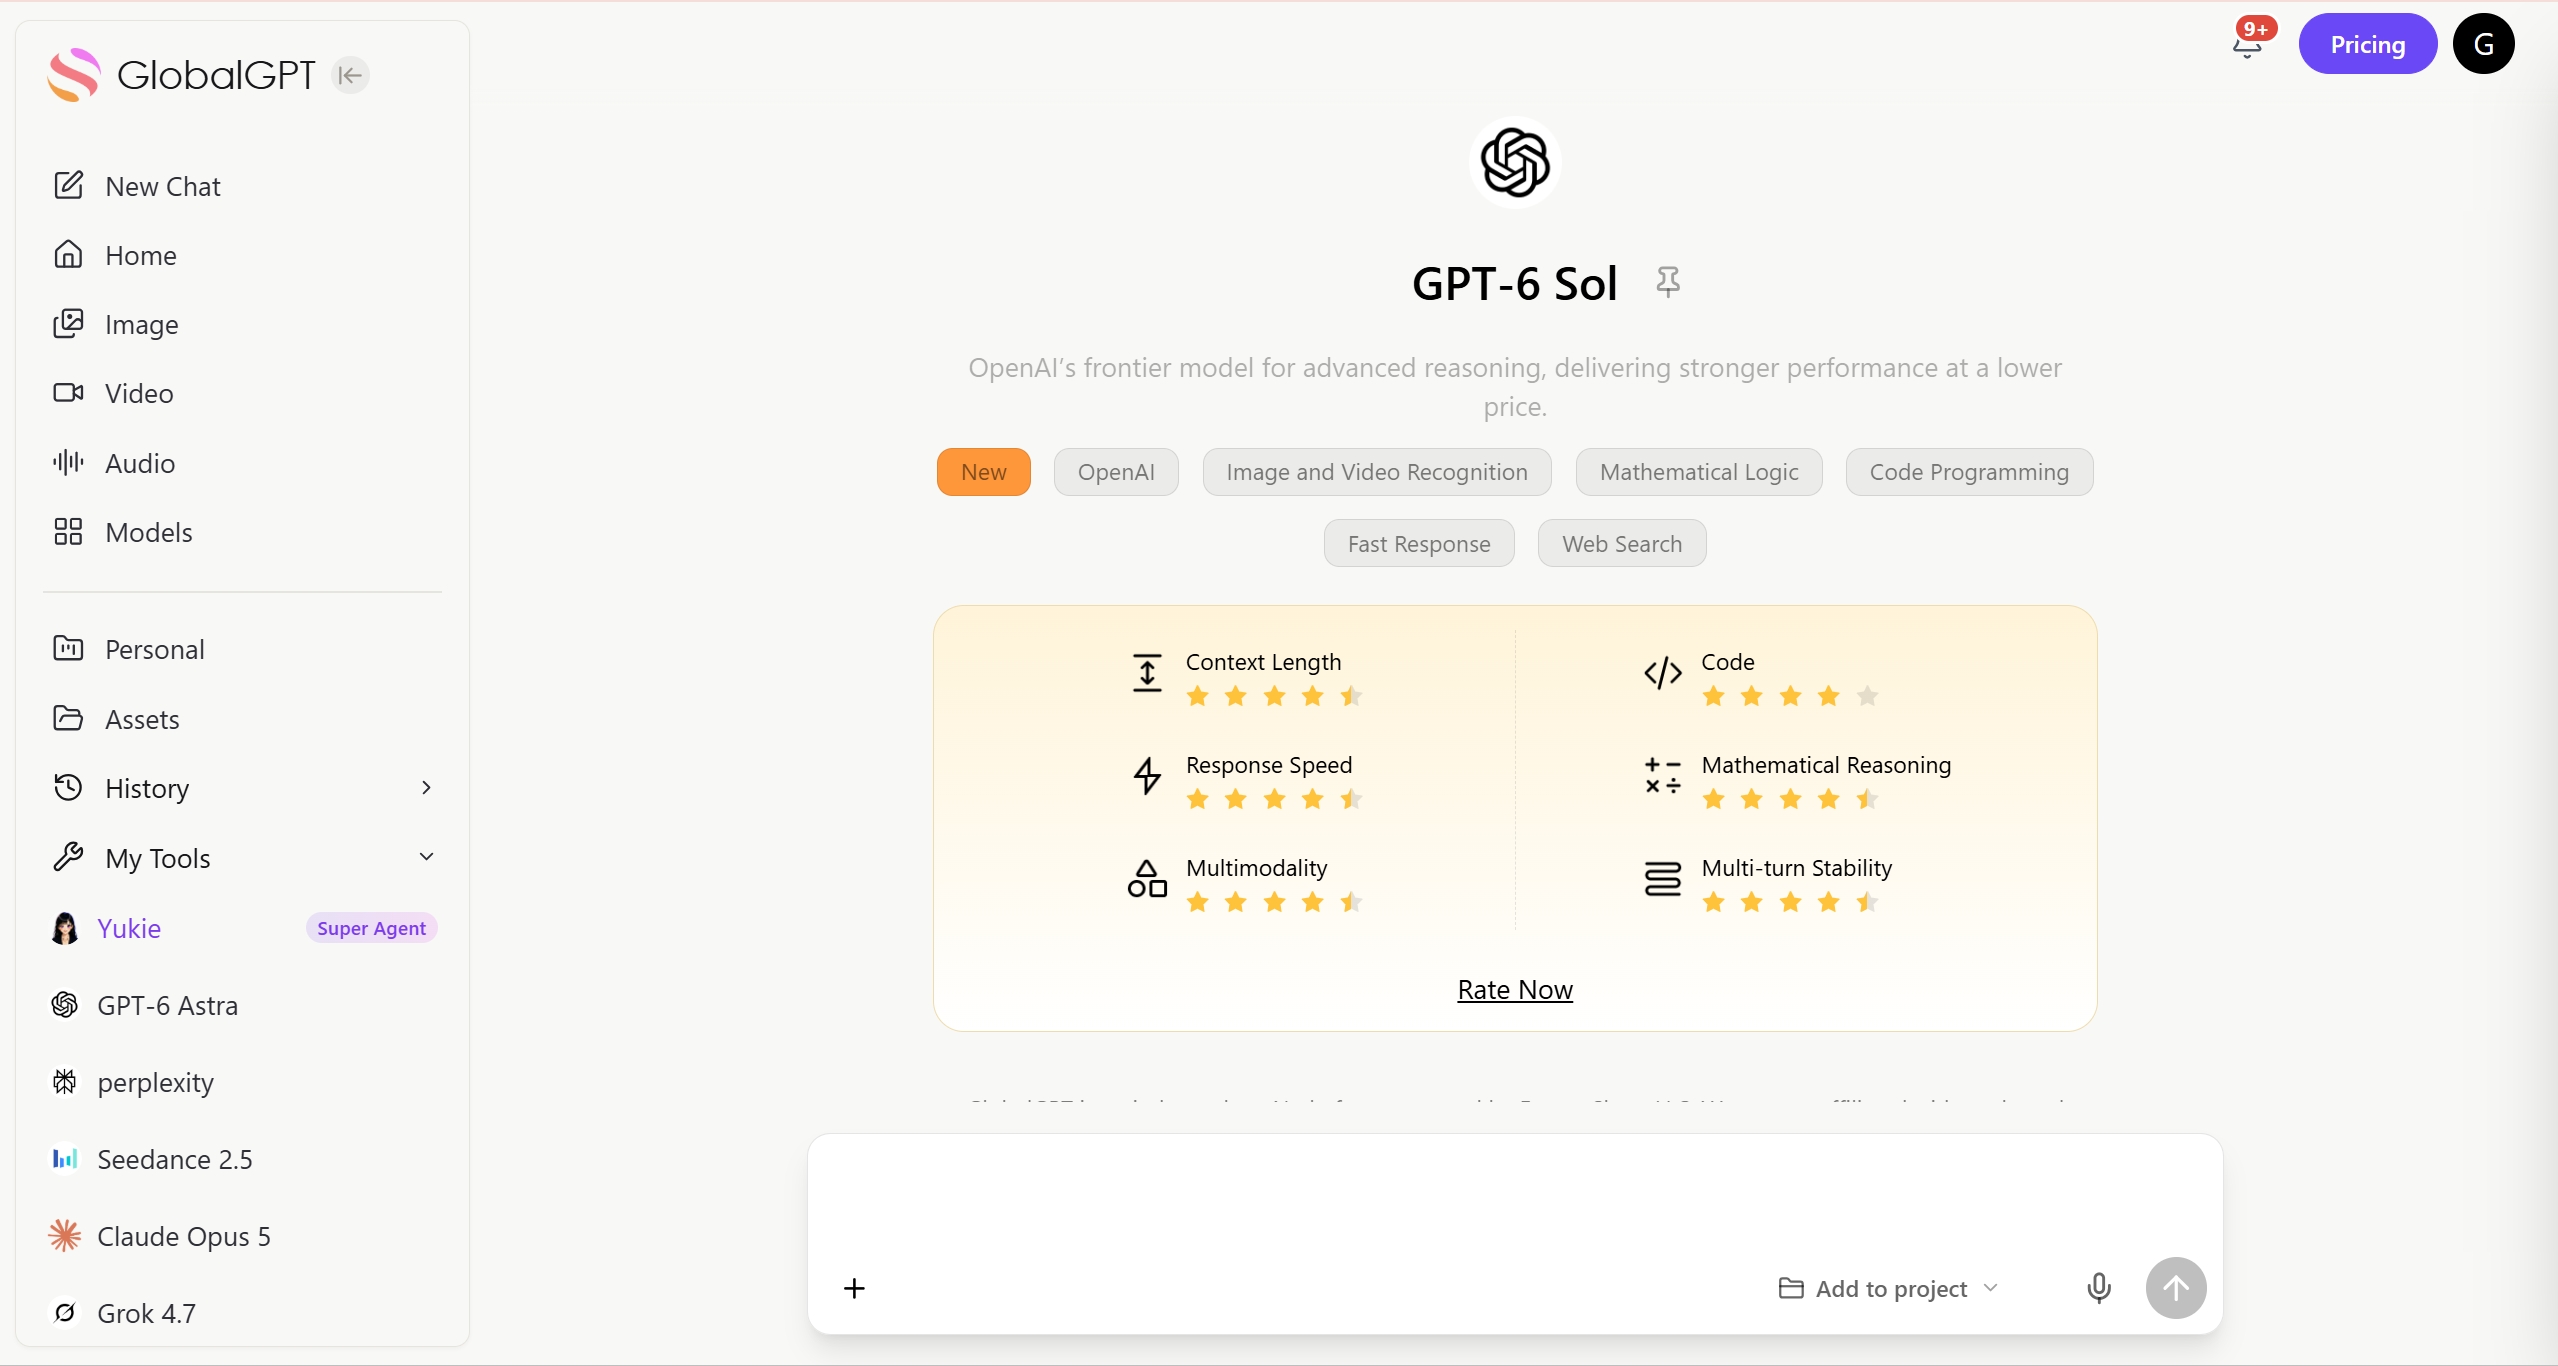
Aprire la sezione Area di lavoro di GPT-6 Sol Inizia con un’attività che puoi valutare: un piccolo esempio di codice, un breve pacchetto di sorgenti o una scheda di estrazione strutturata. Tieni ben visibili il risultato richiesto e i criteri di accettazione mentre confronti le revisioni. I prezzi ufficiali dei token sopra indicati si riferiscono all’utilizzo diretto dell’API e non costituiscono una promessa relativa ai crediti dell’area di lavoro o alle quote di abbonamento.
Per informazioni sull'attuale denominazione delle piattaforme e sul contesto dei crediti separati, consultare il Guida ai prezzi GPT-5.6 e il Confronto tra i modelli GPT-5.6. Quelle pagine rappresentano il contesto della piattaforma e dell’editore; non prevalgono sulla tabella dei prezzi dell’API di OpenAI.
Scegli un'attività rappresentativa e confronta il risultato con i tuoi criteri di accettazione.
Apri l'area di lavoro di GPT-6 SolA chi è consigliato GPT-6 Sol?
Se nella tua lista ristretta figurano alternative più economiche, confronta le catalogo di modelli più ampio anziché dare per scontato che il modello più recente sia automaticamente quello con il miglior rapporto qualità-prezzo. Se state valutando attività che richiedono un'elevata elaborazione dei dati, il Guida ai modelli di analisi dei dati offre una prospettiva separata sul flusso di lavoro.
Domande frequenti
Che cos’è GPT-6 Sol?
GPT-6 Sol è il modello di OpenAI dedicato alla codifica complessa e ai flussi di lavoro agenti. Il suo ID ufficiale del modello API è gpt-6-sol.
Quanto costa GPT-6 Sol?
OpenAI indica per GPT-6 Sol un costo di $2,00 per 1 milione di token in ingresso, $0,20 per 1 milione di token in ingresso memorizzati nella cache, $2,50 per 1 milione di scritture in cache e $10,00 per 1 milione di token in uscita alle tariffe Standard.
Cosa succede quando si superano i 272.000 token in ingresso?
Quando una richiesta supera i 272K token in ingresso, OpenAI applica alla richiesta completa una velocità di ingresso e di cache doppia e una velocità di uscita pari a 1,5 volte quella normale.
Quali sono i limiti relativi al contesto e all'output?
GPT-6 Sol presenta una finestra di contesto di 1.050.000 token, un input massimo di 922.000 token e un output massimo di 128.000 token.
Qual è il limite minimo di conoscenza richiesto?
La pagina attuale del modello OpenAI indica il 20 aprile 2026 come data di riferimento per le conoscenze di GPT-6 Sol.
Quali impostazioni di ragionamento sono disponibili?
L'API documenta i livelli di sforzo di ragionamento "none", "low", "medium", "high", "xhigh" e "max", con "medium" come impostazione predefinita.
Quali endpoint API sono supportati?
GPT-6 Sol supporta le funzioni "Chat Completions", "Responses" e "Batch". La pagina del modello non indica tra le funzionalità supportate: Realtime, Assistants, audio, video, generazione di immagini, embedding, fine-tuning, moderazione né le funzioni "Completions" legacy.
GPT-6 Sol è in grado di elaborare immagini?
Sì. La pagina del modello elenca input di testo e immagini con output di testo. Ciò non lo rende un modello di generazione di immagini.
GPT-6 Sol è disponibile in GlobalGPT?
Utilizza la pagina dedicata al modello GPT-6 Sol, il cui link è riportato sopra. I crediti dell'area di lavoro e le quote previste dai piani sono distinti dalle tariffe dirette relative ai token API descritte in questa recensione.
Questo articolo contiene un benchmark?
Si tratta di tre piccole osservazioni su attività specifiche, non di un benchmark controllato. Al secondo tentativo, Luna ha avuto bisogno di una nuova istruzione di programmazione. Questi risultati non indicano un vincitore assoluto né le prestazioni su larga scala.
Il verdetto finale
Sol è il modello da prendere in considerazione quando il lavoro è realmente complesso, richiede un uso intensivo di strumenti o è incentrato sul codice e si è disposti ad accettare un costo in token più elevato. I dati qui riportati combinano la documentazione ufficiale con il nostro piccolo campione di attività, non un benchmark controllato; pertanto, il verdetto più responsabile è quello di ritenere il modello idoneo, non di fornirgli una classificazione universale. Scegliete in base ai risultati accettabili e al costo operativo totale, quindi rivalutate la scelta quando il vostro carico di lavoro cambia.
Verificato il 23 settembre 2026. Dati ufficiali: OpenAI Developers. Denominazione del percorso sulla piattaforma: GlobalGPT. Reazione del pubblico: creatori e testate citati solo tramite link.









