Muse Spark 1.2 menggabungkan harga token yang sangat rendah dengan jendela konteks sebesar 1 juta token, dan berhasil menyelesaikan ketiga tugas pemrograman model dasar dalam rangkaian uji API percobaan pertama kami. Meta meluncurkan model tersebut pada 5 Agustus 2026, dengan jendela konteks sebesar 1 juta token, dua tingkatan harga API, dan agen terminal terpisah bernama Muse Code. Hasil uji kinerja Meta cukup menjanjikan; papan peringkat pemrograman publik independen belum memverifikasi kombinasi model dan agen yang sama.
Ulasan ini membedakan antara model dan agen, skor resmi dan bukti independen, serta penetapan harga standar dan pertukaran antara penggunaan data pada tingkatan Contributor. Dalam pengujian kami, model ini berhasil menyelesaikan perbaikan idempotensi Python, refaktorisasi TypeScript yang mempertahankan kompatibilitas, dan fitur JSONL di seluruh repositori tanpa perlu pengulangan. Eksekusi agen Muse Code tidak diuji, dan keandalan panggilan alat juga tidak diuji. Jika Anda ingin membandingkan bidang yang lebih luas terlebih dahulu, panduan kami mengenai model AI terbaik untuk pengkodean memberikan gambaran konteks persaingan yang lebih luas.
Ulasan Muse Spark 1.2: Jawaban Singkat
Ringkasnya: Muse Spark 1.2 adalah model Meta yang berfokus pada pemrograman, dilengkapi dengan jendela 1 juta token, akses API yang kompatibel dengan SDK OpenAI, serta tingkatan Contributor yang menarik perhatian. Keunggulan utamanya yang dipublikasikan adalah nilai: input sebesar $0.10 dan output sebesar $0.20 per satu juta token pada model Contributor. Tingkat layanan tersebut dapat digunakan untuk meningkatkan produk Meta, sementara model standar yang lebih mahal tidak digunakan untuk tujuan tersebut.
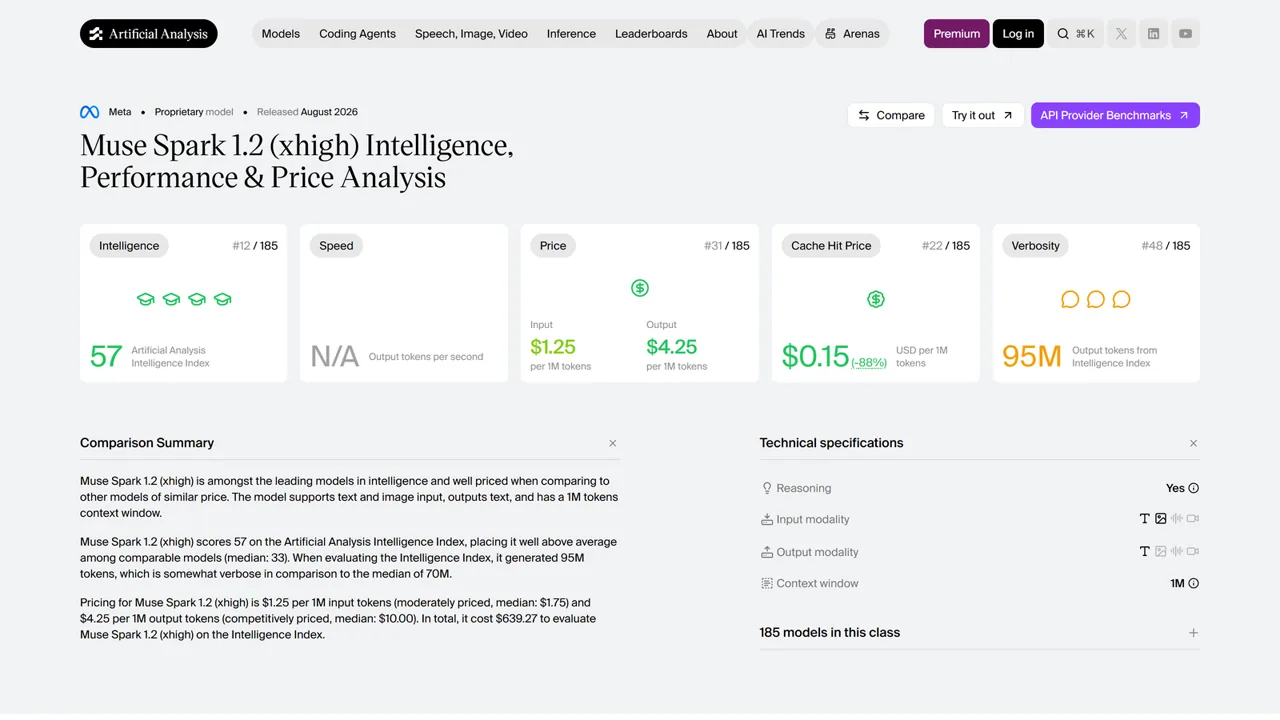
Data kinerja perlu ditinjau kembali. Meta melaporkan nilai 82,91 TP40T pada Terminal-Bench 2.1 untuk Muse Spark 1.2 dengan Muse Code dan 59,31 TP40T pada DeepSWE. Hasil-hasil tersebut diperoleh dari pengujian yang dilakukan oleh Meta. Papan skor Terminal-Bench dan DeepSWE yang terbuka untuk umum masih belum mencantumkan Muse Spark 1.2 saat diperiksa pada tanggal 26 Agustus 2026. Analisis Buatan memberikan verifikasi independen: Indeks Kecerdasannya tetap berada di angka 57, di atas nilai median model sejenis sebesar 35.
- Alasan terbaik untuk mencobanya sekarang: Harga yang terjangkau bagi kontributor, konteks yang luas, dan API yang mengikuti pola klien OpenAI yang sudah dikenal.
- Alasan terbaik untuk tetap waspada: Tiga tugas berbasis model terkontrol tersebut tidak membuktikan keandalan agen Muse Code, kualitas panggilan alat, maupun kinerjanya di repositori produksi berskala besar.
- Pilihan privasi yang penting: Gunakan model standar untuk kode atau prompt yang tidak ingin Anda gunakan untuk meningkatkan produk Meta.
Sekilas tentang Muse Spark 1.2
Spesifikasi yang telah diverifikasi
Meta menggambarkan Muse Spark 1.2 sebagai model yang memiliki akurasi penulisan kode pada upaya pertama yang lebih tinggi serta pemanggilan alat yang lebih andal dibandingkan Muse Spark 1.1. Hal tersebut merupakan klaim dari penyedia yang berasal dari halaman resmi model Muse Spark, bukan kesimpulan dari sesi pemrograman kami sendiri.
Muse Spark 1.2 vs Muse Code
Muse Spark 1.2 adalah modelnya. Muse Code adalah agen terminal beta terpisah yang didukung oleh model tersebut. Perbedaan ini penting karena sebuah agen dapat menambahkan fitur perencanaan, pengaturan alat, navigasi repositori, isolasi worktree, pencatatan, dan perilaku percobaan ulang pada model dasarnya.
Pastikan setiap lapisan tetap terpisah
Muse Spark 1.2
Konteks, penalaran, perilaku API, penagihan token, hasil keluaran, dan keputusan pemanggilan alat.
ID ModelKonteks 1MHarga API
Kode Muse
Antarmuka Pengguna Terminal, subagen, pohon kerja Git, log peristiwa, alur lanjutan, keterampilan terintegrasi, dan orkestrasi.
Alur kerja agenHasil sistem meta-run
The halaman resmi Muse Code menyebut produk tersebut sebagai agen pengkodean beta. Hal itu membuat perbandingan dengan produk-produk seperti Claude Code dan Codex menjadi lebih bermanfaat daripada menganggap bahwa setiap perbedaan alur kerja yang diamati berasal semata-mata dari pemanggilan model dasar. Kami Perbandingan Kode Codex vs Claude menjelaskan mengapa agen di sekitarnya dapat memengaruhi pengalaman pengembang sama besarnya dengan model itu sendiri.
Uji Kinerja Muse Spark 1.2: Apa yang Sebenarnya Ditunjukkan oleh Skor-skor Tersebut
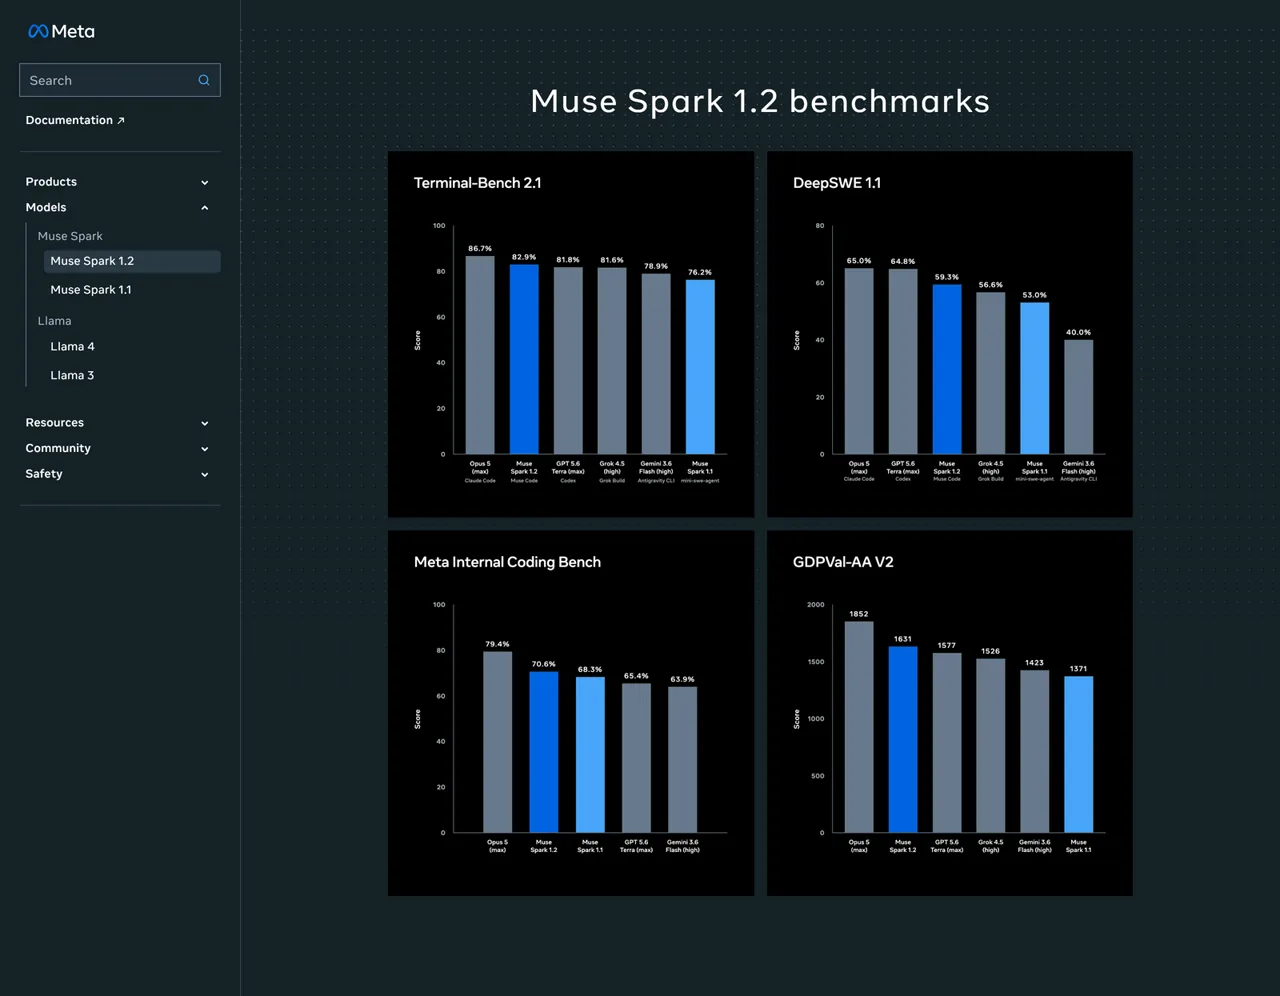
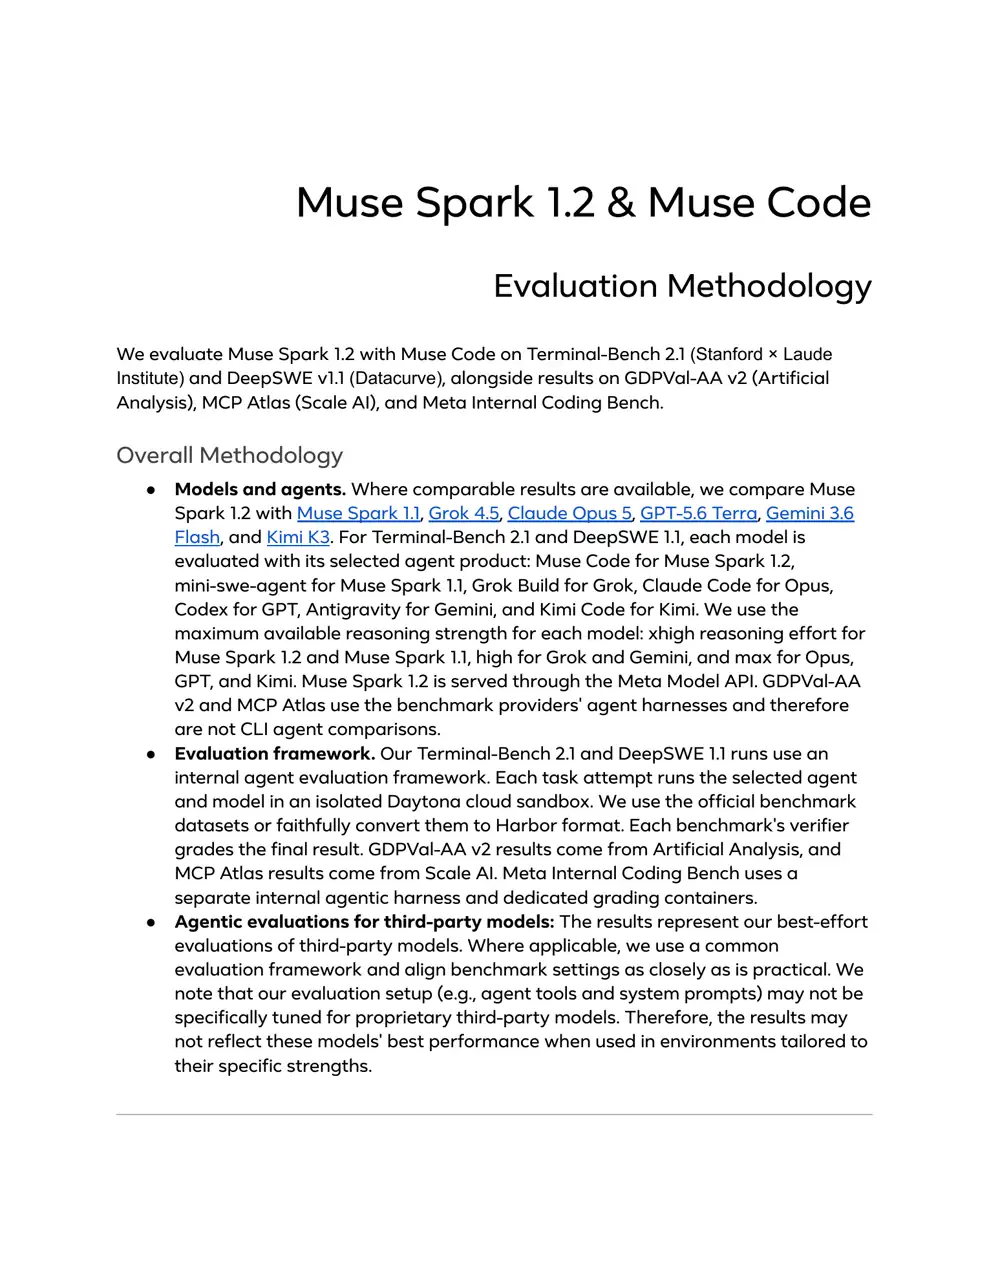
Grafik perbandingan Meta menempatkan Muse Spark 1.2 di peringkat teratas dalam beberapa evaluasi pemrograman. Angka-angka tersebut layak untuk ditelaah, namun tidak mencerminkan peringkat tunggal yang jelas mengenai kualitas model mentah. Model, agen, sistem pengujian, kemampuan penalaran, dan protokol tugas semuanya dapat berubah secara bersamaan.
Meta-reported Terminal-Bench 2.1
Panel tolok ukur Meta
Terminal-Bangku 2.1
Semua 89 tugas · lulus@1 dalam lima kali percobaan · kombinasi model dan agen yang dipilih
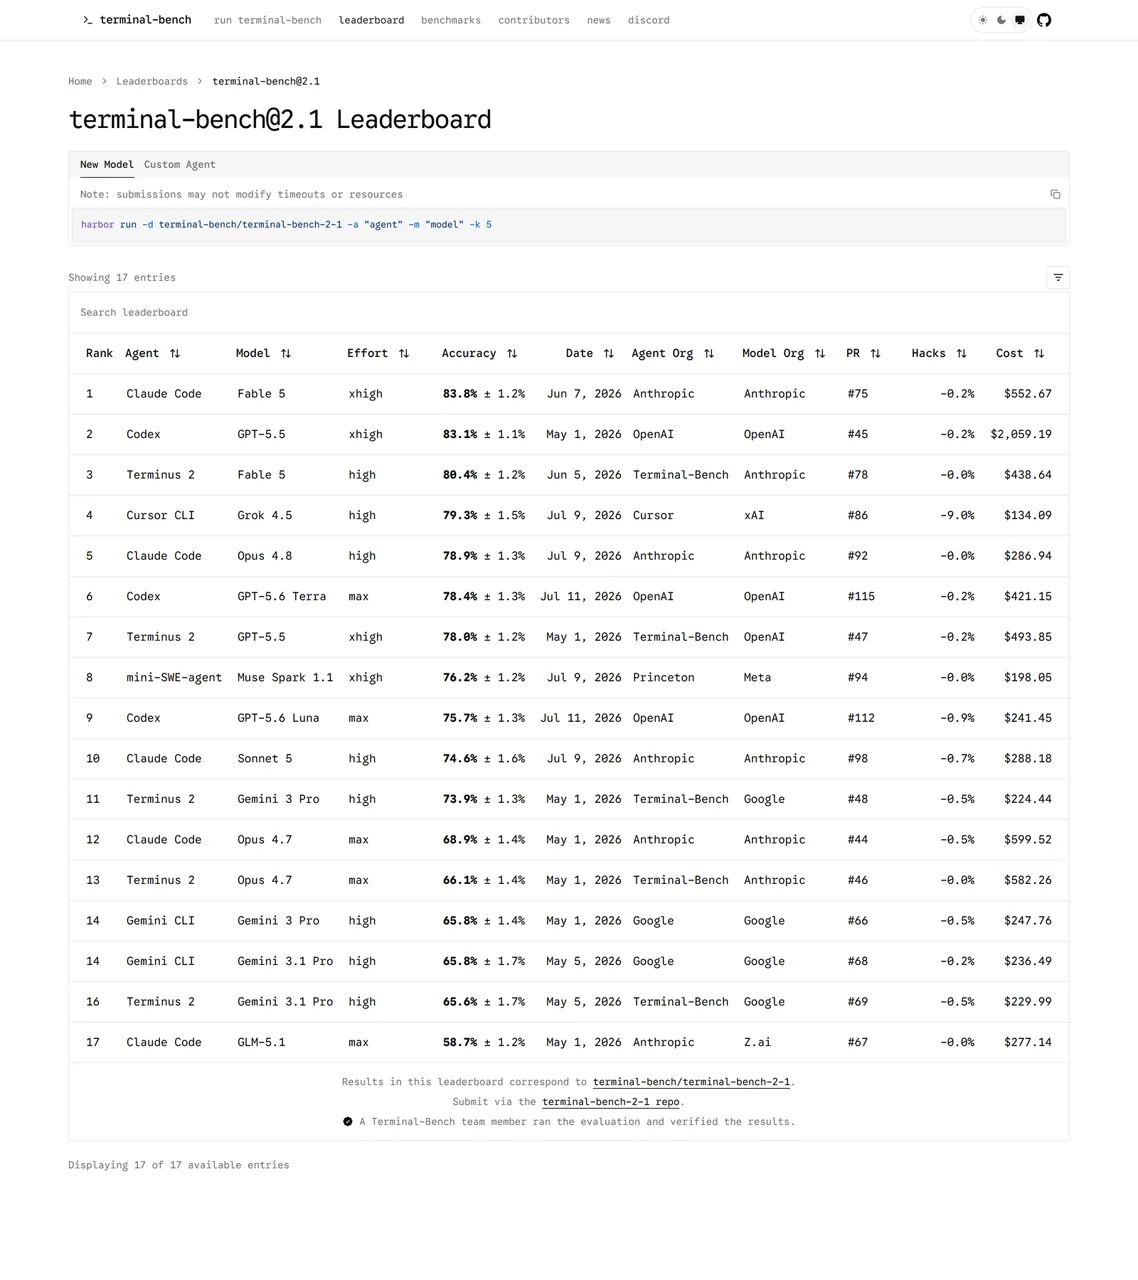
Angka 82,9% merupakan sebuah Hasil Meta-run Kode Muse. The Papan Peringkat Terminal-Bench 2.1 Umum tidak mencantumkan Muse Spark 1.2 pada tanggal 26 Agustus 2026, sehingga bukan entri papan peringkat publik yang terverifikasi. Papan informasi umum memang mencantumkan Muse Spark 1.1 dengan mini-SWE-agent pada nilai 76,2% ±1,2%.
Laporan Meta tentang DeepSWE 1.1
Panel tolok ukur Meta
DeepSWE 1.1
113 tugas · 91 repositori · lima bahasa · lulus@1 dari lima kali percobaan
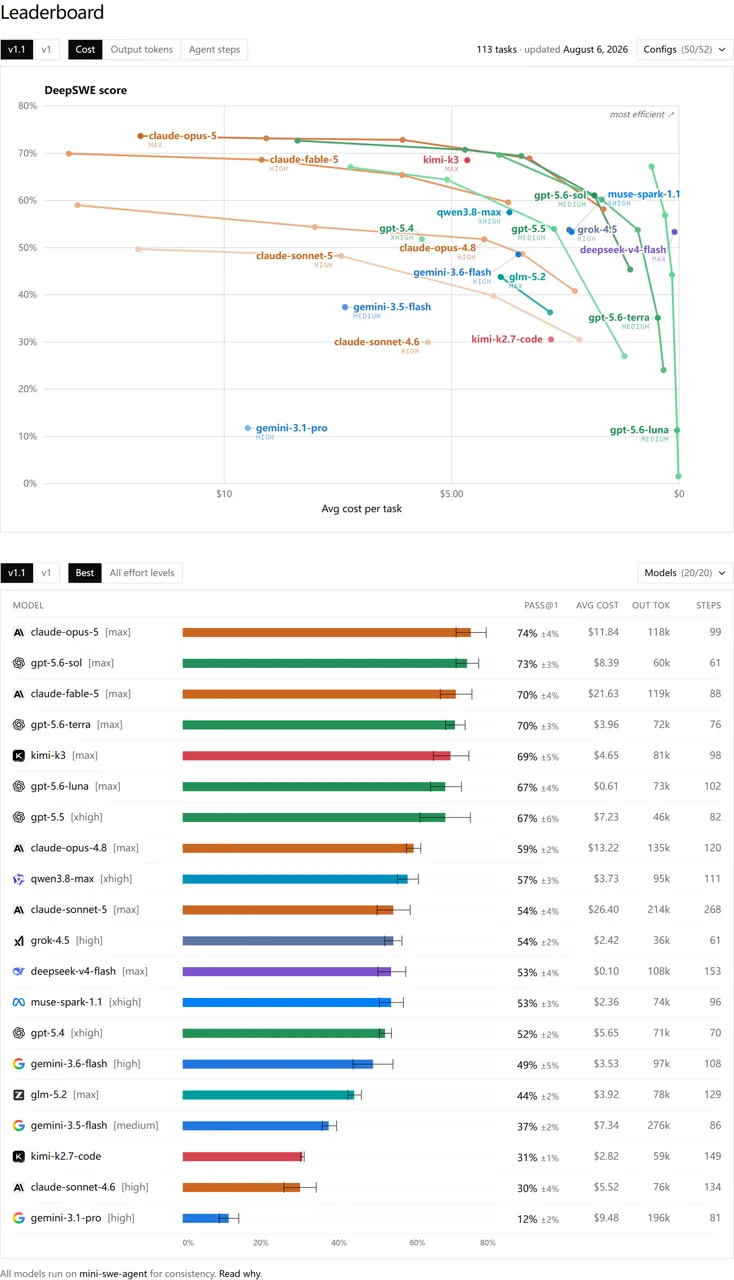
The Papan peringkat publik DeepSWE v1.1 Menggunakan mini-swe-agent pada seluruh model yang tercantum demi konsistensi. Saat diperiksa, Muse Spark 1.2 belum ditambahkan; Muse Spark 1.1 tercantum dengan nilai 53%. Hasil Meta sebesar 59,3% menggunakan Muse Code, sehingga kedua angka tersebut tidak berasal dari pengujian dengan pengaturan yang sama.
Evaluasi internal dan evaluasi agen umum Meta
Dua skala penilaian yang berbeda
Meta Internal Coding Bench
440 tugas internal · dua kali percobaan per tugas
| Model | Skor |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3,6 Flash | 63.9% |
| Grok 4,5 | Tidak ditampilkan |
GDPVal-AA v2
Evaluasi tugas agensial umum · Nilai bergaya Elo
| Model | Skor |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3,6 Flash | 1423 |
Meta’s metodologi evaluasi Terminal-Bench dilaporkan menggunakan seluruh 89 tugas dan mencapai pass@1 dalam lima kali percobaan. DeepSWE mencakup 113 tugas di 91 repositori dan lima bahasa pemrograman, serta juga mencapai pass@1 dalam lima kali percobaan. Meta juga mencatat bahwa pengaturannya mungkin belum disesuaikan secara optimal untuk model pihak ketiga. Untuk perbandingan pesaing terkini yang didasarkan pada keputusan produk nyata, lihat Claude Opus 5 vs GPT-5.6.
Metodologi mengubah makna
Model + agen yang dipilih
89 tugas, lima kali percobaan, pengaturan penalaran maksimum yang berbeda-beda, dan sistem pengujian Meta mungkin tidak disesuaikan secara merata untuk sistem pihak ketiga.
Entri yang telah diverifikasi
Muse Spark 1.2 tidak terdeteksi saat diperiksa. Konfigurasi papan dan status verifikasinya harus dibaca secara terpisah dari bagan Meta.
Agen mini-swe umum
113 tugas di 91 repositori dan lima bahasa pemrograman. Muse Spark 1.2 tidak tercantum; Muse Spark 1.1 tercatat dengan nilai 53%.
Analisis Buatan: konteks independen yang bermanfaat
The Halaman Model Analisis Buatan memberikan Muse Spark 1.2 Indeks Kecerdasan sebesar 57, di atas nilai median model sejenis sebesar 35 berdasarkan data per 26 Agustus 2026. Harness-nya melaporkan skor 80% pada Terminal-Bench v2.1, 57% (dinormalisasi) pada GDPVal-AA v2, 56% pada SciCode, dan 83% pada evaluasi konteks panjang AA-LCR.
Perubahan versi Analisis Buatan
Pelajaran praktisnya sederhana: Muse Spark 1.2 tampak kompetitif, tetapi tidak ada satu skor pun yang dapat dijadikan patokan tunggal untuk model ini. Anggaplah grafik dari Meta sebagai bukti keandalan sistem Muse Code, papan peringkat publik sebagai pengecekan silang terpisah, dan Artificial Analysis sebagai evaluasi independen namun dengan konfigurasi yang berbeda.
Pertimbangan antara Harga dan Privasi pada Muse Spark 1.2
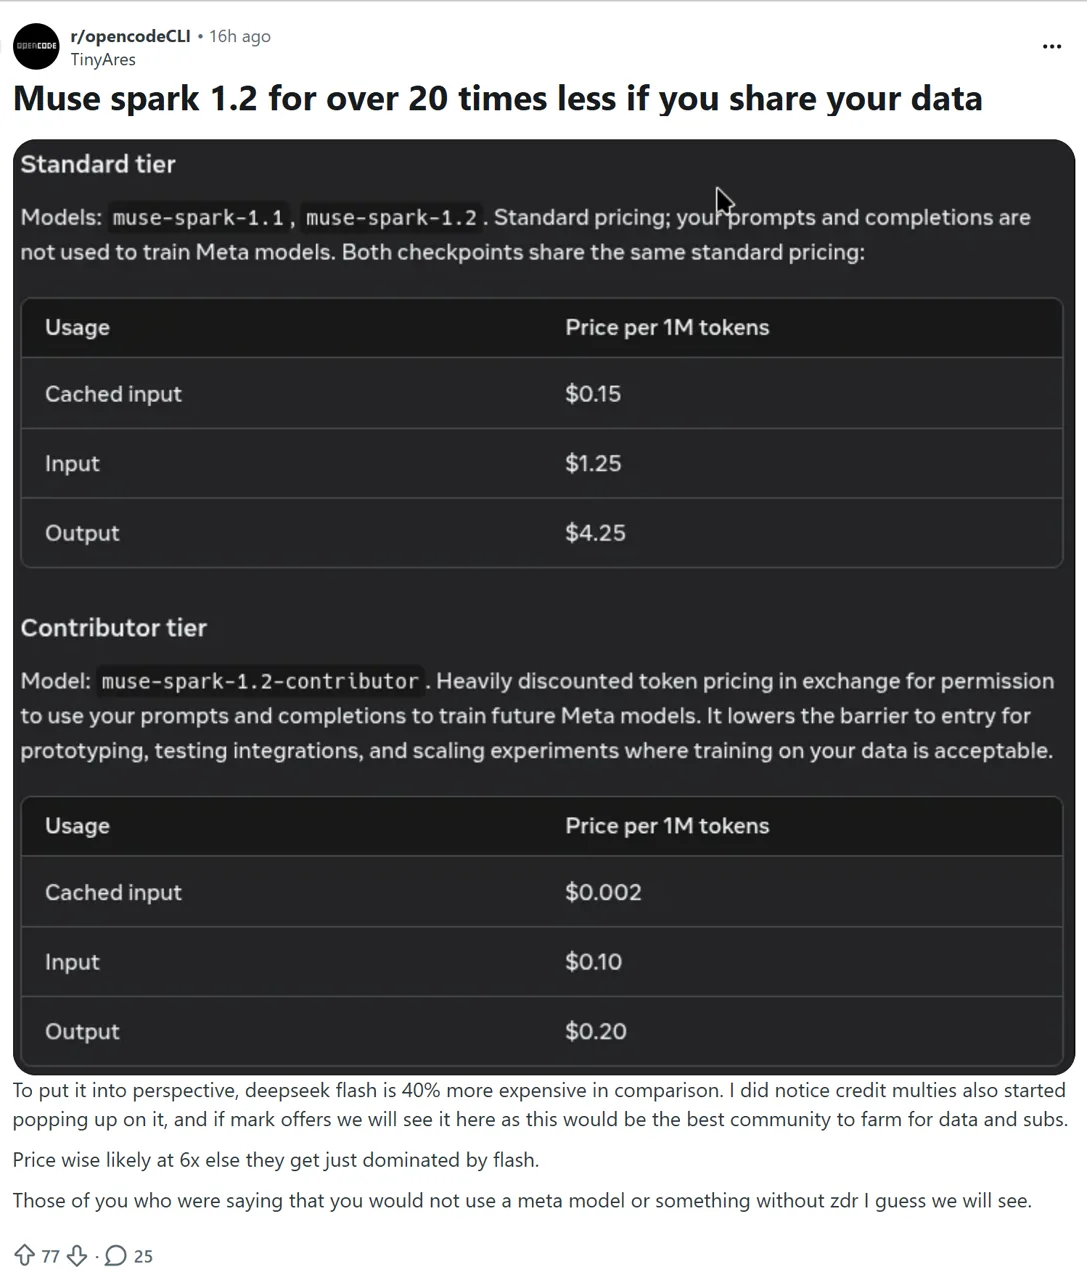
Meta menawarkan dua ID model API dengan harga yang sangat berbeda. Opsi yang lebih murah ini bukan sekadar diskon: hal ini mengubah cara penggunaan data yang dikirimkan.
USD per satu juta token · dalam konteks 1 juta
Tidak digunakan untuk peningkatan produk
Tidak digunakan untuk meningkatkan produk Meta
Lebih murah, namun dengan kompromi dalam hal penggunaan data
Data dapat digunakan untuk meningkatkan produk-produk Meta
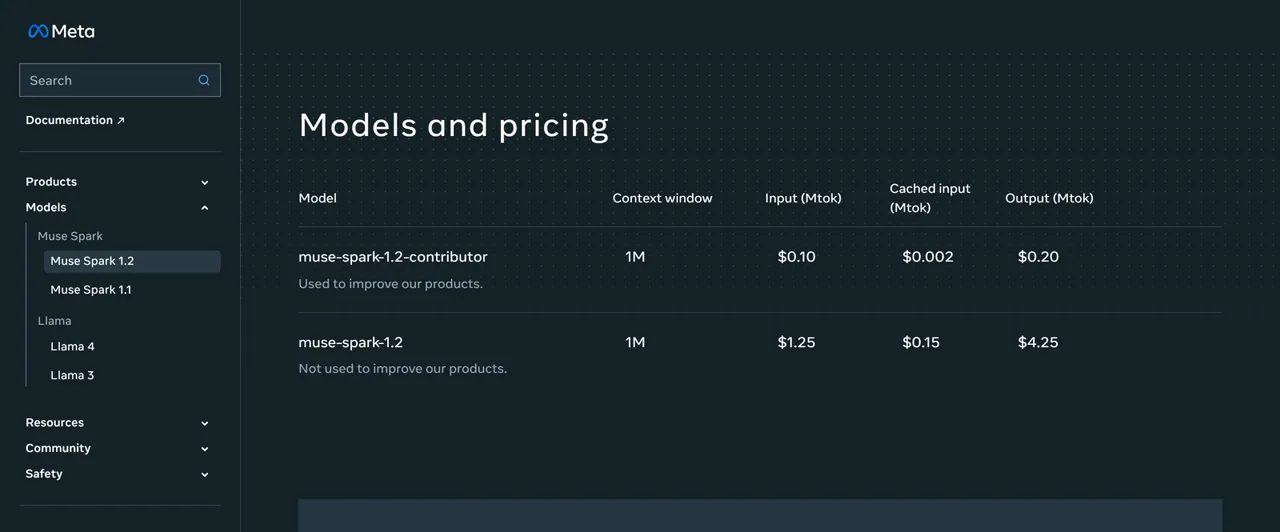
Harga untuk kontributor 12,5 kali lebih murah untuk input, 75 kali lebih murah untuk input yang disimpan dalam cache, dan 21,25 kali lebih murah untuk output dibandingkan dengan tingkatan standar. Tidak ada persentase diskon tunggal yang tepat yang dapat menggambarkan semua jenis token.
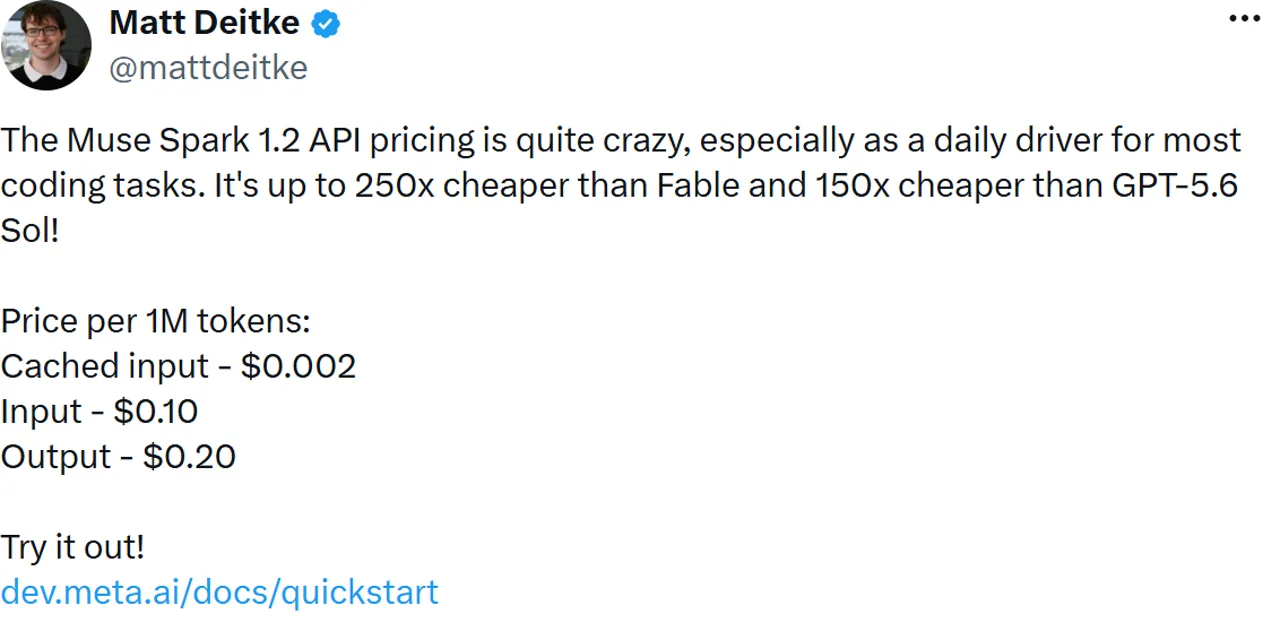
Seorang peneliti dari Meta mempromosikan tingkatan Contributor sebagai “hingga 250 kali lebih murah” daripada Fable dan “150 kali lebih murah” daripada GPT-5.6 Sol. Itu perbandingan sosial menggunakan harga Contributor, bukan model standar, dan harus selalu disertai dengan keterangan mengenai penggunaan data. Pembaca yang ingin membandingkan biaya pesaing saat ini dapat menggunakan halaman terpisah kami Panduan Harga GPT-5.6 dan Rincian harga Kode Claude.
Untuk repositori publik, tugas sintetis, atau perangkat evaluasi sekali pakai, tingkatan Contributor mungkin menjadi pilihan yang menarik. Untuk kode privat, data pelanggan, kredensial, atau arsitektur eksklusif, tingkatan standar merupakan pilihan default yang lebih aman. Meta juga menyatakan bahwa mereka mulai menerima permintaan tanpa penyimpanan data melalui tim penjualan, yang merupakan jalur akses terpisah daripada pengaturan layanan mandiri default.
Akses API dan Contoh Penggunaan Muse Spark 1.2
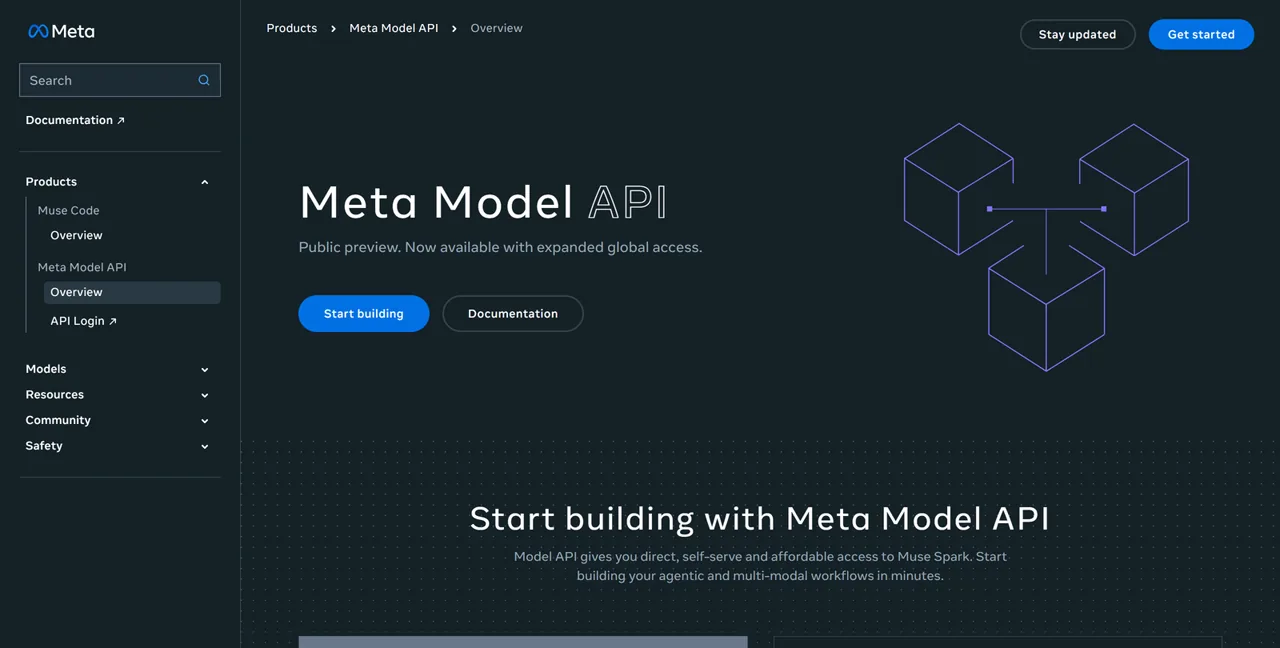
Tiga jalur akses resmi
URL dasar buku resep resmi: https://api.meta.ai/v1 · 1.2 permintaan dalam tinjauan ini: belum dilaksanakan
The API Meta Model mendukung alur kerja yang kompatibel dengan SDK OpenAI. Buku panduan resmi Meta menggunakan URL dasar https://api.meta.ai/v1 dan membaca kunci dari MODEL_API_KEY. Halaman produk tersebut juga menjelaskan tentang “search grounding”, sedangkan buku panduan ini mencakup pelengkapan obrolan, streaming, pemanggilan alat, keluaran terstruktur, penyimpanan sementara prompt, kontrol penalaran, pengenalan gambar, konteks panjang, upaya ulang, dan resep pencarian.
Contoh buku resep resmi — versi yang telah disimpan: The Buku Panduan Resmi GitHub masih menggunakan muse-spark-1.1. Hal ini membuktikan struktur klien dan URL dasar, bukan berarti contoh tersebut telah diperbarui untuk versi 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)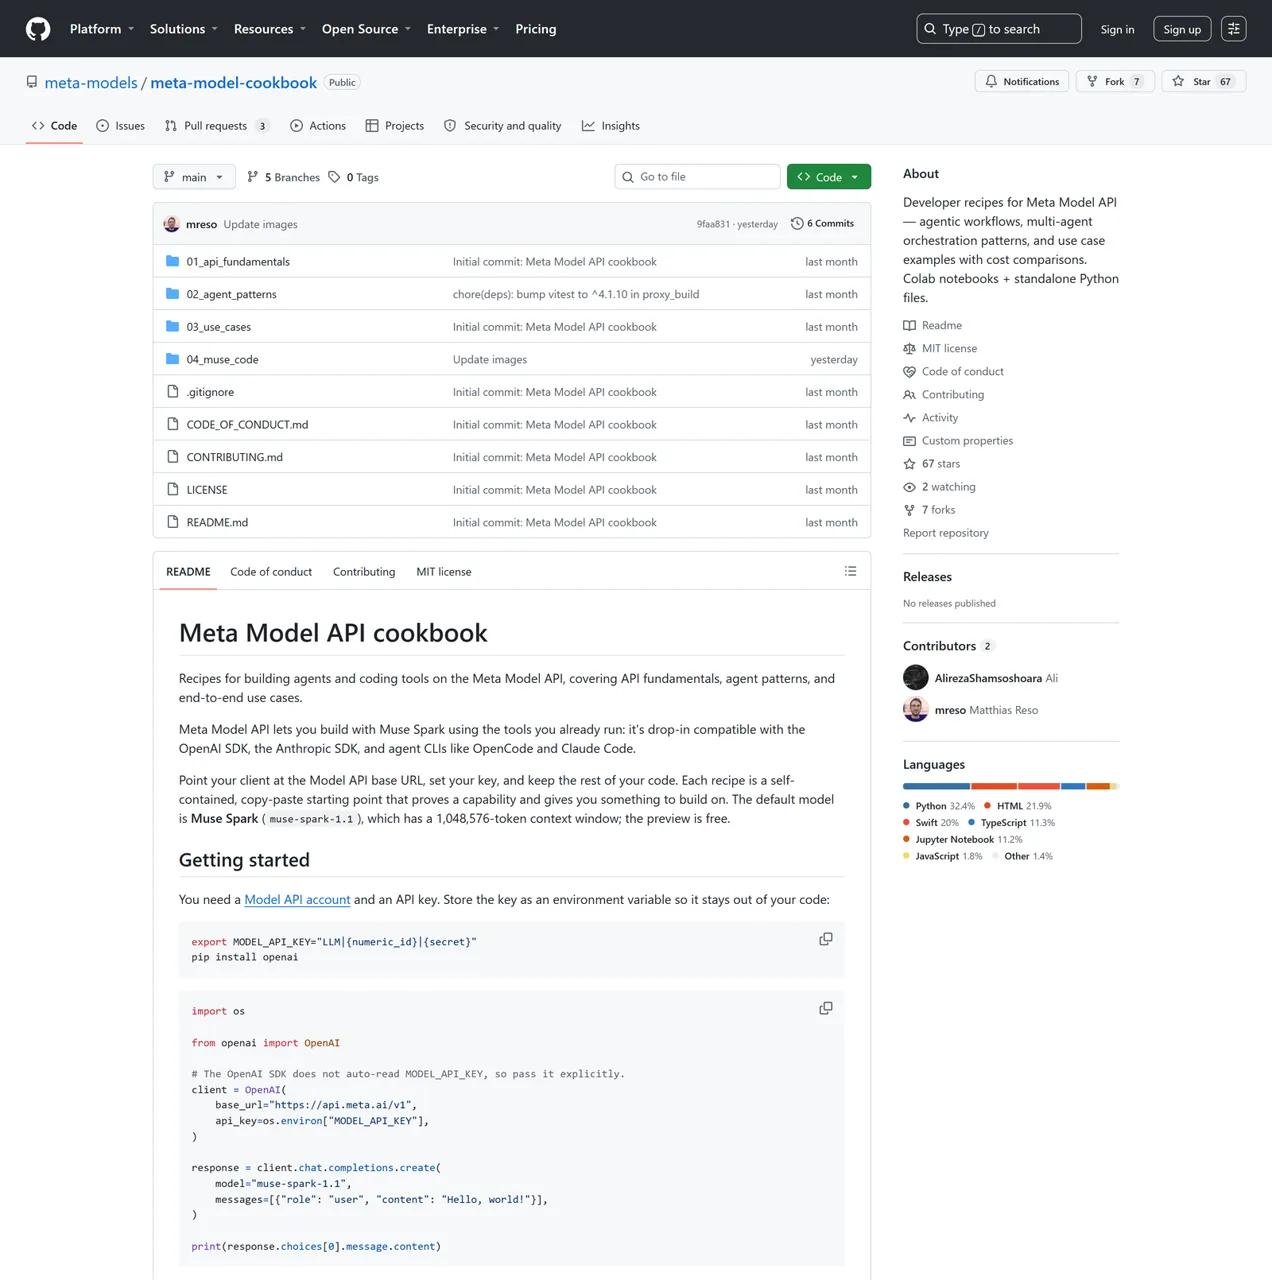
Adaptasi yang telah didokumentasikan — belum dilaksanakan: Meta mencantumkan secara terpisah muse-spark-1.2 sebagai model standar ID 1.2. Penggantian minimal di bawah ini menggabungkan dua fakta resmi, namun tidak ada permintaan berbayar yang dikirimkan selama proses peninjauan ini.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark adalah model penalaran, dan token penalaran diperhitungkan sebagai output. Hal itu membuat laju keluaran standar $4.25 lebih penting daripada yang terlihat pada pandangan pertama: jawaban yang tampaknya singkat tetap dapat mengandung penggunaan penalaran tersembunyi yang substansial. Latensi aktual, waktu hingga token pertama, laju percobaan ulang, dan biaya per tugas masih belum diukur di sini.
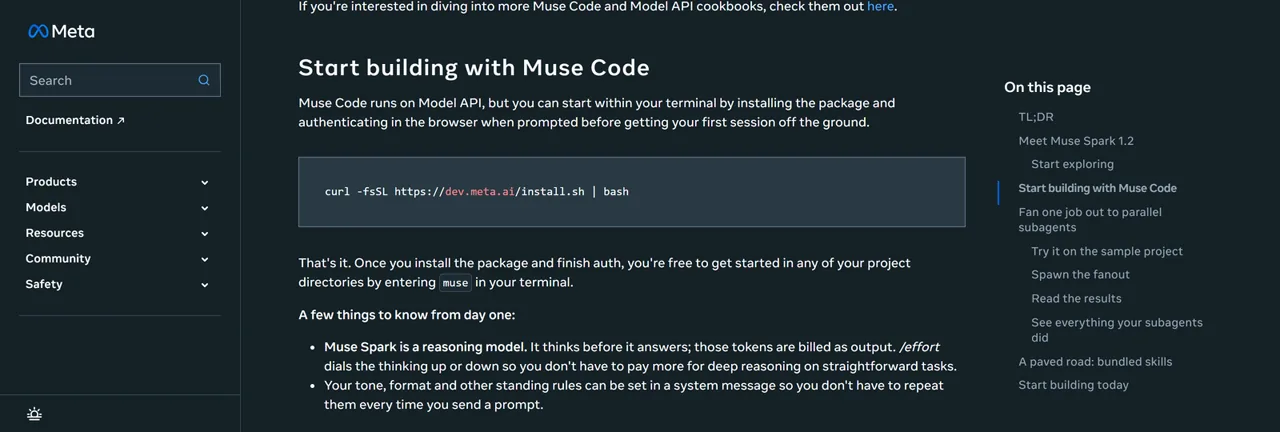
/usaha Perintah tersebut mengubah kedalaman penalaran. Sumber: Panduan Pengembang Meta.Apa yang Ditambahkan oleh Muse Code
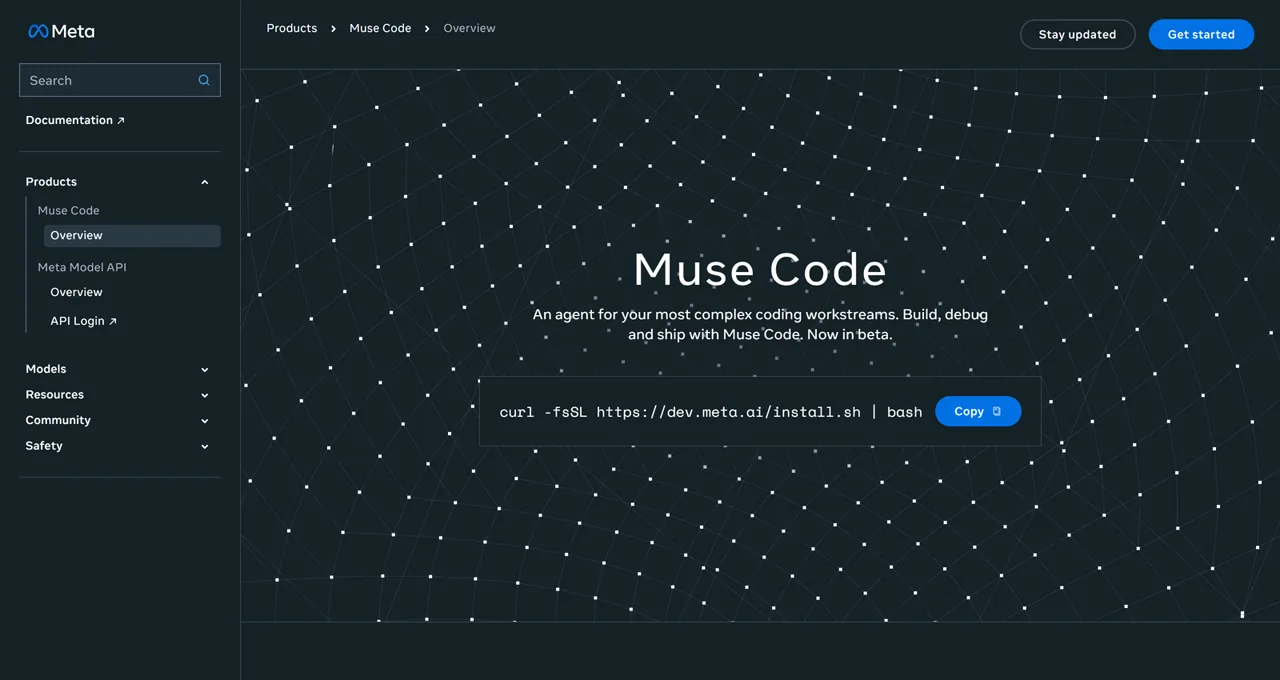
Muse Code diinstal melalui terminal dan mengintegrasikan Muse Spark 1.2 ke dalam alur kerja agen. Meta’s ulasan mendalam tentang pengembang menjelaskan beberapa perilaku yang tidak termasuk dalam panggilan API murni:
- Agen paralel: Tugas-tugas dapat dijalankan dalam struktur kerja Git yang terisolasi.
- Catatan peristiwa yang hanya dapat ditambahkan: Sesi dan tindakan disimpan dalam berkas JSONL lokal untuk keperluan audit dan pemutaran ulang.
- Lanjutkan alur:
riwayat hidup Musedapat melanjutkan sesi yang terputus. - Pengendalian penalaran: yang
/usahaPerintah ini mengatur tingkat kekuatan penalaran. - Keterampilan eksplisit: Nama Meta
/rasa,/memanggang,/panggang-dengan-dokumen, dan/rencana.
Fitur produk agen
Subagen
Tugas-tugas independen dapat menyebar ke berbagai arah.
Pohon Kerja
Cabang-cabang tetap terpisah selama proses kerja paralel.
Log JSONL
Peristiwa lokal yang hanya dapat ditambahkan mendukung pemutaran ulang.
Riwayat Hidup
riwayat hidup Muse melanjutkan sesi yang sempat terhenti.
Keterampilan
/rasa, /memanggang, /panggang-dengan-dokumen, /rencana.
Rangkaian fitur tersebut menjadikan Muse Code relevan bagi pasar agen pemrograman yang lebih luas, di mana perencanaan, isolasi, pemutaran ulang, dan disiplin penggunaan alat sama pentingnya dengan kecerdasan model. The Panduan Perbandingan OpenClaw vs Claude Code vs OpenCode merupakan konteks yang berguna untuk memahami perbedaan-perbedaan pada tingkat produk tersebut.
Klaim Peluncuran dan Tanda-Tanda Awal dari Komunitas
Reaksi bukanlah bentuk pengakuan
Pelatihan + jangka panjang
Kapasitas komputasi pemrograman yang lebih besar, keragaman lingkungan, pelatihan bersama, dan uji ketahanan dengan lebih dari 1.000 panggilan alat.
Harga dan OpenCode
Seorang pengguna Reddit memuji pengalaman dan manfaat belajar pemrograman sejak dini.
Privasi + keandalan
Pengguna lain mengemukakan kekhawatiran terkait penggunaan data, harga standar, ketersediaan, dan keandalan pada tahap awal.
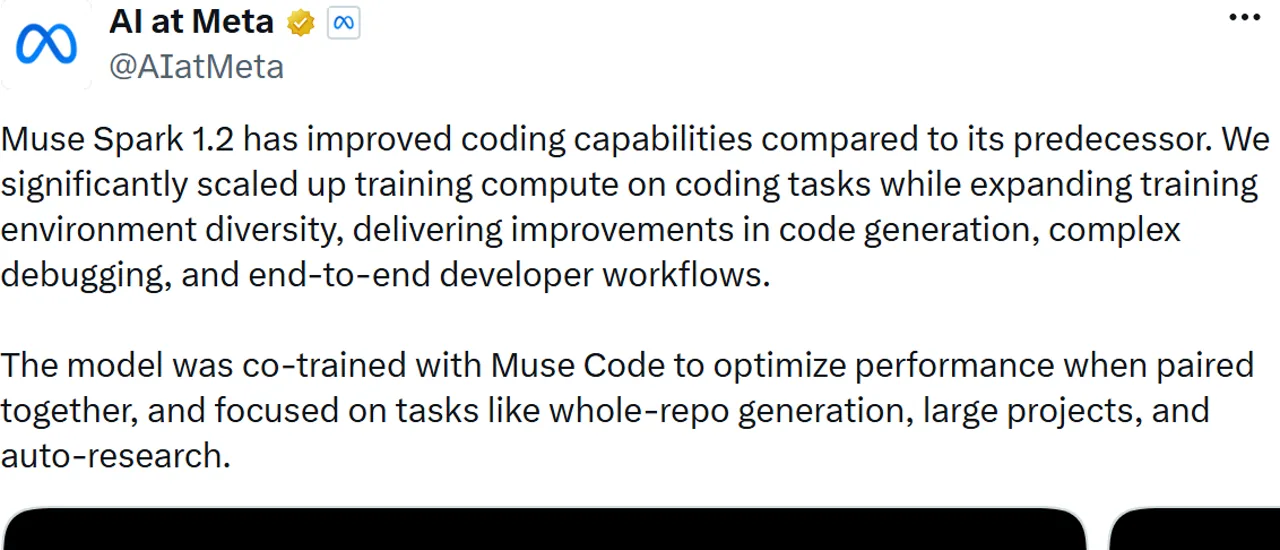
Tim AI di Meta menyatakan bahwa Muse Spark 1.2 telah mendapatkan alokasi daya komputasi yang lebih besar untuk pelatihan pemrograman, lingkungan pelatihan yang lebih beragam, penekanan yang lebih besar pada pembangkitan kode dan debugging pada seluruh repositori, serta pelatihan bersama dengan Muse Code. Sebuah laporan terpisah membuka utas menjelaskan uji ketahanan yang berlangsung hingga 24 jam dengan lebih dari 1.000 panggilan fungsi pada GPU NVIDIA Hopper.
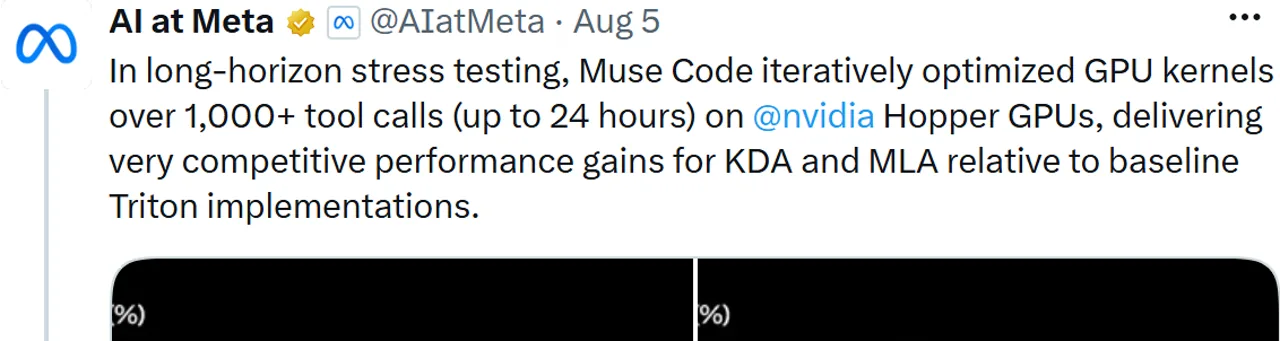
Itu memang demonstrasi yang mengesankan, tetapi bukan merupakan angka keberhasilan umum yang terukur. Hal itu tidak memberi tahu kita seberapa sering agen tersebut memilih alat yang tepat, memulihkan diri dari kesalahan, menghindari panggilan ganda, atau menyelesaikan tugas repositori biasa tanpa bimbingan.
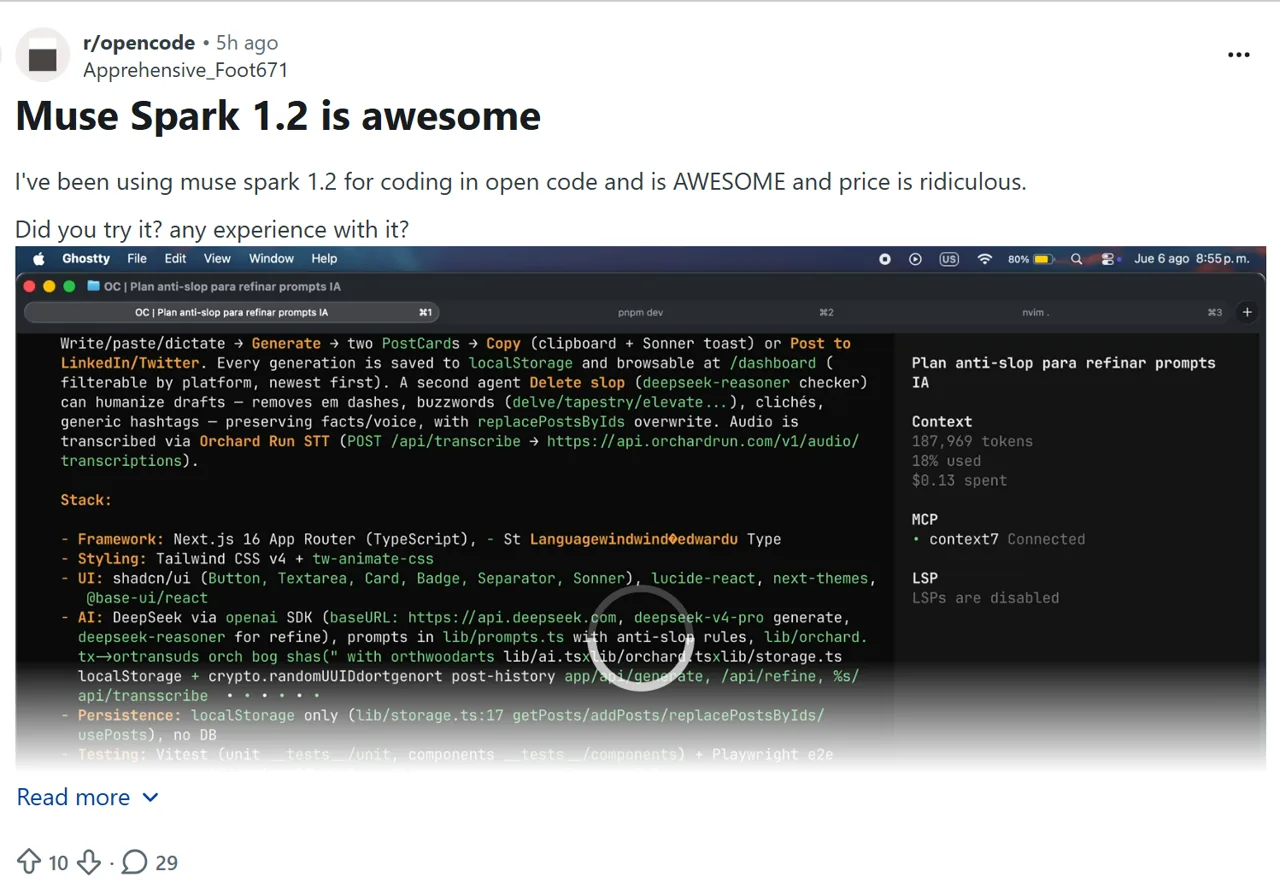
Postingan-postingan awal di Reddit juga menunjukkan tanggapan yang beragam. Salah satunya Seorang pengguna r/opencode melaporkan pengalaman positifnya dengan OpenCode dan memuji harganya. Sebuah artikel terpisah Diskusi mengenai penetapan harga oleh kontributor menimbulkan pertanyaan seputar peningkatan penggunaan data, biaya paket standar, ketersediaan, dan keandalan. Ini adalah tanggapan individu, bukan konsensus komunitas.
Uji Koding Muse Spark 1.2: 3 dari 3 Tugas Telah Dilewati
Dalam pengujian kami, model dasar Muse Spark 1.2 berhasil menyelesaikan tiga tugas pemrograman yang terkendali melalui API penyelesaian obrolan yang kompatibel dengan OpenAI. Setiap tugas diberi satu kali percobaan, tanpa kesempatan ulang dan tanpa campur tangan manusia. Kami mengevaluasi berkas yang dikembalikan di repositori sekali pakai berdasarkan kriteria penilaian yang terbuka dan tersembunyi. Eksekusi agen Muse Code tidak diuji, dan keandalan pemanggilan alat juga tidak diuji; oleh karena itu, hasil ini tidak boleh dianggap sebagai tolok ukur kinerja agen.
Hasil percobaan tunggal
Respons-respons tersebut menggunakan 6.618 token penalaran. Ketiga alasan akhir tersebut adalah berhenti, dan kolom penyedia mencantumkan Meta.
Uji Coba 1: Perbaikan bug idempotensi Python — Lulus
Hentikan transfer ganda tanpa mengubah API publik
Model tersebut mengidentifikasi adanya pengaman request-ID yang hilang, menerapkan perbaikan aman yang paling sederhana, dan menyediakan uji regresi sambil tetap mempertahankan pembaruan keseimbangan atomik.
Evaluator tersembunyi yang asli secara keliru mensyaratkan panggilan berulang untuk mengembalikan hasil Salah, meskipun tugas tersebut hanya mensyaratkan agar pengirim tidak dikenakan biaya dua kali. Setelah memperbaiki persyaratan nilai kembalian yang dibuat-buat itu, respons pertama yang tidak diubah berhasil lulus keenam tes tersebut. Kami tidak melakukan percobaan ulang atau mengedit hasil keluaran model.
Uji Coba 2: Refaktorisasi berkas ganda TypeScript — Lulus
Memisahkan validasi, penyimpanan data, dan pencatatan audit
Berkas-berkas yang dikembalikan tetap mempertahankan kontrak rute publik, penerapan TypeScript yang ketat, serta transaksi tunggal yang mencakup baik penulisan pesanan maupun penulisan audit. Selain itu, berkas-berkas tersebut juga menambahkan uji validasi yang terfokus tanpa ketergantungan pada runtime.
Penilai pertama membandingkan benda-benda dengan bahan mentah JSON.stringify, sehingga objek-objek yang setara namun memiliki urutan penyisipan kunci yang berbeda tampak tidak sama; versi Windows-nya npx Proses peluncuran juga gagal sebelum tahap pemeriksaan tipe. Dengan komparator yang tidak peka urutan dan pemanggilan perintah yang aman untuk Windows, respons asli berhasil melewati semua pemeriksaan. Sekali lagi, tidak ada upaya percobaan ulang.
Uji Coba 3: Fitur repositori JSONL — Lulus
Penerapan pedoman secara menyeluruh di seluruh repositori
Tambahkan JSONL tanpa merusak CSV
Model tersebut menerapkan fitur deteksi ekstensi, kesalahan baris yang tidak valid dengan penghitungan berbasis satu, keluaran atomik, uji coba tanpa eksekusi (dry-run), uji terfokus, teks bantuan, dan contoh berkas README.
Hasil tes menunjukkan: Muse Spark 1.2 mampu menghasilkan patch multi-file yang dapat digunakan, mematuhi batasan kompatibilitas, menambahkan uji coba, serta menangani fitur berskala sedang di seluruh repositori dalam satu kali proses. Biaya rata-rata yang dilaporkan sekitar $0.0151 per tugas, namun fixture-fixture ini berukuran kecil dan tidak sebaiknya digunakan untuk memperkirakan biaya pada basis kode yang besar.
Siapa yang Sebaiknya Menggunakan Muse Spark 1.2?
Panduan pengambilan keputusan
Evaluasi terkendali
Kode publik atau sintetis, tugas yang dapat diukur, kebutuhan dalam konteks yang luas, dan hasil model dasar 3/3 yang menjanjikan.
Diperlukan bukti agen
Perilaku Muse Code, batas laju yang stabil, pemanggilan alat yang berulang, atau pengujian kinerja repositori secara menyeluruh merupakan faktor penentu.
Kode sensitif atau hasil yang tinggi
Gunakan tingkatan standar atau bandingkan alternatif-alternatifnya jika masalah privasi dan biaya token penalaran menjadi faktor utama.
Gunakan model standar untuk kode sensitif, kecuali jika organisasi Anda telah menyetujui secara terpisah Ketentuan Kontributor. Jika harga keluaran standar mengubah perhitungan nilainya, bandingkan dengan harga saat ini Harga Codex, Kode Claude, dan biaya agen pengkodean lainnya sebelum memutuskan untuk menggunakan alur kerja tersebut.
Kesimpulan Ulasan Muse Spark 1.2
Muse Spark 1.2 berhasil masuk dalam daftar pendek evaluasi, namun hal ini bukan berarti produk tersebut secara otomatis direkomendasikan untuk diproduksi. Konteks 1M-token, format API yang sudah dikenal, harga yang terjangkau bagi Kontributor, tiga putaran pengujian kode pada percobaan pertama, serta skor Muse Code yang tinggi dari Meta-run membuatnya sulit untuk diabaikan. Meta juga telah melakukan pekerjaan yang lebih baik daripada banyak peluncuran lainnya dalam mempublikasikan rincian metodologi.
Keterbatasannya juga sama konkretnya. Struktur harga untuk kontributor disertai dengan pertukaran terkait penggunaan data. Token keluaran dan penalaran standar dapat meningkatkan biaya riil. Angka-angka pemrograman teratas Meta belum direproduksi sebagai entri yang sesuai di papan Terminal-Bench atau DeepSWE yang terbuka untuk umum, dan sampel praktik langsung kami mencakup tiga tugas model dasar, bukan eksekusi agen Muse Code.
Langkah yang bijaksana adalah melakukan uji coba terkendali pada kode yang tidak sensitif, dengan data penggunaan mentah dan hasil verifikasi lokal disimpan. Anggaplah biaya dan latensi yang terukur sebagai sampel dari tugas-tugas kecil, lalu uji ukuran repositori Anda sendiri, pemulihan kegagalan, dan alur kerja agen sebelum memutuskan untuk menggunakannya dalam lingkungan produksi.
Pertanyaan Umum (FAQ) Muse Spark 1.2
Apa itu Muse Spark 1.2?
Muse Spark 1.2 adalah model Meta yang berfokus pada pemrograman, diluncurkan pada 5 Agustus 2026, dengan jendela konteks sebesar 1 juta token dan dapat diakses melalui Muse Code, Meta Model API, serta OpenRouter.
Apakah Muse Spark 1.2 sama dengan Muse Code?
Tidak. Muse Spark 1.2 adalah modelnya; Muse Code adalah agen terminal beta terpisah yang didukung oleh model tersebut. Muse Code menambahkan fitur-fitur produk seperti subagen, pohon kerja Git yang terisolasi, pencatatan peristiwa, fitur melanjutkan, dan keterampilan terintegrasi.
Berapa biaya API Muse Spark 1.2?
Model standar membutuhkan biaya sebesar $1,25 untuk input, $0,15 untuk input yang disimpan dalam cache, dan $4,25 untuk output per juta token. Model Contributor membutuhkan biaya sebesar $0,10 untuk input, $0,002 untuk input yang disimpan dalam cache, dan $0,20 untuk output.
Apakah Meta menggunakan data API Muse Spark untuk pelatihan?
Meta menyatakan bahwa data tingkat standar tidak digunakan untuk meningkatkan produk-produk Meta. Data tingkat kontributor mungkin digunakan untuk meningkatkan produk-produk Meta, sehingga kode pribadi atau eksklusif sebaiknya menggunakan jalur standar kecuali jika organisasi bersangkutan menyetujui hal lain.
Apakah Muse Spark 1.2 terdaftar di papan peringkat Terminal-Bench atau DeepSWE yang terbuka untuk umum?
Saat diperiksa pada 7 Agustus 2026, sistem tersebut tidak terdaftar di papan pengumuman publik mana pun. Meta melaporkan nilai 82,9% pada Terminal-Bench 2.1 dengan Muse Code dan 59,3% pada DeepSWE, namun angka-angka tersebut merupakan hasil pengujian yang dijalankan oleh Meta.
Apakah Muse Spark 1.2 sudah diuji secara langsung dalam ulasan ini?
Ya. Dalam tiga uji coba model dasar dengan satu kali percobaan, Muse Spark 1.2 berhasil menyelesaikan perbaikan bug Python, refaktorisasi TypeScript, dan fitur repositori JSONL. Latensi rata-rata adalah 12,98 detik dan total biaya yang dilaporkan adalah $0,045362. Keandalan agen Muse Code dan panggilan alat tidak diuji.
Bagaimana cara pengembang mengakses Muse Spark 1.2?
Meta mencantumkan tiga opsi: agen terminal Muse Code beta, Meta Model API, dan OpenRouter. Buku panduan resmi menggunakan klien yang kompatibel dengan SDK OpenAI dengan URL dasar https://api.meta.ai/v1.