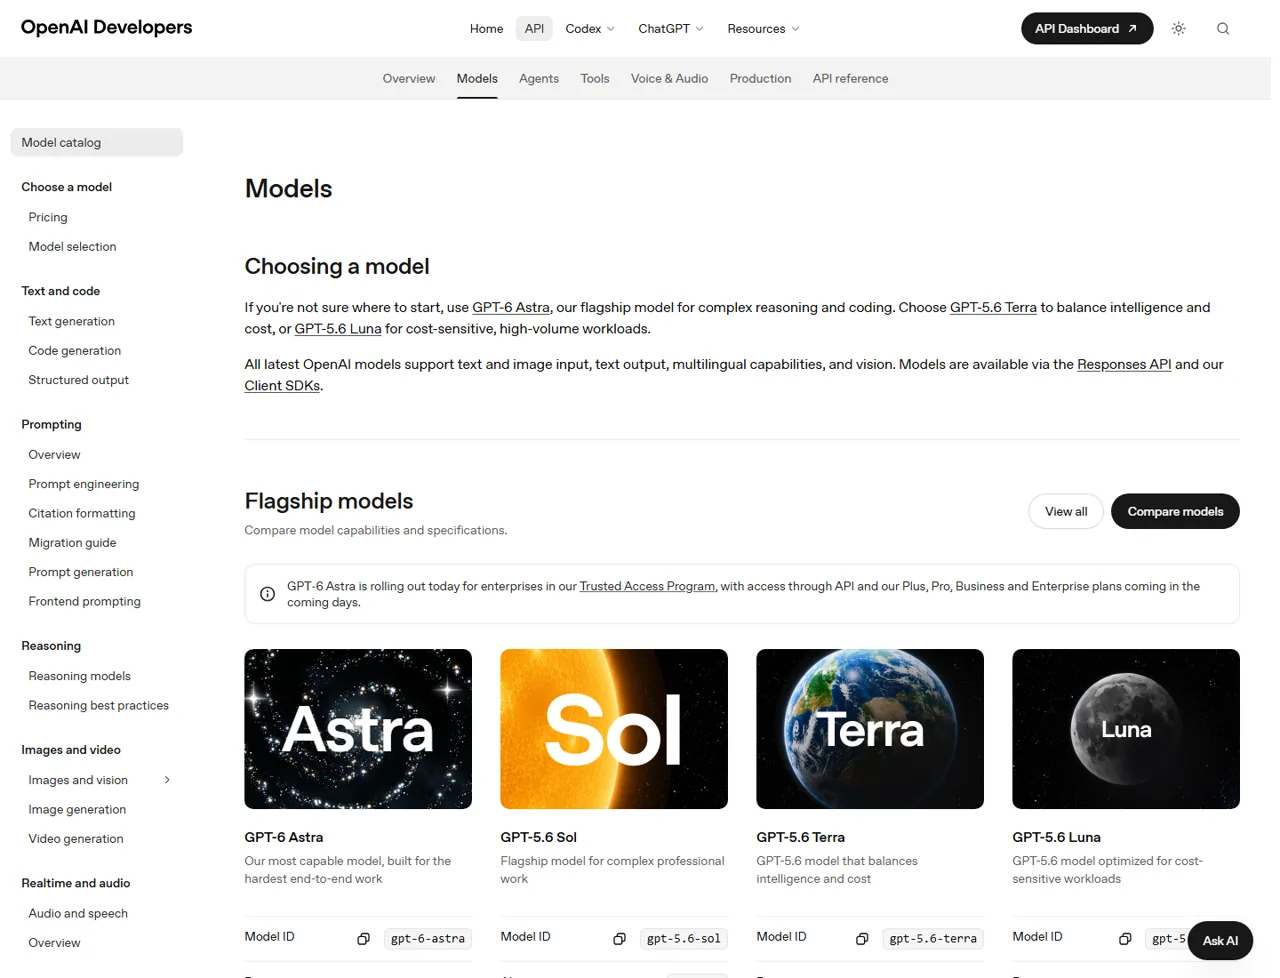
Jawaban singkat: Biaya GPT-6 Astra $10 per 1 juta token masukan, $1 per 1 juta token masukan yang disimpan dalam cache, $12,50 per 1 juta token penulisan cache, dan $50 per 1 juta token keluaran dengan tarif Standar selama jumlah token input tetap pada atau di bawah 272K. Di atas 272K, permintaan penuh beralih ke penetapan harga konteks panjang: $20 input, $2 input yang disimpan dalam cache, $25 penulisan ke cache, dan $75 output per 1 juta token. OpenAI mendokumentasikan jendela konteks sebesar 1,05 juta token dan output maksimum sebesar 128 ribu.
Angka-angka tersebut menjadikan Astra sangat bertenaga, namun juga cukup mahal sehingga memerlukan perencanaan. Permintaan yang diulang dapat menjadi jauh lebih murah jika fitur caching berfungsi dengan baik, sementara permintaan yang jumlah token masukannya nyaris melebihi 272K dapat menjadi jauh lebih mahal. Panduan ini memisahkan harga resmi dari contoh perhitungan serta dari pengamatan langsung kami terhadap API pada tanggal 5 September 2026.

Harga API GPT-6 Astra
OpenAI membagi penetapan harga Standar menjadi konteks jangka pendek dan jangka panjang. Batasannya didasarkan pada token masukan, bukan total input ditambah output. Konteks pendek mencakup perintah dengan jumlah token input hingga 272K; konteks panjang berlaku untuk jumlah di atas batas tersebut.
Biaya per 1 juta token
Kisaran harga yang lebih tinggi berlaku untuk seluruh permintaan. Harga yang ditampilkan adalah per 1 juta token.
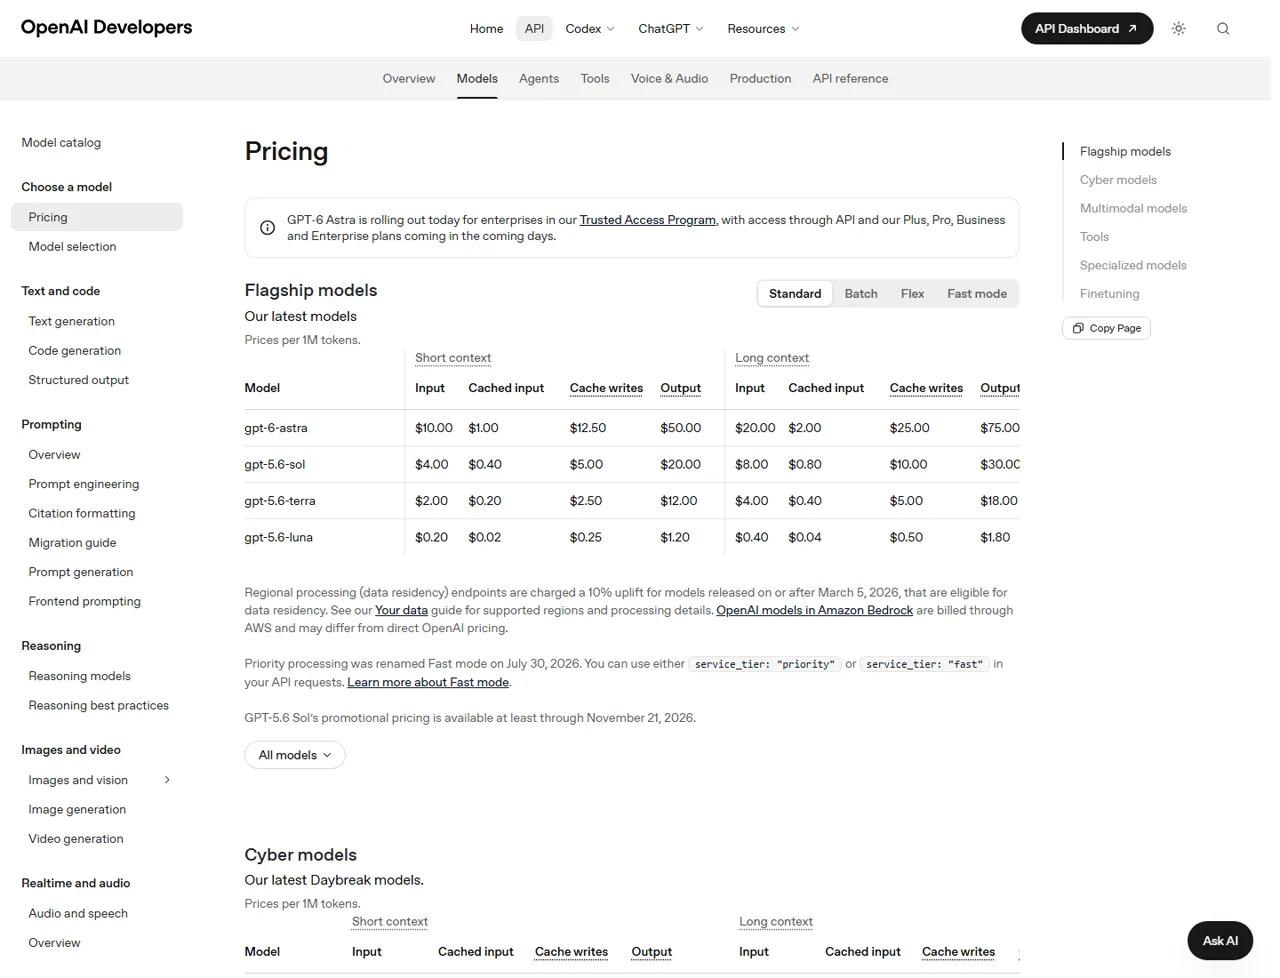
Hal terpenting yang perlu diperhatikan adalah bahwa melampaui batas 272K tidak akan menghasilkan tagihan dengan tarif campuran. Menurut Dokumentasi harga API OpenAI, tarif yang lebih tinggi berlaku untuk seluruh permintaan ketika volume masukan melebihi ambang batas. Oleh karena itu, tim yang membandingkan Astra dengan produk unggulan sebelumnya sebaiknya tidak hanya melihat harga masukan yang tercantum; kami Panduan Harga GPT-5.6 memberikan konteks yang berguna untuk pembahasan anggaran tersebut.
Penyimpanan dalam cache yang cepat dapat secara signifikan mengurangi biaya entri berulang, namun pembuatan cache tidak gratis. Biaya penulisan ke cache sebesar 1,25 kali tarif masukan tanpa cache yang berlaku. Pemrosesan Batch dan Flex dikenakan biaya 50% dari tarif Standar, sedangkan Fast dikenakan biaya dua kali lipat tarif yang berlaku. Pemrosesan regional yang memenuhi syarat menambah biaya sebesar 10%, dan opsi Fast tidak tersedia untuk Astra dengan persyaratan residensi data di UE.
Berapa Biaya Satu Panggilan API GPT-6 Astra?
Untuk permintaan Standar, hitung setiap kategori token yang ditagih secara terpisah, lalu tambahkan hasilnya:
Total biaya = biaya input yang tidak disimpan dalam cache + biaya input yang disimpan dalam cache + biaya penulisan ke cache + biaya output.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75Perkiraan tarif standar tidak mencakup alat, penyesuaian tarif regional, dan layanan lain yang ditagihkan secara terpisah.
100 ribu contoh tersebut menunjukkan mengapa prefiks yang dapat digunakan kembali itu penting: perkiraan model-token turun dari $1,25 menjadi $0,35 ketika semua input memenuhi syarat untuk disimpan dalam cache. Hal ini hanya sebagai ilustrasi penetapan harga, bukan jaminan bahwa setiap prompt yang diulang akan menghasilkan cache hit. Untuk penganggaran multi-model yang lebih luas, bandingkan asumsi alur kerja dalam panduan model AI serba guna.
Token GPT-6 Astra, Jendela Konteks, dan Batas Keluaran
The halaman resmi model GPT-6 Astra mendokumentasikan a Jendela konteks 1.050.000 token dan Output maksimum 128.000 token. Batas waktu pembaruan pengetahuannya adalah 30 April 2026. Sistem ini menerima masukan berupa teks dan gambar, menghasilkan keluaran berupa teks, serta mendukung pengaturan tingkat upaya penalaran rendah, sedang, tinggi, xtinggi, dan maks.
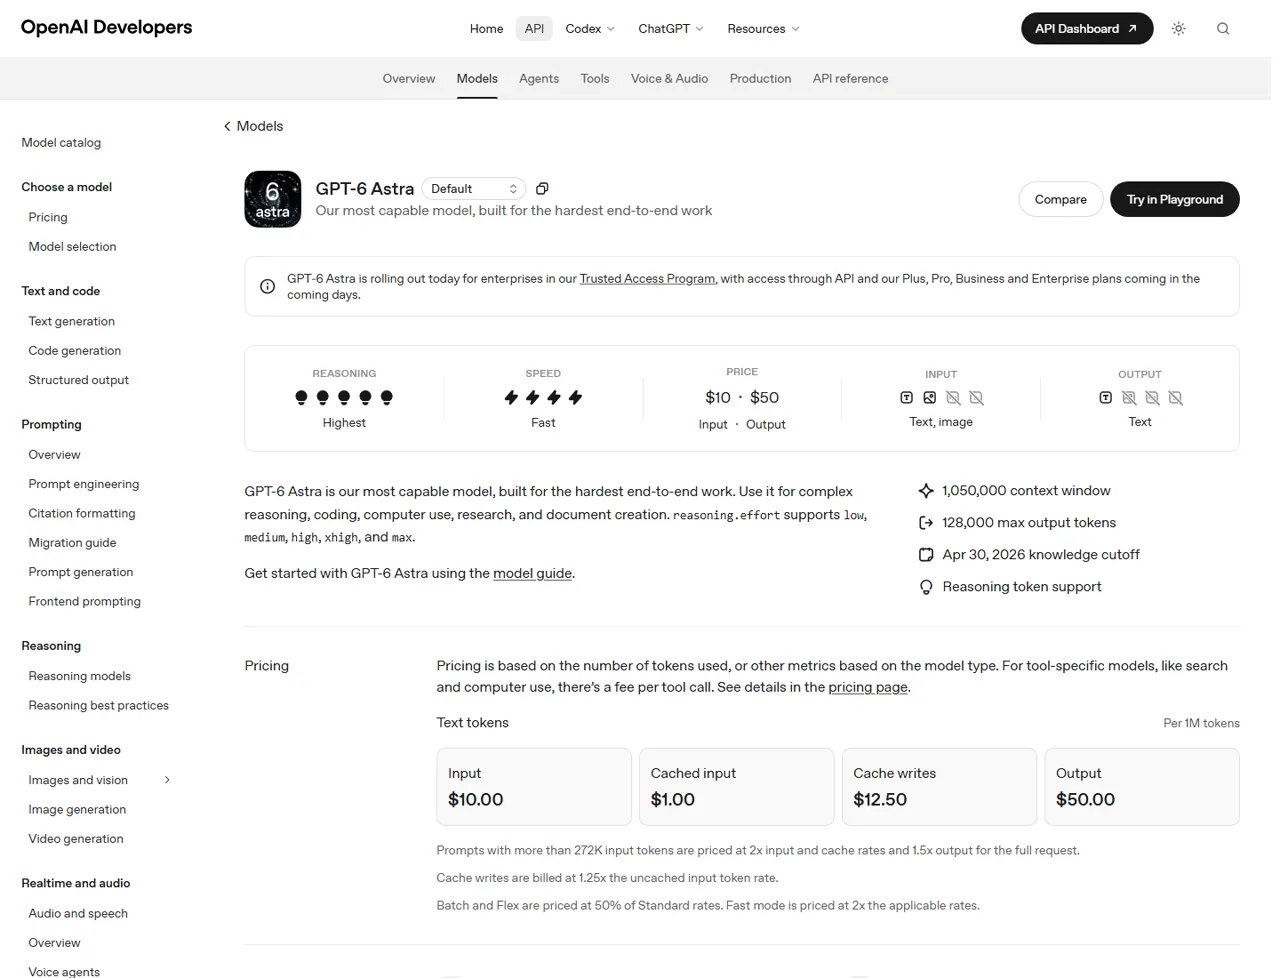
Jendela konteks yang besar merujuk pada kapasitas, bukan rekomendasi untuk memenuhi setiap permintaan. Proses pengambilan data, pemilihan dokumen, ringkasan, dan struktur prompt dapat menjaga agar masukan tetap di bawah batas 272K. Pemilihan model juga penting: pengembang yang berfokus pada pemrograman dapat membandingkan trade-off-nya dalam model AI terbaik untuk pengkodean melakukan analisis, alih-alih berasumsi bahwa model dengan jendela terbesar secara otomatis merupakan model yang paling sesuai.
Enam Tugas Praktis untuk Menguji API Astra GPT-6
Status pengujian: GPT-6 Astra mulai tersedia melalui API kompatibilitas Broly Anywhere pada tanggal 5 September 2026. Kami menjalankan enam tugas yang diungkapkan di bawah ini. Lima di antaranya menghasilkan respons HTTP 200 yang dapat digunakan; sedangkan permintaan batas 272K berakhir dengan kegagalan transmisi dan masih belum terverifikasi.
Perintah dan hasil yang diamati
ID Model gpt-6-astra. Setiap hasil merupakan satu kali pengujian yang diamati, bukan hasil pengujian standar resmi. Waktu jam dinding sudah mencakup penundaan di gateway dan upstream.
Akuntansi token dasar
Model tersebut menghasilkan hasil yang sesuai dengan perhitungan teoretis yang diharapkan. Penggunaan API yang sebenarnya adalah 54 token input dan 26 token output.
Caching yang cepat
Kedua pencarian tersebut benar, tetapi awalan yang diulang mencatat nol token yang disimpan dalam cache dan nol token penulisan ke cache pada kedua respons tersebut.
Batas harga 272K
Permintaan sintetis berskala besar tersebut berakhir sebelum respons HTTP diterima. Tidak ada objek penggunaan yang dikembalikan, sehingga batas laju dan perilaku penagihan tetap tidak terukur.
Alasan nilai rendah vs nilai maksimum
Kedua eksekusi tersebut menghasilkan nilai $265,20. Eksekusi Max memakan waktu lebih lama dan menghasilkan 88 token penalaran; tugas aritmatika tunggal ini tidak menunjukkan peningkatan kualitas jawaban.
Parameter keluaran 128K
Titik akhir kompatibilitas mengembalikan status "OK" alih-alih menolak satu token yang melebihi batas maksimum resmi. Hal ini merupakan perilaku gateway, bukan bukti adanya jendela keluaran yang didukung yang lebih besar.
Tarif paket dan tingkatan layanan
Respons normal tidak memuat header `remaining-request` maupun `remaining-token`. Baik probe Flex maupun probe prioritas berhasil, tetapi keduanya mengembalikan nilai `service_tier: default`.
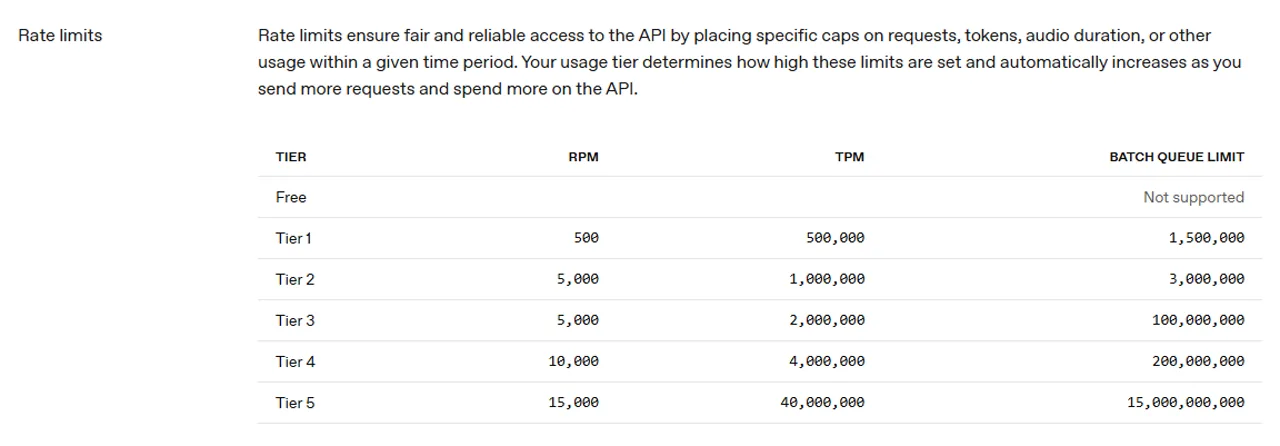
Batas Penggunaan API GPT-6 Astra
GPT-6 Astra tidak didukung pada paket Gratis. Batas publikasi meningkat sesuai dengan tingkatan penggunaan, namun header proyek aktif tetap menjadi sumber informasi yang paling dapat diandalkan untuk mengetahui sisa kapasitas dan waktu reset.
Kapasitas meningkat tajam di Tingkat 5
Tinggi bar berfungsi sebagai ilustrasi. Nilai RPM, TPM, dan antrian batch yang tepat di ataslah yang menjadi penentu.
Opsi Batch atau Flex dapat memangkas setengah tarif model-per-token jika respons instan tidak diperlukan. Opsi Fast mungkin cocok untuk pekerjaan yang sensitif terhadap latensi, namun tarifnya dua kali lipat dan tidak tersedia dengan ketentuan residensi data di UE untuk Astra. Sebelum menerapkan beban kerja produksi, bandingkan biaya model dengan biaya platform terkait; kami Panduan Harga Codex menjelaskan mengapa langganan produk dan penagihan API sebaiknya tidak digabungkan.
Apa yang Ditunjukkan oleh Para Pengulas Awal
Pencipta independen Matt Wolfe telah merilis video pratinjau awal yang menampilkan demonstrasi pemrograman, penggunaan komputer, Blender, dan Unreal Engine. Contoh-contoh ini berguna untuk memahami jenis alur kerja yang sedang dieksplorasi oleh para pengulas, namun bukan merupakan bukti pengujian terkontrol dan tidak dapat menggantikan pengujian API di atas. Perbandingan yang lebih luas seperti ChatGPT vs Claude vs Gemini hal ini juga sebaiknya dipahami sebagai panduan yang disesuaikan dengan beban kerja, bukan sebagai daftar peringkat universal.
Siapa yang Sebaiknya Menggunakan GPT-6 Astra?
Astra merupakan pilihan yang masuk akal untuk pemrograman yang rumit, alur kerja berbasis agen, analisis dokumen berskala besar, dan tugas multimodal di mana kemampuan penalaran yang lebih kuat atau jendela konteks yang sangat luas dapat mengimbangi biaya token yang tinggi. Tim sebaiknya mengujinya terlebih dahulu pada tugas yang spesifik dan terukur, serta membandingkan kualitas per dolar, bukan sekadar kualitas hasilnya. Kami Gambaran Umum Model AI Terbaik menawarkan kerangka kerja pemilihan yang lebih luas.
- Gunakan Astra jika: tugasnya rumit, kesalahan bisa berakibat mahal, diperlukan konteks yang panjang, atau model tersebut dapat menggantikan beberapa tahap pemrosesan yang lebih lemah.
- Gunakan model yang lebih murah jika: Pekerjaan ini meliputi klasifikasi rutin, ekstraksi, penulisan ulang, atau pembuatan konten dalam jumlah besar dengan persyaratan kualitas yang sederhana.
- Lakukan pengoptimalan terlebih dahulu jika: jumlah permintaan berulang kali melampaui 272 ribu, awalan statis yang besar dapat disimpan dalam cache, atau latensi tidak memerlukan pemrosesan Standar atau Cepat.
Bagi pembaca yang membandingkan pilihan premium yang serupa, Perbandingan antara GPT-5.6, Fable 5, dan GPT-5.5 memberikan sudut pandang lain mengenai biaya, kemampuan, dan kesesuaian beban kerja. GlobalGPT memiliki Halaman Utama GPT-6 Astra. Pengamatan API kami dicatat secara terpisah melalui titik akhir kompatibilitas Broly Anywhere.
Pertanyaan yang Sering Diajukan
Berapa harga API GPT-6 Astra?
Harga standar untuk konteks pendek adalah $10/M input, $1/M input yang disimpan dalam cache, $12,50/M penulisan ke cache, dan $50/M output. Di atas 272K token masukan, permintaan penuh menggunakan $20/M masukan, $2/M masukan yang disimpan dalam cache, $25/M penulisan ke cache, dan $75/M keluaran.
Apa yang terjadi jika sebuah prompt melebihi 272 ribu token masukan?
OpenAI memindahkan seluruh permintaan ke jalur konteks panjang. Ini bukanlah paket campuran di mana hanya token di atas 272K yang biayanya lebih mahal.
Apa itu jendela konteks GPT-6 Astra?
OpenAI memiliki jendela konteks sebesar 1.050.000 token, batas maksimum input sebesar 922.000 token, dan batas maksimum output sebesar 128.000 token. Token penalaran juga termasuk dalam konteks dan dihitung sebagai output.
Apakah GPT-6 Astra mendukung input gambar?
Ya. Dokumentasi model tersebut mencantumkan masukan berupa teks dan gambar dengan keluaran berupa teks. Audio dan video tidak tercantum sebagai jenis masukan untuk model ini.
Apakah contoh-contoh biaya ini merupakan faktur resmi?
Tidak. Itu hanyalah contoh perhitungan yang menggunakan tarif yang tercantum. Tagihan Anda juga dapat mencakup perhitungan token yang disimpan dalam cache, mode pemrosesan, pemrosesan regional, serta layanan lain yang ditagihkan secara terpisah.
Mode pemrosesan apa saja yang tersedia?
Harga Astra untuk paket Standard, Batch, Flex, Fast, dan Ultrafast telah didokumentasikan. Biaya paket Batch dan Flex setengah dari paket Standard, biaya paket Fast dua kali lipat dari paket Standard, dan biaya paket Ultrafast enam kali lipat dari paket Standard dalam rentang konteks yang sama. Pemrosesan regional yang memenuhi syarat menambah 10%; ketersediaannya bergantung pada mode dan titik akhir.
Bagaimana cara penagihan GPT-6 Astra melalui GlobalGPT?
API GlobalGPT mencantumkan 23 kredit per 1.000 token masukan dan 117 kredit per 1.000 token keluaran untuk GPT-6 Astra. Token penalaran dihitung sebagai token keluaran. Itu adalah tarif kredit GlobalGPT; penggunaan API OpenAI mengikuti struktur harga dalam USD-nya sendiri.
Keputusan Akhir
GPT-6 Astra menggabungkan jendela konteks sebesar 1,05 juta token dan keluaran maksimum 128 ribu token dengan harga premium. Tarif Standar dengan konteks pendek dimulai dari $10 per 1 juta token masukan dan $50 per 1 juta token keluaran, namun batas 272 ribu, token penalaran, penulisan cache, mode pemrosesan, dan penyesuaian regional dapat secara signifikan memengaruhi tagihan. Perkirakan jumlah token sebelum mengirimkan prompt berukuran besar, verifikasi penggunaan cache berdasarkan data penggunaan, dan nilai Astra berdasarkan nilai tugas yang telah diselesaikan, bukan hanya berdasarkan harga yang tertera.