
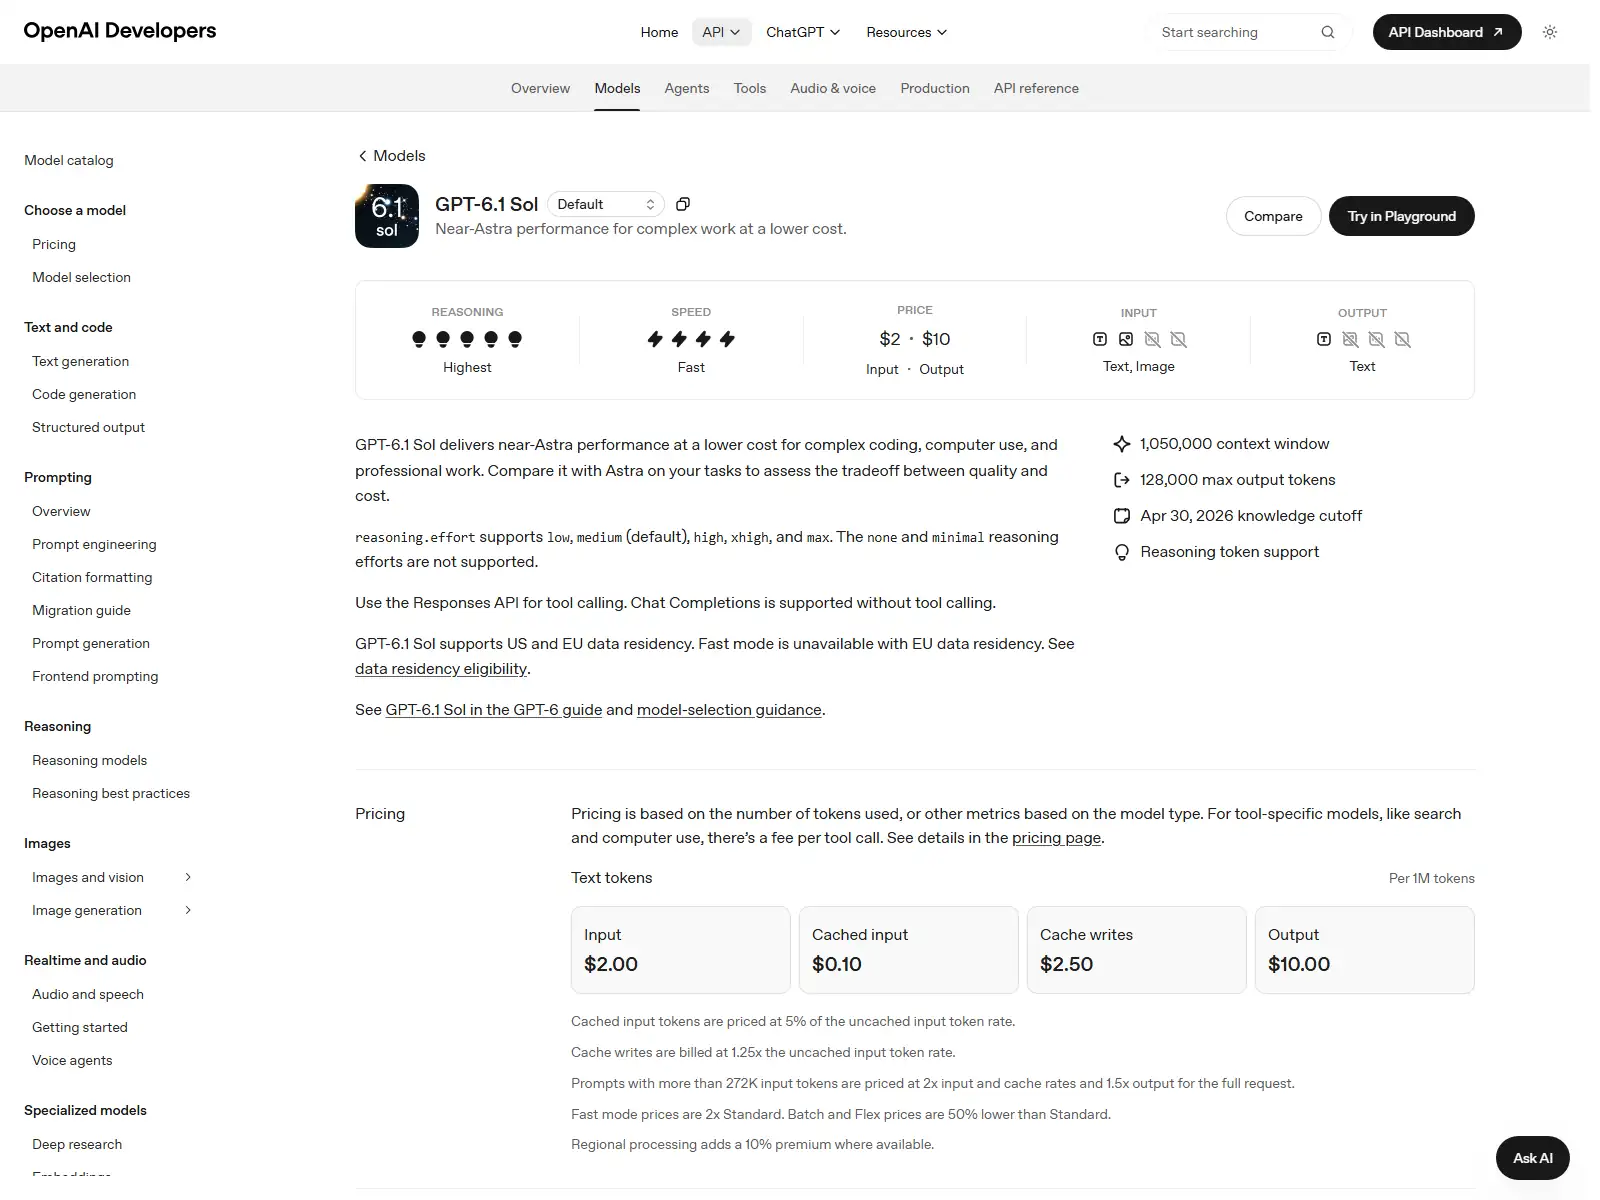
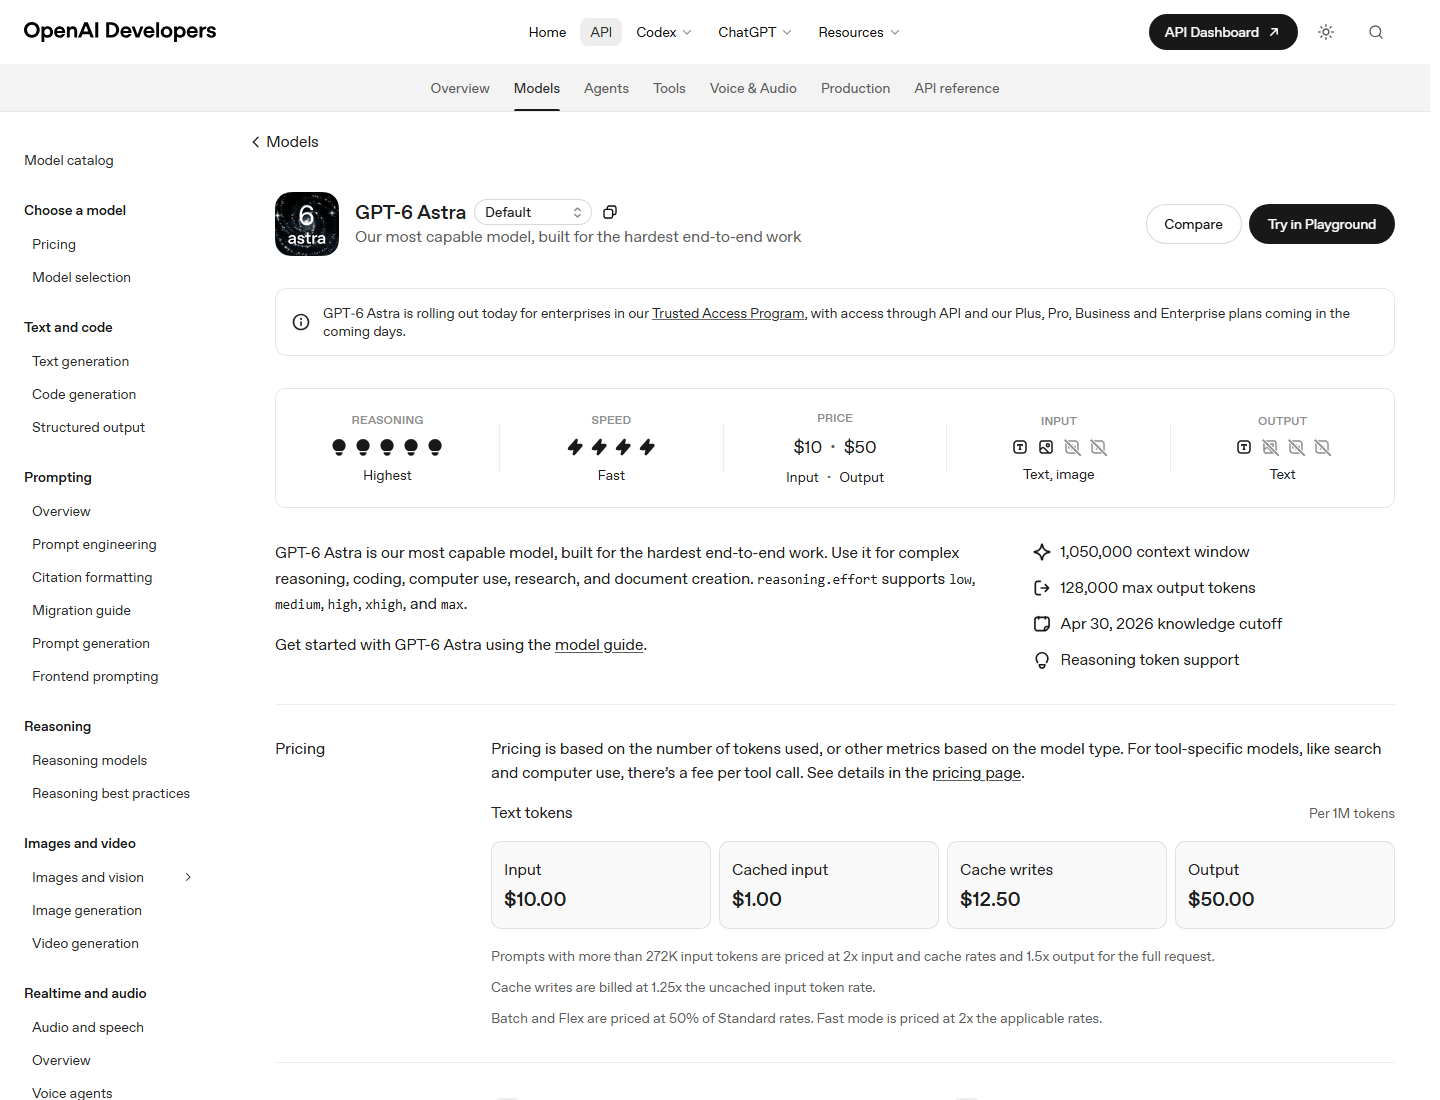
GPT-6.1 Sol adalah nilai default; GPT-6 Astra adalah batas atas kualitas. Keduanya menawarkan jendela konteks yang sama sebesar 1.050.000 token, batas keluaran 128.000 token, masukan multimodal, serta rangkaian alat yang lengkap. Perbedaan yang menentukan terletak pada posisi pasar dan harga: Sol dikenakan biaya $2 per juta token masukan dan $10 per juta token keluaran, sedangkan Astra dikenakan biaya $10 dan $50. Dengan kata lain, Astra harus menciptakan nilai tambah yang cukup untuk membenarkan biaya token Standard yang lima kali lebih tinggi.
Hal itu tidak menjadikan Sol sebagai “model yang sama dengan harga lebih murah.” OpenAI menyebut Astra sebagai model paling mumpuni untuk pekerjaan end-to-end yang paling berat, dan menggambarkan Sol sebagai model yang kinerjanya mendekati Astra untuk pekerjaan kompleks dengan biaya lebih rendah. Oleh karena itu, keputusan yang tepat merupakan masalah evaluasi, bukan sekadar perbandingan peringkat merek. Perbandingan ini menggunakan data terkini Dokumentasi GPT-6.1 Sol, yang Halaman model GPT-6 Astra, serta skenario biaya yang sama yang diperiksa pada tanggal 9 Oktober 2026.
GPT-6.1 Sol vs GPT-6 Astra: Perbandingan Singkat
Tabel tersebut memudahkan pengambilan keputusan awal: jika Anda belum memiliki bukti khusus untuk tugas tersebut, Sol layak menjadi pilihan pertama karena mempertahankan fitur antarmuka dan kapasitas utama sekaligus secara signifikan mengurangi biaya token. Astra menjadi pilihan yang rasional ketika pekerjaan tersebut sangat sulit, konsekuensi negatif dari jawaban yang salah sangat besar, atau hasil yang lebih baik dari Astra dapat menghindari beberapa putaran revisi oleh manusia atau model.
Hal ini berbeda dengan membandingkan Sol dengan model yang kecil dan cepat. Berdasarkan panduan keluarga produk OpenAI saat ini, Sol berada di peringkat atas, bukan di kisaran harga terendah. Pembaca yang mempertimbangkan seluruh jajaran produk juga dapat menggunakan panduan untuk model AI terbaik dan Ulasan GPT-6 Luna untuk mengetahui kapan model yang lebih ringan sudah cukup.
Kesamaan antara GPT-6.1 Sol dan GPT-6 Astra
Kedua halaman model resmi tersebut mencantumkan jendela konteks, input maksimum, output maksimum, dan batas pengetahuan yang sama. Keduanya menerima teks dan gambar serta menghasilkan teks. Tidak ada yang mencantumkan audio atau video sebagai masukan atau keluaran bawaan model. Keduanya juga memiliki tingkat upaya penalaran yang sama, yaitu rendah, sedang, tinggi, xtinggi, dan maksimum, dengan tingkat sedang sebagai pengaturan default. Kesamaan tersebut memudahkan pengujian A/B karena aplikasi dapat mempertahankan sebagian besar parameter permintaan tetap konstan sambil hanya mengganti ID model.
Kedua model tersebut mendukung keluaran terstruktur, pemanggilan fungsi, pencarian web, pencarian berkas, pembuatan gambar, interpreter kode, shell yang dihosting, penerapan patch, penggunaan komputer, MCP, keterampilan, dan pencarian alat. OpenAI mencantumkan pemanggilan alat melalui API Respons; fitur Chat Completions tersedia saat tidak melibatkan alat. Penyesuaian lanjutan (fine-tuning) tidak didukung di halaman model mana pun. Ini hanyalah pernyataan kemampuan, bukan jaminan bahwa kedua model tersebut akan memilih alat dengan tingkat akurasi yang sama.
Jendela konteks sebesar satu juta token merupakan batasan kapasitas, bukan izin untuk mengabaikan desain pengambilan data. Permintaan yang sangat panjang lebih mahal, lebih sulit untuk di-debug, dan akan dikenakan tarif tambahan jika jumlah token masukan melebihi 272K. Pembagian menjadi bagian-bagian (chunking), pengambilan data, ringkasan, dan penyimpanan sementara prompt tetap penting. Peringatan yang sama berlaku untuk batas atas 128K output: artefak yang dapat diverifikasi dalam ukuran lebih kecil biasanya lebih aman daripada satu respons yang sangat besar.
Penetapan Harga: Selisih Lima Kali Lipat
Dengan tarif standar, GPT-6.1 Sol dikenakan biaya $2 per juta token masukan yang tidak disimpan dalam cache, $0.10 untuk masukan yang disimpan dalam cache, $2.50 untuk penulisan ke cache, dan $10 untuk keluaran. Biaya GPT-6 Astra masing-masing sebesar $10, $1, $12.50, dan $50. Sol lima kali lebih murah untuk input yang tidak disimpan dalam cache, penulisan ke cache, dan output; sedangkan input yang disimpan dalam cache sepuluh kali lebih murah. Angka-angka saat ini diambil langsung dari halaman model OpenAI dan Dokumentasi penetapan harga API.
Rasio yang tercantum di judul bukanlah keseluruhan tarif. Begitu suatu permintaan melebihi 272K token input, OpenAI menerapkan tarif input dan cache dua kali lipat dari tarif normal serta tarif output 1,5 kali lipat dari tarif normal untuk keseluruhan permintaan tersebut. Batch dan Flex dihargai sebesar 50% dari tarif Standar, sedangkan Fast dihargai dua kali lipat dari tarif yang berlaku. Astra juga menawarkan tingkatan Ultrafast. Bandingkan yang sejenis: permintaan Sol Batch dan permintaan Astra Fast tidak mengungkapkan rasio model-harga yang mendasarinya.
Untuk rincian lebih lengkap mengenai kategori unggulan, lihat artikel kami Panduan Harga GPT-6 Astra. Yang sebelumnya Analisis harga GPT-6 Sol Hal ini berguna saat merencanakan migrasi dari generasi Sol sebelumnya, namun perkiraan produksi sebaiknya menggunakan ID model terkini yang tepat serta tarif terkini.
Desain Konteks Panjang: Kapasitas yang Sama, Aspek Ekonomi yang Berbeda
Jendela konteks yang sama sebesar 1.050.000 token dapat membuat Sol dan Astra tampak dapat saling menggantikan untuk pekerjaan yang melibatkan banyak dokumen, namun kapasitas hanyalah batasan pertama. Sebuah permintaan yang mendekati batas tersebut tetap harus menemukan bukti yang tepat, membedakan instruksi dari materi yang dikutip, mempertahankan hubungan antar banyak berkas, dan mengembalikan hasil yang dapat diverifikasi oleh manusia atau program. Model dengan nama yang lebih besar tidak menghilangkan kebutuhan akan arsitektur informasi. Atur sumber-sumber, tandai batas-batasnya, dan mintalah kutipan yang merujuk kembali ke pengenal dokumen yang stabil.
Tarif Sol yang lebih rendah membuat eksperimen konteks panjang menjadi layak secara ekonomi. Sebuah tim dapat menguji beberapa strategi pengelompokan, ambang batas pengambilan informasi, dan format ringkasan dengan biaya setara satu kali eksekusi Astra. Pencarian yang lebih luas ini dapat meningkatkan kinerja sistem, bahkan jika Astra unggul dalam satu prompt saja. Astra menjadi lebih menarik setelah alur kerja stabil dan kesalahan yang belum teratasi benar-benar disebabkan oleh keterbatasan model. Pada tahap pengembangan awal, menghabiskan seluruh anggaran untuk beberapa panggilan unggulan mungkin menghasilkan pembelajaran yang lebih sedikit daripada menjalankan evaluasi Sol yang terstruktur pada banyak kasus representatif.
Batas 272K perlu dipantau secara eksplisit. Permintaan dengan 271K token masukan dan permintaan dengan 273K token masukan memiliki ukuran yang hampir sama, tetapi permintaan kedua akan membuat seluruh permintaan masuk ke rentang yang lebih tinggi. Buat perkiraan token pra-pengiriman dan catat band mana yang digunakan oleh setiap pekerjaan. Jika input hanya sedikit melebihi batas, menghapus teks boilerplate yang berulang, riwayat percakapan yang sudah usang, atau bagian teks yang diambil yang bernilai rendah dapat secara signifikan mengurangi biaya tanpa mengorbankan kualitas. Optimalisasi ini berlaku untuk kedua model, meskipun tarif dasar Astra yang lebih tinggi membuat kesalahan menjadi lebih mahal.
Penyimpanan dalam cache yang cepat paling berguna ketika prefiks yang besar tetap stabil di seluruh panggilan. Contohnya antara lain pedoman kebijakan, standar penulisan kode, katalog produk, atau skema alat yang digunakan bersama oleh banyak tugas. Letakkan konten yang stabil terlebih dahulu dan instruksi yang bervariasi di belakangnya, jika perilaku penyimpanan dalam cache API mendukung tata letak tersebut. Kemudian, ukur jumlah cache hit daripada hanya mengasumsikannya. Keunggulan input yang disimpan dalam cache pada Sol sangat besar, tetapi prefiks yang terus berubah dapat menghilangkan keunggulan tersebut. Desain cache harus dimasukkan dalam laporan benchmark bersama dengan akurasi dan latensi.
Untuk penelitian dan analisis dokumen, gunakan alur kerja bertahap: kumpulkan bukti yang mungkin relevan, minta model untuk menyusun peta bukti terstruktur, validasi kutipan-kutipannya, dan baru setelah itu minta sintesis. Gunakan Astra jika sintesisnya masih lemah meskipun alur kerja bukti sudah solid, atau jika kumpulan sumber mengandung kontradiksi yang sangat halus. Hal ini memisahkan kegagalan pengambilan bukti dari kegagalan penalaran. Tanpa pemisahan tersebut, tim sering kali harus mengeluarkan biaya untuk model yang lebih canggih guna mengatasi masalah konstruksi konteks yang sebenarnya dapat dihindari.
Pemrograman dan Penggunaan Alat
Dalam hal pemrograman, pertanyaan yang relevan bukanlah “model mana yang bisa menulis kode?” Keduanya bisa. Pertanyaannya adalah di mana kemampuan tambahan Astra mengubah hasilnya. Sol menarik untuk pekerjaan repositori umum: mengimplementasikan fitur-fitur berskala terbatas, mendiagnosis bug yang dapat direproduksi, meninjau permintaan pull, menulis tes, mentransformasi data, dan menjalankan loop alat secara berulang. Biayanya yang lebih rendah memungkinkan lebih banyak percobaan, verifikasi yang lebih banyak, dan kumpulan evaluasi yang lebih besar dengan anggaran yang sama.
Astra lebih cocok digunakan untuk tugas-tugas yang didominasi oleh ketidakjelasan dan kebutuhan koordinasi: migrasi monorepo yang belum pernah dilakukan sebelumnya, tinjauan arsitektur yang sensitif terhadap keamanan, penggunaan komputer dalam jangka panjang, porting lintas bahasa yang rumit, atau insiden produksi dengan bukti yang tidak lengkap. Model yang paling mumpuni bisa sepadan dengan harganya yang lebih mahal jika satu rencana yang tepat dapat menghemat berjam-jam kerja ulang. Kami Model AI terbaik untuk perbandingan pemrograman menjelaskan mengapa pengujian repositori lebih penting daripada kesan umum mengenai penulisan kode.
- Fitur yang telah ditentukan lingkupnya dengan uji penerimaan yang jelas
- Debugging rutin dan tinjauan kode
- Loop agen bervolume tinggi
- Rancangan migrasi dan refaktorisasi
- Pembuatan tes dan dokumentasi
- Kegagalan total setelah upaya Sol
- Perubahan keamanan atau data berisiko tinggi
- Arsitektur lintas sistem yang ambigu
- Tugas penggunaan komputer mandiri yang berlangsung lama
- Tinjauan akhir ketika kesalahan bisa berakibat fatal
Jangan menilai kedua model tersebut berdasarkan kode yang sekadar terlihat masuk akal. Berikan kedua model tersebut snapshot repositori yang sama, instruksi, alat, anggaran waktu, dan tes yang sama. Catat tingkat keberhasilan, koreksi manual, kegagalan panggilan alat, token, latensi, dan biaya. Model yang biayanya lima kali lipat tetapi mengurangi setengah jumlah upaya yang gagal mungkin dapat dibenarkan; model yang meningkatkan gaya tanpa meningkatkan tingkat penerimaan tidak dapat dibenarkan.
Bukti Kinerja: Apa yang Dapat dan Tidak Dapat Kita Simpulkan
Posisi OpenAI memberikan ringkasan yang paling kuat dan dapat dipertanggungjawabkan: Astra adalah model yang paling mumpuni untuk pekerjaan end-to-end yang paling sulit, sementara GPT-6.1 Sol bertujuan untuk mencapai kinerja yang mendekati Astra pada pekerjaan kompleks dengan biaya lebih rendah. Pernyataan-pernyataan tersebut mendukung hipotesis pemilihan, bukan selisih persentase yang berlaku universal. Tidak ada satu pun tolok ukur publik yang dapat memprediksi kinerja pada dokumen, alat, kebijakan, atau basis kode milik Anda.
Video peluncuran sangat berguna untuk memahami bagaimana sebuah perusahaan mempresentasikan suatu produk, tetapi video tersebut bukanlah evaluasi independen. Demikian pula, ulasan dari para kreator memperlihatkan antarmuka yang sebenarnya dan contoh-contoh yang bermanfaat, namun setiap ulasan mencerminkan serangkaian petunjuk, konfigurasi alat, dan tenggat waktu publikasi tertentu. Anggaplah thumbnail yang menarik atau penilaian awal sebagai petunjuk untuk rencana pengujian Anda sendiri, bukan sebagai bukti bahwa Astra atau Sol menang di setiap kategori.
Video resmi OpenAI di atas mendokumentasikan cara Astra mempresentasikan peluncurannya. Halaman independen Matt Wolfe di bawah ini menunjukkan bahwa perhatian pihak ketiga dengan cepat tertuju pada skala peluncuran tersebut. Kedua tangkapan layar tersebut tidak digunakan di sini sebagai tolok ukur numerik. Artikel ini sengaja menghindari pengubahan antusiasme, jumlah penayangan, atau judul karya seorang kreator menjadi skor kinerja yang tidak didukung data.
Perbandingan yang baik menggunakan kumpulan data evaluasi privat yang menyerupai lingkungan produksi. Sertakan tugas-tugas mudah, tugas-tugas umum, dan kasus kegagalan yang berdampak besar. Sembunyikan hasil keluaran jika preferensi manusia menjadi faktor penting. Untuk agen, uji kemampuan penyelesaian dan pemulihan, bukan respons pertama. OpenAI’s panduan pemilihan model Demikian pula, disarankan untuk membandingkan model-model pada tugas yang sama dan memilih model yang paling ringan serta upaya penalaran yang mampu memenuhi standar kualitas.
Cara Melakukan Evaluasi yang Adil antara Sol dan Astra
Mulailah dengan mendefinisikan keputusan yang akan diambil oleh evaluasi tersebut. Pertanyaan seperti “Model mana yang lebih cerdas?” terlalu samar. Pertanyaan yang lebih berguna adalah “Model mana yang sebaiknya menangani tinjauan pull request untuk repositori ini pada tingkat penalaran sedang?” atau “Apakah sintesis kontrak akhir sebaiknya dialihkan dari Sol ke Astra?” Tentukan terlebih dahulu kelompok tugas, tingkatan layanan, tingkat upaya penalaran, alat yang digunakan, batas waktu, dan kriteria penerimaan sebelum menghasilkan keluaran. Jika tidak, hasil yang menguntungkan dapat dijelaskan oleh konfigurasi, bukan oleh model itu sendiri.
Buatlah kumpulan data yang cukup besar untuk mencakup kasus-kasus umum dan kasus-kasus tepi yang signifikan. Dua puluh contoh yang dipilih dengan cermat dapat mengungkap kegagalan yang jelas, tetapi kebijakan perutean produksi biasanya membutuhkan lebih dari itu. Ambil sampel dari pekerjaan nyata terbaru setelah menghapus data sensitif, lalu beri label pada setiap kasus berdasarkan tingkat kesulitan dan risiko. Simpan kumpulan data holdout yang terkunci agar penyetelan prompt tidak secara bertahap mengalami overfitting terhadap contoh-contoh yang sudah dilihat oleh semua orang. Lakukan versi pada dataset dan evaluator sama seperti Anda melakukan versi pada kode aplikasi.
Gunakan pemeriksaan deterministik setiap kali tugas memungkinkan. Kompilasi kode, jalankan tes, validasi JSON berdasarkan skema, bandingkan bidang yang diekstraksi dengan label, dan verifikasi kutipan yang disebutkan. Penilai manusia sebaiknya berfokus pada aspek-aspek yang tidak dapat ditangkap dengan baik oleh otomatisasi, seperti kejelasan, penilaian, dan apakah suatu rekomendasi sesuai dengan konteks bisnis. Sembunyikan identitas model dan acak urutan keluaran. Jika penilai mengetahui jawaban mana yang berasal dari Astra, harga dan reputasi dapat memengaruhi skor tanpa ada niat untuk bias.
Pantau tingkat keparahan, bukan hanya nilai rata-rata. Sepuluh kelemahan gaya yang minor tidak boleh lebih berat daripada satu rekomendasi kritis terkait kehilangan data. Tentukan kriteria penolakan mutlak, seperti kutipan yang dibuat-buat, perintah yang tidak aman, kolom wajib yang kosong, atau kegagalan mematuhi batasan hukum. Laporkan distribusinya berdasarkan tingkat kesulitan dan kategori risiko. Sol mungkin sejajar dengan Astra pada pekerjaan biasa dan hanya tertinggal pada lima persen yang paling sulit; hasil tersebut sangat mendukung penggunaan router daripada migrasi all-or-nothing.
Terakhir, hitung ketidakpastian dan jalankan kembali kasus-kasus yang tidak stabil. Hasil model dapat bervariasi, sehingga perbandingan satu kali saja akan melebih-lebihkan faktor keberuntungan. Ulangi sebagian data, selidiki ketidaksesuaian antar penilai, dan simpan hasil mentah untuk keperluan audit. Rekomendasi akhir harus mencantumkan tanggal pengujian, ID model, pengaturan, versi dataset, harga yang digunakan, dan celah yang diketahui. Tinjau kembali setelah pembaruan model, perubahan prompt, atau pergeseran beban kerja yang signifikan. Pemilihan model adalah keputusan operasional yang terus diperbarui, bukan pencapaian permanen.
Jangan biarkan penilai menjadi model pengambil keputusan tersembunyi. Jika penilai otomatis sangat memihak pada satu hasil, ambil sampel keputusan tersebut untuk ditinjau oleh ahli dan bandingkan penilai tersebut dengan hasil penerimaan yang pasti. Pisahkan kualitas penyajian dari kebenaran tugas: penjelasan yang rapi dapat menyembunyikan persyaratan yang tidak terpenuhi, sementara jawaban yang ringkas mungkin lolos dari setiap tes. Laporkan juga suara abstain dan hasil seri alih-alih memaksakan pemenang. Detail-detail tersebut membuat hasilnya kurang dramatis, tetapi jauh lebih berguna untuk penganggaran dan penentuan rute. Tujuannya adalah aturan operasional yang dapat diulang, yang dapat diperiksa dan direproduksi oleh anggota tim lainnya. Catat juga hasil yang ditolak; contoh kegagalan sering kali menjelaskan batas penentuan rute dengan lebih jelas daripada tabel skor rata-rata.
Contoh Biaya Sebenarnya
Pertimbangkan eksekusi agen pengkodean dengan 200.000 token masukan yang tidak disimpan dalam cache dan 20.000 token keluaran. Biaya Sol sekitar $0,60: $0,40 untuk masukan dan $0,20 untuk keluaran. Biaya Astra sekitar $3,00: $2,00 ditambah $1,00. Dari 10.000 kali eksekusi, selisihnya sekitar $24.000 sebelum biaya alat, penyimpanan dalam cache, penyesuaian regional, atau penyesuaian tingkat layanan.
Sekarang, pertimbangkan sebuah permintaan dengan konteks panjang yang memiliki 300.000 token masukan dan 30.000 token keluaran. Karena jumlah token masukan melebihi 272K, tarif yang lebih tinggi berlaku untuk seluruh permintaan tersebut. Tarif masukan efektif Sol menjadi $4 per juta dan tarif keluaran menjadi $15, sehingga menghasilkan sekitar $1,65. Astra menjadi $20 untuk input dan $75 untuk output, menghasilkan sekitar $8,25. Rasio lima kali lipat tetap berlaku, tetapi selisih absolutnya semakin besar.
Pencadangan (caching) dapat lebih menggeser perhitungan ke arah Sol karena laju input yang disimpan dalam cache-nya hanya sepersepuluh dari Astra. Hal ini penting untuk instruksi sistem yang stabil, referensi berulang dalam skala besar, dan penyusunan kerangka kerja agen. Namun, penulisan ke cache tetap memiliki biaya, dan mengubah prefiks dapat mengurangi tingkat pemanfaatan ulang. Lakukan perkiraan berdasarkan log penggunaan aktual, bukan dengan mengasumsikan bahwa setiap token akan menerima laju cache tersebut.
Cara Membandingkan Model-model dalam API
Gunakan API Respons untuk aplikasi yang menggunakan alat bantu dan pastikan konfigurasi perbandingannya tetap sama. Pengaturan pengujian paling sederhana yang berguna adalah dengan mengirimkan input yang sama ke kedua ID model, mencatat metadata respons, dan menjalankan evaluator yang sama. Jangan cantumkan kunci API dalam kode sumber; gunakan variabel lingkungan dan pengelola rahasia yang biasa Anda gunakan.
Ukuran sampel sengaja dibuat kecil. Sistem produksi harus menyimpan ID permintaan, versi evaluator, commit repositori, jejak alat, jumlah percobaan ulang, dan hasil penerimaan. Sistem tersebut juga harus menghitung harga berdasarkan tingkatan layanan dan rentang konteks panjang yang benar-benar digunakan. Hindari agar satu model melihat umpan balik yang tidak diterima oleh model lainnya, kecuali jika Anda secara eksplisit sedang menguji urutan perutean.
Strategi Perutean Sol-ke-Astra yang Praktis
Router dua tahap ini menangkap argumen ekonomi terkuat untuk Sol tanpa berpura-pura bahwa setiap prompt itu sama. Kirimkan lalu lintas normal ke Sol dengan tingkat penalaran sedang. Lakukan eskalasi jika uji deterministik gagal, model melaporkan tingkat kepercayaan rendah, tugas tersebut termasuk dalam kategori berisiko tinggi, atau pengguna secara eksplisit meminta tinjauan oleh tim andalan. Pastikan aturan eskalasi tetap transparan agar biaya tidak meningkat secara diam-diam.
Gunakan prompt, alat, dan uji penerimaan yang sama.
Pengujian, tingkat kepercayaan, kelas risiko, dan peninjauan oleh manusia.
Serahkan pekerjaan yang gagal atau berisiko tinggi kepada Astra.
Lacak tingkat penerimaan, pekerjaan ulang, latensi, dan biaya total.
Perutean juga memberikan tim cara yang terkendali untuk memperbarui pengaturan default. Jika tingkat penerimaan Sol meningkat pada suatu kelompok tugas, perluas porsinya. Jika Astra berulang kali mencegah terjadinya cacat yang mahal, alihkan kategori tersebut secara langsung. Perbandingan ini menjadi kebijakan operasional yang didukung data, bukan sekadar perdebatan model yang hanya dilakukan sekali saja. Untuk referensi generasi sebelumnya, lihat GPT-6 Astra vs GPT-5.6 Sol.
Latensi dan keandalan harus menjadi bagian dari kebijakan perutean yang sama. Sebuah model dapat menghasilkan jawaban yang lebih kuat, namun tetap menjadi pilihan default yang salah jika waktu responsnya mengganggu alur kerja interaktif atau proses penalaran yang lebih lama menyebabkan batas waktu tugas terlampaui. Ukur latensi token pertama, durasi total, pemulihan panggilan alat, dan penyelesaian yang berhasil dalam kondisi konkurensi yang realistis. Kemudian, tentukan tujuan layanan untuk setiap kelas tugas. Sol dapat menangani lalu lintas produksi yang sensitif terhadap waktu sementara Astra menangani tinjauan asinkron, atau sebaliknya dapat dibenarkan jika tugas yang sulit secara rutin gagal sebelum ditingkatkan. Keputusan model bersifat operasional, bukan sekadar editorial.
Siapa yang Sebaiknya Memilih Sol, dan Siapa yang Sebaiknya Memilih Astra?
Pilih GPT-6.1 Sol untuk produksi yang mengutamakan efisiensi biaya
Sol cocok untuk tim produk, agensi, peneliti, dan pengembang yang menangani volume pekerjaan yang besar dan rumit, namun tetap memiliki kriteria penerimaan yang dapat diukur. Sol sangat menarik terutama ketika iterasi menjadi bagian dari proses: siklus kode-uji-perbaiki, revisi dokumen, ekstraksi dengan validasi, sintesis penelitian, dan agen internal bertahap. Harganya yang lebih terjangkau memungkinkan cakupan evaluasi yang lebih luas dan anggaran percobaan ulang yang lebih besar.
Pilihlah GPT-6 Astra untuk pekerjaan yang paling sulit dan sangat menuntut kualitas
Astra cocok untuk tim yang menghadapi tugas-tugas paling sulit dengan biaya kesalahan yang tinggi atau sistem pemeriksaan otomatis yang kurang memadai. Keputusan arsitektur yang rumit, tinjauan keamanan akhir, tugas penalaran ilmiah yang inovatif, atau rangkaian penggunaan komputer yang panjang dapat menjadi alasan yang tepat untuk menggunakan model andalan ini. Model ini juga merupakan pilihan default yang lebih tepat pada tahap penemuan awal, ketika tim belum mengetahui apa saja yang terlewatkan oleh model yang lebih kecil dan biaya belum menjadi kendala langsung.
Gunakan keduanya ketika tingkat kesulitan tugas bervariasi
Sebagian besar sistem yang sudah matang sebaiknya tidak memaksakan satu model tertentu untuk setiap permintaan. Gunakan Sol untuk segmen menengah yang luas dan Astra sebagai lapisan eskalasi. Tambahkan Luna atau model lain yang lebih kecil untuk klasifikasi dan transformasi yang dapat diprediksi. Desain berjenjang ini mencerminkan keragaman beban kerja yang sebenarnya dan biasanya lebih ekonomis daripada berdebat untuk menentukan satu model pemenang permanen. Kami metodologi pengujian model menawarkan kerangka kerja yang berguna untuk membedakan bukti yang dapat diulang dari sekadar kesan.
Cara Menggunakan GPT-6.1 Sol dan GPT-6 Astra pada GlobalGPT
GlobalGPT menyediakan alur kerja produk secara real-time untuk kedua model tersebut dalam satu ruang kerja multi-model. Buka ruang kerja tersebut, mulai percakapan baru, dan periksa pemilih model saat ini untuk GPT-6.1 Sol atau GPT-6 Astra. Menempatkan kedua model dalam satu antarmuka berguna untuk pekerjaan eksplorasi secara berdampingan, sementara evaluasi API tetap menjadi pilihan yang lebih baik untuk penilaian otomatis, pencatatan penggunaan yang akurat, dan kontrol penerapan.
Mulailah dengan Sol untuk putaran pertama, lalu jalankan kembali prompt yang paling sulit menggunakan Astra dan bandingkan perubahan signifikan apa saja yang terjadi.
Buka GlobalGPTUntuk informasi latar belakang yang lebih mendalam mengenai model tertentu, silakan baca artikel kami Panduan GPT-6.1 Sol dan Ulasan GPT-6 Astra. Halaman-halaman tersebut membahas masing-masing model secara terpisah; halaman ini berfokus pada keputusan pembelian dan pemilihan rute di antara model-model tersebut.
Pertanyaan yang Sering Diajukan
Apakah GPT-6.1 Sol lebih baik daripada GPT-6 Astra?
Tidak dalam arti mutlak. OpenAI menempatkan GPT-6 Astra sebagai modelnya yang paling mumpuni dan GPT-6.1 Sol sebagai model berbiaya lebih rendah dengan performa yang mendekati Astra untuk pekerjaan kompleks. Sol menawarkan nilai yang lebih baik jika mampu memenuhi standar kualitas Anda; sedangkan Astra adalah pilihan yang lebih aman dan mengutamakan kualitas untuk tugas-tugas tersulit.
Seberapa jauh harga GPT-6.1 Sol lebih murah dibandingkan GPT-6 Astra?
Dengan tarif Standar, Sol dikenakan biaya $2 per juta token masukan dan $10 per juta token keluaran, sedangkan Astra dikenakan biaya $10 dan $50. Oleh karena itu, Sol lima kali lebih murah untuk input dan output yang tidak disimpan dalam cache. Harga input yang disimpan dalam cache sebesar $0,10 adalah sepersepuluh dari tarif Astra sebesar $1.
Apakah GPT-6.1 Sol dan GPT-6 Astra memiliki jendela konteks yang sama?
Ya. OpenAI mencantumkan jendela konteks sebesar 1.050.000 token, batas maksimum input 922.000, dan batas maksimum output 128.000 untuk kedua model tersebut. Permintaan dengan jumlah token input di atas 272K akan dialihkan ke tarif konteks panjang yang lebih tinggi.
Model mana yang lebih baik untuk pemrograman?
Astra adalah pilihan utama yang mengutamakan kualitas untuk pekerjaan repositori yang sangat sulit, ambigu, atau berisiko tinggi. Sol merupakan pilihan standar yang praktis untuk pekerjaan fitur rutin, debugging, tinjauan, dan loop agen karena biayanya yang lebih rendah memungkinkan lebih banyak iterasi. Jalankan keduanya pada tes repositori yang sama sebelum memutuskan standar yang akan digunakan.
Apakah kedua model tersebut mendukung alat dan masukan gambar?
Ya. Halaman model resmi mereka mencantumkan masukan teks dan gambar, keluaran teks, keluaran terstruktur, pemanggilan fungsi, pencarian web, pencarian berkas, interpreter kode, shell yang dihosting, penerapan patch, penggunaan komputer, MCP, keterampilan, dan pencarian alat. Pemanggilan alat sebaiknya menggunakan Respons API.
Kapan saya harus membayar untuk GPT-6 Astra?
Gunakan Astra jika kesalahan dapat menimbulkan biaya yang tinggi, tugas tersebut benar-benar berada di tingkat terdepan, atau evaluasi perbandingan menunjukkan bahwa kualitas ekstra yang dimilikinya dapat mengurangi pekerjaan ulang hingga cukup untuk membenarkan harga token yang lima kali lipat. Contohnya antara lain migrasi kritis, penggunaan komputer otonom yang rumit, dan tinjauan akhir atas hasil kerja yang sangat penting.
Upaya penalaran mana yang sebaiknya saya pilih?
Mulailah dari tingkat sedang, yang merupakan pengaturan default yang tercantum untuk kedua model tersebut. Turunkan tingkatannya untuk transformasi yang sederhana, dan naikkan hanya jika tingkat kesulitan tugas atau biaya kesalahan mengharuskannya. Pengaturan yang efisien adalah pengaturan dengan upaya paling sedikit yang secara konsisten lulus uji penerimaan Anda.
Apakah saya bisa menggunakan GPT-6.1 Sol dan GPT-6 Astra di GlobalGPT?
GlobalGPT menyediakan rute langsung untuk GPT-6.1 Sol dan GPT-6 Astra di ruang kerja multi-modelnya. Ketersediaan dapat bervariasi tergantung pada akun dan antarmuka yang digunakan, jadi silakan buka ruang kerja tersebut dan periksa pemilih model yang tersedia saat ini sebelum memulai alur kerja produksi.
Apakah saya sebaiknya mengarahkan setiap prompt ke satu model?
Biasanya tidak. Router sederhana dapat meneruskan tugas biasa ke Sol dan meneruskan kasus-kasus dengan tingkat keyakinan rendah, yang gagal dalam pengujian, atau berisiko tinggi ke Astra. Hal ini memungkinkan pemanfaatan sebagian besar keunggulan biaya Sol, sekaligus mengalokasikan Astra untuk perintah-perintah di mana kemampuan marjinalnya memiliki nilai yang dapat diukur.
Keputusan Akhir
GPT-6.1 Sol sebaiknya menjadi model pertama yang dievaluasi oleh tim yang paling mengutamakan efisiensi biaya; sedangkan GPT-6 Astra sebaiknya tetap menjadi pilihan utama untuk tugas-tugas yang paling menantang. Konteks yang sama, batas keluaran, modalitas, kontrol penalaran, dan katalog alat yang mereka miliki membuat perbandingan ini menjadi sangat jelas. Sol menawarkan keunggulan ekonomi. Astra memiliki keunggulan resmi dalam hal kemampuan.
Metrik penentu bukanlah sekadar harga token atau prestise model saja. Ukur biaya per hasil yang diterima dalam batasan operasional dan anggaran yang sesungguhnya. Jika Sol lolos dengan tingkat keberhasilan yang serupa, laju input dan output yang tidak tersimpan dalam cache—yang lima kali lebih rendah—sulit untuk diabaikan. Jika Astra mampu mencegah kegagalan, mengurangi kebutuhan tinjauan ahli, atau menyelesaikan tugas yang tidak dapat diselesaikan oleh Sol, premi tersebut dapat dibenarkan. Mulailah dengan tugas yang identik, jaga agar evaluasi tetap buta sejauh mungkin, dan promosikan hanya model serta upaya penalaran yang benar-benar layak mendapat tempatnya.









