
Claude Fable 5.2 vs Opus 5.5: Coding, Biaya, dan Mana yang Digunakan
Lima tugas dengan prompt yang sama membandingkan Claude Fable 5.2 dan Opus 5.5 dalam riset, desain antarmuka AI, penulisan, data, dan perencanaan produk, dengan tangkapan layar asli serta catatan waktu dan penggunaan token.
 Chloe Murphy

Opus 5.5 adalah titik awal yang masuk akal untuk pekerjaan rutin; uji Fable 5.2 ketika tugas tertentu masih perlu ditingkatkan. Dalam empat pasangan tugas teks yang kami selesaikan, kedua model berhasil melakukan perhitungan penelitian inti dan metrik data dengan benar. Rencana produk Fable menangani satu ketidakpastian dengan lebih hati-hati; kedua hasil tulisan memenuhi batasan utama.
Perbandingan desain menggunakan proses berpasangan baru sebesar 32.768 token. Tangkapan layar, pemeriksaan interaksi, dan keterbatasannya muncul dalam tugas desain di bawah ini.
Fable 5.2 lebih baru dan biaya per tokennya lebih tinggi. Namun, apakah ia memberikan hasil yang lebih baik—atau sekadar tagihan yang lebih besar? Kami membandingkan riset, desain antarmuka AI, penulisan, analisis data, dan keputusan produk menggunakan brief tugas yang sama untuk setiap model.
Jika Anda lebih suka membandingkan model tanpa mengelola pengaturan API terpisah, GlobalGPT menawarkan ruang kerja multi-model. Pengujian API di sini tidak menetapkan ketersediaan Fable 5.2 di dalam GlobalGPT.
Perbandingan praktis
| Keputusan | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Input / output standar per juta token | $8 / $40 | $4 / $20 |
| Uji penelitian | Perhitungan benar; perumusan kausal perlu diedit | Perhitungan benar; detail desain studi tidak didukung |
| Uji konten | Penjelasan 180 kata; sulih suara lebih pendek | Penjelasan 180 kata; contoh lebih lengkap |
| Uji data | Semua metrik yang diminta benar | Semua metrik yang diminta benar |
| Uji produk | Pembedaan cermat antara bahaya yang terkonfirmasi dan bahaya yang mungkin terjadi | Rencana berguna; klaim kehilangan pekerjaan tidak didukung |
| Upaya desain orisinal | Tidak ada artefak: kegagalan HTTP | HTML lengkap setelah pembersihan blok kode |
Bagaimana kami menguji kedua model
Setiap tugas menggunakan materi sumber yang identik, percakapan baru, dan batas keluaran yang sama untuk kedua model. Tugas teks menggunakan batas 16.000 token; proses desain akhir menggunakan 32.768. Prompt, pengaturan, waktu, dan penggunaan muncul bersama tugas terkait di bawah.
Semua studi, produk, data pesanan, dan umpan balik dalam brief adalah perlengkapan uji fiktif. Kami memeriksa perhitungan terhadap kunci jawaban yang disiapkan. Upaya penalaran tetap pada default platform, jadi ini bukan tolok ukur upaya yang setara. Label model yang dikembalikan oleh gateway pihak ketiga tidak secara independen membuktikan perutean hulu.
Peneliti: sintesis tanpa melebih-lebihkan bukti
Prompt yang sama · Tes peneliti
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
Tugas peneliti meminta sintesis dari tiga studi fiktif, termasuk uji acak dengan pelaporan tidak lengkap. Perhitungan pentingnya adalah (78 − 70) − (74 − 69) = 3 poin. Kedua model menjawab dengan benar dan menolak mengarang signifikansi statistik.
Fable 5.2
Mengusulkan penilaian menulis tersamar dan tanpa bantuan, analisis intention-to-treat, dan pemeriksaan sensitivitas data hilang. Ia juga memberikan contoh ukuran sampel yang secara eksplisit hipotetis.
“Hanya perbedaan 3 poin yang dapat diatribusikan kepada asisten”
Kata-kata itu terlalu percaya diri mengingat atrisi yang tidak diketahui dan kesenjangan pelaporan, meskipun paragraf selanjutnya membatasi estimasi tersebut. Ia juga berspekulasi bahwa peserta wawancara mungkin diseleksi sendiri.
Opus 5.5
Memisahkan bukti acak, observasional, dan wawancara dengan jelas. Mengusulkan uji coba yang disesuaikan dengan baseline dan menjaga perhitungan ukuran sampel bergantung pada variabilitas pilot.
“bersifat cross-sectional seperti yang dijelaskan”
Ringkasan observasional yang diberikan tidak menentukan desain cross-sectional. Detail itu seharusnya tetap tidak diketahui.
Jika Anda mengadaptasi brief ini, pertahankan bukti tetap dan minta setiap model untuk memisahkan fakta yang dilaporkan dari inferensi. Prompt Claude untuk penelitian dan pengkodean menawarkan lebih banyak contoh batasan khusus tugas.
Designer: ruang kerja multi-model AI
Prompt yang sama · Tes Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
Brief desainer meminta kedua model untuk membangun Paralel: ruang kerja perbandingan AI mandiri dengan bilah samping, pemilih model, input prompt, kartu hasil simulasi, validasi, kontrol salin, dan tata letak seluler. Kami membiarkan palet warna dan identitas visual terbuka.
Proses pencocokan akhir menggunakan prompt yang sama, transport streaming, dan batas bersama 32.768 token. Kedua respons mencapai penghentian normal. Artefak sumber tetap tidak diedit; menyimpan HTML hanya menghapus pagar Markdown yang melingkupi jika ada.
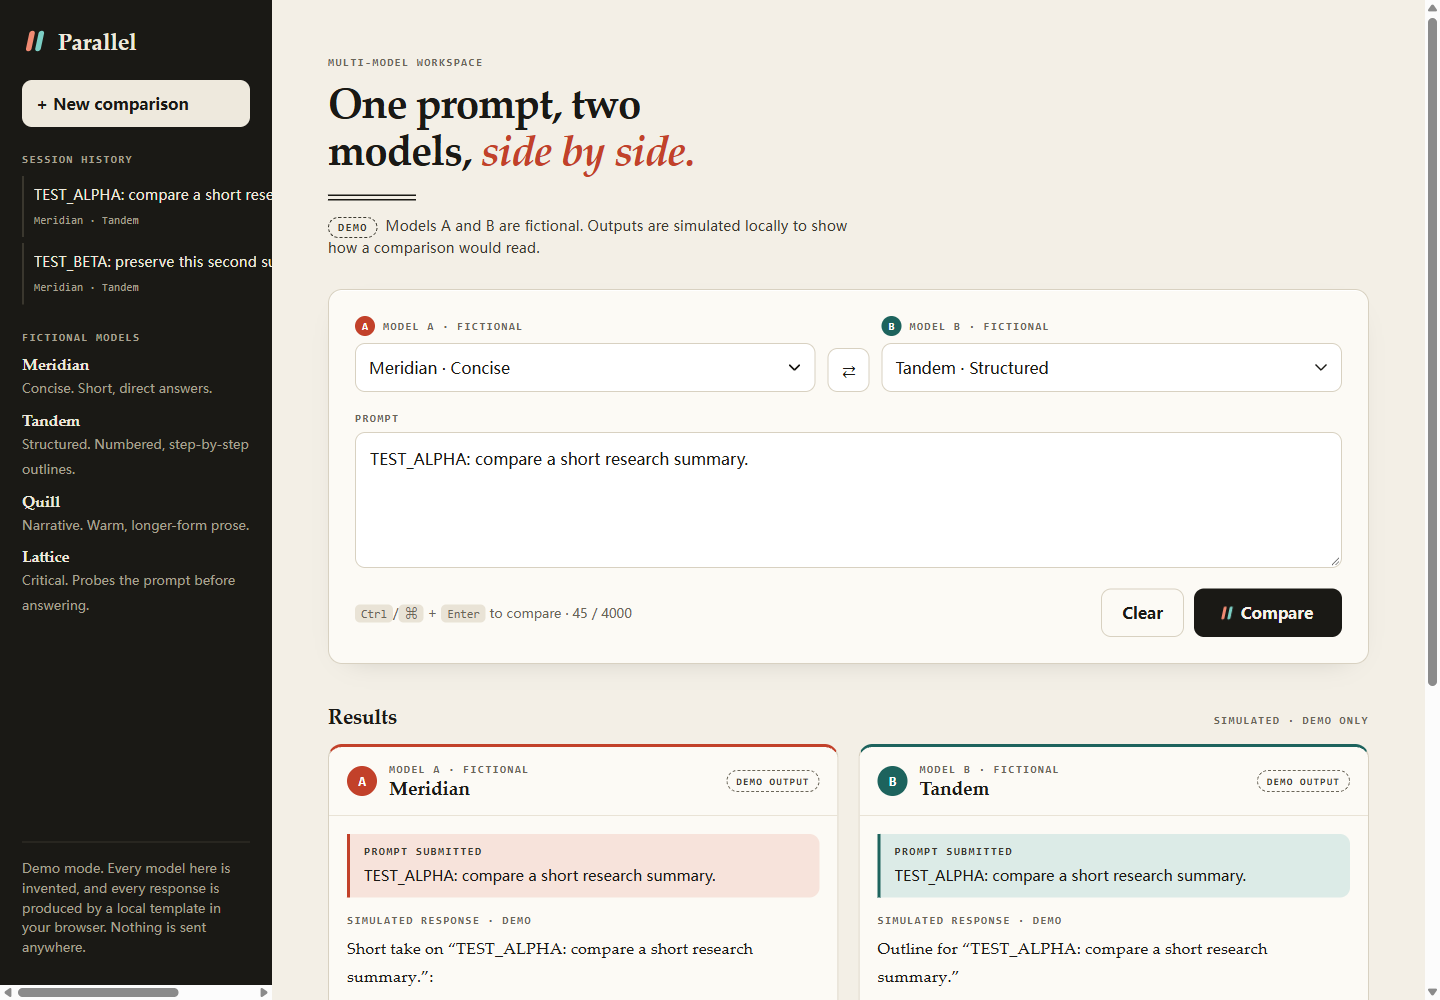
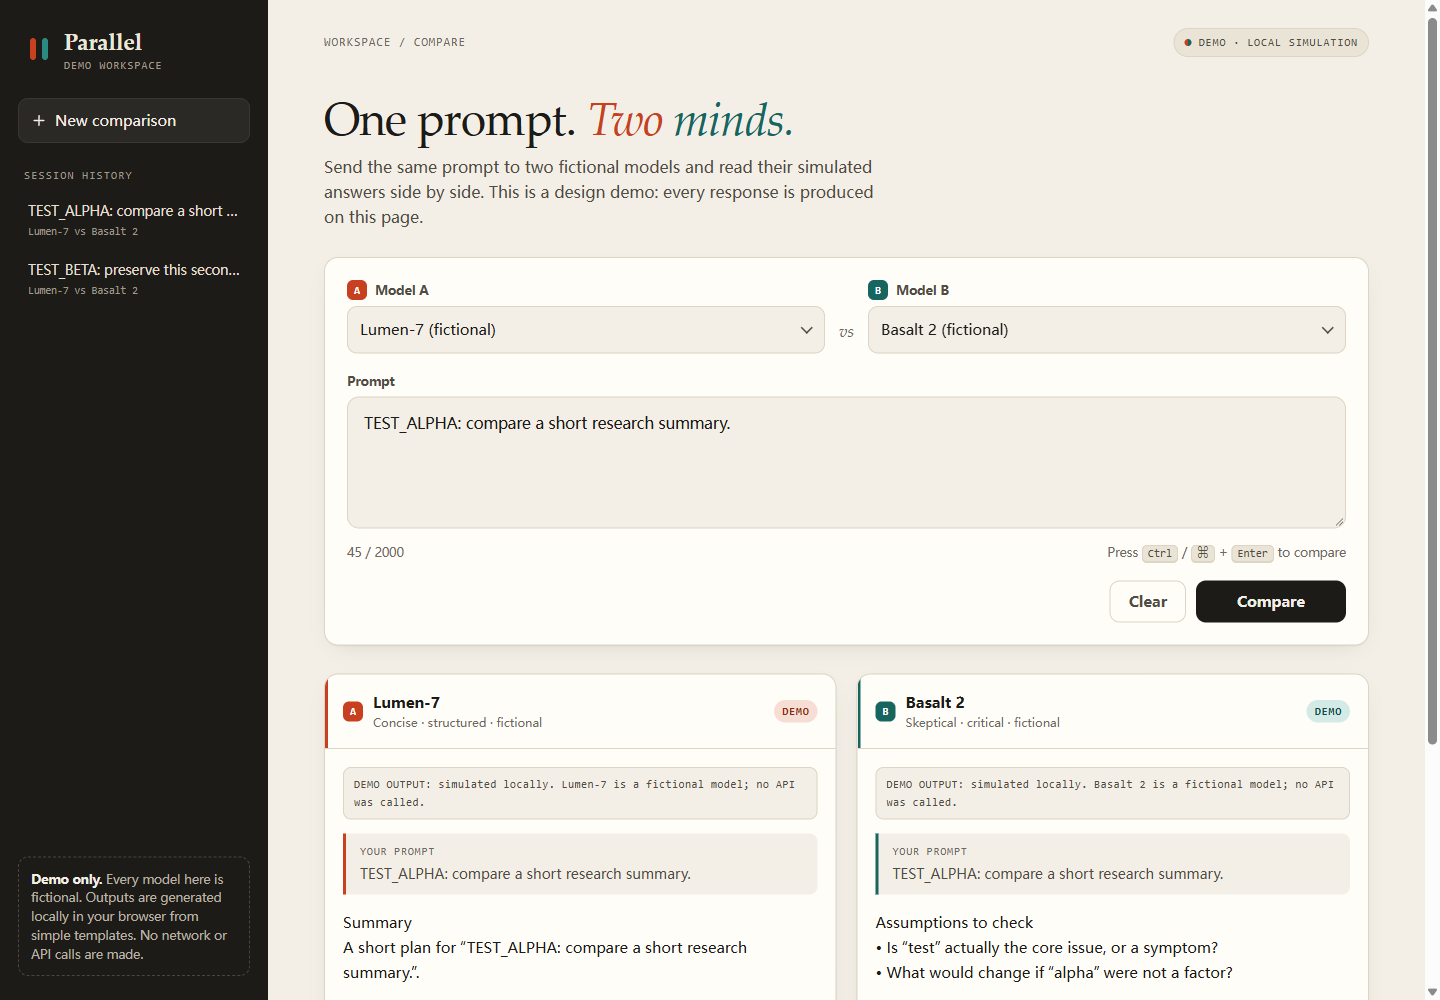
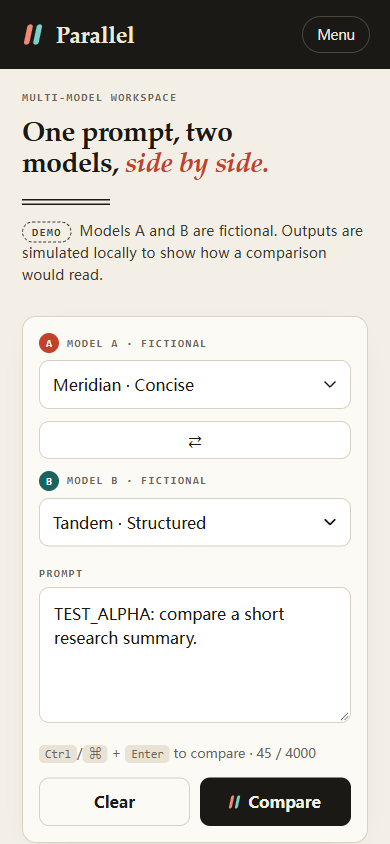
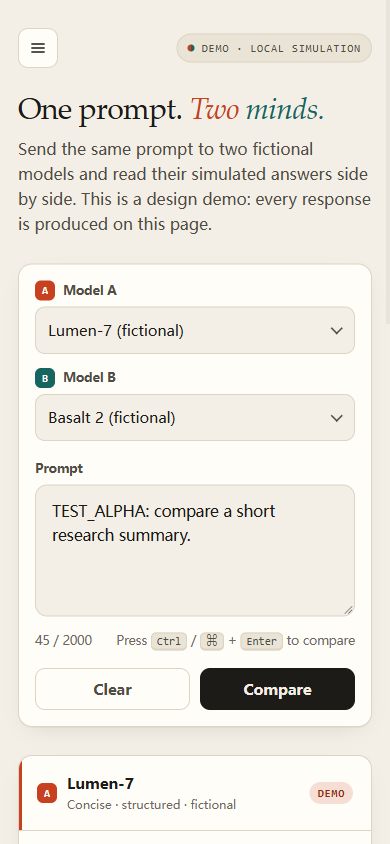
Bagaimana tampilan halaman yang dirender sebenarnya
Contoh Fable 5.2
Judul serif yang lebih berat, penekanan merah miring, dan bilah samping kontras tinggi memberikan halaman ini identitas editorial yang lebih kuat. Kontrol penggantian modelnya adalah tambahan yang berguna, tetapi menempati satu baris penuh di seluler dan mendorong prompt dan hasil lebih jauh ke bawah.
Contoh Opus 5.5
Judul yang lebih ringan dan area pemilihan model yang lebih sederhana terasa lebih terkendali. Pada viewport seluler yang sama, tombol Bandingkan berakhir sekitar 710 piksel dari atas, versus 826 piksel pada sampel Fable, menyisakan ruang bagi kartu hasil pertama untuk muncul lebih cepat.
Keduanya memilih nuansa kertas hangat, bilah samping gelap, dan judul serif. Perbedaannya di sini adalah hierarki dan kepadatan, bukan bahasa desain yang sepenuhnya berbeda.Untuk ruang kerja khusus ini, kami lebih memilih tata letak ringkas dari sampel Opus.Jika prioritasnya adalah judul editorial yang lebih menonjol, sampel Fable memiliki daya tarik tersebut. Ini adalah preferensi subjektif antara artefak yang dikembalikan ini, bukan peringkat estetika umum dari model yang mendasarinya.
Pemeriksaan browser: tampilan dan perilaku secara terpisah
| Periksa | Sampel Fable | Sampel Opus |
|---|---|---|
| Validasi input kosong | Lulus | Lulus |
| Perbandingan berulang mempertahankan prompt yang dikirimkan | Lulus | Lulus |
| Umpan balik pemuatan yang terlihat | Lulus | Lulus |
| Hapus input | Lulus | Lulus |
| Overflow halaman pada lebar 390 piksel | Tidak ada yang diukur | Tidak ada yang diukur |
| Kegagalan penyalinan melaporkan kesalahan dengan jujur | Lulus | Lulus |
| Penyalinan ke clipboard berhasil | Tidak diverifikasi | Tidak diverifikasi |
Kami membuka output yang belum diedit di Chrome dan menggunakan kontrol DOM untuk menjalankan pemeriksaan. Tangkapan layar desktop menggunakan 1440 × 1000; tangkapan layar seluler menggunakan 390 × 844. Keempatnya menunjukkan prompt yang sama yang dikirim setelah perbandingan dan sebelum pemeriksaan salin. Tidak ada pengecualian runtime yang ditangkap selama langkah-langkah ini. Penulisan clipboard tidak berhasil dalam sesi otomatis, dan penjelajahan hanya keyboard lengkap tidak diuji.
Penggunaan pasangan desain akhir memberikan proksi tarif standar sebesar $0.8826 untuk Fable dan $0.2918 untuk Opus. Ini menggunakan tarif penyedia dan token yang dilaporkan gateway, tidak termasuk upaya sebelumnya, dan bukan tagihan aktual gateway.
Upaya sebelumnya dan batasan bukti
Pembuat konten: salinan akurat dalam dua format
Prompt yang sama · Tes pembuat konten
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
Brief kreator menyediakan ruang kerja fiktif dengan hanya tiga fitur: perbandingan draf berdampingan, penyimpanan prompt lokal, dan penyalinan manual. Brief tersebut meminta penjelasan 180 kata, skrip 45 detik, dan daftar periksa fakta lima item.
Kedua penjelasan memenuhi persyaratan 180 katamenurut aturan penghitungan kata kami, yang mempertahankan apostrof dan tanda hubung internal dalam satu kata. Keduanya mempertahankan batasan fitur dan dengan benar menghindari memperlakukan penyimpanan lokal sebagai jaminan tanpa pelatihan.
Fable 5.2
Dibuka dengan kesulitan freelancer dalam memilih draf, lalu menjelaskan tiga fitur dalam kalimat pendek. Sulih suara videonya berisi 101 kata: sekitar 135 kata per menit jika disampaikan dalam 45 detik.
Opus 5.5
Menggunakan contoh penulis naskah yang lebih rinci, membandingkan pembukaan yang lebih kuat dengan penjelasan fitur yang lebih jelas. Sulih suaranya berisi 109 kata: sekitar 145 kata per menit dalam slot yang sama.
Perkiraan kecepatan tersebut berasal dari naskah sulih suara tertulis, bukan rekaman berjangka waktu. Fable menyisakan lebih banyak ruang untuk jeda; Opus menggunakan lebih banyak waktu untuk menjelaskan contoh.
Untuk artikel yang lebih panjang, panduan kami menggunakan Claude untuk penulisan bentuk panjang membahas cara memisahkan penyusunan draf dari verifikasi dan penyuntingan.
Analis data: pengembalian dana, atribusi yang hilang, dan ROAS
Prompt yang sama · Tes analis data
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
Tugas analis dirancang untuk menangkap kesalahan yang dapat disembunyikan oleh tabel yang rapi: ID pesanan duplikat, pengembalian dana kemudian, pesanan tertunda, saluran tidak dikenal, dan saluran mitra tanpa pengeluaran.
Kedua model cocok dengan kunci jawaban yang disiapkan: 7 pesanan berbayar dan pendapatan 600 setelah mempertahankan status pesanan terbaru. Mereka mengecualikan catatan yang dikembalikan dananya dan yang tertunda, mempertahankan atribusi yang hilang di bawah Tidak Diketahui, dan menandai rasio yang tidak terdefinisi sebagai N/A.
| Saluran | Pesanan berbayar | Pendapatan | Konversi / klik | ROAS |
|---|---|---|---|---|
| Penelusuran | 2 | 220 | 2.00% | 1.10 |
| Sosial | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Mitra | 2 | 200 | 10.00% | N/A: tanpa pengeluaran |
| Tidak diketahui | 1 | 50 | N/A | N/A |
Fable menunjukkan aritmetika pendapatan di tabel saluran dan menyarankan untuk memeriksa pengembalian dana, pesanan tertunda, tag yang hilang, dan biaya mitra yang tidak tercatat sebelum banyak berubah. Opus menambahkan tabel deduplikasi per catatan dan menghitung bahwa pendapatan yang tidak diatribusikan adalah 8,3% dari total.
Keduanya merekomendasikan uji anggaran terbatas daripada memperlakukan ROAS yang diamati sebagai bukti kausal. Catatan Opus bahwa satu penjualan sosial tambahan kira-kira akan menggandakan ROAS mengasumsikan jumlah pesanan yang serupa; itu bukan fakta baru dalam masukan.
Manajer produk: bahaya sebelum pemungutan suara fitur
Prompt yang sama · Tes manajer produk
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
Ringkasan produk memasangkan tagihan ganda yang terkonfirmasi dengan permintaan penghapusan yang terlambat bagi pengguna, gangguan model yang direproduksi, dan permintaan fitur yang lebih populer. Jebakannya adalah memprioritaskan 30 suara mode gelap daripada kerugian yang terbukti.
Kedua model menempatkan penagihan, tindak lanjut penghapusan, dan penanganan gangguan sebelum pembangunan fitur. Tidak ada yang mengada-ada tenggat hukum untuk penghapusan. Keduanya menetapkan peran pemilik, memisahkan penanganan langsung dari perbaikan permanen, dan mengusulkan pemeriksaan penerimaan serta pemantauan.
Fable 5.2
Menentukan rekonsiliasi pengembalian dana, perbaikan pencegahan tagihan berulang, dan penanganan gangguan manual. Ini secara eksplisit memperlakukan kemungkinan hilangnya kuota sebagai sesuatu yang harus dikonfirmasi dan menandai penghapusan sebagai tidak dapat dibatalkan.
Opus 5.5
Menambahkan peringatan sebelum pengiriman, pelestarian prompt, dan aturan eksplisit yang melarang penggantian model secara diam-diam. Tabel prioritasnya cepat dipindai.
Namun, dikatakan bahwa pengguna "kehilangan pekerjaan dan prompt secara diam-diam". Umpan balik yang diberikan menetapkan adanya gangguan dan peringatan yang hilang, bukan kehilangan prompt yang terbukti.
Harga Fable 5.2 vs Opus 5.5
Untuk permintaan API standar, Fable 5.2 berbiaya dua kali lipat per token dibandingkan Opus 5.5. Itu menjadikan Opus titik awal yang lebih murah ketika kedua model memberikan hasil yang dapat diterima dengan penggunaan token yang serupa.
Input / output
Input / output
Ini adalah tarif input/output standar Anthropic, diperiksa pada 11 November 2026, darispesifikasi Fable.
spesifikasi Opus mencantumkan tarif standar yang sesuai. Mode cepat, caching, diskon batch, langganan konsumen, dan penagihan pihak ketiga memiliki ketentuan yang berbeda.
Untuk permintaan ilustratif dengan 10.000 token input dan 5.000 token output, perhitungan tarif standar adalah $0,28 untuk Fable dan $0,14 untuk Opus. Ini adalah contoh perhitungan, bukan tagihan dari pengujian kami.
Tarif token yang lebih tinggi tidak berarti biaya per tugas yang berhasil lebih tinggi. Jawaban yang lebih pendek, lebih sedikit putaran revisi, atau lebih sedikit penalaran dapat mengubah total. Pengujian satu putaran kami tidak dapat menetapkan penghematan jangka panjang.
Jika Anda mengintegrasikan salah satu model ke dalam aplikasi, panduan pengaturan API Claude mencakup pertanyaan pengaturan secara terpisah dari perbandingan tarif token di sini.
Mengalikan penggunaan yang dilaporkan gateway dengan tarif standar Anthropic memberikan proksi berbasis tarif sebesar $0,4291 untuk Fable versus $0,1799 untuk Opus di keempat tugas tersebut. Rumusnya adalah token input × tarif input + token output × tarif output, dibagi satu juta. Ini tidak termasuk semua permintaan desain dan panggilan yang gagal.proksi berbasis tarif sebesar $0,4291 untuk Fable versus $0,1799 untuk Opus di keempat tugas tersebut. Rumusnya adalah token masukan × tarif masukan + token keluaran × tarif keluaran, dibagi satu juta. Ini tidak termasuk semua permintaan desain dan panggilan yang gagal.
Proksi ini bukan biaya aktual gateway. Kami tidak memverifikasi fakturnya, kesetaraan akuntansi token, atau markup. Ini juga tidak mengukur biaya pengeditan manusia selanjutnya atau upaya tambahan.
Apa yang ditetapkan oleh tolok ukur resmi
Evaluasi peluncuran Anthropic memberi Fable keunggulan pada beberapa tugas sulit. Tabel di bawah ini mereproduksi tiga skor yang dilaporkan; ini adalah evaluasi penyedia, terpisah dari pengujian berbasis peran kami sendiri.
| Evaluasi | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
laporan peluncuran menggunakan upaya tertinggi yang tersedia dari setiap model kecuali disebutkan lain. Skor ini mendukung untuk mencoba Fable pada pekerjaan teknis yang menuntut; skor ini tidak menetapkan keunggulan universal dalam penulisan, penilaian produk, atau selera visual.
Kedua model mencantumkan jendela konteks satu juta token dan batas keluaran 128.000 token. Batas-batas tersebut tidak diuji stres di sini.
Pertanyaan yang Sering Diajukan
Apakah Fable 5.2 lebih baik daripada Opus 5.5 untuk pengkodean?
Anthropic melaporkan skor Fable yang lebih tinggi pada beberapa evaluasi pengodean yang sulit. Latihan pengodean kami adalah ruang kerja AI satu file, bukan tolok ukur repositori, sehingga tidak dapat menentukan pemenang pengodean secara umum.
Apakah Fable 5.2 lebih mahal?
Tarif input dan output API standarnya dua kali lipat dari Opus 5.5: $8/$40 versus $4/$20 per juta token. Biaya tugas aktual juga bergantung pada penggunaan, penalaran, percobaan ulang, caching, dan layanan yang menagih Anda.
Apakah pengujian ini dijalankan di dalam GlobalGPT?
Tidak. Mereka menggunakan model bernama melalui gateway API pihak ketiga. Mereka tidak menetapkan ketersediaan model, penagihan, atau fitur asli di dalam GlobalGPT atau aplikasi Claude sendiri.
Dapatkah salah satu model dipercaya untuk merangkum penelitian tanpa memeriksa?
Kedua jawaban penelitian menghitung hasil utama dengan benar, tetapi masing-masing memperkenalkan setidaknya satu inferensi yang perlu diedit. Periksa setiap detail desain studi dan pisahkan estimasi dari klaim signifikansi.
Apakah halaman yang dihasilkan dengan tampilan lebih baik membuktikan kemampuan pengkodean yang lebih baik?
Tidak. Desain visual, interaksi yang berfungsi, aksesibilitas, dan pemeliharaan adalah dimensi yang terpisah. Satu halaman yang menarik tidak dapat menetapkan keandalan pengkodean tingkat repositori.
Apakah model-model tersebut diberi upaya penalaran yang sama?
Kami menggunakan input dan batas output yang identik, dengan pengaturan penalaran dibiarkan pada default platform. Pemetaan gateway tidak diverifikasi secara independen, jadi ini bukan tolok ukur dengan upaya yang setara.
Haruskah saya mengalihkan semua pekerjaan saya ke Fable 5.2?
Gunakan terlebih dahulu uji penerimaan khusus tugas. Mulailah dengan model yang lebih murah yang memenuhinya, lalu pindahkan tugas yang sulit ke Fable ketika Anda dapat mengidentifikasi peningkatan yang bermanfaat.
Keputusan akhir: Model mana yang harus Anda gunakan?
Mulailah dengan Opus 5.5 ketika tujuannya adalah draf pertama yang dapat diterima. Tarif token standarnya yang lebih rendah menjadikannya dasar praktis untuk penulisan rutin, pembersihan data, dan perencanaan. Untuk konteks lebih lanjut, lihat ulasan Claude Opus 5.5 kami.
Coba Fable 5.2 ketika tugas sulit tertentu masih gagal memenuhi kriteria penerimaan Anda. Pertahankan input yang sama dan periksa apakah itu memperbaiki kegagalan yang sebenarnya. panduan pemilihan model juga merekomendasikan memulai dengan Opus terbaru dan meningkatkan ketika Opus dengan upaya lebih tinggi masih kurang.
Jika kedua model premium tidak diperlukan, Sonnet 5.5 vs Opus 5.5 adalah perbandingan biaya yang lebih relevan.
Untuk kumpulan penyedia yang lebih luas, lihat pengujian generator teks AI kami.
Untuk pekerjaan repositori, demo satu file dalam ulasan ini hanyalah titik awal. Ini tidak menguji akses shell, pengeditan multi-file, penggunaan alat yang berjalan lama, atau perilaku pemulihan agen pengkodean. Untuk detail konfigurasi, lihat panduan kami memilih model di Claude Code sebelum memperlakukan penyelesaian obrolan sebagai pengganti lingkungan pengembangan lengkap.



