Perbandingan Model Claude: Haiku vs Sonnet vs Opus, dan Di Mana Posisi Fable
Ariette Wynn
Terakhir Diperbarui pada 9 September 2026
Panduan praktis tahun 2026 untuk memilih berdasarkan kecepatan, biaya API, konteks, kompleksitas tugas, dan konsekuensi dari jawaban yang salah.
Untuk sebagian besar pekerjaan sehari-hari seperti menulis, menganalisis, membuat kode, dan menggunakan alat, mulailah dengan Claude Sonnet 5. Pilih Haiku 4.5 jika latensi rendah dan volume tinggi lebih diutamakan daripada penanganan kasus-kasus khusus yang rumit. Pilih Opus 5 jika tugasnya rumit, sulit diverifikasi, atau konsekuensi kesalahannya sangat besar. Fable 5.1 berada di atas Opus sebagai jalur eskalasi khusus, bukan sebagai pilihan default.
Rekomendasi tersebut ditujukan untuk beban kerja campuran secara umum. Panduan produksi Anthropic menyebutkan bahwa sebagian besar beban kerja sebaiknya dimulai dengan Opus 5, sementara matriks tugasnya sendiri secara terpisah menempatkan Sonnet untuk pekerjaan sehari-hari yang mengutamakan kecepatan dan kemampuan. Oleh karena itu, titik awal yang tepat bergantung pada toleransi risiko dan proses evaluasi Anda, bukan hanya pada nama modelnya.
GlobalGPT memperluas alur kerja Praktis dengan satu langganan yang terjangkau: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3, dan berbagai fungsi AI berbagi satu dasbor untuk penelitian, penulisan, analisis, pemrograman, dan penyempurnaan. CLI-nya juga dapat mengintegrasikan akses ke model tersebut ke dalam terminal Anda, alur kerja pengembangan, dan alat produksi yang sudah ada. Membandingkan hasil merupakan salah satu bagian yang berguna dalam alur kerja; untuk pilihan yang lebih luas pada tingkat keluarga model, lihat Perbandingan ChatGPT vs Claude vs Gemini. Bagian selanjutnya dari panduan ini akan membahas pemilihan dalam rentang Claude.
Keempat tingkatan yang ada saat ini mengatasi masalah ekonomi yang berbeda-beda. Panggilan termurah tidak selalu berarti tugas yang diselesaikan dengan biaya termurah, dan model terkuat tidak otomatis menjadi pilihan terbaik dalam memanfaatkan anggaran.
Panduan Pengambilan Keputusan Model Claude
Pilih berdasarkan beban kerja dan biaya kegagalan
Gunakan Sonnet untuk pekerjaan sehari-hari yang seimbang, turunkan levelnya untuk efisiensi, dan naikkan levelnya saat verifikasi sulit dilakukan atau kesalahan dapat menimbulkan kerugian besar.
Haiku 4.5
Efisiensi diutamakan
Mulailah dari sini untuk tugas-tugas dengan volume tinggi, sensitif terhadap latensi, dan memiliki batasan yang jelas, di mana biaya untuk mendeteksi dan memperbaiki kesalahannya relatif rendah.
Naik ke tingkat berikutnya saatKasus-kasus khusus atau waktu yang dibutuhkan peninjau untuk melakukan koreksi menghilangkan keunggulan harga token tersebut.
Soneta 5
Keseimbangan sehari-hari
Digunakan untuk tugas-tugas yang menggabungkan penulisan, analisis, pemrograman, pemahaman visual, dan penggunaan alat, yang tetap akan dinilai seperti biasa.
Naik ke tingkat berikutnya saatPenalaran jangka panjang, verifikasi, atau biaya kegagalan menjadi faktor pembatas.
Opus 5
Kemampuan diutamakan
Mulailah dari sini untuk pemrograman agen yang kompleks, pekerjaan skala perusahaan, diagnosis yang rumit, atau keputusan yang konsekuensinya sangat besar jika salah.
Geser ke bawah saatSebuah model yang lebih murah berulang kali lulus uji penerimaan yang sama.
Fable 5.1
Jalur pengecualian
Lakukan eskalasi hanya jika diperlukan penalaran yang rumit atau pekerjaan agen yang memakan waktu lama, ketika Opus yang membutuhkan upaya lebih besar tetap tidak lolos evaluasi Anda.
Jangan berasumsiTingkat yang lebih tinggi secara otomatis menjadi lebih murah setelah mempertimbangkan kualitas, waktu peninjauan, dan jumlah percobaan ulang.
Aturan praktis
Bekukan satu tugas representatif beserta pemeriksaan penerimaannya. Pilih model termurah yang dapat lulus uji secara andal, lalu hitung waktu koreksi dan verifikasi sebelum menyimpulkan bahwa itu adalah opsi termurah.
Jajaran Model Claude Saat Ini
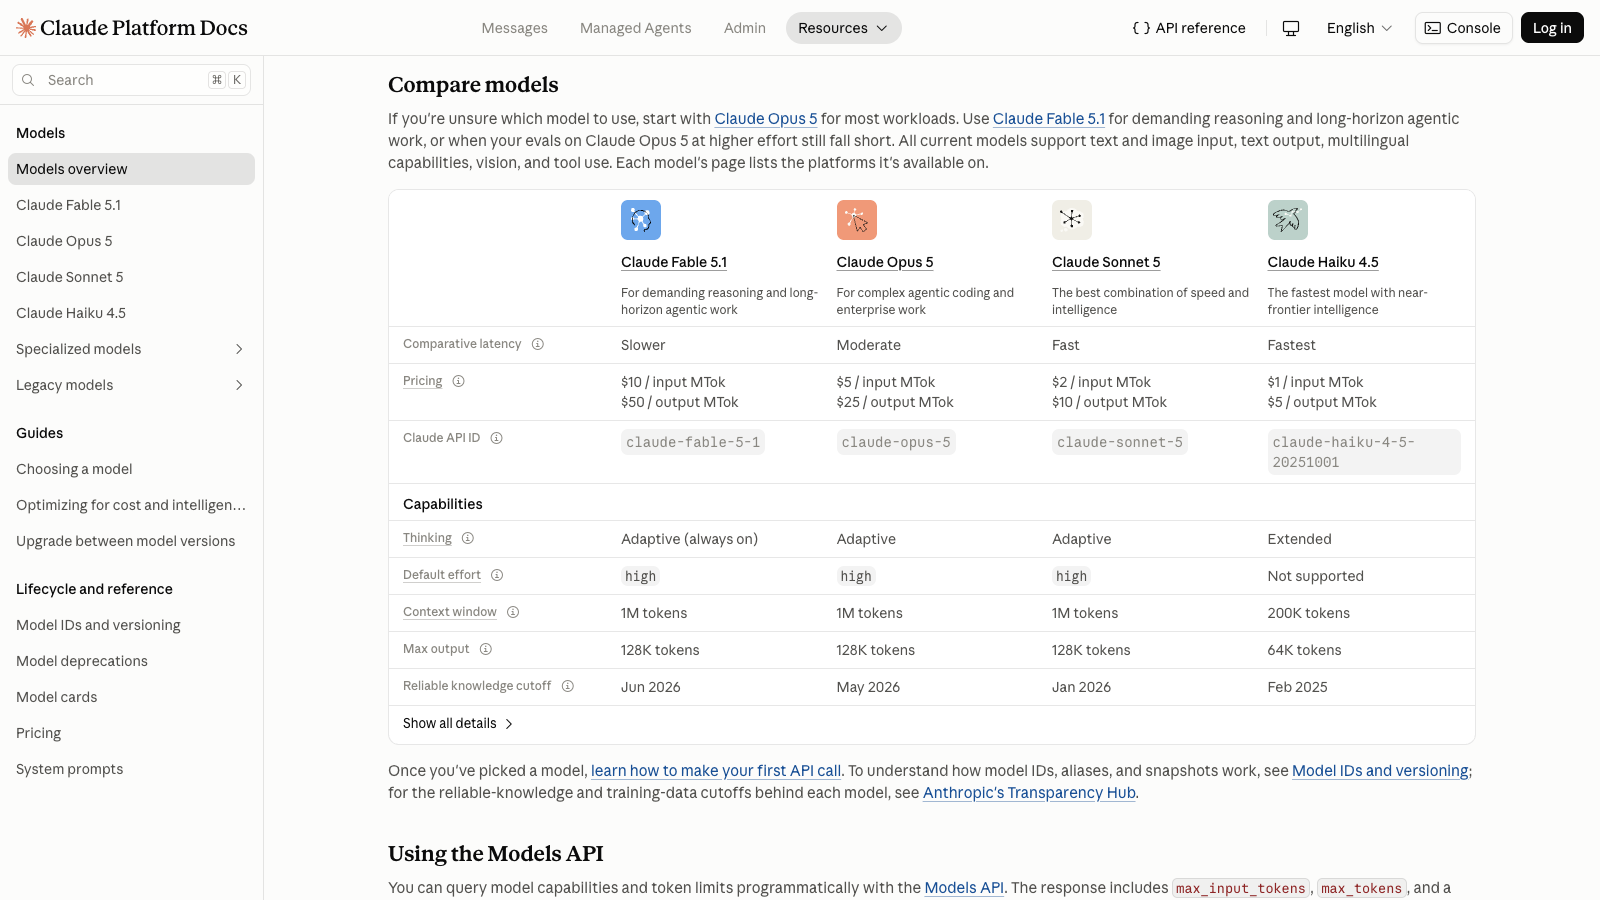
Per 8 September 2026, jajaran produk aktif Anthropic meliputi Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5, dan Claude Fable 5.1. Haiku, Sonnet, dan Opus adalah nama keluarga yang tetap, tetapi versi yang terkait dengan masing-masing keluarga berubah seiring waktu. Tandai ID model yang tepat yang Anda evaluasi dalam produksi, alih-alih mengasumsikan bahwa label keluarga akan selalu mengarah ke snapshot yang sama.
Model saat ini
Label kecepatan resmi
Konteks API
Output maksimum
Masukan/keluaran API dasar
Haiku 4.5
Tercepat
200 ribu
64K
$1 / $5 per MTok
Soneta 5
Cepat
1M
128 KB
$2 / $10 per MTok
Opus 5
Sedang
1M
128 KB
$5 / $25 per MTok
Fable 5.1
Lebih lambat
1M
128 KB
$10 / $50 per MTok
Daftar ringkasan model Anthropic mencantumkan Haiku 4.5, Sonnet 5, Opus 5, dan Fable 5.1 sebagai jajaran produk terkini per 8 September 2026.
Akses ke Claude.ai tidak sama dengan spesifikasi API
Tabel paket Claude.ai menjelaskan akses konsumen dan saat ini mencantumkan jendela konteks sebesar 200K untuk setiap paket. Dokumentasi API mencantumkan batasan konteks dan keluaran khusus model, termasuk jendela konteks sebesar 1M untuk Sonnet 5, Opus 5, dan Fable 5.1. Jangan gunakan tabel API untuk menyimpulkan apa saja yang termasuk dalam rencana Claude.ai tertentu, atau gunakan tabel rencana konsumen untuk menyimpulkan batasan model API. Lihat Panduan Harga dan Paket Claude untuk pembedaan pada tingkat rencana.
Claude Haiku vs Sonnet vs Opus: Perbedaan Utama
Pertimbangan utamanya bukanlah sekadar peringkat kualitas. Semakin tinggi levelnya, semakin besar kemampuan yang dimiliki untuk menangani pekerjaan yang kompleks, tetapi hal itu juga meningkatkan biaya token dasar dan umumnya memperlambat kecepatan. Batasan konteks dan kontrol penalaran juga berbeda-beda.
Pertimbangan praktis
Label resmi dan spesifikasi API dasar, disertai dengan panduan praktis untuk beban kerja umum.
Dimensi
Haiku 4.5
Soneta 5
Opus 5
Titik awal yang terbaik
Pekerjaan yang cepat, berulang, dan terbatas
Pekerjaan berbasis pengetahuan sehari-hari yang bersifat campuran
Pekerjaan yang rumit dan berisiko tinggi
Label kecepatan resmi
Tercepat
Cepat
Sedang
Konteks / keluaran API
200K / 64K
1M / 128K
1M / 128K
Pengendalian penalaran
Pemikiran yang diperluas secara manual
Pemikiran adaptif dan upaya
Pemikiran adaptif dan upaya
Harga dasar API
Masukan $1 / Keluaran $5
Masukan $2 / Keluaran $10
Masukan $5 / keluaran $25
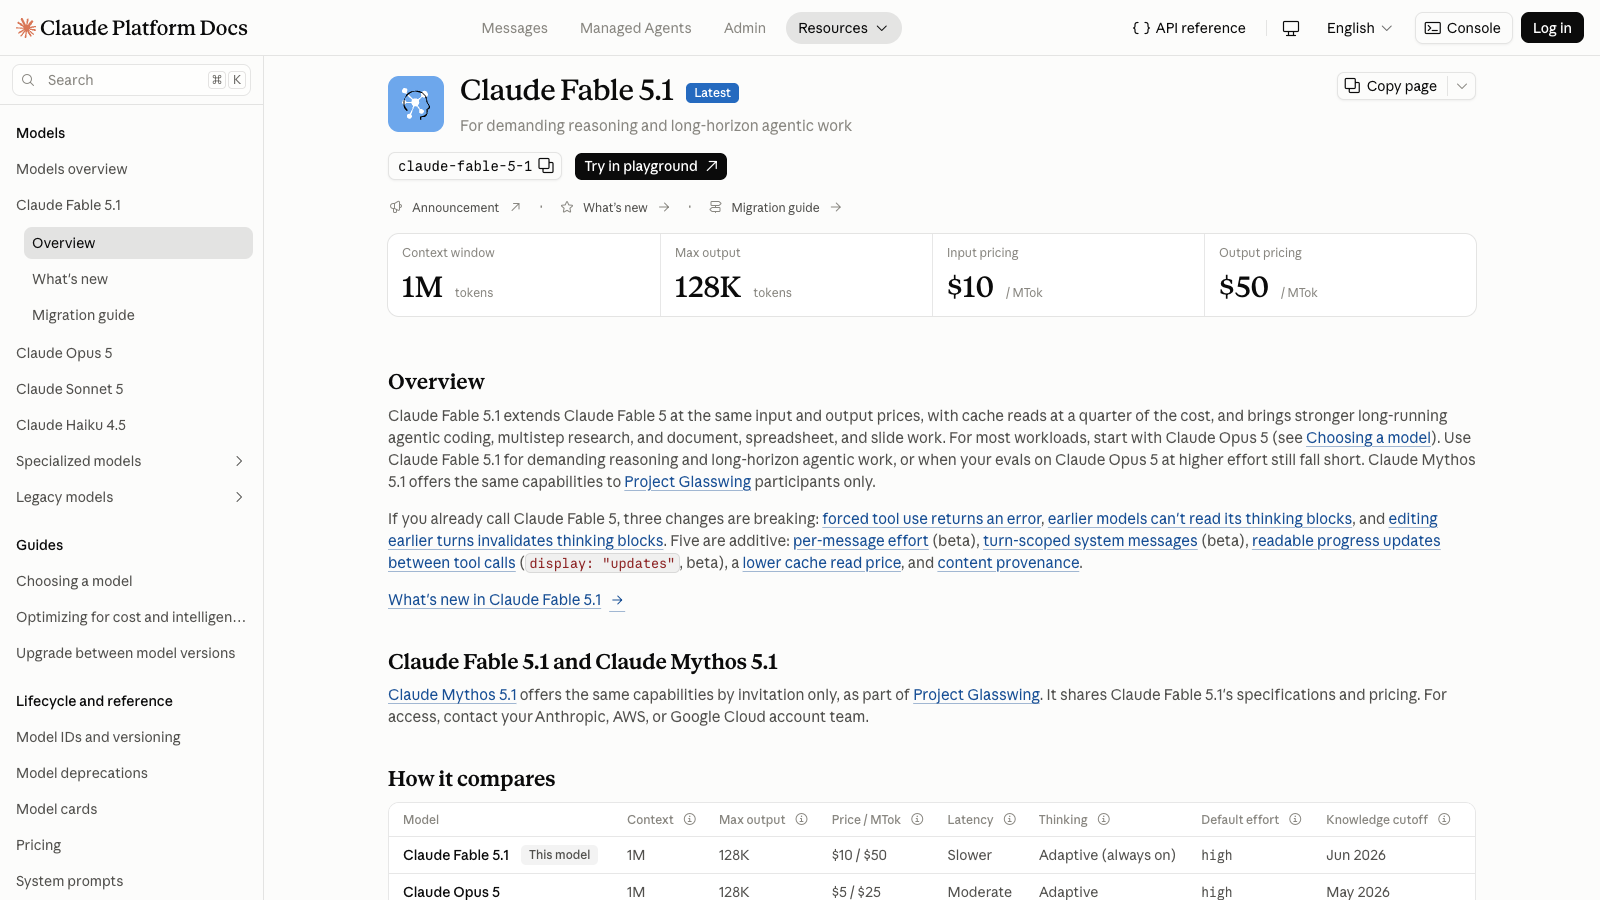
Di mana Fable cocok: Fable 5.1 secara resmi diberi label "Slower", dengan konteks 1M, output maksimum 128K, serta tarif dasar input/output $10 / $50 per juta token. Gunakan ini sebagai tingkatan eskalasi jika Opus dengan tingkat upaya yang lebih tinggi tetap gagal memenuhi kriteria evaluasi Anda.
Kecepatan dan latensi
Label Anthropic untuk Haiku 4.5 adalah “Tercepat,” Sonnet 5 “Cepat,” Opus 5 “Sedang,” dan Fable 5.1 “Lebih Lambat.” Label-label ini bersifat kualitatif, bukan hasil pengukuran dalam milidetik atau token per detik. Latensi aktual bergantung pada ukuran permintaan, pengaturan penalaran, alat yang digunakan, beban sistem, dan mode penyajian.
Kontrol konteks, hasil, dan penalaran
Konteks API Haiku yang lebih kecil (200K) dan batas keluaran maksimum 64K masih cukup besar untuk banyak tugas dengan batasan tertentu. Sonnet dan Opus memperluas kedua batas tersebut menjadi 1M dan 128K. Haiku 4.5 menggunakan pemikiran ekstensif manual, sedangkan Sonnet 5 dan Opus 5 mendukung pemikiran adaptif dan pengendalian upaya. Perbedaan tersebut merupakan salah satu alasan mengapa pengaturan penalaran yang identik tidak dapat menghasilkan tes yang sepenuhnya setara di seluruh model.
Model Claude mana yang sebaiknya Anda gunakan untuk setiap tugas?
Beban kerja
Mulailah dengan
Mengapa
Tingkatkan saat
Klasifikasi, ekstraksi, penyaluran, dan triase dukungan
Haiku 4.5
Latensi rendah dan biaya token dasar yang rendah cocok untuk pekerjaan yang jelas dan dapat diulang.
Kasus-kasus khusus atau waktu koreksi menghilangkan penghematan tersebut.
Keseimbangan antara kecepatan, kemampuan, konteks, dan biaya untuk pekerjaan campuran.
Proses penalaran atau verifikasi jangka panjang menjadi kendala utama.
Pemrograman yang rumit, diagnosis yang sulit, agen otonom
Opus 5
Kemampuan lebih penting daripada harga per token yang paling rendah.
Opus yang membutuhkan upaya lebih besar tetap gagal dalam evaluasi representatif yang ketat.
Karya yang luar biasa, baik yang berdurasi panjang maupun yang sarat dengan pemikiran
Fable 5.1
Itu adalah jalur eskalasi saat ini di atas Opus.
Gunakan hanya jika manfaat yang diukur sebanding dengan biayanya yang lebih tinggi.
Ini hanyalah titik awal, bukan solusi yang cocok untuk semua kasus. Misalnya, perubahan kode yang singkat namun berisiko tinggi mungkin lebih cocok menggunakan Opus, sementara pekerjaan ekstraksi yang panjang namun sangat terstruktur mungkin masih lebih sesuai dengan Haiku. Untuk contoh alur kerja praktis, lihat panduan kami mengenai menggunakan Claude untuk pengkodean.
Apabila daftar pendek Anda melampaui Claude, GlobalGPT memungkinkan Anda menjalankan prompt representatif yang sama melalui Claude, GPT-5.6 Sol, Gemini 3 Pro, dan Kimi K3 dalam satu ruang kerja. Pertahankan kriteria penerimaan yang konsisten: kecepatan penting untuk pekerjaan berulang, sementara kualitas jawaban dan waktu koreksi menentukan apakah hasil dengan biaya lebih rendah benar-benar lebih hemat.
Pilihlah berdasarkan Biaya Kegagalan, Bukan Hanya Jenis Tugas
Label tugas menyembunyikan variabel terpenting: apa yang terjadi jika jawabannya salah? Kerangka kerja di bawah ini adalah alat bantu pengambilan keputusan editorial yang didasarkan pada pedoman Anthropic yang mengutamakan efisiensi dan kemampuan. Ini bukanlah tolok ukur Anthropic.
Skala Biaya Kegagalan
Mulailah dari nilai yang lebih rendah jika biaya untuk mendeteksi kesalahan masih terjangkau; mulailah dari nilai yang lebih tinggi jika verifikasi belum lengkap atau biayanya mahal.
Biaya rendah
Contoh Penandaan, perutean, pembersihan draf, ringkasan yang dapat dibalik
Mulai Haiku 4.5
Meningkatkan Ketika waktu koreksi menghilangkan peningkatan efisiensi
Bahan
Contoh Draf yang ditujukan kepada pelanggan, analisis yang telah ditinjau, kode produksi yang telah diuji
Mulai Soneta 5
Meningkatkan Ketika tinjauan tidak dapat secara andal mendeteksi kegagalan-kegagalan penting
Mahal
Contoh Perubahan dengan tingkat otonomi tinggi, diagnosis yang sulit, keputusan yang berdampak besar
Mulai Opus 5
Meningkatkan Ke Fable hanya setelah Opus yang membutuhkan usaha lebih besar gagal dalam evaluasi beku
Kapan Harus Mengupgrade atau Menurunkan Versi Model Claude Anda
Naikkan hanya jika batas yang telah ditentukan muncul
Haiku hingga Soneta
Lakukan peningkatan jika kasus-kasus khusus, kegagalan instruksi, atau waktu koreksi peninjau melebihi penghematan yang diperoleh.
Soneta untuk Opus
Lakukan peningkatan ketika pelaksanaan jangka panjang, penalaran yang kompleks, verifikasi, atau biaya kegagalan menjadi kendala.
Opus dengan tingkat kesulitan yang lebih tinggi
Uji beban kerja yang berat dengan serangkaian pemeriksaan penerimaan yang telah disiapkan sebelumnya sebelum beralih ke tingkatan teratas.
Opus ke Fable
Lakukan eskalasi hanya jika Opus yang membutuhkan upaya lebih besar tetap gagal dalam evaluasi representatif dan manfaatnya sebanding dengan biayanya.
Aturan penurunan peringkat: Kembalilah ke model yang lebih rendah ketika model yang lebih murah secara berulang kali lulus pemeriksaan penerimaan yang sama dengan latensi dan keandalan yang disyaratkan.
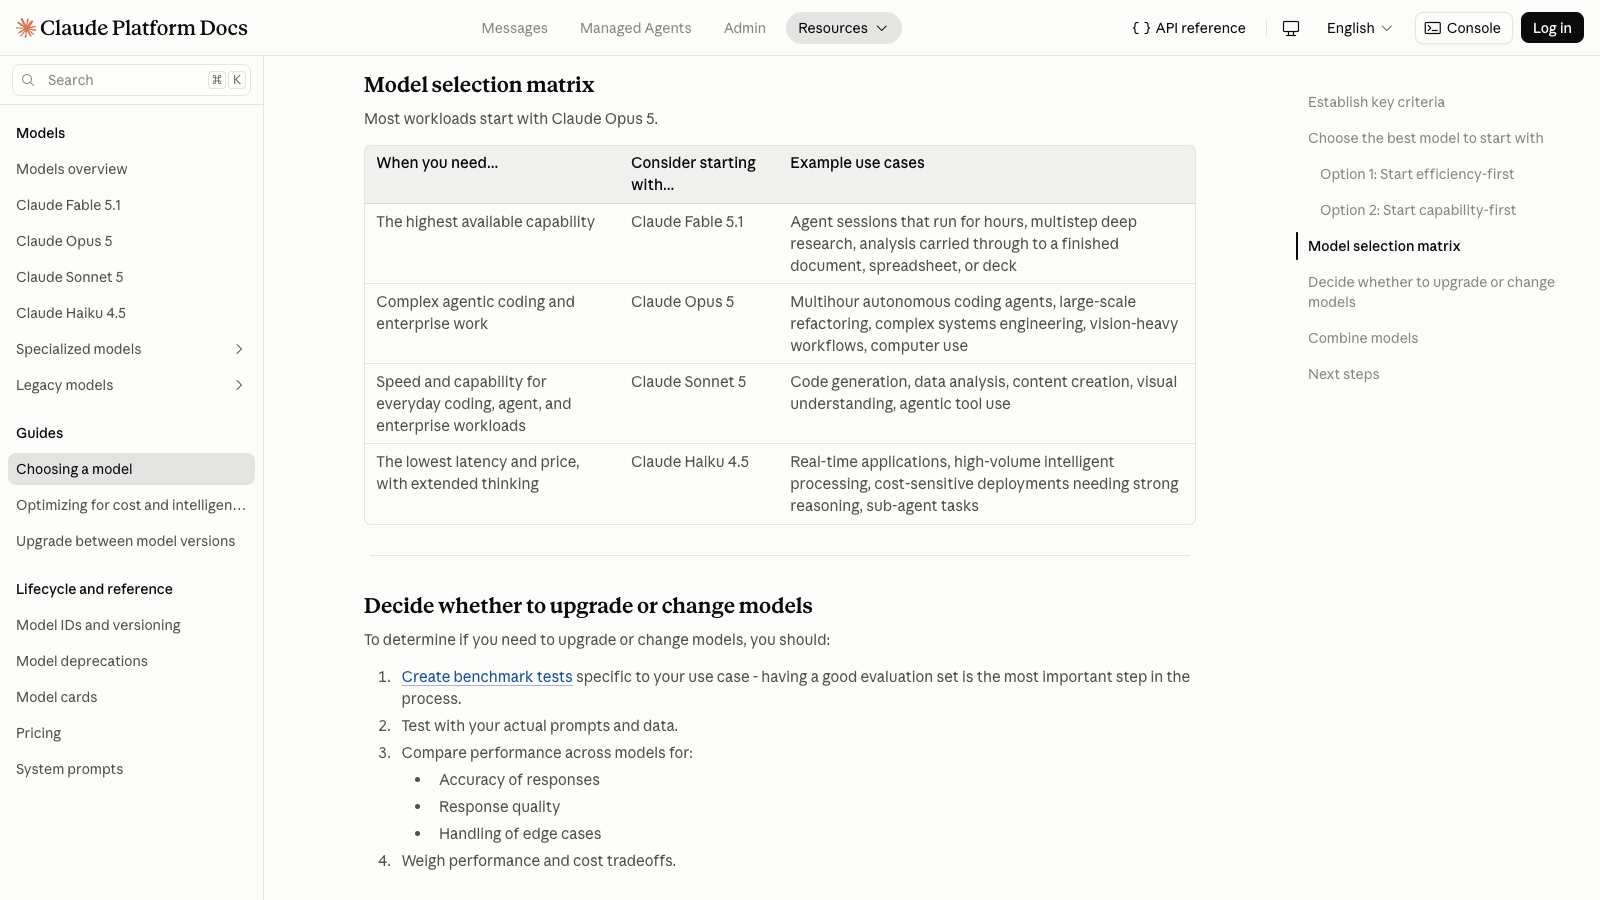
Matriks Anthropic memetakan empat model Claude yang ada saat ini ke berbagai kebutuhan kemampuan, kecepatan, dan beban kerja.
Contoh Biaya API Tetap Claude
Untuk beban kerja agregat tetap sebesar 1 juta token masukan ditambah 100.000 token keluaran yang tersebar di beberapa permintaan API standar, biaya token dasar berkisar antara $1,50 dengan Haiku 4.5 hingga $15,00 dengan Fable 5.1. Ini bukan satu permintaan, dan tidak menggantikan batas keluaran per permintaan.
Satu beban kerja, empat model Claude
Volume token yang sama berharga 2 kali, 5 kali, atau 10 kali lipat dari total Haiku seiring Anda naik ke tingkatan yang lebih tinggi.
Beban kerja 1,0 juta masukan + 0,1 juta keluaran melintasi beberapa permintaan
Haiku 4.5
$1.50
Soneta 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Model
Perhitungan masukan
Perhitungan keluaran
Total
Haiku 4.5
1,0 × $1
0,1 × $5
$1.50
Soneta 5
1,0 × $2
0,1 × $10
$3.00
Opus 5
1,0 × $5
0,1 × $25
$7.50
Fable 5.1
1,0 × $10
0,1 × $50
$15.00
Termasuk: Tingkat token input dan output dasar standar dari satu cuplikan harga Anthropic.
Tidak termasuk: Penyimpanan sementara prompt, API Batch, mode cepat, lokasi geografis, biaya layanan, pajak, diskon, dan kredit GlobalGPT.
Tabel harga menunjukkan biaya token, bukan biaya hasil akhir. Model yang lebih murah bisa jadi justru lebih mahal jika upaya ulang, koreksi, dan verifikasi memakan waktu staf lebih banyak daripada penghematan yang diperoleh dari token.
Uji Model Claude Secara Praktis: Prompt yang Sama, Mode Kegagalan yang Berbeda
Pada tanggal 9 September 2026, kami mengirimkan tiga prompt yang sama melalui API Anywhere ke Claude Haiku 4.5, Sonnet 5, Opus 5, dan Fable 5.1. Tugas-tugas tersebut mencakup triase dukungan terstruktur, penulisan berbasis bukti, dan debugging JavaScript yang dapat diaudit. Kami menyimpan keluaran valid pertama dari masing-masing model dan mengevaluasinya berdasarkan aturan yang telah ditetapkan sebelum tanggapan-tanggapan tersebut ditinjau.
Hasilnya bukanlah sekadar peringkat biasa. Sonnet, Opus, dan Fable masing-masing meraih skor 26,5 dari 30, sementara kelebihan dan kelemahan masing-masing sangat berbeda. Haiku mengembalikan kode status HTTP 503 pada kedua upaya yang diizinkan untuk setiap tugas, sehingga kualitas hasilnya masih belum diketahui dalam pengujian ini.
Pengaturan pengujian dan hasil secara keseluruhan
Tiga prompt yang dibekukan, batas token pada tingkat tugas yang sama, tanpa alat bantu atau pencarian, dan hasil yang valid pertama disimpan untuk setiap model.
Aturan percobaan ulangSekali untuk pengiriman, 429/5xx, konten kosong, atau respons yang tidak valid
Model
Tugas yang telah diselesaikan
Skor kualitas total
Sinyal yang paling berguna
Claude Haiku 4.5
0/3
Belum diberi nilai
Keenam permintaan yang diizinkan tersebut semuanya menghasilkan kode status 503; hanya ketersediaan rute saja.
Claude Soneta 5
3/3
26.5/30
Satu-satunya model yang memenuhi semua persyaratan dalam catatan peluncuran.
Claude Opus 5
3/3
26.5/30
Kedalaman debugging yang mendalam; terlewatkan batasan panjang penulisan.
Claude Fable 5.1
3/3
26.5/30
Hasil yang terstruktur dan rapi; catatan peluncuran terpotong setelah satu respons kosong.
Hasil terstruktur
Tes 1: Penyaringan tiket dukungan
Hasil tugas: Fable 5.1, 10/10
Fable adalah satu-satunya model yang menghasilkan JSON yang dapat langsung diparsing dengan keenam label dan tindakan yang benar. Opus dan Sonnet memberikan label yang benar, tetapi menambahkan tanda pembatas Markdown; keduanya juga memperketat satu batas waktu yang ditentukan, dan Sonnet terlalu dini menjanjikan koreksi atau pengembalian dana.
Model
Status
Skor
Latensi di mana pun
Token yang dilaporkan
Apa yang terjadi
Claude Haiku 4.5
Rute tidak tersedia
Belum diberi nilai
Tidak tersedia
Tidak tersedia
Dua respons 503; tidak ada skor kualitas.
Claude Soneta 5
Hasil tetap dipertahankan
7.5/10
10,39 detik
1005
Labelnya benar, tetapi JSON-nya dibatasi dan hasil pengembalian dana/koreksi yang dibuat-buat.
Claude Opus 5
Hasil tetap dipertahankan
8.5/10
11,87 detik
1051
Label yang tepat dan tindakan tegas, namun JSON yang dibatasi dan tenggat waktu yang diperketat.
Claude Fable 5.1
Hasil tetap dipertahankan
10/10
8,55 detik
680
JSON yang dapat diurai secara langsung; semua pemeriksaan "frozen" telah lulus.
Input uji lengkap
Anda mengelola kotak masuk dukungan SaaS. Klasifikasikan setiap tiket di bawah ini. Kembalikan JSON hanya dengan satu bidang tingkat atas bernama `tickets`. `tickets` harus berupa array dalam urutan aslinya, dan setiap item harus berisi tepat `ticket_id`, `category`, `urgency`, dan `action`. `category` harus salah satu dari `billing`, `access`, `bug`, atau `feature`. `urgency` harus salah satu dari `low`, `medium`, atau `high`. Gunakan hanya teks tiket; jangan membuat-buat hasil kebijakan atau fakta pelanggan.

#481: Kami dikenakan biaya dua kali untuk perpanjangan tahunan yang sama. Penutupan penggajian dilakukan pada hari Jumat dan saya ingin hal ini diselidiki sebelum tanggal tersebut.
#482: Fitur reset kata sandi menyatakan bahwa email telah terkirim, tetapi saya tidak menerima apa pun. Saya sudah memeriksa folder spam dan mencoba kembali sekali.
#483: Ekspor CSV membulatkan setiap jumlah mata uang ke dolar utuh, sementara dasbor masih menampilkan sen.
#484: Tolong tambahkan mode gelap ke dasbor analitik.
#485: Setelah domain perusahaan kami berubah pagi ini, setiap karyawan menerima pesan penolakan akses SSO.
#486: Bisakah Anda mengirimkan salinan faktur bulan lalu kepada saya?
Claude Haiku 4.5: hasil operasional penuh
Tidak ada hasil model yang dihasilkan. Kedua upaya pemanggilan API Anywhere yang diizinkan mengembalikan kode status HTTP 503, sehingga rute ini ditandai sebagai tidak tersedia dan dikecualikan dari penilaian kualitas.
Claude Sonnet 5: keluaran penuh
```json
{
  "tiket": [
    {
 "id_tiket": "#481",
      "category": "billing",
 "urgency": "high",
 "action": "Selidiki tagihan perpanjangan tahunan yang terduplikasi dan terbitkan koreksi/pengembalian dana sebelum penutupan penggajian pelanggan pada hari Jumat."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "Verifikasi alamat email akun dan kelancaran pengiriman email, lalu aktifkan atau kirim ulang email reset kata sandi secara manual."
    },
    {
 "ticket_id": "#483",
      "kategori": "bug",
 "tingkat urgensi": "sedang",
 "tindakan": "Escalate ke tim teknik untuk memperbaiki pembulatan ekspor CSV agar nilai mata uang sesuai dengan presisi hingga sen yang ditampilkan di dasbor."
    },
    {
 "ticket_id": "#484",
 "category": "fitur",
 "urgency": "rendah",
 "action": "Catat permintaan mode gelap untuk dasbor analitik dan tambahkan ke daftar fitur produk yang tertunda."
    },
    {
 "ticket_id": "#485",
      "kategori": "akses",
 "urgensi": "tinggi",
 "tindakan": "Segera selidiki konfigurasi SSO yang terkait dengan perubahan domain perusahaan dan pulihkan akses bagi semua karyawan yang terdampak."
    },
    {
      "id_tiket": "#486",
 "kategori": "penagihan",
 "urgensi": "rendah",
 "tindakan": "Cari faktur bulan lalu dan kirim salinannya ke pelanggan."
    }
  ]
}
```
Claude Opus 5: output penuh
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "penagihan",
 "urgency": "tinggi",
 "action": "Escalate ke bagian penagihan untuk memverifikasi tagihan perpanjangan tahunan yang terduplikasi dan memastikan penyelesaiannya sebelum penutupan penggajian pelanggan pada hari Jumat."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "Periksa log pengiriman email untuk pesan reset ke alamat tersebut dan, jika tidak terkirim, jalankan jalur reset yang terverifikasi untuk pengguna."
    },
    {
 "ticket_id": "483",
      "kategori": "bug",
 "urgensi": "sedang",
 "tindakan": "Laporkan bug terkait pembulatan mata uang pada ekspor CSV, dengan mencatat ketidaksesuaian dengan nilai di dasbor, serta minta langkah-langkah reproduksi atau contoh ekspor."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "Catat sebagai permintaan fitur mode gelap untuk dasbor analitik dan konfirmasikan penerimaan tanpa menjanjikan jadwal."
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "Tingkatkan statusnya sebagai gangguan SSO di seluruh organisasi yang terkait dengan perubahan domain; minta tim identitas/otentikasi untuk segera meninjau konfigurasi domain SSO."
    },
    {
      "id_tiket": "486",
 "kategori": "penagihan",
 "urgensi": "rendah",
 "tindakan": "Kirimkan salinan faktur bulan sebelumnya yang diminta kepada kontak akun yang terverifikasi."
    }
  ]
}
```
Claude Fable 5.1: output penuh
{"tiket":[{"id_tiket":"481","kategori":"penagihan","tingkat_kegentingan":"tinggi","tindakan":"Selidiki laporan mengenai tagihan perpanjangan tahunan yang terduplikasi dan berikan tanggapan sebelum batas waktu pembayaran gaji pelanggan pada hari Jumat."},{"ticket_id":"482","kategori":"akses","urgensi":"sedang","tindakan":"Periksa log pengiriman email reset kata sandi untuk alamat pengguna tersebut dan kirim ulang atau berikan cara reset alternatif."},{"ticket_id":"483","category":"bug","urgency":"medium","action":"Ulangi proses ekspor CSV yang membulatkan jumlah mata uang ke dolar utuh dan eskalasikan ke tim engineering untuk diperbaiki."},{"ticket_id":"484","category":"feature","urgency":"low","action":"Catat permintaan mode gelap untuk dasbor analitik bersama tim produk dan konfirmasikan penerimaannya."},{"ticket_id":"485","category":"access","urgency":"tinggi","action":"Escalate kesalahan penolakan akses SSO di seluruh perusahaan akibat perubahan domain dan tinjau konfigurasi domain SSO."},{"ticket_id":"486","category":"penagihan","urgency":"rendah","action":"Cari dan kirimkan salinan faktur bulan lalu kepada pelanggan."}]}
Kebijakan "First-valid-output". Latensi yang dimaksud adalah waktu jam dinding melalui Anywhere, bukan latensi asli Anthropic. Jumlah token dilaporkan oleh penyedia; tidak ada biaya API langsung yang dapat disimpulkan dari rute ini.
Pemenuhan batasan
Tes 2: Catatan peluncuran berbasis bukti
Hasil tugas: Sonnet 5, 10/10
Sonnet adalah satu-satunya model yang memenuhi semua persyaratan yang ditetapkan. Opus menghasilkan catatan yang kuat, namun melebihi batas jumlah kata dan menyimpulkan bahwa semua yang tidak merespons adalah mahasiswa yang terdaftar. Respons pertama Fable kosong; saat diberi kesempatan mencoba kembali, model tersebut menghasilkan catatan yang terlihat terpotong tanpa rekomendasi atau peringatan.
Model
Status
Skor
Latensi di mana pun
Token yang dilaporkan
Apa yang terjadi
Claude Haiku 4.5
Rute tidak tersedia
Belum diberi nilai
Tidak tersedia
Tidak tersedia
Dua respons 503; tidak ada skor kualitas.
Claude Soneta 5
Hasil tetap dipertahankan
10/10
9,94 detik
796
Telah memenuhi persyaratan terkait kata kunci “ruang lingkup”, “struktur”, “bukti”, “rekomendasi”, dan “peringatan”.
Claude Opus 5
Hasil tetap dipertahankan
8/10
9,49 detik
826
Analisis yang kuat, namun masih kurang 223 kata menurut metode penghitungan kata yang dibekukan dan terdapat satu kesimpulan yang tidak didukung bukti.
Claude Fable 5.1
Hasil tetap dipertahankan
6.5/10
19,27 detik
1685
Respons pertama kosong; upaya percobaan ulang yang disimpan terpotong sebelum bagian rekomendasi dan peringatan.
Input uji lengkap
Tuliskan catatan peluncuran internal sebanyak 180–220 kata untuk seorang direktur produk dengan hanya menggunakan fakta-fakta di bawah ini. Sertakan: baris subjek, paragraf pembuka singkat, tepat tiga poin penting, sebuah rekomendasi, dan satu peringatan yang disebutkan dengan jelas. Jangan mengada-ada mengenai keputusan anggaran, persentase, signifikansi statistik, atau hubungan sebab-akibat.

Fakta:
- Program percontohan ini diikuti oleh 120 siswa.
- Pada titik pemeriksaan tanggal 31 Maret, 96 siswa telah menghadiri setidaknya tiga sesi.
- Skor survei rata-rata adalah 4,3 dari 5, berdasarkan 71 responden.
- Lembar operasional program mencantumkan anggaran sebesar $18.000.
- Catatan persetujuan keuangan mencantumkan angka $20.000. Tidak disebutkan apakah selisih tersebut merupakan revisi atau kesalahan pencatatan.
- Peserta tidak ditugaskan secara acak dan tidak ada skor awal yang dikumpulkan.
- Keputusan yang harus diambil adalah apakah akan meluncurkan program percontohan kedua, bukan apakah akan melaksanakannya secara permanen.
Claude Haiku 4.5: hasil operasional penuh
Tidak ada hasil model yang dihasilkan. Kedua upaya pemanggilan API Anywhere yang diizinkan mengembalikan kode status HTTP 503, sehingga rute ini ditandai sebagai tidak tersedia dan dikecualikan dari penilaian kualitas.
Claude Sonnet 5: keluaran penuh
**Subjek: Hasil Program Percontohan — Rekomendasi untuk Melanjutkan ke Program Percontohan Kedua**

Program percontohan awal telah menyelesaikan periode penilaian pertamanya, dan indikator keterlibatan serta kepuasan awal menunjukkan hasil yang menggembirakan. Sebelum memutuskan untuk melanjutkan ke program percontohan kedua, ada beberapa poin data dan hal-hal yang masih perlu dibahas yang harus ditinjau bersama oleh tim.

- Dari 120 siswa yang terdaftar, 96 di antaranya telah menghadiri setidaknya tiga sesi hingga titik pemeriksaan tanggal 31 Maret.
- Survei pasca-sesi yang diisi oleh 71 responden menghasilkan skor rata-rata 4,3 dari 5.
- Angka anggaran tidak konsisten di berbagai dokumen: lembar operasional program mencantumkan $18.000, sedangkan catatan persetujuan keuangan mencantumkan $20.000; belum jelas apakah hal ini mencerminkan revisi atau kesalahan pencatatan.

**Rekomendasi:** Mengingat hasil kehadiran dan survei, kami merekomendasikan untuk melanjutkan ke uji coba kedua guna mengumpulkan data yang lebih terstruktur — idealnya dengan kelompok pembanding yang jelas dan pengukuran awal — sebelum mempertimbangkan keputusan peluncuran yang lebih luas. Uji coba kedua ini juga harus menjadi kesempatan untuk menyelesaikan ketidaksesuaian anggaran dengan bagian keuangan sebelum dana disahkan.

**Peringatan:** Hasil ini harus ditafsirkan dengan hati-hati. Peserta tidak ditugaskan secara acak dan tidak ada skor awal yang dikumpulkan, sehingga kami tidak dapat mengaitkan hasil survei atau pola kehadiran dengan program itu sendiri. Ini adalah keputusan awal untuk uji coba kedua, bukan keputusan mengenai implementasi permanen.
Claude Opus 5: output penuh
**Perihal: Hasil uji coba dan rekomendasi mengenai kelompok uji coba kedua**

Uji coba pertama telah menyelesaikan penilaian pada 31 Maret, dan kini kami memiliki informasi yang cukup untuk memutuskan apakah akan menjalankan uji coba kedua. Catatan ini merangkum apa yang kami amati, rekomendasi kami, serta keterbatasan utama dalam menafsirkan hasil tersebut. Pada tahap ini, belum ada keputusan permanen mengenai peluncuran program.

- **Pendaftaran dan partisipasi:** 120 mahasiswa terdaftar. Hingga titik penilaian 31 Maret, 96 di antaranya telah menghadiri setidaknya tiga sesi.
- **Umpan balik peserta:** Survei pasca-partisipasi mencatat skor rata-rata 4,3 dari 5, berdasarkan 71 responden. Siswa terdaftar lainnya tidak merespons, sehingga skor tersebut hanya mencerminkan kelompok tersebut.
- **Perbedaan anggaran:** Lembar operasional program mencantumkan anggaran sebesar $18.000, sedangkan catatan persetujuan keuangan mencantumkan $20.000. Catatan keuangan tersebut tidak menyebutkan apakah perbedaan tersebut disebabkan oleh revisi atau kesalahan pencatatan, dan kami belum menentukan angka mana yang berlaku.

**Rekomendasi:** Lanjutkan perencanaan uji coba kedua, dengan syarat Bagian Keuangan dan Operasional Program menyamakan kedua angka anggaran tersebut dan mengonfirmasi satu angka yang berlaku sebelum kami mengalokasikan dana. Program percontohan kedua juga harus mengumpulkan skor awal pada saat pendaftaran.

**PERINGATAN:** Peserta tidak ditugaskan secara acak dan tidak ada skor awal yang dikumpulkan. Oleh karena itu, angka-angka keterlibatan dan survei hanya menggambarkan apa yang dilakukan dan dilaporkan oleh kelompok ini; angka-angka tersebut tidak dapat memberi tahu kami apa yang disebabkan oleh program ini atau bagaimana kinerjanya jika diterapkan pada populasi yang berbeda.
Claude Fable 5.1: output penuh
**Perihal:** Ringkasan evaluasi tahap uji coba dan rekomendasi untuk tahap uji coba kedua

Halo [Direktur],

Berikut ini adalah ringkasan perkembangan program uji coba pada evaluasi tanggal 31 Maret, beserta rekomendasi mengenai apakah program ini akan dilanjutkan ke tahap uji coba kedua. Catatan ini hanya membahas keputusan terkait tahap uji coba kedua, bukan peluncuran permanen.

- **Pendaftaran dan kehadiran:** 120 siswa terdaftar. Pada titik pemeriksaan tanggal 31 Maret, 96 di antaranya telah menghadiri setidaknya tiga sesi.
- **Umpan balik peserta:** Sebuah survei menunjukkan skor rata-rata 4,3 dari 5 berdasarkan tanggapan 71 responden.
- **Catatan anggaran:** Lembar operasional program mencantumkan anggaran sebesar $18.000, sedangkan catatan persetujuan keuangan mencantumkan $20.000. Catatan keuangan tersebut tidak menyebutkan apakah selisih tersebut merupakan revisi atau kesalahan pencatatan.

**
Kebijakan "First-valid-output". Latensi yang dimaksud adalah waktu jam dinding melalui Anywhere, bukan latensi asli Anthropic. Jumlah token dilaporkan oleh penyedia; tidak ada biaya API langsung yang dapat disimpulkan dari rute ini.
Keakuratan kode
Tes 3: Debugging JavaScript yang Dapat Diaudit
Hasil tugas: Opus 5 dan Fable 5.1 sama-sama mendapat nilai 10/10
Ketiga model yang tersedia berhasil menemukan cacat dan menghasilkan pengganti yang lolos delapan kasus yang dapat dijalankan. Opus dan Fable menghasilkan JSON yang valid dan sama-sama meraih skor 10/10. Kode Sonnet juga lolos, tetapi tanda pembatas Markdown di sekelilingnya melanggar persyaratan JSON langsung.
Model
Status
Skor
Latensi di mana pun
Token yang dilaporkan
Apa yang terjadi
Claude Haiku 4.5
Rute tidak tersedia
Belum diberi nilai
Tidak tersedia
Tidak tersedia
Dua respons 503; tidak ada skor kualitas.
Claude Soneta 5
Hasil tetap dipertahankan
9/10
13,17 detik
1471
Hasil penggantian lolos pada 8 dari 8 kasus; hasil yang dibatasi kehilangan poin terkait format JSON.
Claude Opus 5
Hasil tetap dipertahankan
10/10
20,17 detik
1826
JSON valid, kedua cacat telah teridentifikasi, dan 8 dari 8 kasus yang dapat dieksekusi berhasil dilalui.
Claude Fable 5.1
Hasil tetap dipertahankan
10/10
15,89 detik
1409
JSON yang valid, diagnosis yang ringkas, dan 8 dari 8 kasus yang dapat dijalankan telah berhasil diselesaikan.
Input uji lengkap
Diagnosis dan perbaiki fungsi JavaScript ini. Kembalikan JSON yang hanya berisi tepat empat bidang: root_cause (string), replacement (string yang berisi fungsi pengganti lengkap), tests (array string kasus uji), dan remaining_risk (string). Jangan menyatakan bahwa Anda telah menjalankan uji coba. Lakukan perbaikan terkecil yang jelas dan memenuhi kontrak.

Kontrak:
- `tasks` adalah array fungsi tanpa argumen yang mengembalikan `Promise`.
- Kembalikan nilai pertama yang terpenuhi sesuai urutan masukan, bahkan jika nilai tersebut adalah 0, `false`, atau string kosong.
- Abaikan tugas yang ditolak.
- Kembalikan `null` jika semua tugas ditolak atau array kosong.

Kode saat ini:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: hasil operasional penuh
Tidak ada hasil model yang dihasilkan. Kedua upaya pemanggilan API Anywhere yang diizinkan mengembalikan kode status HTTP 503, sehingga rute ini ditandai sebagai tidak tersedia dan dikecualikan dari penilaian kualitas.
Claude Sonnet 5: keluaran penuh
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: output penuh
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: output penuh
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Kebijakan "First-valid-output". Latensi yang dimaksud adalah waktu jam dinding melalui Anywhere, bukan latensi asli Anthropic. Jumlah token dilaporkan oleh penyedia; tidak ada biaya API langsung yang dapat disimpulkan dari rute ini.
Hasil Anywhere ini menunjukkan mengapa pemilihan model sebaiknya disesuaikan dengan tugas yang dihadapi, bukan hanya berdasarkan satu papan peringkat saja. Dalam GlobalGPT, Anda dapat menerapkan metode perbandingan yang sama pada prompt Anda sendiri untuk membandingkannya dengan Claude dan model-model terkemuka lainnya, lalu memilih hasil yang paling sesuai dengan standar kualitas, kebutuhan kecepatan, dan beban kerja peninjauan Anda.
Bagaimana cara melakukan perbandingan secara adil
Bekukan tugas yang representatif. Gunakan niat, bahan sumber, akses alat, dan pemeriksaan penerimaan tujuan yang sama.
Catat hasil keluaran pertama yang sah. Jangan diam-diam memberikan kesempatan percobaan ulang tambahan kepada satu model dalam perbandingan utama.
Bedakan kualitas dari ketersediaan. Masalah otentikasi, kapasitas, dan rute harus dicantumkan dalam catatan ketersediaan, bukan dalam skor kualitas.
Ukur seluruh alur kerja. Hitung waktu yang telah berlalu, upaya peninjau, waktu koreksi, dan pemulihan tugas yang gagal.
Pilihlah model yang paling murah. Lakukan pengujian ulang jika ada perubahan pada petunjuk, alat, versi model, atau biaya kegagalan.
Peran GlobalGPT
Posisi Anthropic menempatkan Fable 5.1 pada tugas-tugas yang menuntut ketika evaluasi Opus 5 yang lebih intensif masih belum memadai.
Per 8 September 2026, jajaran produk aktif Anthropic meliputi Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5, dan Claude Fable 5.1. Versi dan ID model yang tepat dapat berubah, jadi periksa kembali ikhtisar model resmi sebelum penerapan.
Apa perbedaan antara Claude Haiku, Sonnet, dan Opus?
Haiku mengutamakan kecepatan dan biaya token dasar yang rendah, Sonnet menyeimbangkan kecepatan dan kemampuan untuk pekerjaan sehari-hari, sedangkan Opus mengutamakan kemampuan untuk tugas-tugas yang kompleks atau berisiko tinggi. Pilihan yang tepat bergantung pada beban kerja dan biaya verifikasi Anda, bukan pada peringkat absolut.
Model Claude mana yang sebaiknya saya gunakan untuk sebagian besar tugas?
Mulailah dengan Sonnet 5 untuk sebagian besar kegiatan sehari-hari seperti menulis, menganalisis, membuat kode, memahami visual, dan menggunakan alat. Gantilah dengan Opus 5 jika risiko kegagalan sangat besar atau pekerjaan tersebut membutuhkan penalaran yang lebih mendalam dan verifikasi yang lebih ketat.
Model Claude mana yang paling cocok untuk pemrograman?
Sonnet 5 merupakan titik awal yang praktis untuk pemrograman sehari-hari dengan proses peninjauan dan pengujian rutin. Gunakan Opus 5 untuk diagnosis yang sulit, pemrograman agen yang kompleks, eksekusi jangka panjang, atau perubahan yang akan menimbulkan konsekuensi serius jika dilakukan dengan salah.
Model Claude mana yang paling cocok untuk menulis?
Sonnet 5 merupakan titik awal yang seimbang untuk sebagian besar proses penulisan dan penyuntingan. Haiku 4.5 cocok untuk teks bervolume besar dan berstruktur ketat, sedangkan Opus 5 layak dicoba untuk sintesis yang rumit atau materi penting yang sulit diverifikasi.
Apakah Claude Sonnet lebih baik daripada Opus?
Tidak selalu demikian. Sonnet 5 lebih cepat dan lebih murah berdasarkan tarif API dasar, sedangkan Anthropic dirancang agar Opus 5 dapat menangani pekerjaan yang lebih kompleks. Model yang lebih baik adalah opsi termurah yang secara andal lolos dari kriteria penerimaan Anda sendiri.
Apakah Claude Fable akan menggantikan Opus?
No. Anthropic menetapkan Fable 5.1 sebagai tingkatan eskalasi untuk kasus yang menuntut penalaran kompleks atau pekerjaan agen yang memakan waktu lama, ketika Opus 5 yang membutuhkan upaya lebih besar masih belum memadai, bukan sebagai pengganti universal untuk Opus.
Apakah Claude.ai dan API Claude memiliki jendela konteks yang sama?
Batas paket No. Claude.ai dan spesifikasi model API merupakan hal yang terpisah. Tabel paket individual Anthropic saat ini mencantumkan jendela konteks sebesar 200 ribu, sedangkan dokumentasi API mencantumkan jendela konteks sebesar 1 juta untuk Sonnet 5, Opus 5, dan Fable 5.1.
Kapan sebaiknya saya melakukan upgrade dari Haiku ke Sonnet atau Opus?
Lakukan peningkatan jika hasil pemeriksaan penerimaan yang gagal, kasus tepi yang rumit, waktu koreksi, upaya verifikasi, atau biaya kesalahan lebih besar daripada keunggulan kecepatan dan harga token yang dimiliki model yang lebih rendah. Kembalilah ke model yang lebih rendah jika model yang lebih murah tersebut berulang kali lulus pemeriksaan yang sama yang telah dibekukan.
Berapa biaya yang dikenakan untuk Claude Haiku, Sonnet, dan Opus melalui API?
Berdasarkan tarif dasar Anthropic yang diverifikasi pada 8 September 2026, Haiku 4.5 membutuhkan $1 sebagai masukan dan $5 sebagai keluaran, Sonnet 5 membutuhkan $2 dan $10, dan Opus 5 membutuhkan $5 dan $25 per juta token. Lihat Anthropic’s halaman harga resmi untuk tarif terkini dan opsi penetapan harga lainnya.
Kesimpulan Akhir: Mulailah dengan Model Termurah yang Memenuhi Syarat
Untuk pekerjaan campuran umum, Sonnet 5 tetap menjadi pilihan default yang paling praktis, dan model ini adalah satu-satunya yang lolos dari setiap batasan catatan peluncuran dalam pengujian kami. Opus 5 dan Fable 5.1 menyamai skor total Sonnet sebesar 26,5/30 melalui keunggulan masing-masing, sementara Haiku 4,5 tidak dapat dinilai karena rute Anywhere mengembalikan kode status 503 pada setiap upaya yang diizinkan. Anggaplah hasil ini sebagai bukti kinerja beban kerja, bukan peringkat universal yang permanen.
Langkah Anda selanjutnya sangat sederhana: tentukan satu tugas nyata, tentukan seperti apa hasil yang memenuhi syarat, uji setiap kandidat yang layak dalam kondisi yang sebanding, dan sertakan waktu koreksi dalam perhitungan biaya akhir. Model yang menang adalah model dengan biaya terendah yang dapat memberikan hasil yang dapat diandalkan, bukan model dengan tarif token terendah atau nama tingkatan tertinggi.
GlobalGPT menjadikan metode tersebut sebagai bagian dari alur kerja AI yang lebih luas dan terjangkau. Gunakan Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3, dan model-model terkemuka lainnya dengan berbagai fungsi AI dalam satu dasbor, lalu terapkan pekerjaan tersebut ke terminal, alur kerja pengembangan, dan alat produksi yang sudah ada melalui CLI GlobalGPT. Pengujian berdampingan membantu Anda memilih; keuntungan utamanya adalah menjaga alur kerja yang lengkap tetap terhubung.
Nano Banana 2.1 vs Pro: bandingkan poster, grafik, gambar produk, dan hasil pengeditan yang dibuat dari prompt yang sama dengan harga resmi API. Lihat hasilnya sebelum memilih model.
GPT-6.1 Sol vs GPT-6 Astra: bandingkan harga, pemrograman, konteks, alat, dan contoh biaya aktual untuk memilih model OpenAI yang tepat sesuai kebutuhan beban kerja Anda.
Pahami arti kata kunci AI Motion Designer for After Effects GPT serta cara GLBGPT memanfaatkan Yukie, Video Editor, prompt, efek, teks keterangan, audio, dan klip yang dihasilkan.
Pelajari cara membuat gambar blog AI dengan sumber-sumber terkini, uji coba praktis, batasan yang jelas, serta langkah yang lebih aman mulai dari percobaan pertama hingga tahap produksi.