
Jawaban singkat: GPT-6 Luna adalah model OpenAI yang dirancang khusus untuk tugas-tugas bervolume tinggi. API resmi mencantumkan tarif $0.10 per 1 juta token masukan dan $0.50 per 1 juta token keluaran pada tarif Standar, dengan jendela konteks 1,05 juta token dan keluaran maksimum 128 ribu. Pertanyaan utama yang perlu dipertimbangkan adalah apakah jawaban yang dihasilkannya memenuhi persyaratan tugas Anda dengan total biaya yang wajar.
OpenAI menggambarkan GPT-6 Luna sebagai model paling efisien untuk tugas-tugas yang terfokus dan bervolume tinggi. Ungkapan tersebut merupakan strategi pemasaran penyedia layanan, bukan skor kualitas yang terukur. Ulasan ini menerjemahkan spesifikasi yang dipublikasikan menjadi keputusan pembelian dan arsitektur, lalu mencatat reaksi publik dengan mencantumkan sumbernya. Kami juga menjalankan tiga tugas kecil dengan ID model, rute, set prompt, hasil mentah, dan penggunaan yang dipertahankan. Hasil tugas tersebut ditampilkan di bawah ini sebagai satu kali eksekusi yang diamati, bukan sebagai tolok ukur resmi.
Kesimpulan singkat
Luna merupakan opsi pragmatis yang mengutamakan efisiensi biaya dalam daftar harga resmi: platform ini mempertahankan konteks utama dan batas keluaran yang sama dengan Sol, namun mengenakan tarif token yang jauh lebih rendah. Hal ini menjadikannya pilihan yang menarik untuk panggilan yang terfokus dan berulang, namun harga yang rendah tersebut tidak menjamin latensi yang lebih rendah atau kualitas yang lebih baik tanpa uji coba terkontrol.
Perbedaan yang paling berguna bukanlah sekadar “cerdas” versus “cepat.” Melainkan bentuk beban kerja. GPT-6 Luna memiliki konteks utama dan batas keluaran yang sama dengan saudaranya, tetapi posisi pasar dan harganya membuat titik operasi yang berbeda menjadi lebih masuk akal. Bandingkan yang lebih luas Panduan pemilihan model AI dan model AI terbaik untuk pengkodean panduan jika tugas tersebut melibatkan lebih dari satu penyedia layanan.
Sekilas tentang GPT-6 Luna
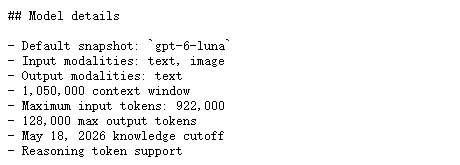
Tabel di bawah ini mengikuti ketentuan yang berlaku saat ini halaman resmi model GPT-6 Luna. Kapasitas konteks tidak sama dengan ukuran prompt yang direkomendasikan, dan batas maksimum input terpisah dari jendela konteks judul.
gpt-6-lunaKedua model yang serupa ini mendukung keluaran terstruktur, pemanggilan fungsi, streaming, penyimpanan sementara prompt, masukan gambar, pencarian berkas, dan pencarian web dalam daftar fitur yang tercantum. Perilaku alat yang sebenarnya tetap bergantung pada titik akhir, akun, dan konfigurasi permintaan; jangan menyimpulkan bahwa alat telah berjalan dengan sukses hanya berdasarkan kotak centang kemampuan.
Untuk konteks tingkat keluarga, Ulasan GPT-6 Astra menunjukkan bagaimana sebuah artikel terkait GPT-6 memisahkan dokumentasi penyedia, rute platform, dan reaksi yang dikaitkan.
Harga GPT-6 Luna dan aturan 272 ribu
Dengan tarif standar, Halaman harga OpenAI mencantumkan $0.10 input, $0.01 input yang disimpan dalam cache, $0.125 penulisan ke cache, dan $0.50 output per 1 juta token. Penulisan ke cache setara dengan 1,25 kali lipat input yang tidak disimpan dalam cache. Harga Batch dan Flex adalah 50% dalam mode Standar, mode Cepat dihitung 2 kali lipat dari tarif yang berlaku, dan pemrosesan regional menambahkan 10% jika tersedia.
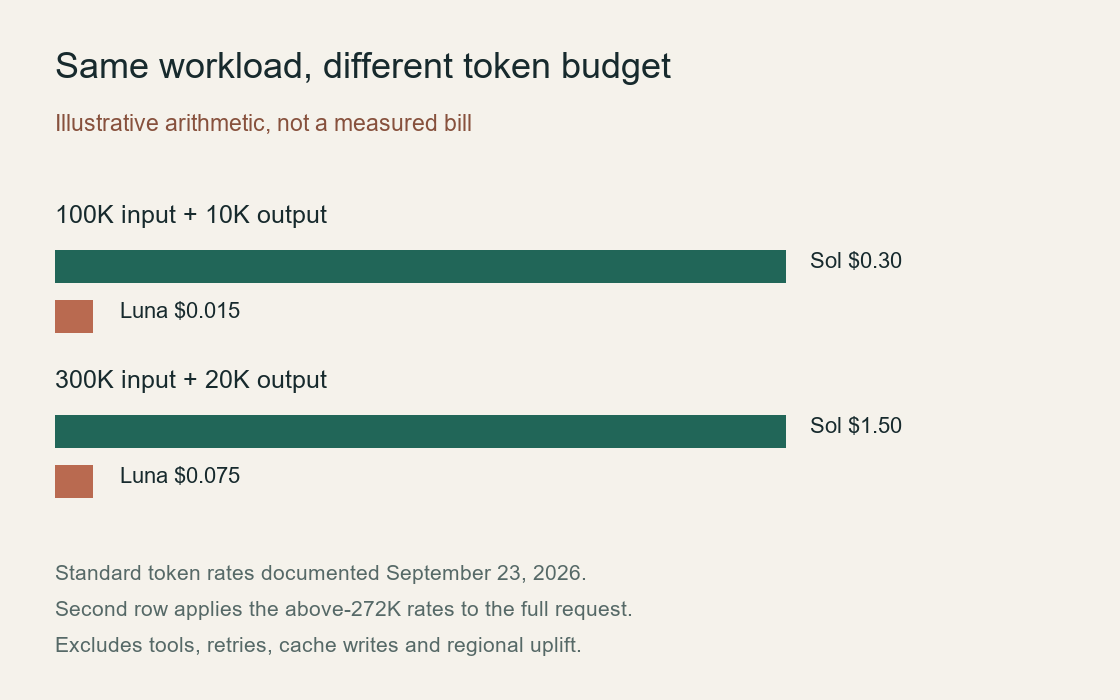
Kolom konteks panjang dihitung berdasarkan aturan OpenAI: jika input melebihi 272 ribu, laju input dan cache menjadi dua kali lipat, sedangkan output dikalikan 1,5 untuk permintaan penuh. Ini bukan tagihan dengan laju campuran. Sebagai patokan anggaran praktis, 100 ribu input ditambah 10 ribu output biayanya sekitar $0.015 sebelum memperhitungkan alat atau kenaikan regional; contoh dengan input 300 ribu ditambah output 20 ribu biayanya sekitar $0.075 pada tarif konteks panjang.
Jendela konteks yang besar bisa berguna, meski tidak mudah diisi. Proses pengambilan data, pemilihan blok, pemanfaatan kembali cache, dan batasan keluaran jauh lebih penting daripada angka 1,05 juta yang tercantum di judul. Lihat Rincian harga GPT-6 Astra untuk penjelasan terkait mengenai ambang batas konteks dan mekanisme cache.
Kesesuaian, alat, dan batasan API GPT-6 Luna
OpenAI merekomendasikan Responses API untuk alat bawaan dan pemanggilan fungsi. Fitur Chat Completions hanya mendukung pemanggilan fungsi jika upaya penalaran akan diatur ke tidak ada. Itu adalah detail implementasi yang perlu diperhatikan sebelum migrasi: sebuah permintaan bisa saja secara sintaksis valid, namun tidak sesuai dengan perilaku alat yang diharapkan oleh integrasi Anda saat ini.
Tabel batas laju saat ini mencantumkan tingkatan Standar berikut ini. RPM berarti permintaan per menit, TPM berarti token per menit, dan nilai antrian merupakan batas token per batch.
Sebelum peluncuran produksi, pastikan untuk memverifikasi tingkatan, titik akhir, mode streaming, dan kontrak alat yang tepat di akun Anda sendiri. Hal ini Panduan Batas Penggunaan Codex merupakan konteks yang berguna untuk menjelaskan mengapa batas maksimum yang dipublikasikan suatu model tidak sama dengan kuota aktual suatu akun.
Apa yang dapat disimpulkan dari spesifikasi GPT-6 Luna
Ini adalah peta kesesuaian, bukan tolok ukur. Gunakan panduan alur kerja model AI serba guna ketika keputusan sesungguhnya yang harus Anda ambil adalah bagaimana mengganti model di dalam satu proses yang dapat diulang, bukan model mana yang terdengar paling meyakinkan.
Dalam pengujian kami: GPT-6 Luna pada tiga tugas praktis
Kami menguji perbaikan kecil pada JavaScript, memo keputusan tiga poin, dan ekstraksi JSON pada tanggal 23 September 2026. Hasil yang disajikan di bawah ini merupakan respons lengkap untuk ID model gpt-6-luna. Upaya-upaya sebelumnya mengalami kesalahan kelebihan beban sementara, sehingga hasil-hasil ini tidak boleh dianggap sebagai pengukuran keandalan pada upaya pertama. Kami mengkaji apa saja yang terkandung dalam jawaban-jawaban tersebut, apa yang dapat dimanfaatkan kembali oleh pembaca, dan apa saja yang masih belum diuji.
Perbaikan kode: mempertahankan nilai nol tanpa menulis ulang fungsi
Tugas pemrograman tersebut meminta diagnosis bug, perbaikan minimal, dan dua uji regresi. Hasil yang ditampilkan adalah hasil percobaan ulang yang telah diselesaikan; teks prompt yang tepat tidak tersedia.
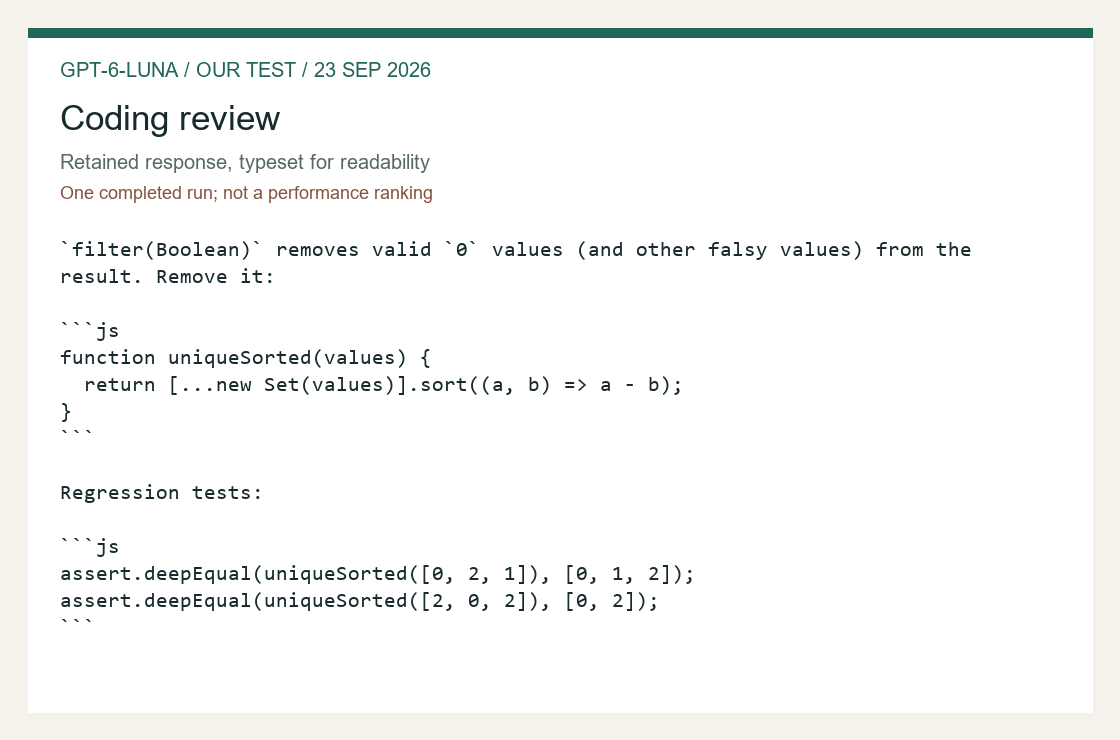
`filter(Boolean)` menghapus nilai `0` yang valid (dan nilai-nilai lain yang bernilai palsu) dari hasil. Hapus baris ini:

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

Uji regresi:

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
Penggunaan yang dilaporkan untuk tanggapan yang telah diselesaikan ini: 61 token masukan, 317 token hasil, total 378 token. Penggunaan kata pelengkap dapat mencakup token penalaran; hal ini bukan sekadar panjang jawaban yang terlihat.
Jawaban Luna yang sudah selesai tersebut dengan tepat menunjukkan bahwa filter(Boolean) menghapus nilai nol yang valid dan menghapus operasi terakhir tersebut. Respons tersebut tetap mempertahankan deduplikasi berbasis himpunan dan pembanding numerik yang sudah ada. Untuk tiket pemeliharaan dengan cakupan yang terbatas, format keluaran ini sangat berguna: penjelasan singkat yang diikuti oleh fungsi yang tepat. Tidak ada perancangan ulang API yang tidak perlu, ketergantungan paket baru, atau proses pemformatan yang tidak relevan yang dapat mengaburkan perbaikan tersebut.
Kesenjangan integrasi terdapat pada soal-soal ujian. Luna menggunakan assert.deepEqual dua kali tetapi tidak menyertakan pernyataan `assert import`. Menyalin pernyataan-pernyataan tersebut ke dalam berkas Node.js baru akan gagal sebelum salah satu pernyataan `assert` dijalankan. Pernyataan `assert` itu sendiri menargetkan kombinasi-kombinasi yang relevan dari nilai nol, pengurutan, dan duplikat, tetapi contoh ini tidak bersifat mandiri. Tambahkan pernyataan `import` `assert` yang ketat atau sesuaikan pernyataan tersebut dengan alat pengujian yang sudah Anda miliki. Meskipun ini hanya perbaikan kecil, hal ini menggambarkan mengapa jawaban kode yang masuk akal dan artefak yang siap dijalankan merupakan kriteria penerimaan yang berbeda.
Jawaban pemrograman yang disimpan merupakan hasil percobaan ulang. Upaya sebelumnya telah mencapai batas keluaran 900 token; percobaan ulang yang berhasil ini menggunakan prompt yang lebih pendek dan batas 1.200 token. Rumusan percobaan ulang yang tepat tidak disimpan, sehingga kami tidak menampilkan prompt pemrograman asli seolah-olah prompt tersebut menghasilkan jawaban ini. Hal ini mencegah perbandingan kualitas atau latensi yang sepadan secara langsung dengan Sol. Hal ini juga memberikan pelajaran praktis dalam penerapan: catat versi prompt dan alasan penyelesaian, serta jangan pernah menganggap respons yang terpotong sebagai tambalan kode yang berhasil.
Sintesis tiga nada: menjaga agar keputusan bersifat bersyarat
Gabungkan tiga catatan berikut menjadi memo keputusan yang ringkas yang memuat: keputusan, bukti, risiko, dan langkah selanjutnya. Catatan A: Jendela konteks sebesar 1,05 juta token dapat menampung kumpulan sumber yang besar, tetapi tidak membuat setiap permintaan menjadi murah. Catatan B: Di atas 272 ribu token masukan, laju masukan/cache yang tercatat meningkat dan keluaran dikalikan untuk permintaan secara keseluruhan. Catatan C: Pengambilan data dan penggunaan kembali cache dapat mengurangi biaya prompt yang berulang, tetapi kriteria penerimaan masih perlu diuji.
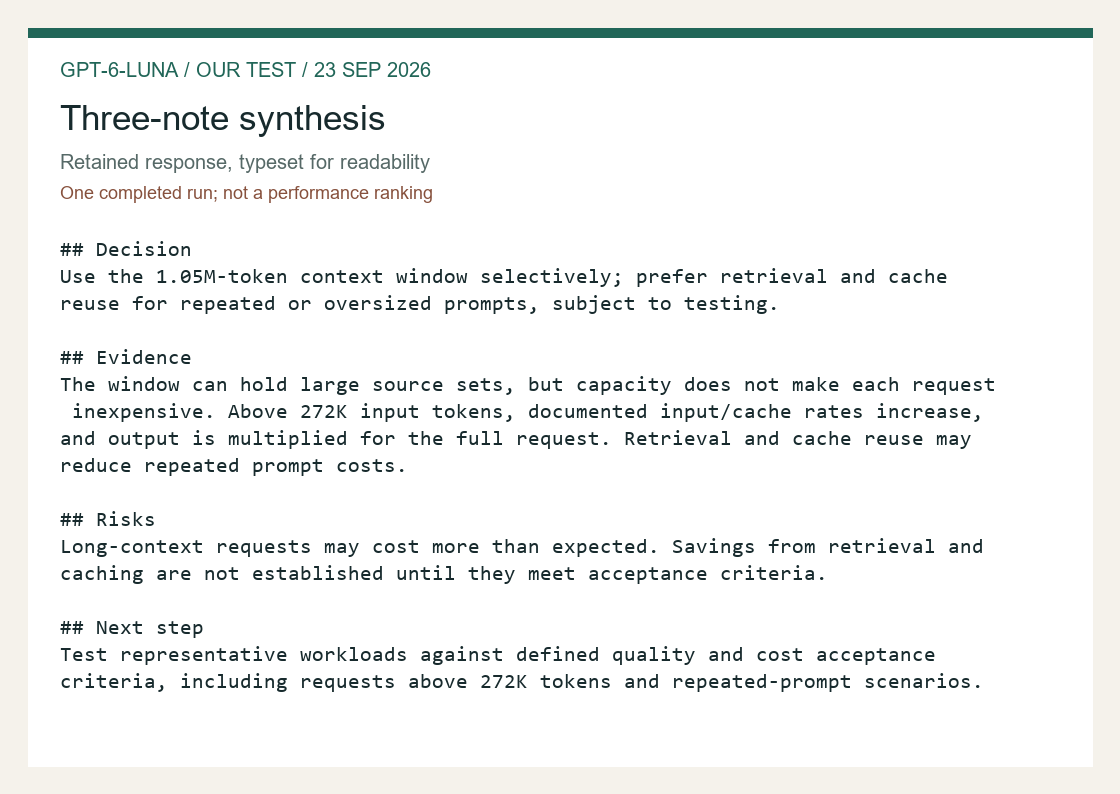
## Keputusan
Gunakan jendela konteks 1,05 juta token secara selektif; prioritaskan pengambilan data dan penggunaan ulang cache untuk prompt yang berulang atau berukuran besar, dengan syarat telah melalui pengujian.

## Bukti
Jendela tersebut dapat menampung kumpulan sumber yang besar, tetapi kapasitasnya tidak membuat setiap permintaan menjadi murah. Di atas 272K token masukan, tingkat masukan/cache yang terdokumentasi meningkat, dan keluaran dikalikan untuk permintaan penuh. Pengambilan data dan penggunaan kembali cache dapat mengurangi biaya prompt yang berulang.

## Risiko
Permintaan konteks panjang mungkin lebih mahal dari yang diperkirakan. Penghematan dari pengambilan dan penyimpanan dalam cache belum dapat dipastikan hingga memenuhi kriteria penerimaan.

## Langkah Selanjutnya
Uji beban kerja yang representatif terhadap kriteria penerimaan kualitas dan biaya yang telah ditetapkan, termasuk permintaan di atas 272K token dan skenario prompt yang diulang.
Penggunaan yang dilaporkan untuk tanggapan yang telah diselesaikan ini: 99 token masukan, 223 token hasil, total 322 token. Penggunaan kata pelengkap dapat mencakup token penalaran; hal ini bukan sekadar panjang jawaban yang terlihat.
Luna mempertahankan keempat bagian memo yang diminta dan menjadikan rekomendasinya bergantung pada hasil pengujian. Luna tetap mempertahankan perbedaan antara memiliki kumpulan data sumber yang besar dan memprosesnya secara efisien. Selain itu, Luna juga menyatakan bahwa penghematan dalam hal pengambilan data dan penyimpanan dalam cache belum dapat dipastikan hingga memenuhi kriteria penerimaan. Keterbatasan tersebut berguna untuk ringkasan internal yang berulang, di mana rekomendasi yang menarik dapat berubah menjadi janji yang tidak didukung setelah beberapa putaran penyuntingan.
Tugas tersebut terdiri dari tiga catatan singkat dan hanya 99 token prompt yang dilaporkan. Menyebutnya sebagai tolok ukur konteks panjang akan melebih-lebihkan apa yang terjadi. Respons tersebut menunjukkan bahwa Luna mampu mengorganisasikan paket bukti yang sangat kecil yang disediakan dalam pengujian ini; namun, hal ini tidak membuktikan tingkat recall pengambilan informasi, cakupan dokumen, ketahanan terhadap instruksi yang bertentangan, atau keakuratan mendekati ukuran input maksimum. Sebelum menggunakannya untuk ringkasan berulang, sertakan kasus-kasus dengan tanggal yang bertentangan dan pemilik yang tidak diketahui, lalu periksa apakah ketidakpastian tersebut tetap ada dalam hasil akhir.
Ekstraksi JSON: memastikan variabel tak diketahui tetap dinyatakan secara eksplisit
Ekstrak bidang-bidang berikut dari ringkasan ini dan kembalikan JSON yang valid yang hanya berisi kunci customer, priority, deadline, dan unknowns. Ringkasan: Pelanggan: Northwind Labs. Prioritas: tinggi. Batas waktu: 2026-10-04. Nama pemilik tidak disebutkan dan anggaran belum dikonfirmasi.
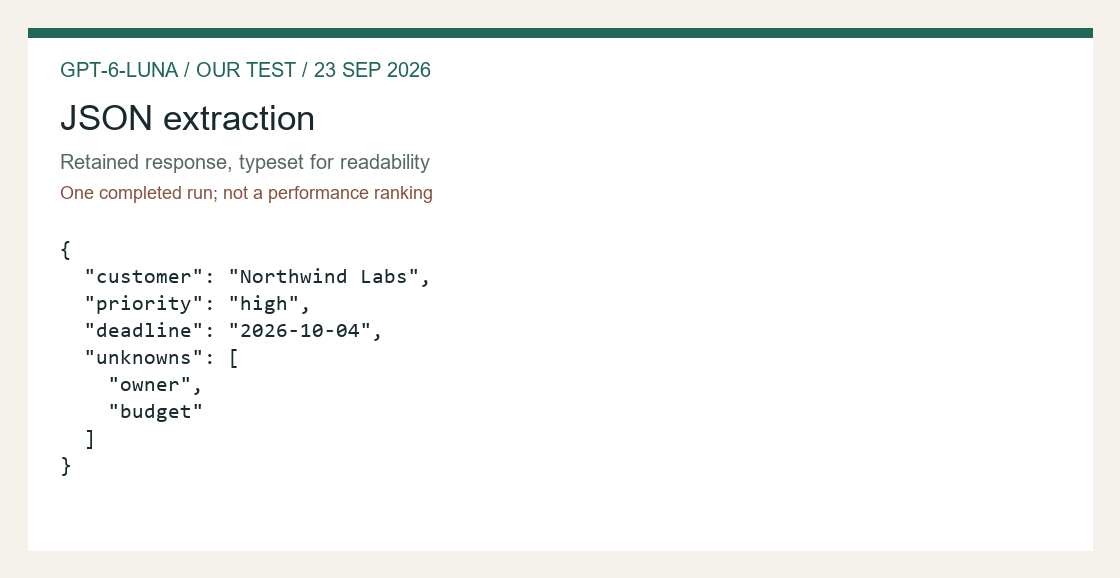
{"pelanggan":"Northwind Labs","prioritas":"tinggi","batas waktu":"2026-10-04","yang belum diketahui":["pemilik","anggaran"]}Penggunaan yang dilaporkan untuk tanggapan yang telah diselesaikan ini: 64 token masukan, 63 token hasil, total 127 token. Penggunaan kata pelengkap dapat mencakup token penalaran; hal ini bukan sekadar panjang jawaban yang terlihat.
Hasil ekstraksi merupakan alasan konkret terkuat dalam sampel kecil ini untuk mempertimbangkan Luna dalam pekerjaan yang spesifik dan dapat diulang. Model ini menghasilkan JSON yang valid dengan kunci-kunci yang diminta, menyalin Northwind Labs dan tenggat waktu bergaya ISO dengan benar, serta mempertahankan kolom pemilik dan anggaran sebagai nilai yang tidak diketahui. Tidak ada awalan percakapan yang perlu dihapus. Sol menghasilkan JSON yang identik pada prompt ekstraksi yang sama, sehingga bukti yang tersedia tidak menunjukkan keunggulan dari model yang lebih mahal pada catatan ini.
Validitas sintaksis hanyalah gerbang pertama. Sebuah parser JSON akan dengan mudah menerima pemilik yang dibuat-buat, pelanggan yang salah, atau tanggal yang tampak valid namun sebenarnya salah. Skema dapat membatasi bidang dan tipe; namun, skema tidak dapat membuktikan bahwa konten sesuai dengan sumbernya. Untuk tugas ini, memeriksa tiga nilai yang diketahui terhadap spesifikasi dan memastikan bahwa dua bidang yang hilang tetap tidak diketahui berfungsi sebagai gerbang semantik. Pada skala besar, alihkan konflik rute dan tanggal yang tidak pasti ke tahap peninjauan, bukan memperbaikinya dengan menebak-nebak.
Pemeriksaan validasi yang melampaui batas JSON yang dapat diurai
Berikut ini adalah contoh validasi editorial, bukan respons model tambahan. Kode ini dijalankan secara lokal di Node.js dan tidak melakukan permintaan ke model. Kode ini memeriksa fixture tertentu yang telah dibahas di atas; ini bukanlah penilaian umum terhadap model.
const assert = require('node:assert/strict');
const response = '{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer','deadline','priority','unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'high');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('Fixture ini sesuai dengan spesifikasi. Input baru memerlukan nilai yang diharapkan masing-masing.');
Validator secara sengaja memeriksa fakta-fakta yang diharapkan serta kumpulan kunci. Validator akan menolak respons yang menambahkan kolom pemilik dengan nilai pasti atau mengubah tanggal, meskipun respons tersebut tetap berupa JSON yang valid. Nilai-nilai tepat tersebut merupakan bagian dari fixture ini; validator produksi harus memperoleh ekspektasi dari kontrak input, bukan mengkodekan Northwind Labs secara permanen untuk setiap pelanggan. Validasi kalender dan izin untuk memperbarui catatan merupakan pemeriksaan terpisah. Lulus contoh ini berarti jawaban yang disimpan sesuai dengan panduan ini, bukan berarti setiap ekstraksi di masa depan akan benar.
Bagaimana GPT-6 Luna mengubah alur kerja yang sebenarnya
Spesifikasi utama hanya penting jika hal itu mengubah cara kerja sebuah tim. GPT-6 Luna dirancang untuk tugas-tugas yang terfokus dan bervolume tinggi, sehingga pertanyaan pertamanya adalah apakah beban kerja Anda akan diuntungkan oleh karakteristik tersebut. Jika setiap permintaan memiliki input yang singkat, kontrak output yang terbatas, dan uji penerimaan yang jelas, model tersebut dapat diintegrasikan ke dalam alur kerja yang dapat diulang. Jika tugas tersebut ambigu, memerlukan banyak alat, atau kemungkinan besar membutuhkan beberapa putaran koreksi, pengaturan alur kerja di sekitarnya sama pentingnya dengan nama model itu sendiri.
Untuk GPT-6 Luna, pola produksi yang berguna adalah pendekatan dua tahap: pertama, minta jawaban ringkas yang menyertakan ketidakpastian secara eksplisit, lalu kirimkan hanya bagian yang diperdebatkan atau belum lengkap ke tahap kedua. Hal ini membatasi token keluaran yang terbuang dan membuat kegagalan menjadi terlihat. Selain itu, hal ini juga memberi Anda titik perbandingan yang lebih baik terhadap GPT-6 Sol: pertanyaannya bukanlah nama mana yang terdengar lebih kuat, melainkan rute mana yang memenuhi kriteria penerimaan dengan jumlah percobaan ulang yang lebih sedikit.
Model perhitungan biaya sederhana sebelum Anda mengirim barang
Tabel harga resmi sebaiknya dikonversi ke dalam satuan yang benar-benar dibeli oleh tim Anda: permintaan per hari, rata-rata token masukan, porsi prefiks yang disimpan dalam cache, token keluaran, serta persentase panggilan yang melampaui 272 ribu token masukan. Lembar kerja yang hanya mencatat harga masukan utama akan menyembunyikan faktor pengganda dalam konteks jangka panjang serta biaya upaya ulang.
Perhitungan ini sangat relevan terutama saat membandingkan GPT-6 Luna dengan GPT-6 Sol. Permintaan yang lebih murah bisa jadi mahal jika memerlukan beberapa putaran perbaikan; sebaliknya, permintaan yang lebih canggih bisa menjadi pemborosan jika tugasnya adalah ekstraksi deterministik. Patokan yang tepat adalah sampel kecil dari lalu lintas Anda sendiri dengan prompt yang sama, skema yang sama, dan aturan peninjauan yang sama.
Jenis-jenis kegagalan yang perlu diperiksa sebelum penerapan
Halaman model dapat memberi tahu Anda endpoint dan modalitas mana saja yang telah didokumentasikan, tetapi tidak dapat menjamin bahwa aplikasi yang Anda miliki saat ini akan berperilaku sama setelah migrasi. Periksa apakah peristiwa streaming diparsing dengan benar, apakah panggilan alat mempertahankan statusnya saat dilakukan percobaan ulang, apakah keluaran terstruktur menolak bidang yang tidak sesuai format, dan apakah jalur pencatatan (logging pipeline) Anda mencatat ID model dan pengaturan penalaran untuk setiap permintaan.
Kriteria yang sama inilah yang membuat pengamatan langsung dalam ulasan ini bermanfaat tanpa menjadikannya semacam papan peringkat. Tiga tugas kami menunjukkan bagaimana sistem ini menangani cacat kode kecil, memo keputusan, dan ekstraksi JSON yang ketat. Tugas-tugas tersebut tidak mengukur latensi, keandalan pada skala besar, atau peringkat kualitas yang universal.
Kerangka kerja pengambilan keputusan untuk tim yang sesungguhnya
Tinjauan model berguna jika dapat membantu seseorang mengambil keputusan di tengah adanya batasan-batasan. Untuk GPT-6 Luna, batasan-batasan yang paling relevan adalah bentuk permintaan, biaya tinjauan, ukuran konteks, format keluaran, dan konsekuensi dari jawaban yang salah. Deskripsi penyedia mengarah pada tugas-tugas yang terfokus dan bervolume tinggi, tetapi tim tetap perlu menerjemahkan deskripsi tersebut menjadi alur kerja yang dapat dipantau. Mulailah dengan menuliskan tugas tersebut dalam satu kalimat, masukan yang akan diterima model, keluaran yang diharapkan oleh sistem lain, serta titik pemeriksaan manusia yang mencegah terjadinya kesalahan yang tidak terdeteksi.
Kesalahan pertama adalah memilih model dari prompt demo. Sebuah demo lebih mengutamakan kelancaran dan menyembunyikan detail operasional seperti upaya ulang, penghitungan token, izin alat, dan kegagalan skema. Perbandingan yang lebih baik menggunakan tiga tugas representatif: satu permintaan biasa, satu permintaan sulit, dan satu permintaan yang seharusnya ditolak atau ditingkatkan. Hasilnya bukanlah skor tunggal. Ini adalah gambaran singkat di mana model menghemat waktu, di mana model memerlukan pengawasan, dan di mana model lain—seringkali GPT-6 Sol—merupakan pilihan yang lebih hemat biaya atau lebih aman.
Mulailah dengan uji penerimaan
Tulis uji penerimaan sebelum Anda menulis prompt. Untuk kode, uji tersebut bisa berupa uji unit yang lulus atau patch yang tidak mengubah API publik. Untuk ekstraksi, uji tersebut bisa berupa JSON yang valid dengan semua kunci yang diperlukan ada dan nilai-nilai yang tidak diketahui dipertahankan secara eksplisit. Untuk memo keputusan, uji tersebut bisa berupa struktur tetap yang memuat bukti, risiko, penanggung jawab, dan langkah selanjutnya. Model hanya dapat dievaluasi berdasarkan target yang terlihat. Tanpa target tersebut, sebuah paragraf yang disusun dengan rapi bisa terlihat berhasil, padahal diam-diam mengabaikan satu bidang yang dibutuhkan oleh proses hilir.
Uji penerimaan yang baik cukup spesifik untuk dijalankan secara otomatis dan cukup bermakna untuk melindungi pengguna. Uji tersebut juga harus dapat memperjelas adanya ketidaksepakatan. Jika dua hasil keluaran berbeda, tim harus dapat menunjukkan fakta yang terlewat, asumsi yang tidak didukung, kolom yang tidak diisi dengan benar, atau perhitungan yang salah. Hal itu lebih dapat ditindaklanjuti daripada sekadar mengatakan bahwa satu jawaban “terasa lebih cerdas.” Hal ini juga menjadi pembeda antara tinjauan yang membantu proses pengadaan dan tinjauan yang sekadar mengulang bahasa yang digunakan saat peluncuran.
Gunakan nama model untuk memilih hipotesis awal. Gunakan uji penerimaan Anda untuk menentukan apakah hipotesis tersebut masih berlaku setelah diterapkan di lingkungan produksi.
Desain prompt yang sesuai dengan profil model
Prompt yang sama tidak boleh disalin begitu saja ke setiap model. Kontrak tugas boleh tetap sama, tetapi jumlah konteks, instruksi penalaran, dan batasan keluaran harus disesuaikan dengan rutenya. Untuk GPT-6 Luna, buatlah instruksi sistem cukup singkat agar tidak bersaing dengan materi sumber. Sebutkan peran, aturan pengambilan keputusan, bentuk keluaran yang diperlukan, serta kondisi yang memerlukan variabel tak diketahui secara eksplisit atau eskalasi.
Untuk dokumen yang panjang, pisahkan proses pencarian dari penarikan kesimpulan. Pertama, identifikasi bagian-bagian yang menjawab pertanyaan; kemudian tarik kesimpulan dengan hanya menggunakan bagian-bagian tersebut dan kriteria yang telah ditetapkan. Hal ini mengurangi kemungkinan bahwa kalimat yang terdengar meyakinkan dibentuk dari detail yang jauh dan tidak relevan. Selain itu, hal ini menjadikan jendela konteks 1,05 juta token sebagai alat, bukan sebagai pengaturan default. Konteks yang luas sangat berguna ketika hubungan antar bukti yang berjauhan menjadi penting. Namun, hal ini menjadi sia-sia jika tugas tersebut dapat diselesaikan dengan paket kecil yang dipilih dengan cermat.
Untuk alur kerja yang menggunakan alat, jelaskan batasan antara model dan alat tersebut. Model harus menentukan apakah suatu alat diperlukan, menyediakan argumen dalam skema yang ketat, dan menjelaskan apa yang akan dilakukannya terhadap nilai yang dikembalikan. Aplikasi harus menerapkan kontrol izin, memvalidasi argumen, mencatat panggilan, dan memutuskan apakah panggilan alat yang gagal dapat dicoba ulang. Memperlakukan model sebagai seluruh aplikasi akan mempersulit proses debugging dan memperluas dampak dari asumsi yang salah.
Sebuah petunjuk yang dapat digunakan kembali dan terdiri dari empat bagian
Konteks: Sampaikan hanya fakta dan dokumen yang diperlukan untuk tugas tersebut. Gol: Jelaskan keputusan atau perubahan tersebut dalam satu kalimat. Batasan: tentukan format, pengecualian, penanganan ketidakpastian, dan batas alat. Periksa: Mintalah model tersebut untuk mencantumkan input yang hilang atau kontradiksi sebelum model tersebut menetapkan jawabannya. Struktur ini cukup ringkas untuk dipanggil berulang kali dan cukup eksplisit untuk membandingkan antar model.
Ketika jendela konteks yang besar sangat membantu
Judul "1,05 juta token" mudah diulang dan mudah disalahartikan. Jendela konteks memberi tahu Anda berapa banyak materi yang dapat dimasukkan dalam satu permintaan; namun, jendela tersebut tidak memberi tahu Anda berapa banyak materi yang sebaiknya dikirim, seberapa baik model akan memanfaatkan setiap bagian teks, atau berapa biaya yang akan dikenakan untuk permintaan tersebut. Permintaan yang panjang juga dapat memperlambat proses peninjauan karena tim memiliki lebih banyak bukti yang harus diperiksa dan lebih banyak ruang untuk terjadinya konflik instruksi yang halus.
Gunakan jendela penuh jika tugas tersebut benar-benar bergantung pada referensi yang berjauhan: sebuah kontrak dengan definisi yang terpisah dari pengecualian, sebuah repositori di mana antarmuka dan implementasinya berjauhan, atau arsip penelitian yang panjang di mana jawabannya memerlukan penelusuran urutan. Gunakan fitur pencarian jika pertanyaannya bersifat lokal, jika kumpulan sumbernya sering berubah, atau jika Anda menginginkan jejak kutipan yang ringkas. Gunakan caching ketika prefiks yang stabil digunakan kembali di banyak permintaan dan platform menyediakan detail penggunaan yang cukup untuk membuktikan bahwa cache berfungsi.
Ambang batas 272K seharusnya menjadi bagian dari diagram arsitektur, bukan sekadar catatan kaki di paragraf tentang penetapan harga. Sebuah permintaan yang aman jika berada di bawah ambang batas tersebut bisa menjadi jauh lebih mahal jika melebihi ambang batas tersebut. Tim harus mencatat token masukan, token yang disimpan dalam cache, token keluaran, ID model, pengaturan penalaran, serta apakah permintaan tersebut melampaui ambang batas. Catatan tersebut mendukung model biaya yang akurat dan memungkinkan untuk mendeteksi inflasi konteks yang tidak disengaja sebelum hal itu menjadi kejutan bulanan.
Pertanyaan seputar migrasi API yang perlu diuji coba terlebih dahulu
Sebelum memindahkan integrasi yang sudah ada ke GPT-6 Luna, buatlah alat pengujian (staging harness) yang memutar ulang sampel kecil yang telah dianonimkan. Bandingkan teks akhir, bidang terstruktur, panggilan alat, alasan penghentian, dan penggunaan token. Jangan hanya membandingkan layar pertama dari respons. Sebuah model dapat mempertahankan kesimpulan yang terlihat sambil mengubah nama bidang, mengabaikan kondisi kesalahan, atau mengembalikan argumen alat yang tidak dapat dieksekusi dengan aman oleh aplikasi.
Respons dan Penyelesaian Obrolan bukanlah label yang dapat saling menggantikan dalam rencana integrasi. Dukungan titik akhir, pengaturan penalaran, perilaku alat, peristiwa streaming, dan objek kesalahan semuanya memengaruhi adaptor. Tetapkan ID model dalam konfigurasi, tetapi pastikan tetap terlihat dalam log dan laporan pengujian. Saat permintaan gagal, catatan harus menampilkan titik akhir, model, upaya penalaran, versi prompt, ukuran permintaan, dan keputusan percobaan ulang. Bukti tersebut memungkinkan seorang insinyur mereproduksi kegagalan tersebut, alih-alih memperdebatkan apakah model tersebut hanya sedang mengalami hari yang buruk.
Pemrosesan batch mengubah aspek ekonomi dan ritme operasional. Metode ini dapat sesuai untuk klasifikasi semalam, persiapan dokumen, atau antrian transformasi dengan tingkat urgensi rendah. Namun, metode ini kurang cocok untuk tindakan interaktif yang memerlukan respons langsung kepada pengguna. Mode cepat dan regional juga memengaruhi perhitungan harga. Perlakukan opsi-opsi tersebut sebagai pilihan konfigurasi eksplisit dan cantumkan dalam lembar kerja anggaran, bukan menyembunyikannya dalam pengaturan default.
Putar ulang masukan perwakilan, validasi keluaran terstruktur, catat argumen alat, bandingkan alasan penghentian, ukur penggunaan token, dan uji satu jalur kegagalan sebelum mengubah pengaturan default produksi.
Kualitas, keamanan, dan biaya peninjauan
Harga token yang lebih rendah tidak secara otomatis berarti biaya total yang lebih rendah, dan model yang lebih mahal tidak secara otomatis menghasilkan hasil bisnis yang lebih baik. Biaya total mencakup upaya ulang, peninjauan manual, penanganan insiden, serta pekerjaan yang diperlukan untuk memperbaiki data hilir. Metrik yang berguna adalah biaya per hasil yang diterima, yang dikelompokkan berdasarkan kategori tugas. Rute yang sedikit lebih mahal per permintaan masih bisa menjadi pilihan terbaik jika dapat mengurangi pekerjaan perbaikan pada tugas-tugas berdampak tinggi; rute yang sangat murah bisa menjadi pilihan terbaik secara mutlak untuk ekstraksi deterministik dengan validasi yang kuat.
Risiko harus diklasifikasikan berdasarkan tindakan, bukan berdasarkan merek model. Membaca dokumen publik dan menyusun ringkasan berbeda dengan mengubah catatan pelanggan, menyetujui pembayaran, menghapus data, atau menerbitkan pernyataan hukum. Letakkan tindakan yang tidak dapat dibatalkan di balik pemeriksaan oleh manusia atau langkah validasi independen kedua. Minta model untuk mengidentifikasi ketidakpastian, tetapi jangan pernah memperlakukan kalimat yang terdengar meyakinkan sebagai sistem izin.
Pertanyaan seputar privasi dan penyimpanan data harus dibahas dalam tinjauan implementasi. Pastikan data apa saja yang dikirimkan, berapa lama log disimpan, siapa saja yang dapat memeriksa prompt, dan apakah permintaan tersebut berisi informasi rahasia atau data pribadi. Sensor informasi yang tidak perlu jika memungkinkan, minimalkan konteks, dan catat dengan jelas bidang-bidang mana yang telah dihapus. Pengendalian ini berlaku baik jika model digunakan melalui API resmi maupun melalui jalur lain yang kompatibel.
Cara membandingkan GPT-6 Luna dengan GPT-6 Sol
Perbandingan yang adil mempertahankan tugas dan aturan penerimaan tetap konstan, sekaligus memungkinkan setiap model memanfaatkan keunggulan yang telah didokumentasikan. Jalankan paket input yang sama, tetapi catat apakah suatu model memerlukan pengaturan penalaran yang berbeda atau titik akhir yang berbeda. Laporkan perbedaannya secara jelas: satu model mungkin menghasilkan patch yang lebih lengkap, model lain mungkin lebih hemat biaya untuk ekstraksi berulang, dan model ketiga mungkin lebih mudah diintegrasikan karena kontrak alatnya sesuai dengan adaptor Anda saat ini.
Jangan jadikan satu tugas yang berhasil sebagai patokan umum. Tiga tugas kecil berguna untuk mengidentifikasi masalah dalam alur kerja, bukan untuk membuktikan adanya pemenang yang universal. Ulangi tugas tersebut dengan beberapa masukan yang realistis, sertakan setidaknya satu kasus yang menantang atau tidak lengkap, dan tentukan terlebih dahulu apa yang dianggap lulus. Jika sampel terlalu kecil untuk mendukung suatu kesimpulan, katakanlah demikian. Batasan tersebut justru meningkatkan kepercayaan, bukan melemahkan tinjauan.
Peluncuran bertahap yang memungkinkan keputusan tersebut dapat dibatalkan
Mulailah dengan lalu lintas bayangan atau antrian yang tidak kritis. Biarkan rute baru menghasilkan hasil sementara rute yang sudah ada tetap menjadi acuan utama. Bandingkan tingkat penerimaan, biaya token, waktu peninjauan, dan kategori kegagalan selama periode tertentu. Kemudian pindahkan satu kelompok tugas pada satu waktu, dengan tetap menyediakan tombol rollback dan tag versi yang jelas. Peluncuran bertahap mengubah pemilihan model menjadi perubahan teknis yang dapat diamati, bukan penggantian dalam satu hari.
Selama proses peluncuran, perhatikan perubahan-perubahan yang tidak tercermin dalam angka tingkat keberhasilan semata: hasil yang lebih panjang, lebih banyak pemanggilan alat, lebih banyak eskalasi, atau lebih banyak permintaan yang melampaui ambang batas konteks panjang. Sebuah model bisa saja tampak akurat, namun justru menghabiskan lebih banyak anggaran atau menambah beban kerja operator. Tambahkan peringatan untuk aspek-aspek tersebut dan tinjau bersama orang-orang yang secara langsung menangani pengecualian.
Seperti apa bentuk kesuksesan itu
Kesuksesan adalah jalur yang stabil dengan biaya yang diketahui, pola kegagalan yang jelas, dan proses peninjauan yang dapat diikuti oleh orang-orang. Hal ini tidak memerlukan berpura-pura bahwa model tersebut sempurna. Yang diperlukan adalah mengetahui tugas-tugas mana yang dapat ditangani dengan baik oleh model tersebut, tugas-tugas mana yang memerlukan jalur lain, serta cara menghentikan atau memperbaikinya ketika masukan tidak lengkap. Itulah standar praktis yang mendasari pengamatan dan dokumentasi yang dikumpulkan dalam tinjauan ini.
Apa saja yang dapat dan tidak dapat Anda ketahui dari reaksi publik
Sumber-sumber berikut ini disertakan sebagai tanggapan publik yang disebutkan sumbernya, bukan sebagai dokumentasi resmi atau bukti tolok ukur yang terkontrol. Judul-judulnya menunjukkan apa yang dipilih oleh masing-masing pembuatnya untuk diuji atau dijelaskan; judul-judul tersebut tidak menunjukkan hasil yang berlaku secara menyeluruh di pasar.
- Chase AI: GPT 6 Sol & Luna Sudah Hadir (Dan 50% LEBIH MURAH!). Anggaplah cara penyajian dan setiap demonstrasi sebagai pengalaman sang pencipta, bukan sebagai standar universal.
- Rob, Ahli Kecerdasan Buatan: ChatGPT Meluncurkan GPT-6 Sol & GPT-6 Luna (Model dan Agen Baru dari ChatGPT). Anggaplah cara penyajian dan setiap demonstrasi sebagai pengalaman sang pencipta, bukan sebagai standar universal.
- AI bersama Surya: GPT-6 Soul vs Luna vs Claude Opus 5.5: Mana yang Sebaiknya Anda Gunakan?. Anggaplah cara penyajian dan setiap demonstrasi sebagai pengalaman sang pencipta, bukan sebagai standar universal.
Ada masalah penamaan terpisah yang perlu diperhatikan di sini: beberapa video publik menggunakan istilah “GPT-6” dan “GPT-5.6” secara bergantian dalam judulnya. Pastikan ID model yang tepat tetap tercantum saat Anda mengutip klaim tersebut. Hal ini Perbandingan GPT-6 Astra vs GPT-5.6 Sol merupakan contoh yang bermanfaat mengenai mengapa identitas penyedia, label platform, dan rute harus dicatat secara terpisah.
Cara mengakses GPT-6 Luna
Buka aplikasi Ruang Kerja GPT-6 Luna Mulailah dengan tugas yang dapat Anda evaluasi: contoh kode kecil, paket sumber singkat, atau ringkasan ekstraksi yang terstruktur. Pastikan hasil yang diminta dan aturan penerimaan tetap terlihat saat membandingkan revisi. Harga token resmi di atas mengacu pada penggunaan API secara langsung, bukan janji terkait kredit ruang kerja atau kuota langganan.
Untuk informasi mengenai penamaan platform saat ini dan konteks kredit terpisah, lihat Panduan Harga GPT-5.6 dan Perbandingan model GPT-5.6. Halaman-halaman tersebut merupakan konteks platform/redaksional; halaman-halaman tersebut tidak menggantikan tabel harga API OpenAI.
Siapkan sebuah tugas yang representatif, lalu bandingkan hasilnya dengan kriteria penerimaan Anda sendiri.
Buka ruang kerja GPT-6 LunaSiapa yang sebaiknya memilih GPT-6 Luna?
Jika daftar pilihan Anda mencakup alternatif yang lebih murah, bandingkan katalog model yang lebih lengkap daripada berasumsi bahwa model terbaru otomatis merupakan pilihan yang paling menguntungkan. Jika Anda sedang mengevaluasi pekerjaan yang melibatkan data dalam jumlah besar, maka panduan model analisis data menyediakan perspektif alur kerja tersendiri.
Pertanyaan yang Sering Diajukan
Apa itu GPT-6 Luna?
GPT-6 Luna adalah model OpenAI yang dirancang khusus untuk menangani tugas-tugas dalam volume besar. ID model API resminya adalah gpt-6-luna.
Berapa harga GPT-6 Luna?
OpenAI mencantumkan GPT-6 Luna dengan tarif $0.10 per 1 juta token masukan, $0.01 per 1 juta token masukan yang disimpan dalam cache, $0,125 per 1 juta penulisan cache, dan $0,50 per 1 juta token keluaran dengan tarif Standar.
Apa yang terjadi jika jumlah token masukan melebihi 272 ribu?
Apabila suatu permintaan melebihi 272K token masukan, OpenAI akan menerapkan laju masukan dan cache sebesar 2x serta laju keluaran sebesar 1,5x terhadap seluruh permintaan tersebut.
Apa saja batasan konteks dan keluaran?
GPT-6 Luna memiliki jendela konteks sebesar 1.050.000 token, batas maksimum masukan sebesar 922.000 token, dan batas maksimum keluaran sebesar 128.000 token.
Berapa batas nilai pengetahuan yang ditentukan?
Halaman model OpenAI saat ini mencantumkan tanggal 18 Mei 2026 sebagai batas waktu pembaruan pengetahuan untuk GPT-6 Luna.
Pengaturan penalaran apa saja yang tersedia?
API ini mendokumentasikan tingkat upaya penalaran none, low, medium, high, xhigh, dan max, dengan medium sebagai pengaturan default.
Titik akhir API mana saja yang didukung?
GPT-6 Luna mendukung fitur Chat Completions, Responses, dan Batch. Halaman model tersebut tidak mencantumkan fitur Realtime, Assistants, audio, video, pembuatan gambar, embeddings, fine-tuning, moderasi, atau Completions versi lama sebagai fitur yang didukung.
Apakah GPT-6 Luna bisa menerima gambar?
Ya. Halaman model tersebut mencantumkan input berupa teks dan gambar dengan output berupa teks. Hal itu tidak berarti model tersebut merupakan model pembuat gambar.
Apakah GPT-6 Luna tersedia di GlobalGPT?
Gunakan halaman model GPT-6 Luna khusus yang tertaut di atas. Kredit Workspace dan kuota paket tidak termasuk dalam tarif token API langsung yang dijelaskan dalam ulasan ini.
Apakah artikel ini menyertakan uji perbandingan?
Hasil ini mencakup tiga pengamatan tugas kecil, bukan uji perbandingan terkontrol. Luna memerlukan petunjuk pemrograman yang direvisi saat mencoba kembali. Hasil-hasil ini tidak menentukan pemenang yang mutlak atau kinerja pada skala besar.
Keputusan akhir
Luna adalah opsi pragmatis yang mengutamakan biaya dalam daftar harga resmi: layanan ini mempertahankan konteks utama dan batas keluaran yang sama dengan Sol, namun mengenakan tarif yang jauh lebih rendah. Hal ini menjadikannya pilihan yang menarik untuk panggilan yang terfokus dan berulang, namun harga yang rendah tersebut bukanlah bukti latensi yang lebih rendah atau kualitas yang lebih rendah tanpa uji coba yang terkontrol. Pilihlah berdasarkan output yang diterima dan total biaya operasional, lalu tinjau kembali pilihan tersebut ketika beban kerja Anda berubah.
Diverifikasi pada 23 September 2026. Fakta resmi: OpenAI Developers. Penamaan rute platform: GlobalGPT. Reaksi publik: pencipta dan publikasi yang ditautkan, hanya disebutkan sumbernya.









