Les tests ont été effectués les 7 et 11 septembre 2026 ; les sources ont été vérifiées à nouveau le 16 septembre 2026.
Il convient d’apporter une précision concernant ce nom. Les internautes continuent de rechercher “ Grok 4 ”, mais le modèle que nous avons testé était Grok 4,6, et non la date de sortie initialement prévue en juillet 2025. La date actuelle Catalogue de modèles xAI recommande la version Grok 4.6 pour le code, alors que la version d'origine grok-4-0709 Le nom de l'API n'est plus utilisé. Je ferai la distinction entre ces produits et ces dates tout au long de cette analyse.
Si vous comparez plusieurs assistants avant d'en choisir un, commencez par les critères les plus généraux Meilleur modèle d'IA pour la comparaison de codes. La question qui se pose ici est de savoir si Grok est capable de transformer un cahier des charges de programmation précis en un résultat que l'on peut réellement vérifier.
Réponse rapide : le modèle Grok 4 est-il adapté au codage ?
La version Grok 4.6 est suffisamment performante pour permettre de déboguer une fonction isolée, de générer une première implémentation, d'expliquer du code inconnu et de rédiger des tests. Elle n'est toutefois pas assez fiable pour être acceptée sans exécution préalable. Les erreurs détectées dans notre petite suite de tests n'étaient pas de simples divergences de style obscures : une refactorisation a supprimé net pour chaque résultat non vide, et une suite de tests générée n'a pas réussi à distinguer un délai d'un horodatage absolu.
La règle pratique est simple : définissez un cahier des charges restreint, demandez une seule modification et effectuez des vérifications indépendantes. Un modèle capable de générer rapidement du code plausible peut tout de même effacer un champ, affaiblir une invariante ou respecter l'exigence relative au code tout en ignorant celle concernant le format de la réponse.
Vous pouvez Essayez Grok 4,6 sur GlobalGPT pour les invites limitées et les comparaisons côte à côte. GlobalGPT est une plateforme indépendante ; elle ne remplace pas Grok Build, un IDE, l'accès au dépôt, la console API native de xAI, ni votre pipeline d'intégration continue (CI).
Ce que nous avons réellement testé
Nous avons évalué quatre petites tâches JavaScript : la correction d'un problème de fusion d'intervalles, le débogage d'un système d'attribution de places basé sur les priorités, la refactorisation d'une fonction de résumé des modifications et l'écriture de tests pour un Retry-After analyseur syntaxique. Chaque tâche disposait d’une invite figée et d’un évaluateur local déterministe. Trois d’entre elles ont été exécutées le 11 septembre 2026 ; la tâche d’intervalle a réutilisé une exécution du 7 septembre que nous avons revérifiée par rapport à son invite enregistrée, à sa réponse brute et à son évaluateur.
- Lieu : API d'agrégation Broly autorisée par l'utilisateur, « Chat Completions ».
- Modèle demandé et restitué :
grok-4.6. - Tentatives : une requête par tâche, sans nouvelle tentative.
- Exécution : Le code JavaScript renvoyé a été isolé et exécuté localement à l'aide de fixtures ou de mutants prédéfinis.
- Non disponible pour ce modèle : un IDE, un référentiel, un accès à Internet, l'exécution d'outils xAI et des systèmes de production.
L'étiquette de la passerelle constitue une information utile sur la provenance, mais elle ne prouve pas à elle seule le déploiement en amont. Le temps écoulé inclut la surcharge liée au réseau et à la passerelle, et les nombres de jetons indiqués ne constituent pas une facturation xAI officielle. Pour une vue d'ensemble plus large au niveau du produit, consultez le document séparé Grok 4.6 : avis et tests réels.
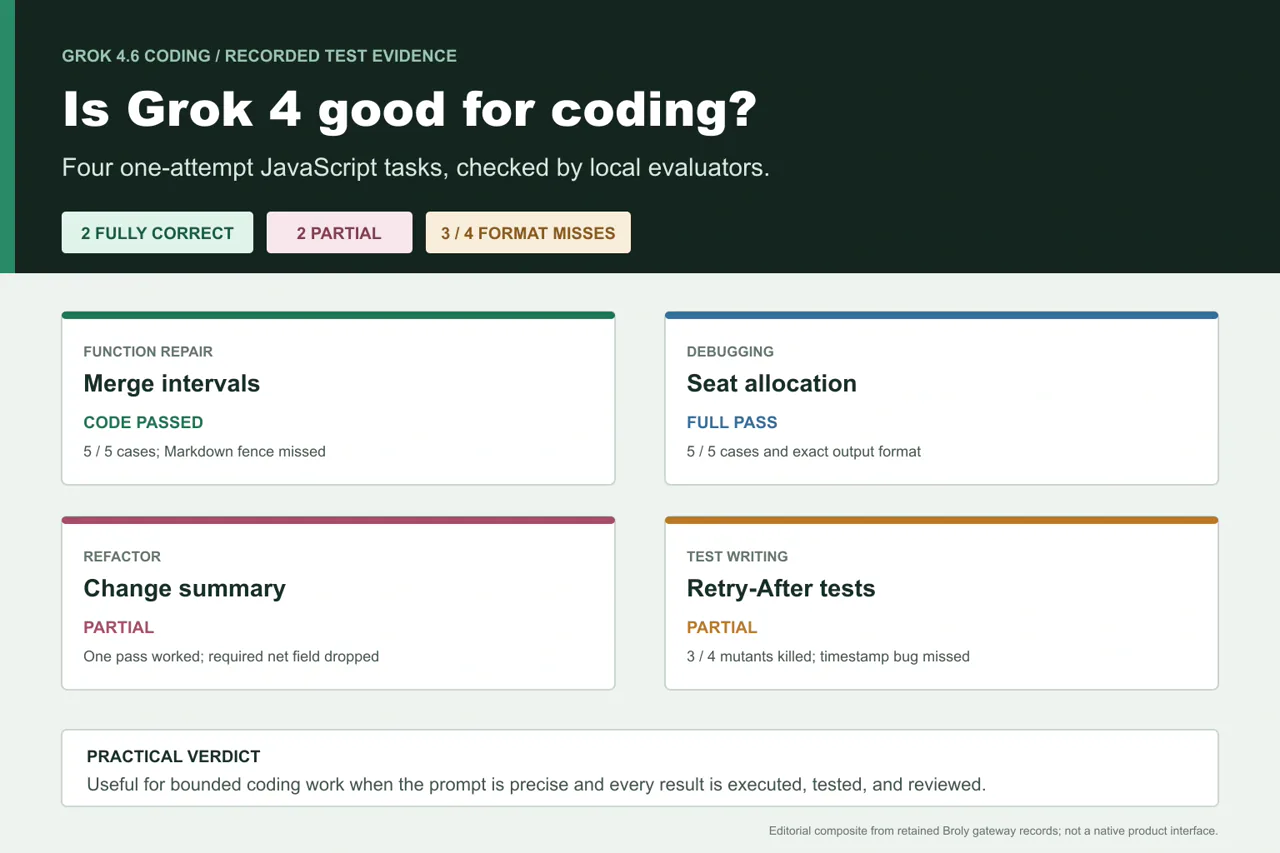
Aperçu des résultats des tests de codage
net.Le meilleur résultat n'était pas la réponse la plus longue. Il s'agissait de la correction de l'attribution des places : concise, correctement formatée et complète sur le plan comportemental. L'échec le plus instructif était celui de la refactorisation, car l'implémentation semblait propre et respectait l'exigence d'un seul passage, tout en modifiant silencieusement le contrat de sortie.
Test n° 1 : correction d'une fonction d'intervalle de fusion
La première fonction modifiait sa donnée d'entrée, plantait lorsqu'elle recevait un tableau vide, ne parvenait pas à fusionner les extrémités adjacentes et pouvait réduire un intervalle plus grand lorsqu'un intervalle imbriqué apparaissait par la suite. L'invite a permis de rendre ces invariants explicites.
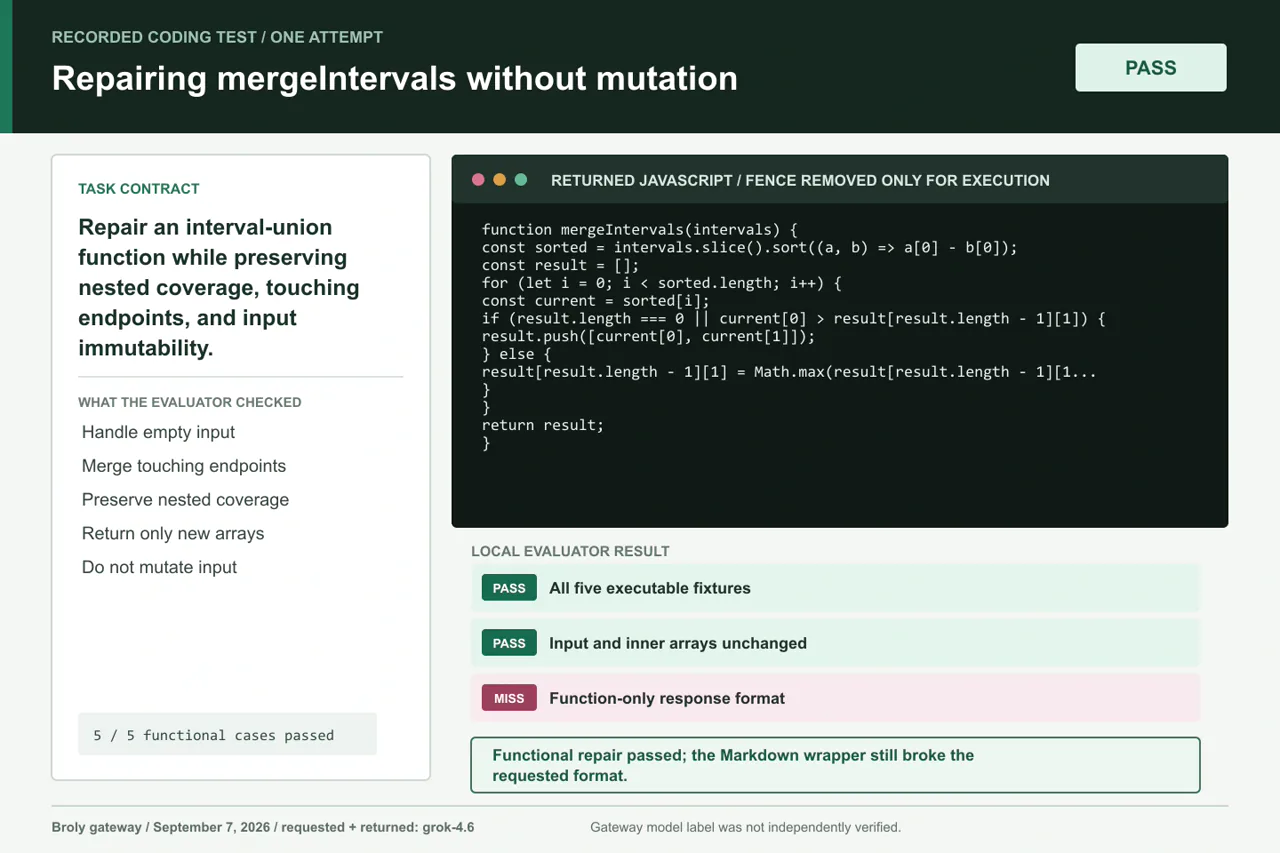
Limite clé : La réparation fonctionnelle a été validée après avoir supprimé uniquement la balise Markdown externe pour l'exécution.
Résultat : Les cinq cas d'exécution ont tous été validés. La fonction a renvoyé de nouveaux tableaux, n'a pas modifié les données d'entrée, a préservé la couverture imbriquée et a fusionné les points d'extrémité adjacents. Elle a toutefois échoué sur une instruction explicite en encapsulant le code dans du Markdown. Après avoir supprimé uniquement cette barrière externe d'exécution, le résultat fonctionnel s'est avéré correct.
Conclusion pratique : Grok a géré un cas de réparation simple lorsque le prompt a identifié les cas limites cachés. L'erreur de format est mineure pour un utilisateur, mais elle peut perturber un pipeline qui s'attend à recevoir du texte directement exécutable.
Test n° 2 : débogage de l'attribution des places en fonction des priorités
Cette tâche combinait la gestion stable des égalités, la priorité descendante, l'absence de mutation, une capacité exacte et une règle de “ saut et poursuite ”. Le code d'origine effectuait le tri dans le mauvais sens, modifiait le tableau d'entrée et s'arrêtait trop tôt lorsqu'une requête dépassait la taille autorisée.
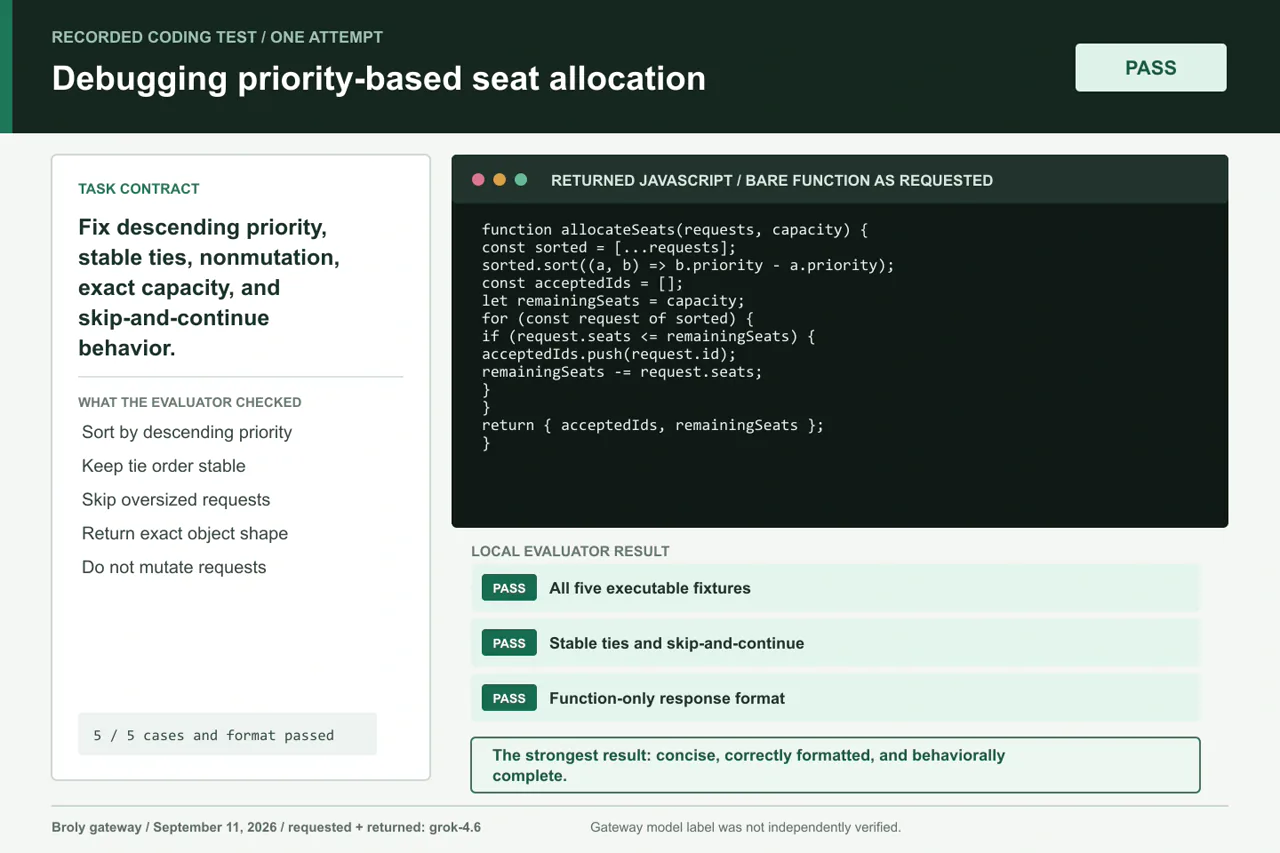
Limite clé : C'était la seule réponse qui respectait à la fois le contrat comportemental et le format de sortie exact.
Résultat : Les cinq cas ont tous été validés, notamment ceux concernant un ordre de priorité égal, une requête principale de taille excessive, une capacité exacte, une capacité nulle et une liste vide. L'entrée est restée inchangée, identifiants acceptés il s'agissait d'un nouveau tableau, et le modèle n'a renvoyé que la fonction demandée.
Conclusion pratique : C'est exactement le genre de tâche pour laquelle Grok est particulièrement bien adapté : une seule fonction, un contrat clair et des cas limites pouvant être traités immédiatement.
Test n° 3 : refactorisation sans altération du comportement
La troisième consigne demandait à Grok de remplacer les analyses répétées par un seul passage d'agrégation, tout en conservant l'ordre, les noms de fichiers inhabituels et la structure exacte de la sortie. Il s'agit là d'un risque réel lié à la refactorisation : le code peut gagner en rapidité et en clarté, mais au prix d'une perte de fonctionnalité.
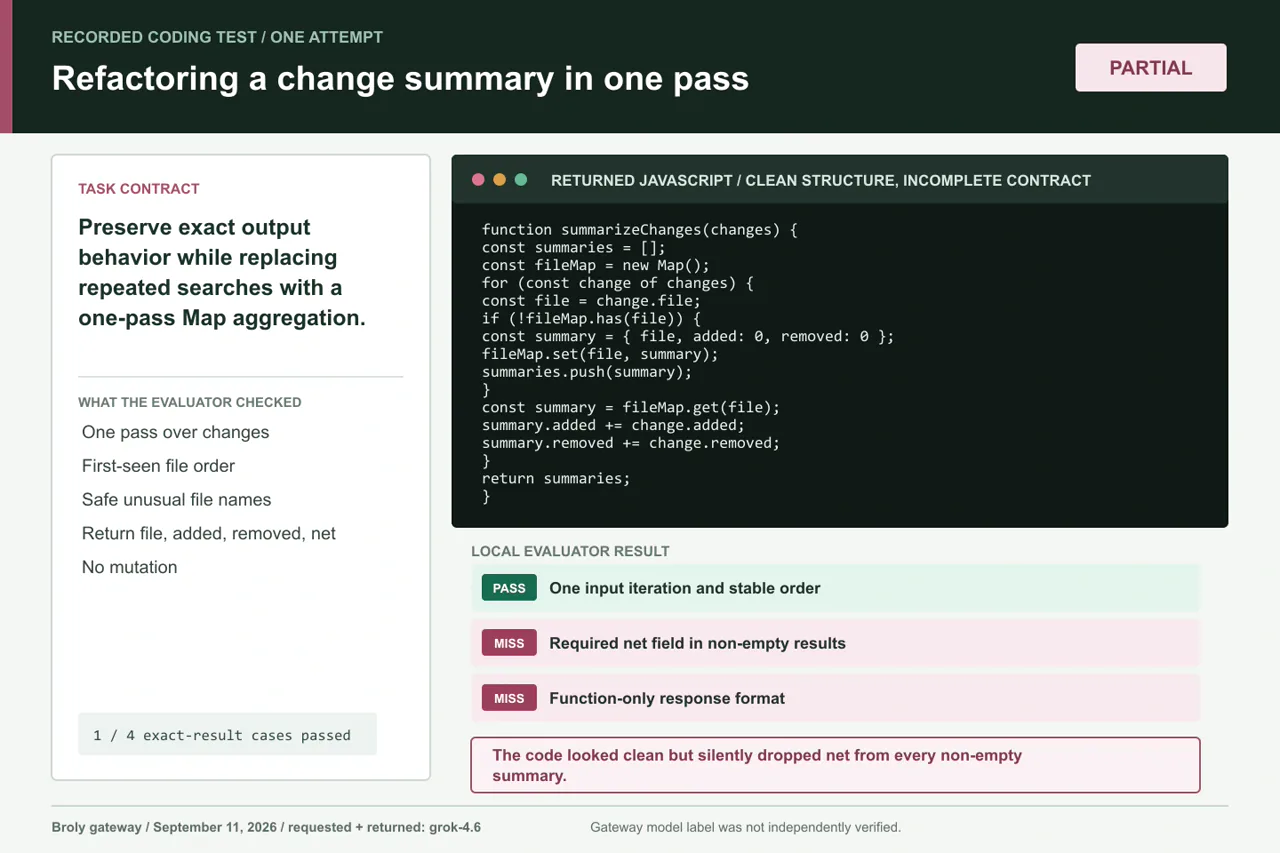
Limite clé : L'approche « Map » en un seul passage semblait correcte, mais elle a omis sans le signaler le champ « net » requis.
Résultat : la réponse a été générée en un seul passage, un Carte, un classement correct par ordre d’apparition, une gestion sécurisée de __proto__ et constructeur, et aucune mutation au niveau des données d'entrée. Mais il n'a jamais effectué de calcul ni renvoyé de résultat net. Le cas vide a été validé car il ne contenait aucun objet de résultat ; les trois cas non vides ont échoué à la comparaison exacte.
Conclusion pratique : Ne jugez jamais une refactorisation uniquement en fonction de la complexité algorithmique ou de la propreté du code. Enregistrez les anciens résultats, vérifiez chaque champ obligatoire et comparez le comportement avant d'accepter la nouvelle version.
Test n° 4 : rédiger des tests permettant de détecter des bogues plausibles
La dernière tâche a inversé la procédure habituelle : Grok a rédigé les tests, et notre harnais les a exécutés sur une implémentation de référence stricte ainsi que sur quatre implémentations délibérément erronées. L'objectif n'était pas la couverture de code, mais de déterminer si les entrées choisies permettaient de distinguer des sémantiques d'apparence similaire.
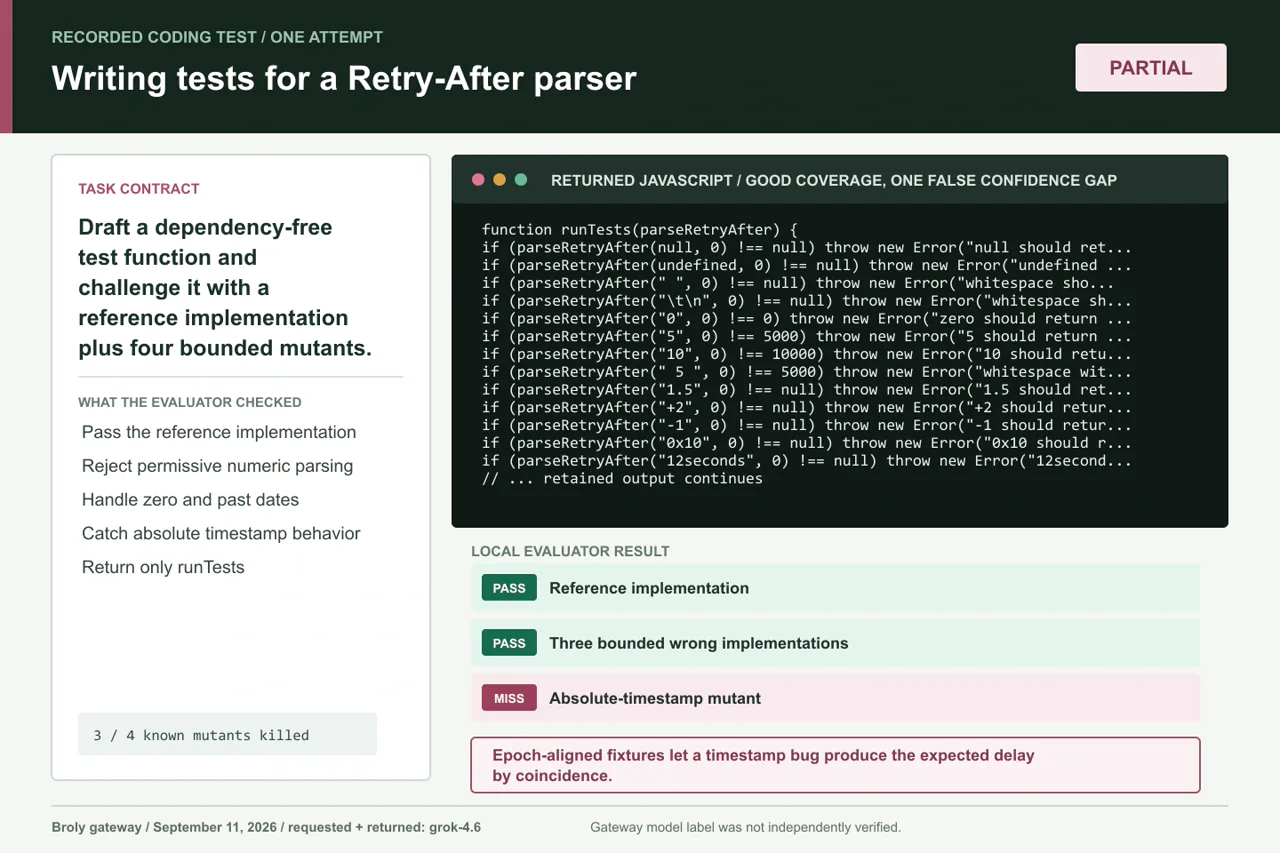
Limite clé : Les fonctions de date alignées sur l'époque permettent à un bogue lié à un horodatage absolu de subsister par hasard.
Résultat : La suite a réussi le test de référence et a détecté l'analyse numérique permissive, le zéro considéré comme une valeur fausse, ainsi qu'un délai négatif pour une date passée. Elle n'a toutefois pas détecté le cas particulier qui renvoyait l'horodatage absolu de la date analysée. Les deux tests de date utilisaient des valeurs alignées sur l'époque, de sorte que le délai attendu correspondait justement à l'horodatage.
Conclusion pratique : Les tests générés par l'IA constituent une première étape utile, mais ne constituent pas une garantie d'exactitude. Demandez-vous ce que chaque test permet de mettre en évidence. Les tests de mutation, les tests de propriétés et les valeurs délibérément non conformes peuvent révéler une suite de tests qui ne fait que paraître exhaustive.
Les versions Grok 4, Grok 4.6 et Grok Build ne sont pas identiques.
Contexte du lancement de juillet 2025. L'ancien slug de l'API a ensuite été supprimé.
L'étiquette renvoyée par la passerelle dans ces quatre tâches isolées.
Un agent distinct capable de fonctionner dans le cadre d'un workflow de référentiel interactif ou sans interface utilisateur.
Un outil Python fonctionnant en mode sandbox qui doit être activé dans une requête prise en charge.
Le Annonce originale Grok 4 Il s'agit du contexte historique du lancement. Cela ne décrit pas le modèle utilisé lors de nos essais de 2026.
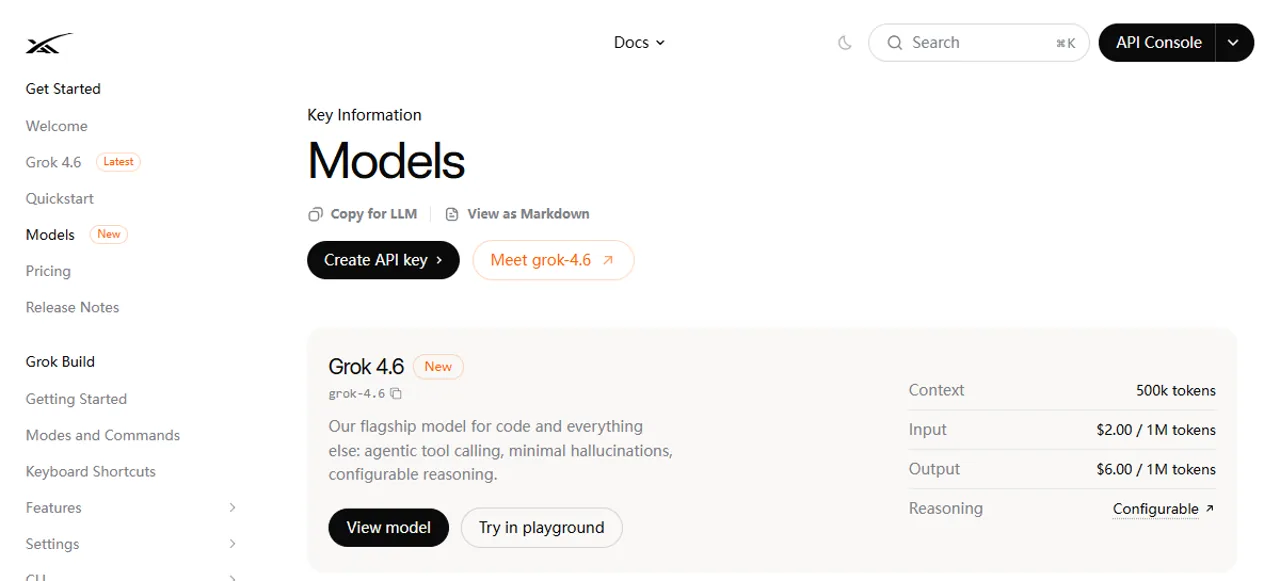
xAI’s Avis de migration du 15 mai 2026 dit grok-4-0709 redirige désormais vers le modèle Grok 4.3, ce qui n'est pas très logique. Cela ne signifie pas pour autant que tous les produits portant le nom de la gamme Grok 4 ont disparu ; cela signifie simplement que l'identifiant exact du modèle a son importance.
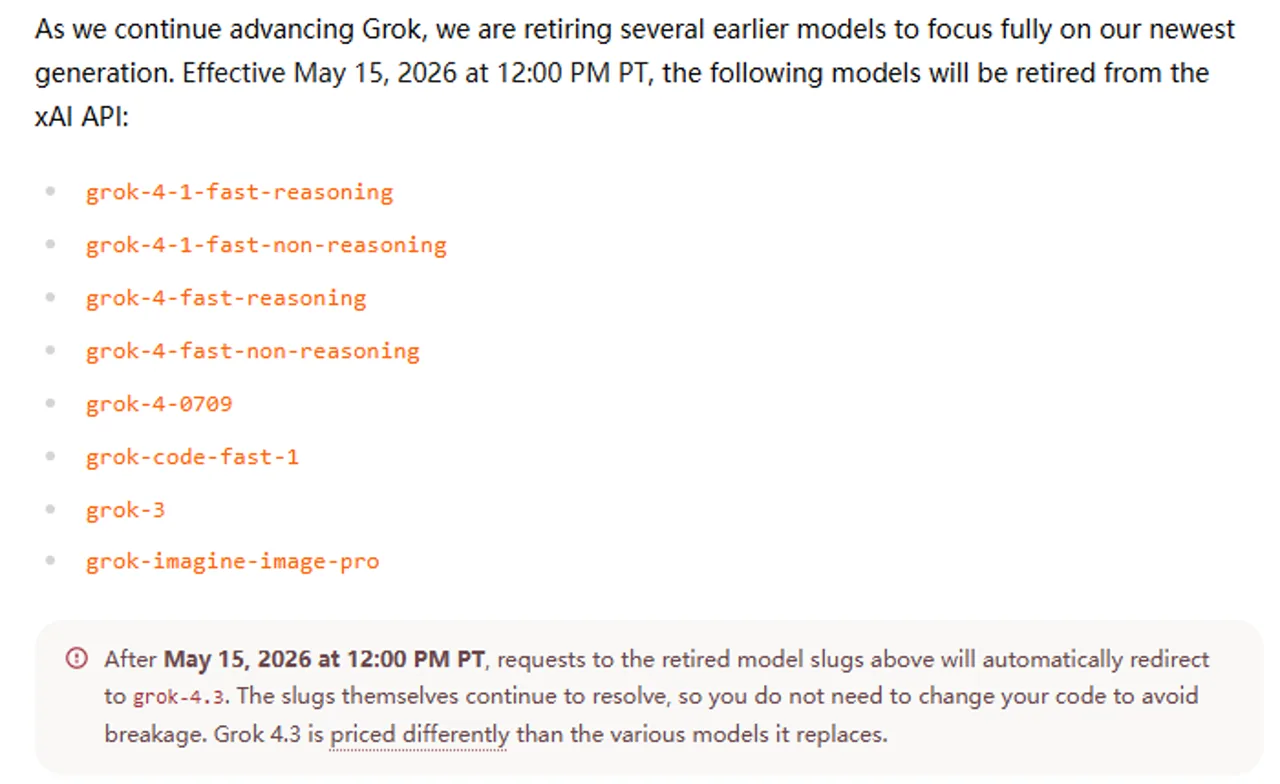
Le modèle Grok 4.6 est celui que xAI recommande actuellement pour le code. Le site officiel Spécifications du modèle Grok 4.6 Parmi les outils pris en charge figurent l'appel de fonctions, la recherche sur le Web, la recherche X et l'exécution de code. La prise en charge ne signifie pas pour autant une activation automatique : c'est toujours le produit appelant ou la requête API qui détermine ce que le modèle peut voir et faire.
Le Annonce concernant le Grok 4.6 cette approche s'inscrit dans le cadre des agents à exécution longue et du travail sur la base de code. Il s'agit là d'un argument de vente officiel du produit, et non d'un résultat obtenu de manière indépendante par nos quatre tâches JavaScript isolées.
Version Grok est l'agent de codage autonome. Son interface interactive en ligne de commande et son mode sans interface graphique permettent de s'intégrer dans un flux de travail de référentiel. Si vous effectuez une sélection parmi des noms de modèles plutôt que parmi des produits de codage, le Meilleur modèle Grok par tâche Ce guide présente la famille actuelle.
Le Outil d'exécution de code xAI Il s'agit d'un environnement Python en mode sandbox facultatif. Il n'était pas activé lors de nos tests avec Broly ; le modèle n'a donc pas exécuté son propre code JavaScript ni examiné les retours de l'évaluateur avant de répondre.
Meilleurs cas d'utilisation du codage pour le Grok
Débogage d'une erreur isolée
Grok s'avère particulièrement utile lorsque le problème peut être réduit à une fonction, une trace de pile, un test défaillant ou un petit diff. Indiquez ce qui devrait se passer, ce qui s'est réellement passé et les limites que vous ne souhaitez pas voir modifiées. Le résultat de l'attribution des places montre comment un cas limite précis peut transformer une demande vague du type “ corrigez cela ” en un correctif vérifiable.
Création d'une première implémentation
En ce qui concerne les adaptateurs, les analyseurs syntaxiques, les fonctions de transformation et les exemples d’API, Grok permet d’éliminer les obstacles liés aux pages vierges. Demandez la plus petite unité complète, les versions de la bibliothèque de broches, puis exécutez l’extrait de code. Le Guide d'intégration API Grok 4 c'est l'étape suivante lorsque le travail porte sur l'API plutôt que sur une solution de code isolée.
Révision ou élaboration d'épreuves
Demandez à Grok les cas limites manquants, les invariants et les mutants candidats. Vérifiez ensuite si chaque entrée permet de distinguer le comportement qu’elle prétend tester. La suite de tests « Retry-After » semblait exhaustive sur le papier, mais une paire d’horodatages alignés a permis à un bug sémantique de passer inaperçu.
Comparaison des différentes approches
Grok est également utile pour obtenir un deuxième avis sur un algorithme, une structure de données ou une hypothèse de débogage. Lorsque la décision porte sur l'adéquation d'un assistant plutôt que sur un correctif ponctuel, le Comparaison des codes Grok et ChatGPT ajoute une vue inter-modèles.
Dans les cas où le codage Grok nécessite une supervision
Refactorisations préservant le comportement : Le modèle peut répondre aux exigences de l'algorithme demandé tout en ne disposant pas d'un champ de sortie. Effectuez des tests de régression et comparez les sorties sérialisées, les erreurs, l'ordre des éléments, les mutations et les effets secondaires.
Modifications apportées au référentiel contenant plusieurs fichiers : Nos outils ne couvrent pas la détection des dépendances, les systèmes de compilation, la recherche de code, les fichiers générés, les migrations ni les modifications coordonnées. Utilisez un véritable agent de codage disposant d’un accès limité au dépôt, puis examinez ses commandes et les différences. Le Comparaison entre Codex et l'agent de codage Claude montre pourquoi le flux de travail qui l'entoure est tout aussi important que le modèle lui-même.
Tâches liées à la sécurité et à la production : Ne considérez pas une réponse affirmative comme un modèle de menace, un audit des dépendances ou une autorisation de déploiement. Intégrez systématiquement les processus d’intégration continue (CI), d’analyse statique, de scan des secrets, de mise en production, de retour en arrière et de vérification humaine dans le cycle.
Formats machine-à-machine stricts : Trois des quatre réponses brutes utilisaient une balise Markdown, malgré des instructions explicites interdisant l'utilisation de Markdown. Il faut valider et analyser la sortie à la limite ; il ne faut jamais transmettre directement le texte du modèle à l'exécution sous prétexte qu'il ressemble à du code.
Coûts et longues chaînes de raisonnement : Notre passerelle a signalé 4 260 jetons de fin de traitement pour une requête avec max_tokens : 4096, principalement en tant que jetons de raisonnement. Cette observation ne prouve pas le comportement de facturation ou de plafonnement de xAI. Consultez la source officielle actuelle et comparez-la avec le Grok 4 : Guide de tarification et de configuration de l'API avant d'établir un budget de production.
Un processus pratique pour utiliser Grok dans le code
1. Limiter l'ampleur du problème
Indiquez à Grok le scénario de reproduction le plus simple qui ne fonctionne toujours pas. Précisez l'erreur, le code concerné et un résultat attendu. Supprimez l'historique du projet qui n'est pas pertinent ainsi que les informations confidentielles.
2. Rédigez un contrat, pas une liste de vœux
Indiquez le nom de la fonction, les entrées acceptées, la structure exacte du résultat, l'ordre des éléments, les règles de modification, les limites de dépendance et le format de sortie. Le Mode d'emploi du Grok - Guide n° 4 couvre l'ensemble du processus comptable et de la gestion des relances.
3. Demandez de la petite monnaie
Privilégiez une fonction ou une modification ciblée plutôt qu'une refonte en profondeur. Demandez-lui de conserver le comportement public et de préciser toute hypothèse qu'il a dû formuler.
4. Effectuer des vérifications indépendantes
Exécutez le code en dehors de la réponse du modèle. Ajoutez des cas limites permettant de distinguer des sémantiques proches, vérifiez les mutations des entrées, comparez chaque champ de sortie et testez les échecs attendus. Pour les suites de tests générées, exécutez des mutants connus lorsque le risque le justifie.
5. Examinez les différences et assumez la décision
Lisez le fichier diff final comme s'il provenait d'un contributeur humain. Vérifiez les modifications apportées aux dépendances, les limites de sécurité, l'observabilité et la possibilité de revenir en arrière. La personne chargée de la fusion ou du déploiement reste responsable du résultat.
Ce que les développeurs révèlent publiquement
Les avis du public sont mitigés et dépendent fortement de la tâche, du produit, de la consigne et de la date. Deux commentaires publiés sur Hacker News illustrent cette diversité, mais aucun des deux ne constitue une référence ni une enquête représentative.
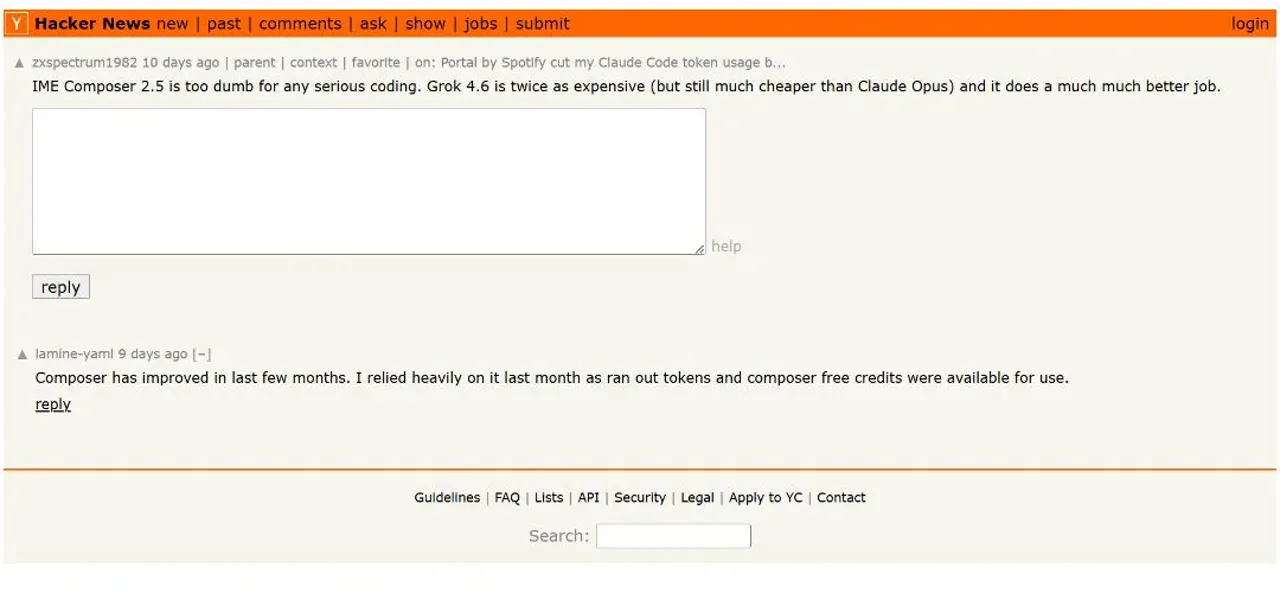
Le 5 septembre 2026, un utilisateur de Hacker News zxspectrum1982 Il a décrit la version Grok 4.6 comme étant bien plus performante que Composer 2.5 pour le codage intensif, tout en précisant qu'elle coûtait plus cher. Il s'agit là de la comparaison d'un utilisateur, et non d'une affirmation générale sur les performances.
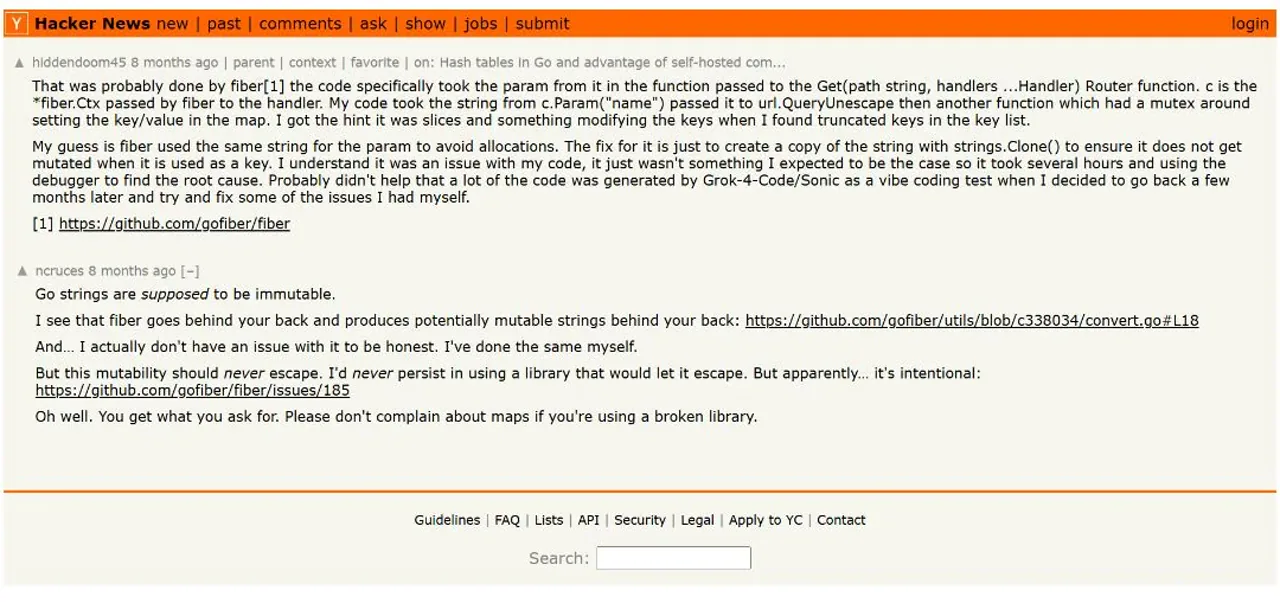
Le 20 décembre 2025, un utilisateur de Hacker News hiddendoom45 Il a décrit avoir découvert ultérieurement, à l'aide d'un débogueur, un bug subtil lié à la durée de vie des chaînes dans Go/Fiber, après la génération du code lors d'une expérience Grok-4-Code/Sonic. Ce récit historique plaide en faveur du débogage manuel et d'une révision tenant compte de la durée de vie ; il n'établit toutefois pas de taux de défaillance de Grok 4,6.
Le point commun n'est pas que la méthode Grok aboutisse ou échoue systématiquement. C'est plutôt que la qualité du code ne se révèle qu'une fois que le code est confronté à une tâche concrète, à une chaîne d'outils et à un relecteur. Il en va de même dans le cas distinct de Analyse réaliste du codage ChatGPT: la qualité de l'assistance est indissociable de la vérification.
Foire aux questions
Le modèle Grok 4 est-il adapté aux débutants en programmation ?
Oui, pour les explications, les petits exemples et le débogage guidé. Les débutants doivent toutefois tester chaque extrait de code, se demander ce que chaque ligne modifie et éviter de copier-coller des informations confidentielles ou de déployer du code qu'ils ne connaissent pas sans l'avoir vérifié au préalable.
Quel modèle Grok dois-je utiliser pour le codage ?
D'après les informations vérifiées le 11 septembre 2026, xAI recommande Grok 4.6 pour le code. Vérifiez l'identifiant exact du modèle dans votre produit, car le slug API d'origine « grok-4-0709 » n'est plus utilisé.
Le modèle Grok 4.6 permet-il de modifier l'intégralité d'un référentiel ?
Le modèle peut faciliter le travail sur les référentiels lorsqu'il est utilisé au sein d'un agent disposant d'un accès limité aux fichiers et aux commandes. Nos tests portaient sur des requêtes isolées ; ils ne permettent donc pas de démontrer une capacité autonome à traiter plusieurs fichiers ni une maturité suffisante pour une utilisation en production.
La commande « Grok Build » revient-elle au même que d'utiliser « Grok » dans le chat ?
No. Grok Build est un agent de codage interactif ou « headless » indépendant. Une complétion standard via le chat ou l'API ne récupère pas automatiquement le contexte de son référentiel, son terminal, ses autorisations ni sa boucle d'outils.
Puis-je utiliser la version Grok 4.6 pour le codage sur la version GlobalGPT ?
Oui. GlobalGPT propose un parcours Grok 4.6 validé pour les prompts de codage bornés et les comparaisons de modèles. Il s’agit d’une plateforme indépendante qui ne remplace ni Grok Build, ni un environnement de développement intégré (IDE), ni les outils API natifs de xAI.
Dois-je faire confiance au code généré par Grok sans le tester ?
Non. Exécutez le code, ajoutez des cas limites, examinez les différences et lancez vos vérifications habituelles (lint, type, sécurité et CI). Notre refactorisation semblait correcte, mais elle omettait un champ obligatoire dans chaque résultat non vide.
Verdict final
Le modèle Grok 4 est-il adapté à la programmation ? Le modèle actuel Grok 4.6 est un assistant de codage performant pour les corrections limitées, les petites fonctions, les explications et les tests de première étape. Dans notre suite de quatre tâches, il a produit deux solutions entièrement correctes, une refactorisation altérant le comportement et une suite de tests incomplète. Il a également ignoré une consigne interdisant strictement l'utilisation du Markdown dans trois réponses.
Utilisez-la lorsque la détection des défaillances ne présente pas de risque : périmètre restreint, contrats explicites, fixtures exécutables et vérification humaine. Ne considérez pas ces éléments comme une autorisation pour apporter des modifications au dépôt sans supervision, pour valider la sécurité ou pour procéder à un déploiement en production.
Pour un essai pratique, ouvrir Grok 4,6 sur GlobalGPT, exécutez l'une des commandes complètes ci-dessus et comparez le résultat avec vos propres tests avant de décider si elle a sa place dans votre flux de travail.