Le DeepSeek V4 Pro est désormais disponible en version de série, mais le choix entre les modèles Pro, Flash et Vision-Exp s'est compliqué après les mises à jour d'août 2026. Ces trois modèles appartiennent à la même gamme, mais répondent à des priorités différentes : fiabilité dans des conditions complexes, coût et volume, ou traitement des images.
Le choix pratique dépend avant tout de la charge de travail. La version Flash constitue le point de départ le plus judicieux pour les volumes importants de texte et les automatisations soumises à des contraintes budgétaires. La version Pro est plus adaptée lorsque des réponses incohérentes entraînent des retouches coûteuses. Lorsque les données d'entrée contiennent des images, utilisez deepseek-v4-flash-vision-exp plutôt que l'un ou l'autre de ces modèles exclusivement textuels.
Si vous préférez regrouper la recherche, la rédaction, le raisonnement et l'aide au codage au sein d'un même flux de travail, vous pouvez accéder à GlobalGPT. Il existe également un itinéraire dédié pour DeepSeek V4 Pro. Il s'agit d'une alternative d'interface ; la facturation, les limites et les intégrations officielles de l'API restent gérées au sein de l'environnement propre à DeepSeek.

La version DeepSeek V4 est-elle officiellement sortie ?
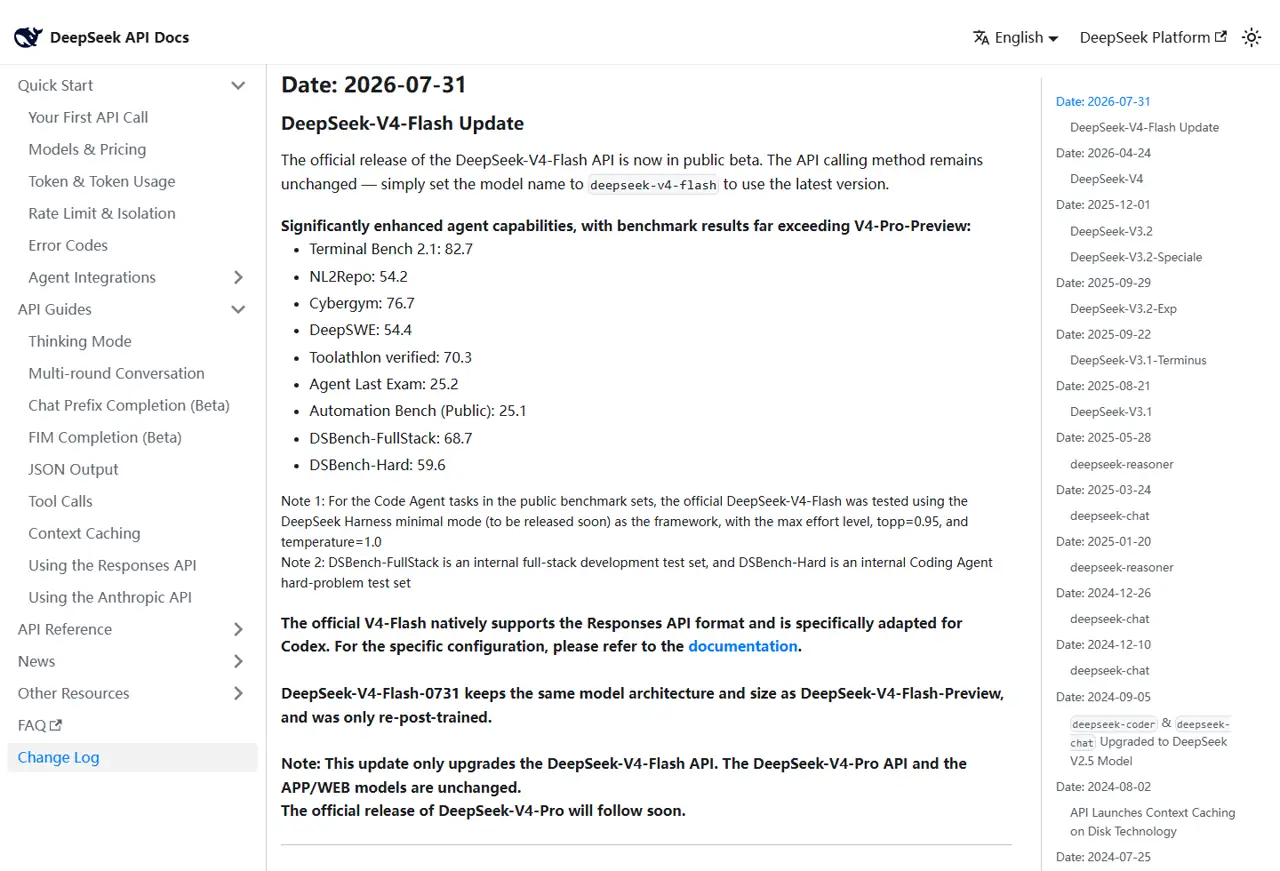
Oui. DeepSeek a annoncé la mise à disposition générale de V4 Pro le 13 août 2026. La documentation officielle désigne le modèle de série sous le nom de DeepSeek-V4-Pro-0813. V4 Flash s'affiche sous la forme DeepSeek-V4-Flash-0731, tandis que le modèle expérimental de vision a été lancé le 21 août sous le nom de deepseek-v4-flash-vision-exp.
- V4 Pro : un modèle textuel destiné à des tâches plus exigeantes.
- V4 Flash : un modèle de texte optimisé en termes de coût et de volume.
- V4 Flash Vision-Exp : une variante expérimentale qui prend en charge les images.
La disponibilité générale ne signifie pas que tous les produits ou fournisseurs proposent la même interface, les mêmes quotas ou les mêmes possibilités d'intégration. Pour toute décision relative aux API, veuillez vous reporter à la documentation officielle Modèles et tarifs page et la Note de mise à jour GA.
DeepSeek V4 Pro
Version : Pro-0813
Le plus adapté : une programmation plus complexe, des agents, le raisonnement et des livrables comportant de nombreuses contraintes.
DeepSeek V4 Flash
Version : Flash-0731
Le plus adapté : la production à haut débit, le codage courant, la recherche de données et les tâches où le coût est un facteur déterminant.
Ces noms peuvent prêter à confusion, car le rapport technique V4 décrit des variantes “ Preview ”, tandis que l'API en production utilise des versions de production datées. Dans le cadre de cette analyse, “ Pro ” désigne Pro-0813 et “ Flash ” désigne Flash-0731, sauf si une phrase mentionne explicitement « V4 Preview ».”
Quelles sont les nouveautés de la version DeepSeek V4 Pro ?
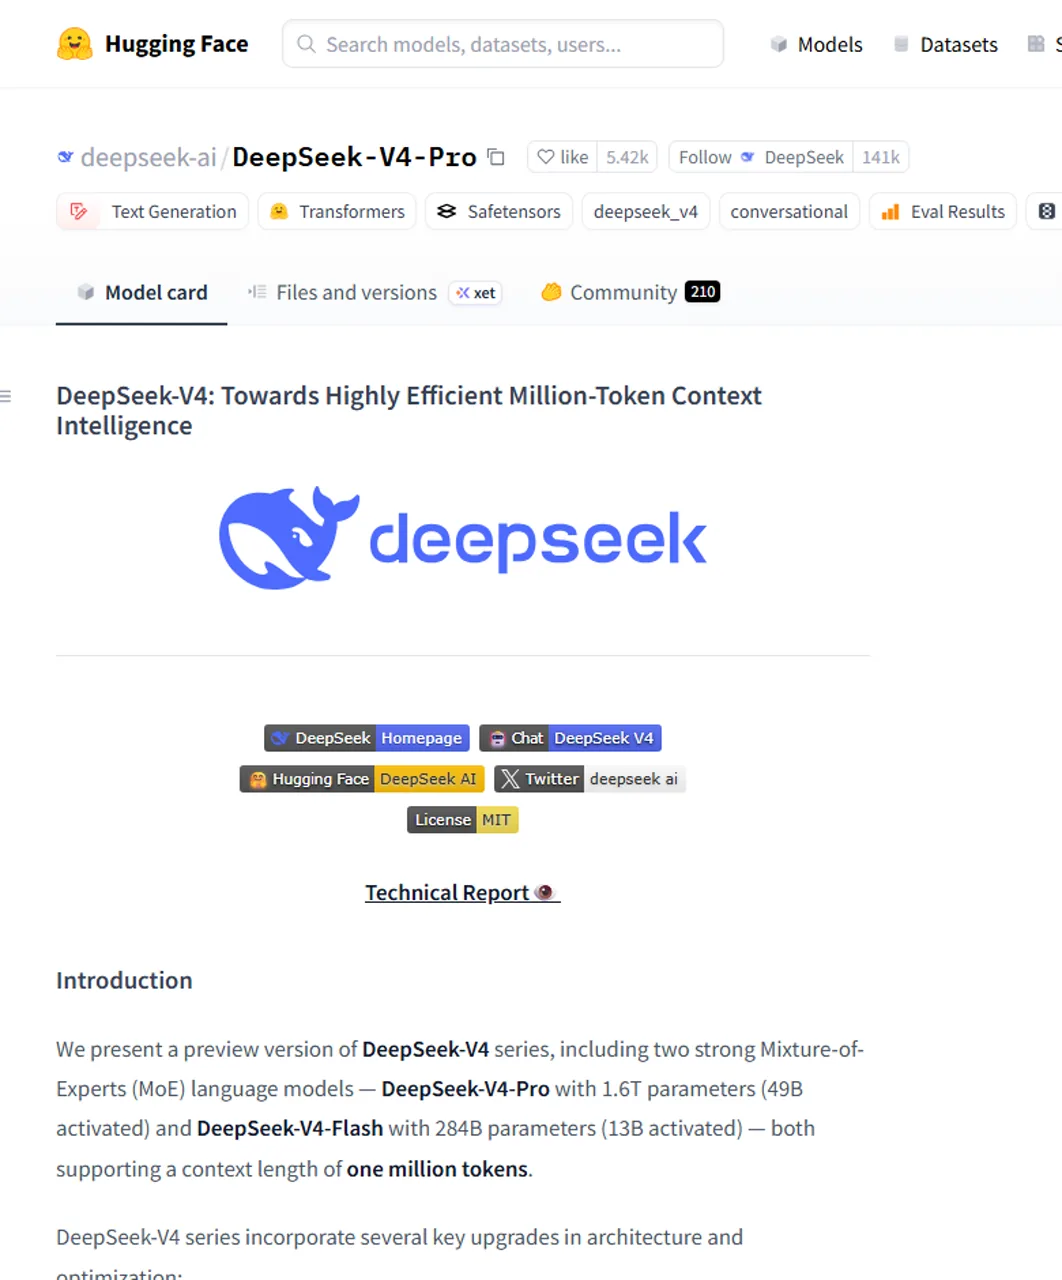
Les changements les plus marquants concernent l'échelle, la capacité contextuelle, les interfaces orientées agents et une stratégie produit à deux niveaux. DeepSeek’s carte officielle du modèle Pro présente un modèle de type « mixture-of-experts » comportant 1,6 billion de paramètres au total et 49 milliards de paramètres actifs, publié sous licence MIT. Les documents V4 qui l'accompagnent décrivent de nouveaux travaux sur l'attention et le routage visant à rendre viable le traitement de millions de tokens.
- Deux niveaux actuels : Pro pour les travaux où la qualité est primordiale, et Flash pour le débit et les coûts.
- Une mémoire de travail bien plus longue : une fenêtre de contexte de 1 million de tokens pour les deux modèles.
- Plafond de production élevé : jusqu’à 384 000 jetons de sortie, selon la spécification officielle.
- Interfaces d'agent : appels d'outils, sortie JSON, API de réponses et accès compatible avec Anthropic.
- Poids libres : Les fiches techniques et fichiers officiels du modèle V4 sont disponibles, même si un déploiement local à grande échelle reste un projet d'infrastructure de grande envergure.
Cette combinaison rend V4 particulièrement adapté au codage à l'échelle d'un référentiel, aux longs paquets de recherche et aux traces d'agents en plusieurs étapes. Elle modifie également le cadre de la concurrence : une évaluation pertinente doit désormais aller au-delà de la qualité des conversations et s'interroger sur le comportement du modèle lorsqu'il est soumis à des outils, à des formats stricts et à des entrées longues. Notre Comparaison entre DeepSeek et ChatGPT fournit davantage d'informations sur les différences entre ces écosystèmes.
DeepSeek V4 Pro vs Flash : la différence concrète
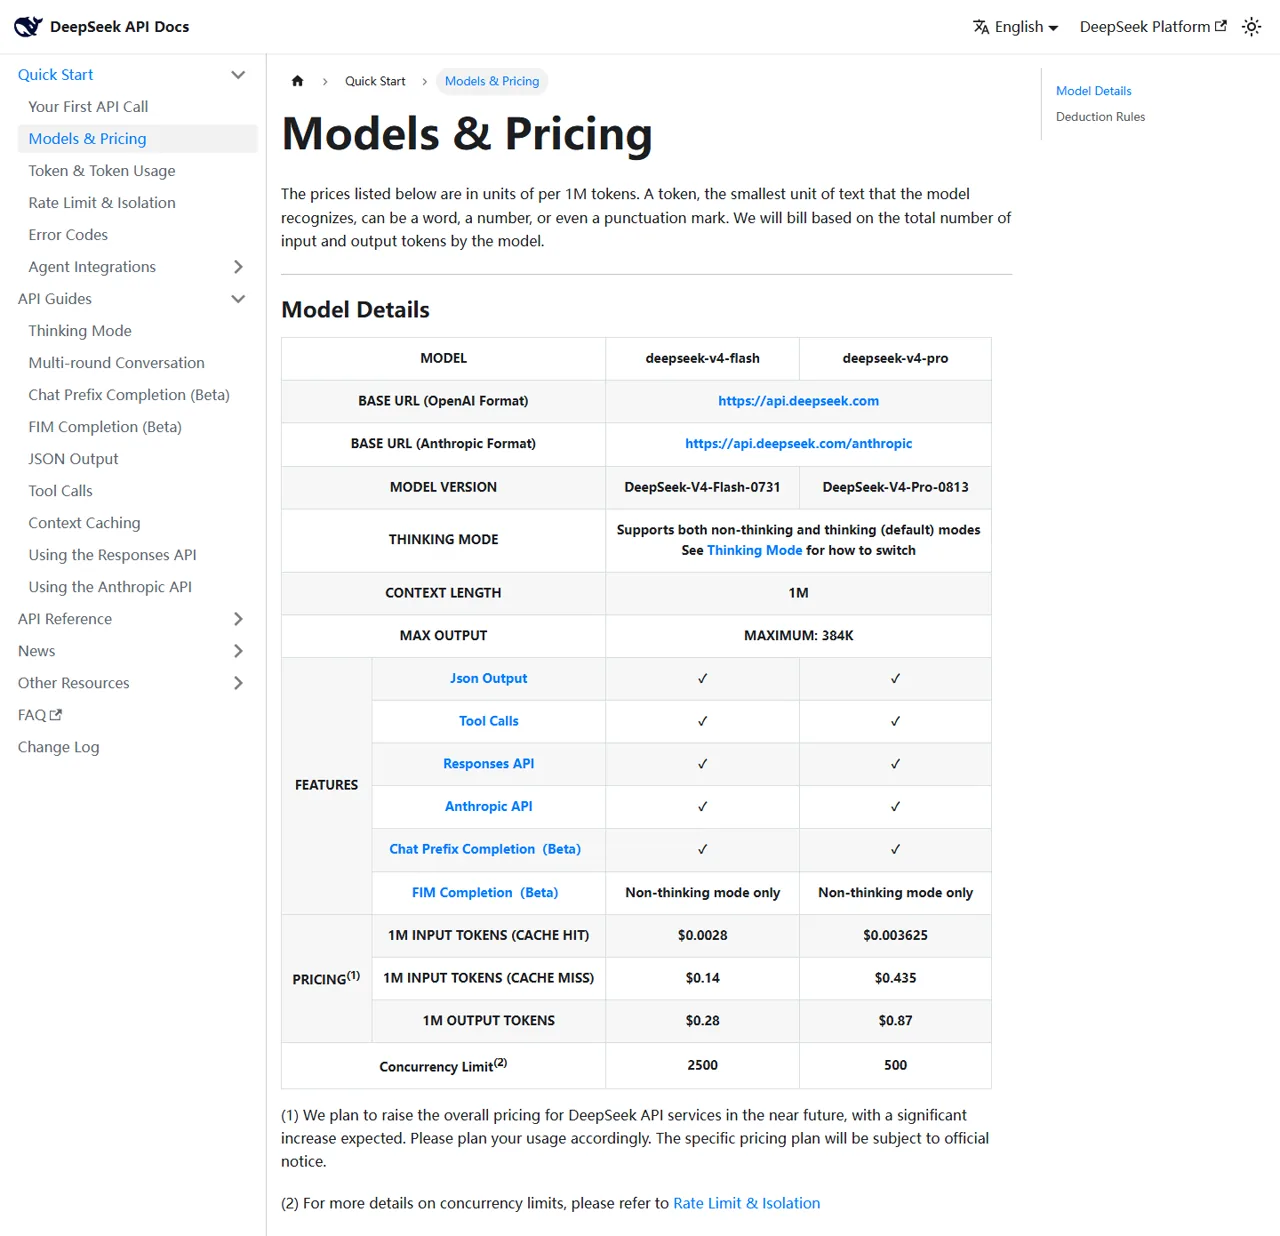
Les deux versions présentent les mêmes contraintes en matière de contexte et de limites de sortie ; il ne s'agit donc pas d'un choix entre un “ modèle complet ” et un « modèle à contexte réduit ». Il s'agit principalement d'une décision liée à la qualité, au prix et à la planification des capacités. Le plafond officiel de concurrence de Flash est cinq fois supérieur à celui de Pro, tandis que les jetons d’entrée et de sortie en cas d’échec de cache de Pro coûtent un peu plus de trois fois plus cher.
Pro vs Flash : en bref
Caractéristiques techniques et prix officiels vérifiés le 13 août 2026 ; les observations pratiques sont issues d'un seul test par tâche et ne constituent pas des résultats de benchmark officiels.
Choisissez Flash lorsque…
Vous avez besoin d'une solution évolutive et peu coûteuse, de corrections de code courantes, d'opérations d'extraction et de classification, ou encore de traiter de nombreuses requêtes en parallèle — et vous pouvez valider des calculs critiques ainsi que des contraintes de format.
Optez pour la version Pro lorsque…
Le résultat tient compte à la fois du code, de la politique, des aspects financiers et de nombreuses contraintes précises, et le surcoût est inférieur au coût d'un échec, même minime.
Tests pratiques : codage, récupération et respect des contraintes
Nous avons testé les deux identifiants de modèle API via le même point de terminaison Broly Anywhere compatible avec OpenAI le 13 août 2026. La température était de 0. Chaque résultat noté correspond à un test par modèle et par tâche. Le temps réel inclut les délais liés à la passerelle et en amont ; il s'agit donc d'une observation utile, mais non d'un classement stable en termes de latence.
Fiche d'évaluation pratique
Pro et Flash ont tous deux réussi tous les tests corrigés.
Les deux réponses ainsi que toutes les références aux documents requis étaient correctes.
Pro respectait toutes les règles ; Flash ne respectait pas les contraintes arithmétiques et de longueur.
Test n° 1 : débogage Python avec agentic
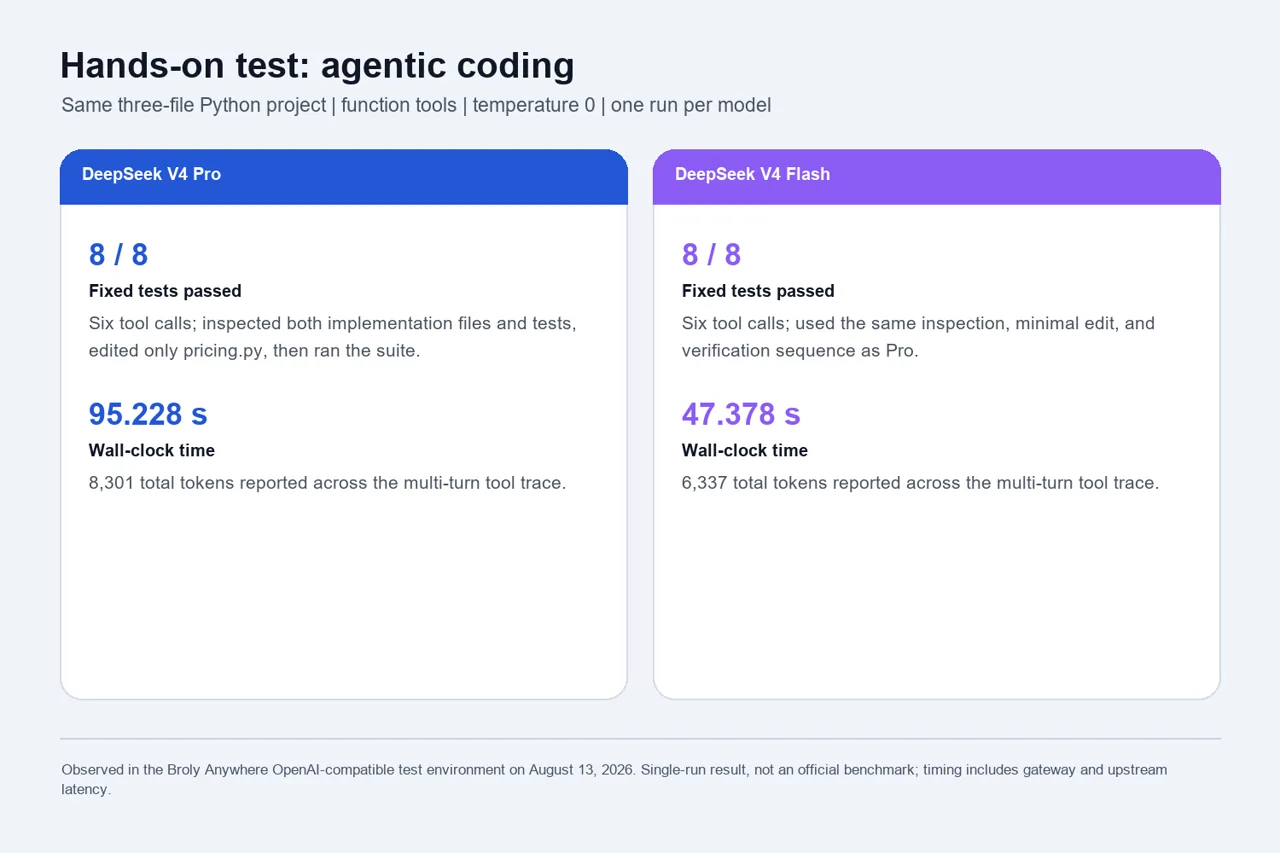
Le harnais a fourni à chaque modèle quatre outils — parcourir des fichiers, lire un fichier, écrire un fichier et exécuter des tests — au sein d'un petit projet Python de tarification composé de trois fichiers. Cela s'apparente davantage à un flux de travail d'agent qu'à la demande d'un extrait de code dans un chat.
Déboguer, corriger et vérifier un projet Python de tarification
Les deux modèles ont suivi le même enchaînement de six appels, en ne modifiant que la mise en œuvre, et ont produit 8 ont réussi. Flash a bouclé ce parcours en 47,378 secondes, contre 95,228 secondes pour Pro, et a utilisé moins de jetons récupérés. Il n'y a pas eu de vainqueur en termes de qualité dans cette épreuve. Pour un autre point de vue axé sur le code, consultez notre Test de programmation Python : DeepSeek vs ChatGPT.
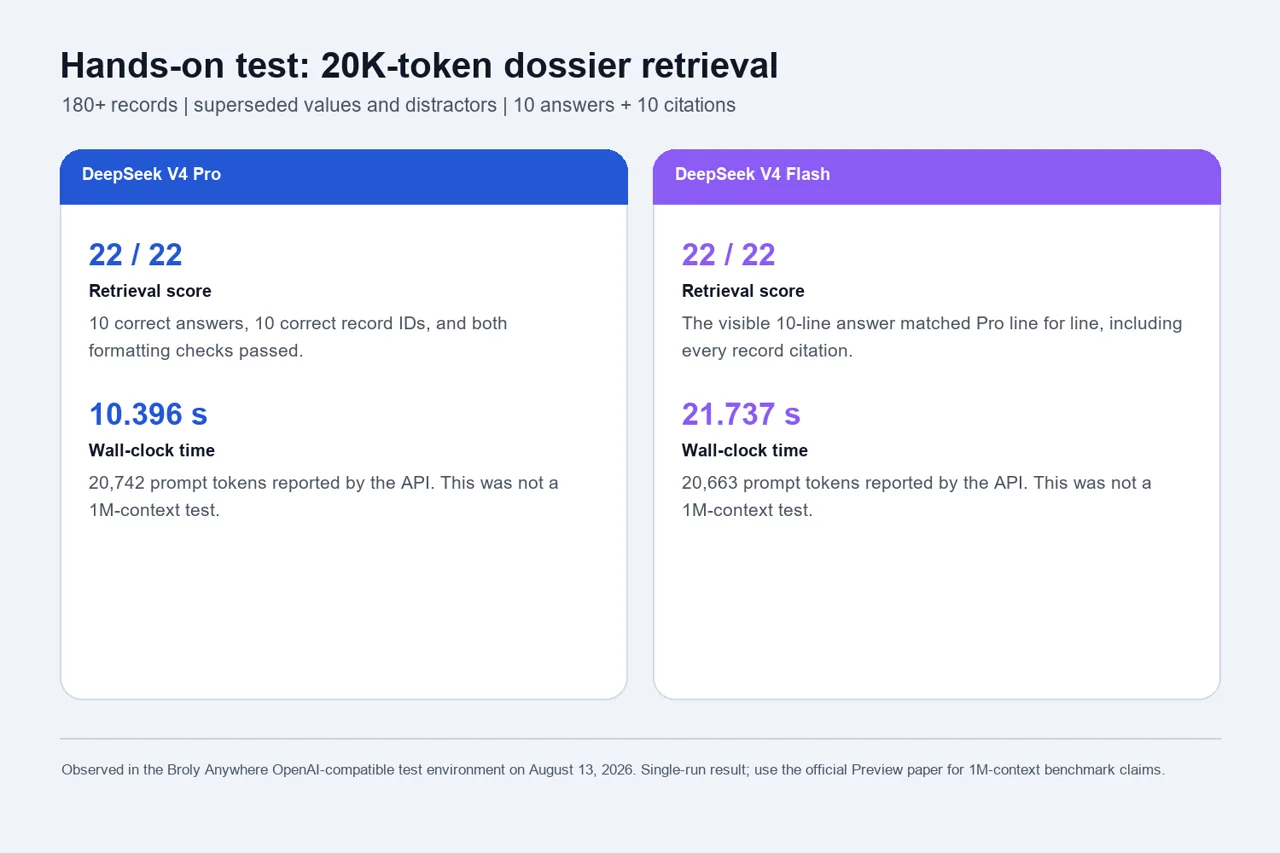
Test n° 2 : recherche d'un dossier d'environ 20,7 K-tokens
Nous avons joint un dossier contenant plus de 180 documents, des éléments de distraction récurrents, des brouillons obsolètes et dix faits épars. Le modèle devait répondre en respectant strictement un format de dix lignes et citer un document pour chaque réponse.
Répondez à un dossier controversé en fournissant des références précises
Les deux modèles ont obtenu un score de 22/22 : dix réponses correctes, dix citations correctes et deux points attribués pour le respect du format. Pro a terminé cette série en 10,396 secondes et Flash en 21,737 secondes. Le nombre réel de tokens utilisés dans la requête était d'environ 20,7K. Cela en fait un test de recherche de longueur moyenne utile, mais cela pas valider la fenêtre complète de 1 million de jetons.
Test n° 3 : note de décision stricte concernant le lancement
Cette tâche combinait un résumé de 120 à 180 mots, un tableau comportant exactement quatre lignes, des risques fixes et des nombres inconnus, une décision succincte, un fichier JSON valide, ainsi qu'un calcul des coûts pour la première année à partir de notes issues des services financiers, juridiques, d'ingénierie, commerciaux, d'assistance et de sécurité.
Rédiger une note de lancement respectant des règles arithmétiques et de formatage strictes
Avec une limite de 2 048 tokens pour la complétion, les deux modèles ont utilisé l'intégralité du budget de complétion alloué au raisonnement fourni et n'ont produit aucune réponse visible. Nous avons conservé ces enregistrements, puis avons relancé la requête inchangée avec une limite de 8 192 tokens. Pro a obtenu un score de 12/12. Flash a obtenu un score de 8/12 car il a rapporté $217 100 au lieu de $216 900, a reporté l’erreur $200 dans la variance, et a rédigé un résumé de 94 mots au lieu des 120 à 180 mots requis.
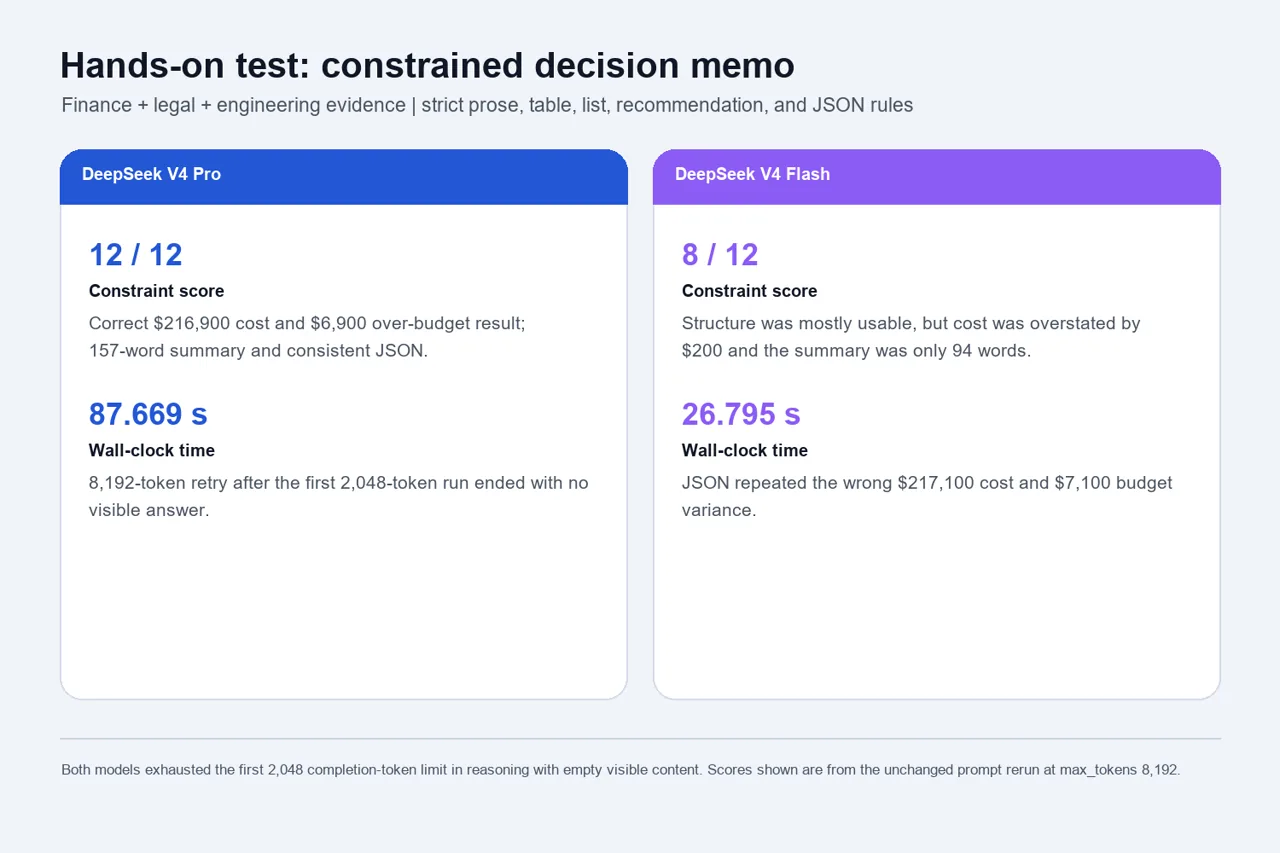
La leçon à en tirer est spécifique et non universelle : Flash excellait déjà dans les tâches de codage et de récupération, tandis que Pro s'est montré plus fiable face à la combinaison la plus complexe de contraintes arithmétiques, structurelles et de politique. Si votre flux de travail repose sur un shell d'agent, notre Comparaison entre OpenClaw, Claude et OpenCode permet d'adapter le modèle à l'outil qui l'entoure.
Tests de performance du DeepSeek V4 : ce que révèlent les données officielles
La source de référence la plus fiable est le Rapport technique DeepSeek V4, mais ses tableaux et graphiques décrivent les modèles V4 Preview. Ils permettent de mieux comprendre les capacités prévues de l'architecture et la configuration des tests ; il ne s'agit pas de résultats indépendants pour la version datée de l'API Pro-0813.
Les scores de l'aperçu ne correspondent pas aux scores Pro-0813
Architecture et résultats des tests de performance de DeepSeek.
Versions de production obsolètes répertoriées dans la documentation de l'API.
Les résultats de l'aperçu ne peuvent pas être renommés en « Pro-0813 ».
La mise à jour Flash du 31 juillet publie également les résultats des agents et précise le harnais, les paramètres et la prise en charge de Codex. Ces détails sont importants car les classements inter-fournisseurs peuvent varier en fonction de la structure, du budget de raisonnement, des définitions des outils et des règles de nouvelle tentative. Un résultat sans indication du harnais utilisé ne suffit pas pour désigner un vainqueur sans réserve.
Pour la même raison, nos trois tâches viennent compléter les données officielles au lieu de les remplacer. Elles vous indiquent ce qui s'est passé dans un contexte donné. Si vous comparez des produits d'agents plutôt que de simples API de modèles, notre Guide comparatif : Codex vs Claude explique pourquoi le contexte de travail peut influencer l'expérience utilisateur.
Tarifs de l'API DeepSeek V4
La tarification de l'API de DeepSeek est exceptionnellement compétitive lors de son lancement. Le tableau ci-dessous reprend les chiffres officiels par million de jetons, vérifiés le 13 août 2026. La page officielle précise également que les prix augmenteront considérablement à l'avenir ; il convient donc de considérer ces chiffres comme datant de la période de lancement.
Prix pour 1 million de jetons
Une charge de travail simple sans mise en cache, comprenant 10 millions de jetons d’entrée et 2 millions de jetons de sortie, correspondrait à $1,96 sur Flash et à $6,09 sur Pro, selon ces tarifs. Cet exemple ne tient pas compte des accès au cache, des majorations des fournisseurs, des nouvelles tentatives ni d’éventuelles modifications ultérieures des prix. Les équipes chargées de comparer les fournisseurs doivent utiliser une seule combinaison de jetons et une seule base de facturation ; notre Guide des tarifs de l'API Claude Opus 4.6 explique pourquoi les entrées, les sorties et la mise en cache doivent faire l'objet de lignes distinctes.
Que signifie la fenêtre de contexte de 1 M ? Et quelles sont ses limites ?
Une fenêtre contextuelle de 1 million de tokens correspond à une capacité, et non à la garantie d’un rappel parfait à chaque position. Elle permet à l’API de prendre en charge des référentiels, des collections de documents, des dossiers de recherche ou des historiques d’agents de très grande taille. La question de la qualité réside dans la capacité du modèle à extraire le détail pertinent lorsque les éléments pertinents sont noyés parmi des centaines de milliers de tokens parasites.
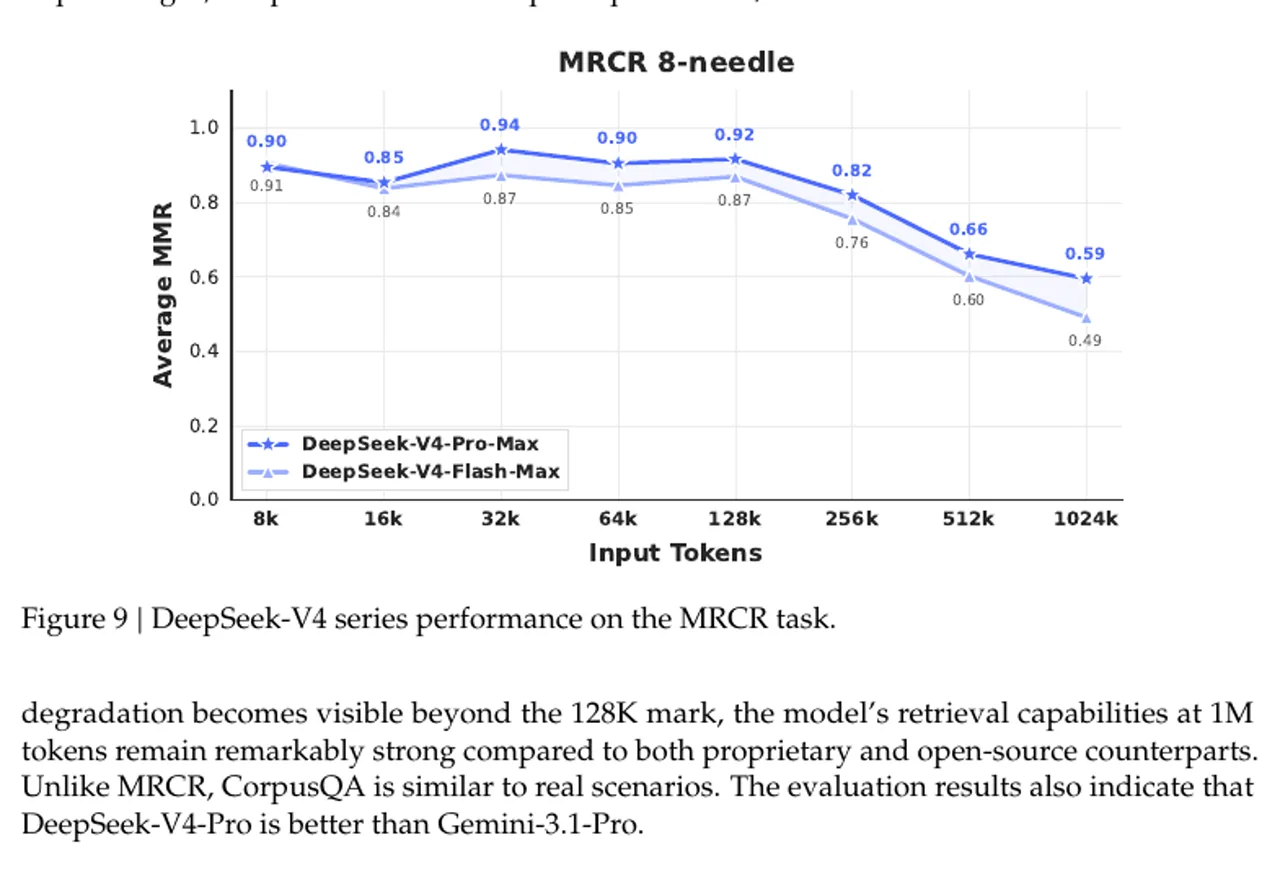
Le rapport “ Preview ” de DeepSeek comprend un graphique de résolution de coréférence en plusieurs itérations (MRCR) pour des entrées allant de 8 000 à 1 million de tokens. La courbe reste solide pour les longueurs plus courtes, mais diminue au-delà de 128K. Il s’agit là d’une preuve évidente d’un problème inhérent au contexte long, et c’est pourquoi “ prend en charge 1M ” ne doit en aucun cas être interprété comme « sans perte à 1M ».”
L'interface API est soumise à des restrictions distinctes. Celles de DeepSeek Guide de l'API « Responses » décrit une implémentation sans état : des fonctionnalités telles que id_de_la_réponse_précédente, les conversations, le magasin et le contexte ne sont pas pris en charge. Les entrées d'images et de fichiers ne sont pas non plus prises en charge ; vous devez donc extraire le texte ou créer la couche d'état en dehors du modèle.
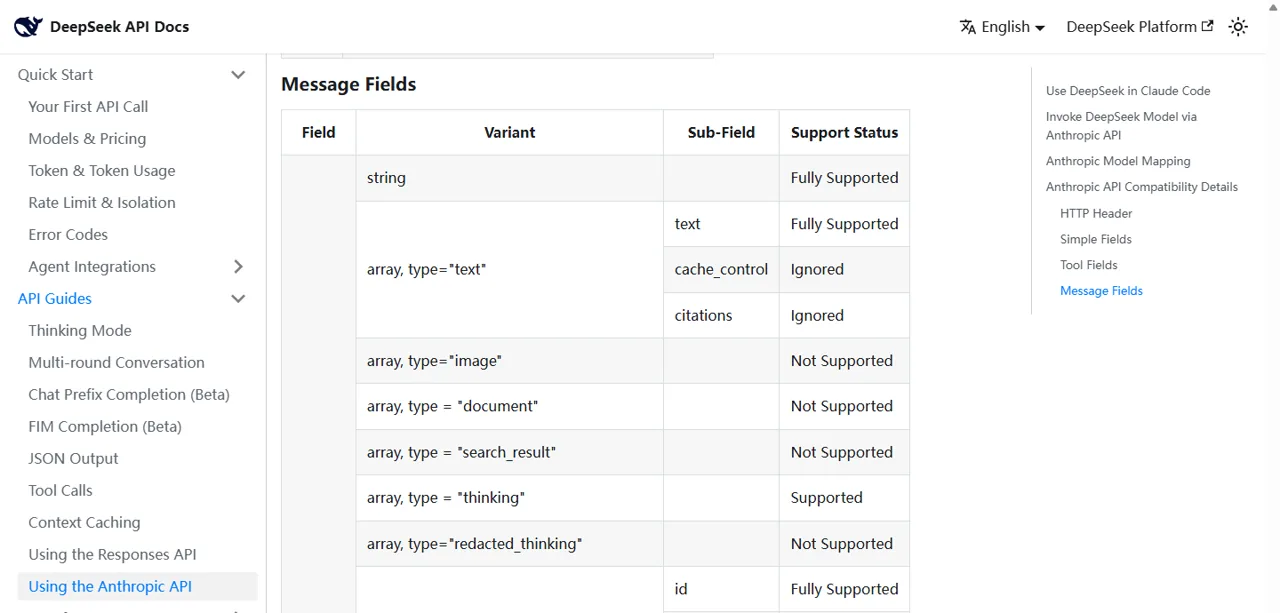
Le Tableau des API compatibles avec Anthropic indique également que certaines variantes d'images et de messages de documents ne sont pas prises en charge. La compatibilité implique donc des formats de requêtes et des outils familiers, et non une parité fonction par fonction avec chaque modèle ou client Anthropic.
Comment tester DeepSeek V4 Pro et Flash
Trois options s'offrent à vous. Choisissez celle qui vous convient le mieux selon que vous souhaitiez simplement échanger rapidement, gérer une API de production ou disposer d'un espace de travail multimodèle.
Choisissez votre chemin d'accès
DeepSeek Web/Application
Idéal pour tester le modèle via l'interface grand public propre à DeepSeek.
API officielle
Idéal pour la facturation par jetons, les outils, le JSON, les frameworks d'agents et le contrôle de la production.
GlobalGPT
Idéal pour ouvrir des fichiers Pro ou Flash dans un environnement de travail multimodèle plus complet, sans avoir à créer de client au préalable.
Option 1 : le chat officiel DeepSeek
Commencez par Site officiel de DeepSeek si vous souhaitez simplement découvrir l'expérience utilisateur actuelle. L'accès grand public et la facturation de l'API sont deux choses distinctes ; le fait qu'une interface de chat soit disponible ne signifie pas que l'API est gratuite.
Option 2 : API officielle et agents de codage
Utilisation deepseek-v4-pro ou deepseek-v4-flash avec les interfaces documentées compatibles OpenAI. Les deux prennent en charge les modes « thinking » et « non-thinking », la sortie JSON, les appels d'outils, l'API Responses et l'accès compatible Anthropic. Le FIM s'applique uniquement en mode « non-thinking ».
DeepSeek publie également un Guide officiel d'intégration de Codex. Si vous hésitez entre plusieurs shells d'agent, comparez d'abord Claude : Tarification et limites d'utilisation du code avant de supposer que le coût du jeton « modèle » correspond au montant total de la facture.
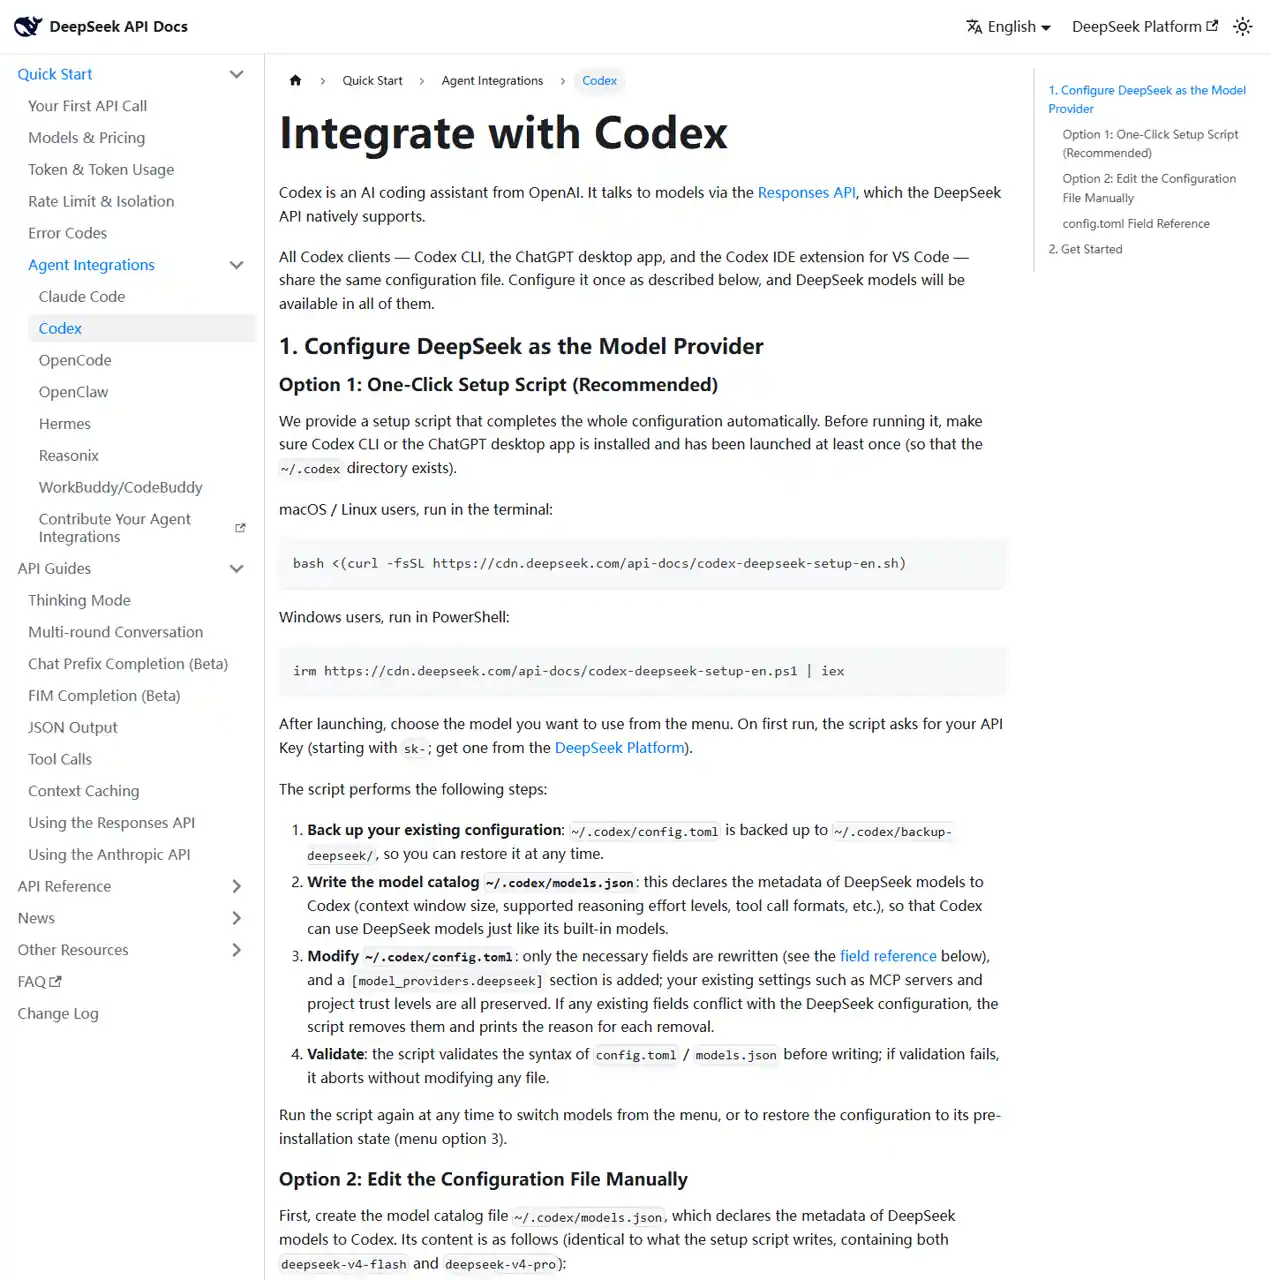
Les utilisateurs du code Claude peuvent suivre la même logique « point de terminaison et modèle » que celle décrite dans notre guide consacré à Configuration d'un modèle dans le code Claude, tout en consultant le tableau de compatibilité en ligne de DeepSeek pour vérifier les champs non pris en charge.
Itinéraire 3 : GlobalGPT
GlobalGPT comporte des entrées spécifiques pour ces deux modèles. La route de conversion validée est la suivante : DeepSeek V4 Pro sur GlobalGPT. Il existe également une page produit au format Flash, mais nous n'avons pas trouvé de paramètre de campagne spécifique à Flash ayant été validé ; nous n'en inventons donc pas.
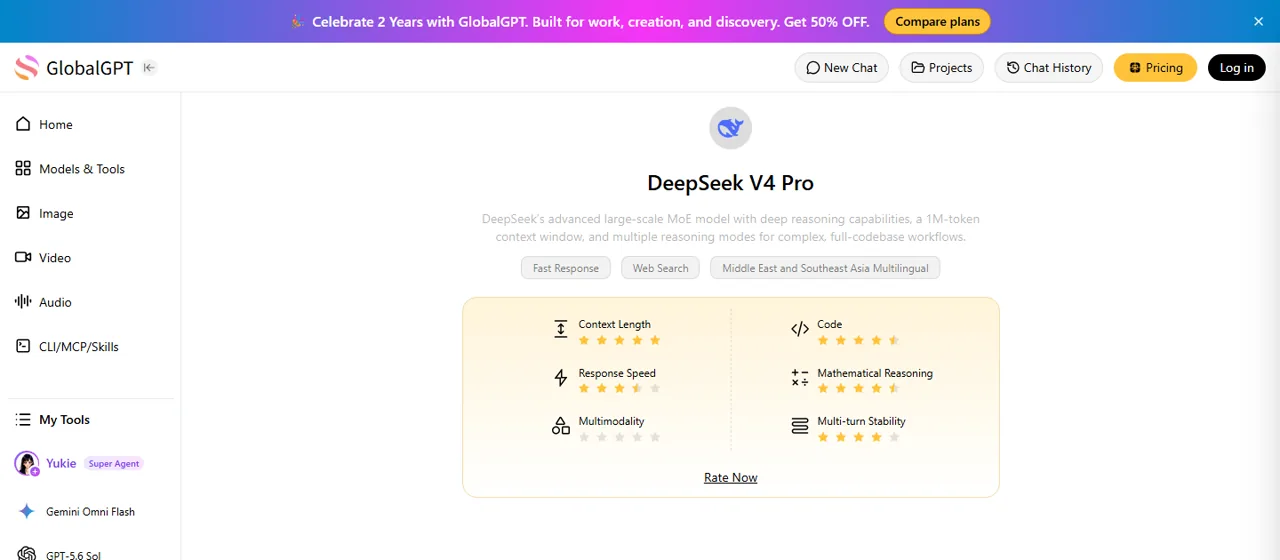
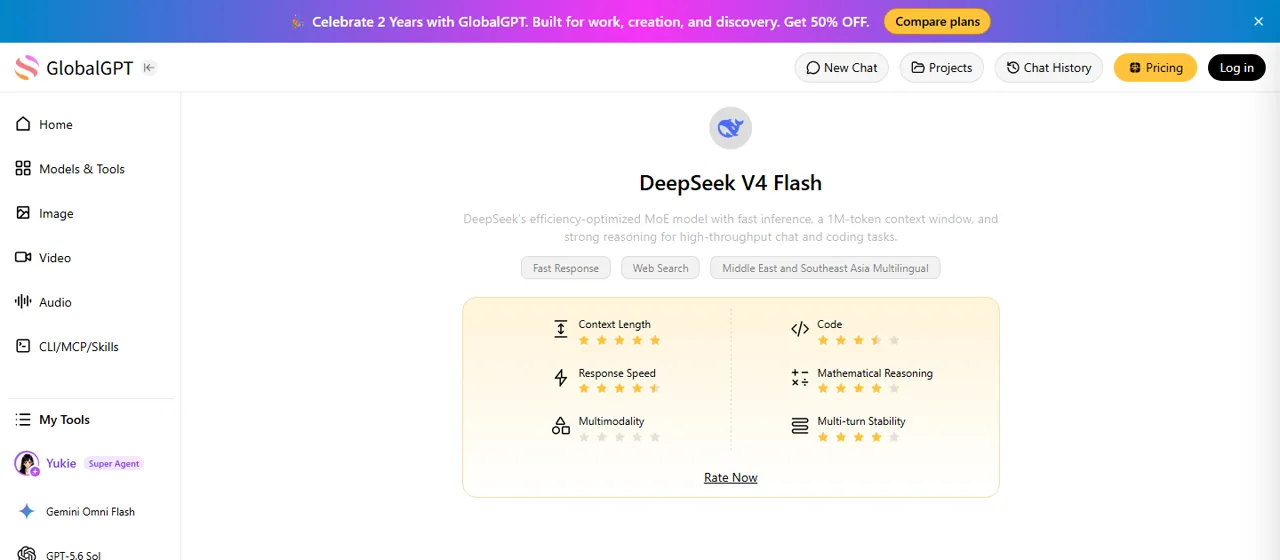
Pour les flux de travail en terminal, le Configuration du code GlobalGPT CLI dans Claude explique comment une plateforme multimodèle peut s'intégrer à une routine de codage existante. Elle ne remplace pas les outils natifs de gestion de référentiels ; elle modifie la manière dont vous accédez aux modèles et les comparez.
Quel modèle DeepSeek V4 choisir ?
Adapter le modèle au coût d'une défaillance
Flash
Optez pour cette solution pour les discussions à fort volume, l'extraction de données, le code de routine, la recherche d'informations et les agents soumis à une validation rigoureuse. Elle a parfaitement réussi deux de nos trois tâches au prix officiel le plus bas.
Pro
Optez pour cette solution lorsque l'arithmétique rigoureuse, la mise en forme, le respect des règles et le raisonnement multi-domaines se rejoignent dans un seul livrable. C'est le seul modèle à avoir obtenu la note de 12/12 à notre évaluation.
GlobalGPT
Optez pour l'approche « plateforme » lorsque vous souhaitez tester le modèle ou comparer différentes options sans avoir à développer au préalable un client API.
Pour de nombreuses équipes, Flash constitue la solution la plus judicieuse pour un premier déploiement : il est nettement moins coûteux, prend en charge les mêmes limites de contexte et de sortie que celles spécifiées, et a géré nos tests de codage et de récupération de 20,7 K sans aucune perte de qualité. Ajoutez des vérifications déterministes pour les nombres, le schéma et les sections obligatoires.
Passez à la version Pro lorsque le temps consacré à la révision ou le coût d'un échec l'emporte sur les économies réalisées grâce aux jetons. L'écart de prix est bien réel, mais la valeur d'une note de conformité ou de lancement bien rédigée dès la première ébauche l'est tout autant. Si votre sélection comprend d'autres assistants, l'éventail plus large Guide de choix : DeepSeek ou ChatGPT peut permettre de distinguer la qualité du modèle de l'écosystème du produit.
Verdict : le DeepSeek V4 Pro en vaut-il la peine ?
Le modèle DeepSeek V4 Pro mérite d'être pris en considération lorsque le travail exige davantage de contrôle que de volume. Ce n’est pas l’option par défaut la plus économique : dans l’API, la version Pro coûte trois fois plus cher que la version Flash sur les lignes d’entrée et de sortie principales en cas d’échec de mise en cache, tant pendant les périodes de pointe qu’en dehors. Ce surcoût se justifie lorsqu’une réponse erronée entraîne un surcroît de travail, des frais de révision ou un risque opérationnel.
Pour les tâches courantes, Flash offre le meilleur compromis entre coût et évolutivité. Pour les images, utilisez Vision-Exp. Si l’objectif n’est pas la gestion d’API, mais plutôt de passer de la recherche à la rédaction et à l’assistance technique, un espace de travail multimodèle peut s’avérer plus pratique que de configurer chaque service séparément.
Étape suivante
Ouvrez DeepSeek V4 Pro dans un espace de travail qui regroupe également d'autres modèles destinés à la recherche, à la rédaction et à l'aide au codage.
Essayez DeepSeek V4 ProFoire aux questions sur DeepSeek V4
La version DeepSeek V4 Pro est-elle déjà sortie ?
Oui. La version DeepSeek V4 Pro a été mise à la disposition du grand public le 13 août 2026, sous l'identifiant de production DeepSeek-V4-Pro-0813.
Quelle est la différence entre le DeepSeek V4 Pro et le Flash ?
Flash privilégie le coût et la concurrence, tandis que Pro est conçu pour les tâches de traitement de texte soumises à davantage de contraintes et présentant un coût d'échec plus élevé. Les deux versions proposent une fenêtre de contexte d'un million de tokens et un volume de sortie maximal de 384 000 tokens.
Combien coûte le DeepSeek V4 Pro ?
Par million de jetons, les tarifs « Pro » hors heures de pointe s'élèvent à $0,022 pour les entrées avec accès au cache, à $0,66 pour les entrées sans accès au cache et à $1,98 pour les sorties. Les tarifs en heures de pointe sont respectivement de $0,044, $1,32 et $3,96.
Quelles sont les heures de pointe de l'API ?
Les heures de pointe sont comprises entre 01 h 00 et 04 h 00 et entre 06 h 00 et 10 h 00 UTC, du lundi au vendredi. En dehors de ces horaires, les tarifs hors pointe s'appliquent.
Le DeepSeek V4 prend-il en charge les images ?
deepseek-v4-flash-vision-exp accepte les images. Le guide officiel mentionne les formats JPEG, PNG, GIF et WebP. Les modèles « Pro » et « Flash » doivent être traités séparément.
La fenêtre contextuelle d'un million de tokens garantit-elle une recherche parfaite ?
Non. La limite d’un million de tokens correspond à la capacité. La récupération dépend toujours de la structure du document, de l’emplacement des faits, de la consigne et de la méthode de vérification.
Puis-je utiliser DeepSeek V4 avec Codex ?
Oui. La documentation officielle décrit une intégration via l'API Responses et mentionne Flash, Pro et Vision-Exp parmi les options de modèles disponibles.
Comment puis-je tester DeepSeek V4 Pro sans configurer d'API ?
Vous pouvez utiliser une interface proposant ce modèle, telle que GlobalGPT. Cette solution convient notamment au chat, à la recherche, à la rédaction et à l'assistance technique ; sa facturation et ses fonctionnalités ne sont toutefois pas équivalentes à celles de la console API officielle.