
Il est facile de se tromper sur le prix du GPT-6 Sol, car deux questions sont confondues. Une tarification API est un calcul au compteur basé sur des jetons et la grille tarifaire d'un fournisseur. Un parcours d'abonnement/de workflow correspond à un choix plus général concernant la fréquence à laquelle vous avez besoin d'un ou de plusieurs modèles, ainsi que des outils associés.
Ce guide utilise GPT-6 Sol à GlobalGPT pour les tests pratiques. La page officielle de lancement de OpenAI indique que GPT-6 Sol coûte $2 par million de jetons d'entrée et $10 par million de jetons de sortie, avec une réduction de 90% sur les lectures d’entrée mises en cache (environ $0,20 par million de jetons d’entrée mis en cache). Le calculateur ci-dessous utilise ces tarifs publiés lorsque vous les saisissez et traite séparément l’option d’abonnement.
Pour des travaux interactifs plus approfondis, GlobalGPT réunit GPT-6 Sol et d’autres modèles ainsi que des fonctionnalités d’IA au sein d’un même tableau de bord. C’est un atout lorsque le travail concret passe de la recherche à la rédaction, au code, aux images, à la vidéo ou à un flux de travail connecté à une interface en ligne de commande (CLI).
A Espace de travail GlobalGPT propose une formule d'abonnement couvrant l'ensemble des modèles et des fonctions d'IA. Il s'agit d'un mode d'achat différent de celui des appels API facturés à l'unité par un fournisseur. Le Avis sur le GPT-6 Sol explique comment le modèle s'intègre dans un processus de travail plus large.
Que peut signifier l'expression “ tarification GPT-6 Sol ” ?
Il existe trois aspects distincts liés aux coûts : le compteur de jetons d'entrée/sortie de l'API, les règles facultatives telles que le traitement en cache ou par lots, et le coût d'un abonnement regroupant l'accès et les outils de workflow. Seuls les deux premiers peuvent être ramenés à une formule de calcul des jetons.
- API : C'est particulièrement utile lorsque le logiciel envoie des requêtes prévisibles et que vous avez besoin d'une estimation traçable pour chaque appel.
- Abonnement/processus : c'est particulièrement utile lorsque les utilisateurs passent d'un modèle à l'autre et d'une fonction à l'autre dans le cadre d'une tâche plus large.
- Parcours mixte : Utile lorsque les tâches de production sont programmables, mais que l'exploration, l'écriture ou le travail multimodal sont interactifs.
Statut officiel des tarifs de l'API
OpenAI indique que GPT-6 Sol consomme $2 par million de jetons d'entrée et $10 par million de jetons de sortie. La même page d'annonce précise que les lectures d'entrées mises en cache bénéficient d'une remise de 90%, ce qui correspond à $0,20 par million de jetons d'entrée mis en cache. OpenAI présente ces tarifs comme étant inférieurs de 50% au tarif promotionnel de GPT-5.6 Sol.
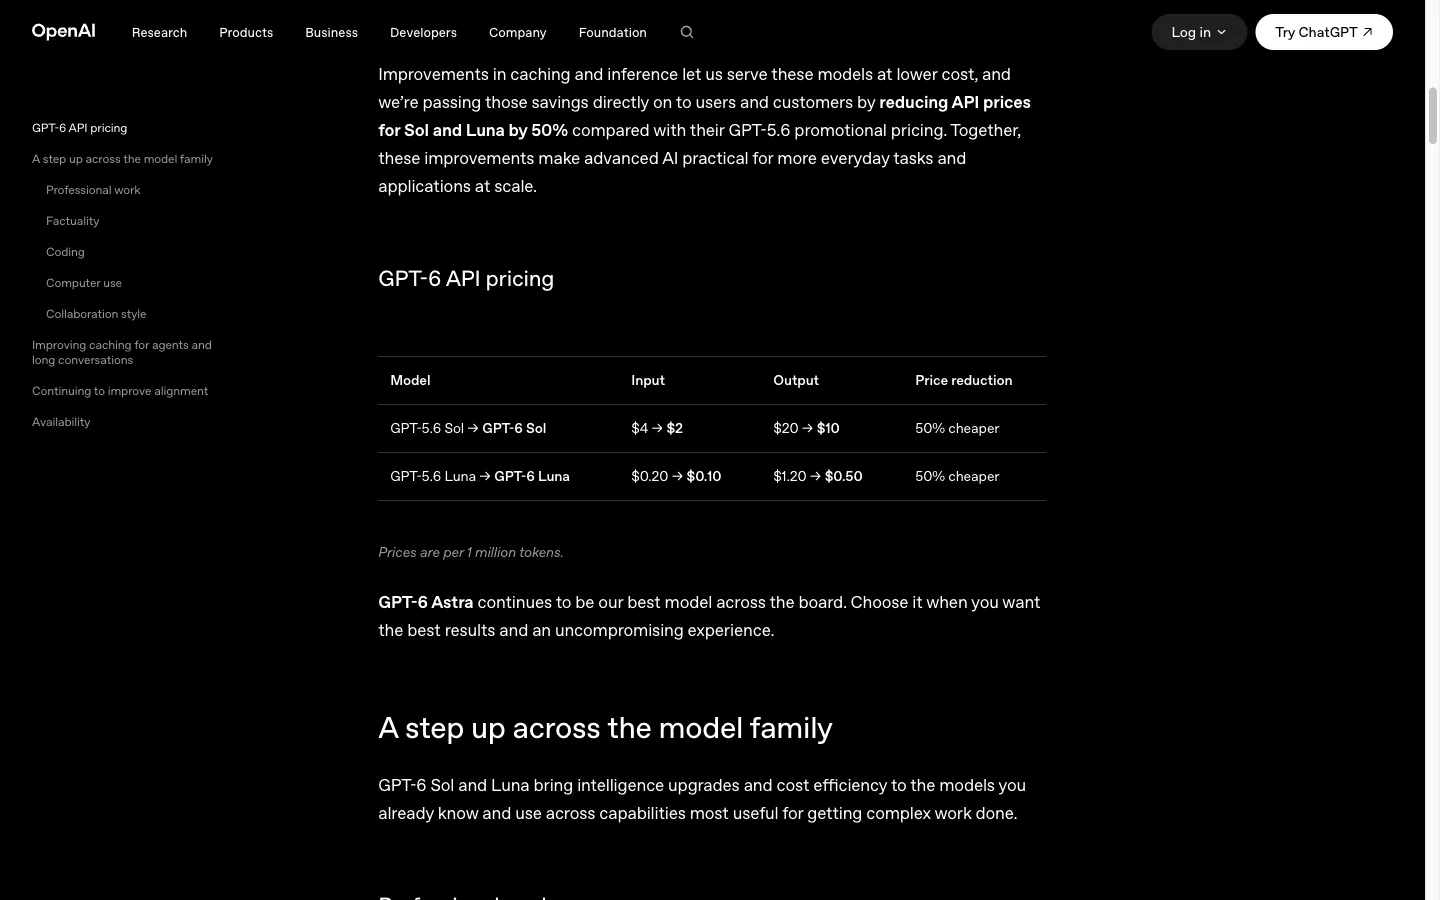
À nombre d'itérations égal, la sortie coûte cinq fois plus cher que l'entrée non mise en cache. Il peut être tout aussi important de formuler une réponse concise que de raccourcir la consigne.
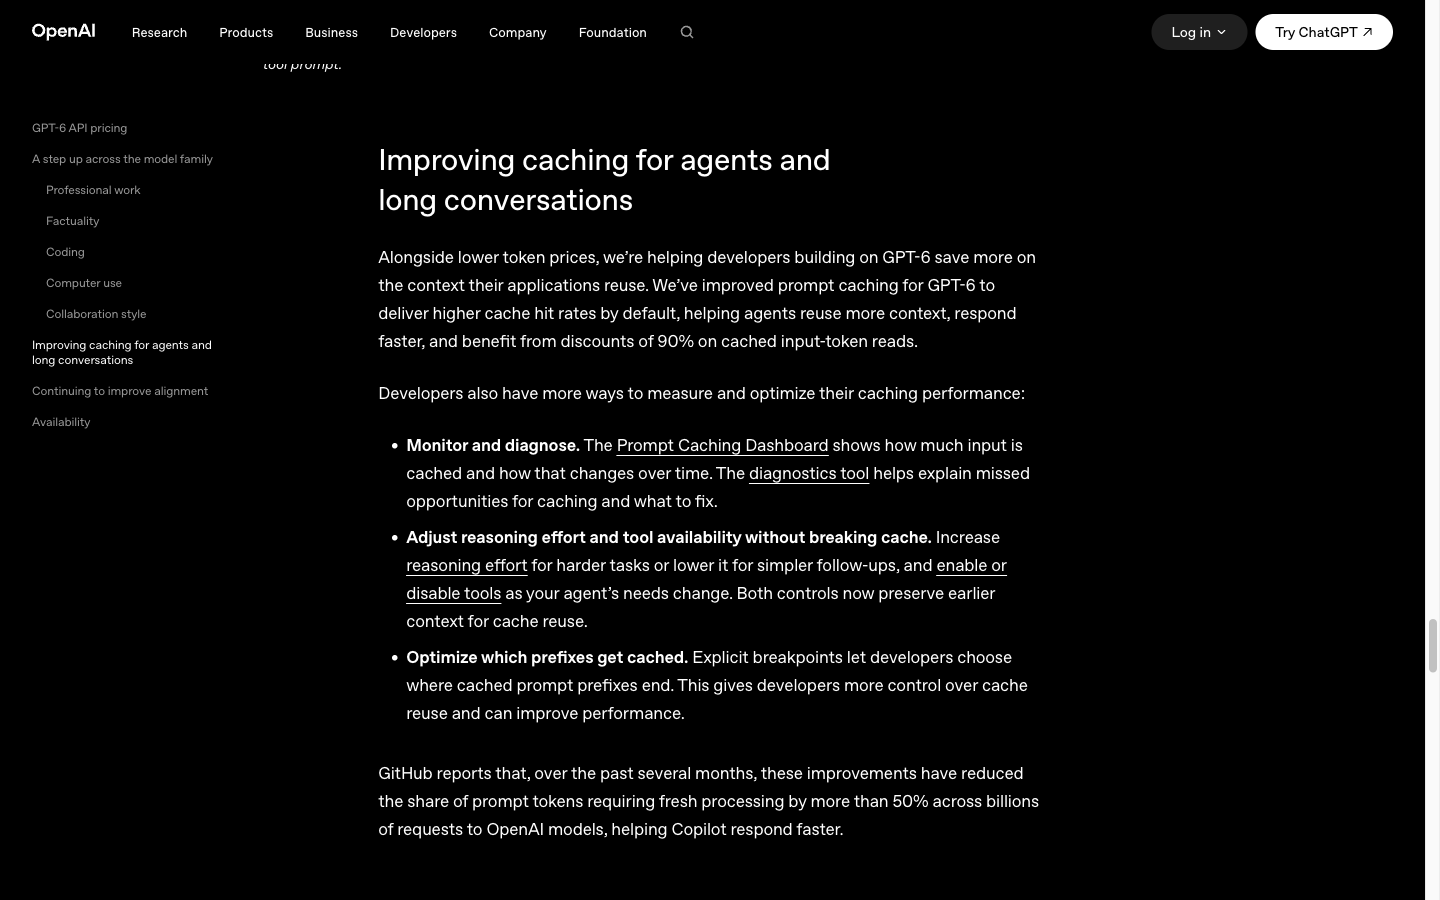
La remise transforme $2 par million de jetons d'entrée en $0,20 par million de lectures en cache éligibles. Une requête répétée ne constitue pas une preuve de réussite de la mise en cache ; utilisez les données enregistrées relatives à l'utilisation des jetons en cache lors du rapprochement des coûts réels.
Devis réalisés aux tarifs publiés
Les exemples suivants s'appuient sur les tarifs GPT-6 Sol publiés. Ils illustrent comment le nombre de tokens est converti en une estimation de coût via l'API ; il ne s'agit pas d'un prix d'abonnement.
| Scénario | Entrée | Sortie | Formule | Résultat |
|---|---|---|---|---|
| Questions-réponses succinctes | 12 500 @ $2/M | 2 000 @ $10/M | 0,0125 × 2 + 0,002 × 10 | $0.045 |
| Grand livre structuré | 1 200 000 @ $2/M | 300 000 à $10/M | 1,2 × 2 + 0,3 × 10 | $5.40 |
| Contexte mis en cache | 1 000 000 @ $0,20/M | 100 000 @ $10/M | 1 × 0,20 + 0,1 × 10 | $1.20 |
Divisez le nombre de jetons par un million avant de le multiplier par le tarif par million. N'appliquez le tarif mis en cache qu'aux jetons d'entrée qui remplissent effectivement les conditions pour un accès au cache ; facturez le reste des jetons d'entrée au tarif standard.
Une remise sur les entrées 90% ne signifie pas que la facture sera inférieure de 90%.
Exemple de calcul : 1 million de jetons d'entrée au total + 100 000 jetons de sortie. La couleur bleu-vert correspond au coût d'entrée ; la couleur rouille, au coût de sortie. Seul le taux de réussite du cache d'entrée varie.
L'économie réalisée s'élève à $1,80, soit 60% sur le total de cet exemple. Le coût de sortie reste de $10 par million de jetons. Une réponse longue peut donc représenter la majeure partie de la facture, même lorsque la consigne est mise en cache.
Coût = (entrée totale − entrée mise en cache) / 1M × $2
 + entrée mise en cache / 1M × $0,20
 + sortie / 1M × $10
Tiré de Tarifs standard publiés par OpenAI et remise sur les lectures en cache 90%. Ce calcul tient compte des accès au cache éligibles ; il exclut les frais liés aux outils, les taxes et autres ajustements de facturation.
API interactive et calculateur de flux de travail
Utilisez les taux GPT-6 Sol publiés comme valeurs de départ : entrée $2/M, sortie $10/M et entrée mise en cache $0,20/M. Le sélecteur d'itinéraire explique la limite de décision GlobalGPT sans intégrer de prix d'abonnement dans les calculs de l'API.
Calculateur de coûts de l'API GPT-6 Sol
Utilisez les tarifs OpenAI publiés comme point de départ : $2/M en entrée, $10/M en sortie et $0,20/M en entrée mise en cache. Vous pourrez les remplacer dès qu’une nouvelle grille tarifaire officielle sera publiée.
Résultat de l'API = (entrée totale − entrée mise en cache) ÷ 1 000 000 × débit d'entrée + sortie ÷ 1 000 000 × débit de sortie + entrée mise en cache ÷ 1 000 000 × débit de mise en cache. La valeur du workflow est indiquée sous forme de décision d'acheminement, et non de prix d'abonnement.
Tests pratiques de Sol avec GPT-6
Ce que permettent réellement de vérifier ces trois contrôles pratiques
| Vérifier | Résultat observé | Fonctionnalités prises en charge |
|---|---|---|
| P01 : calcul simple | $0.041, d'après les tarifs fictifs fournis pour les modèles $2/$8 | Ces tarifs sont donnés à titre indicatif et l'estimation est fictive ; il ne s'agit pas de la facture officielle d'aujourd'hui. |
| P02 : estimation structurée | $7.20 issu du registre fictif $3/$12 ; 105 jetons d'entrée réels | Calculs JSON et conservation des inconnues. Le chiffre de 1,2 million de tokens correspondait à une valeur du grand livre, et non à un test à long terme. |
| P03 : fonction « calculatrice » | La première tentative a atteint sa limite de sortie ; la seconde a renvoyé la fonction complète | Génération de code avec une seule tentative de réessai indiquée. L'API Batch, la facturation des prestataires et les remises par lot n'ont pas été testées. |
Ces vérifications permettent de déterminer comment le modèle gère une tâche de tarification. La grille tarifaire officielle ci-dessus indique les tarifs pratiqués par le prestataire. Le fait de bien distinguer ces deux aspects permet d'éviter qu'un chiffre généré par le modèle ne soit considéré comme une affirmation en matière de tarification.
Ces tests utilisent le modèle GPT-6 Sol dans GlobalGPT. Ils montrent comment le modèle gère les calculs de tarification, les données structurées et le code de calculatrice ; le tableau de facturation des prestataires ci-dessus provient de la page de publication de la version OpenAI. Les tests P01 et P02 conservent leurs premiers résultats. Le test P03 a été relancé une fois, car sa première réponse s'est arrêtée à la limite de sortie avant d'avoir terminé la fonction.
P01 · Questions-réponses sur la vente à découvert
P01-court · première sortie renvoyéeHTTP 2005,23 sDans cette vérification : GPT-6 Sol a traité la requête dans le format GlobalGPT. Le résultat montre comment il gère les calculs de tarification et les instructions structurées ; il ne dépend d'aucune grille tarifaire de prestataire.
Utilisation : 109 entrées · 132 sorties · 241 au total · finish_reason=stop.
Afficher la ligne de commande exacte et la sortie complète
Prompt
Vous testez un outil d'explication des tarifs. Utilisez uniquement la grille tarifaire fictive fournie : tarif d'entrée $2,00 par million de jetons, tarif de sortie $8,00 par million de jetons. Question : quel serait le coût de 12 500 jetons en entrée et de 2 000 jetons en sortie ? Indiquez la formule, précisez que le résultat est fictif et expliquez quelles informations sont encore nécessaires pour obtenir un devis réel auprès d'un prestataire.
Sortie complète
**Coût fictif :**
(12 500 ÷ 1 000 000 × $2,00) + (2 000 ÷ 1 000 000 × $8,00) = **$0,041** (4,1 ¢).

Pour obtenir un devis réel auprès d’un fournisseur, vous devez connaître le fournisseur et le modèle, ses tarifs actuels, ainsi que les remises, frais supplémentaires ou taxes applicables.
P02 · Devis structuré
Structure P02 · première sortie renvoyéeHTTP 2005,639 sDans cette vérification : GPT-6 Sol a traité la requête dans le format GlobalGPT. Le résultat montre comment il gère les calculs de tarification et les instructions structurées ; il ne dépend d'aucune grille tarifaire de prestataire.
Utilisation : 105 entrées · 196 sorties · 301 au total · finish_reason=stop.
Afficher la ligne de commande exacte et la sortie complète
Prompt
Renvoie un objet JSON compact comportant les clés suivantes : input_cost, output_cost, total_cost, assumptions, unknowns. Utilisez ce registre fictif : 1 200 000 jetons en entrée, 300 000 jetons en sortie ; les taux sont de $3/M en entrée et de $12/M en sortie ; le taux en entrée mis en cache n'est pas fourni. N'ajoutez pas de remise mise en cache ni aucune information relative au fournisseur.
Sortie complète
{"coût_d'entrée" : 3,60, "coût_de_sortie" : 3,60, "coût_total" : 7,20, "hypothèses" : ["USD ; tous les jetons d'entrée facturés à $3/M sans remise pour mise en cache"],"unknowns":["taux d'entrée mis en cache","nombre de jetons d'entrée mis en cache"]}P03 · Fonction de calcul des coûts
Lot de codes P03 · deuxième tentative après tronquage de la limite de sortieHTTP 20013,602 sDans cette vérification : GPT-6 Sol a traité la requête dans le format GlobalGPT. Le résultat montre comment il gère les calculs de tarification et les instructions structurées ; il ne dépend d'aucune grille tarifaire de prestataire.
Utilisation : 129 entrées · 757 sorties · 886 au total · finish_reason=stop.
Réessayer : La première tentative s'est arrêtée à « max_tokens » et était incomplète ; une nouvelle tentative est autorisée en cas de sortie mal formée.
Afficher la ligne de commande exacte et la sortie complète
Prompt
Écrivez une fonction JavaScript complète et exécutable, nommée `estimateTokenCost(inputTokens, outputTokens, inputRatePerMillion, outputRatePerMillion)`, destinée à un calculateur de prix. Exigences : renvoyer une erreur de validation claire en cas de valeurs vides, non numériques, négatives ou non finies ; n'accepter zéro que lorsque les deux nombres de jetons sont égaux à zéro ; utiliser l'arithmétique ordinaire ; inclure un exemple normal et un exemple fini très grand sans générer l'infini ; ne pas prétendre que ces taux sont réels. Ne renvoyez que le code JavaScript complet et une brève note.
Sortie complète
```javascript
function estimateTokenCost(
  inputTokens,
  outputTokens,
  inputRatePerMillion,
  outputRatePerMillion
) {
  const values = {
    inputTokens,
    outputTokens,
    inputRatePerMillion,
    outputRatePerMillion
  };

  for (const [name, value] of Object.entries(values)) {
    if (typeof value !== "number" || !Number.isFinite(value)) {
      return { error: `${name} must be a finite number.` };
    }
    if (value < 0) {
      return { error: `${name} cannot be negative.` };
    }
  }

  const bothCountsZero = inputTokens === 0 && outputTokens === 0;
  if (!bothCountsZero && (inputTokens === 0 || outputTokens === 0 ||
      inputRatePerMillion === 0 || outputRatePerMillion === 0)) {
    return { error: "Zero values are allowed only when both token counts are zero." };
  }

  const cost =
    (inputTokens / 1_000_000) * inputRatePerMillion +
    (outputTokens / 1_000_000) * outputRatePerMillion;

  if (!Number.isFinite(cost)) {
    return { error: "The calculated cost is not finite." };
  }

  return { cost };
}

// Illustrative rates only; these are not real prices.
console.log(estimateTokenCost(1_000, 500, 2, 4));
console.log(estimateTokenCost(1e150, 2e150, 3e150, 4e150));
```

Note: The examples use hypothetical rates.
API vs GlobalGPT : parcours du workflow
Le prix n'est qu'un des critères à prendre en compte. Une API peut s'avérer être l'outil idéal pour un appel backend, même lorsqu'une solution par abonnement ou un workflow est plus adaptée aux tâches humaines associées.
| Question | Route API | Parcours du workflow GlobalGPT |
|---|---|---|
| Comment le coût est-il évalué ? | Jetons facturés au compteur issus d'une grille tarifaire d'un fournisseur certifié. | Conditions actuelles du forfait, règles d'accès et valeur du flux de travail ; vérifiez la page en ligne. |
| Quel type de travail convient ? | Appels programmables, tâches par lots, services de production. | Recherche interactive, rédaction, programmation et multiples fonctionnalités d'IA réunies dans un seul tableau de bord. |
| Que devez-vous vérifier ? | Unités d'entrée/sortie, règles de cache/lot, limites et identifiant du modèle. | Prix actuel du forfait, correspondance entre les modèles, quotas et contrôles d'utilisation. |
| Quelle est la place de CLI dans ce contexte ? | Intégration directe des applications. | L'interface CLI de GlobalGPT permet d'intégrer l'accès aux modèles aux terminaux et aux flux de travail existants, lorsque ceux-ci sont disponibles sur votre compte. |
Recueillez les chiffres réels relatifs aux jetons au sein de votre application, calculez l'exposition de l'API à l'aide de la grille tarifaire vérifiée, puis estimez séparément la valeur du tableau de bord multimodèle pour le reste de la tâche. Veillez à bien séparer ces registres.
FAQ
Quel est le prix officiel de l'API GPT-6 Sol ?
OpenAI indique que GPT-6 Sol coûte $2 par million de jetons d'entrée et $10 par million de jetons de sortie. Les lectures d'entrée mises en cache bénéficient d'une réduction de 90%, soit l'équivalent de $0,20 par million de jetons d'entrée mis en cache, comme indiqué sur la page de publication de la version.
Le GPT-6 Sol est-il inclus dans un forfait GlobalGPT ?
Ne tirez pas de conclusions quant à l’inclusion d’un forfait à partir d’un répertoire de forfaits types. Vérifiez la page du forfait GlobalGPT actuel et le tableau de correspondance des forfaits affichés pour votre compte.
Comment puis-je estimer le coût d'une requête API ?
Soustraire d'abord les coûts liés aux données mises en cache du total des données. Facturer les données non mises en cache à $2/M, les données mises en cache éligibles à $0,20/M et les données de sortie à $10/M. Ajouter les frais d'outillage ou autres frais documentés séparément, le cas échéant.
Dois-je opter pour une API ou un abonnement ?
Utilisez l'API pour les appels facturés à l'unité programmables avec une grille tarifaire validée. Envisagez l'option GlobalGPT lorsque votre travail fait appel à plusieurs modèles et fonctions d'IA au sein d'un même tableau de bord. Une approche mixte peut s'avérer pertinente lorsque les appels de production et les tâches interactives présentent des besoins différents.
Laissez la grille tarifaire s'occuper des calculs, et le flux de travail prendre les décisions. Vérifiez à nouveau les tarifs en temps réel et les conditions des forfaits avant de valider votre budget.









