
Test du Claude Opus 5.5 : prix, benchmarks et tests API en conditions réelles
Claude Opus 5.5 combine une fenêtre de contexte de 1 million de tokens avec un tarif de l'API de $4 / $20 par million de tokens. Cette analyse distingue les affirmations publiées par Anthropic, les instantanés de benchmarks indépendants et cinq exécutions directes de tâches via l’API Messages.
Le résultat de la mesure est précis. Trois tâches ont donné des réponses correctes et exploitables ; la tâche de codage a fourni une réponse utile mais a atteint la limite fixée à 1 024 tokens ; l'exécution de l'écriture en chinois a généré un texte illisible sur le parcours testé. Cet échantillon illustre des comportements concrets et les limites du parcours, et ne reflète pas un taux de réussite universel.
Réponse rapide
- Performance : Le test Anthropic fait état de performances de niveau Fable 5.1 pour la plupart des tâches, tandis que le test « Artificial Analysis » a enregistré un score de 58 à l’indice d’intelligence en effort maximal. Les résultats plus restreints du test METR concernant les capacités de jugement n’ont pas montré d’amélioration significative par rapport au Fable 5.1.
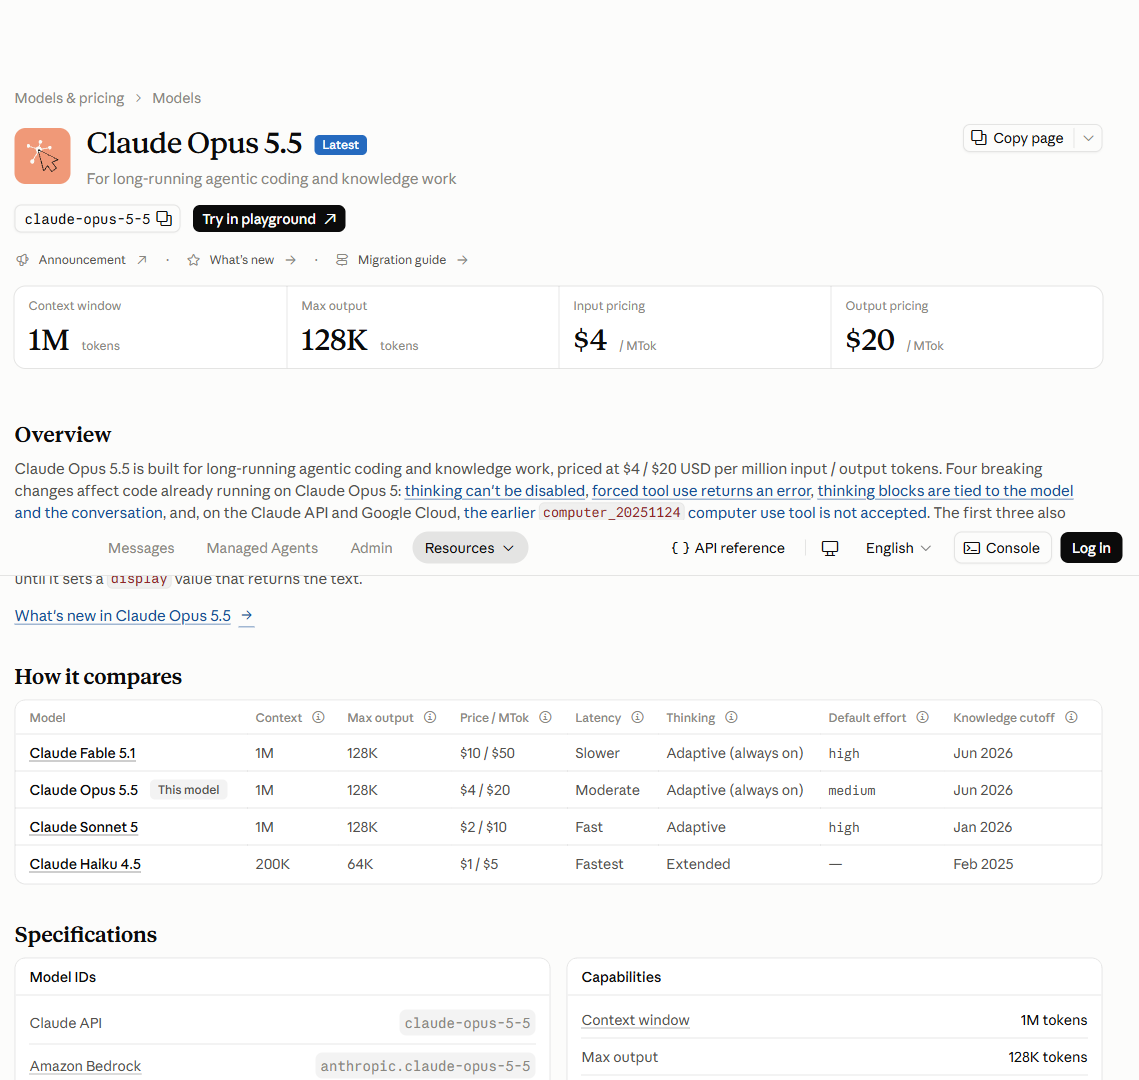
- Prix : le taux officiel de l'API est de $4 par million de jetons d'entrée et $20 par million de jetons de sortie. Les lectures en cache coûtent $0,20 par million ; les écritures en cache toutes les 5 minutes coûtent $5 par million.
- Résultat pratique : L'extraction de textes longs, le JSON strict et le raisonnement arithmétique ont été validés lors des exécutions enregistrées. Le codage s'est avéré utile, mais a été tronqué au seuil initial. Le résultat concernant le chinois est consigné comme un problème lié à l'itinéraire ou à l'encodage, et non comme un verdict linguistique au niveau du modèle.
- Avertissement concernant l'API : la réflexion ne peut pas être désactivée, l'utilisation forcée d'un outil génère une erreur, les blocs de réflexion sont liés au modèle et à la conversation, et l'ancien
ordinateur_20251124L'outil n'est pas pris en charge par l'API Claude ni par Google Cloud.

Ce qu'indiquent les documents officiels
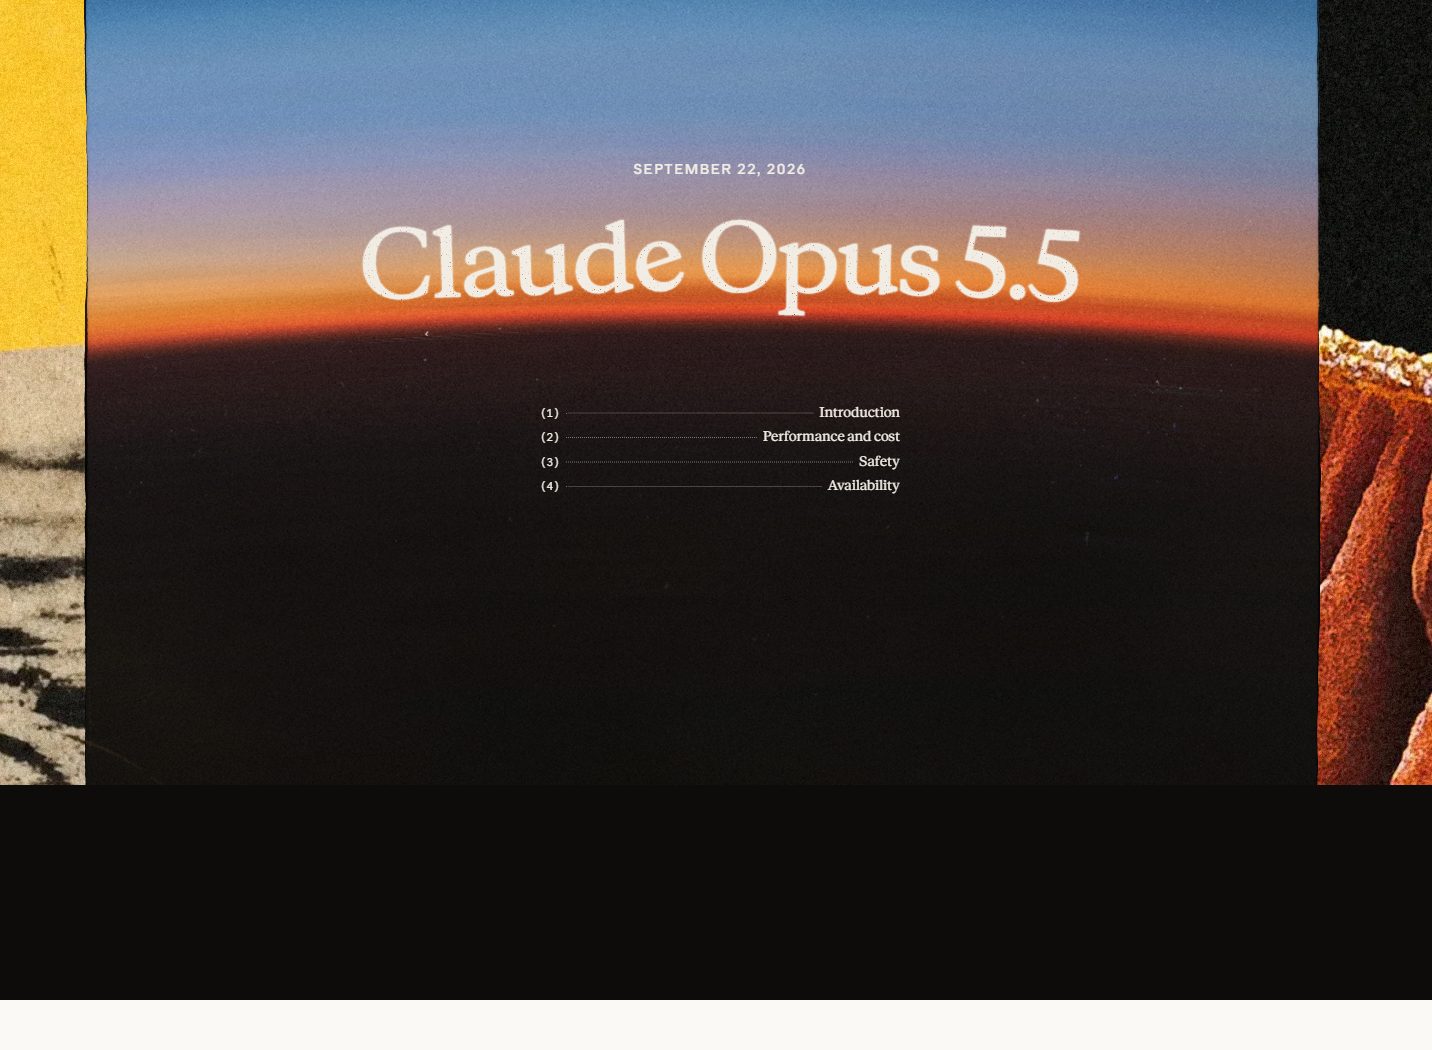
La page de présentation de Anthropic date la version Claude Opus 5.5 au 22 septembre 2026 et la décrit comme le premier modèle de la gamme Claude 5.5. L'annonce revendique des performances équivalentes à celles du Claude Fable 5.1 pour la plupart des tâches, un coût de charge de travail typique inférieur de 40% à celui d'Opus 5, et une vitesse de traitement supérieure de plus de 30% à celle d'Opus 5. Il s’agit là d’allégations du fournisseur ; elles sont donc présentées séparément des preuves indépendantes et des résultats pratiques présentés ci-dessous.
Le Documentation de la plateforme Claude indiquez l'ID du modèle API comme suit : claude-opus-5-5, une fenêtre contextuelle de 1 million de jetons, un volume de sortie maximal de 128 000 et une réflexion adaptative toujours active. La documentation répertorie également les modifications qui affectent les intégrations Opus 5 existantes ; celles-ci sont abordées dans la section consacrée à la migration ci-dessous.
Données relatives aux performances
Il n'y a pas ici de chiffre unique permettant d'évaluer les “ performances ”. Les trois sources publiques mesurent des éléments différents ; c'est pourquoi chaque fiche présente clairement ses propres indicateurs et le cadre de référence de ses données.
Annonce concernant le Anthropic
Signal publié : Selon Anthropic, Opus 5.5 offre des performances équivalentes à celles de Claude Fable 5.1 pour la plupart des tâches, coûte 40% de moins qu’Opus 5 sur des charges de travail types et génère des résultats plus de 30% plus rapidement.
Limite : Exemples de positionnement et de tests publiés par le fournisseur ; il ne s'agit pas d'un test de performance indépendant.
Analyse artificielle
Signal publié : L'instantané « max-effort » indique 59,61 TP40T sur Terminal-Bench 4.0, 61,41 TP40T sur « Humanity’s Last Exam » et 66,91 TP40T sur SciCode.
Limite : Les scores dépendent de l'effort fourni, de l'ensemble de données, de la date et de la définition des indicateurs. Ils ne permettent pas de prédire toutes les requêtes API.
Évaluation préalable au déploiement du METR
Signal publié : METR indique que ses résultats n'ont pas montré d'amélioration significative par rapport à Fable 5.1 en ce qui concerne les capacités de jugement étudiées, tout en prévoyant néanmoins une accélération notable pour certains travaux de R&D.
Limite : Il s'agit d'une analyse plus ciblée portant sur l'appréciation et la rapidité d'exécution des tâches, et non d'un classement complet en matière de qualité.
Prises dans leur ensemble, ces fiches permettent de tirer une conclusion relative : l’Opus 5.5 est un modèle de référence selon plusieurs évaluations publiques antérieures, mais l’ampleur de son avantage varie en fonction de la tâche, du niveau d’effort requis et de la conception de l’évaluation. Ces fiches ne permettent pas de désigner un “ meilleur modèle ” universel.
Claude Opus 5.5 : unités de prix et de facturation
Le prix de l'API et le prix de l'abonnement grand public correspondent à des produits différents. Les chiffres relatifs à l'API indiqués ci-dessous correspondent aux prix unitaires utilisés pour la gestion du budget des jetons ; les chiffres relatifs au grand public correspondent aux fiches de forfait visibles dans la zone capturée du navigateur.
Prix officiel de l'API
Estimation simplifiée : 10 000 jetons d'entrée plus 2 000 jetons de sortie correspondent à environ $0,08 aux tarifs standard, avant prise en compte du cache, du traitement par lots, des taxes ou de la marge de la plateforme.
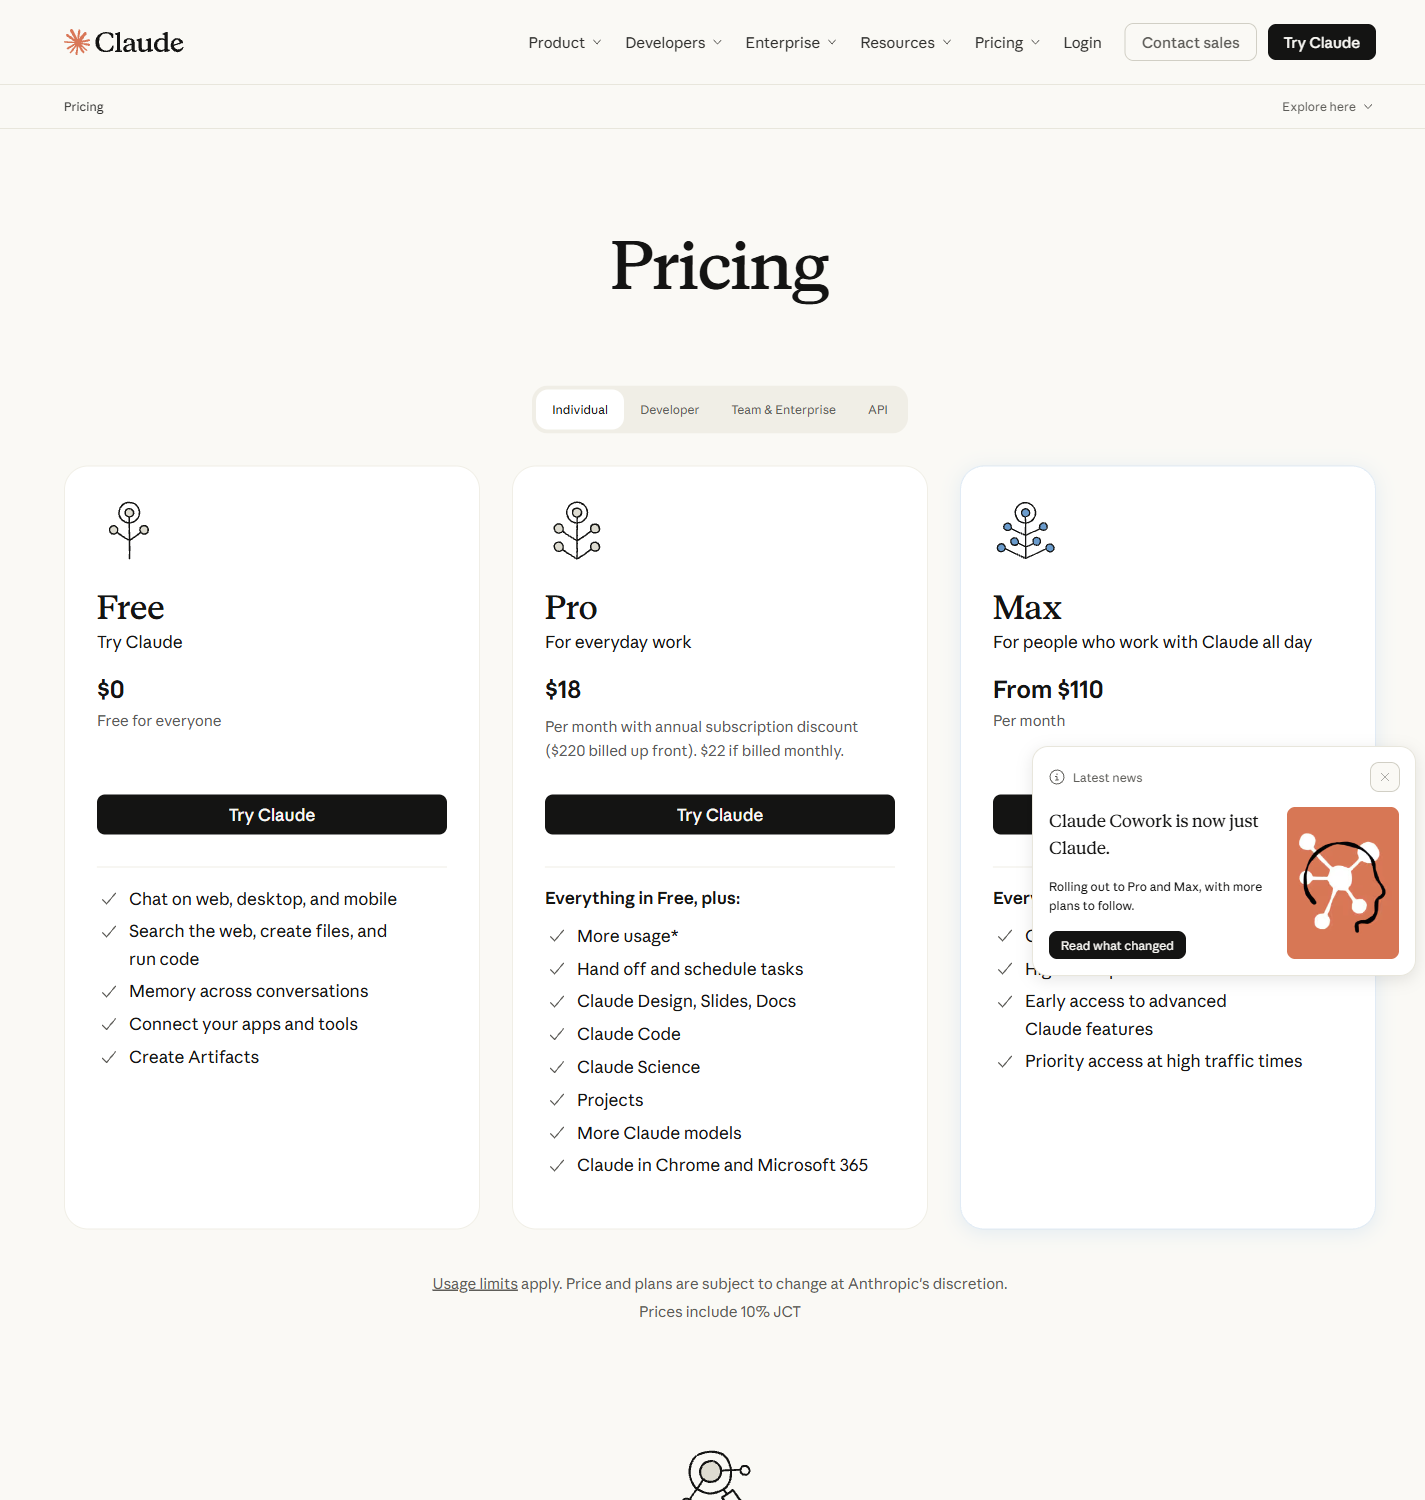
Capture d'écran du forfait grand public
La capture d'écran montre également une note JCT 10%. Il s'agit de valeurs affichées en fonction de la région, et non d'une garantie de prix globale.
Pour une explication détaillée de la facturation par jeton et du coût de la fenêtre contextuelle, consultez le Guide des tarifs et du contexte du GPT-5.5. Les frais liés à l'API du fournisseur, le prix de l'abonnement et tout solde créditeur sur la plateforme multi-modèles doivent être comptabilisés séparément dans votre budget.
Test pratique : cinq fiches de résultats des tâches
Le 23 septembre 2026, nous avons envoyé cinq requêtes indépendantes via la même route contrôlée de l’API Messages, avec l’identifiant de modèle claude-opus-5-5. Le premier passage a utilisé max_tokens : 1024. Nous avons enregistré le temps écoulé au niveau local, le nombre de tokens d'entrée et de sortie, la raison de l'arrêt, l'exactitude et la conformité au format littéral. La tâche d'écriture en chinois a été relancée avec un plafond de 4 096 tokens après que le premier passage eut mis en évidence un problème au niveau de la sortie de l'itinéraire. Il s'agit d'un échantillon de cinq tâches, et non d'une estimation de fiabilité.
Est-il capable de corriger une fonction de déduplication de type mixte ?
Configuration de la tâche
Trouver le bug dans un code Python déduplication fonction, gérer les valeurs qui ne sont ni des chaînes de caractères ni hachables, conserver la première orthographe et fournir des tests.
La réponse a mis en évidence les .lower() échec avec les valeurs non de type chaîne ; conversion des chaînes en casefold(), a ajouté une solution de secours non hachable et a renvoyé le code corrigé ainsi que des cas de test.
La réponse s'est arrêtée au plafond de 1 024 tokens. La correction était utile, mais la configuration était trop restreinte pour permettre une révision complète du code.
Verdict sur la carte : Réponse techniquement valable renvoyée ; cette exécution ne permet pas de se prononcer sur la latence ou l'exhaustivité, car la limite maximale de tokens a interrompu le processus.
Peut-elle préserver les faits et les limites des tests ?
Configuration de la tâche
Extrayez cinq conclusions numérotées d'une brève note d'évaluation, en précisant la méthode utilisée et ce qui n'a pas été mesuré lors de la phase suivante.
Le rapport a présenté exactement cinq points numérotés. Il a conservé les comparaisons entre assistants, la méthode des 20 questions et les lacunes concernant la fidélisation à long terme et la conversion des clients.
Il s'agissait d'un petit ensemble de sources ; il ne permet donc pas de tester la fenêtre de contexte de 1 Mo.
Verdict sur la carte : extraction propre, avec le nombre demandé et la délimitation des éléments probants de la note source préservée.
Peut-il renvoyer un résultat lisible par machine sans avoir à le nettoyer ?
Configuration de la tâche
Renvoie un objet JSON fixe comprenant un titre, un public cible, deux avantages, deux inconvénients et un verdict. L'utilisation d'une balise Markdown n'était pas autorisée.
A renvoyé un JSON analysable contenant les clés demandées, deux avantages, deux inconvénients et une recommandation concise. Aucune balise Markdown n'était présente.
Une réponse valide ne prouve pas la fiabilité du schéma pour des objets plus grands ou imbriqués.
Verdict sur la carte : La conformité littérale au format JSON a été validée lors de cette exécution.
Est-ce qu'il peut appliquer correctement une règle d'arrondi répétée ?
Configuration de la tâche
Commencez par 12 articles, multipliez chaque lot suivant par 1,25, arrondissez à l'unité inférieure après chaque lot, puis indiquez le total des quatre lots.
A renvoyé 12, 15, 18 et 22, puis les a additionnés pour obtenir 67. Les étapes de calcul étaient visibles.
Cette tâche est déterministe et de petite envergure ; elle ne reflète pas les performances globales en matière de raisonnement.
Verdict sur la carte : un résultat correct et des étapes intermédiaires transparentes.
Le parcours testé a-t-il généré un texte en chinois exploitable ?
Configuration de la tâche
Rédigez une introduction pour une critique en chinois qui distingue clairement les arguments officiels, le prix, les données de référence et les tests pratiques.
La structure de la réponse était bien présente, mais les caractères chinois apparaissaient déformés dans le résultat enregistré, via le chemin testé.
Les données ne permettent pas de distinguer la qualité de la formulation du modèle du comportement de routage ou d'encodage. Aucun score de qualité « chinois » n'est attribué.
Verdict sur la carte : Le texte renvoyé sur cette route est inutilisable ; relancez l'opération en utilisant un chemin UTF-8 vérifié avant de vous prononcer sur la qualité linguistique.
Sur les quatre séries de tests en anglais ou sans spécification de langue, la moyenne locale s’est établie à 6,24 secondes. Ce chiffre correspond à cinq requêtes consécutives sur un même parcours et ne correspond pas à la latence côté fournisseur. Les points forts observés étaient l’extraction concise, la conformité littérale au format JSON et l’arithmétique correcte ; les deux problèmes non résolus concernaient la contrainte de budget de sortie sur le codage et une sortie en chinois illisible sur l’itinéraire testé.
Précautions concernant l'API et la migration
La réponse rapide mentionne ces éléments, car ils peuvent modifier une intégration même lorsque la qualité du texte du modèle semble bonne.
- La réflexion ne s'arrête jamais. Utilisez le paramètre « effort » documenté pour contrôler la profondeur, la latence et le coût ; il n'y a pas de bouton d'arrêt.
- L'utilisation forcée d'un outil génère une erreur. Le code existant qui impose une sélection obligatoire d'outils nécessite un test de migration distinct.
- Les blocages cognitifs sont inévitablement liés au modèle et à la conversation. Ne partez pas du principe qu’un bloc de réflexion peut être réutilisé après avoir changé de modèle.
ordinateur_20251124n'est pas accepté sur l'API Claude et la procédure Google Cloud indiquée dans la documentation.- Les plafonds de production ont leur importance. La fiche de codage montre qu'une réponse utile peut tout de même être interrompue par un petit
max_tokensvaleur. - Le mode par lots et le mode rapide constituent deux modes de facturation distincts. Veillez à distinguer leurs remises ou suppléments des prix standard des jetons.
Verdict fondé sur des preuves
Le Claude Opus 5.5 s'appuie sur des données de référence publiques solides et récentes, et présente un taux API standard publié inférieur à celui de l'Opus 5 indiqué dans l'annonce du Anthropic. Au cours des cinq exécutions de tâches enregistrées, il a produit une extraction propre, un JSON conforme et des calculs arithmétiques ; la réponse de codage était utile mais tronquée par la limite initiale ; et la sortie en chinois n’était pas utilisable via la méthode testée.
La conclusion qui s'impose est donc limitée : le modèle a fait preuve d'une bonne capacité d'apprentissage sur plusieurs tâches de petite envergure, tandis que le parcours et la configuration ont révélé des limites évidentes. Toute décision de migration devrait consister à répéter les mêmes instructions avec un budget de sortie adapté, à vérifier les appels d'outils et à séparer les tarifs officiels des jetons des crédits d'abonnement ou de la plateforme.
Si vous souhaitez disposer d'un deuxième itinéraire à titre de comparaison, le Comparatif entre le DeepSeek V4 Pro et le Flash : format de test montre comment les verdicts au niveau des tâches peuvent rester distincts des affirmations portant sur l'ensemble du modèle. Le Guide des cas d'utilisation de GPT-5.5 apporte un repère axé sur les tâches, tandis que Notes sur le test de performance Flash Gemini et le Guide comparatif des modèles d'IA fournir le contexte du modèle le plus proche. Pour l'accès à plusieurs modèles, voir abonnements IA tout-en-un et Comparaison des plateformes multimodèles.
Foire aux questions
Combien coûte le modèle Claude Opus 5.5 ?
Le taux officiel de l'API est de $4 par million de jetons en entrée et de $20 par million de jetons en sortie. Les lectures en cache s'élèvent à $0,20 par million de jetons, et les écritures en cache toutes les 5 minutes s'élèvent à $5 par million de jetons.
Qu'est-ce que la fenêtre contextuelle Claude Opus 5.5 ?
La documentation de la plateforme Claude indique une fenêtre de contexte d’un million de tokens et un nombre maximal de 128 000 tokens en sortie. Une version bêta distincte, documentée, prend en charge jusqu’à 300 000 tokens en sortie pour les lots de messages.
Le Claude Opus 5.5 est-il meilleur que l'Opus 5 ?
Anthropic fait état d’un coût unitaire de traitement plus faible et d’une production plus rapide, tandis que des évaluations indépendantes montrent d’excellents résultats sur plusieurs tâches classiques. L’ampleur du gain de qualité dépend du benchmark, des paramètres d’effort, de la consigne et de l’itération.
Peut-on « éteindre » la pensée ?
Non. La documentation actuelle du modèle indique que la réflexion adaptative est toujours activée. Utilisez le paramètre « effort » pour contrôler la profondeur de réflexion, la latence et le coût.
Les cinq tâches API ont-elles démontré leur fiabilité ?
Non. Les cartes mettent en évidence des limites concrètes en matière de comportement et de configuration, mais cinq tâches ne suffisent pas pour estimer un taux de réussite général. Les problèmes liés au « plafond de codage » et à la « route chinoise » font l'objet de rapports distincts.
Cette évaluation a-t-elle démontré la qualité chinoise ?
Non. L'itinéraire testé a renvoyé du texte chinois déformé ; le résultat est donc enregistré comme un problème d'encodage ou d'itinéraire, dans l'attente d'une nouvelle exécution avec l'encodage UTF-8 vérifié.









