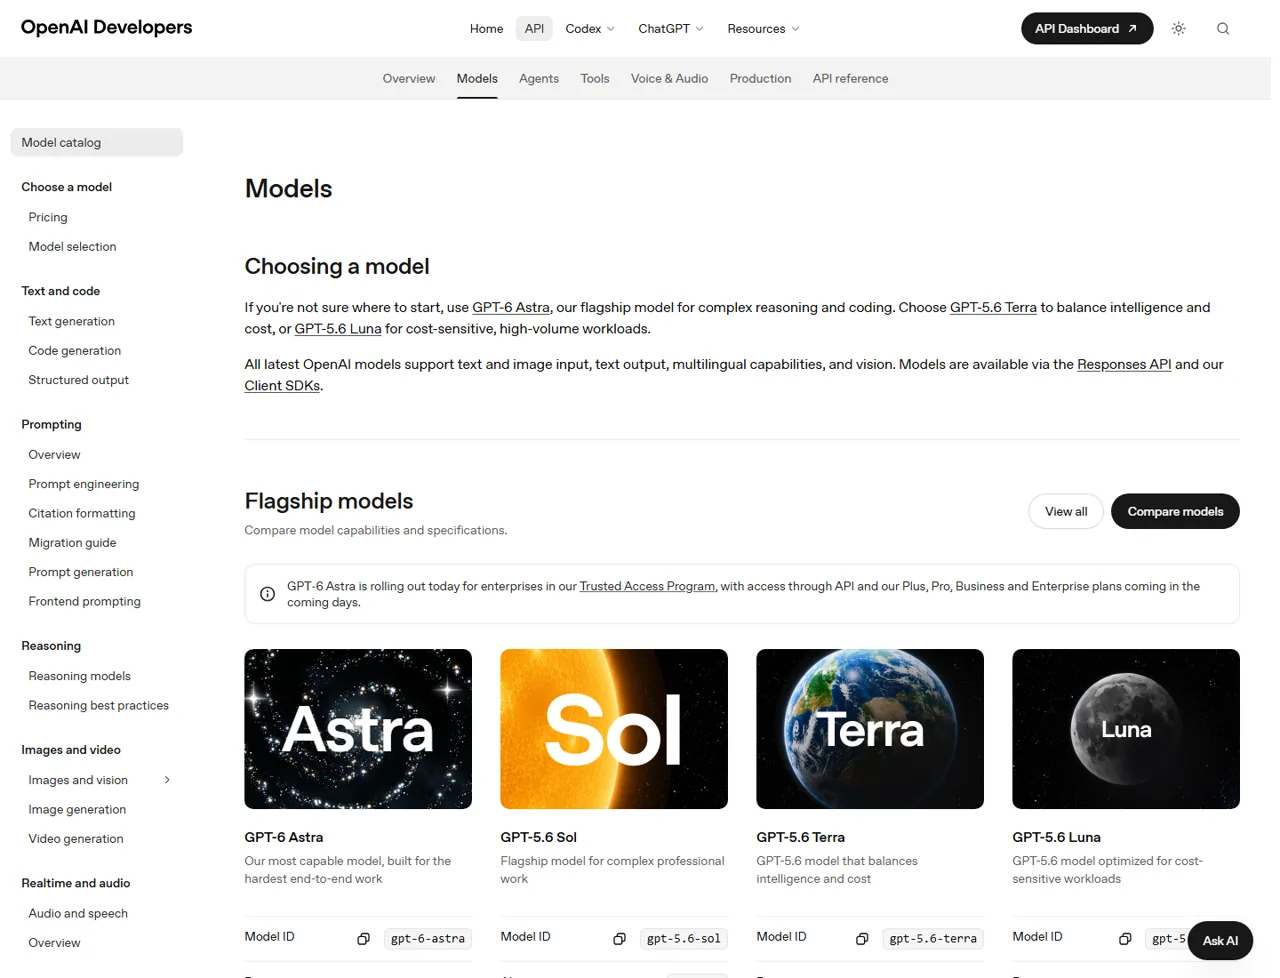
Respuesta rápida: Precios del GPT-6 Astra $10 por cada millón de tokens de entrada, $1 por cada millón de tokens de entrada almacenados en caché, $12,50 por cada millón de tokens de escritura en caché, y $50 por cada millón de tokens emitidos a tarifas estándar, siempre que el prompt tenga 272 000 tokens de entrada o menos. Por encima de 272 000, la solicitud completa pasa a aplicarse la tarifa de contexto largo: $20 de entrada, $2 de entrada en caché, $25 de escrituras en caché y $75 de salida por cada 1 millón de tokens. OpenAI especifica una ventana de contexto de 1,05 millones de tokens y una salida máxima de 128 000.
Esas cifras hacen que Astra sea potente, pero lo suficientemente cara como para que sea necesario planificar su uso. Una solicitud repetida puede resultar mucho más barata cuando el almacenamiento en caché funciona, mientras que una solicitud que apenas supere los 272 000 tokens de entrada puede resultar considerablemente más cara. Esta guía distingue entre los precios oficiales, los ejemplos calculados y nuestras observaciones prácticas sobre la API del 5 de septiembre de 2026.

Precios de la API de GPT-6 Astra
OpenAI divide los precios estándar en contexto corto y largo. El umbral se basa en fichas de entrada, y no la suma total de la entrada y la salida. El contexto corto abarca entradas de hasta 272 000 tokens; el contexto largo se aplica a partir de esa cifra.
Coste por cada millón de tokens
El tramo superior se aplica a toda la solicitud. Los precios indicados son por cada millón de tokens.
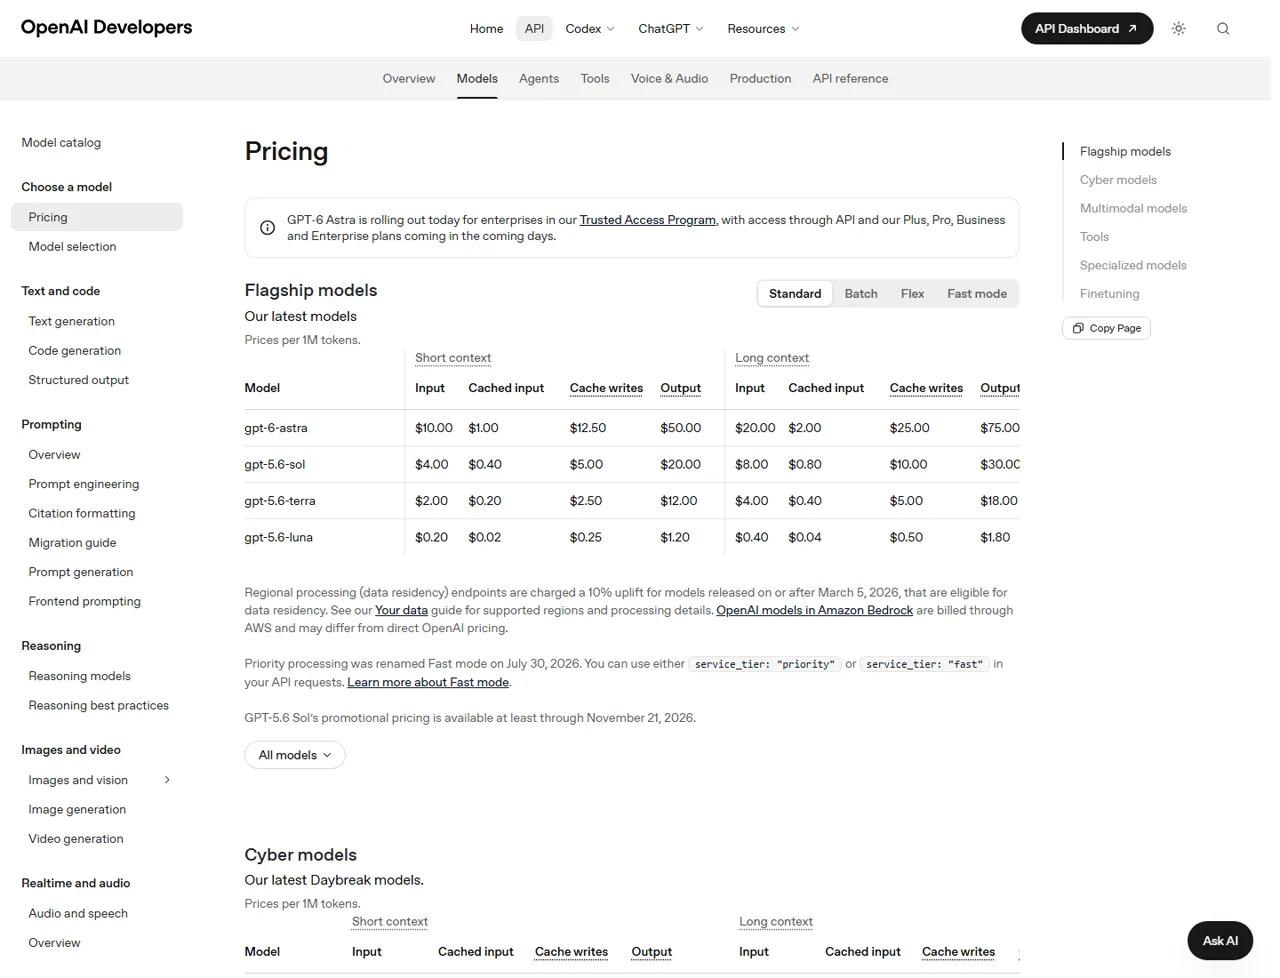
Lo más importante es que al superar los 272K no se genera una factura con tarifas mixtas. Según Documentación sobre precios de la API de OpenAI, las tarifas más elevadas se aplican a toda la solicitud cuando la entrada supera el umbral. Por lo tanto, los equipos que comparen Astra con un producto estrella anterior deberían mirar más allá del precio de entrada que aparece en los titulares; nuestro Guía de precios de GPT-5.6 ofrece un contexto útil para ese debate sobre el presupuesto.
El almacenamiento en caché de las entradas puede reducir considerablemente los costes de las entradas repetidas, pero la creación de la caché tiene un coste. Una escritura en caché cuesta 1,25 veces la tarifa de entrada sin caché aplicable. El procesamiento por lotes y Flex cuestan 50% de Standard, mientras que Fast cuesta el doble de la tarifa aplicable. El procesamiento regional elegible añade 10%, y Fast no está disponible para Astra con residencia de datos en la UE.
¿Cuánto cuesta una llamada a la API de Astra con GPT-6?
En el caso de una solicitud estándar, calcula cada categoría de tokens facturados por separado y, a continuación, suma los resultados:
Coste total = coste de entrada sin caché + coste de entrada con caché + coste de escritura en caché + coste de salida.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75Las estimaciones con tarifas estándar no incluyen herramientas, recargos regionales ni otros servicios que se facturan por separado.
Los 100 000 ejemplos muestran por qué son importantes los prefijos reutilizables: la estimación de «modelo-token» desciende de $1,25 a $0,35 cuando todas las entradas cumplen los requisitos para ser almacenadas en caché. Se trata de un ejemplo de fijación de precios, no de una promesa de que cada prompt repetido vaya a generar un acierto en la caché. Para una estimación presupuestaria multimodelo más amplia, compara los supuestos del flujo de trabajo en nuestro Guía de modelos de IA «todo en uno».
Tokens de GPT-6 Astra, ventana de contexto y límites de salida
En página oficial del modelo GPT-6 Astra documenta un Ventana contextual de 1.050.000 fichas y un Producción máxima de 128 000 tokens. Su fecha límite de conocimientos es el 30 de abril de 2026. Acepta entradas de texto e imágenes, devuelve texto y admite los ajustes de nivel de razonamiento. bajo, medio, alto, xalto, y máx..
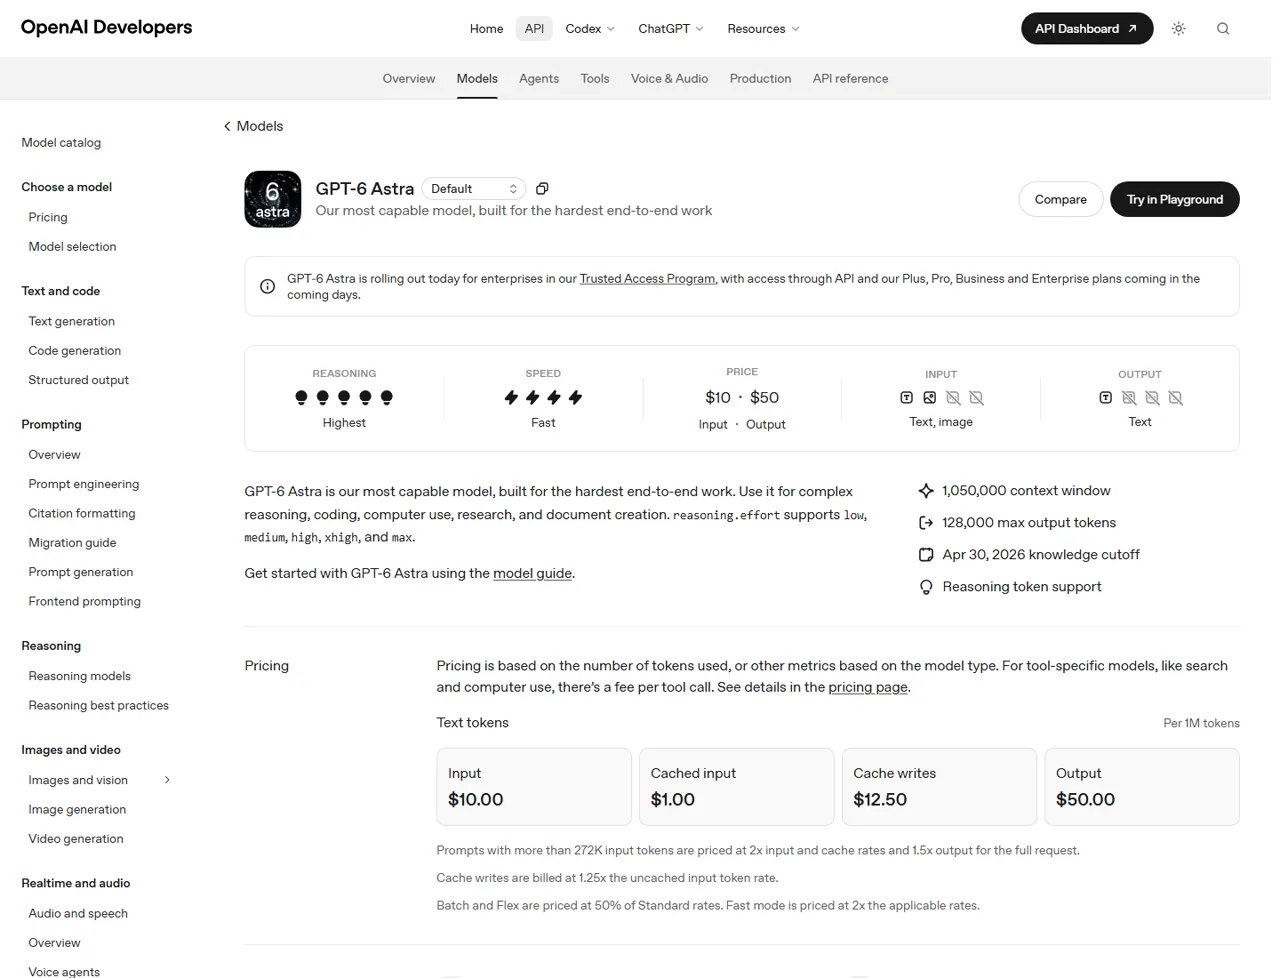
Una ventana de contexto amplia es una capacidad, no una recomendación para satisfacer todas las solicitudes. La recuperación, la selección de documentos, la síntesis y la estructura de las indicaciones pueden mantener la entrada por debajo del límite de 272K. La elección del modelo también es importante: los desarrolladores centrados en la programación pueden comparar las ventajas e inconvenientes en nuestro mejor modelo de IA para codificación realizar un análisis, en lugar de dar por sentado que el modelo con la ventana más amplia es automáticamente el que mejor se ajusta.
Seis tareas prácticas para probar la API de GPT-6 Astra
Estado de las pruebas: GPT-6 Astra pasó a estar disponible a través de la API de compatibilidad de Broly Anywhere el 5 de septiembre de 2026. Ejecutamos las seis tareas publicadas que se indican a continuación. Cinco de ellas generaron respuestas HTTP 200 válidas; la solicitud límite de 272K terminó con un error de transporte y sigue sin verificarse.
Indicaciones y resultados observados
ID del modelo gpt-6-astra. Cada resultado corresponde a una ejecución observada, no a una prueba de rendimiento oficial. El tiempo real incluye el retraso de la pasarela y el retraso en el enlace ascendente.
Contabilidad básica de tokens
El modelo arrojó el resultado teórico esperado. El uso real de la API fue de 54 tokens de entrada y 26 de salida.
Caché de avisos
Ambas consultas fueron correctas, pero el prefijo repetido registró cero tokens almacenados en caché y cero tokens de escritura en caché en ambas respuestas.
Límite de precio de 272 000
La solicitud sintética de gran volumen finalizó antes de que llegara una respuesta HTTP. No se devolvió ningún objeto de uso, por lo que la banda de velocidad y el comportamiento de facturación siguen sin medirse.
Razonamiento «mínimo frente a máximo»
En ambas ejecuciones se obtuvo el resultado $265,20. Max tardó más tiempo y devolvió 88 tokens de razonamiento; esta única tarea aritmética no mostró ninguna mejora en la calidad de la respuesta.
Parámetro de salida de 128 K
El punto final de compatibilidad devolvió «OK» en lugar de rechazar un token que superaba el máximo oficial. Se trata de un comportamiento de la pasarela, no de una indicación de que se admita una ventana de salida mayor.
Tarifas y niveles de servicio
Las respuestas normales no incluían los encabezados «remaining-request» ni «remaining-token». Tanto las pruebas «Flex» como las de prioridad se completaron con éxito, pero devolvieron «service_tier: default».
Límites de uso de la API de GPT-6 Astra
GPT-6 Astra no está disponible en el nivel gratuito. Los límites publicados aumentan según el nivel de uso, pero los encabezados de los proyectos activos siguen siendo la fuente más práctica para conocer la capacidad restante y los plazos de restablecimiento.
La capacidad aumenta considerablemente en el Nivel 5
La altura de la barra es orientativa. Los valores exactos de RPM, TPM y la cola de lotes son los que determinan el control.
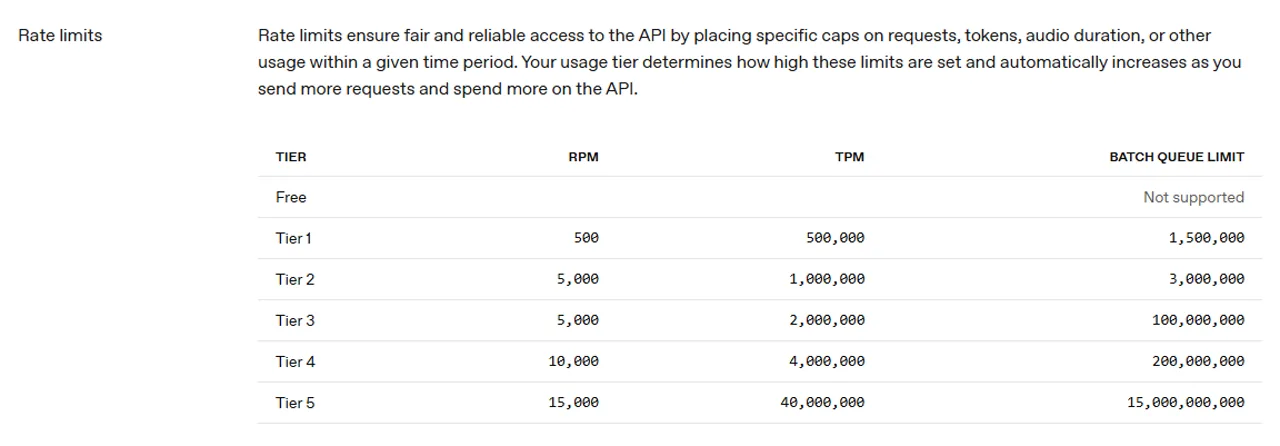
Las modalidades «Batch» o «Flex» pueden reducir a la mitad las tarifas por token del modelo cuando no se necesitan respuestas inmediatas. La modalidad «Fast» puede ser adecuada para tareas en las que la latencia es un factor importante, pero duplica el precio aplicable y no está disponible con la residencia de datos en la UE para Astra. Antes de implementar una carga de trabajo en producción, compara el coste del modelo con los gastos asociados a la plataforma; nuestro Guía de precios de Codex ilustra por qué no se deben mezclar las suscripciones a productos y la facturación de las API.
Lo que revelan las primeras reseñas
El creador independiente Matt Wolfe ha publicado un primer vídeo de avance en el que se muestran demostraciones de programación, uso de ordenadores, Blender y Unreal Engine. Estos ejemplos resultan útiles para comprender el tipo de flujos de trabajo que están explorando los revisores, pero no constituyen pruebas de rendimiento controladas y no sustituyen a las pruebas de API mencionadas anteriormente. Comparaciones más amplias, como ChatGPT frente a Claude frente a Gemini Asimismo, debe interpretarse como una orientación específica para cada carga de trabajo, y no como una clasificación universal.
¿Quién debería utilizar GPT-6 Astra?
Astra resulta una opción plausible para tareas de programación complejas, flujos de trabajo basados en agentes, análisis de documentos extensos y trabajos multimodales en los que un razonamiento más sólido o una ventana de contexto muy amplia puedan compensar un coste elevado por token. Los equipos deberían probarla en una tarea concreta y cuantificable, y comparar la relación calidad-precio, no solo la calidad del resultado. Nuestra Resumen de los mejores modelos de IA ofrece un marco de selección más amplio.
- Utiliza Astra cuando: la tarea es compleja, los errores salen caros, se necesita un contexto extenso o el modelo puede sustituir a varias pasadas menos potentes.
- Utiliza un modelo más barato cuando: El trabajo consiste en tareas rutinarias de clasificación, extracción, reescritura o generación de grandes volúmenes de contenido, con requisitos de calidad sencillos.
- Optimiza primero cuando: las solicitudes superan repetidamente los 272 000, los prefijos estáticos de gran tamaño se pueden almacenar en caché, o la latencia no requiere un procesamiento estándar o rápido.
Para los lectores que estén comparando opciones premium similares, el Comparación entre GPT-5.6, Fable 5 y GPT-5.5 ofrece otra perspectiva sobre el coste, las prestaciones y la adecuación a la carga de trabajo. GlobalGPT cuenta con un Página de inicio de GPT-6 Astra. Nuestras observaciones de la API se registraron por separado a través del punto final de compatibilidad de Broly Anywhere.
Preguntas frecuentes
¿Cuál es el precio de la API de GPT-6 Astra?
Los precios estándar para contextos cortos son: $10/M de entrada, $1/M de entrada en caché, $12,50/M de escrituras en caché y $50/M de salida. Por encima de los 272 000 tokens de entrada, la solicitud completa utiliza $20/M de entrada, $2/M de entrada en caché, $25/M de escrituras en caché y $75/M de salida.
¿Qué ocurre cuando una solicitud supera los 272 000 tokens de entrada?
OpenAI traslada toda la solicitud a la banda de contexto largo. No se trata de una combinación en la que solo los tokens por encima de 272K cuesten más.
¿En qué consiste la ventana de contexto de GPT-6 Astra?
OpenAI especifica una ventana de contexto de 1 050 000 tokens, una entrada máxima de 922 000 tokens y una salida máxima de 128 000 tokens. Los tokens de razonamiento también ocupan espacio en el contexto y se facturan como salida.
¿Admite GPT-6 Astra la introducción de imágenes?
Sí. La documentación del modelo indica que admite entradas de texto e imágenes, con salida de texto. El audio y el vídeo no figuran como modalidades de entrada para este modelo.
¿Estos ejemplos de costes son facturas oficiales?
No. Son ejemplos aritméticos que utilizan las tarifas documentadas. Tu factura también puede incluir la contabilidad de tokens almacenados en caché, el modo de procesamiento, el procesamiento regional y otros servicios que se facturan por separado.
¿Qué modos de procesamiento hay disponibles?
Los planes Standard, Batch, Flex, Fast y Ultrafast tienen precios de Astra documentados. Los planes Batch y Flex cuestan la mitad que el Standard, el Fast cuesta el doble que el Standard y el Ultrafast cuesta seis veces más que el Standard en la misma banda de contexto. El procesamiento regional elegible añade 10%; la disponibilidad depende del modo y del punto final.
¿Cómo se factura GPT-6 Astra a través de GlobalGPT?
La API de GlobalGPT indica 23 créditos por cada 1.000 tokens de entrada y 117 créditos por cada 1.000 tokens de salida para GPT-6 Astra. Los tokens de razonamiento se facturan como salida. Esas son las tarifas de créditos de GlobalGPT; el uso de la API de OpenAI sigue su propia estructura de precios en dólares estadounidenses.
Veredicto final
GPT-6 Astra combina una ventana de contexto de 1,05 millones de tokens y una salida máxima de 128.000 con una tarifa premium. Su tarifa «Standard» para contextos cortos parte de $10 por cada millón de tokens de entrada y de $50 por cada millón de tokens de salida, pero el límite de 272 000, los tokens de razonamiento, las escrituras en caché, el modo de procesamiento y el recargo regional pueden modificar sustancialmente el coste. Calcula el número de tokens antes de enviar solicitudes extensas, comprueba el almacenamiento en caché a partir de los datos de uso y evalúa Astra en función del valor de la tarea completada, en lugar de basarte únicamente en el precio nominal.