Die Tests fanden am 7. und 11. September 2026 statt; die Quellen wurden am 16. September 2026 erneut überprüft.
Der Name bedarf einer Klarstellung. Es gibt immer noch Nutzer, die nach “Grok 4” suchen, aber das von uns getestete Modell war Grok 4,6, nicht der ursprünglich für Juli 2025 geplante Termin. Der aktuelle xAI-Modellkatalog empfiehlt Grok 4.6 für den Code, während das Original grok-4-0709 Der API-Name wurde außer Kraft gesetzt. Ich werde diese Produkte und Daten im gesamten Überblick getrennt aufführen.
Wenn Sie mehrere Assistenten vergleichen, bevor Sie sich für einen entscheiden, beginnen Sie mit dem allgemeineren Das beste KI-Modell zum Vergleich von Programmiercodes. Hier geht es konkret um die Frage, ob Grok einen präzisen Programmierauftrag in ein Ergebnis umsetzen kann, das man tatsächlich überprüfen kann.
Kurze Antwort: Eignet sich Grok 4 zum Programmieren?
Grok 4.6 ist gut genug, um beim Debuggen einer darin enthaltenen Funktion, beim Erstellen einer ersten Implementierung, beim Erläutern unbekannten Codes und beim Entwerfen von Tests hilfreich zu sein. Es ist jedoch nicht zuverlässig genug, um Ergebnisse ohne Ausführung zu akzeptieren. Die Fehler in unserer kleinen Testsuite waren keine obskuren stilistischen Unstimmigkeiten: Bei einer Refaktorisierung fiel netto aus jedem nicht leeren Ergebnis, und eine generierte Testsuite konnte eine Verzögerung nicht von einem absoluten Zeitstempel unterscheiden.
Die praktische Vorgehensweise ist einfach: Man gibt dem Programm einen eng gefassten Auftrag, fordert eine Änderung an und führt unabhängige Überprüfungen durch. Ein Modell, das schnell plausiblen Code erzeugt, kann dennoch ein Feld löschen, eine Invariante schwächen oder zwar die Code-Anforderung erfüllen, dabei aber die Anforderung an das Antwortformat ignorieren.
Sie können Versuche Grok 4.6 auf GlobalGPT für begrenzte Eingabeaufforderungen und Side-by-Side-Vergleiche. GlobalGPT ist eine eigenständige Plattform; sie ersetzt weder Grok Build noch eine IDE, den Zugriff auf Repositorys, die native API-Konsole von xAI noch Ihre CI-Pipeline.
Was wir tatsächlich getestet haben
Wir haben vier kleine JavaScript-Aufgaben untersucht: die Korrektur der Intervallzusammenführung, das Debuggen der prioritätsbasierten Sitzplatzzuweisung, die Umgestaltung einer Funktion zur Zusammenfassung von Änderungen und das Schreiben von Tests für eine Wiederholungsversuch nach Parser. Jede Aufgabe verfügte über eine festgelegte Eingabeaufforderung und einen deterministischen lokalen Auswerter. Drei davon wurden am 11. September 2026 ausgeführt; bei der Intervall-Aufgabe wurde ein Lauf vom 7. September wiederverwendet, den wir anhand der gespeicherten Eingabeaufforderung, der Rohantwort und des Auswerters erneut überprüft haben.
- Veranstaltungsort: Vom Benutzer autorisierte Broly-Aggregations-API, Chat-Vervollständigungen.
- Angefordertes und zurückgegebenes Modell:
grok-4.6. - Versuche: Eine Anfrage pro Aufgabe, ohne Wiederholungsversuche.
- Ausführung: Das zurückgegebene JavaScript wurde isoliert und lokal anhand von vorab definierten Fixtures oder Mutanten ausgeführt.
- Für das Modell nicht verfügbar: eine IDE, ein Repository, Internetzugang, die Ausführung von xAI-Tools sowie Produktionssysteme.
Die Gateway-Kennzeichnung liefert zwar nützliche Herkunftsinformationen, belegt jedoch nicht eigenständig die vorgelagerte Bereitstellung. Die verstrichene Zeit umfasst Netzwerk- und Gateway-Overhead, und die gemeldeten Token-Zahlen bilden keine Grundlage für die offizielle xAI-Abrechnung. Einen umfassenderen Überblick auf Produktebene finden Sie im separaten Grok 4.6 – Testbericht und Praxistests.
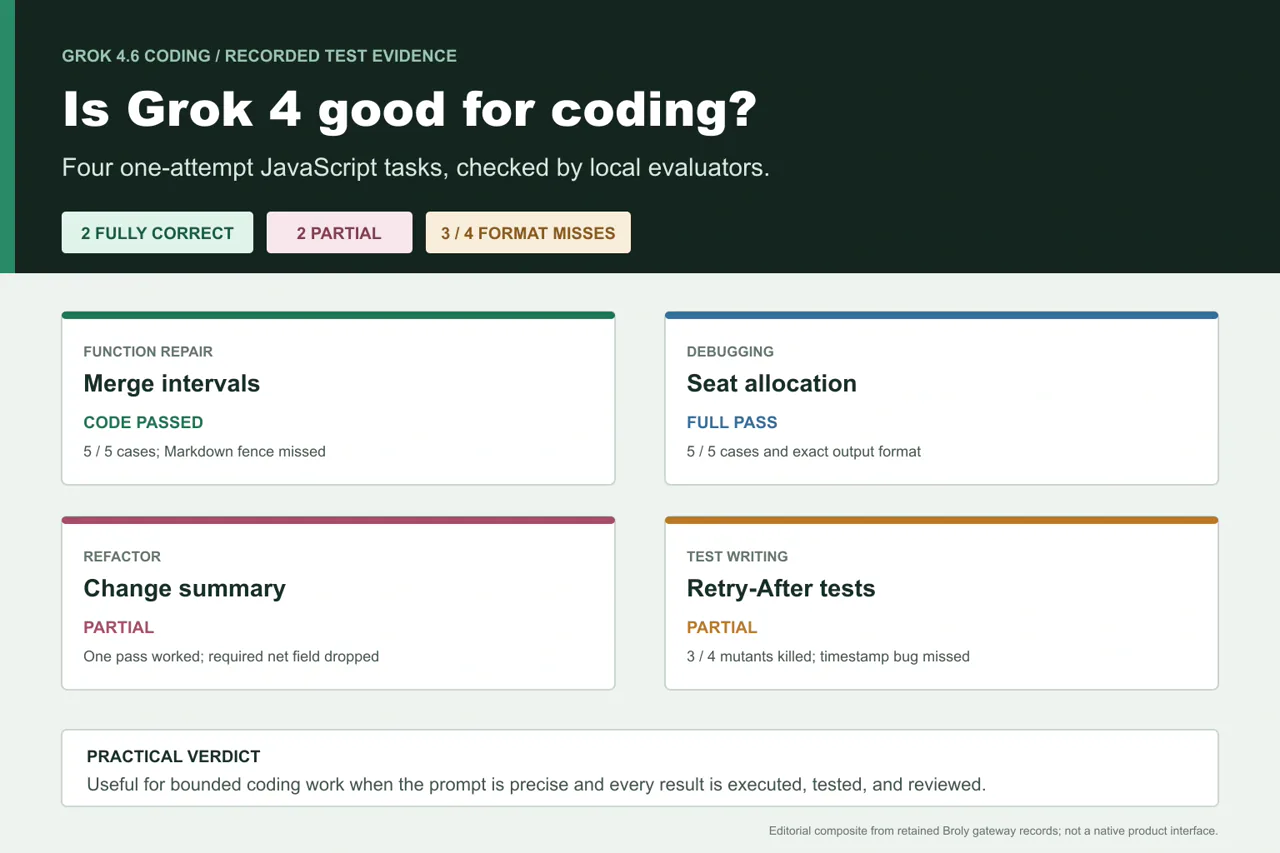
Die Ergebnisse des Codierungstests auf einen Blick
netto.Das beste Ergebnis war nicht die längste Antwort. Es war die Korrektur der Sitzplatzvergabe: prägnant, korrekt formatiert und verhaltensmäßig vollständig. Der lehrreichste Fehlschlag war die Refaktorisierung, da die Implementierung sauber aussah und die Anforderung eines Durchlaufs erfüllte, dabei jedoch stillschweigend den Ausgabekontrakt änderte.
Test 1: Reparatur einer Merge-Intervall-Funktion
Die erste Funktion veränderte ihre Eingabe, stürzte bei einem leeren Array ab, konnte benachbarte Endpunkte nicht zusammenführen und konnte ein größeres Intervall verkleinern, wenn später ein verschachteltes Intervall auftrat. Durch die Eingabeaufforderung wurden diese Invarianten explizit gemacht.
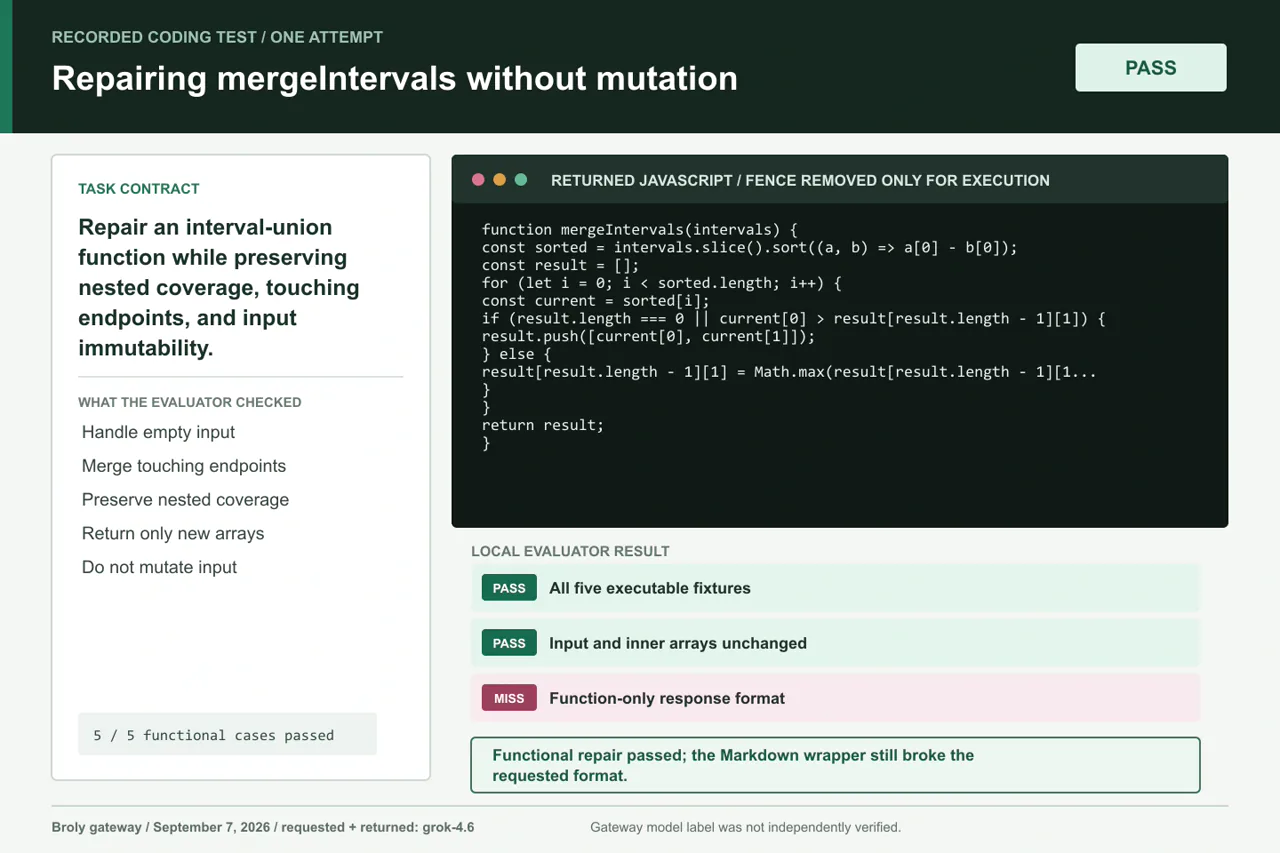
Schlüsselgrenze: Die Funktionswiederherstellung war erfolgreich, nachdem lediglich die äußere Markdown-Eingrenzung für die Ausführung entfernt wurde.
Ergebnis: Alle fünf ausführbaren Fälle wurden erfolgreich durchlaufen. Die Funktion gab neue Arrays zurück, veränderte die Eingabe nicht, bewahrte die verschachtelte Abdeckung und führte benachbarte Endpunkte zusammen. Bei einer expliziten Anweisung trat jedoch weiterhin ein Fehler auf, da der Code in Markdown eingeschlossen war. Nachdem nur diese äußere Ausführungsbegrenzung entfernt worden war, war das funktionale Ergebnis korrekt.
Praktischer Tipp: Grok hat eine kompakte Korrektur gut bewältigt, als die Prompt die versteckten Randfälle benannte. Der Formatfehler ist für einen Menschen zwar geringfügig, kann jedoch eine Pipeline zum Absturz bringen, die direkt ausführbaren Text erwartet.
Test 2: Fehlerbehebung bei der prioritätsbasierten Sitzplatzzuweisung
Diese Aufgabe kombinierte den Umgang mit stabilen Gleichständen, absteigende Priorität, Mutationsfreiheit, exakte Kapazität und eine “Skip-and-Continue”-Regel. Der ursprüngliche Code sortierte in die falsche Richtung, veränderte das Eingabe-Array und brach zu früh ab, wenn eine Anfrage zu groß war.
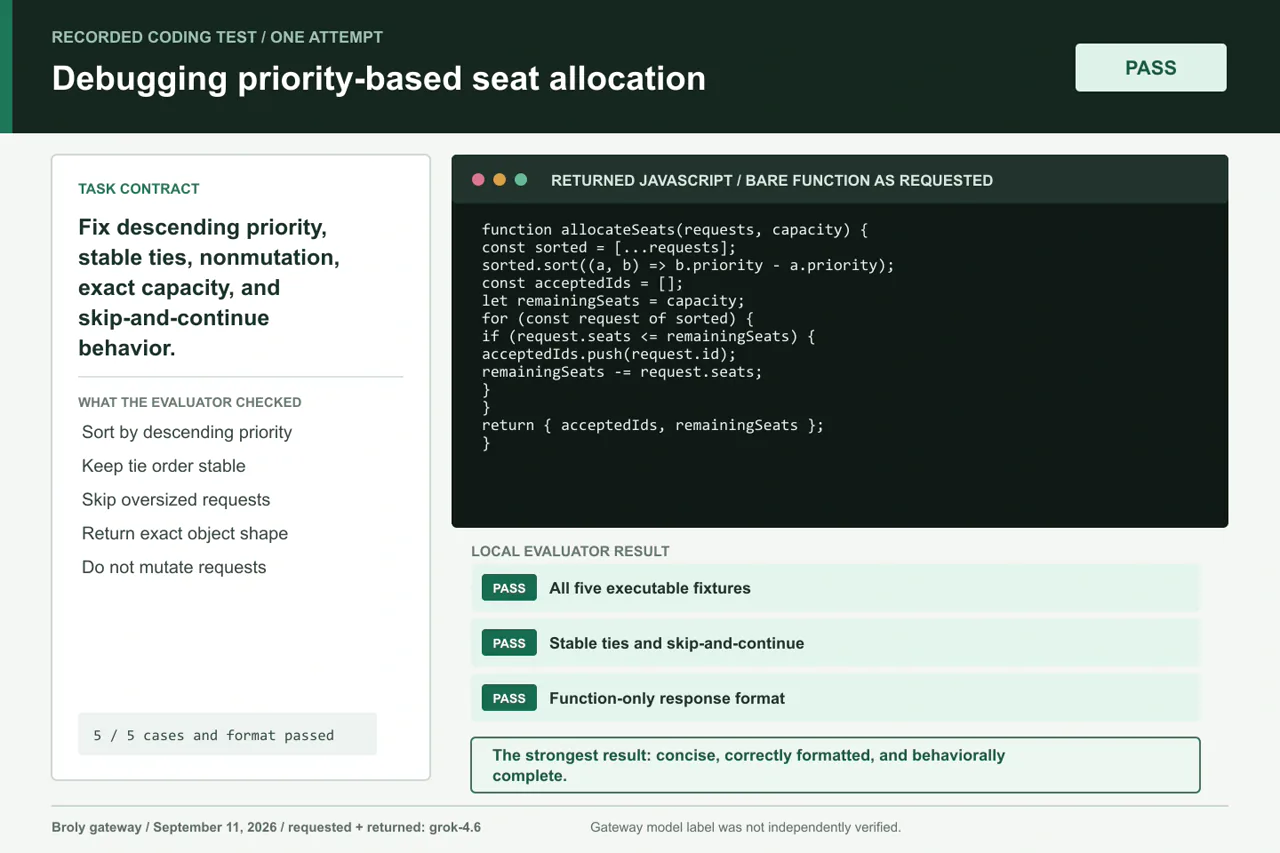
Schlüsselgrenze: Dies war die einzige Antwort, die sowohl den Verhaltensvertrag als auch das exakte Ausgabeformat erfüllte.
Ergebnis: Alle fünf Fälle wurden erfolgreich abgearbeitet, darunter eine Reihenfolge mit gleicher Priorität, ein übergroßer führender Antrag, exakte Kapazität, null Kapazität und eine leere Liste. Die Eingabe blieb unverändert, akzeptierte IDs war ein neues Array, und das Modell gab nur die angeforderte Funktion zurück.
Praktischer Tipp: Das ist genau die Art von Aufgabe, für die sich Grok besonders gut eignet: eine Funktion, ein klarer Auftrag und Grenzfälle, die sofort umgesetzt werden können.
Test 3: Refactoring ohne Beeinträchtigung des Verhaltens
In der dritten Aufgabe wurde Grok aufgefordert, wiederholte Scans durch einen einzigen Aggregationsdurchlauf zu ersetzen und dabei die Reihenfolge, ungewöhnliche Dateinamen und die genaue Ausgabestruktur beizubehalten. Dies ist ein realistisches Refactoring-Risiko: Der Code kann schneller und übersichtlicher werden, während gleichzeitig das Verhalten verloren geht.
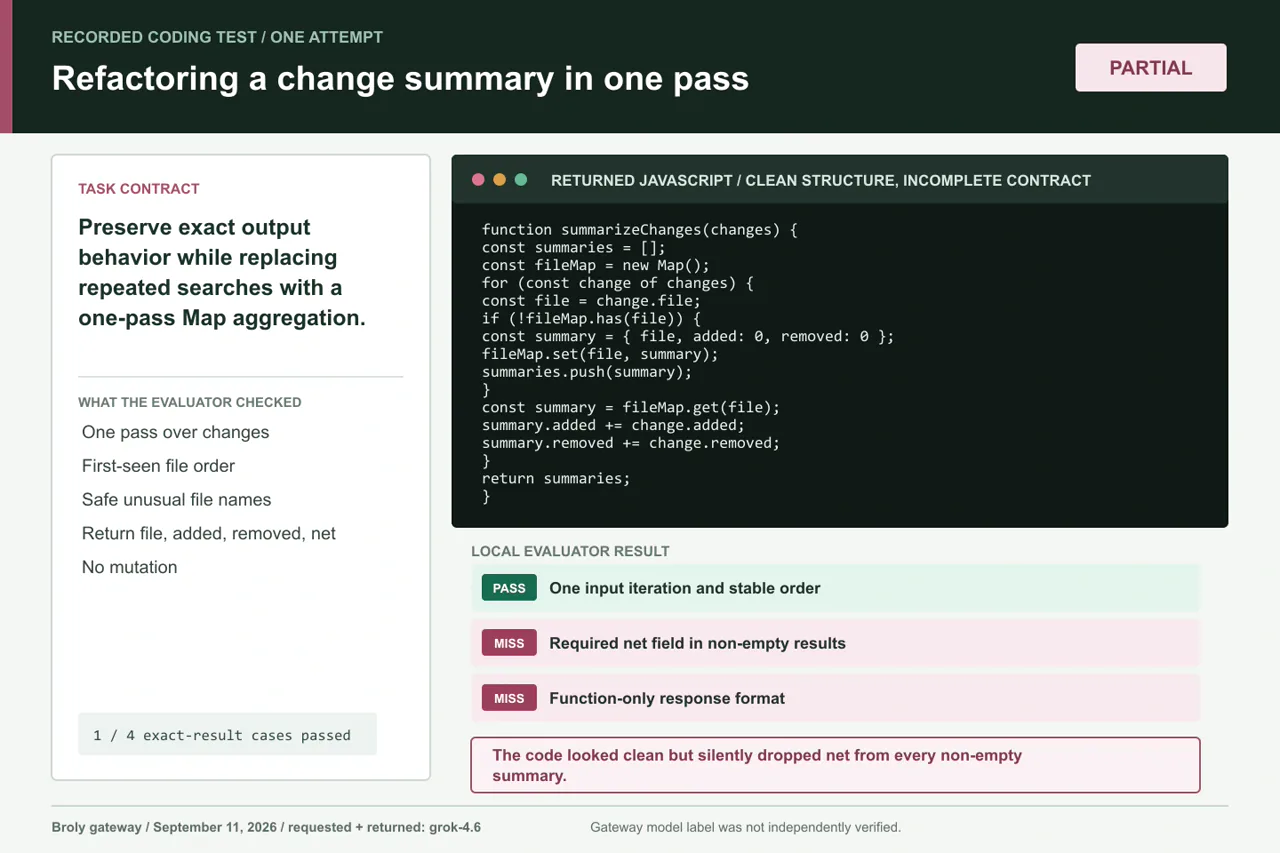
Schlüsselgrenze: Der „One-Pass-Map“-Ansatz schien korrekt zu sein, ließ jedoch das erforderliche Netzfeld unbemerkt weg.
Ergebnis: Die Antwort erfolgte in einem Durchgang, einem Karte, korrekte Reihenfolge bei der ersten Anzeige, sicherer Umgang mit __proto__ und Konstruktor, und es gab keine Mutation in der Eingabe. Aber es wurde nie berechnet oder zurückgegeben netto. Der leere Fall wurde akzeptiert, da er keine Ergebnisobjekte enthielt; alle drei nicht leeren Fälle haben den exakten Vergleich nicht bestanden.
Praktischer Tipp: Beurteilen Sie eine Refaktorisierung niemals nur anhand der algorithmischen Komplexität oder der Sauberkeit des Codes. Erstellen Sie eine Momentaufnahme der alten Ausgaben, überprüfen Sie jedes erforderliche Feld und vergleichen Sie das Verhalten, bevor Sie die neue Version akzeptieren.
Test 4: Tests schreiben, die plausible Fehler aufspüren
Bei der letzten Aufgabe wurde das übliche Vorgehen umgekehrt: Grok verfasste die Tests, und unser Test-Harness führte sie an einer strengen Referenzimplementierung sowie an vier bewusst fehlerhaften Implementierungen durch. Das Ziel war nicht die Zeilenabdeckung. Es ging vielmehr darum, ob die ausgewählten Eingaben scheinbar ähnliche Semantiken unterscheiden konnten.
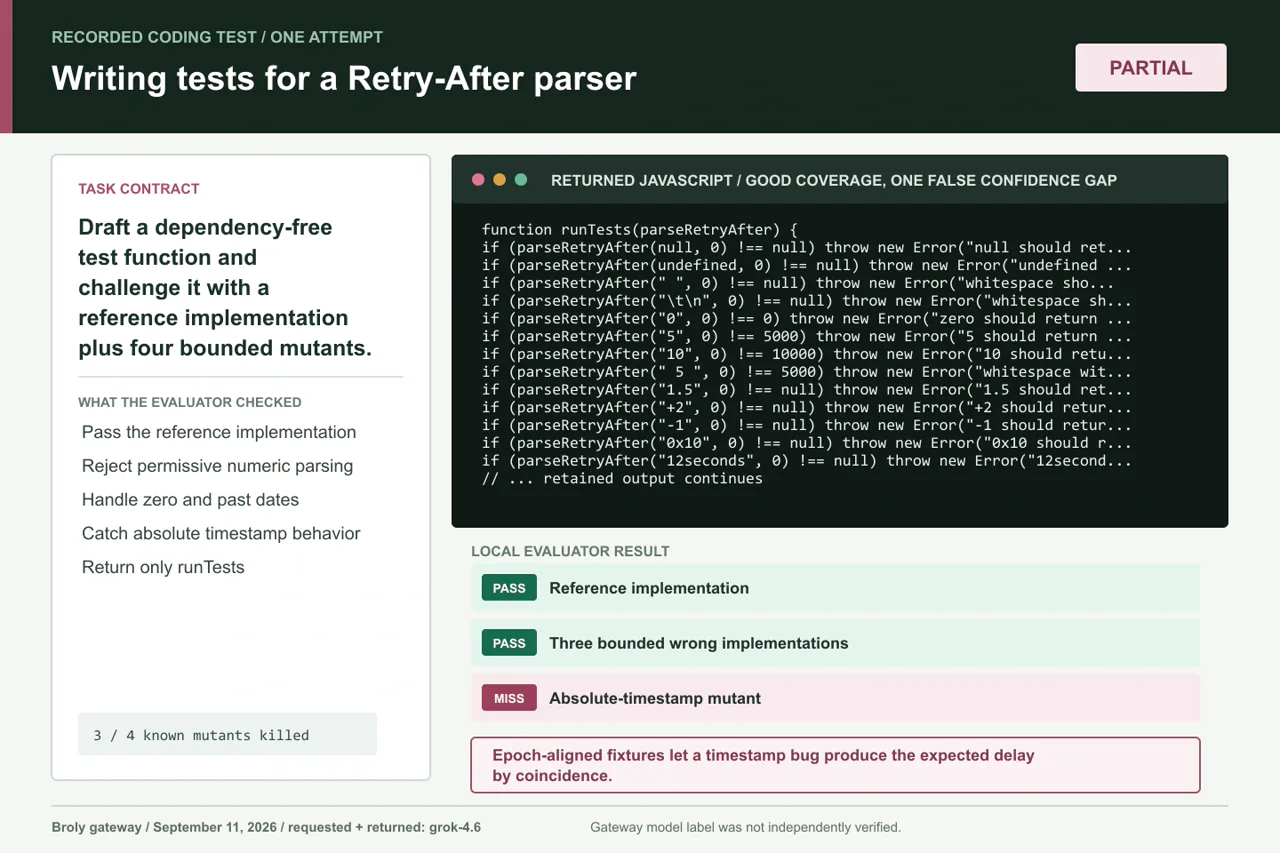
Schlüsselgrenze: Durch auf die Epoche abgestimmte Datumsfixierungen kann ein Fehler im absoluten Zeitstempel zufällig bestehen bleiben.
Ergebnis: Die Suite hat den Referenztest bestanden und die permissive numerische Auswertung erkannt, bei der Null als „falsy“ behandelt wurde, sowie eine negative Verzögerung für ein Datum in der Vergangenheit. Sie hat jedoch den Mutanten übersehen, der den absoluten Zeitstempel des ausgewerteten Datums zurückgab. Bei beiden Datumsprüfungen wurden auf die Epoch ausgerichtete Werte verwendet, sodass die erwartete Verzögerung zufällig dem Zeitstempel entsprach.
Praktischer Tipp: Von KI erstellte Tests sind ein nützlicher erster Ansatz, aber kein Beweis für die Korrektheit. Fragen Sie sich, was die einzelnen Fixtures unterscheiden. Mutationstests, Eigenschaftstests und absichtlich nicht übereinstimmende Werte können eine Testsuite entlarven, die nur auf den ersten Blick gründlich erscheint.
Grok 4, Grok 4.6 und Grok Build sind nicht dasselbe.
Hintergrund der Einführung im Juli 2025. Der alte API-Slug wurde später außer Betrieb genommen.
Die vom Gateway in diesen vier isolierten Aufgaben zurückgegebene Kennung.
Ein eigenständiger Agent, der im Rahmen eines interaktiven oder headless Repository-Workflows eingesetzt werden kann.
Ein Python-Tool in einer Sandbox, das in einer unterstützten Anfrage aktiviert werden muss.
Die Original Grok 4 – Ankündigung Dies ist der historische Kontext der Markteinführung. Er beschreibt nicht das Modell, das in unseren Tests für das Jahr 2026 verwendet wurde.
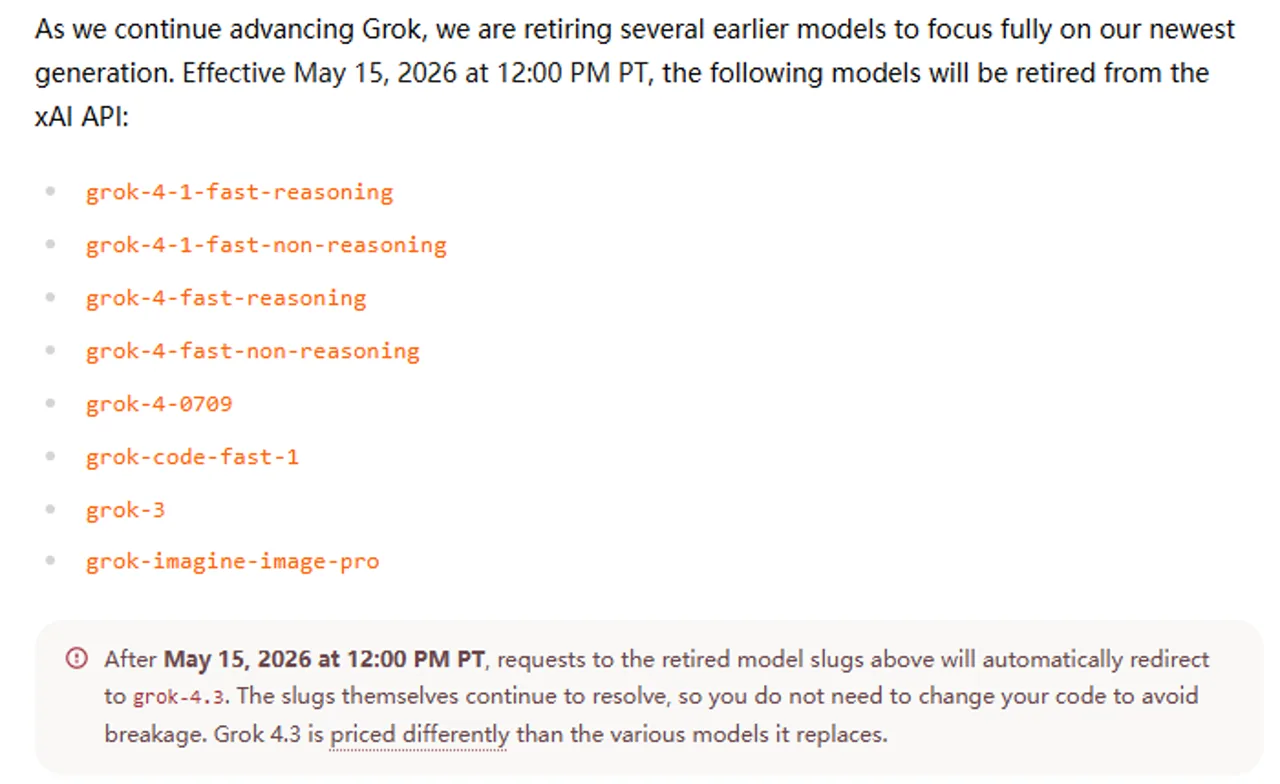
xAI’s Mitteilung zur Umstellung am 15. Mai 2026 sagt grok-4-0709 Leitet nun mit geringer Wahrscheinlichkeit zu Grok 4.3 weiter. Das bedeutet nicht, dass jedes Produkt mit dem Namen „Grok 4“ vom Markt verschwunden ist; es bedeutet vielmehr, dass die genaue Modell-ID entscheidend ist.
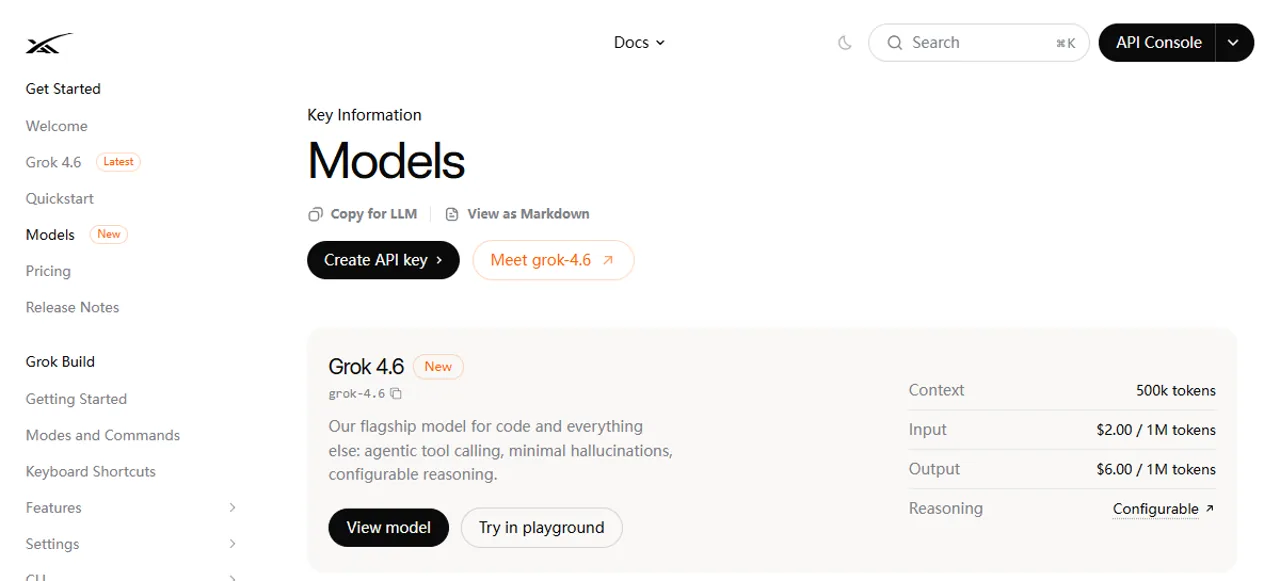
Grok 4.6 ist das aktuelle Modell, das xAI für die Code-Erstellung empfiehlt. Die offizielle Grok 4.6 – Technische Daten Zu den unterstützten Tools zählen unter anderem Funktionsaufrufe, Websuche, X-Suche und Codeausführung. Unterstützung ist nicht gleichbedeutend mit automatischer Aktivierung: Das aufrufende Produkt oder die API-Anfrage bestimmt weiterhin, was das Modell sehen und tun kann.
Die Grok 4.6 – Ankündigung Das Modell ist auf lang laufende Agenten und die Arbeit an der Codebasis ausgelegt. Das ist eine offizielle Produktangabe und kein Ergebnis, das unsere vier isolierten JavaScript-Aufgaben unabhängig voneinander gemessen haben.
Grok-Ausführung ist das eigenständige Kodierungsprogramm. Dank seiner interaktiven Terminal-Oberfläche und des Headless-Modus lässt es sich in einen Repository-Workflow integrieren. Wenn Sie zwischen Modellnamen statt zwischen Kodierungsprodukten wählen, dann ist das Das beste Grok-Modell je nach Aufgabe In diesem Leitfaden wird die aktuelle Familie erläutert.
Die xAI-Tool zur Codeausführung ist eine optionale Python-Umgebung in einer Sandbox. Bei unseren Broly-Tests war diese nicht aktiviert, sodass das Modell vor der Antwort weder eigenes JavaScript ausführte noch das Feedback des Evaluators überprüfte.
Die besten Anwendungsfälle für Grok
Fehlerbehebung bei einem isolierten Fehler
Grok ist besonders nützlich, wenn sich der Fehler auf eine Funktion, einen Stack-Trace, eine fehlerhafte Testumgebung oder einen kurzen Diff reduzieren lässt. Geben Sie an, was passieren sollte, was tatsächlich passiert ist und welche Rahmenbedingungen nicht verändert werden dürfen. Das Ergebnis der Sitzplatzzuweisung zeigt, wie ein präziser Randfall eine vage Anfrage wie “Behebe das” in einen überprüfbaren Patch verwandeln kann.
Erstellen einer ersten Implementierung
Was Adapter, Parser, Transformationsfunktionen und API-Beispiele angeht, kann Grok Hindernisse bei der ersten Nutzung beseitigen. Fragen Sie nach der kleinsten vollständigen Einheit und den Versionen der Pin-Bibliothek und führen Sie den Codeausschnitt aus. Die Grok 4 – Leitfaden zur API-Integration ist der nächste Schritt, wenn es bei der Arbeit um die API geht und nicht um eine isolierte Code-Lösung.
Prüfungen korrigieren oder erstellen
Fragen Sie Grok nach fehlenden Randfällen, Invarianten und Mutantenkandidaten. Prüfen Sie anschließend, ob jede Eingabe das Verhalten, das sie angeblich testet, tatsächlich unterscheidet. Die „Retry-After“-Suite war auf dem Papier umfassend, doch ein Paar abgeglichener Zeitstempel ließ einen semantischen Fehler unentdeckt bleiben.
Vergleich alternativer Ansätze
Grok eignet sich auch als zweite Meinung zu einem Algorithmus, einer Datenstruktur oder einer Hypothese zur Fehlerbehebung. Wenn es bei der Entscheidung eher um die Eignung des Assistenten als um einen einzelnen Patch geht, dann ist die Vergleich der Codierungen von Grok und ChatGPT fügt eine modellübergreifende Ansicht hinzu.
In welchen Fällen erfordert die Grok-Kodierung eine Überwachung?
Refactorings unter Beibehaltung des Verhaltens: Das Modell kann den geforderten Algorithmus erfüllen, obwohl ein Ausgabefeld fehlt. Führen Sie Regressionstests durch und vergleichen Sie serialisierte Ausgaben, Fehler, Reihenfolge, Mutationen und Nebeneffekte.
Änderungen am Repository mit mehreren Dateien: Unsere Nachweise erstrecken sich nicht auf die Erkennung von Abhängigkeiten, Build-Systeme, die Codesuche, generierte Dateien, Migrationen oder koordinierte Bearbeitungen. Verwenden Sie einen echten Programmier-Agenten mit eingeschränktem Repository-Zugriff und überprüfen Sie anschließend dessen Befehle und Diff. Die Vergleich zwischen Codex und Claude-Code-Agenten zeigt, warum der umgebende Arbeitsablauf genauso wichtig ist wie das Modell.
Sicherheits- und Produktionsarbeiten: Betrachten Sie eine positive Antwort nicht als Bedrohungsmodell, Abhängigkeitsprüfung oder Freigabe für die Bereitstellung. Beziehen Sie CI, statische Analyse, Secret-Scanning, Staging, Rollback und manuelle Überprüfung weiterhin in den Prozess mit ein.
Strenge Machine-to-Machine-Formate: In drei von vier Rohantworten wurde trotz ausdrücklicher Anweisung, kein Markdown zu verwenden, ein Markdown-Fence verwendet. Überprüfen und analysieren Sie die Ausgabe an der Grenze; übergeben Sie Modelltext niemals direkt an die Ausführung, nur weil er wie Code aussieht.
Kosten und lange Argumentationsketten: Unser Gateway hat 4.260 Abschluss-Token für eine Anfrage mit max_tokens: 4096, hauptsächlich als Argumentationsmarker. Diese Beobachtung beweist weder das Abrechnungsverhalten noch das Cap-Verhalten von xAI. Sehen Sie sich die aktuelle offizielle Plattform an und vergleichen Sie sie mit der Grok 4 – Leitfaden zu Preisgestaltung und Einrichtung der API bevor man ein Produktionsbudget veranschlagt.
Ein praktischer Arbeitsablauf für die Verwendung von Grok im Code
1. Das Problem eingrenzen
Geben Sie für Grok den kleinsten Reproduktionsfall an, bei dem der Fehler noch auftritt. Geben Sie dabei den Fehler, den relevanten Code und ein erwartetes Ergebnis an. Entfernen Sie irrelevante Projektverläufe und vertrauliche Informationen.
2. Verfassen Sie einen Vertrag, keinen Wunschzettel
Geben Sie den Funktionsnamen, die akzeptierten Eingaben, die genaue Rückgabestruktur, die Reihenfolge, die Mutationsregeln, die Abhängigkeitsgrenzen und das Ausgabeformat an. Die Anleitung zur Verwendung des Grok 4 befasst sich mit dem übergeordneten Konto und dem Eingabe-Workflow.
3. Bitten Sie um Kleingeld
Zieh eine einzelne Funktion oder einen gezielten Diff einer umfassenden Neuprogrammierung vor. Weise das Programm an, das öffentliche Verhalten beizubehalten, und nenne alle Annahmen, die es treffen musste.
4. Unabhängige Überprüfungen durchführen
Führen Sie den Code außerhalb der Modellantwort aus. Fügen Sie Randfälle hinzu, die ähnliche Semantiken voneinander unterscheiden, überprüfen Sie Eingabeveränderungen, vergleichen Sie jedes Ausgabefeld und testen Sie erwartete Fehlerfälle. Führen Sie bei generierten Testsuiten bekannte Mutanten aus, wenn das Risiko dies rechtfertigt.
5. Überprüfen Sie die Unterschiede und übernehmen Sie die Verantwortung für die Entscheidung
Lesen Sie den endgültigen Diff so, als stamme er von einem menschlichen Mitwirkenden. Überprüfen Sie Änderungen an Abhängigkeiten, Sicherheitsgrenzen, Observabilität und Rollback-Möglichkeiten. Die Person, die den Merge durchführt oder die Bereitstellung vornimmt, bleibt für das Ergebnis verantwortlich.
Was Entwickler öffentlich mitteilen
Die Erfahrungen der Nutzer sind gemischt und hängen stark von der Aufgabe, dem Produkt, der Eingabeaufforderung und dem Zeitpunkt ab. Zwei Kommentare auf Hacker News veranschaulichen die Bandbreite, doch keiner von beiden stellt einen Maßstab oder eine repräsentative Umfrage dar.
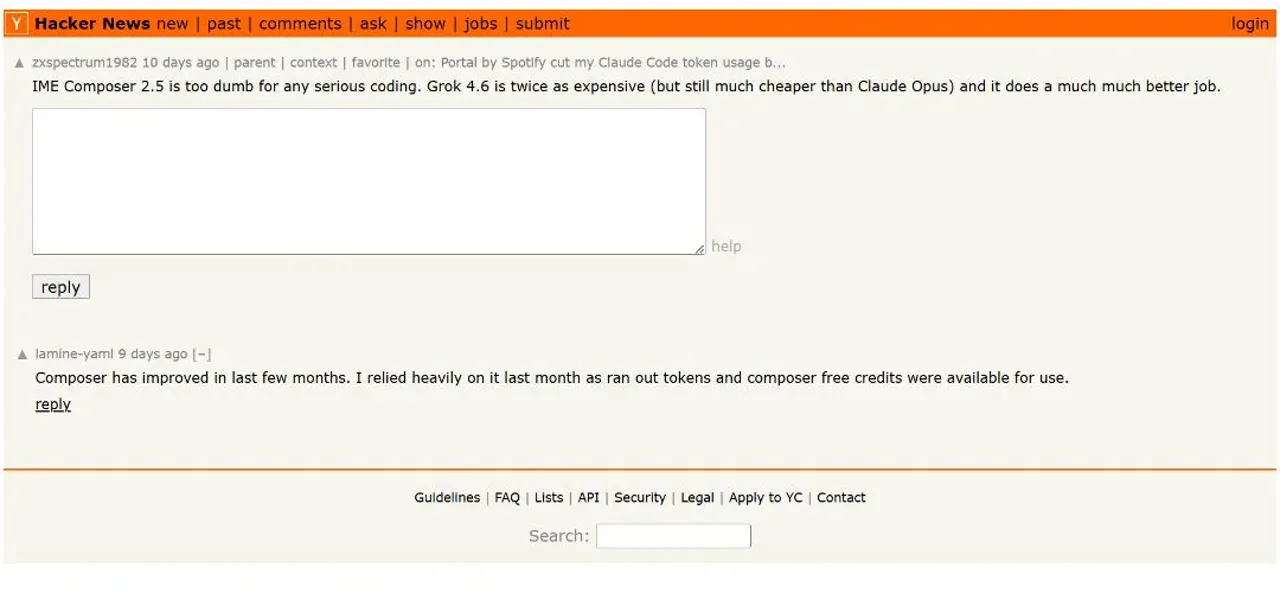
Am 5. September 2026 schrieb ein Nutzer von Hacker News zxspectrum1982 beschrieb Grok 4.6 als deutlich leistungsfähiger als Composer 2.5 bei anspruchsvollen Programmieraufgaben, merkte jedoch gleichzeitig an, dass es teurer sei. Dies ist der Vergleich eines einzelnen Nutzers und keine allgemeine Aussage zur Leistung.
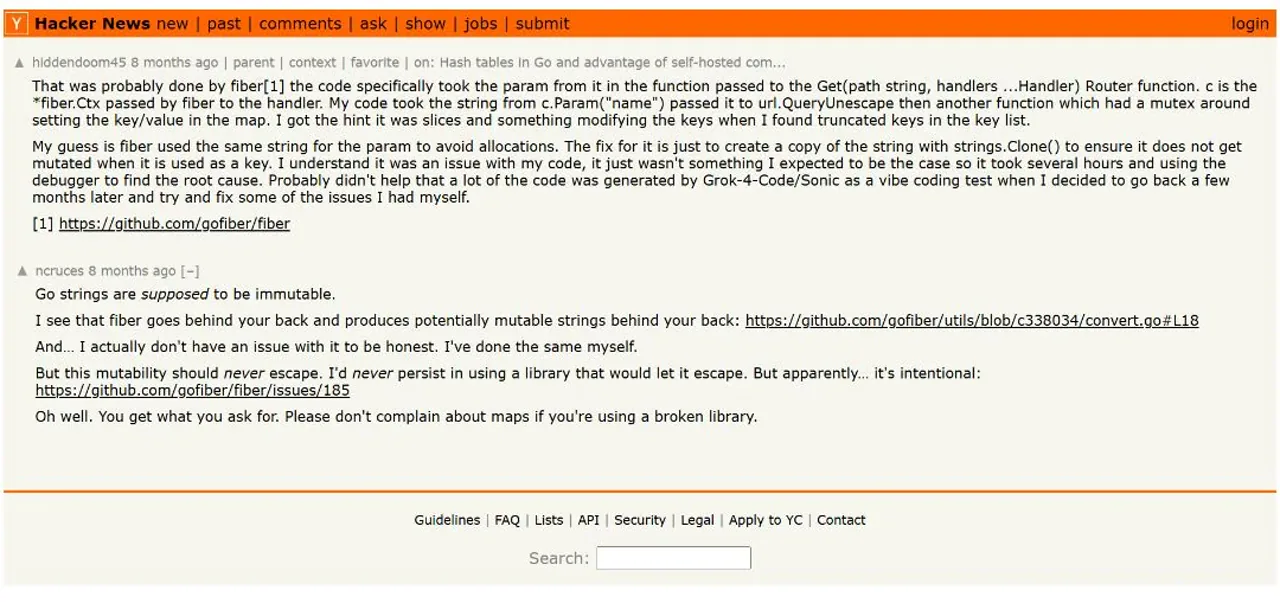
Am 20. Dezember 2025 schrieb ein Nutzer von Hacker News hiddendoom45 beschrieb, wie später mit einem Debugger ein subtiler Fehler bezüglich der Lebensdauer von Go/Fiber-Strings entdeckt wurde, nachdem im Rahmen eines Grok-4-Code/Sonic-Experiments Code generiert worden war. Dieser historische Bericht spricht für manuelles Debugging und eine auf die Lebensdauer ausgerichtete Überprüfung; er belegt jedoch keine Ausfallrate von Grok 4.6.
Der gemeinsame Nenner ist nicht, dass Grok immer erfolgreich ist oder scheitert. Vielmehr wird die Qualität des Codes erst dann sichtbar, wenn die Lösung auf eine konkrete Aufgabe, eine bestimmte Toolchain und einen bestimmten Prüfer trifft. Dasselbe gilt auch in dem separaten ChatGPT – Realitätscheck der Codierung: Die Qualität der Assistenzarbeit ist untrennbar mit der Überprüfung verbunden.
Häufig gestellte Fragen
Ist Grok 4 für Programmieranfänger geeignet?
Ja, zur Verdeutlichung, für kleine Beispiele und zur angeleiteten Fehlerbehebung. Anfänger sollten dennoch jeden Codeausschnitt ausführen, nachfragen, was sich durch die einzelnen Zeilen ändert, und vermeiden, vertrauliche Daten einzufügen oder unbekannten Code ohne vorherige Überprüfung bereitzustellen.
Welches Grok-Modell sollte ich für die Programmierung verwenden?
Nach Stand vom 11. September 2026 empfiehlt xAI „Grok 4.6“ als Code. Überprüfen Sie die genaue Modell-ID in Ihrem Produkt, da der ursprüngliche API-Slug „grok-4-0709“ nicht mehr verwendet wird.
Kann Grok 4.6 ein gesamtes Repository bearbeiten?
Das Modell kann die Arbeit mit Repositorys unterstützen, wenn es innerhalb eines Agenten mit begrenztem Datei- und Befehlszugriff eingesetzt wird. Bei unseren Tests handelte es sich um isolierte Abfragen, sodass sie keine Aussage über die autonome Verarbeitung mehrerer Dateien oder die Produktionsreife zulassen.
Ist „Grok Build“ dasselbe wie die Verwendung von „Grok“ im Chat?
Nr. Grok Build ist ein eigenständiger interaktiver oder headless Coding-Agent. Bei einer normalen Chat- oder API-Vervollständigung werden dessen Repository-Kontext, Terminal, Berechtigungen oder Tool-Loop nicht automatisch übernommen.
Kann ich Grok 4.6 für die Programmierung auf GlobalGPT verwenden?
Ja. GlobalGPT bietet einen verifizierten Grok-4.6-Weg für begrenzte Codierungsanweisungen und Modellvergleiche. Es handelt sich um eine unabhängige Plattform, die weder Grok Build noch eine IDE oder die nativen API-Tools von xAI ersetzt.
Sollte ich dem von Grok generierten Code vertrauen, ohne ihn zu testen?
Nein. Führen Sie den Code aus, fügen Sie Randfälle hinzu, überprüfen Sie den Diff und führen Sie Ihre üblichen Lint-, Typ-, Sicherheits- und CI-Prüfungen durch. Unsere Umgestaltung sah zwar sauber aus, ließ jedoch in jedem nicht leeren Ergebnis ein Pflichtfeld aus.
Endgültiges Urteil
Eignet sich Grok 4 gut zum Programmieren? Das aktuelle Modell „Grok 4.6“ ist ein leistungsfähiger Programmierassistent für begrenzte Korrekturen, kleine Funktionen, Erläuterungen und Tests im ersten Durchlauf. In unserer Suite aus vier Aufgaben lieferte es zwei vollständig korrekte Lösungen, eine Refaktorisierung, die zu Fehlverhalten führte, und eine unvollständige Testsuite. Außerdem ignorierte es in drei Antworten die strikte Anweisung, kein Markdown zu verwenden.
Setzen Sie diese Methode dort ein, wo Fehler kostengünstig erkannt werden können: bei begrenztem Umfang, expliziten Vereinbarungen, ausführbaren Testumgebungen und menschlicher Überprüfung. Betrachten Sie diese Nachweise nicht als Freigabe für unbeaufsichtigte Änderungen am Repository, als Sicherheitsfreigabe oder als Freigabe für den Einsatz in der Produktion.
Für einen Praxistest, Grok 4.6 auf GlobalGPT öffnen, führen Sie einen der oben genannten vollständigen Befehle aus und vergleichen Sie die Ausgabe mit Ihren eigenen Tests, bevor Sie entscheiden, ob er in Ihren Arbeitsablauf passt.