Modellübersicht · Benchmarks · Echte API-Tests
Gemini 3.7 Flash wird als schnelles, schlussfolgerungsfähiges Modell für die Programmierung, agentenbasierte Aufgaben, multimodale Eingaben und alltägliche Produktionsaufgaben positioniert. Die wichtigere Frage ist jedoch schwieriger zu beantworten: Liefert es bessere Endergebnisse als Gemini 3.6 Flash, wenn beide Modelle dieselbe Eingabe erhalten?
Dieser Testbericht zum Gemini 3.7 Flash unterscheidet zwischen drei Arten von Belegen. Die Dokumentation von Google liefert Informationen zu den Modellspezifikationen, Preisen und offiziellen Benchmark-Angaben. Artificial Analysis bietet unabhängige Benchmark-Ergebnisse von Drittanbietern. Unser praktischer Vergleich basiert auf sieben aufeinander abgestimmten API-Aufgaben, wobei für beide Modelle dieselben Eingabe- und Generierungseinstellungen verwendet wurden.
Gemini 3.7 Flash ist für Tests über die GlobalGPT Gemini 3.7 Seite „Flash-Modell“. So können Sie dieselbe Eingabe an einem einzigen Ort für mehrere Modelle ausführen, einschließlich des in diesem Test verwendeten Basismodells. Weitere Informationen hierzu finden Sie in unserem Gemini 3.6 Kurzrezension und die Vergleich zwischen Gemini 3.6 Flash und Gemini 3.1 Pro.
Gemini 3.7 Kurzrezension: Die kurze Antwort
Gemini 3.7 Flash lieferte bei drei von sechs abgeschlossenen Aufgabenpaaren das bessere Endergebnis., verglichen mit zwei Siegen für Gemini 3.6 Flash und einem Unentschieden. Seine Stärken zeigten sich in den Bereichen Programmierung, Datenauswertung und claim-safe SEO-Bearbeitung. Gemini 3.6 Flash lieferte den übersichtlicheren textuellen Frontend-Entwurf und die sorgfältigere Statusextraktion, während die agentische Planung mit einem Unentschieden endete.
Übersicht über die Bewertung
| Maß | Beobachtetes Ergebnis | Was das bedeutet |
|---|---|---|
| Ausgabequalität | 3,7 Siege; 3,6 Siege; 1 Unentschieden | Die Bewertungen ergeben sich aus dem fertigen Werk, das auf der jeweiligen Karte abgebildet ist. |
| Geschwindigkeit | Gemischt | 3.7 war bei vier Aufgaben schneller, aber 3.6 hatte einen etwas niedrigeren Durchschnitt bei sechs Aufgaben. |
| Token-Effizienz | 3.7 verwendete 7.948 Ausgabetoken; 3.6 verwendete 10.058 | Bei den abgeschlossenen Aufgaben lieferte 3.7 21% weniger Ausgabetoken. |
| Bestes Ergebnis mit 3,7 | SEO-Optimierung ohne riskante Behauptungen | Es hielt sich an die feststehenden Fakten, ohne eine unbegründete Beschreibung hinzuzufügen. |
Es handelt sich hierbei um sechs kleine, kontrollierte Textaufgaben und nicht um eine allgemeine Modellbewertung. T01 wurde ausgeschlossen, da keines der Modelle die geforderte Antwort innerhalb der vorgegebenen Ausgabegrenze fertiggestellt hat.
Was ist Gemini 3.7 Flash?
Gemini 3.7 Flash ist Googles stabiles Modell mit hohem Durchsatz für Aufgaben, bei denen logisches Schlussfolgern weiterhin von Vorteil ist. Google listet Text-, Bild-, Video-, Audio- und PDF-Eingaben auf; zu den unterstützten Funktionen gehören Funktionsaufrufe, Codeausführung, suchbasierte Verknüpfung, Dateisuche, strukturierte Ausgaben und Computernutzung (Vorschau). Die praktische Frage ist, wie sich diese Steuerungsmöglichkeiten auf das fertige Ergebnis auswirken.
Erscheinungsdatum und Verfügbarkeit
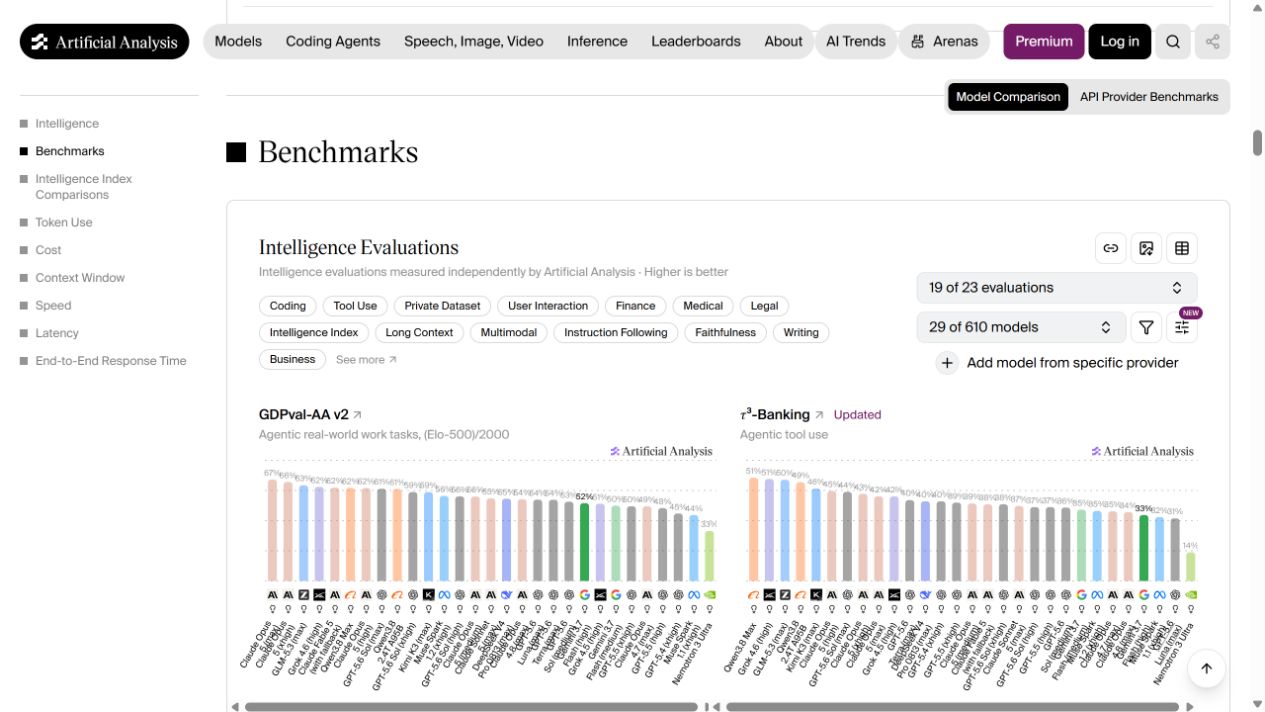
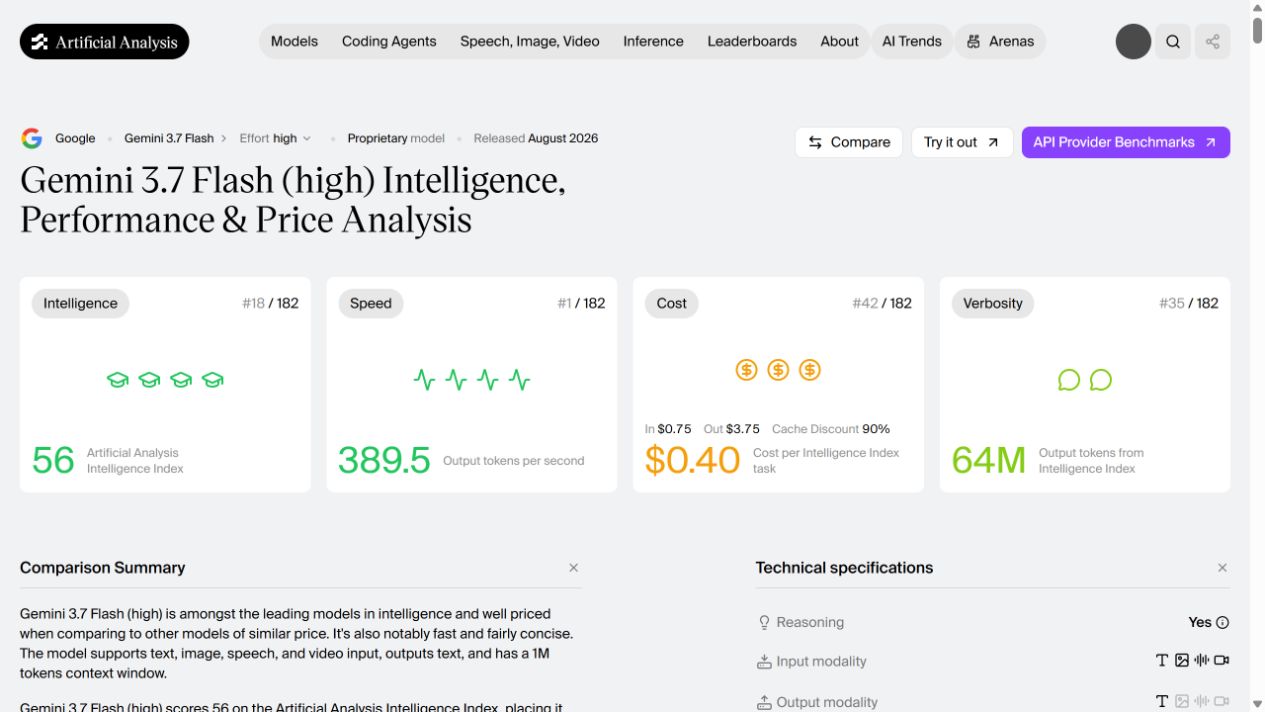
Auf der abgebildeten Seite „Artificial Analysis“ wird „Gemini 3.7 Flash (high)“ mit einem Veröffentlichungsdatum im August 2026 aufgeführt. Informationen zum offiziellen Status, zur Modell-ID, zu den unterstützten Funktionen und zu den Details der Einführung finden Sie bei Google unter Offizielle Gemini 3.7 Flash-Modellkarte sowie die verlinkte API-Dokumentation. Die Verfügbarkeit kann je nach Produkt, Region, Konto und Modellstufe variieren, sodass eine Seite, auf der ein Modell aufgeführt ist, für sich genommen noch kein Beweis für einen universellen Zugriff ist.
Was hat sich gegenüber der Version „Gemini 3.6 Flash“ geändert?
Bei dieser Änderung handelt es sich nicht lediglich um einen höheren Benchmark-Wert. Google beschreibt Gemini 3.7 Flash als Weiterentwicklung von Gemini 3.6 Flash mit Verbesserungen hinsichtlich der Grundlagen des logischen Schlussfolgerns und der anpassbaren Denkweise. In unseren abgeschlossenen Testpaaren führte dies bei drei Aufgaben zu einer besseren Bewältigung von Einschränkungen, allerdings nicht zu einem durchgängigen Erfolg.
| Vergleichsbereich | Gemini 3.7 Flash | Gemini 3.6 Flash | Beobachtete Beweise |
|---|---|---|---|
| Behebung eines Programmierfehlers | Richtig, mit saubereren Tests | Richtig, aber länger | 3,7 knapper Sieg |
| Konzeption des Text-Frontends | Verwertbar, mit zwei redaktionellen Mängeln | Übersichtlicher und in sich schlüssiger | 3,6 knapper Sieg |
| Statusorientierte Extraktion | Vollständige Erinnerung, aber eine übertriebene Erfolgsbezeichnung | Genauere Statusangaben | 3,6 knapper Sieg |
| Datenauswertung | Richtig, mit einer übersichtlicheren Standardaufteilung | Richtig, mit weiteren bedingten Details | 3,7 knapper Sieg |
| Agentenbasierte Planung | Stabile Absperrschranken | Konkretere Details zum Tool-Aufruf | Krawatte |
| SEO-Bearbeitung | Alle gesperrten Ansprüche wurden beibehalten | Ein nicht unterstütztes Adjektiv hinzugefügt | 3,7 knapper Sieg |
Gemini 3.7 Flash-Spezifikationen und Kontextfenster
Spezifikationen sind wichtig, da sie die Bedingungen festlegen, unter denen ein Vergleich fair ist. Wenn Sie eher die Leistungsgrenzen der Tarife als das Modellverhalten vergleichen, ist unser Leitfaden zu den Gemini-Grenzwerten und -Kontingenten ist die genauere Nachverfolgung. Eine Kontextfensterzahl bedeutet nicht automatisch, dass ein Modell jedes lange Dokument korrekt zusammenfasst; sie gibt lediglich an, was die API laut Spezifikation akzeptieren soll. Der folgende Extraktionstest prüft separat den Recall, den Umgang mit Widersprüchen und unbekannte Elemente.
| Spezifikation | Gemini 3.7 Flash | Gemini 3.6 Flash | Quelle |
|---|---|---|---|
| Zurückgegebene API-Modell-ID | gemini-3.7-flash | gemini-3.6-flash | Aufgezeichnete API-Antworten |
| Eingabekontext | Bis zu 1 Million Token | Bis zu 1 Million Token | Google-Modellkarte |
| Maximale Textlänge | 64K-Token | 64K-Token | Google-Modellkarten |
| Dokumentierte Eingaben | Text, Bilder, Audio, Video | Text, Bilder, Audio, Video | Google-Modellkarten |
Gemini 3.7 Flash-Preise und API-Kosten
Bei der Preisgestaltung muss klar zwischen einem veröffentlichten Tarif und den Kosten für eine bestimmte Antwort unterschieden werden. Die erfasste Zusammenfassung der künstlichen Analyse zeigt $0,75 pro 1 Million Eingabetoken und $3,75 pro 1M ausgegebener Token für den ausgewählten Eintrag „Gemini 3.7 Flash (high)“. Bei diesen Zahlen handelt es sich um Daten von Drittanbietern, die weder die offizielle Preistabelle von Google ersetzen noch Aussagen über alle Zugangswege treffen.
Erfasster Preiskontext von Drittanbietern
Nur zur visuellen Veranschaulichung. Die Balken ersetzen nicht die offizielle Abrechnungseinheit, die Preisstufe, die Region oder die Cache-/Batch-Regeln.
Die Google-Modellkarte gibt einen Einführungs-API-Tarif von $0,75 pro 1 Mio. Eingabetoken und $3,75 pro 1 Mio. Ausgabetoken für beide Flash-Modelle bis zum 31. Dezember 2026. Die nachstehenden Schätzungen pro Karte wenden diesen Tarif auf erfasste Token an; Wiederholungsversuche, Zwischenspeicherung, Steuern und streckenspezifische Gebühren sind darin nicht enthalten.
| Kostenposition | Gemini 3.7 Flash | Gemini 3.6 Flash | Beweisgrenze |
|---|---|---|---|
| Einstiegspreis | $0,75 / 1M | $0,75 / 1M | Google-Modellkarte; gültig bis zum 31. Dezember 2026 |
| Einführungs-Verkaufspreis | $3,75 / 1M | $3,75 / 1M | Die Abrechnung kann je nach Strecke variieren |
| Sechs abgeschlossene Testpaare | Über $0.0303 | Über $0.0382 | Abgeleitet aus erfassten Tokens; T01 ausgenommen |
Gemini 3.7 Flash – Offizielle Benchmark-Ergebnisse
Offizielle Benchmarks beantworten eine eng gefasste Frage: Wie hat sich das Modell bei einer veröffentlichten Evaluierung unter den dort festgelegten Bedingungen geschlagen? Sie liefern nützliche Hintergrundinformationen, sind jedoch kein Ersatz für den in diesem Test durchgeführten Vergleich der Ausgaben bei identischer Eingabeaufforderung.
Benchmarks für Programmierung, Agenten und Schlussfolgerungen
Die Google-Modellkarte und die offizielle Dokumentation sind die Quellen, auf die man sich bei den von Google selbst angegebenen Benchmark-Werten stützen sollte. In der endgültigen Fassung werden für jeden Wert die Kennzahl, das Datum, die Modellvariante, das Vergleichsmodell und die Testbedingungen angegeben. Ein Ergebnis von 3,7 im Vergleich zu einem älteren Modell wird nicht einfach stillschweigend als „3,7 gegenüber 3,6“ dargestellt.
Was Benchmark-Ergebnisse nicht belegen
- Ein höherer Coding-Score bedeutet nicht, dass der erste Patch in jedem Repository sauberer ist.
- Eine hohe Punktzahl im Bereich „logisches Denken“ ist kein Beweis für bessere SEO-Bearbeitung oder die Interpretation von Screenshots.
- Ein von Dritten erstellter Intelligenzindex ersetzt nicht die aufgabenspezifischen Belege in dieser Übersicht.
- Sich überschneidende Unsicherheiten oder unterschiedliche Testbedingungen sollten nicht zu einer entscheidenden Rangfolge führen.
So haben wir den Gemini 3.7 Flash getestet
Es handelte sich um einen API-Test mit identischen Bedingungen, nicht um eine Sammlung unabhängiger Demos. Beide Modelle erhielten dieselbe Eingabeaufforderung, dasselbe Quellmaterial, eine Temperatur von 0, dieselbe Obergrenze für die Anzahl der Ausgabe-Token und dieselbe Präsentationsweise. T05 wurde anhand eines gemeinsamen Wiederholungslaufs mit 5.000 Token bewertet, nachdem beide ersten Versuche die untere Obergrenze erreicht hatten. T01 blieb für beide Modelle auch nach demselben Wiederholungslauf unvollständig.
| Erfasstes Feld | Warum das wichtig ist |
|---|---|
| Modell-ID und zurückgegebene Modell-ID | Stellt sicher, dass das angeforderte Modell auch das Modell ist, das geantwortet hat. |
| Verstrichene Sekunden | Misst die End-to-End-Reaktionszeit auf derselben Route. |
| Eingabe- und Ausgabemarken | Unterstützt eine vergleichbare Kostenschätzung. |
| Einhaltung der Formatvorgaben | Unterscheidet eine richtige Antwort von einer Antwort, deren Struktur noch überarbeitet werden muss. |
| Redaktionelle Qualität | Überprüft die Richtigkeit, Vollständigkeit, Spezifität, Darstellung und Sicherheit der Angaben. |
Eine ausgelöste Anfrage ohne verwertbare Ausgabe wird als Ausführungsproblem ausgewiesen und nicht als Qualitätsverlust gewertet.
Gemini 3.7 Flash – Praxistestergebnisse
Jede Karte enthält die eigentliche Aufgabenstellung, einen originalgetreuen Auszug aus jeder gespeicherten Antwort sowie eine Bewertung auf Grundlage der fertigen Arbeit. Die verstrichene Zeit bezieht sich auf den gesamten Prozess. Bei den Kosten wird der oben beschriebene Google-Einführungstarif zugrunde gelegt.
Test 1 – Forschungsübersicht
Aufgabentext: Verfassen Sie eine Kaufempfehlung mit einer Länge von 180 Wörtern, wobei Sie ausschließlich die vier vorgegebenen Fakten verwenden und eine Empfehlung, drei Gründe, zwei Unbekannte sowie einen Testplan einbeziehen.
Gemini 3.7 Flash
33,427 s · 85 Eingabe- / 4.996 Ausgabe-Token · geschätzt: $0,01880
Der zweite abgeglichene Durchlauf stoppte an der Obergrenze von 5.000 Tokens, bevor er eine brauchbare Empfehlung mit 180 Wörtern lieferte.
Gemini 3.6 Flash
28,706 s · 85 Eingabe- / 4.996 Ausgabe-Token · geschätzt: $0,01880
Es gab dieselbe Anzahl an Abschluss-Tokens und dasselbe Länge Abschlussgrund.
Was die Ergebnisse zeigen
Beide Modelle erreichten zunächst 2.400 Token und wiederholten dieses Verhalten dann bei 5.000. Teiltexte werden nicht als Qualitätsnachweis gewertet.
Test 2 – Behebung eines Programmierfehlers
Aufgabentext: Beheben top_paid(Datensätze) Die drei Datensätze mit den höchsten Werten zurückgeben, bei Gleichstand die Eingabereihenfolge beibehalten, die Signatur beibehalten, mit leeren Eingaben umgehen, die Ursache erläutern und zwei Tests hinzufügen.
Gemini 3.7 Flash
11,379 s · 90 Eingabe- / 1.431 Ausgabe-Token · geschätzt $0,00543
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]Es identifizierte die aufsteigende Sortierung als Ursache und testete Filterung, Rangfolge, Gleichstände und leere Eingaben.
Gemini 3.6 Flash
13,984 s · 90 Eingabe- / 2.273 Ausgabe-Token · geschätzt: $0,00859
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]Es lieferte denselben korrekten Patch und erfüllte dieselben Abnahmekriterien, allerdings mit einer längeren Antwortzeit.
Was die Ergebnisse zeigen
Beide nutzen bei gleichen Werten korrekterweise die stabile Sortierfunktion von Python. Die Lösung in Version 3.7 ist kürzer, aber der fertige Code und die Abdeckung sind gleichwertig.
Test 3 – Plan zur Implementierung des textbasierten Frontends
Aufgabentext: Planen Sie Korrekturen für einen beschriebenen zweispaltigen Bezahlvorgang mit übermäßigen Leerzeichen, einer unklaren Hierarchie, einer winzigen „Jetzt bezahlen“-Beschriftung, einem schwer erkennbaren Vertrauenshinweis, einer Rabattwarnung, Summenangaben und einer Stapelung auf Mobilgeräten. Es wurde kein Screenshot bereitgestellt.
Gemini 3.7 Flash
15,009 s · 86 Eingabe- / 1.591 Ausgabe-Token · geschätzt: $0,00603
Es wurden ein 58/42-Raster, ein 48–56px großer CTA, ein daneben platziertes Vertrauenssiegel, eine gelbe Warnung, die Stapelung auf Mobilgeräten, Fokuszustände und 44px große Touch-Ziele vorgeschlagen.
Gemini 3.6 Flash
15,254 s · 86 Eingabe- / 1.767 Ausgabe-Token · geschätzt: $0,00669
Das Ergebnis war ein einheitliches 60/40-Layout, explizit festgelegte Schriftgrößen, ein CTA mit einer Größe von 48–52 px, geordnete Inhalte in der rechten Spalte, Breakpoints und Barrierefreiheitsprüfungen.
Was die Ergebnisse zeigen
Beide sind umsetzbar. In der Antwort 3.7 heißt es “Klick-Affordance”, womit offenbar “Affordanz” gemeint ist, und ein asymmetrisches Raster wird als „symmetrisch“ bezeichnet. Die Version 3.6 erfordert weniger Überarbeitungsaufwand.
Test 4 – Statusabhängige Extraktion
Aufgabentext: Fassen Sie neun Fakten zu Orion in 120 Wörtern zusammen und fügen Sie eine Tabelle hinzu, wobei Sie die Status „bestätigt“, „geplant“, „ausstehend“, „unbekannt“ und „unbestätigt“ beibehalten.
Gemini 3.7 Flash
13,681 s · 117 Eingabe- / 1.064 Ausgabe-Token · geschätzt: $0,00408
Das Ergebnis für das bildlastige Modell 18% blieb ungewiss, doch das Pilotergebnis für das Modell 82% wurde als “erfolgreich” bezeichnet, und der zweite Pilotversuch wurde als “bestätigt / geplant” eingestuft.”
Gemini 3.6 Flash
9,270 s · 117 Eingabe- / 1.454 Ausgabe-Token · geschätzt $0,00554
Darin wurde das Pilotprojekt neutral als ein Projekt beschrieben, das 82% Fälle bearbeitete, und das zweite Pilotprojekt wurde als “Genehmigt (rechtliche Klärung ausstehend)” gekennzeichnet.”
Was die Ergebnisse zeigen
Beide haben alle wesentlichen Fakten beibehalten. Gemini 3.6 Flash hat die Statusangaben „genehmigt“, „anhängig“ und „unbekannt“ genauer wiedergegeben, während 3.7 den ersten Pilotversuch leicht überbewertet hat.
Test 5 – Datenauswertung
Aufgabentext: Anhand der Ausgaben, Klicks, bezahlten Conversions und Umsätze für vier Kanäle sind Berechnungen vorzunehmen, der ROAS und die Conversion-Rate nach ihrer Messbarkeit zu ordnen, Ausgaben in Höhe von null als nicht messbar zu behandeln und eine bedingte Aufteilung nach dem $300-Schema zu empfehlen.
Gemini 3.7 Flash
16,540 s · 137 Eingabe- / 1.981 Ausgabe-Token · geschätzt $0,00753
ROAS: E-Mail 7,00×, Suche 3,00×, Social Media 2,60×; Partner nicht messbar. Konversion: E-Mail 12,5%, Suche und Partner 10%, Social Media 5%. Es wurden drei bedingte Splits angeboten.
Gemini 3.6 Flash
18,096 s · 137 Eingabe- / 2.403 Ausgabe-Token · geschätzt: $0,00911
Es erzeugte dieselben Ranglisten und dieselbe Behandlung von Sonderfällen und bot anschließend Effizienz, Diversifizierung und Zuteilungen auf Basis des Partner-Tests an.
Was die Ergebnisse zeigen
Beide Berechnungen sind korrekt und beide stellen die Empfehlung unter Vorbehalt. Beide fügen spekulative Erläuterungen zu den Nullausgaben von Partner hinzu, sodass dieser Satz entweder durch eine Quelle belegt oder gestrichen werden muss.
Test 6 – Agentesch Planen und Werkzeuggebrauch
Aufgabentext: Erstellen Sie einen Plan mit weniger als 220 Wörtern, wobei Sie ausschließlich vier namentlich genannte Tools verwenden dürfen. Brechen Sie den Vorgang ab, wenn die Seite nicht verfügbar, inoffiziell oder mehrdeutig ist, und geben Sie nicht an, dass die Tools ausgeführt wurden.
Gemini 3.7 Flash
10,787 s · 100 Eingabe- / 1.174 Ausgabe-Token · geschätzt $0,00448
Die vier Schritte entsprechen eins zu eins den bereitgestellten Tools, gefolgt von den Prüfschritten „offizielle Domain“, „Verfügbarkeit“ und „Klarheit“. Für den Abschluss ist genau ein validierter CSV-Datensatz erforderlich.
Gemini 3.6 Flash
9,702 s · 100 Eingabe- / 1.328 Ausgabe-Token · geschätzt $0,00506
Der Plan ist zwar umsetzbar, sieht jedoch zusätzlich vor, “den HTML-Body zu analysieren” – eine Operation, die über den Umfang der bereitgestellten Tools hinausgeht.
Was die Ergebnisse zeigen
Beide halten sich an die „Stop-Regel“ für offizielle Quellen und vermeiden es, so zu tun, als wären Tools ausgeführt worden. Der 3.7-Plan hält sich strenger an die verfügbaren Funktionen.
Test 7 – SEO-Texterstellung und -Bearbeitung
Aufgabentext: Geben Sie HTML-Code zurück, der nur einen Absatz und eine kurze Aufzählung enthält, verwenden Sie das genaue Schlüsselwort einmal und behalten Sie vier feststehende Fakten bei, ohne ein Ergebnis, einen Preis, ein Erscheinungsdatum oder Angaben zur Verfügbarkeit zu erfinden.
Gemini 3.7 Flash
7,263 s · 125 Eingabe- / 707 Ausgabe-Token · geschätzt $0,00275
<p>In diesem bevorstehenden Testbericht zum Gemini 3.7 Flash untersuchen wir das Modell von Google, indem wir offizielle Benchmark-Ergebnisse mit API-Tests unter Verwendung derselben Eingabe vergleichen; praktische Testergebnisse stehen derzeit noch aus.</p>Es folgte der HTML-Struktur, verwendete das Schlüsselwort einmal und behielt die gesperrten Ansprüche bei.
Gemini 3.6 Flash
7,542 s · 125 Eingabe- / 833 Ausgabe-Token · geschätzt: $0,00322
<p>In diesem vorläufigen Testbericht zum Gemini 3.7 Flash wird das neue Modell von Google bewertet … detaillierte Ergebnisse aus der Praxis stehen jedoch derzeit noch aus.</p>Die Struktur ist korrekt, aber “neues Modell” fügt eine Behauptung hinzu, die über die feststehenden Fakten hinausgeht.
Was die Ergebnisse zeigen
Der entscheidende Unterschied liegt in der Sicherheit der Angaben: 3.7 hat die Einfügung des nicht unterstützten Deskriptors verhindert und gleichzeitig gültigen, kompakten HTML-Code zurückgegeben.
Gemini 3.7 Flash-Test-Bewertungsbogen und Erkenntnisse
Der Vergleich fällt zugunsten von Gemini 3.7 Flash hinsichtlich der Qualität des Endergebnisses aus, doch dieser Vorsprung ist eher auf die Befehlsdisziplin zurückzuführen als auf einen dramatischen Leistungsunterschied. Gemini 3.6 Flash blieb bei Code und Arithmetik konkurrenzfähig und erstellte den besseren Frontend-Plan.
Bewertungsbogen für den Matched-Test
| Maß | Gemini 3.7 Flash | Gemini 3.6 Flash |
|---|---|---|
| Auftragserfolge | 3 | 2 |
| Hochwertige Krawatten | 1 | 1 |
| Unerledigte Aufgaben | 1 | 1 |
| Verwertbare abgeschlossene Aufgaben | 6 von 7 | 6 von 7 |
| Ausgabe-Token für abgeschlossene Aufgaben | 7,948 | 10,058 |
| Am besten beobachtete Ausgabe | Begrenzter agentischer Plan | Konzeption des Text-Frontends |
Gemini 3.7 Einschränkungen beim Flash-Speicher
Die größte festgestellte Einschränkung trat bei beiden Modellen auf: Bei einer einfachen Anfrage zur Zusammenfassung von Forschungsergebnissen mit 180 Wörtern verbrauchten beide Modelle das gesamte Ausgabebudget zweimal. T01 ist unter der getesteten Konfiguration unbrauchbar.
Gemini 3.7 Flash war nicht durchweg besser. Sein Frontend-Entwurf wies einen Formulierungsfehler und eine Diskrepanz zwischen interner Layout-Beschreibung auf, während beide Datenantworten spekulative Zusammenhänge im Zusammenhang mit einem Kanal ohne Ausgaben aufzeigten. Da das Paket ausschließlich textuelle Eingaben verwendete, lässt sich keine Aussage über die Qualität von Bild, Audio, Video oder wirklich langem Kontext treffen.
Lohnt sich der Gemini 3.7 Flash?
Ja, Gemini 3.7 Flash ist einen Test wert, wenn es auf die exakte Einhaltung der Befehle ankommt. Es gewann bei drei abgeschlossenen Aufgaben und verbrauchte bei den sechs verwendbaren Paaren weniger Ausgabetoken. Bei einfachen Code-Korrekturen, arithmetischen Aufgaben oder der UI-Planung ist das Ergebnis weniger überzeugend: Hier gewann der Gemini 3.6 Flash die Frontend-Aufgabe oder lag knapp dahinter.
Du kannst denselben Befehl in GlobalGPT und vergleichen Sie es mit „Gemini 3.6 Flash“ im selben Arbeitsbereich. Verwenden Sie Ihre wiederkehrende Aufgabe als entscheidenden Test.
Gemini 3.7 Blitz-Testbericht: Fazit
Dieser Testbericht zum Gemini 3.7 Flash endet mit einem knappen, aber vertretbaren Ergebnis: Gemini 3.7 Flash gewann drei abgeschlossene Aufgaben, Gemini 3.6 Flash gewann zwei, und bei einer gab es ein Unentschieden. Eine Forschungsaufgabe blieb ergebnislos, da beide Modelle zweimal die gemeinsame Obergrenze der Ausgabe erreichten.
Gemini 3.6 Flash ist nicht veraltet. Es lieferte den besseren textbasierten Frontend-Plan und die sorgfältigere Statustabelle, während 3.7 in den Bereichen Codierung, Datenauswertung und SEO-Bearbeitung mit festen Fakten stärker war. Bei der agentenbasierten Planungsaufgabe gab es ein Unentschieden, sodass das Upgrade eher selektiv als absolut ist.
Gemini 3.7 – Häufig gestellte Fragen zum Flash
Wann wurde Gemini 3.7 Flash veröffentlicht?
Google führt „Gemini 3.7 Flash“ als stabiles Modell auf, wobei die Modelldokumentation zuletzt am 13. August 2026 aktualisiert wurde.
Ist Gemini 3.7 Flash eine stabile Version oder eine Vorschauversion?
In der Dokumentation zum Gemini-API-Modell von Google wird es als stabil aufgeführt. AI Studio, Gemini-Endkundenprodukte und Routen von Drittanbietern können jedoch weiterhin abweichende Verfügbarkeiten oder Kontingente aufweisen.
Wie lautet die Modell-ID der Gemini 3.7 Flash API?
Der angeforderte Vergleich verwendet `gemini-3.7-flash`, doch die zurückgegebene Modell-ID muss aus der API-Antwort erfasst werden, bevor der Artikel endgültig als verifiziert ausgewiesen wird.
Wie viel kostet Gemini 3.7 Flash?
Der Tarif für die kostenpflichtige Stufe von Google beträgt bis zum 31. Dezember 2026 $0,75 pro 1 Million Eingabetoken und $3,75 pro 1 Million Ausgabetoken; ab dem 1. Januar 2027 beträgt der angegebene Tarif $1,50/$7,50.
Ist Gemini 3.7 Flash-frei?
Die Verfügbarkeit für Verbraucher oder Dritte bedeutet nicht, dass ein unbegrenzter, kostenloser API-Zugriff gewährt wird. Informieren Sie sich über die Route, das Kontingent, die Ratenbeschränkungen und die Abrechnungsbedingungen für die von Ihnen geplante Zugriffsmethode.
Was ist das Gemini 3.7 Flash-Kontextfenster?
Die erfasste Zusammenfassung der künstlichen Analyse zeigt eine Auflistung von Kontexten mit einer Länge von 1 Million Token. Informieren Sie sich in der Dokumentation von Google über die genaue offizielle Kontextgrenze sowie über etwaige Preis- oder Funktionsbeschränkungen für lange Kontexte.
Unterstützt Gemini 3.7 Flash Bilder, Audio, Video und PDF-Dateien?
Überprüfen Sie die unterstützten Eingabetypen für die jeweilige API-Modell-ID. Bei der Überprüfung wird jede unterstützte Modalität als dokumentierte Funktion betrachtet, nicht jedoch als Nachweis für eine einheitliche Qualität bei allen Eingabetypen.
Was sind die Gemini 3.7-Flash-Denkebenen?
Gemini 3.7 Flash verfügt über konfigurierbare Steuerungsfunktionen. Die genauen Werte, Standardwerte, das Verhalten der Token sowie die Auswirkungen auf die Abrechnung entnehmen Sie bitte der offiziellen API-Dokumentation.
Ist Gemini 3.7 Flash besser als Gemini 3.6 Flash?
In diesem API-Vergleichstest gewann Gemini 3.7 Flash drei abgeschlossene Aufgaben, Gemini 3.6 Flash zwei; bei einer gab es ein Unentschieden und bei einer war das Ergebnis nicht eindeutig. Dies spricht für einen knappen Vorteil von 3.7, nicht jedoch für einen durchgängigen Sieg.
Ist Gemini 3.7 Flash besser als Gemini 3.1 Pro?
Dieser Entwurf erhebt diesen Anspruch nicht. Gemini 3.1 Pro ist eine andere Vergleichsbasis, daher erfordert es einen eigenen, darauf abgestimmten Prompt-Satz und eigene Belege, anstatt einer Schlussfolgerung aus dem Gemini 3.6 Flash-Vergleich.
Eignet sich der Gemini 3.7 Flash gut zum Programmieren?
Ja, bei der hier getesteten, eng gefassten Aufgabe zur Fehlerbehebung. Beide Modelle erzeugten den korrekten minimalen Patch, doch Gemini 3.7 Flash konnte sich durch eine sauberere Testabdeckung mit weniger Abschluss-Tokens einen leichten Vorsprung sichern.
Kann Gemini 3.7 Flash Tools verwenden und Agent-Workflows ausführen?
Die genaue Vorgehensweise entnehmen Sie bitte der offiziellen Dokumentation zu den Werkzeugen und Funktionsaufrufen. Der in diesem Test durchgeführte agentische Test bewertet die Planungs- und Grenzerkennungsfähigkeiten; er erhebt keinen Anspruch darauf, dass ein Plan allein bereits eine erfolgreiche Ausführung des Werkzeugs belegt.
Wo kann ich auf „Gemini 3.7 Flash“ zugreifen?
Nutzen Sie, sofern verfügbar, die offiziellen Zugangspunkte von Google oder probieren Sie die Modellseite GlobalGPT sobald das Modell für Ihr Konto und Ihre Region aktiviert ist.
Stimmen die offiziellen Benchmark-Ergebnisse mit den Ergebnissen in der Praxis überein?
Nicht automatisch. Offizielle Benchmarks und Bewertungen durch Dritte liefern nützliche Hintergrundinformationen, während Tests mit identischen Eingabeaufforderungen zeigen, wie ein Modell mit der jeweils gemessenen Aufgabe umgeht. In dieser Übersicht werden diese Arten von Belegen getrennt behandelt.