DeepSeek V4 Pro ist nun als Serienmodell erhältlich, doch die Entscheidung zwischen den Modellen Pro, Flash und Vision-Exp ist nach den Updates vom August 2026 nicht mehr ganz so einfach. Die drei Modelle tragen zwar denselben Namen, verfolgen jedoch unterschiedliche Schwerpunkte: Zuverlässigkeit unter komplexen Rahmenbedingungen, Kosten und Stückzahlen oder Bildeingabe.
Die praktische Entscheidung hängt in erster Linie vom Arbeitsaufwand ab. „Flash“ ist die sinnvolle Wahl für große Textmengen und budgetorientierte Automatisierung. „Pro“ eignet sich besser, wenn uneinheitliche Ergebnisse zu kostspieligen Nacharbeiten führen. Wenn die Eingabe Bilder enthält, verwenden Sie deepseek-v4-flash-vision-exp anstatt eines der beiden reinen Textmodelle.
Wenn Sie es vorziehen, die Unterstützung bei Recherche, Schreiben, Argumentation und Programmierung in einem einzigen Arbeitsablauf zu bündeln, können Sie auf GlobalGPT. Außerdem gibt es eine eigene Route für DeepSeek V4 Pro. Hierbei handelt es sich um eine alternative Schnittstelle; die offizielle API-Abrechnung, die Limits und die Integrationen bleiben weiterhin Teil der eigenen Umgebung von DeepSeek.

Ist DeepSeek V4 offiziell veröffentlicht worden?
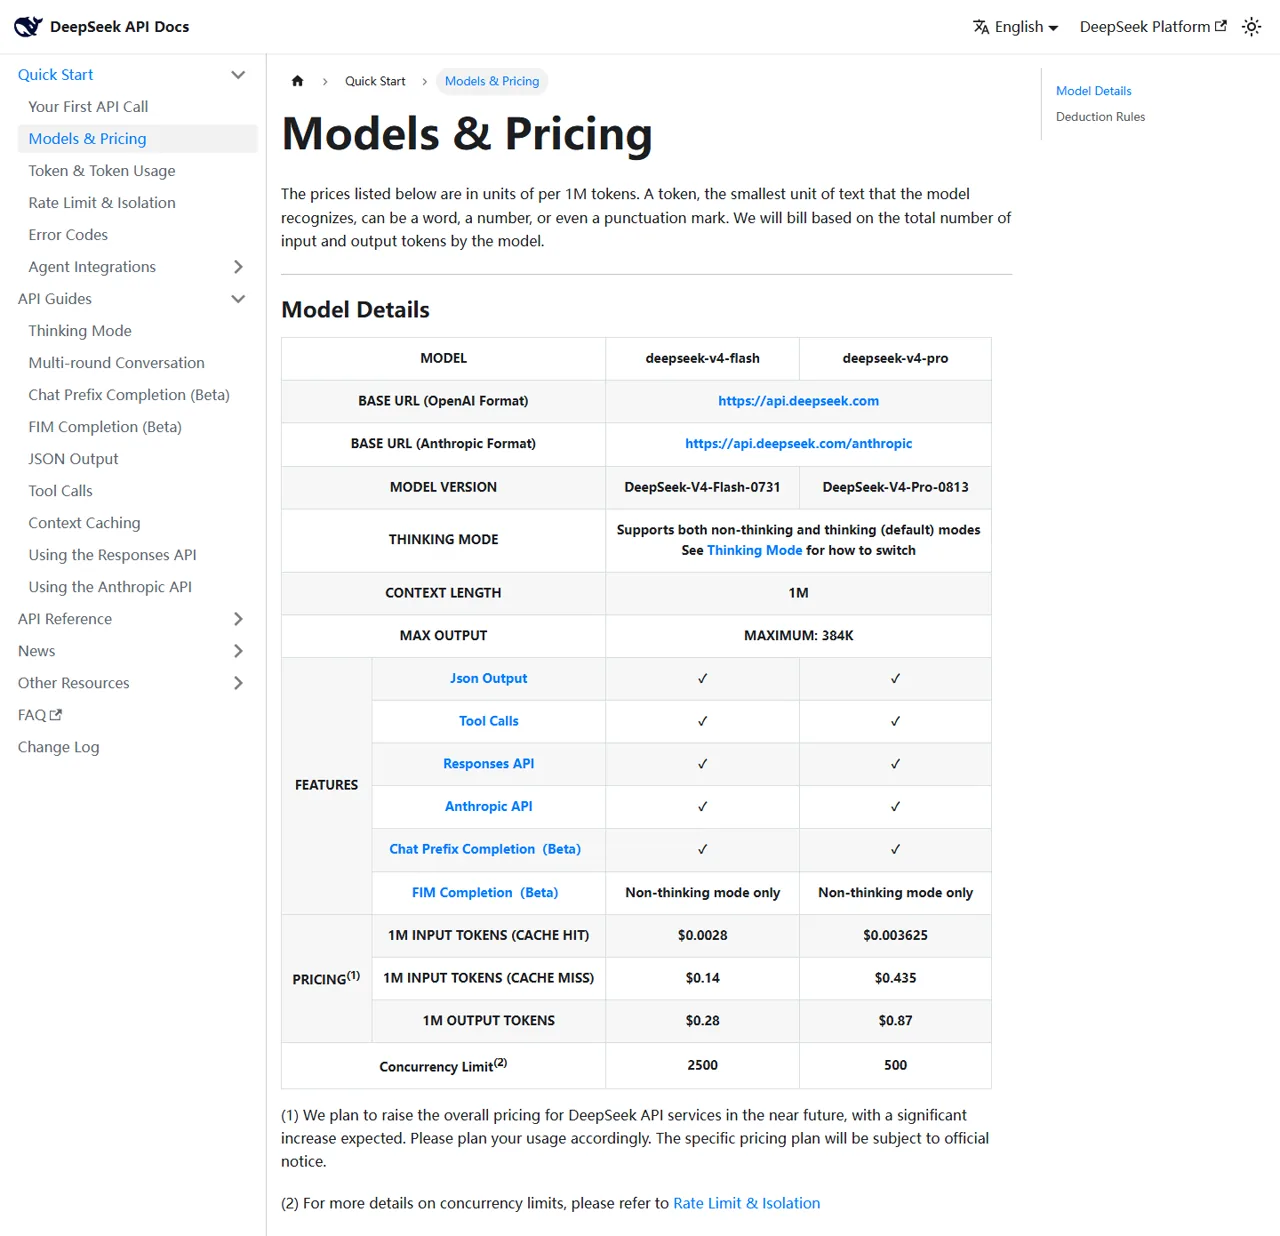
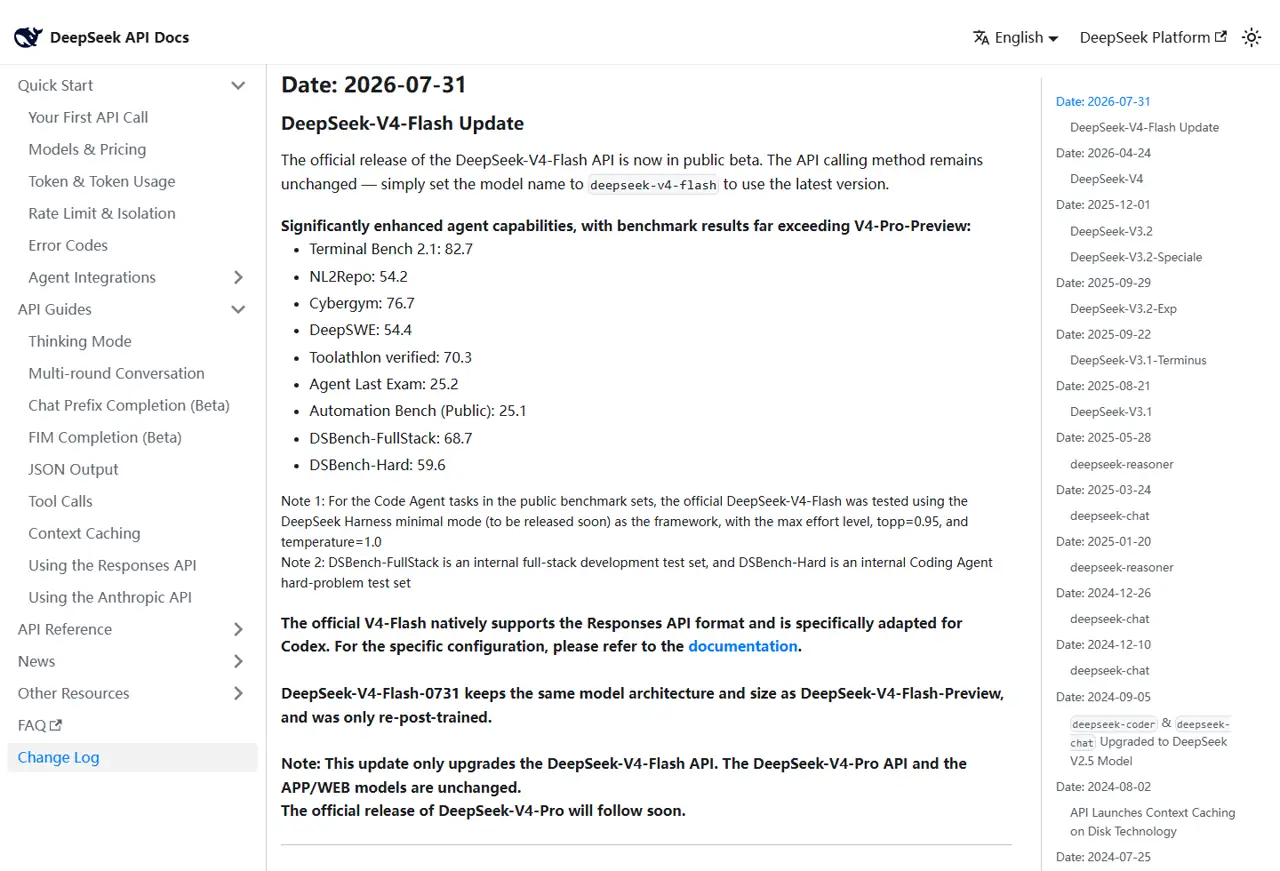
Ja. DeepSeek hat am 13. August 2026 die allgemeine Verfügbarkeit von V4 Pro bekannt gegeben. In der offiziellen Dokumentation wird das Serienmodell als DeepSeek-V4-Pro-0813. V4 Flash erscheint als DeepSeek-V4-Flash-0731, während das experimentelle Sehmodell am 21. August unter dem Namen deepseek-v4-flash-vision-exp.
- V4 Pro: ein Textmodell, das für anspruchsvollere Aufgaben konzipiert ist.
- V4 Flash: ein hinsichtlich Kosten und Umfang optimiertes Textmodell.
- V4 Flash Vision-Exp: eine experimentelle Variante, die Bilder akzeptiert.
Allgemeine Verfügbarkeit bedeutet nicht, dass jedes Produkt oder jeder Anbieter dieselbe Schnittstelle, dieselbe Kontingentierung oder dieselbe Integration bietet. Bei Entscheidungen bezüglich APIs beziehen Sie sich bitte auf die offizielle Modelle & Preise Seite und die GA-Versionshinweise.
DeepSeek V4 Pro
Version: Pro-0813
Am besten geeignet für: aufwändigere Programmierung, Agenten, Schlussfolgerungen und Ergebnisse mit zahlreichen Einschränkungen.
DeepSeek V4 Flash
Version: Flash-0731
Am besten geeignet für: Hochdurchsatz-Produktion, routinemäßige Kodierung, Datenabruf und kostenorientierte Arbeitsabläufe.
Die Bezeichnungen können verwirrend sein, da im technischen Bericht zu V4 Preview-Varianten beschrieben werden, während die Live-API veraltete Produktionsversionen verwendet. In diesem Testbericht steht “Pro” für Pro-0813 und “Flash” für Flash-0731, sofern in einem Satz nicht ausdrücklich “V4 Preview” angegeben ist.”
Was hat sich in DeepSeek V4 Pro geändert?
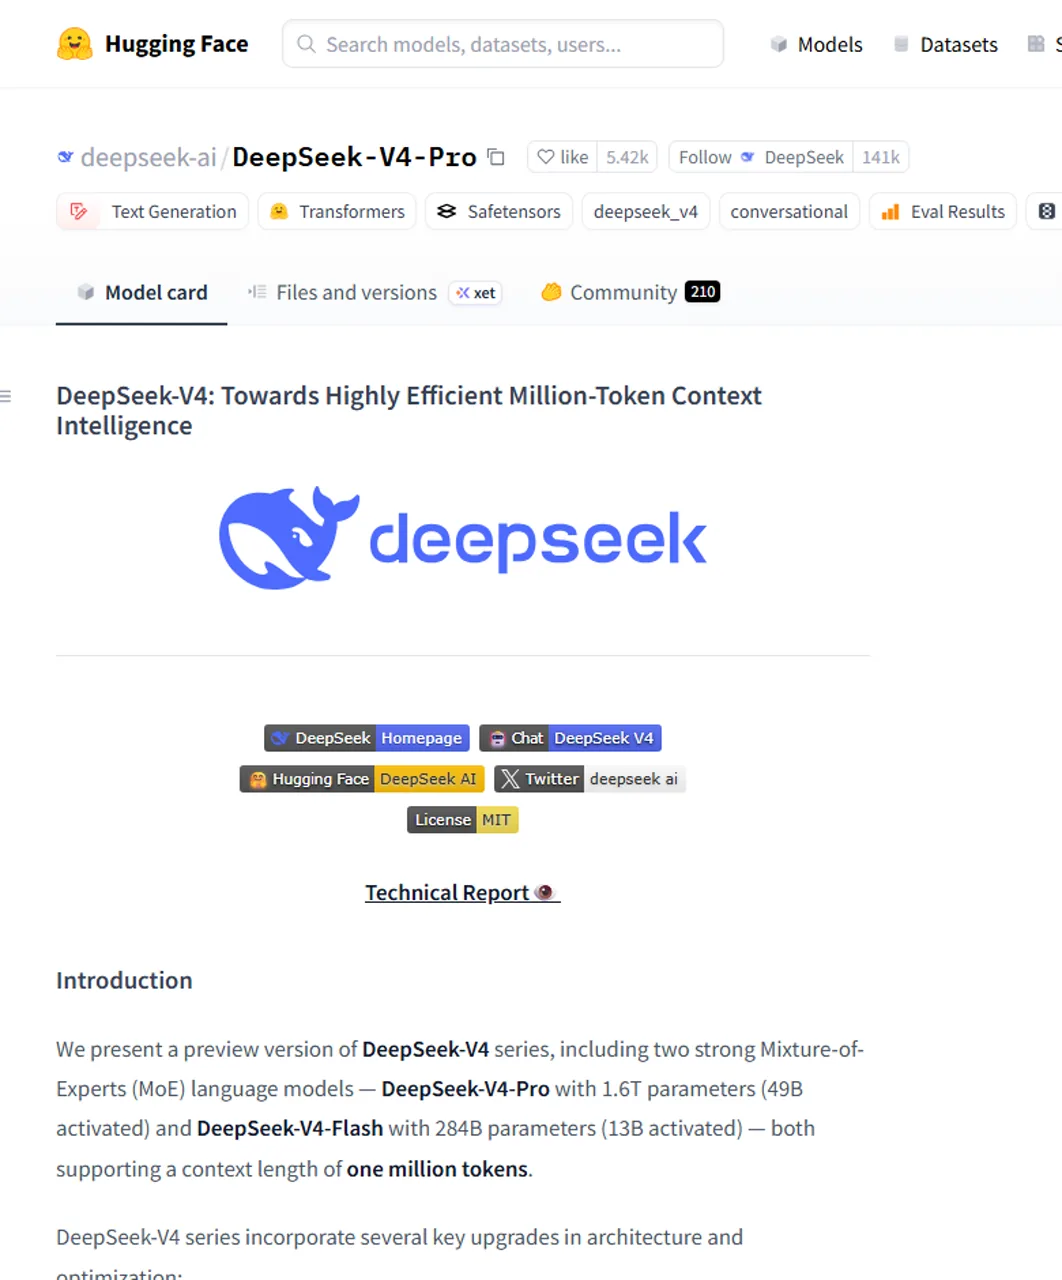
Die deutlichsten Veränderungen betreffen die Skalierbarkeit, die Kontextkapazität, agentenorientierte Schnittstellen und eine zweistufige Produktstrategie. DeepSeek’s Offizielle Pro-Modell-Karte beschreibt ein „Mixture-of-Experts“-Modell mit insgesamt 1,6 Billionen Parametern und 49 Milliarden aktiven Parametern, das unter der MIT-Lizenz veröffentlicht wurde. Die begleitenden V4-Unterlagen beschreiben neue Ansätze im Bereich Attention und Routing, die darauf abzielen, die Verarbeitung von Millionen von Tokens praktikabel zu machen.
- Zwei aktuelle Stufen: Pro für qualitätsorientierte Arbeiten und Flash für Durchsatz und Kosten.
- Ein deutlich größeres Arbeitsgedächtnis: ein aufgeführtes Kontextfenster mit 1 Million Token für beide Modelle.
- Hohe Obergrenze für die Stromerzeugung: bis zu 384K Ausgabe-Token gemäß der offiziellen Spezifikation.
- Agentenschnittstellen: Tool-Aufrufe, JSON-Ausgabe, Responses-API und Anthropic-kompatibler Zugriff.
- Offene Gewichtsklassen: Offizielle V4-Modellkarten und -Dateien sind verfügbar, doch eine umfassende lokale Implementierung stellt nach wie vor ein großes Infrastrukturprojekt dar.
Diese Kombination macht V4 für die Programmierung im Repository-Maßstab, umfangreiche Forschungspakete und mehrstufige Agentenverläufe relevant. Außerdem verändert sie den Wettbewerbsrahmen: Eine aussagekräftige Bewertung muss nun über die Chat-Qualität hinausgehen und untersuchen, wie sich das Modell im Einsatz mit Tools, bei strengen Formaten und bei langen Eingaben verhält. Unsere Vergleich zwischen DeepSeek und ChatGPT gibt weitere Einblicke darin, worin sich diese Ökosysteme unterscheiden.
DeepSeek V4 Pro vs. Flash: Der praktische Unterschied
Beide Versionen bieten denselben Kontext für Überschriften und dieselben Ausgabebeschränkungen, es handelt sich also nicht um eine Entscheidung zwischen einem “Vollmodell” und einem „Modell mit kurzem Kontext“. Es ist in erster Linie eine Entscheidung hinsichtlich Qualität, Preis und Kapazitätsplanung. Die offizielle Obergrenze für die gleichzeitige Nutzung bei Flash ist fünfmal so hoch wie bei Pro, während die Eingabe- und Ausgabetoken bei Cache-Fehlern bei Pro etwas mehr als dreimal so viel kosten.
Pro vs. Flash auf einen Blick
Die offiziellen technischen Daten und Preise wurden am 13. August 2026 überprüft; die praktischen Beobachtungen basieren auf jeweils einem Durchlauf pro Aufgabe und stellen keine offiziellen Benchmark-Ergebnisse dar.
Wählen Sie „Flash“, wenn…
Sie benötigen kostengünstige Skalierbarkeit, routinemäßige Code-Korrekturen, Extraktion, Klassifizierung oder viele parallele Anfragen – und Sie können arithmetische Berechnungen mit hohem Risiko sowie Formatvorgaben überprüfen.
Entscheiden Sie sich für „Pro“, wenn…
Das Ergebnis umfasst Code, Richtlinien, Finanzen oder zahlreiche genaue Vorgaben, und die zusätzlichen Kosten sind geringer als die Kosten eines kleinen Fehlers.
Praktische Tests: Kodierung, Abruf und Einhaltung von Einschränkungen
Wir haben beide API-Modell-IDs am 13. August 2026 über denselben Broly Anywhere OpenAI-kompatiblen Endpunkt getestet. Die Temperatur betrug 0. Jedes ausgewertete Ergebnis entspricht einem Durchlauf pro Modell und Aufgabe. Die Istzeit umfasst Gateway- und Upstream-Verzögerungen und dient daher als Anhaltspunkt – nicht als verlässliches Latenz-Ranking.
Praktische Bewertungsvorlage
Sowohl Pro als auch Flash haben alle festgelegten Tests bestanden.
Sowohl die Antworten als auch alle erforderlichen Verweise auf Urteile waren korrekt.
Pro hat alle Regeln erfüllt; Flash hat die Anforderungen hinsichtlich Arithmetik und Länge nicht erfüllt.
Test 1: Agentesches Python-Debugging
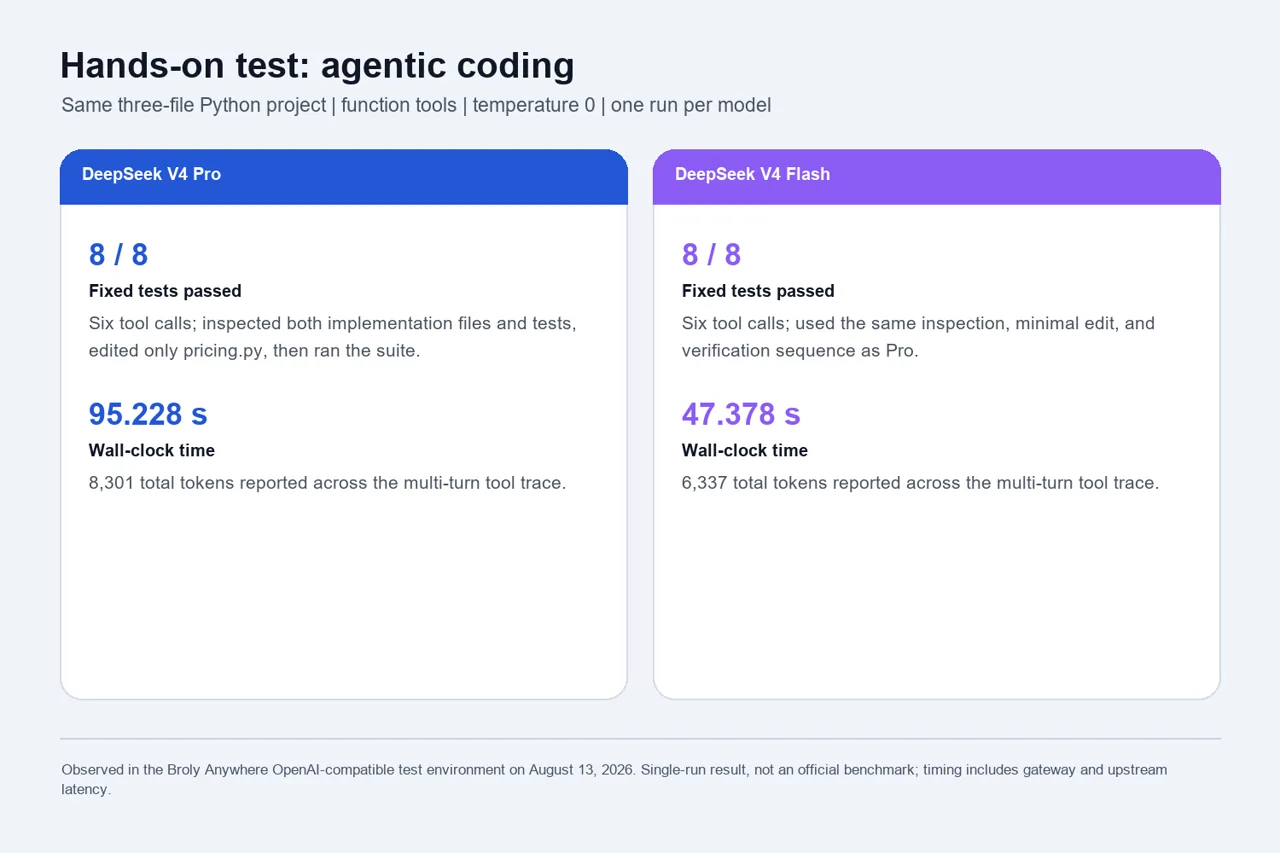
Das Toolkit stellte jedem Modell vier Werkzeuge zur Verfügung – Listen-Dateien, „Datei lesen“, „Datei schreiben“ und „Tests ausführen“ – innerhalb eines kleinen Python-Projekts zur Preisberechnung, das aus drei Dateien bestand. Dies kommt einem Agenten-Workflow näher, als im Chat nach einem Code-Schnipsel zu fragen.
Ein Python-Projekt zur Preisberechnung debuggen, korrigieren und überprüfen
Beide Modelle folgten demselben Pfad mit sechs Aufrufen, unterschieden sich lediglich in der Umsetzung und erzeugten 8 bestanden. Flash absolvierte diesen Durchlauf in 47,378 Sekunden gegenüber Pros 95,228 Sekunden und verbrauchte dabei weniger zurückgegebene Token. Hier gab es keinen Sieger in Bezug auf die Qualität. Eine weitere, auf den Code ausgerichtete Perspektive finden Sie in unserem DeepSeek vs. ChatGPT – Python-Programmiertest.
Test 2: Abruf eines Dossiers mit etwa 20,7K Token
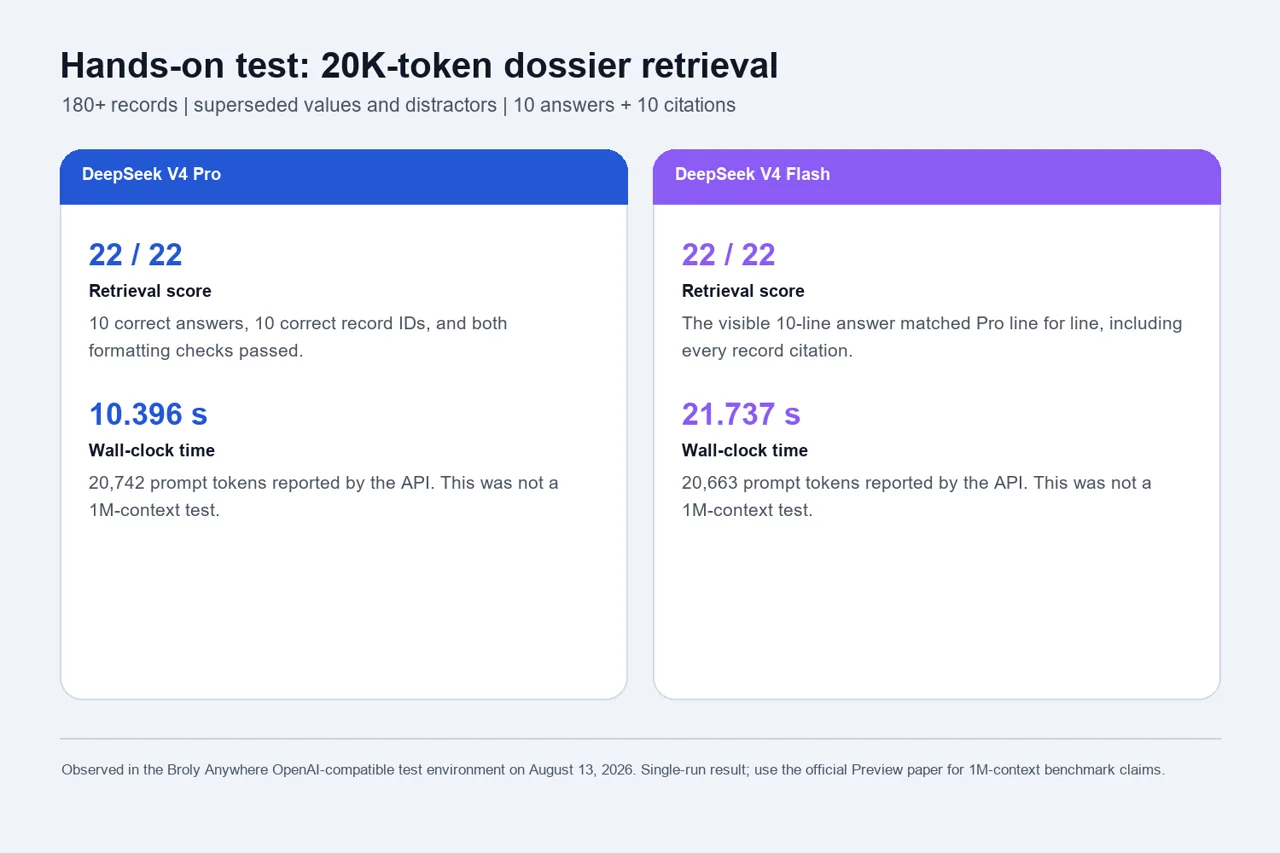
Wir haben ein Dossier beigefügt, das mehr als 180 Datensätze, wiederkehrende Ablenkungselemente, veraltete Entwürfe und zehn vereinzelte Fakten enthielt. Das Modell musste in einem exakten Zehn-Zeilen-Format antworten und für jede Antwort einen Datensatz angeben.
Beantworten Sie ein umfangreiches Dossier mit genauen Quellenangaben
Beide Modelle erzielten 22 von 22 Punkten: zehn richtige Antworten, zehn korrekte Zitate und zwei Formatpunkte. Pro absolvierte diesen Durchlauf in 10,396 Sekunden und Flash in 21,737 Sekunden. Die tatsächliche Prompt-Länge betrug etwa 20,7K Token. Damit handelt es sich um einen nützlichen Abruftest mittlerer Länge, aber es nicht das gesamte Fenster mit 1 Million Token validieren.
Test 3: Ein strenges Memo zur Startentscheidung
Diese Aufgabe umfasste eine Zusammenfassung von 120 bis 180 Wörtern, eine Tabelle mit genau vier Zeilen, festgelegte Risiken und unbekannte Zahlen, eine kurze Entscheidung, gültiges JSON sowie eine Kostenkalkulation für das erste Jahr auf der Grundlage von Angaben aus den Bereichen Finanzen, Recht, Technik, Vertrieb, Support und Sicherheit.
Erstellen Sie ein Startmemo mit Berechnungen und strengen Ausgaberegeln
Bei einem Limit von 2.048 Completion-Token nutzten beide Modelle das verfügbare Completion-Budget für die zurückgegebenen Schlussfolgerungen auf und lieferten keine sichtbare Antwort. Wir haben diese Datensätze gespeichert und anschließend die unveränderte Eingabeaufforderung mit einem Limit von 8.192 Token erneut ausgeführt. „Pro“ erzielte 12 von 12 Punkten. „Flash“ erzielte 8 von 12 Punkten, da es $217.100 anstelle von $216.900 meldete, den Fehler $200 in die Varianz übernahm und eine Zusammenfassung mit 94 Wörtern anstelle der geforderten 120–180 Wörter verfasste.
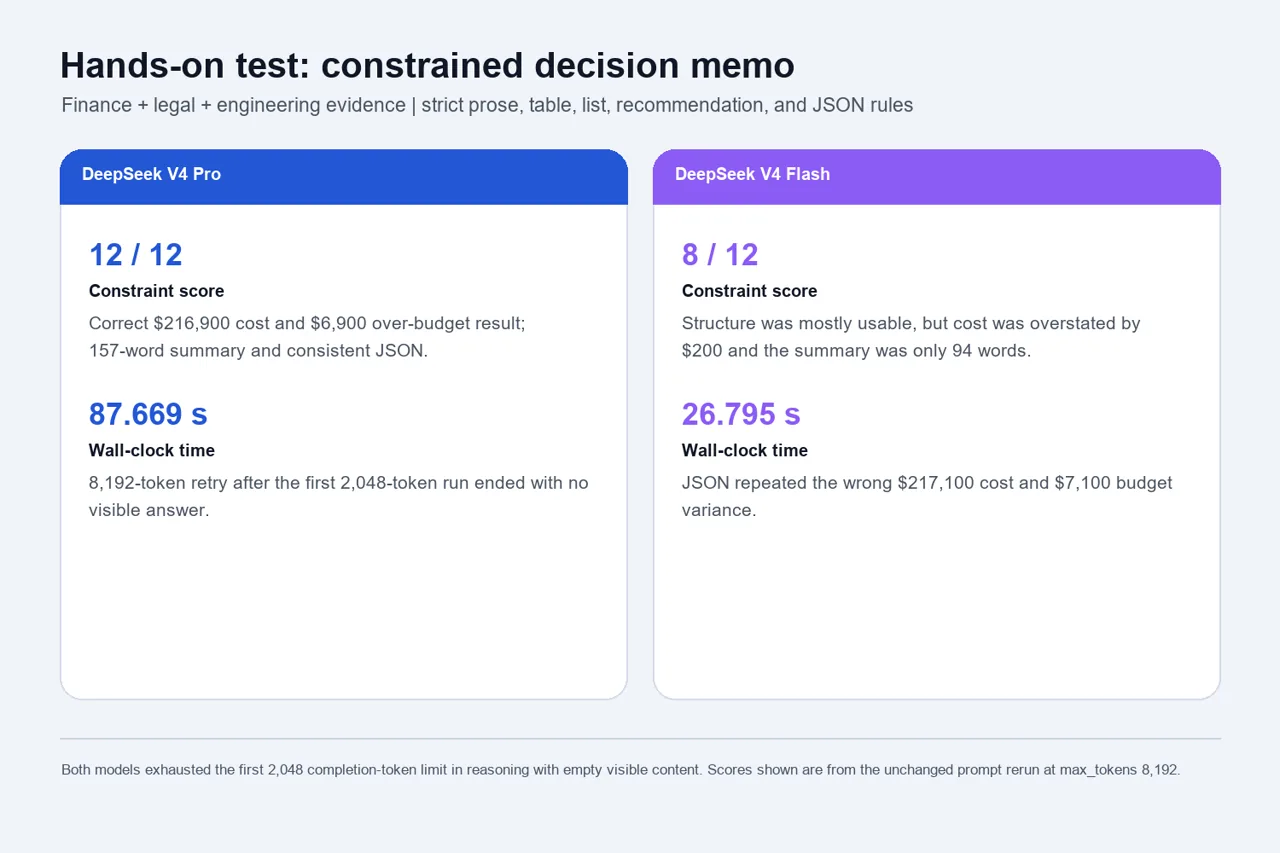
Die Erkenntnis ist spezifisch und nicht allgemeingültig: Flash schnitt bei den Programmier- und Abrufaufgaben bereits hervorragend ab, während Pro bei der komplexesten Kombination aus arithmetischen, strukturellen und richtlinienbezogenen Einschränkungen sicherer war. Wenn Ihr Arbeitsablauf auf einer Agent-Shell basiert, ist unsere Vergleich zwischen OpenClaw und Claude: Code vs. OpenCode trägt dazu bei, das Modell an das umgebende Werkzeug anzupassen.
DeepSeek V4-Benchmarks: Was die offiziellen Daten belegen
Die zuverlässigste Quelle für Benchmarks ist die Technischer Bericht zu DeepSeek V4, doch die darin enthaltenen Tabellen und Diagramme beziehen sich auf V4-Preview-Modelle. Sie sind hilfreich, um die beabsichtigte Leistungsfähigkeit der Architektur und den Testaufbau zu verstehen; es handelt sich dabei nicht um eigenständige Bewertungsergebnisse für die veraltete Pro-0813-API-Version.
Vorschau-Ergebnisse sind keine Pro-0813-Ergebnisse
Architektur und Benchmark-Ergebnisse von DeepSeek.
In den API-Dokumenten aufgeführte veraltete Produktionsversionen.
Vorschau-Partituren können nicht als „Pro-0813“-Partituren umbenannt werden.
Das Flash-Update vom 31. Juli veröffentlicht zudem die Ergebnisse der Agenten und nennt den Testrahmen, die Einstellungen sowie die Codex-Unterstützung. Diese Details sind wichtig, da sich herstellerübergreifende Ranglisten je nach Testrahmen, Reasoning-Budget, Tool-Definitionen und Wiederholungsregeln ändern können. Ein Ergebnis ohne Angabe des Testrahmens reicht nicht aus, um einen bedingungslosen Sieger zu ermitteln.
Aus demselben Grund ergänzen unsere drei Aufgaben die offiziellen Nachweise, anstatt sie zu ersetzen. Sie geben Aufschluss darüber, was unter einer bestimmten, offengelegten Konfiguration geschehen ist. Wenn Sie nicht nur Modell-APIs, sondern auch Agent-Produkte miteinander vergleichen, dann ist unser Codex vs. Claude – Leitfaden zu den Codes erklärt, warum der umgebende Arbeitsablauf die Benutzererfahrung beeinflussen kann.
Preise für die DeepSeek V4-API
Die Preisgestaltung für die API von DeepSeek ist zum Start ungewöhnlich aggressiv. Die folgende Tabelle gibt die offiziellen Zahlen pro Million Token wieder, die am 13. August 2026 überprüft wurden. Auf der offiziellen Seite wird zudem darauf hingewiesen, dass die Preise in Zukunft deutlich steigen werden; betrachten Sie diese Zahlen daher als veraltete Angaben aus der Startphase.
Preis pro 1 Mio. Token
Eine einfache, nicht zwischengespeicherte Arbeitslast mit 10 Millionen Eingabetoken und 2 Millionen Ausgabetoken würde bei diesen Tarifen auf Flash $1,96 und auf Pro $6,09 betragen. Diese Darstellung berücksichtigt keine Cache-Treffer, Anbieter-Aufschläge, Wiederholungsversuche und spätere Preisänderungen. Teams, die Anbieter vergleichen, sollten eine einheitliche Token-Zusammensetzung und Abrechnungsgrundlage verwenden; unsere Claude Opus 4.6 – API-Preisliste zeigt, warum für Eingabe, Ausgabe und Zwischenspeicherung separate Zeilen erforderlich sind.
Was das 1-M-Kontextfenster bedeutet – und wo die Grenzen liegen
Ein Kontextfenster von 1 Million Token ist eine Kapazitätsangabe und kein Versprechen für eine perfekte Wiederauffindbarkeit an jeder Position. Es bietet der API Spielraum für sehr große Repositorien, Dokumentensammlungen, Forschungspakete oder Agentenhistorien. Die Frage nach der Qualität lautet, ob das Modell die richtigen Details abrufen kann, wenn relevante Informationen unter Hunderttausenden von ablenkenden Token verborgen sind.
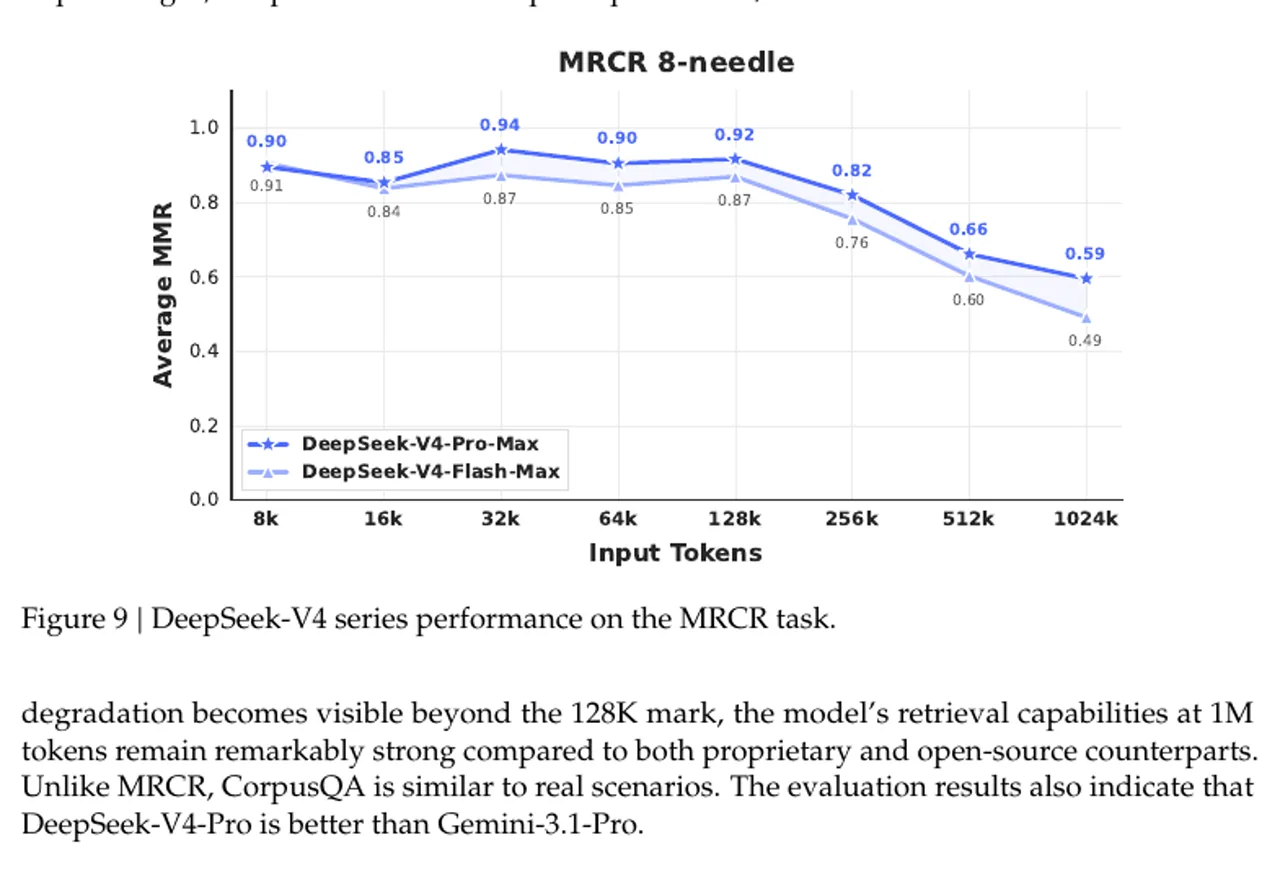
Der Vorschau-Bericht von DeepSeek enthält ein Diagramm zur mehrrundigen Koreferenzauflösung (MRCR) für Eingabetoken von 8K bis 1M. Die Kurve bleibt bei kürzeren Längen stark, fällt jedoch ab 128K ab. Dies ist ein typisches Anzeichen für ein schwerwiegendes Problem mit langen Kontexten, und deshalb sollte “unterstützt 1M” niemals mit “verlustfrei bei 1M” übersetzt werden.”
Für die API-Oberfläche gelten gesonderte Einschränkungen. DeepSeek’s Leitfaden zur Responses-API beschreibt eine zustandslose Implementierung: Funktionen wie ID der vorherigen Antwort, „Conversations“, „Store“ und „Background“ werden nicht unterstützt. Auch die Eingabe von Bildern und Dateien wird nicht unterstützt, sodass Sie Text extrahieren oder die Zustandsschicht außerhalb des Modells erstellen müssen.
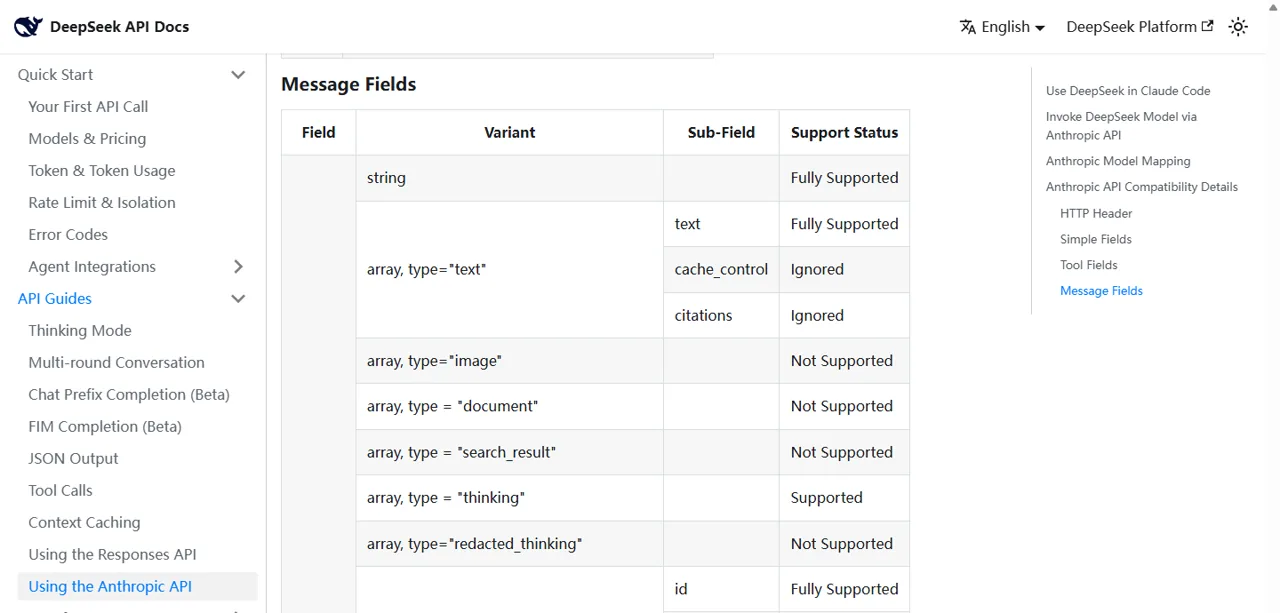
Die Anthropic-kompatible API-Tabelle Ebenso werden Varianten von Bild- und Dokumentnachrichten als nicht unterstützt gekennzeichnet. Kompatibilität bedeutet daher vertraute Anforderungsformate und Werkzeuge – nicht jedoch eine vollständige Funktionsübereinstimmung mit jedem Anthropic-Modell oder -Client.
So testen Sie DeepSeek V4 Pro und Flash
Ihnen stehen drei praktische Möglichkeiten zur Auswahl. Entscheiden Sie sich je nachdem, ob Sie eine kurze Beratung, die Steuerung der Produktions-API oder einen Arbeitsbereich für mehrere Modelle wünschen.
Wählen Sie Ihren Zugriffspfad
DeepSeek Web/App
Ideal, um das Modell über die eigene Benutzeroberfläche von DeepSeek auszuprobieren.
Offizielle API
Ideal für Token-Abrechnung, Tools, JSON, Agent-Frameworks und Produktionssteuerung.
GlobalGPT
Ideal, um Pro oder Flash in einer umfassenderen, modellübergreifenden Arbeitsumgebung zu öffnen, ohne zuvor einen Client erstellen zu müssen.
Route 1: Offizieller DeepSeek-Chat
Beginnen Sie bei Die offizielle Website von DeepSeek Wenn Sie sich lediglich einen Überblick über das aktuelle Nutzererlebnis verschaffen möchten. Der Nutzerzugang und die API-Abrechnung sind voneinander getrennt; die Verfügbarkeit einer Chat-Schnittstelle bedeutet nicht, dass die API kostenlos ist.
Möglichkeit 2: Offizielle API und Programmier-Tools
Verwenden Sie deepseek-v4-pro oder deepseek-v4-flash mit den dokumentierten OpenAI-kompatiblen Schnittstellen. Beide unterstützen den „Thinking“- und den „Non-Thinking“-Modus, JSON-Ausgabe, Tool-Aufrufe, die Responses-API sowie Anthropic-kompatiblen Zugriff. FIM gilt nur im „Non-Thinking“-Modus.
DeepSeek veröffentlicht außerdem einen Offizieller Leitfaden zur Codex-Integration. Wenn Sie sich zunächst zwischen verschiedenen Agent-Shells entscheiden müssen, vergleichen Sie Claude – Preisgestaltung und Nutzungsbeschränkungen bevor man davon ausgeht, dass die Modellkosten den gesamten Rechnungsbetrag ausmachen.
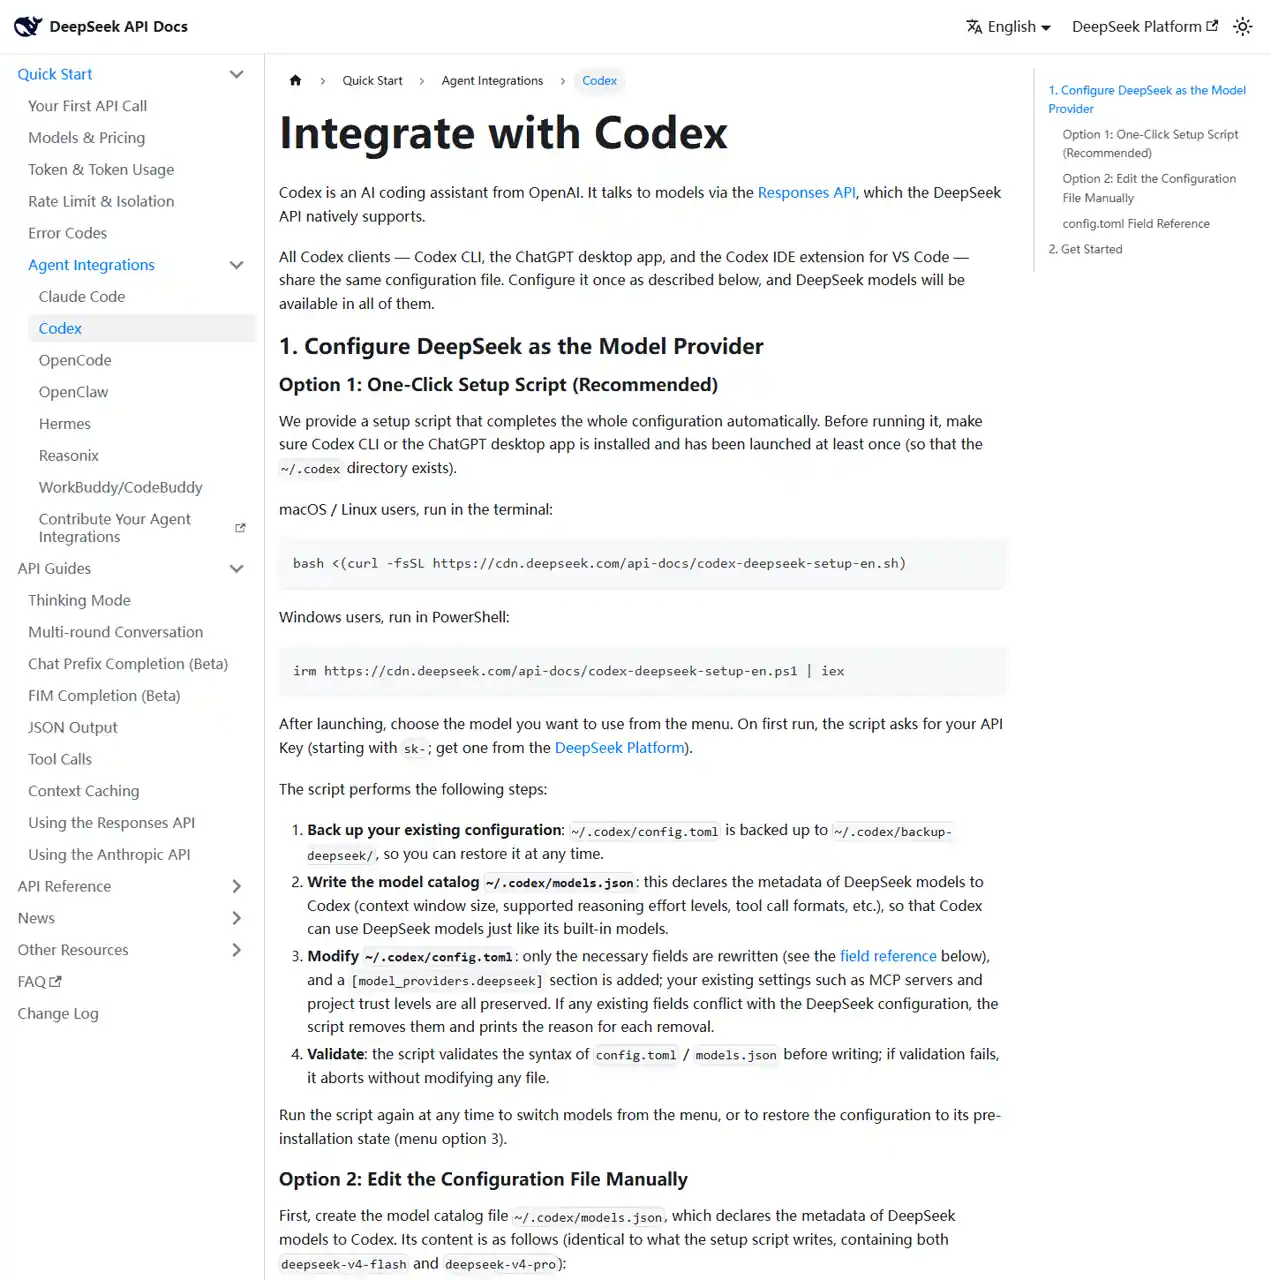
Benutzer des Codes „Claude“ können sich an dieselbe Endpunkt- und Modelllogik halten, die in unserem Leitfaden zu Konfiguration eines Modells im Claude-Code, während die Live-Kompatibilitätstabelle von DeepSeek auf nicht unterstützte Felder überprüft wird.
Route 3: GlobalGPT
GlobalGPT enthält eigene Einträge für beide Modelle. Der geprüfte Umrechnungsweg lautet DeepSeek V4 Pro auf GlobalGPT. Es gibt zwar auch eine Flash-Produktseite, aber da wir keinen verifizierten, Flash-spezifischen Kampagnenparameter gefunden haben, werden wir auch keinen erfinden.
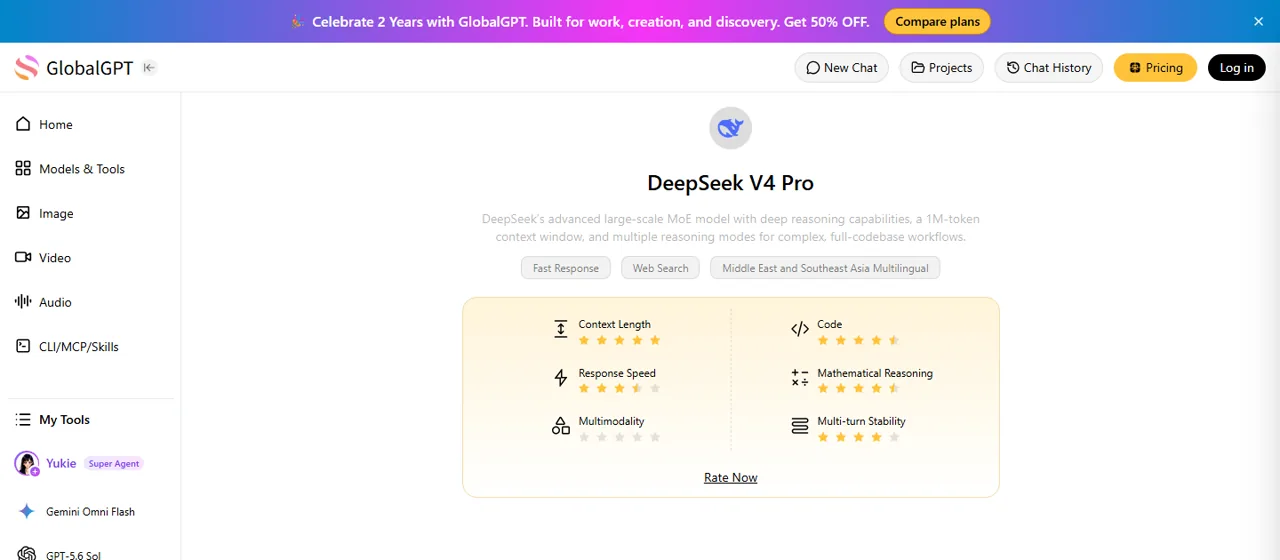
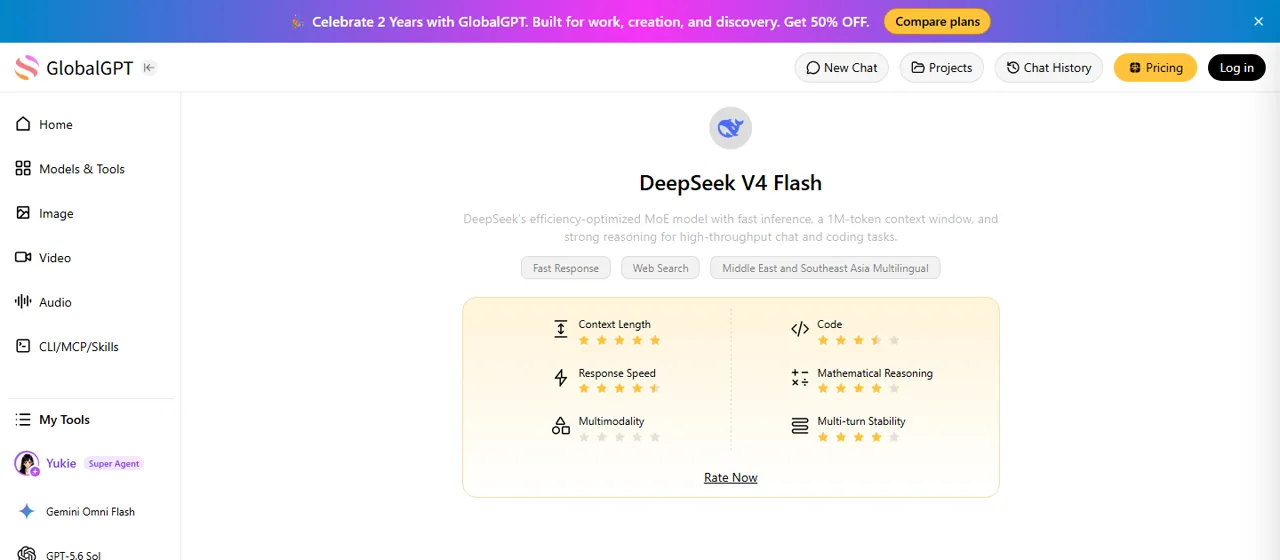
Für Terminal-Workflows gilt, dass die GlobalGPT-CLI in der Claude-Code-Konfiguration erläutert, wie sich eine Multi-Modell-Plattform in eine bestehende Programmierroutine integrieren lässt. Sie ersetzt keine nativen Repository-Tools, sondern verändert die Art und Weise, wie Sie auf Modelle zugreifen und diese vergleichen.
Für welches DeepSeek-V4-Modell sollten Sie sich entscheiden?
Passen Sie das Modell an die Ausfallkosten an
Blitzlicht
Entscheiden Sie sich dafür bei Chats mit hohem Datenaufkommen, bei der Datenextraktion, bei Routinecode, beim Abruf von Daten und bei Agenten mit strenger Validierung. Es hat zwei unserer drei Aufgaben zum niedrigsten offiziellen Preis einwandfrei gemeistert.
Pro
Entscheiden Sie sich dafür, wenn strenge arithmetische Anforderungen, Formatierung, Richtlinien und domänenübergreifendes Denken in einem einzigen Ergebnis zusammenkommen. Es war das einzige Modell, das bei unserem Memo 12 von 12 Punkten erzielte.
GlobalGPT
Wählen Sie den Plattformweg, wenn Sie das Modell ausprobieren oder Alternativen vergleichen möchten, ohne zuvor einen API-Client zu schreiben.
Für viele Teams ist Flash die sinnvollste erste Implementierung: Es ist deutlich kostengünstiger, unterstützt dieselben festgelegten Kontext- und Ausgabebeschränkungen und hat unsere Codierungs- und 20,7K-Abruftests ohne Qualitätseinbußen bestanden. Fügen Sie deterministische Prüfungen für Zahlen, Schemata und erforderliche Abschnitte hinzu.
Wechseln Sie zu Pro, wenn der Zeitaufwand für die Überprüfung oder die Kosten bei Fehlern die Einsparungen durch Token übersteigen. Der Preisunterschied ist zwar erheblich, aber ebenso groß ist der Mehrwert, wenn ein umfangreiches Compliance- oder Einführungsmemo bereits im ersten Durchgang korrekt erstellt wird. Falls Ihre Auswahlliste noch andere Assistenten enthält, ist die breitere Leitfaden zur Auswahl zwischen DeepSeek und ChatGPT kann dabei helfen, die Modellqualität vom Produkt-Ökosystem zu trennen.
Fazit: Lohnt sich der Kauf des DeepSeek V4 Pro?
DeepSeek V4 Pro ist eine Überlegung wert, wenn bei der Arbeit mehr Kontrolle als Leistung gefragt ist. Es ist nicht die kostengünstigste Standardoption: In der API kostet „Pro“ dreimal so viel wie „Flash“ bei den wichtigsten Cache-Miss-Eingabe- und -Ausgabezeilen, sowohl in Spitzenzeiten als auch außerhalb der Spitzenzeiten. Dieser Aufpreis ist gerechtfertigt, wenn eine falsche Antwort Nacharbeit, Überprüfungsaufwand oder ein operatives Risiko nach sich zieht.
Für Routineaufgaben bietet Flash ein besseres Verhältnis zwischen Kosten und Skalierbarkeit. Für Bilder sollten Sie Vision-Exp verwenden. Wenn es nicht um die Verwaltung von APIs geht, sondern um den Wechsel zwischen Recherche, Schreiben und technischer Unterstützung, kann ein multimodeller Arbeitsbereich praktischer sein, als jeden Dienst einzeln zu konfigurieren.
Nächster Schritt
Öffnen Sie DeepSeek V4 Pro in einem Arbeitsbereich, in dem auch andere Modelle für Recherche, Texterstellung und Unterstützung beim Programmieren zusammengefasst sind.
Testen Sie DeepSeek V4 ProHäufig gestellte Fragen zu DeepSeek V4
Ist DeepSeek V4 Pro bereits erschienen?
Ja. DeepSeek V4 Pro ist seit dem 13. August 2026 allgemein verfügbar und trägt die Produktionskennung DeepSeek-V4-Pro-0813.
Was ist der Unterschied zwischen DeepSeek V4 Pro und Flash?
Flash legt den Schwerpunkt auf Kosten und Parallelität, während Pro für Textaufgaben mit mehr Einschränkungen und höheren Ausfallkosten konzipiert ist. Beide weisen ein Kontextfenster von 1 Million Token und eine maximale Ausgabe von 384.000 Token auf.
Wie viel kostet der DeepSeek V4 Pro?
Pro 1 Million Token betragen die Pro-Preise außerhalb der Spitzenzeiten $0,022 für Eingaben mit Cache-Treffer, $0,66 für Eingaben ohne Cache-Treffer und $1,98 für Ausgaben. Die Preise in Spitzenzeiten betragen $0,044, $1,32 und $3,96.
Zu welchen Zeiten ist die Auslastung der API am höchsten?
Die Spitzenzeiten sind montags bis freitags von 01:00 bis 04:00 Uhr und von 06:00 bis 10:00 Uhr UTC. Zu allen anderen Zeiten gelten die Nebenzeittarife.
Unterstützt DeepSeek V4 Bilder?
deepseek-v4-flash-vision-exp akzeptiert Bilder. Im offiziellen Leitfaden sind JPEG, PNG, GIF und WebP aufgeführt. Die Textmodelle „Pro“ und „Flash“ sollten gesondert behandelt werden.
Garantiert das Kontextfenster mit einer Größe von 1 Million Token ein perfektes Abrufen?
Nein. Das Fenster mit 1 Million Token beschreibt die Kapazität. Das Abrufen hängt weiterhin von der Dokumentstruktur, der Anordnung der Fakten, der Eingabeaufforderung und der Verifizierungsmethode ab.
Kann ich DeepSeek V4 mit Codex verwenden?
Ja. In der offiziellen Dokumentation wird eine Integration über die Responses-API beschrieben, und als Modelloptionen werden Flash, Pro und Vision-Exp aufgeführt.
Wie kann ich DeepSeek V4 Pro ausprobieren, ohne eine API zu konfigurieren?
Sie können eine Schnittstelle nutzen, die das Modell bereitstellt, wie beispielsweise GlobalGPT. Diese Option eignet sich für Chats, Recherchen, das Verfassen von Texten und technische Unterstützung; die Abrechnungsmodalitäten und Funktionen entsprechen jedoch nicht denen der offiziellen API-Konsole.