
Claude Opus 5.5 Testbericht: Preis, Benchmarks und API-Tests unter realen Bedingungen
Claude Opus 5.5 kombiniert ein Kontextfenster von 1 Million Token mit einem API-Preis von $4 bzw. $20 pro Million Token. In diesem Bericht werden die veröffentlichten Angaben von Anthropic, unabhängige Benchmark-Momentaufnahmen und fünf direkte Aufgabenausführungen über die Messages-API voneinander getrennt betrachtet.
Das Messergebnis ist spezifisch. Drei Aufgaben lieferten fehlerfreie, brauchbare Ergebnisse; die Programmieraufgabe lieferte zwar ein brauchbares Ergebnis, stieß jedoch an die Obergrenze von 1.024 Token; der Durchlauf zum Schreiben auf Chinesisch erzeugte auf der getesteten Route unlesbaren Text. Das Beispiel zeigt konkretes Verhalten und Routenbeschränkungen, keine allgemeingültige Erfolgsquote.
Kurze Antwort
- Leistung: Anthropic weist bei den meisten Aufgaben Leistungen auf dem Niveau von Fable 5.1 auf, während Artificial Analysis bei maximaler Anstrengung einen Intelligenzindex von 58 verzeichnete. Die enger gefassten Belege für die Urteilsfähigkeit im METR zeigten keine wesentliche Verbesserung gegenüber Fable 5.1.
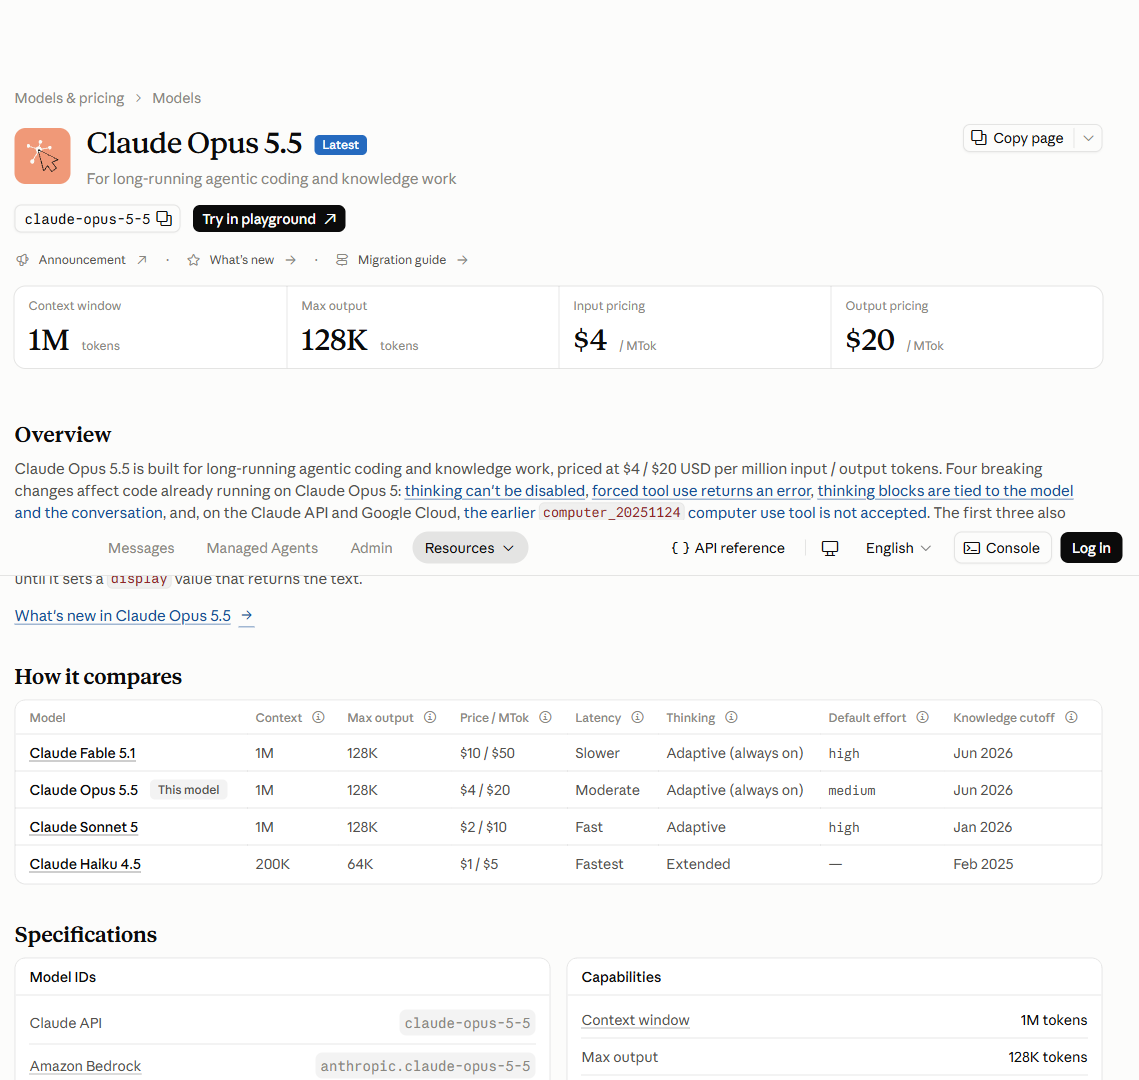
- Preis: Der offizielle API-Kurs beträgt $4 pro Million Eingabe-Token und $20 pro Million Ausgabe-Token. Cache-Lesezugriffe kosten $0,20 pro Million; 5-Minuten-Cache-Schreibzugriffe kosten $5 pro Million.
- Ergebnis aus der Praxis: Die Extraktion von Langtexten, striktes JSON und arithmetisches Schlussfolgern wurden in den aufgezeichneten Durchläufen bestanden. Die Kodierung war nützlich, wurde jedoch an der anfänglichen Obergrenze abgeschnitten. Das chinesische Ergebnis wird als Problem bei der Routenführung bzw. Kodierung vermerkt, nicht als sprachliches Urteil auf Modellebene.
- API-Warnung: Das Denken lässt sich nicht deaktivieren, der erzwungene Einsatz von Werkzeugen führt zu einer Fehlermeldung, Denkblöcke sind an das Modell und den Dialog gebunden, und die ältere
computer_20251124Das Tool wird bei der Claude-API und über Google Cloud nicht akzeptiert.

Was in der offiziellen Dokumentation steht
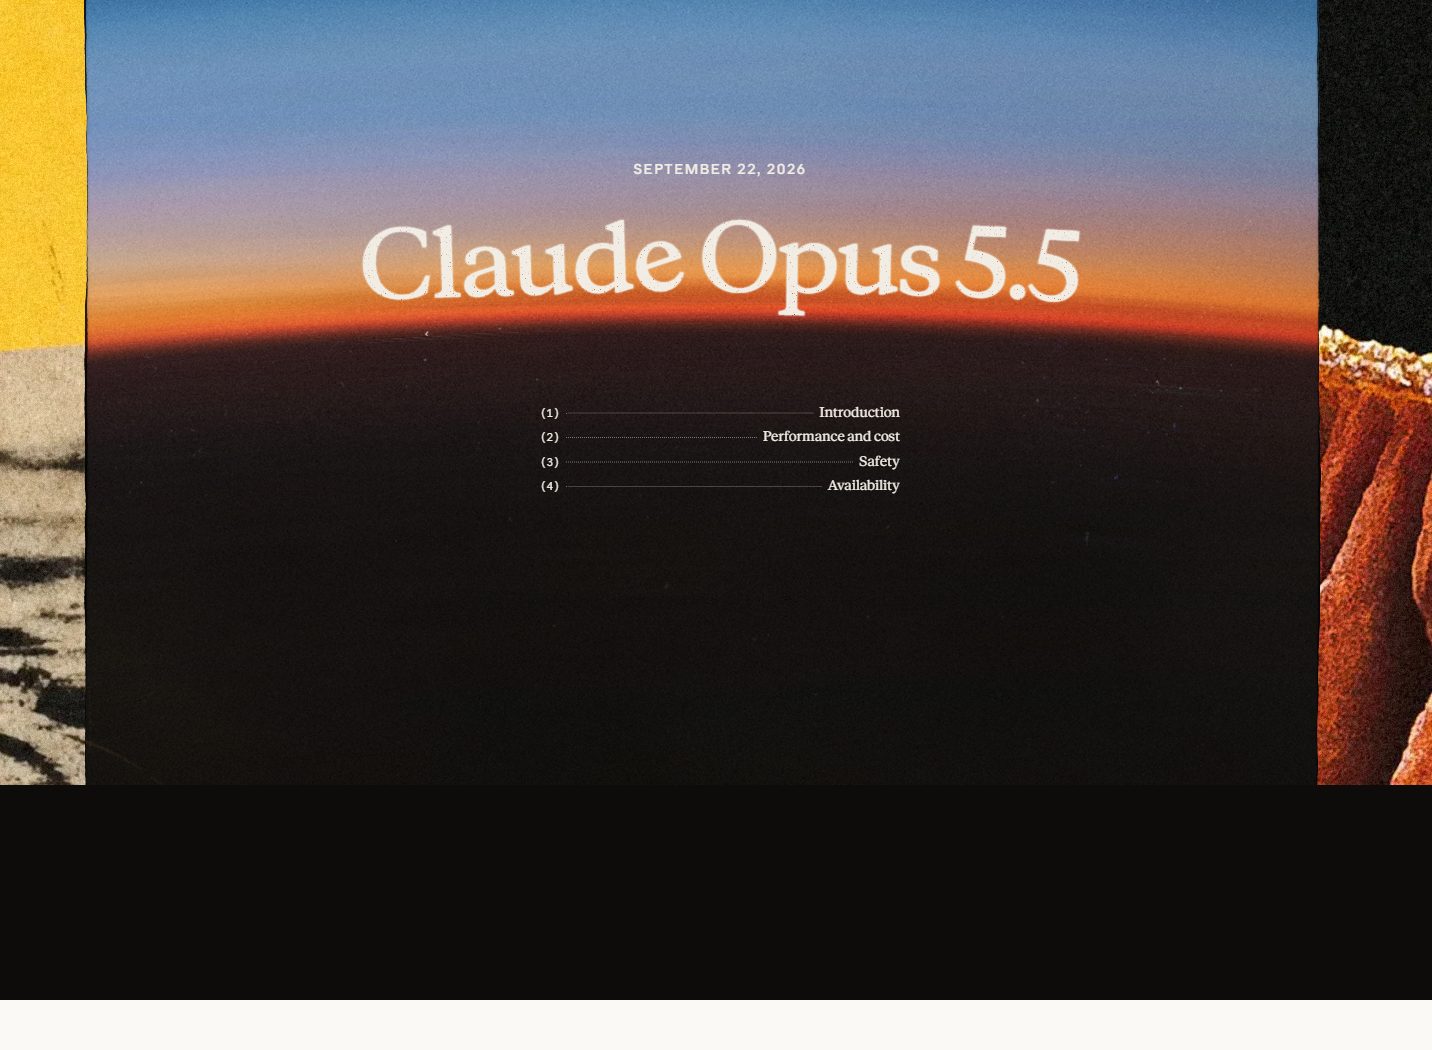
Auf der Produktseite von Anthropic wird Claude Opus 5.5 mit dem Erscheinungsdatum 22. September 2026 angegeben und als erstes Modell der Claude 5.5-Familie beschrieben. In der Ankündigung wird behauptet, dass die Leistung bei den meisten Aufgaben auf dem Niveau von Claude Fable 5.1 liegt, die typischen Arbeitslastkosten um 40% niedriger sind als bei Opus 5 und die Ausgabe um mehr als 30% schneller erfolgt als bei Opus 5. Da es sich hierbei um Angaben des Anbieters handelt, werden sie getrennt von den unten aufgeführten unabhängigen und praktischen Erfahrungswerten dargestellt.
Die Claude-Plattform-Dokumentation Geben Sie die API-Modell-ID wie folgt an: claude-opus-5-5, ein Kontextfenster von 1 Million Token, eine maximale Ausgabe von 128.000 und stets aktiviertes adaptives Denken. In der Dokumentation sind außerdem die Änderungen aufgeführt, die sich auf bestehende Opus-5-Integrationen auswirken; diese werden im folgenden Abschnitt zur Migration behandelt.
Leistungsnachweise
Es gibt hier keine einheitliche “Leistungskennzahl”. Die drei öffentlichen Quellen messen unterschiedliche Aspekte, daher werden für jede Karte die jeweiligen Messgrößen und die Grenzen der Datenbasis deutlich ausgewiesen.
Anthropic-Ankündigung
Veröffentlichtes Signal: Laut Anthropic erreicht Opus 5.5 bei den meisten Aufgaben die Leistung von Claude Fable 5.1, kostet bei typischen Arbeitslasten 40% weniger als Opus 5 und liefert die Ergebnisse um mehr als 30% schneller.
Grenze: Vom Anbieter veröffentlichte Beispiele zur Positionierung und zu Testern, kein unabhängiger Benchmark.
Künstliche Analyse
Veröffentlichtes Signal: Der „Max-Effort“-Snapshot weist 59,61 TP40T bei Terminal-Bench 4.0, 61,41 TP40T bei „Humanity’s Last Exam“ und 66,91 TP40T bei SciCode aus.
Grenze: Die Ergebnisse hängen vom Aufwand, vom Harness, vom Datum und von der Definition der Metrik ab. Sie lassen nicht jede API-Anfrage vorhersagen.
METR-Bewertung vor der Bereitstellung
Veröffentlichtes Signal: METR gibt an, dass seine Ergebnisse bei den untersuchten Beurteilungsfähigkeiten keine wesentliche Verbesserung gegenüber Fable 5.1 zeigten, rechnet jedoch weiterhin mit einer deutlichen Beschleunigung bei bestimmten Forschungs- und Entwicklungsarbeiten.
Grenze: Hierbei handelt es sich um eine gezieltere Bewertung der Urteilsfähigkeit und der Arbeitsgeschwindigkeit, nicht um eine umfassende Qualitätsbewertung.
Insgesamt lassen die Karten nur eine begrenzte Schlussfolgerung zu: Opus 5.5 ist in mehreren älteren öffentlichen Bewertungen das führende Modell, doch der Umfang des Vorsprungs variiert je nach Aufgabe, Aufwandsgrad und Bewertungsdesign. Die Karten liefern kein allgemeingültiges Ergebnis für das “beste Modell”.
Claude Opus 5.5 Preis- und Abrechnungseinheiten
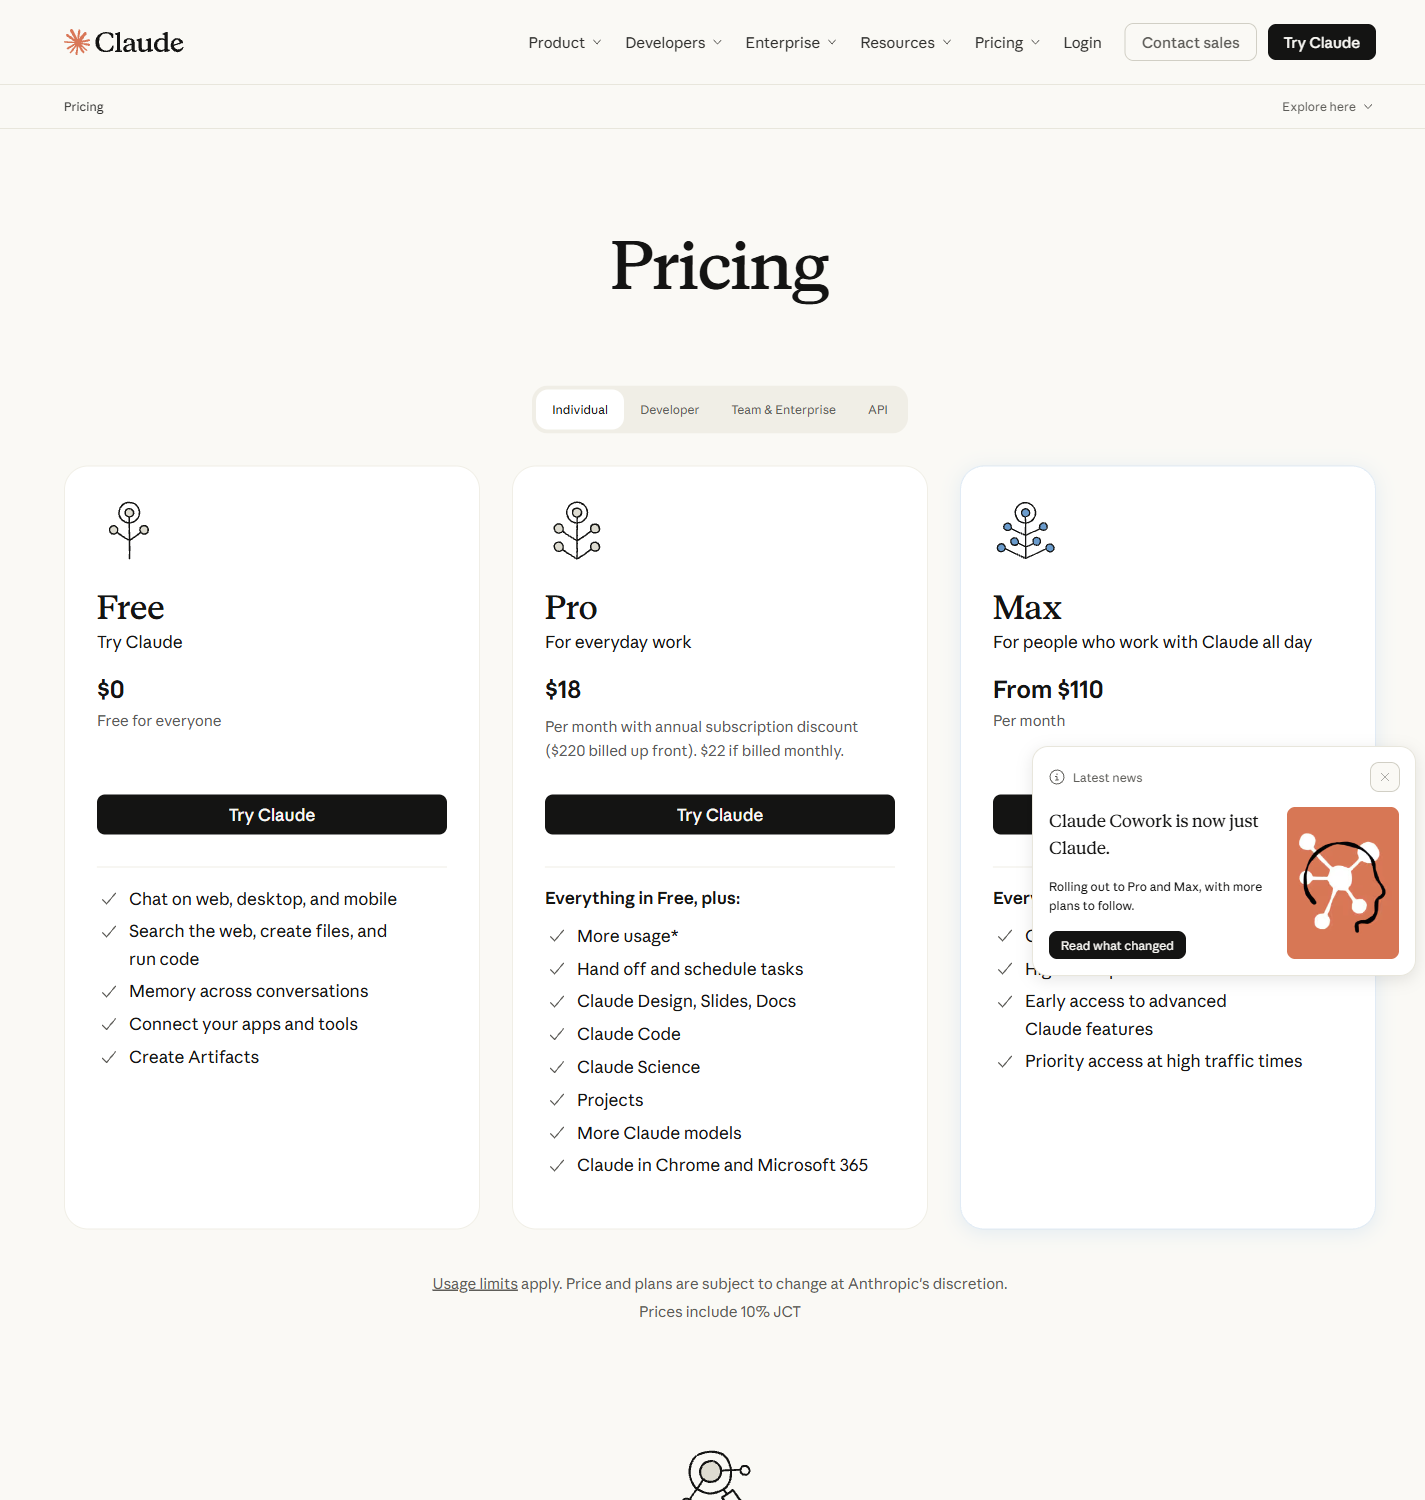
Der API-Preis und der Preis für das Verbraucherabonnement sind unterschiedliche Produkte. Bei den unten aufgeführten API-Zahlen handelt es sich um die Stückpreise, die für die Token-Budgetierung verwendet werden; bei den Verbraucherzahlen handelt es sich um die Tarifübersichten, die im erfassten Browserbereich angezeigt werden.
Offizielle API-Preise
Grobe Schätzung: 10.000 Eingabe-Token plus 2.000 Ausgabe-Token entsprechen bei Standardtarifen etwa $0,08 – vor Berücksichtigung von Cache, Batch, Steuern oder Plattformaufschlag.
Screenshot des Verbraucher-Tarifs
Auf der erfassten Seite ist außerdem eine JCT-Notiz mit der Bezeichnung „10%“ zu sehen. Dabei handelt es sich um regionsabhängige Anzeigewerte und nicht um eine globale Preisgarantie.
Eine gesonderte Erläuterung zur Token-Abrechnung und zu den Kosten pro Kontextfenster finden Sie unter Leitfaden zu Preisen und Hintergründen für GPT-5.5. Die API-Gebühr des Anbieters, die Abonnementkosten sowie etwaige Guthaben auf der Multi-Modell-Plattform sollten in Ihrem Budget separat ausgewiesen werden.
Praxistest: fünf Ergebniskarten für verschiedene Aufgaben
Am 23. September 2026 haben wir fünf unabhängige Eingaben über denselben kontrollierten Messages-API-Pfad mit der Modell-ID gesendet claude-opus-5-5. Im ersten Durchgang wurde max_tokens: 1024. Wir haben die lokal gemessene Laufzeit, die Anzahl der Eingabe- und Ausgabetoken, den Grund für den Abbruch, die Korrektheit sowie die Einhaltung des Literalformats erfasst. Die Aufgabe zum Schreiben chinesischer Schriftzeichen wurde mit einer Obergrenze von 4.096 Token erneut ausgeführt, nachdem beim ersten Durchlauf das Problem mit der Ausgabe der Route zutage getreten war. Hierbei handelt es sich um eine Stichprobe aus fünf Aufgaben, nicht um eine Schätzung der Zuverlässigkeit.
Kann es eine Funktion zur Deduplizierung gemischter Typen reparieren?
Aufgabeneinrichtung
Finde den Fehler in einem Python-Programm Deduplizierung Funktion, Verarbeitung von Werten, die keine Zeichenketten sind und nicht in einen Hash-Tabellen-Index aufgenommen werden können, Beibehaltung der ursprünglichen Schreibweise und Bereitstellung von Tests.
In der Antwort wurde Folgendes festgestellt: .lower() Fehler bei Nicht-String-Werten, Strings wurden geändert in casefold(), fügte einen Fallback für nicht hashbare Werte hinzu und lieferte den korrigierten Code sowie Testfälle zurück.
Die Antwort wurde bei der Obergrenze von 1.024 Tokens abgebrochen. Die Korrektur war hilfreich, aber die Konfiguration war für eine vollständige Codeüberprüfung zu klein.
Kartenurteil: Es wurde eine technisch brauchbare Antwort zurückgegeben; dieser Durchlauf kann jedoch keine Aussage über Latenz oder Vollständigkeit zulassen, da die Token-Obergrenze den Durchlauf vorzeitig beendet hat.
Kann es Fakten bewahren und Grenzen ausloten?
Aufgabeneinrichtung
Wählen Sie aus einem kurzen Bewertungsbericht fünf nummerierte Ergebnisse aus, einschließlich der Methode und der Aspekte, die in der nächsten Runde nicht gemessen wurden.
Es wurden genau fünf nummerierte Stichpunkte zurückgegeben. Die Vergleiche mit den Assistenten, die 20-Fragen-Methode sowie die Lücken in Bezug auf das Langzeitgedächtnis und die Kundenkonversion blieben erhalten.
Da es sich um ein kurzes Quellcode-Paket handelte, wird das 1-M-Kontextfenster nicht getestet.
Kartenurteil: Saubere Extraktion unter Beibehaltung der gewünschten Anzahl und der Nachweiskriterien des Quellmemos.
Kann es ohne Nachbearbeitung maschinenlesbare Ausgabe liefern?
Aufgabeneinrichtung
Gib ein festes JSON-Objekt mit einem Titel, einer Zielgruppe, zwei Vor- und zwei Nachteilen sowie einem Fazit zurück. Markdown-Fence-Zeichen waren nicht zulässig.
Es wurde ein auswertbares JSON-Objekt mit den angeforderten Schlüsseln, zwei Vor- und zwei Nachteilen sowie einer prägnanten Empfehlung zurückgegeben. Ein Markdown-Wrapper war nicht vorhanden.
Eine gültige Antwort ist kein Beweis für die Zuverlässigkeit des Schemas bei größeren oder verschachtelten Objekten.
Kartenurteil: Die Übereinstimmung mit dem wörtlichen JSON-Format wurde in diesem Durchlauf bestätigt.
Kann es eine Regel zur wiederholten Rundung korrekt anwenden?
Aufgabeneinrichtung
Beginnen Sie mit 12 Artikeln, multiplizieren Sie jede nächste Charge mit 1,25, runden Sie nach jeder Charge ab und geben Sie die Gesamtsumme über vier Chargen an.
Gab 12, 15, 18 und 22 zurück und summierte diese dann zu 67. Die Zwischenberechnungen waren sichtbar.
Die Aufgabe ist deterministisch und überschaubar; sie spiegelt keine umfassende Denkfähigkeit wider.
Kartenurteil: korrektes Ergebnis und transparente Zwischenschritte.
Hat die getestete Route brauchbaren chinesischen Text zurückgegeben?
Aufgabeneinrichtung
Entwerfen Sie eine Einleitung für einen chinesischen Testbericht, in der offizielle Angaben, Preis, Vergleichsdaten und praktische Tests voneinander getrennt dargestellt werden.
Die Antwortstruktur war vorhanden, doch wurden chinesische Schriftzeichen über den getesteten Pfad im gespeicherten Ergebnis verfälscht zurückgegeben.
Die Daten unterscheiden nicht zwischen der Qualität der Modellsprache und dem Routing- oder Kodierungsverhalten. Es wird kein Qualitätswert für Chinesisch vergeben.
Kartenurteil: Der auf dieser Route zurückgegebene Text ist unbrauchbar; führen Sie den Vorgang mit einem verifizierten UTF-8-Pfad erneut aus, bevor Sie Aussagen zur Sprachqualität treffen.
Über die vier sprachneutralen bzw. englischen Durchläufe hinweg betrug der lokale Mittelwert 6,24 Sekunden. Diese Zahl bezieht sich auf fünf aufeinanderfolgende Anfragen auf einer Route und stellt keine anbieterseitige Latenz dar. Die am stärksten beobachteten Verhaltensweisen waren prägnante Extraktion, die Einhaltung des JSON-Standards und korrekte arithmetische Berechnungen; die beiden ungelösten Probleme waren der Druck auf die Codierung durch das Ausgabebudget und eine verstümmelte chinesische Ausgabe auf der getesteten Route.
Hinweise zu APIs und Migration
Die kurze Antwort umfasst diese Punkte, da sie eine Integration beeinflussen können, selbst wenn die Textqualität des Modells auf den ersten Blick gut erscheint.
- Das Denken läuft ständig. Verwenden Sie den dokumentierten „Effort“-Parameter, um Tiefe, Latenz und Kosten zu steuern; es gibt keinen Ausschalter.
- Der erzwungene Einsatz des Werkzeugs führt zu einer Fehlermeldung. Bestehender Code, der eine erzwungene Werkzeugauswahl erfordert, muss einem separaten Migrationstest unterzogen werden.
- Denkblockaden hängen zwangsläufig mit Modellen und Gesprächen zusammen. Gehen Sie nicht davon aus, dass ein Denkblock nach einem Modellwechsel wiederverwendet werden kann.
computer_20251124wird nicht akzeptiert zur Claude-API und zum Google Cloud-Ansatz, wie in der Dokumentation beschrieben.- Produktionsobergrenzen spielen eine Rolle. Die Kodierungskarte zeigt, dass eine nützliche Antwort dennoch durch ein kleines
max_tokensWert. - Der Batch-Modus und der Schnellmodus sind getrennte Abrechnungswege. Die Rabatte bzw. Aufschläge sollten getrennt von den regulären Token-Preisen ausgewiesen werden.
Evidenzbasiertes Urteil
Claude Opus 5.5 verfügt über aussagekräftige, datierte öffentliche Benchmark-Ergebnisse und weist eine niedrigere veröffentlichte Standard-API-Rate auf als die in der Ankündigung von Anthropic genannten Opus-5-Werte. In den fünf aufgezeichneten Aufgabenläufen lieferte es eine saubere Extraktion, korrektes JSON und korrekte arithmetische Ergebnisse; die Programmierantwort war brauchbar, wurde jedoch durch die anfängliche Obergrenze abgeschnitten; und die chinesische Ausgabe war über den getesteten Weg nicht nutzbar.
Die vertretbare Schlussfolgerung fällt daher eher begrenzt aus: Das Modell zeigte bei mehreren kleinen Aufgaben eine starke Befolgung der Anweisungen, während die Route und die Konfiguration sichtbare Grenzen aufzeigten. Bei jeder Migrationsentscheidung sollten dieselben Eingabeaufforderungen mit einem angemessenen Ausgabebudget wiederholt, die Tool-Aufrufe überprüft und die offiziellen Token-Sätze getrennt von Abonnement- oder Plattformguthaben gehalten werden.
Wenn Sie eine zweite Route zum Vergleich wünschen, dann die DeepSeek V4 Pro im Vergleich zum Flash-Testformat zeigt, wie Urteile auf Aufgabenebene von modellweiten Aussagen getrennt bleiben können. Die Leitfaden zu Anwendungsfällen für GPT-5.5 bietet einen aufgabenorientierten Bezugspunkt, während Hinweise zum Gemini-Flash-Benchmark und die Leitfaden zum Vergleich von KI-Modellen Stellen Sie den Kontext des nahegelegenen Modells bereit. Informationen zum Zugriff auf mehrere Modelle finden Sie unter All-in-One-KI-Abonnements und Der Vergleich verschiedener Modellplattformen.
Häufig gestellte Fragen
Wie viel kostet Claude Opus 5.5?
Die offizielle API-Rate beträgt $4 pro Million Eingabe-Token und $20 pro Million Ausgabe-Token. Cache-Lesevorgänge kosten $0,20 pro Million Token, und 5-Minuten-Cache-Schreibvorgänge kosten $5 pro Million Token.
Was ist das Claude Opus-5,5-Kontextfenster?
In der Dokumentation zur Claude-Plattform sind ein Kontextfenster von 1 Million Token und eine maximale Ausgabe von 128.000 Token angegeben. Ein separat dokumentierter Beta-Pfad unterstützt bis zu 300.000 Ausgabetoken für Nachrichtenbatches.
Ist der Claude Opus 5.5 besser als der Opus 5?
Anthropic weist geringere typische Arbeitskosten und eine schnellere Ausgabe auf, während unabhängige Bewertungen bei mehreren veralteten Aufgaben überzeugende Ergebnisse zeigen. Das Ausmaß des Qualitätsgewinns hängt vom Benchmark, den Aufwandsparametern, der Eingabeaufforderung und dem Verfahren ab.
Kann man das Denken ausschalten?
Nein. Laut der aktuellen Modelldokumentation ist das adaptive Denken immer aktiviert. Verwenden Sie den Parameter „Aufwand“, um die Denktiefe, die Latenzzeit und die Kosten zu steuern.
Haben die fünf API-Aufgaben ihre Zuverlässigkeit unter Beweis gestellt?
Nein. Die Karten zeigen konkrete Verhaltensweisen und Konfigurationsgrenzen auf, aber anhand von fünf Aufgaben lässt sich keine allgemeine Erfolgsquote abschätzen. Die Probleme hinsichtlich der Kodierungsgrenze und der chinesischen Route werden separat behandelt.
Hat diese Bewertung die chinesische Qualität unter Beweis gestellt?
Nein. Die getestete Route lieferte verstümmelten chinesischen Text, daher wird das Ergebnis als Problem mit der Kodierung oder der Route vermerkt, bis eine verifizierte Wiederholung mit UTF-8 erfolgt ist.









