
إجابة سريعة: يُعد GPT-6 Sol نموذجًا معقدًا للترميز وسير العمل التفاعلي التابع لـ OpenAI. تسرد واجهة برمجة التطبيقات (API) الرسمية $2.00 لكل مليون رمز إدخال و$10.00 لكل مليون رمز إخراج وفقًا للأسعار القياسية، مع نافذة سياق تبلغ 1.05 مليون رمز وإخراج أقصى يبلغ 128 ألف رمز. والسؤال الأهم الذي يجب طرحه عند الشراء هو ما إذا كانت إجاباته تلبي متطلبات مهمتك بتكلفة إجمالية مقبولة.
يُبرز OpenAI قدرات GPT-6 Sol في مجال البرمجة المعقدة وسير العمل القائم على الوكلاء. هذه العبارة تمثل التوجيه التسويقي للمزود، وليست درجة جودة تم قياسها. تُترجم هذه المراجعة المواصفات المنشورة إلى قرارات شراء وتصميم بنية، ثم تسجل ردود الفعل العامة مع الإشارة إلى مصادرها. كما قمنا بتنفيذ ثلاث مهام صغيرة مع الاحتفاظ بمعرف النموذج والمسار ومجموعة المطالبات والمخرجات الأولية وطريقة الاستخدام. تظهر نتائج المهام أدناه كعملية تشغيل واحدة تمت ملاحظتها، وليست معيارًا رسميًا للأداء.
الحكم السريع
يُعد نموذج «Sol» هو النموذج الذي ينبغي دراسته عندما يكون العمل معقدًا حقًّا، أو يعتمد بشكل كبير على الأدوات، أو يركز على الكود، ويكون ارتفاع تكلفة الرموز مقبولًا. وتجمع الأدلة في هذا الصدد بين الوثائق الرسمية وعينة المهام الصغيرة التي قمنا بها، وليس اختبار أداء خاضعًا للرقابة؛ لذا فإن الحكم المسؤول هو أن هذا النموذج مناسب، وليس تصنيفًا شاملاً.
التمييز الأكثر فائدة لا يقتصر على مجرد “الذكاء” مقابل “السرعة”، بل يكمن في شكل حمل العمل. يتمتع GPT-6 Sol بنفس السياق العام ونفس الحدود القصوى للمخرجات مثل نظيره، لكن موقعه في السوق وسعره يجعلان من المنطقي اعتماد نقطة تشغيل مختلفة. قارن بين النطاق الأوسع دليل اختيار نماذج الذكاء الاصطناعي و أفضل نموذج ذكاء اصطناعي للبرمجة دليل يُستخدم عندما تشمل المهمة أكثر من مزود واحد.
نظرة عامة على GPT-6 Sol
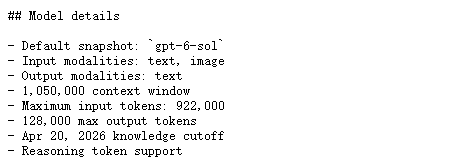
الجدول أدناه يتبع الصيغة الحالية الصفحة الرسمية لنموذج Sol من GPT-6. سعة السياق تختلف عن الحجم الموصى به للموجه، كما أن الحد الأقصى للإدخال منفصل عن نافذة سياق العنوان.
gpt-6-solيدعم كلا النموذجين المتشابهين المخرجات المنظمة، واستدعاء الدوال، والبث المباشر، والتخزين المؤقت للمطالبات، وإدخال الصور، والبحث عن الملفات، والبحث على الويب ضمن مجموعة الميزات الموثقة. ولا يزال السلوك الدقيق للأداة يعتمد على نقطة النهاية والحساب وتكوين الطلب؛ فلا تستنتج نجاح تشغيل الأداة من مجرد وجود خانة اختيار للإمكانية.
فيما يتعلق بالسياق على مستوى الأسرة، فإن مراجعة سيارة GPT-6 Astra يوضح كيف يقوم مقال ذو صلة بـ GPT-6 بالفصل بين وثائق المزود ومسارات المنصة وردود الفعل المنسوبة.
أسعار GPT-6 Sol وقاعدة 272 ألف
وفقًا للأسعار القياسية، فإن صفحة أسعار OpenAI تُدرج القيم التالية: $2.00 للمدخلات، و$0.20 للمدخلات المخزنة في ذاكرة التخزين المؤقت، و$2.50 لعمليات الكتابة إلى ذاكرة التخزين المؤقت، و$10.00 للمخرجات لكل مليون رمز. وتبلغ عمليات الكتابة إلى ذاكرة التخزين المؤقت 1.25 ضعف المدخلات غير المخزنة في ذاكرة التخزين المؤقت. يبلغ سعر كل من «Batch» و«Flex» 50% من «Standard»، بينما يبلغ سعر «Fast mode» ضعف السعر المطبق، وتضيف المعالجة الإقليمية 10% حيثما كانت متاحة.
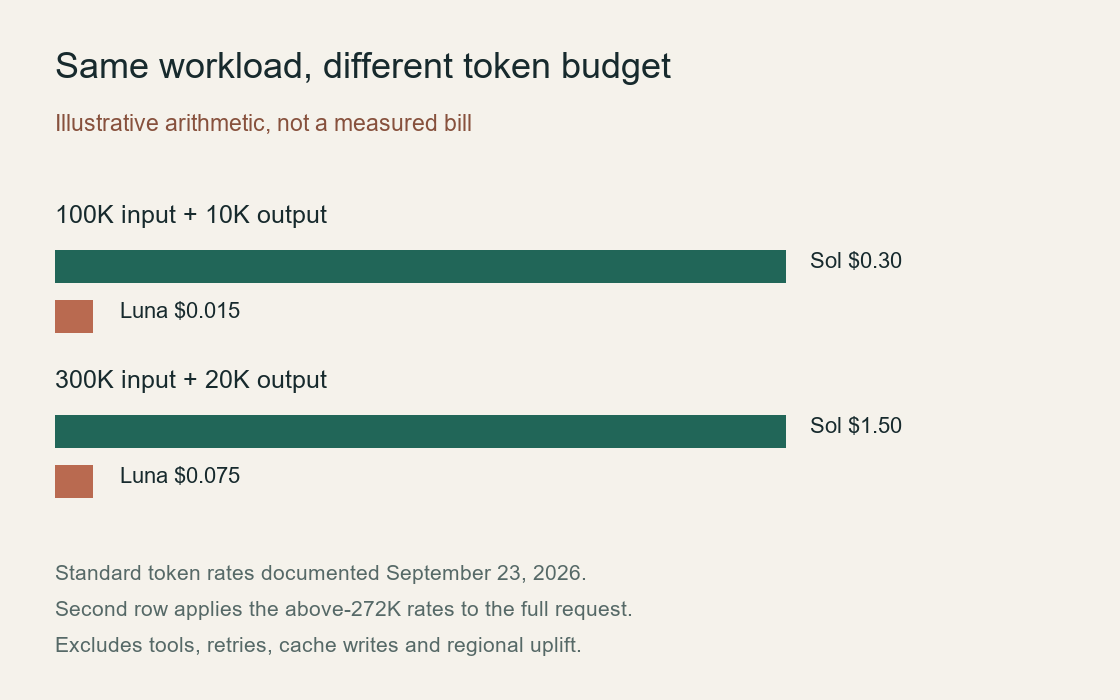
يُحسب عمود «السياق الطويل» وفقًا لقاعدة OpenAI: عند تجاوز مدخلات 272 ألف، تتضاعف معدلات المدخلات والذاكرة المؤقتة، ويُضرب الناتج في 1.5 بالنسبة للطلب الكامل. ولا يُعد هذا فاتورة ذات معدلات مختلطة. وللحصول على خط أساس عملي للميزانية، فإن 100 ألف مدخلات بالإضافة إلى 10 آلاف مخرجات تكلف حوالي $0.30 قبل احتساب تكاليف الأدوات أو الارتفاع الإقليمي؛ مثال يتضمن مدخلات بقيمة 300 ألف ومخرجات بقيمة 20 ألف يكلف حوالي $1.50 بمعدلات السياق الطويل.
قد تكون نافذة السياق الكبيرة مفيدة، لكن ملؤها لا يأتي بسهولة. فعمليات الاسترجاع واختيار المقاطع وإعادة استخدام ذاكرة التخزين المؤقت وحدود الإخراج لها أهمية أكبر من الرقم الرئيسي البالغ 1.05 مليون. انظر تفاصيل أسعار GPT-6 Astra للاطلاع على شرح ذي صلة بعتبات السياق وآليات عمل ذاكرة التخزين المؤقت.
توافق واجهة برمجة تطبيقات GPT-6 Sol، والأدوات، والقيود
توصي OpenAI باستخدام واجهة برمجة التطبيقات (API) «Responses» للأدوات المدمجة واستدعاء الدالات. ولا يدعم «Chat Completions» استدعاء الدالات إلا عندما جهد_التفكير تم ضبطه على لا شيء. هذه إحدى تفاصيل التنفيذ التي يجدر الانتباه إليها قبل عملية الترحيل: فقد يكون الطلب صحيحًا من الناحية النحوية، لكنه لا يتوافق مع سلوك الأداة الذي يتوقعه نظام التكامل الحالي لديك.
يسرد جدول حدود المعدل الحالي المستويات القياسية التالية. ويشير مصطلح «RPM» إلى عدد الطلبات في الدقيقة، ويشير مصطلح «TPM» إلى عدد الرموز في الدقيقة، أما قيمة «قائمة الانتظار» فهي الحد الأقصى لعدد الرموز في الدفعة الواحدة.
قبل بدء الإنتاج، تأكد من صحة المستوى ونقطة النهاية ووضع البث وعقد الأداة في حسابك الخاص. الـ دليل حدود استخدام كوديكس وهذا يوضح السبب في أن الحد الأقصى المعلن للنموذج يختلف عن الحد المسموح به فعليًّا للحساب.
ما الذي تشير إليه مواصفات GPT-6 Sol
هذه خريطة ملاءمة، وليست معيارًا. استخدم دليل سير العمل لنماذج الذكاء الاصطناعي المتكاملة عندما يكون قرارك الحقيقي هو كيفية التبديل بين النماذج ضمن عملية واحدة قابلة للتكرار، بدلاً من التركيز على أي نموذج واحد يبدو الأقوى.
في اختباراتنا: GPT-6 Sol في ثلاث مهام عملية
قمنا باختبار إصلاح بسيط لـ JavaScript، ومذكرة قرار من ثلاث نقاط، واستخراج بيانات JSON في 23 سبتمبر 2026. النتائج المُحتفظ بها أدناه هي استجابات كاملة لمعرف النموذج gpt-6-sol. وقد واجهت المحاولات السابقة أخطاءً مؤقتة تتعلق بالحمل الزائد، لذا لا ينبغي اعتبار هذه النتائج بمثابة قياسات موثوقة للمحاولة الأولى. ونحن ندرس ما تتضمنه الإجابات، وما يمكن للقارئ إعادة استخدامه، وما لم يتم اختباره بعد.
تصحيح الكود: الحفاظ على القيمة صفر دون إعادة كتابة الدالة
قم بمراجعة هذه الدالة الصغيرة المكتوبة بلغة جافا سكريبت كما لو كانت جزءًا من مستودع الإنتاج. حدد الخطأ، وشرح سبب الفشل، واقترح تصحيحًا بسيطًا بالإضافة إلى اختبارين محددين للرجوع. الدالة: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }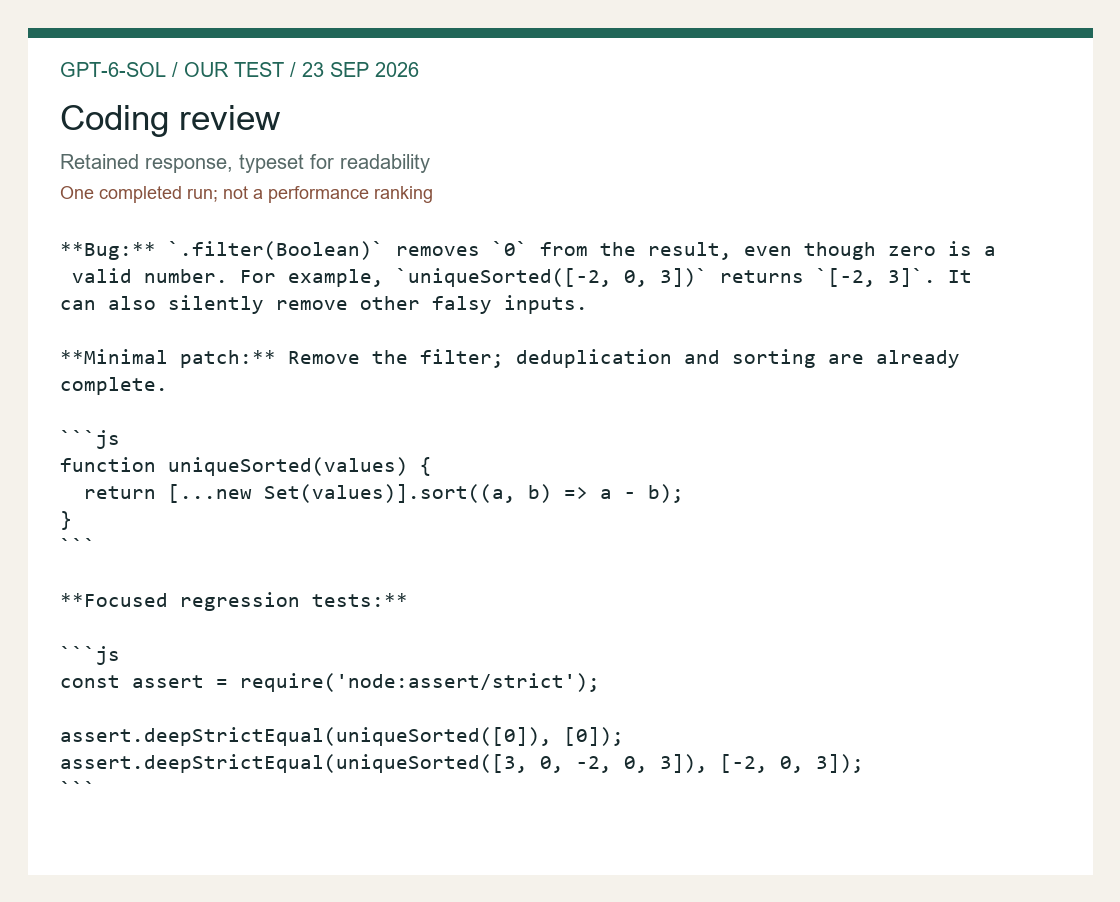
**خطأ:** تزيل دالة `.filter(Boolean)` الرقم `0` من النتيجة، على الرغم من أن الصفر رقم صحيح. على سبيل المثال، تُرجع الدالة `uniqueSorted([-2, 0, 3])` النتيجة `[-2, 3]`. كما يمكنها إزالة المدخلات الأخرى التي تُعتبر 'كاذبة' (falsy) دون إظهار أي رسالة خطأ.

**التصحيح البسيط:** إزالة عامل التصفية؛ فقد تم بالفعل إزالة التكرار والفرز.

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**اختبارات الانحدار المركزة:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
الاستخدام المُبلغ عنه لهذه الإجابة المكتملة: 71 رمز إدخال، 409 رموز إكمال، 480 رمزًا إجماليًا. قد يشمل استخدام «الإكمال» رموز الاستدلال؛ فهو لا يقتصر فقط على طول الإجابة الظاهرة.
تمكن «سول» من تحديد الخلل الفعلي بدلاً من إعادة كتابة الدالة استنادًا إلى تفضيل لا علاقة له بالموضوع. النتيجة النهائية .filter(Boolean) يتجاهل الرقم صفر لأن لغة جافا سكريبت تحول الصفر إلى القيمة "false". يتم إجراء إزالة التكرار والفرز الرقمي التصاعدي قبل هذا المرشح. وبالتالي، فإن إزالة المرشح وحده تُصلح الخلل الموضح مع ترك بقية الخوارزمية كما هي. هذا هو النوع من التصحيحات الصغيرة التي يمكن للمراجع فهمها بسرعة: يحدد الشرح القيمة المعيبة، ويستهدف التعديل العملية المسؤولة عن الخلل، وتُظهر الاختبارات السلوك المقصود.
يؤدي كل من تأكيدي الانحدار هذين وظائف مختلفة. حالة العنصر الوحيد [0] يعزل عيب «الصفر المتلاشي». وتجمع الحالة المختلطة بين عدد سالب، والصفر، وعدد موجب، وتكرارات، للتحقق من أن عملية إزالة التكرار والترتيب العددي تظلان سليمتين بعد التعديل. كما أدرج «سول» أيضًا require('node:assert/strict'), ، وبالتالي فإن تبعية التأكيدات واضحة. هذه التفاصيل تجعل الرد أكثر فائدة من مجرد تصحيح مصحوب بنصيحة غامضة بإضافة اختبارات. ومع ذلك، فهي لا توضح كيف سيقوم «سول» بفحص المستودع، أو معالجة عمليات الاستيراد عبر الملفات، أو التعامل مع فشل عملية البناء.
هناك مسألة تتعلق بشروط العقد تتجاوز الخلل الذي تم إثباته. هل من المفترض أن تقبل هذه الوظيفة الأعداد المحدودة فقط، أم قيم جافا سكريبت تعسفية؟ كما أن إزالة عامل التصفية يؤدي إلى الاحتفاظ بمدخلات أخرى تُعتبر «كاذبة» (falsy) في حالة إرسالها من قبل المستدعين. وتتطلب قيم NaN، والصفر السالب، واللانهايات، والسلاسل الرقمية، والقيمة null اتخاذ قرارات سياسية مدروسة. ولن نقوم بإضافة عملية تحويل أو التحقق من الصحة إلى هذا التصحيح دون وجود تلك السياسة. إن الإصلاح البسيط له قيمته بالضبط لأنه يفصل الخلل المؤكد عن عملية إعادة تصميم أوسع نطاقًا.
التوليف ثلاثي النوتات: الحفاظ على الطابع الشرطي للقرار
قم بتجميع الملاحظات الثلاث التالية في مذكرة قرار موجزة تتضمن: القرار، والأدلة، والمخاطر، والخطوة التالية. الملاحظة أ: يمكن لنافذة السياق التي تضم 1.05 مليون توكن استيعاب مجموعات كبيرة من البيانات المصدرية، لكنها لا تجعل كل طلب منخفض التكلفة. الملاحظة ب: عند تجاوز 272 ألف توكن من المدخلات، تزداد معدلات الإدخال/التخزين المؤقت الموثقة، ويضاعف الناتج بالنسبة للطلب الكامل. الملاحظة ج: يمكن أن يقلل الاسترجاع وإعادة استخدام ذاكرة التخزين المؤقت من تكلفة المطالبات المتكررة، لكن معايير القبول لا تزال بحاجة إلى الاختبار.
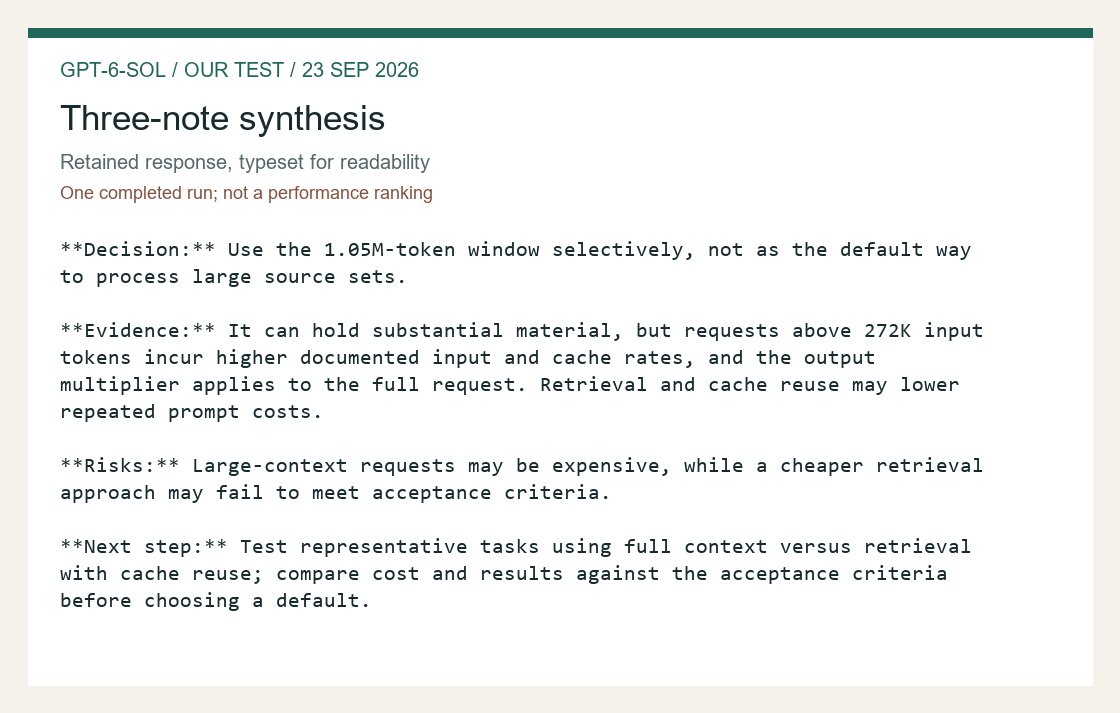
**القرار:** استخدام نافذة 1.05 مليون توكن بشكل انتقائي، وليس كطريقة افتراضية لمعالجة مجموعات المصادر الكبيرة.

**الأدلة:** يمكنها استيعاب كمية كبيرة من المواد، لكن الطلبات التي تتجاوز 272 ألف رمز إدخال تتسبب في ارتفاع معدلات الإدخال والذاكرة المؤقتة الموثقة، كما أن مضاعف الإخراج ينطبق على الطلب بالكامل. قد يؤدي الاسترجاع وإعادة استخدام الذاكرة المؤقتة إلى خفض تكاليف المطالبات المتكررة.

**المخاطر:** قد تكون الطلبات ذات السياق الكبير مكلفة، في حين أن نهج الاسترجاع الأرخص قد يفشل في تلبية معايير القبول.

**الخطوة التالية:** اختبار مهام تمثيلية باستخدام السياق الكامل مقابل الاسترجاع مع إعادة استخدام ذاكرة التخزين المؤقت؛ ومقارنة التكلفة والنتائج بمعايير القبول قبل اختيار الإعداد الافتراضي.
الاستخدام المُبلغ عنه لهذه الإجابة المكتملة: 99 رمز إدخال، 186 رمز إكمال، 285 رمزًا إجمالاً. قد يشمل استخدام «الإكمال» رموز الاستدلال؛ فهو لا يقتصر فقط على طول الإجابة الظاهرة.
قامت «سول» بتنظيم الملاحظات الثلاث في فئات: «القرار»، و«الأدلة»، و«المخاطر»، و«الخطوة التالية». وكانت توصيتها هي الاستخدام الانتقائي للنافذة الكبيرة، مع تقييم عمليات الاسترجاع وإعادة استخدام ذاكرة التخزين المؤقت وفقًا لمعايير القبول. وكان السلوك المفيد هو الحفاظ على الصياغة الشرطية: قد يقلل الاسترجاع من التكلفة، لكن اختبار عبء العمل هو وحده الذي يمكنه تحديد ما إذا كان يحافظ على المعلومات التي يحتاجها القرار. ولم تتضمن الاستجابة تحديد نسبة مئوية للتوفير، أو درجة استرجاع مقاسة، أو توصية بإرسال السياق الأقصى دائمًا.
لم تتجاوز هذه المدخلات 99 وحدة نصية موجهة تم الإبلاغ عنها. وهي تختبر القدرة على توليف الملاحظات القصيرة واتباع التعليمات، وليس القدرة على استرجاع حقيقة مخفية من بين مئات الآلاف من الوحدات النصية. وقد وردت بيانات التسعير في الملاحظات؛ ولا يُعد تكرارها بشكل صحيح تحققاً مستقلاً من التسعير. بالنسبة لمذكرة هندسية حقيقية، كنا سنضيف معرّفات المصادر، وصاحب القرار، وافتراضًا صريحًا للميزانية. هذه الإضافات من شأنها أن تجعل كل جملة قابلة للتدقيق دون الادعاء بأن هذا التمرين القصير قد غطى نافذة السياق بالكامل.
استخراج JSON: الحفاظ على صراحة العناصر المجهولة
استخرج الحقول التالية من هذه الملخصة وأعد بيانات JSON صالحة تحتوي فقط على المفاتيح التالية: customer، priority، deadline، وunknowns. الملخصة: العميل: Northwind Labs. الأولوية: عالية. الموعد النهائي: 2026-10-04. لم يتم ذكر اسم المسؤول ولم يتم تأكيد الميزانية.
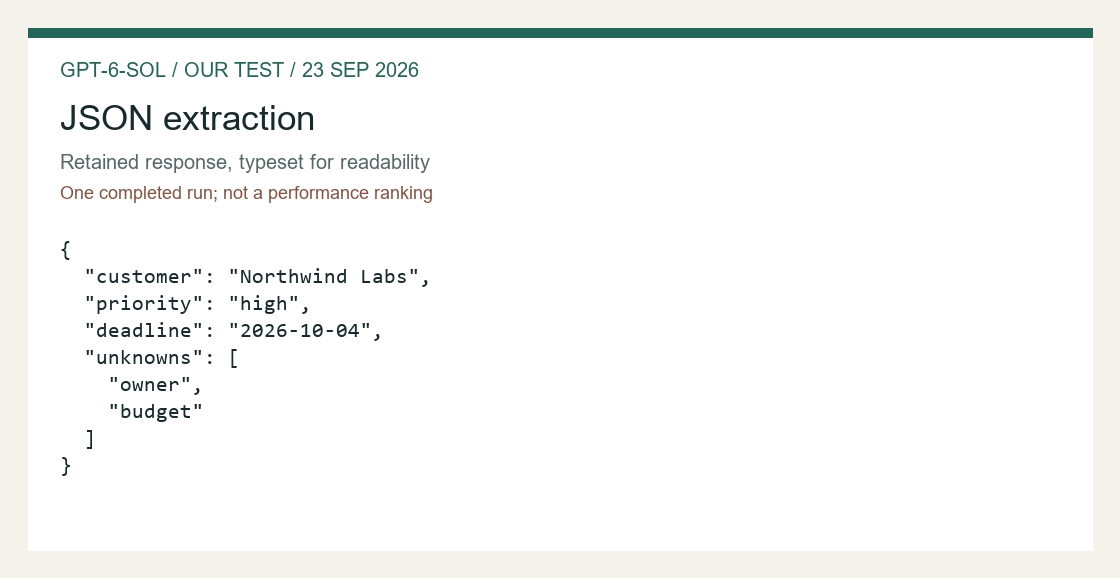
{"العميل":"Northwind Labs","الأولوية":"عالية","الموعد النهائي":"2026-10-04","المعلومات غير المعروفة":["المسؤول","الميزانية"]}الاستخدام المُبلغ عنه لهذه الإجابة المكتملة: 64 رمزًا من رموز الإدخال، و64 رمزًا من رموز الإكمال، بإجمالي 128 رمزًا. قد يشمل استخدام «الإكمال» رموز الاستدلال؛ فهو لا يقتصر فقط على طول الإجابة الظاهرة.
أرجعت «Sol» بالضبط الحقول المطلوبة: العميل، والأولوية، والموعد النهائي، والحقول المجهولة. وقد احتفظت قائمة الحقول المجهولة بـ«المالك الغائب» و«الميزانية غير المؤكدة» بدلاً من ملئهما بتخمينات معقولة. ويُعد ذلك نجاحًا ملموسًا لهذه المهمة الصغيرة: حيث يمكن للنظام التالي التمييز بين الموعد النهائي المعروف والمعلومات الناقصة. كما لم تحتوي النتيجة على أي علامات Markdown أو مقدمة توضيحية، مما يجعلها قابلة للتحليل مباشرةً بتنسيق JSON.
ظهر نفس نص JSON في النتيجة التي احتفظت بها «لونا». لا توجد هنا ميزة ملحوظة في جودة الاستخراج تبرر دفع السعر الأعلى الذي يطلبه «سول» مقابل هذا الإدخال بالذات. قد يظل «سول» خيارًا يستحق التقييم عندما يعتمد الاستخراج على حل التناقضات عبر عدة وثائق، لكن تلك مهمة مختلفة. ستكون نقطة انطلاقنا العملية هي اتباع مسار استخراج أرخص تم التحقق من صحته مع اللجوء إلى مستويات أعلى عند وجود أدلة متضاربة، بدلاً من استخدام النموذج الأغلى لكل سجل.
اختبار انحدار قابل للتشغيل للخلل الموضح
ما يلي هو مثال على التحقق التحريري، وليس إجابة نموذجية إضافية. يعمل هذا المثال محليًّا في Node.js ولا يقوم بأي طلبات على النموذج. وهو يتحقق من التجهيز المحدد الذي تمت مناقشته أعلاه؛ ولا يُعد تقييمًا عامًّا للنموذج.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('تمت عملية التصحيح بنجاح؛ تم إعادة إنتاج الخلل الأصلي ذي القيمة الصفرية.');
يؤكد الافتراض السلبي الأخير أن الدالة الأصلية تفقد القيمة صفر. وهذا يمنح الاختبار عنصر تحكم حساس للفشل: فالاختبار لا يكتفي بقبول التنفيذ الجديد فحسب، بل يُظهر أيضًا الأعراض التي يهدف التغيير إلى إصلاحها. تعد حالة المصفوفة الفارغة فحصًا تحريريًّا إضافيًّا، منفصلاً بوضوح عن التأكيدين اللذين يوفرهما النموذج. بالنسبة لرمز الإنتاج، ضع الاختبار بجانب الدالة الحقيقية وقم بتشغيل أمر اختبار المشروع الفعلي؛ حيث إن نسخ دالة إلى ملف اختبار منفصل لا يمكنه اكتشاف أخطاء التكامل.
كيف يغير GPT-6 Sol سير العمل الفعلي
لا تكتسب المواصفات الرئيسية أهمية إلا عندما تغير طريقة عمل الفريق. تم تصميم GPT-6 Sol للبرمجة المعقدة وسير العمل الذي يعتمد على الوكلاء، لذا فإن السؤال الأول هو ما إذا كان حجم عملك يستفيد من هذا النمط. إذا كان كل طلب يحتوي على مدخلات قصيرة، وعقد مخرجات محدود، واختبار قبول واضح، فيمكن إدراج النموذج ضمن مسار عمل قابل للتكرار. أما إذا كانت المهمة غامضة، أو تتطلب استخدام أدوات كثيرة، أو من المحتمل أن تتطلب عدة جولات من التصحيح، فإن التنسيق المحيط بها يكتسب أهمية لا تقل عن اسم النموذج نفسه.
بالنسبة لـ GPT-6 Sol، يُعد مسار «المرورتين» نمطًا إنتاجيًّا مفيدًا: اطلب أولاً إجابة موجزة تتضمن عدم اليقين بشكل صريح، ثم أرسل الجزء موضع الخلاف أو غير المكتمل فقط إلى المرور الثاني. وهذا يحد من إهدار الرموز الناتجة ويجعل الفشل واضحًا. كما يمنحك نقطة مقارنة أفضل مع GPT-6 Luna: فالسؤال ليس أي الاسمين يبدو أقوى، بل أي المسارين يصل إلى معايير القبول بعدد أقل من المحاولات.
نموذج تكلفة بسيط قبل الشحن
ينبغي ترجمة جدول الأسعار الرسمي إلى الوحدات التي يشتريها فريقك فعليًّا: عدد الطلبات يوميًا، ومتوسط الرموز المدخلة، وحصة البادئة المخزنة مؤقتًا، والرموز الناتجة، والنسبة المئوية للمكالمات التي تتجاوز 272 ألف رمز مدخل. فجدول البيانات الذي يقتصر على تتبع السعر الرئيسي للمدخلات يخفي عامل المضاعف في السياق الأوسع وتكلفة عمليات إعادة المحاولة.
يكتسب هذا الحساب أهمية خاصة عند مقارنة GPT-6 Sol بـ GPT-6 Luna. فقد يصبح الطلب الأرخص تكلفة مكلفًا إذا تطلب إجراء عمليات إصلاح متكررة؛ في حين أن الطلب الأكثر كفاءة قد يكون مضيعة للموارد عندما تكون المهمة عبارة عن استخراج حتمي. ويُعد الخط الأساسي الصحيح هو عينة صغيرة من حركة المرور الخاصة بك باستخدام نفس المطالبات ونفس المخطط ونفس قاعدة المراجعة.
أنماط الفشل التي يجب التحقق منها قبل اعتماد المنتج
يمكن أن توضح لك صفحة النموذج نقاط النهاية وطرق العمل التي تم توثيقها، لكنها لا تضمن أن التطبيق الحالي الخاص بك سيتصرف بنفس الطريقة بعد عملية الترحيل. تحقق مما إذا كانت أحداث البث يتم تحليلها بشكل صحيح، وما إذا كانت استدعاءات الأدوات تحافظ على الحالة عبر المحاولات المتكررة، وما إذا كانت المخرجات المنظمة ترفض الحقول التي تحتوي على أخطاء في التنسيق، وما إذا كان مسار التسجيل الخاص بك يسجل معرّف النموذج وإعدادات الاستدلال لكل طلب.
وهذه المعايير نفسها هي التي تجعل الملاحظات العملية الواردة في هذه المراجعة مفيدة دون تحويلها إلى قائمة ترتيب. وتُظهر مهامنا الثلاث كيفية تعامل المسار مع عيب برمجي بسيط، ومذكرة قرار، واستخراج JSON دقيق. وهي لا تحدد زمن الاستجابة، ولا الموثوقية على نطاق واسع، ولا تصنيفًا شاملاً للجودة.
إطار عمل لاتخاذ القرارات مخصص للفرق الحقيقية
تكون مراجعة النموذج مفيدة عندما تساعد شخصًا ما على اتخاذ قرار في ظل وجود قيود. بالنسبة لـ GPT-6 Sol، فإن القيود الأكثر صلة هي شكل الطلب، وتكلفة المراجعة، وحجم السياق، وتنسيق المخرجات، وعواقب الإجابة الخاطئة. يشير وصف المزود إلى برمجة معقدة وسير عمل قائم على الوكلاء، لكن الفريق لا يزال بحاجة إلى ترجمة هذا الوصف إلى مسار يمكنه مراقبته. ابدأ بتدوين المهمة في جملة واحدة، والمدخلات التي سيتلقاها النموذج، والمخرجات التي يتوقعها نظام آخر، ونقطة التحقق البشرية التي تمنع حدوث خطأ خفي.
الخطأ الأول هو اختيار نموذج من موجه تجريبي. فالنسخة التجريبية تكافئ الطلاقة وتخفي التفاصيل التشغيلية مثل محاولات إعادة التنفيذ، وحساب الرموز، وأذونات الأدوات، وفشل المخططات. تستخدم المقارنة الأفضل ثلاث مهام تمثيلية: طلب عادي، وطلب صعب، وطلب يجب رفضه أو رفعه إلى مستوى أعلى. والنتيجة ليست مجرد درجة واحدة، بل هي خريطة مصغرة توضح المجالات التي يوفر فيها النموذج الوقت، والمجالات التي يحتاج فيها إلى الإشراف، والمجالات التي يكون فيها نموذج آخر — غالبًا GPT-6 Luna — هو الخيار الأرخص أو الأكثر أمانًا.
ابدأ باختبار القبول
اكتب اختبار القبول قبل كتابة الموجه. بالنسبة للكود، قد يكون الاختبار عبارة عن اختبار وحدة ناجح أو تصحيح لا يُغيّر من واجهة برمجة التطبيقات العامة (API). بالنسبة لعملية الاستخراج، قد يكون الاختبار عبارة عن ملف JSON صالح يحتوي على كل المفاتيح المطلوبة مع الحفاظ صراحةً على القيم المجهولة. أما بالنسبة لمذكرة القرار، فقد يكون الاختبار عبارة عن هيكل ثابت يتضمن الأدلة والمخاطر والمسؤول والخطوة التالية. لا يمكن تقييم النموذج إلا مقابل هدف مرئي. وبدون هذا الهدف، قد تبدو الفقرة المصقولة ناجحة بينما تغفل بهدوء الحقل الوحيد الذي تحتاجه العملية اللاحقة.
اختبار القبول الجيد هو اختبار محدود النطاق بدرجة كافية لتشغيله تلقائيًّا، وذو مغزى كافٍ لحماية المستخدم. كما يجب أن يتيح تحديد أسباب الخلاف بوضوح. فإذا اختلفت نتيجتان، يجب أن يتمكن الفريق من تحديد حقيقة مفقودة، أو افتراض غير مدعوم، أو حقل غير صحيح الشكل، أو حساب خاطئ. وهذا أكثر قابلية للتنفيذ من القول إن إحدى الإجابات “بدت أكثر ذكاءً”. وهذا أيضًا هو الفرق بين المراجعة التي تساعد عملية الشراء والمراجعة التي تكتفي بتكرار عبارات الإعلان عن الإطلاق.
استخدم اسم النموذج لاختيار فرضية أولية. واستخدم اختبار القبول لتحديد ما إذا كانت الفرضية ستصمد عند تطبيقها في بيئة الإنتاج.
تصميم سريع يتوافق مع ملف تعريف النموذج
لا ينبغي نسخ نفس المطالبة دون تغيير بين كل نموذج وآخر. يمكن أن يظل عقد المهمة ثابتًا، لكن حجم السياق، وتعليمات الاستدلال، وقيود المخرجات يجب أن تتوافق مع المسار. بالنسبة لـ GPT-6 Sol، اجعل تعليمات النظام قصيرة بما يكفي بحيث لا تتنافس مع المادة المصدرية. حدد الدور، وقاعدة اتخاذ القرار، وشكل المخرجات المطلوب، والشروط التي تتطلب وجود متغير مجهول صريح أو تصعيدًا.
بالنسبة للوثائق الطويلة، يجب فصل عملية الاسترجاع عن عملية التقييم. حدد أولاً المقاطع التي تجيب على السؤال؛ ثم اطلب استخلاص الاستنتاج باستخدام تلك المقاطع والمعايير المحددة فقط. وهذا يقلل من احتمال تكوين جملة مؤكدة استنادًا إلى تفصيل بعيد وغير ذي صلة. كما أنه يجعل نافذة السياق المكونة من 1.05 مليون توكن أداةً وليس الإعداد الافتراضي. يكون السياق الواسع ذا قيمة عندما تكون العلاقة بين الأدلة البعيدة عن بعضها مهمة. ويُعد إهدارًا للموارد عندما يمكن حل المهمة باستخدام حزمة صغيرة ومختارة بعناية.
بالنسبة لسير العمل الذي يستخدم الأدوات، يجب وصف الحدود الفاصلة بين النموذج والأداة. يجب أن يقرر النموذج ما إذا كانت الأداة مطلوبة أم لا، وأن يوفر المعلمات وفقًا لمخطط صارم، وأن يشرح ما سيفعله بالقيمة المرجعة. يجب أن يقوم التطبيق بفرض الأذونات، والتحقق من صحة الوسيطات، وتسجيل الاستدعاء، وتحديد ما إذا كان من الممكن إعادة محاولة استدعاء الأداة في حالة الفشل. إن التعامل مع النموذج على أنه التطبيق بأكمله يجعل عملية تصحيح الأخطاء أكثر صعوبة ويزيد من نطاق تأثير أي افتراض خاطئ.
موجه قابل لإعادة الاستخدام مكون من أربعة أجزاء
السياق: لا تذكر سوى الحقائق والوثائق التي تتطلبها المهمة. الهدف: اذكر القرار أو التغيير في جملة واحدة. القيود: تحديد التنسيق، والاستثناءات، وكيفية التعامل مع عدم اليقين، وحدود الأداة. تحقق من: اطلب من النموذج أن يذكر المدخلات الناقصة أو التناقضات قبل أن يضع اللمسات الأخيرة على الإجابة. هذه البنية موجزة بما يكفي لإجراء استدعاءات متكررة، وواضحة بما يكفي لإجراء المقارنة بين النماذج المختلفة.
عندما تكون نافذة السياق الكبيرة مفيدة
العنوان الذي يشير إلى 1.05 مليون توكن سهل التكرار وسهل إساءة الاستخدام. توضح نافذة السياق كمية البيانات التي يمكن أن يتسع لها الطلب؛ لكنها لا توضح كمية البيانات التي ينبغي إرسالها، أو مدى كفاءة استخدام النموذج لكل مقطع، أو تكلفة الطلب. كما أن الطلب الطويل قد يؤدي إلى إبطاء عملية المراجعة، لأن الفريق سيكون أمامه المزيد من الأدلة لفحصها، مما يزيد من احتمالية حدوث تعارض خفي في التعليمات.
استخدم «النافذة الكاملة» عندما تعتمد المهمة فعليًّا على مراجع بعيدة: مثل عقد تتفصل فيه التعريفات عن الاستثناءات، أو مستودع تكون فيه الواجهات والتطبيقات متباعدة، أو أرشيف بحثي طويل تتطلب الإجابة فيه تتبع تسلسل معين. استخدم «الاسترجاع» عندما يكون السؤال محليًّا، أو عندما تتغير مجموعة المصادر بشكل متكرر، أو عندما تريد مسارًا موجزًا للاستشهادات. استخدم التخزين المؤقت عندما يتم إعادة استخدام بادئة ثابتة عبر العديد من الطلبات، وتوفر المنصة تفاصيل استخدام كافية لإثبات أن ذاكرة التخزين المؤقت تعمل بشكل صحيح.
يجب أن يكون الحد الأقصى البالغ 272 ألفًا جزءًا من مخطط البنية، وليس مجرد حاشية في فقرة التسعير. فالطلب الذي يعتبر آمنًا عند بقائه دون هذا الحد يمكن أن يصبح أكثر تكلفة بشكل جوهري عند تجاوزه. يجب على الفرق تسجيل الرموز المدخلة، والرموز المخزنة مؤقتًا، والرموز المخرجة، ومعرّف النموذج، وإعدادات الاستدلال، وما إذا كان الطلب قد تجاوز الحد الأقصى أم لا. يدعم هذا السجل نموذج التكلفة الحقيقي ويجعل من الممكن اكتشاف التضخم العرضي في التكلفة قبل أن يصبح مفاجأة شهرية.
أسئلة حول ترحيل واجهة برمجة التطبيقات (API) تستحق إجراء اختبار تجريبي
قبل نقل عملية تكامل قائمة إلى GPT-6 Sol، قم بإنشاء نظام اختبار تجريبي يعيد تشغيل عينة صغيرة ومجهولة الهوية. قارن بين النص النهائي، والحقول المنظمة، وطلبات الأدوات، وأسباب الإيقاف، واستخدام الرموز. لا تقارن الشاشة الأولى من الاستجابة فقط. فقد يحافظ النموذج على النتيجة الظاهرة مع تغيير اسم أحد الحقول، أو حذف حالة خطأ، أو إرجاع وسيطة أداة لا يمكن للتطبيق تنفيذها بأمان.
لا تُعد «الردود» و«إكمالات الدردشة» تسميات قابلة للتبادل في خطة التكامل. فكل من دعم نقاط النهاية، وإعدادات الاستدلال، وسلوك الأداة، وأحداث البث، وكائنات الأخطاء، كلها عوامل تؤثر على المُكيِّف. قم بتثبيت معرّف النموذج في التكوين، مع الحفاظ على ظهوره في السجلات وتقارير الاختبار. عند فشل الطلب، يجب أن يُظهر السجل نقطة النهاية، والنموذج، ومجهود الاستدلال، وإصدار المطالبة، وحجم الطلب، وقرار إعادة المحاولة. تتيح هذه الأدلة للمهندس إعادة إنتاج الفشل بدلاً من الجدل حول ما إذا كان النموذج يمر ببساطة بيوم سيئ.
تُغير المعالجة الدفعية الجوانب الاقتصادية وإيقاع العمل. وقد تكون مناسبة للتصنيف الليلي، أو إعداد المستندات، أو قائمة انتظار عمليات التحويل ذات الأولوية المنخفضة. لكنها غير مناسبة للإجراءات التفاعلية التي تتطلب استجابة موجهة للمستخدم. كما تؤثر الأوضاع السريعة والإقليمية على حساب السعر. تعامل مع هذه الخيارات على أنها خيارات تكوين صريحة، وقم بتضمينها في ورقة عمل الميزانية بدلاً من إخفائها ضمن الإعدادات الافتراضية.
إعادة تشغيل المدخلات التمثيلية، والتحقق من صحة المخرجات المنظمة، وتسجيل معلمات الأداة، ومقارنة أسباب التوقف، وقياس استخدام الرموز، واختبار مسار فشل واحد قبل تغيير الإعداد الافتراضي في بيئة الإنتاج.
الجودة والسلامة وتكلفة المراجعة
انخفاض سعر التوكن لا يعني تلقائيًّا انخفاض التكلفة الإجمالية، كما أن النموذج الأغلى ثمناً لا يؤدي تلقائيًّا إلى نتائج تجارية أفضل. تشمل التكلفة الإجمالية عمليات إعادة المحاولة، والمراجعة البشرية، ومعالجة الحوادث، والعمل المطلوب لإصلاح البيانات في المراحل اللاحقة. والمقياس المفيد هو التكلفة لكل نتيجة مقبولة، مقسمةً حسب فئة المهام. فالمسار الذي يكون تكلفته أعلى قليلاً لكل طلب يمكن أن يكون هو الأفضل إذا كان يقلل من حجم أعمال الإصلاح في المهام ذات التأثير الكبير؛ أما المسار الرخيص جدًّا فيمكن أن يكون هو الأفضل بشكل قاطع في حالات الاستخراج الحتمي مع التحقق القوي من الصحة.
ينبغي تصنيف المخاطر حسب الإجراء، وليس حسب العلامة التجارية للنموذج. فإن قراءة وثيقة عامة وصياغة ملخص لها يختلف عن تعديل سجل أحد العملاء، أو الموافقة على دفعة مالية، أو حذف البيانات، أو نشر بيان قانوني. ضع الإجراءات التي لا رجعة فيها تحت رقابة بشرية أو خطوة تحقق مستقلة ثانية. اطلب من النموذج تحديد أوجه عدم اليقين، لكن لا تعامل أبدًا جملة تبدو واثقة على أنها نظام ترخيص.
تندرج المسائل المتعلقة بالخصوصية والاحتفاظ بالبيانات ضمن مراجعة النشر. تأكد من البيانات التي يتم إرسالها، ومدة الاحتفاظ بالسجلات، ومن يمكنه الاطلاع على المطالبات، وما إذا كان الطلب يحتوي على معلومات سرية أو شخصية. قم بحجب المعلومات حيثما أمكن، وقلل السياق إلى أدنى حد، واحتفظ بسجل واضح بالحقول التي تمت إزالتها. تنطبق هذه الضوابط سواء تم استخدام النموذج من خلال واجهة برمجة تطبيقات (API) رسمية أو أي مسار آخر متوافق.
كيفية مقارنة GPT-6 Sol بـ GPT-6 Luna
تتمثل المقارنة العادلة في الحفاظ على ثبات المهمة وقاعدة القبول، مع السماح لكل نموذج بالاستفادة من نقاط قوته الموثقة. قم بتشغيل نفس حزمة الإدخال، ولكن سجل ما إذا كان النموذج يحتاج إلى إعداد استدلال مختلف أو نقطة نهاية مختلفة. أبلغ عن الاختلافات بوضوح: فقد ينتج أحدهما تصحيحًا أكثر اكتمالًا، وقد يكون آخر أرخص من حيث تكلفة الاستخراج المتكرر، وقد يكون ثالث أسهل في التكامل لأن عقد أداته يتوافق مع المحول الحالي الخاص بك.
لا تحوّل مهمة واحدة ناجحة إلى تصنيف عام. فالمهام الثلاث الصغيرة مفيدة لاكتشاف المشكلات المتعلقة بسير العمل، وليست لإثبات وجود فائز شامل. كرر المهمة باستخدام عدة مدخلات واقعية، وقم بتضمين حالة معادية أو غير مكتملة واحدة على الأقل، وحدد مسبقًا ما يُعتبر نجاحًا. إذا كانت العينة صغيرة جدًّا بحيث لا تدعم استنتاجًا، فاذكر ذلك. فهذا الحد يزيد الثقة بدلًا من إضعاف المراجعة.
طرح تدريجي يتيح إمكانية التراجع عن القرار
ابدأ بحركة مرور تجريبية أو قائمة انتظار غير حاسمة. دع المسار الجديد يقدم إجابة بينما يظل المسار الحالي هو المرجع الموثوق. قارن معدل القبول وتكلفة الرموز ووقت المراجعة وفئات الفشل لفترة محددة. ثم انقل مجموعة مهام واحدة في كل مرة، مع الاحتفاظ بمفتاح الرجوع إلى الإصدار السابق وعلامة إصدار فورية. يؤدي النشر التدريجي إلى تحويل اختيار النموذج إلى تغيير هندسي قابل للملاحظة بدلاً من استبدال يتم في يوم واحد.
أثناء عملية النشر، انتبه إلى التغييرات التي لا تظهر في معدل النجاح البسيط: مخرجات أطول، أو المزيد من استدعاءات الأدوات، أو المزيد من حالات التصعيد، أو المزيد من الطلبات التي تتجاوز عتبة السياق الطويل. فقد يبدو النموذج دقيقًا في حين أنه يستهلك ميزانية أكبر أو يزيد من عبء العمل على المشغلين. أضف تنبيهات لتلك الأبعاد وراجعها مع الأشخاص الذين يتعاملون فعليًّا مع الاستثناءات.
كيف يبدو النجاح
النجاح هو مسار مستقر بتكلفة معروفة، وطريقة فشل واضحة، وعملية مراجعة يمكن للناس اتباعها. ولا يتطلب الأمر التظاهر بأن النموذج مثالي. بل يتطلب معرفة المهام التي يتعامل معها النموذج بشكل جيد، والمهام التي تحتاج إلى مسار آخر، وكيفية إيقافه أو تصحيحه عندما تكون المدخلات غير كاملة. وهذا هو المعيار العملي الذي تستند إليه الملاحظات والوثائق التي تم جمعها في هذه المراجعة.
ما الذي يمكن أن تخبرك به ردود الفعل العامة وما الذي لا يمكنها أن تخبرك به
تم تضمين المصادر التالية باعتبارها ردود فعل عامة منسوبة إلى أصحابها، وليس كوثائق رسمية أو أدلة مرجعية خاضعة للرقابة. وتُظهر عناوينها ما اختار كل منشئ محتوى اختباره أو شرحه؛ وهي لا تُثبت نتيجة شاملة للسوق بأكمله.
- نيت هيرك | الأتمتة بالذكاء الاصطناعي: قمت باختبار Opus 5.5 مقابل GPT-6 Sol في 10 حالات استخدام حقيقية. تعامل مع طريقة عرض الموضوع وأي توضيح على أنه تجربة ذلك المبدع، لا كمعيار عام.
- Arena AI: GPT-6 Sol | الانطباعات الأولى. تعامل مع طريقة عرض الموضوع وأي توضيح على أنه تجربة ذلك المبدع، لا كمعيار عام.
- Chase AI: GPT 6 Sol وLuna أصبحتا متوفرتين (وبسعر أرخص من طراز 50%!). تعامل مع طريقة عرض الموضوع وأي توضيح على أنه تجربة ذلك المبدع، لا كمعيار عام.
هناك مسألة أخرى تتعلق بالتسمية تكتسب أهمية هنا: تستخدم العديد من مقاطع الفيديو العامة مصطلحي “GPT-6” و“GPT-5.6” بالتبادل في عناوينها. احرص على إظهار معرّف النموذج الدقيق عند إعادة ذكر أي ادعاء. الـ مقارنة بين GPT-6 Astra و GPT-5.6 Sol وهذا مثال مفيد يوضح سبب ضرورة تسجيل هوية المزود وعلامة المنصة والمسار بشكل منفصل.
كيفية الوصول إلى GPT-6 Sol
افتح مساحة عمل GPT-6 Sol ابدأ بمهمة يمكنك تقييمها: مثال برمجي صغير، أو حزمة مصدر قصيرة، أو موجز استخراج منظم. احرص على إبقاء الناتج المطلوب وقواعد القبول مرئيين أثناء مقارنة المراجعات. أسعار الرموز الرسمية المذكورة أعلاه تصف الاستخدام المباشر لواجهة برمجة التطبيقات (API)، ولا تمثل أي وعد بشأن أرصدة مساحة العمل أو حصص الاشتراك.
للاطلاع على سياق تسمية المنصات الحالية وتخصيص الفضل بشكل منفصل، انظر دليل أسعار GPT-5.6 و مقارنة بين طرازي GPT-5.6. تلك الصفحات تمثل سياقًا خاصًّا بالمنصة أو تحريريًّا؛ وهي لا تلغي جدول أسعار واجهة برمجة التطبيقات (API) الخاص بـ OpenAI.
أحضر مهمة تمثيلية وقارن النتيجة بمعايير القبول الخاصة بك.
فتح مساحة عمل GPT-6 Solمن الذي ينبغي أن يختار GPT-6 Sol؟
إذا كانت قائمة المرشحين النهائيين الخاصة بك تتضمن خيارات أقل تكلفة، فقم بمقارنة كتالوج نماذج أكثر شمولاً بدلاً من افتراض أن أحدث طراز هو الأفضل من حيث القيمة تلقائيًا. إذا كنت تقيّم مهام تتطلب معالجة كميات كبيرة من البيانات، فإن دليل نموذج تحليل البيانات يوفر منظورًا منفصلاً لسير العمل.
الأسئلة الشائعة
ما هو GPT-6 Sol؟
يُعد GPT-6 Sol نموذجًا معقدًا للترميز وسير العمل التفاعلي من OpenAI. ومعرّف النموذج الرسمي لواجهة برمجة التطبيقات (API) الخاص به هو gpt-6-sol.
كم تبلغ تكلفة GPT-6 Sol؟
يُدرج OpenAI نموذج GPT-6 Sol بسعر $2.00 لكل مليون رمز إدخال، و$0.20 لكل مليون رمز إدخال مخزّن مؤقتًا، $2.50 لكل مليون عملية كتابة في ذاكرة التخزين المؤقت، و$10.00 لكل مليون رمز إخراج وفقًا للأسعار القياسية.
ماذا يحدث عندما يتجاوز عدد الرموز المدخلة 272 ألف رمز؟
عندما يتجاوز الطلب 272 ألف رمز إدخال، يقوم OpenAI بتطبيق معدلات إدخال وذاكرة تخزين مؤقت تبلغ ضعف المعدل الأصلي، ومعدلات إخراج تبلغ 1.5 ضعف المعدل الأصلي، على الطلب بأكمله.
ما هي حدود السياق والنتائج؟
يُشير GPT-6 Sol إلى نافذة سياق تضم 1,050,000 توكن، وحد أقصى للإدخال يبلغ 922,000 توكن، وحد أقصى للإخراج يبلغ 128,000 توكن.
ما هو الحد الأدنى المطلوب من المعرفة؟
تشير صفحة النموذج OpenAI الحالية إلى أن تاريخ 20 أبريل 2026 هو تاريخ انتهاء تحديث المعرفة لنموذج GPT-6 Sol.
ما هي إعدادات الاستدلال المتاحة؟
توثق واجهة برمجة التطبيقات (API) مستويات الجهد المنطقي التالية: «لا شيء»، و«منخفض»، و«متوسط»، و«مرتفع»، و«xمرتفع»، و«أقصى»، مع اعتبار «متوسط» هو الإعداد الافتراضي.
ما هي نقاط نهاية واجهة برمجة التطبيقات (API) المدعومة؟
يدعم GPT-6 Sol ميزات إكمال المحادثات، والردود، والمعالجة المجمعة. ولا تذكر صفحة النموذج أن الميزات التالية مدعومة: المعالجة في الوقت الفعلي، والمساعدون، والصوت، والفيديو، وتوليد الصور، والتضمينات، والضبط الدقيق، والإشراف، أو ميزات الإكمال القديمة.
هل يمكن لـ GPT-6 Sol استقبال الصور؟
نعم. تضم صفحة النموذج إدخالًا نصيًّا وصوريًّا مع إخراج نصي. وهذا لا يجعله نموذجًا لتوليد الصور.
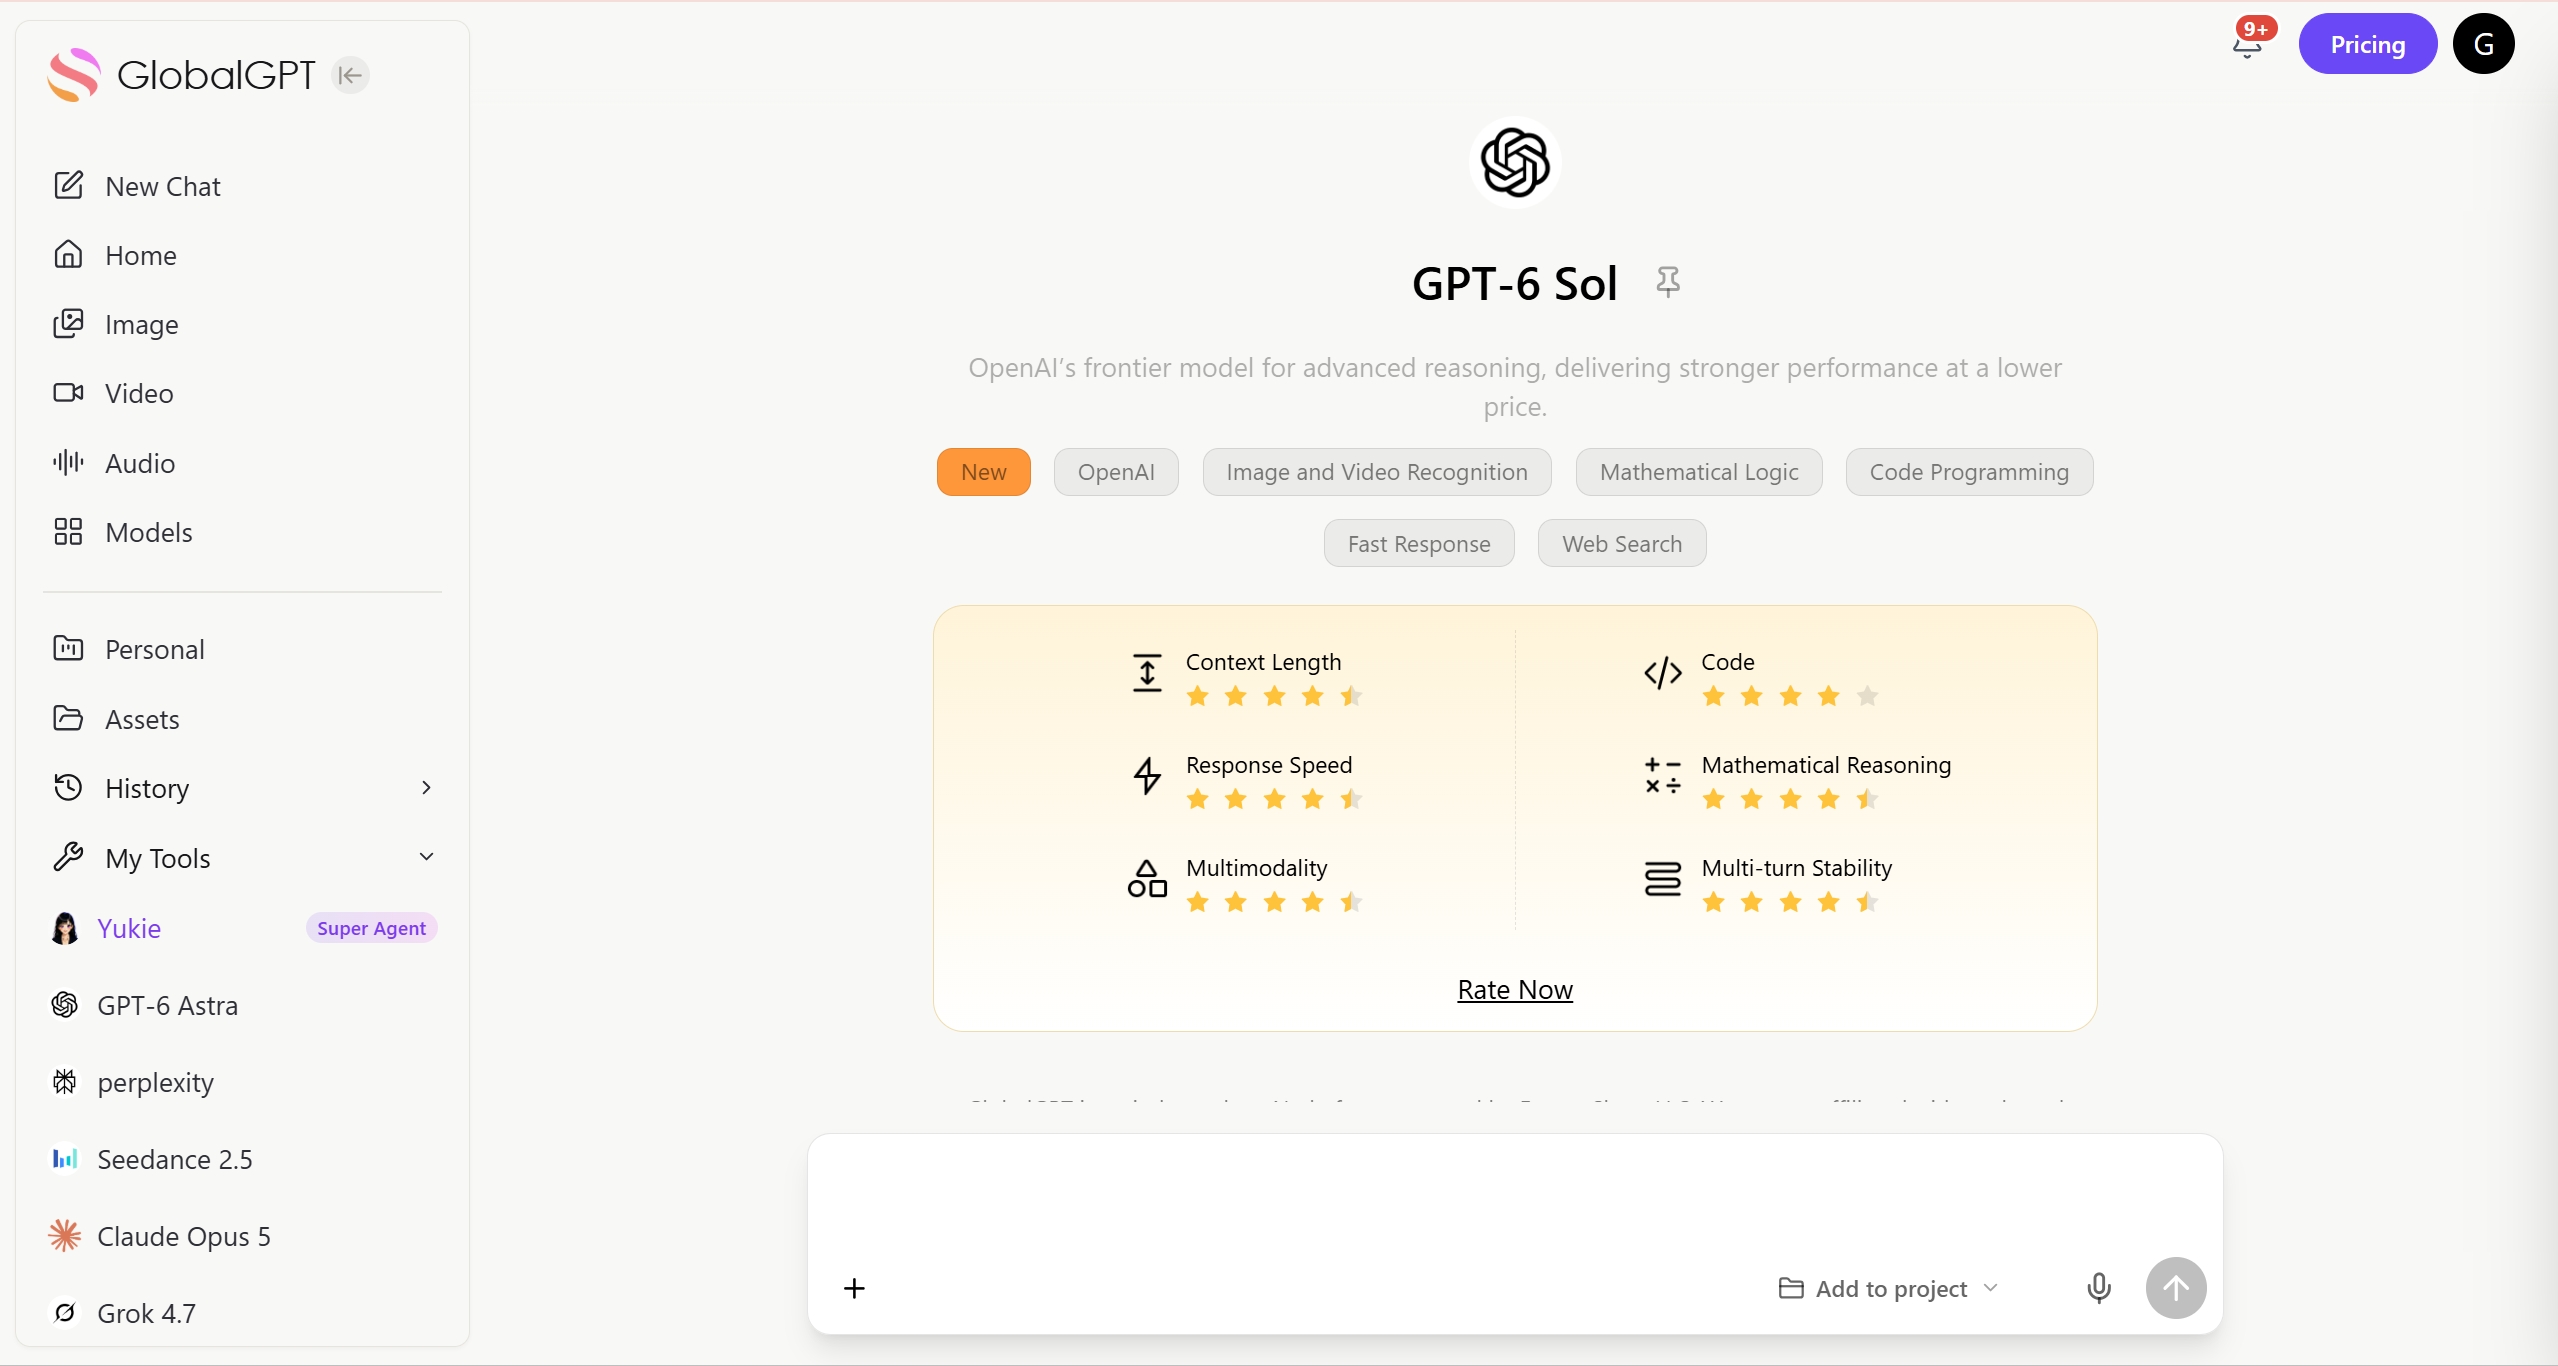
هل يتوفر GPT-6 Sol في GlobalGPT؟
استخدم صفحة نموذج GPT-6 Sol المخصصة المرتبطة أعلاه. تعتبر أرصدة مساحة العمل ومخصصات الباقات منفصلة عن أسعار رموز API المباشرة الموضحة في هذه المراجعة.
هل يتضمن هذا المقال مقياسًا مرجعيًّا؟
وهي تتضمن ثلاث ملاحظات حول مهام صغيرة، وليست اختبارًا قياسيًّا خاضعًا للرقابة. واحتاجت «لونا» إلى تعديل توجيهات البرمجة عند إعادة المحاولة. ولا تُثبت هذه النتائج وجود فائز مطلق أو أداءً على نطاق واسع.
الحكم النهائي
يُعد Sol النموذج الذي يجب النظر فيه عندما يكون العمل معقدًا حقًّا، أو يعتمد بشكل كبير على الأدوات، أو يركز على الكود، وتكون التكلفة المرتفعة للرموز مقبولة. تجمع الأدلة هنا بين الوثائق الرسمية وعينة المهام الصغيرة الخاصة بنا، وليست معيارًا مقارنة خاضعًا للرقابة، لذا فإن الحكم المسؤول هو أن هذا النموذج مناسب، وليس تصنيفًا شاملاً. اختر على أساس النتائج المقبولة والتكلفة التشغيلية الإجمالية، ثم أعد النظر في اختيارك عندما يتغير حجم العمل لديك.
تم التحقق في 23 سبتمبر 2026. الحقائق الرسمية: OpenAI Developers. تسمية مسار المنصة: GlobalGPT. رد فعل الجمهور: تم إدراج روابط للمبدعين والمنشورات، مع ذكر المصادر فقط.









