
يُعد GPT-6.1 Sol القيمة الافتراضية؛ أما GPT-6 Astra فهو الحد الأقصى للجودة. يتميز كلاهما بنفس نافذة السياق التي تضم 1,050,000 رمز، وحد أقصى للإخراج يبلغ 128,000 رمز، وإدخال متعدد الوسائط، ومجموعة أدوات واسعة. والفرق الحاسم يكمن في التموضع والسعر: تبلغ تكلفة Sol $2 لكل مليون رمز مدخل و$10 لكل مليون رمز مخرج، بينما تبلغ تكلفة Astra $10 و$50. بعبارة أخرى، يجب على Astra أن تخلق قيمة إضافية كافية لتبرير تكلفة الرموز القياسية الأعلى بخمس مرات.
وهذا لا يجعل “سول” «نفس الطراز بسعر أقل». تصف شركة OpenAI طراز «أسترا» بأنه أكثر طرازاتها كفاءةً لأصعب الأعمال من البداية إلى النهاية، وتصف «سول» بأنه يقدم أداءً قريبًا من «أسترا» في الأعمال المعقدة بتكلفة أقل. لذا، فإن القرار الصحيح هو مسألة تقييم، وليس مجرد عملية ترتيب للعلامات التجارية. تستخدم هذه المقارنة وثائق GPT-6.1 Sol, ، صفحة نموذج GPT-6 Astra, ، وسيناريوهات التكلفة المطابقة التي تم التحقق منها في 9 أكتوبر 2026.
GPT-6.1 Sol مقابل GPT-6 Astra: مقارنة سريعة
يُسهّل الجدول اتخاذ القرار الأول: إذا لم تكن لديك بعد أدلة خاصة بالمهمة، فإن «سول» تستحق أن تُجرب أولاً لأنها تحافظ على ميزات الواجهة والسعة الرئيسية مع خفض تكلفة الرموز بشكل كبير. أما «أسترا» فتصبح الخيار العقلاني عندما يكون العمل صعباً بشكل غير عادي، أو عندما تكون عواقب الإجابة الخاطئة كبيرة، أو عندما تؤدي نتائجها الأقوى إلى تجنب عدة جولات من المراجعة البشرية أو مراجعة النموذج.
وهذا يختلف عن مقارنة «سول» بنموذج صغير وسريع. فالتوجيهات الحالية من الشركة بشأن فئة «OpenAI» تضع «سول» في مقدمة الفئة، وليس في أدنى فئة من حيث السعر. ويمكن للقراء الذين يختارون من بين المجموعة الكاملة أيضًا الاستعانة بـ دليل لأفضل نماذج الذكاء الاصطناعي و مراجعة GPT-6 Luna لمعرفة متى يكفي استخدام طراز أخف وزنًا.
ما يشترك فيه كل من GPT-6.1 Sol وGPT-6 Astra
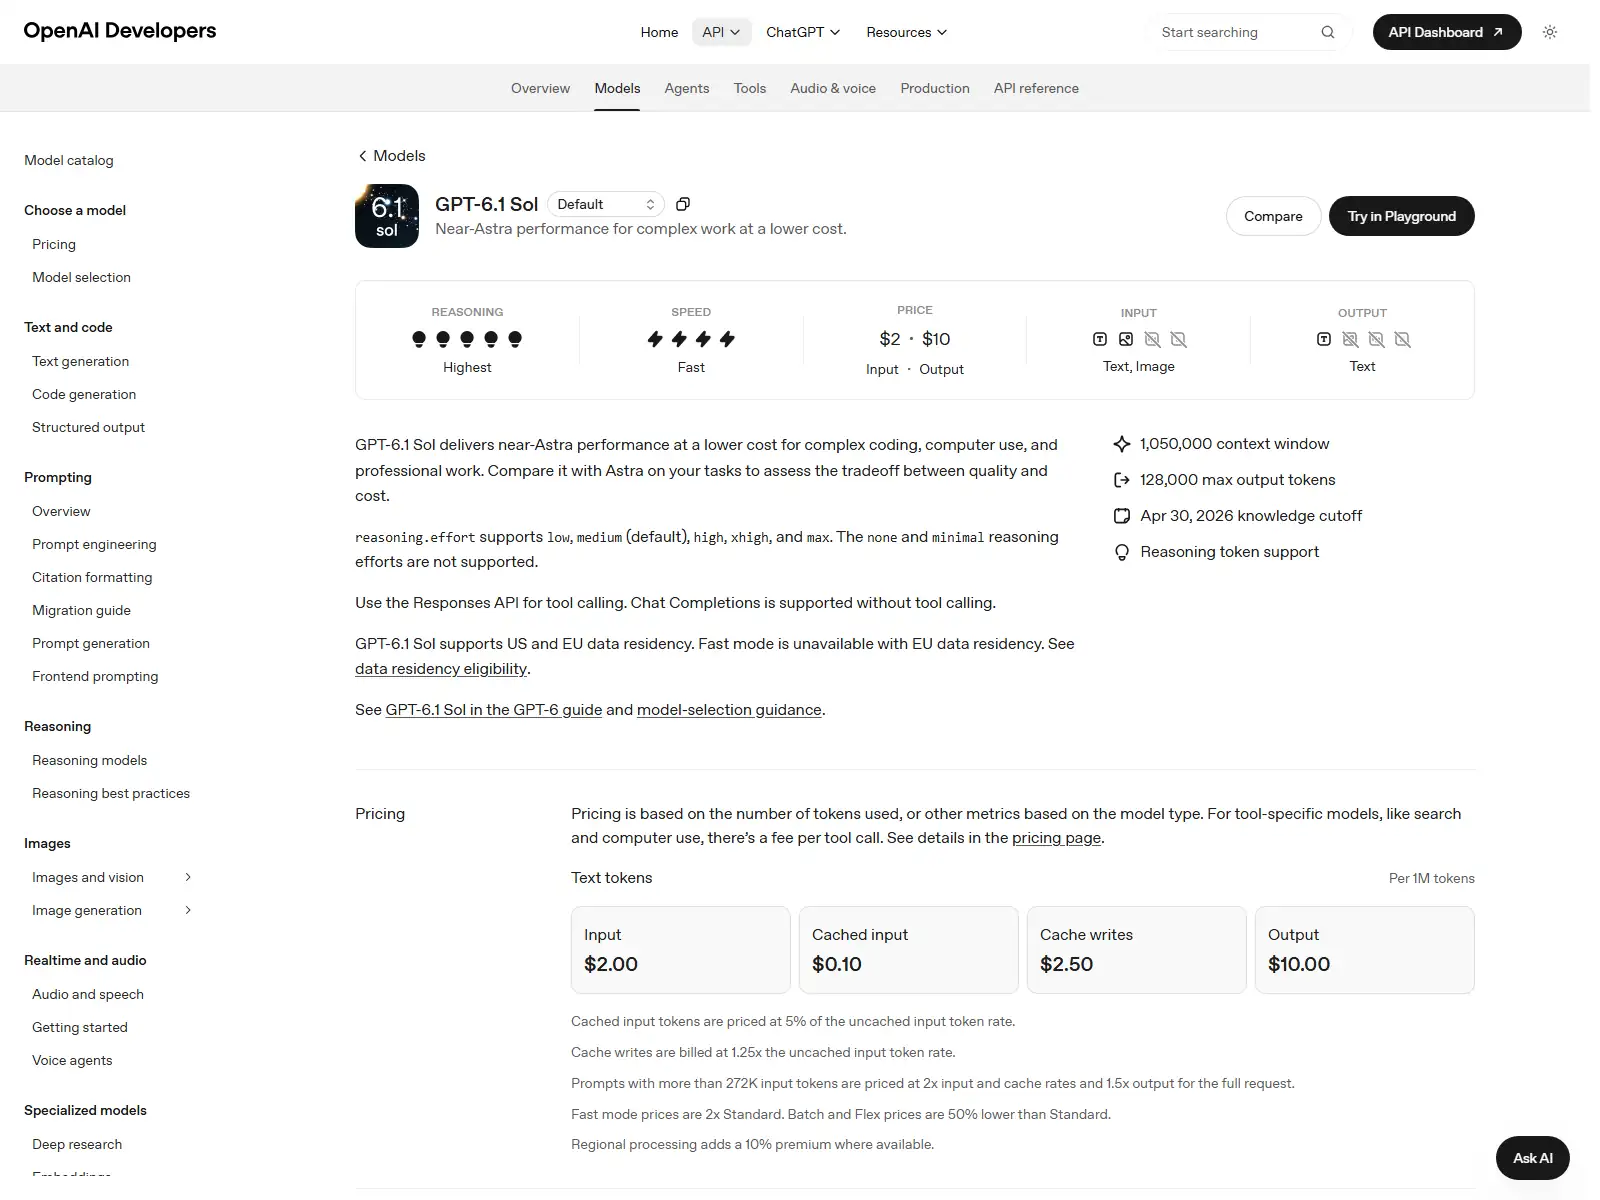
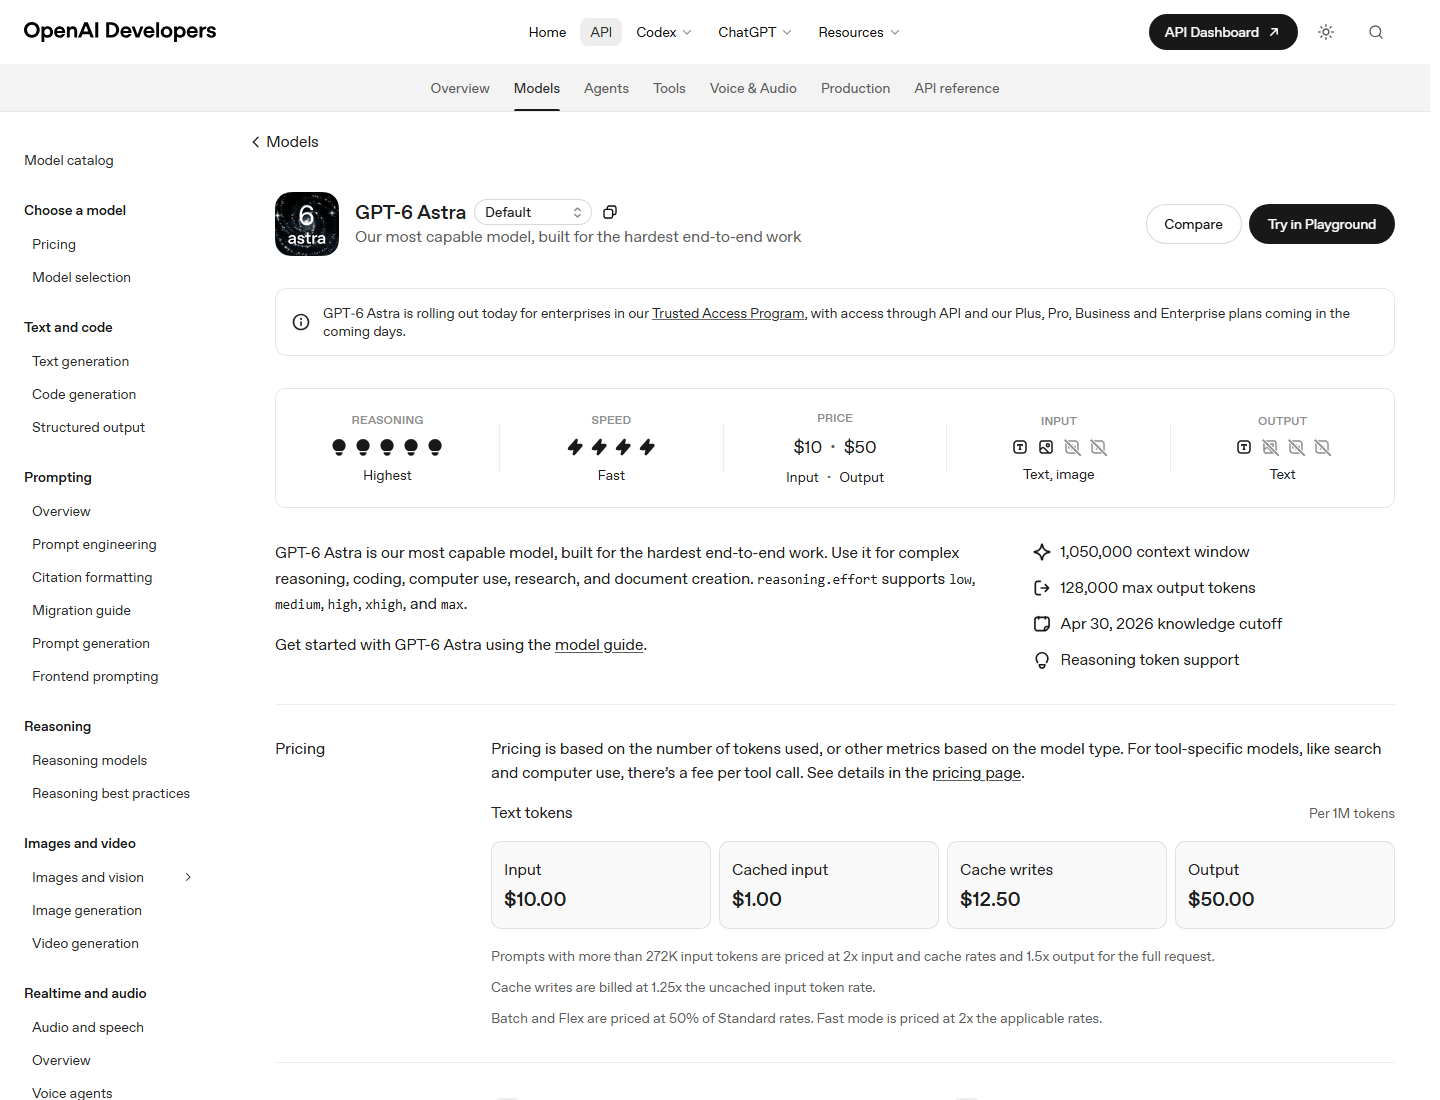
تُدرج صفحتا النموذجين الرسميتين نفس نافذة السياق، والحد الأقصى للإدخال، والحد الأقصى للإخراج، وعتبة المعرفة. ويقبل كلا النموذجين النصوص والصور ويُنتجان نصًا. ولا تدرج أي منهما الصوت أو الفيديو كمدخلات أو مخرجات أصلية للنموذج. كما تشتركان في مستويات الجهد الاستدلالي المنخفض والمتوسط والعالي وxhigh والقصوى، مع تعيين المستوى المتوسط كقيمة افتراضية. ويؤدي هذا التماثل إلى تبسيط اختبارات A/B، حيث يمكن للتطبيق الحفاظ على ثبات معظم معلمات الطلب مع تغيير معرّف النموذج فقط.
يدعم كلا النموذجين المخرجات المنظمة، واستدعاء الدوال، والبحث على الويب، والبحث في الملفات، وتوليد الصور، ومترجم الأكواد، وبيئة التشغيل المستضافة، وتطبيق التصحيحات، واستخدام الكمبيوتر، وMCP، والمهارات، والبحث عن الأدوات. يدرج النموذج OpenAI استدعاء الأدوات عبر واجهة برمجة تطبيقات «Responses API»؛ بينما تتوفر ميزة «Chat Completions» في الحالات التي لا تتضمن استخدام أدوات. لا يتم دعم الضبط الدقيق في أي من صفحتي النموذجين. هذه إعلانات عن القدرات، وليست وعودًا بأن النموذجين سيختاران الأدوات بنفس الدقة.
نافذة السياق التي تتسع لمليون رمز هي سعة، وليست إذنًا بتجاهل تصميم عملية الاسترجاع. فالطلبات الطويلة جدًّا تكون أكثر تكلفة، وأصعب في تصحيح الأخطاء، وتخضع لخطوة التسعير عند تجاوز 272 ألف رمز إدخال. ولا تزال عمليات التقسيم إلى أجزاء، والاسترجاع، والملخصات، والتخزين المؤقت للموجهات أمورًا مهمة. وينطبق التحذير نفسه على الحد الأقصى للإخراج البالغ 128 ألف رمز: فالنتائج الصغيرة القابلة للتحقق منها عادةً ما تكون أكثر أمانًا من استجابة واحدة ضخمة.
التسعير: فجوة الخمسة أضعاف
وفقًا للأسعار القياسية، تبلغ تكلفة GPT-6.1 Sol $2 لكل مليون رمز إدخال غير مخزّن في ذاكرة التخزين المؤقت، و$0.10 للرموز المدخلة المخزّنة في ذاكرة التخزين المؤقت، و$2.50 لعمليات الكتابة إلى ذاكرة التخزين المؤقت، و$10 للمخرجات. تبلغ تكلفة GPT-6 Astra $10 و$1 و$12.50 و$50 على التوالي. يُعد Sol أرخص بخمس مرات بالنسبة للمدخلات غير المخزنة مؤقتًا، وعمليات الكتابة إلى ذاكرة التخزين المؤقت، والمخرجات؛ أما المدخلات المخزنة مؤقتًا فهي أرخص بعشر مرات. الأرقام الحالية مأخوذة مباشرةً من صفحات نماذج OpenAI و وثائق تسعير واجهة برمجة التطبيقات (API).
نسبة العنوان ليست هي التكلفة الإجمالية. بمجرد أن يتجاوز الطلب 272 ألف رمز إدخال، تطبق فئة OpenAI ضعف معدلات الإدخال والتخزين المؤقت العادية و1.5 ضعف معدل الإخراج العادي على الطلب بأكمله. يُحدد سعر كل من «Batch» و«Flex» بـ 50% من الفئة القياسية، بينما يُحدد سعر «Fast» بضعف السعر المطبق. كما تقدم «Astra» فئة «Ultrafast». قارن بين ما هو متشابه: لا يكشف طلب «Sol Batch» وطلب «Astra Fast» عن نسبة السعر إلى النموذج الأساسية.
للاطلاع على تفاصيل أكثر شمولاً عن الفئة الرئيسية، انظر دليل أسعار GPT-6 Astra. السابق تحليل أسعار GPT-6 Sol وهذا مفيد عند التخطيط للانتقال من الجيل السابق من Sol، لكن تقديرات الإنتاج يجب أن تستخدم معرّف النموذج الحالي بالضبط والمعدلات الحالية.
التصميم القائم على السياق الطويل: نفس السعة، اقتصاديات مختلفة
قد تجعل نافذة السياق المتطابقة التي تضم 1,050,000 رمزًا كل من «سول» و«أسترا» يبدوان متبادلين في الأعمال التي تتضمن كميات كبيرة من المستندات، لكن السعة ليست سوى القيد الأول. فالطلب الذي يقترب من الحد الأقصى لا يزال يتعين عليه تحديد الدليل الصحيح، والتمييز بين التعليمات والمواد المقتبسة، والحفاظ على العلاقات عبر العديد من الملفات، وإرجاع نتيجة يمكن لأي شخص أو برنامج التحقق منها. والنموذج الذي يحمل الاسم الأكبر لا يلغي الحاجة إلى هندسة المعلومات. لذا، يجب تنظيم المصادر، وتحديد الحدود، وطلب الإحالات المرجعية إلى معرّفات مستقرة للوثائق.
يحدد معدل سول المنخفض أي التجارب ذات السياق الطويل تكون مجدية من الناحية الاقتصادية. يمكن للفريق اختبار عدة استراتيجيات لتقسيم النص إلى مقاطع، وعتبات استرجاع، وتنسيقات ملخصات، بتكلفة تشغيل واحد لنظام «أسترا». ويمكن لهذا البحث الأوسع نطاقًا أن يحسّن أداء النظام حتى لو تفوقت «أسترا» في موجه واحد فقط. تصبح «أسترا» أكثر جاذبية بعد أن يستقر سير العمل وتصبح الأخطاء التي لم يتم حلها مقيدة فعليًّا بالنموذج. في المراحل المبكرة من التطوير، قد يؤدي إنفاق الميزانية بالكامل على عدد قليل من الاستدعاءات الرئيسية إلى تحقيق تعلم أقل مقارنةً بإجراء تقييم منضبط باستخدام «سول» عبر العديد من الحالات التمثيلية.
يستحق الحد الأقصى البالغ 272 ألفًا مراقبةً دقيقة. فالطلب الذي يحتوي على 271 ألف رمز إدخال والطلب الذي يحتوي على 273 ألفًا متقاربان في الحجم، لكن الطلب الثاني ينقل الطلب بأكمله إلى النطاق الأعلى. قم بإجراء تقدير مسبق لعدد الرموز وتسجيل النطاق الذي استخدمته كل مهمة. إذا تجاوزت المدخلات الحد بقليل، فإن إزالة النصوص النمطية المكررة، أو سجل المحادثات القديمة، أو المقاطع المسترجعة ذات القيمة المنخفضة قد يقلل التكلفة بشكل ملموس دون الإضرار بالجودة. ينطبق هذا التحسين على كلا النموذجين، على الرغم من أن المعدلات الأساسية الأعلى في Astra تجعل الأخطاء أكثر تكلفة.
يكون التخزين المؤقت الفوري أكثر فائدة عندما تظل البادئة الكبيرة ثابتة عبر المكالمات. ومن الأمثلة على ذلك أدلة السياسات، ومعايير الترميز، وكتالوج المنتجات، أو مخطط أداة مشترك بين العديد من المهام. ضع المحتوى الثابت أولاً، ثم ضع التعليمات المتغيرة لاحقًا عندما يدعم سلوك التخزين المؤقت لواجهة برمجة التطبيقات (API) هذا الترتيب. ثم قم بقياس مرات الوصول إلى ذاكرة التخزين المؤقت بدلاً من افتراضها. تعد ميزة المدخلات المخزنة مؤقتًا في Sol كبيرة بشكل خاص، لكن البادئة المتغيرة باستمرار يمكن أن تلغيها. يجب أن يُدرج تصميم ذاكرة التخزين المؤقت في تقرير المعايير المرجعية جنبًا إلى جنب مع الدقة وزمن الاستجابة.
بالنسبة للبحث وتحليل الوثائق، استخدم سير عمل على مراحل: استرجع الأدلة المحتملة، واطلب من النموذج خريطة أدلة منظمة، وتحقق من صحة المراجع، وعندها فقط اطلب التوليف. استخدم Astra عندما يظل التوليف ضعيفًا بعد أن يكون مسار الأدلة سليمًا، أو عندما تحتوي مجموعة المصادر على تناقضات دقيقة بشكل غير معتاد. وهذا يفصل بين حالات الفشل في الاسترجاع وحالات الفشل في الاستدلال. وبدون هذا الفصل، غالبًا ما تضطر الفرق إلى دفع ثمن نموذج أكثر قدرة لتعويض مشكلة في بناء السياق كان من الممكن تجنبها.
البرمجة واستخدام الأدوات
فيما يتعلق بالبرمجة، فإن السؤال المهم ليس “أي نموذج يمكنه كتابة الكود؟”؛ فكلاهما قادر على ذلك. بل السؤال هو: في أي الحالات تؤدي القدرات الإضافية التي يتمتع بها «أسترا» إلى تغيير النتيجة؟ يُعد «سول» خيارًا جذابًا لأعمال المستودعات الشائعة: مثل تنفيذ الميزات المحددة النطاق، وتشخيص الأخطاء القابلة للتكرار، ومراجعة طلبات السحب، وكتابة الاختبارات، وتحويل البيانات، وتشغيل حلقات الأدوات التكرارية. ويتيح سعره المنخفض إجراء المزيد من المحاولات، والمزيد من عمليات التحقق، ومجموعات تقييم أكبر بنفس الميزانية.
من الأفضل الاحتفاظ باستخدام «أسترا» للمهام التي يسودها الغموض والحاجة إلى التنسيق: مثل عملية ترحيل إلى مستودع أحادي غير مألوف، أو مراجعة بنية حساسة من الناحية الأمنية، أو استخدام الحاسوب على المدى الطويل، أو عملية تحويل صعبة بين لغات البرمجة، أو حادث في بيئة الإنتاج مع أدلة غير كاملة. وقد يكون النموذج الأكثر كفاءة يستحق تكلفته الإضافية عندما تمنع خطة واحدة صحيحة ساعات من إعادة العمل. إن أفضل نموذج ذكاء اصطناعي لمقارنة الأكواد البرمجية يشرح لماذا تعتبر اختبارات المستودع أكثر أهمية من الانطباعات العامة المتعلقة بالبرمجة.
- ميزات محددة النطاق مع اختبارات قبول واضحة
- التصحيح الروتيني ومراجعة الكود
- حلقات الوكلاء ذات الحجم الكبير
- مسودات عمليات الترحيل وإعادة الهيكلة
- إنشاء الاختبارات وتوثيقها
- أعطال جسيمة بعد محاولة «سول»
- التغييرات الأمنية أو المتعلقة بالبيانات التي تنطوي على مخاطر عالية
- بنية غامضة تشمل أنظمة متعددة
- المهام الطويلة التي تتطلب استخدام الكمبيوتر بشكل مستقل
- المراجعة النهائية عندما تكون الأخطاء مكلفة
لا تحكم على أي من النموذجين استنادًا إلى كود يبدو معقولاً فحسب. زود كلا النموذجين بنفس اللقطة من المستودع، والتعليمات، والأدوات، والوقت المخصص، والاختبارات. سجل معدل النجاح، والتصحيحات البشرية، وفشل استدعاء الأدوات، والرموز، وزمن الاستجابة، والتكلفة. قد يكون النموذج الذي يكلف خمسة أضعاف ولكن يقلل عدد المحاولات الفاشلة إلى النصف مبررًا؛ أما النموذج الذي يحسّن الأسلوب دون تحسين القبول فليس كذلك.
أدلة الأداء: ما يمكننا وما لا يمكننا استنتاجه
يقدم التوجيه الاستراتيجي لـ OpenAI ملخصًا قويًا يمكن الدفاع عنه: يُعد Astra النموذج الأكثر قدرة على إنجاز المهام الأكثر صعوبة من البداية إلى النهاية، بينما يهدف GPT-6.1 Sol إلى تحقيق أداء يقترب من أداء Astra في المهام المعقدة بتكلفة أقل. وتدعم هذه التصريحات فرضية الاختيار، وليس فارقًا نسبيًا عامًّا. لا يوجد معيار قياس عام واحد يمكنه التنبؤ بالأداء على مستنداتك أو أدواتك أو سياساتك أو قاعدة الكود الخاصة بك.
تُعد مقاطع الفيديو الترويجية مفيدة لفهم الكيفية التي تُقدّم بها الشركة منتجها، لكنها لا تُعد تقييمات مستقلة. وبالمثل، تُظهر مراجعات المبدعين واجهات حقيقية وأمثلة مفيدة، إلا أن كل مراجعة تعكس مجموعة محددة من التعليمات، وتكوينًا معينًا للأداة، وموعدًا نهائيًا للنشر. تعامل مع الصورة المصغرة الإيجابية أو الحكم الأولي على المنتج باعتباره دليلاً لخطة الاختبار الخاصة بك، وليس دليلاً على أن Astra أو Sol يفوزان في كل فئة.
يوثق مقطع الفيديو الرسمي OpenAI أعلاه التغطية الإعلامية لإطلاق لعبة «أسترا». وتُظهر الصفحة المستقلة الخاصة بـ«مات وولف» أدناه أن اهتمام الأطراف الخارجية سرعان ما تركز على حجم الإصدار. ولم يتم استخدام أي من لقطتي الشاشة هنا كمعيار رقمي. ويتجنب المقال عمدًا تحويل الحماس أو عدد المشاهدات أو لقب المبدع إلى درجة أداء غير مدعومة بأدلة.
تستند المقارنة السليمة إلى استخدام مجموعة تقييم خاصة تشبه بيئة الإنتاج. يجب تضمين مهام سهلة ومهام نموذجية وحالات فشل مكلفة. ويجب إخفاء النتائج عندما يكون لتفضيلات البشر دور مهم. أما بالنسبة للوكلاء، فيجب اختبار قدرتهم على إتمام المهام والتعافي منها بدلاً من التركيز على الاستجابة الأولى. OpenAI’s إرشادات اختيار النموذج كما يوصي بمقارنة النماذج في مهام متطابقة، والاحتفاظ بالنموذج الأقل حجمًا والجهد المنطقي الذي يفي بمعايير الجودة.
كيفية إجراء تقييم عادل بين Sol و Astra
ابدأ بتحديد القرار الذي سيتوصل إليه التقييم. فالسؤال “أي نموذج أكثر ذكاءً؟” غامض للغاية. ومن الأسئلة المفيدة: “أي نموذج ينبغي أن يتولى مراجعة طلبات السحب لهذا المستودع عند مستوى استدلال متوسط؟” أو “هل ينبغي رفع مستوى توليف العقد النهائي من Sol إلى Astra؟” حدد مجموعة المهام، ومستوى الخدمة، وجهد الاستدلال، والأدوات، والحد الزمني، ومعايير القبول قبل إنشاء المخرجات. وإلا، فقد يُعزى الحصول على نتيجة إيجابية إلى التكوين بدلاً من النموذج.
قم بإنشاء مجموعة كبيرة بما يكفي لتشمل الحالات العادية والحالات الحدية ذات المغزى. قد تكشف عشرون مثالاً تم اختيارها بعناية عن حالات فشل واضحة، لكن سياسة التوجيه في بيئة الإنتاج تحتاج عادةً إلى المزيد. اختر عينات من أعمال حقيقية حديثة بعد إزالة البيانات الحساسة، ثم صنف كل حالة حسب الصعوبة والمخاطر. احتفظ بمجموعة احتياطية محمية بكلمة مرور حتى لا يؤدي الضبط السريع إلى الإفراط التدريجي في ملاءمة الأمثلة التي سبق للجميع رؤيتها. قم بترقيم إصدارات مجموعة البيانات وأداة التقييم تمامًا كما تقوم بترقيم إصدارات كود التطبيق.
يفضل إجراء الفحوصات الحتمية كلما سمحت المهمة بذلك. قم بتجميع الكود، وتشغيل الاختبارات، والتحقق من صحة ملف JSON وفقًا لمخطط البيانات، ومقارنة الحقول المستخرجة مع التسميات، والتحقق من المقاطع المقتبسة. يجب أن يركز المصححون البشريون على الصفات التي لا تستطيع الأتمتة التقاطها جيدًا، مثل الوضوح، والحكم، وما إذا كانت التوصية تراعي سياق العمل. قم بإخفاء هوية النموذج وجعل ترتيب المخرجات عشوائيًا. إذا علم المصححون أي إجابة جاءت من Astra، فقد يؤثر السعر والسمعة على النتيجة دون أن يقصد أحد التحيز.
تتبع درجة الخطورة، لا تكتفِ بالمتوسطات فقط. فلا ينبغي أن تفوق عشر مزايا بسيطة في الأسلوب توصية واحدة حاسمة تتعلق بفقدان البيانات. حدد حالات الرفض القاطع مثل الاقتباسات الملفقة، أو الأوامر غير الآمنة، أو الحقول الإلزامية المفقودة، أو عدم الالتزام بقيود قانونية. قم بالإبلاغ عن التوزيع حسب فئة الصعوبة والمخاطر. قد يتعادل Sol مع Astra في المهام العادية ولا يتخلف إلا في أصعب 5 في المائة؛ وهذا النتيجة تدعم بقوة استخدام جهاز توجيه بدلاً من الترحيل الكلي أو عدمه على الإطلاق.
أخيرًا، احسب درجة عدم اليقين وأعد تشغيل الحالات غير المستقرة. قد تختلف مخرجات النموذج، لذا فإن المقارنة التي تُجرى مرة واحدة واحدة تُبالغ في دور الحظ. كرر اختبار مجموعة فرعية، وتحقق من الاختلافات بين المُقيِّمين، واحتفظ بالمخرجات الأولية لأغراض التدقيق. يجب أن تتضمن التوصية النهائية تاريخ الاختبار، ومعرّفات النماذج، والإعدادات، وإصدار مجموعة البيانات، والأسعار المستخدمة، والثغرات المعروفة. أعد النظر فيها بعد تحديث النموذج، أو تغيير المطالبة، أو حدوث تحول ملموس في حجم العمل. اختيار النموذج هو قرار إنتاجي يتم صيانته باستمرار، وليس إنجازًا دائمًا.
لا تدع المُقيِّم يصبح النموذج الخفي المُقرِّر. إذا كان المُقيِّم الآلي يفضل أحد النتائج بشدة، فاختر عينة من تلك القرارات لمراجعتها من قِبل الخبراء وقارن بين المُقيِّم ونتائج القبول المحددة. افصل جودة العرض عن صحة أداء المهمة: فقد يخفي الشرح المُحكم متطلبًا لم يتم استيفاؤه، في حين أن الإجابة الموجزة قد تجتاز كل الاختبارات. قم أيضًا بالإبلاغ عن حالات الامتناع عن التصويت والتعادل بدلاً من فرض فائز. هذه التفاصيل تجعل النتيجة أقل إثارة، لكنها أكثر فائدة بكثير في إعداد الميزانية وتحديد المسار. الهدف هو قاعدة تشغيل قابلة للتكرار يمكن لأي عضو آخر في الفريق فحصها وإعادة إنتاجها. سجل النتائج المرفوضة أيضًا؛ فغالبًا ما تشرح أمثلة الفشل حدود المسار بشكل أوضح من جدول الدرجات المتوسطة.
أمثلة على التكلفة الفعلية
لنفترض أن عملية تشغيل عامل الترميز تتم باستخدام 200,000 رمز إدخال غير مخزّن مؤقتًا و20,000 رمز إخراج. تبلغ تكلفة «Sol» حوالي $0.60: $0.40 للإدخال و$0.20 للإخراج. تبلغ تكلفة Astra حوالي $3.00: $2.00 بالإضافة إلى $1.00. وعلى مدار 10,000 عملية تشغيل، يبلغ الفرق حوالي $24,000 قبل احتساب رسوم الأدوات، والتخزين المؤقت، والزيادات الإقليمية، أو تعديلات مستويات الخدمة.
لنفترض الآن طلبًا ذي سياق طويل يحتوي على 300,000 رمز إدخال و30,000 رمز إخراج. ونظرًا لأن عدد رموز الإدخال يتجاوز 272 ألفًا، فإن المعدلات الأعلى تنطبق على الطلب بأكمله. يصبح معدل الإدخال الفعلي لـ Sol هو $4 لكل مليون، ويصبح معدل الإخراج $15، مما ينتج عنه حوالي $1.65. أما معدل Astra فيصبح $20 للإدخال و$75 للمخرجات، مما ينتج عنه حوالي $8.25. وتبقى العلاقة الخماسية قائمة، لكن الفارق المطلق يزداد.
يمكن أن يؤدي التخزين المؤقت إلى تحويل الحساب بشكل أكبر نحو «سول» (Sol) لأن معدل المدخلات المخزنة مؤقتًا فيه يبلغ عُشر معدل «أسترا» (Astra). وهذا أمر مهم بالنسبة لتعليمات النظام الثابتة، والمراجع المتكررة الكبيرة، وبنية الوكلاء. ومع ذلك، فإن عمليات الكتابة في ذاكرة التخزين المؤقت لا تزال تنطوي على تكلفة، ويمكن أن يؤدي تغيير البادئة إلى تقليل إعادة الاستخدام. قم بالتقدير استنادًا إلى سجلات الاستخدام الفعلية بدلاً من افتراض أن كل رمز سيحصل على معدل التخزين المؤقت.
كيفية مقارنة النماذج في واجهة برمجة التطبيقات (API)
استخدم واجهة برمجة التطبيقات (API) الخاصة بالاستجابات للتطبيقات التي تستخدم الأدوات، وحافظ على تكوين المقارنة كما هو. إن أبسط طريقة مفيدة هي إرسال نفس المدخلات إلى معرّفي النموذجين، وتسجيل بيانات تعريف الاستجابة، وتشغيل نفس أداة التقييم. لا تكشف عن مفاتيح واجهة برمجة التطبيقات (API) في شفرة المصدر؛ بل استخدم متغير بيئة ومدير السر الخاص بك كالمعتاد.
العينة صغيرة عن قصد. يجب أن يقوم نظام الإنتاج بحفظ معرّفات الطلبات، وإصدارات أدوات التقييم، وعمليات التسجيل في المستودع، وتسجيلات الأدوات، وعدد محاولات الإعادة، ونتائج القبول. كما يجب أن يحسب السعر بناءً على فئة الخدمة ونطاق السياق الطويل المستخدم فعليًّا. تجنب السماح لأحد النماذج برؤية تعليقات لم يتلقاها النموذج الآخر، ما لم تكن تختبر تسلسل التوجيه بشكل صريح.
استراتيجية عملية لتحديد مسار الرحلة من «سول» إلى «أسترا»
يقدم الموجه ذو المرحلتين الحجة الاقتصادية الأقوى لصالح «سول» دون التظاهر بأن كل موجه متساوٍ. أرسل حركة المرور العادية إلى Sol باستخدام مستوى متوسط من الاستدلال. قم بالتصعيد عندما تفشل الاختبارات الحتمية، أو عندما يُبلغ النموذج عن ثقة منخفضة، أو عندما تندرج المهمة ضمن فئة عالية المخاطر، أو عندما يطلب شخص ما صراحةً مراجعة من قبل فريق العمل الرئيسي. اجعل قواعد التصعيد قابلة للمراقبة حتى لا تنحرف التكاليف بشكل خفي.
استخدم نفس التعليمات والأدوات واختبارات القبول.
الاختبارات، ومستوى الثقة، وفئة المخاطر، والمراجعة البشرية.
أرسل حالات الفشل أو الأعمال عالية المخاطر إلى Astra.
تتبع معدل القبول، وإعادة العمل، ووقت الاستجابة، والتكلفة الإجمالية.
كما يوفر التوجيه للفرق طريقة منظمة لتحديث الإعدادات الافتراضية. فإذا تحسّن معدل قبول «سول» في مجموعة مهام معينة، فقم بتوسيع حصتها. وإذا نجحت «أسترا» مرارًا في منع حدوث عيوب مكلفة، فقم بتوجيه تلك الفئة مباشرةً. وهكذا تصبح المقارنة سياسة تشغيلية مدعومة بالبيانات، بدلاً من مجرد نقاش نموذجي يُجرى مرة واحدة. للاطلاع على مرجع من الجيل السابق، انظر GPT-6 Astra مقابل GPT-5.6 Sol.
ينتمي كل من زمن الاستجابة والموثوقية إلى سياسة التوجيه نفسها. فقد يقدم النموذج إجابة أقوى، لكنه يظل الخيار الافتراضي الخاطئ إذا كان زمن استجابته يعطل سير العمل التفاعلي، أو إذا كان استنتاجه الأطول يتسبب في انتهاء مهلة المهام. قم بقياس زمن استجابة الرمز الأول، والمدة الإجمالية، واستعادة استدعاء الأداة، والإكمال الناجح في ظل ظروف التزامن الواقعية. ثم حدد هدفًا خدميًّا لكل فئة من المهام. يمكن أن يتولى «سول» (Sol) حركة المرور الإنتاجية الحساسة للوقت بينما تتولى «أسترا» (Astra) المراجعة غير المتزامنة، أو يمكن تبرير العكس إذا كانت مهمة صعبة تفشل بشكل روتيني قبل تصعيدها. قرار النموذج هو قرار تشغيلي، وليس مجرد قرار تحريري.
من الذي ينبغي أن يختار «سول»، ومن الذي ينبغي أن يختار «أسترا»؟
اختر GPT-6.1 Sol للإنتاج الذي يراعي التكلفة
تُعد «Sol» خيارًا مناسبًا لفرق المنتجات والوكالات والباحثين والمطورين الذين يتولون أحجامًا كبيرة من الأعمال الصعبة، مع وجود معايير قبول قابلة للقياس. ويكون هذا النظام مقنعًا بشكل خاص عندما تكون التكرار جزءًا من العملية: مثل حلقات «البرمجة - الاختبار - التصحيح»، ومراجعة الوثائق، والاستخراج مع التحقق من الصحة، وتوليف الأبحاث، والعمليات الداخلية متعددة الخطوات. ويتيح سعره المنخفض تغطية تقييمية أوسع وميزانية أكبر لإعادة المحاولة.
اختر GPT-6 Astra لأصعب المهام التي تتطلب دقة عالية في الجودة
يُعد «أسترا» الخيار الأمثل للفرق التي تنطوي مهامها الأصعب على تكاليف عالية في حالة حدوث أخطاء أو على عمليات فحص آلية ضعيفة. وقد يكون اتخاذ قرار معقد بشأن البنية، أو إجراء مراجعة أمنية نهائية، أو مهمة استدلال علمي مبتكرة، أو سلسلة طويلة من عمليات استخدام الكمبيوتر، مبرراً كافياً للاستثمار في النموذج الرائد. كما أنه الخيار الافتراضي الأكثر دقة خلال مرحلة الاكتشاف المبكرة، عندما لا يكون الفريق على دراية بعد بما قد يفوته النموذج الأصغر، ولا تشكل التكلفة قيداً مباشراً.
استخدم كليهما عندما تختلف صعوبة المهمة
لا ينبغي أن تفرض معظم الأنظمة الناضجة نموذجًا واحدًا على كل طلب. استخدم «سول» (Sol) للجزء الأوسط الواسع، و«أسترا» (Astra) كطبقة تصعيد. أضف «لونا» (Luna) أو نموذجًا أصغر آخر للتصنيف والتحويل القابلين للتنبؤ. يعكس هذا التصميم المتدرج التنوع الفعلي لأعباء العمل، وعادةً ما يكون أكثر اقتصادية من الجدل حول اختيار نموذج واحد دائم. لدينا منهجية اختبار النماذج يقدم إطارًا مفيدًا للتمييز بين الأدلة القابلة للتكرار والانطباعات.
كيفية استخدام GPT-6.1 Sol و GPT-6 Astra على GlobalGPT
يوفر GlobalGPT مسارات منتجات مباشرة لكلا النموذجين داخل مساحة عمل واحدة متعددة النماذج. افتح مساحة العمل، وابدأ محادثة جديدة، وتحقق من أداة اختيار النموذج الحالية لاختيار GPT-6.1 Sol أو GPT-6 Astra. ويُعد الاحتفاظ بكلا النموذجين في واجهة واحدة أمرًا مفيدًا للعمل الاستكشافي جنبًا إلى جنب، في حين يظل تقييم واجهة برمجة التطبيقات (API) هو المسار الأفضل للتقييم الآلي، والتسجيل الدقيق للاستخدام، وضوابط النشر.
ابدأ باستخدام «Sol» في الجولة الأولى، ثم أعد تشغيل المطالبة الأصعب باستخدام «Astra» وقارن التغييرات الجوهرية التي طرأت.
افتتاح GlobalGPTللحصول على معلومات أساسية أكثر تفصيلاً خاصة بالنموذج، يرجى قراءة دليل شرح GPT-6.1 Sol و مراجعة سيارة GPT-6 Astra. تتناول تلك الصفحات كل طراز على حدة؛ أما هذه الصفحة فتركز على قرار الشراء واختيار المسار بينهما.
الأسئلة المتداولة
هل يُعد GPT-6.1 Sol أفضل من GPT-6 Astra؟
ليس بالمعنى المطلق. تُصنف OpenAI نموذج GPT-6 Astra باعتباره النموذج الأكثر كفاءة، بينما يُصنف نموذج GPT-6.1 Sol باعتباره نموذجًا أقل تكلفة يتمتع بأداء يقترب من أداء Astra في المهام المعقدة. يُعد Sol الخيار الأفضل من حيث القيمة إذا كان يفي بمعايير الجودة الخاصة بك؛ أما Astra فهو الخيار الأكثر أمانًا الذي يضع الجودة في المقام الأول للمهام الأصعب.
ما مدى انخفاض سعر GPT-6.1 Sol مقارنةً بـ GPT-6 Astra؟
وفقًا للأسعار القياسية، تبلغ تكلفة Sol $2 لكل مليون توكن مدخل و$10 لكل مليون توكن مخرج، مقارنةً بـ Astra التي تبلغ تكلفتها $10 و$50. وبالتالي، فإن Sol أرخص بخمس مرات بالنسبة للمدخلات والمخرجات غير المخزنة مؤقتًا. ويبلغ سعر المدخلات المخزنة مؤقتًا $0.10، وهو ما يمثل عُشر سعر Astra البالغ $1.
هل تشترك كل من GPT-6.1 Sol و GPT-6 Astra في نفس نافذة السياق؟
نعم. يحدد النموذج OpenAI نافذة سياق تبلغ 1,050,000 رمز، وحدًا أقصى للإدخال يبلغ 922,000 رمز، وحدًا أقصى للإخراج يبلغ 128,000 رمز لكلا النموذجين. أما الطلبات التي يتجاوز عدد رموز الإدخال فيها 272 ألف رمز، فيتم تحويل الطلب بأكمله إلى أسعار أعلى مخصصة للسياقات الطويلة.
أي طراز أفضل للبرمجة؟
يُعد «أسترا» الخيار الأمثل من حيث الجودة للأعمال المتعلقة بالمستودعات التي تتسم بصعوبة غير عادية أو غموض أو مخاطر عالية. أما «سول» فهو الخيار الافتراضي العملي للأعمال الروتينية المتعلقة بالميزات، وتصحيح الأخطاء، والمراجعات، وحلقات الوكلاء؛ لأن تكلفته المنخفضة تتيح إجراء المزيد من عمليات التكرار. قم بتشغيل كليهما على نفس اختبارات المستودع قبل اتخاذ قرار بشأن الخيار القياسي.
هل يدعم كلا الطرازين الأدوات وإدخال الصور؟
نعم. تضم صفحات النماذج الرسمية الخاصة بهم إدخال النصوص والصور، وإخراج النصوص، والمخرجات المنظمة، واستدعاء الدوال، والبحث على الويب، والبحث عن الملفات، ومترجم الأكواد، وبيئة التشغيل المستضافة، وتطبيق التصحيحات، واستخدام الكمبيوتر، وبرنامج MCP، والمهارات، والبحث عن الأدوات. ويجب أن يتم استدعاء الأدوات باستخدام واجهة برمجة التطبيقات (API) الخاصة بـ «Responses».
متى يجب عليّ دفع رسوم GPT-6 Astra؟
استخدم Astra عندما يكون ثمن الخطأ باهظًا، أو عندما تكون المهمة رائدة حقًّا، أو عندما يُظهر تقييم مقارن أن جودتها الإضافية تقلل من الحاجة إلى إعادة العمل بدرجة كافية لتبرير دفع خمسة أضعاف سعر التوكن. ومن الأمثلة على ذلك عمليات الترحيل الحرجة، واستخدام الحواسيب ذاتية التشغيل في المهام الصعبة، والمراجعة النهائية للنتائج ذات الأهمية البالغة.
أي أسلوب استدلال ينبغي أن أختار؟
ابدأ بالإعداد المتوسط، وهو الإعداد الافتراضي الموثق لكلا الطرازين. قم بخفض المستوى في حالة التحويلات البسيطة، ولا ترفعه إلا عندما تتطلب صعوبة المهمة أو تكلفة الخطأ ذلك. الإعداد الفعال هو أقل جهد يضمن اجتياز اختبارات القبول الخاصة بك بشكل ثابت.
هل يمكنني استخدام GPT-6.1 Sol و GPT-6 Astra على جهاز GlobalGPT؟
يحتوي GlobalGPT على مسارات تشغيلية لكل من GPT-6.1 Sol وGPT-6 Astra في مساحة العمل متعددة النماذج الخاصة به. قد تختلف إتاحة هذه النماذج حسب الحساب والواجهة، لذا يرجى فتح مساحة العمل والتحقق من أداة اختيار النموذج الحالية قبل البدء في سير عمل الإنتاج.
هل يجب عليّ توجيه كل موجه إلى نموذج واحد؟
عادةً لا. يمكن لجهاز التوجيه البسيط إرسال المهام العادية إلى «سول»، وتحويل الحالات ذات الثقة المنخفضة أو التي فشلت في الاختبار أو ذات المخاطر العالية إلى «أسترا». وهذا يتيح الاستفادة من معظم الميزة التكلفية لـ«سول»، مع الاحتفاظ بـ«أسترا» للحالات التي تكون فيها القدرة الهامشية ذات قيمة قابلة للقياس.
الحكم النهائي
ينبغي أن يكون نموذج GPT-6.1 Sol هو النموذج الأول الذي تقيّمه الفرق الأكثر اهتمامًا بالتكلفة؛ أما نموذج GPT-6 Astra فينبغي أن يظل الهدف الذي يُلجأ إليه في الحالات الأكثر تعقيدًا. إن السياق المشترك بينهما، وحدود الإنتاج، وطرق التشغيل، وآليات التحكم في الاستدلال، وقائمة الأدوات، كل ذلك يجعل المقارنة واضحة بشكل غير عادي. توفر «سول» الميزة الاقتصادية، بينما تتمتع «أسترا» بميزة القدرات الرسمية.
المقياس الحاسم ليس سعر التوكن أو مكانة النموذج وحدهما. قم بقياس التكلفة لكل نتيجة مقبولة في ظل القيود التشغيلية والميزانيات الفعلية. إذا حقق «سول» نسبة نجاح مماثلة، فسيكون من الصعب تجاهل معدلات الإدخال والإخراج غير المخزنة في ذاكرة التخزين المؤقت، والتي تقل بمقدار خمسة أضعاف. وإذا تمكن «أسترا» من منع حالات الفشل، أو قلل من الحاجة إلى المراجعة من قبل الخبراء، أو حل مهام لا يستطيع «سول» حلها، فقد يكون هذا الفارق في السعر مبررًا. ابدأ بمهام متطابقة، وحافظ على تقييم أعمى حيثما أمكن، ولا تروج إلا للنموذج وجهود الاستدلال التي تستحق مكانها.









