
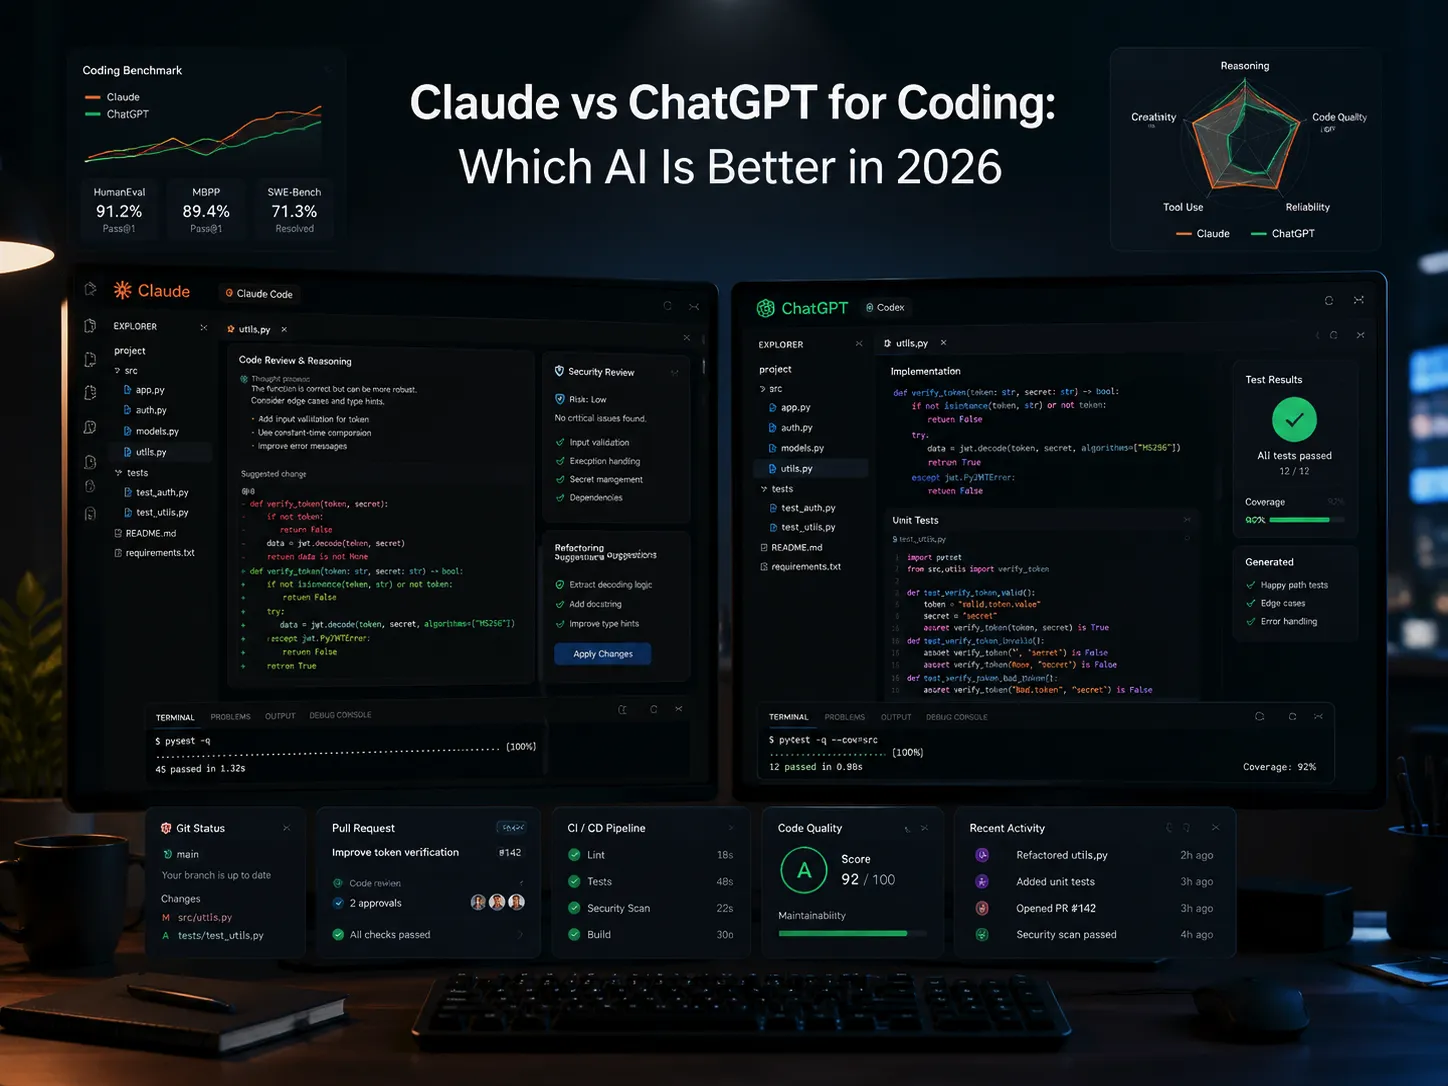
في الاختبارات التي أجريناها في 7 يوليو 2026، كان نموذج Claude Sonnet 5 هو الخيار الأفضل في المرحلة الأولى لمراجعة الكود، وتحليل الأسباب الجذرية، وتخطيط البنية، والاستدلال في السياقات الطويلة. أما GPT-5.5 فقد كان الخيار الأفضل في المرحلة الأولى عندما تحتاج إلى مسودة تنفيذ كاملة، أو هيكل اختبار قابل للتشغيل، أو أمثلة جاهزة للنسخ. بالنسبة للأعمال على مستوى المستودع، قارن بين Claude Code و Codex بدلاً من الحكم على أي من الشركتين من خلال نافذة الدردشة وحدها.
التقسيم المفيد لا يقتصر على مجرد “فوز Claude” أو “فوز ChatGPT”. اعتبارًا من 27 سبتمبر 2026، تشمل مجموعة منتجات Anthropic كلًّا من Claude Fable 5.1 و Opus 5.5 و Sonnet 5 و Haiku 4.5؛ وتشمل عائلة GPT-6 الخاصة بـ OpenAI كلًا من Astra وSol وLuna. ويُعد الوصول إلى المنتج أمرًا مهمًا: فقد تم إطلاق Sol وLuna في ChatGPT Work وCodex وواجهة برمجة التطبيقات (API)، مع استبعاد الإعلان صراحةً لـ Chat العادي. تظل الأقسام العملية أدناه مقارنة قديمة بين Claude Sonnet 5 وGPT-5.5، تم اختبارها باستخدام نفس المطالبات في 7 يوليو 2026. للاطلاع على مقارنة حديثة، انظر Claude Opus 5.5 مقابل GPT-6 Sol.
إذا كنت ترغب في مقارنة النماذج دون الحاجة إلى التبديل بين اشتراكات منفصلة، فإن GlobalGPT هي مساحة عمل عملية تدعم نماذج متعددة، بما في ذلك GPT-6 Astra و Claude Opus 5.5 متوفر في أداة اختيار النماذج الخاصة به. وهو مفيد لمقارنة إجابات البرمجة، والتخطيط، والكتابة، والبحث، لكنه لا يحل محل Claude Code، أو Codex، أو واجهات برمجة التطبيقات (API) الرسمية، أو بيئة تطوير متكاملة (IDE)، أو سير عمل التطوير الذي يراعي مستودعات البرمجة.

جدول المحتويات
- كلود مقابل ChatGPT في البرمجة: إجابة سريعة
- ما الذي تغير في عام 2026
- مجموعة نماذج الترميز الحالية
- نظرة عامة على المعايير المرجعية: SWE-Bench وTerminal-Bench وما تعنيه
- كيف قمنا باختبار كلود وChatGPT في مجال البرمجة
- الاختبار 1: تصحيح الأخطاء وتحليل الأسباب الجذرية
- الاختبار 2: إعادة الهيكلة وقابلية الصيانة
- الاختبار 3: الاستدلال والتخطيط المتعلقان بملفات متعددة
- الاختبار 4: الاختبارات الفردية والتحقق
- الاختبار 5: مراجعة الأمان والموثوقية
- «كلود كود» و«كوديكس»: عندما لا تكفي المحادثة
- الأسعار: كلود، ChatGPT، Codex، و GlobalGPT
- ما هو نظام الترميز الذي ينبغي أن تختاره؟
- لماذا لا يزال العديد من المطورين يستخدمون كليهما
- الأسئلة الشائعة
كلود مقابل ChatGPT في البرمجة: إجابة سريعة
في اختبارات الدردشة التي أجريناها في 7 يوليو باستخدام نفس المطالبة، كان نموذج Claude Sonnet 5 هو الأفضل في المراجعة الأولى عندما كانت المشكلة غامضة: فقد أعطى الأولوية للأسباب المحتملة، وتخطى المعلومات غير المهمة، وشرح المخاطر بوضوح. كان نموذج GPT-5.5 أكثر فعالية عندما كانت الخطوة التالية عبارة عن مسودة تنفيذ أكثر اكتمالاً تتضمن عمليات الاستيراد، وبنية الاختبار، والمزيد من تفاصيل الكود. وتصف هذه الملاحظات ذلك الاختبار تحديدًا، ولا تنطبق على كل إصدار مستقبلي للنموذج.
بالنسبة للتطوير اليومي، عادةً ما يكون أفضل مسار عمل هو:
- استخدم «كلود» أولاً للمراجعة البرمجية، وتصنيف الأخطاء، واتخاذ القرارات المتعلقة بالبنية، والأسئلة من نوع “ما الذي يجب أن أتحقق منه أولاً؟”.
- استخدم ChatGPT أولاً لإنشاء نموذج أولي للتنفيذ، وكتابة هياكل الاختبارات، وإعداد الأمثلة، وتحويل الخطة إلى كود برمجي.
- استخدم كليهما فيما يتعلق بعمليات الترحيل، والتغييرات الحساسة من الناحية الأمنية، والمدفوعات، والمصادقة، وتحميل الملفات، وأي شيء قد يؤدي إلى تلف بيانات بيئة الإنتاج.
| الحاجة إلى البرمجة | الاختيار الأول الأفضل | لماذا |
|---|---|---|
| تصحيح خطأ برمجي صعب | كلود أولاً | في الاختبار الذي أجريناه، أعطى نموذج Claude الأولوية للسبب المحتمل وشرح مسار الفشل بوضوح. |
| كتابة مسودة تنفيذ كاملة | ChatGPT أولاً | في الاختبار الذي أجريناه، قدمت GPT-5.5 كودًا أكثر اكتمالاً وبنية أساسية أكثر جاهزية للاستخدام. |
| مراجعة المخاطر المتعلقة بالأمن أو الموثوقية | كلود أولاً، ثم ChatGPT | قام Claude بتصنيف درجات الخطورة بشكل واضح؛ بينما أضاف ChatGPT أنماطًا ملموسة للتنفيذ. |
| تعديل الملفات عبر المستودع | Claude: «كود» أو «كودكس» | يُعد سياق السؤال، وتنفيذ الأوامر، والاختبارات، ومقارنات الاختلافات أكثر أهمية من الإجابة التي تقتصر على الدردشة فقط. |
إذا كان سؤالك الرئيسي هو: أي عائلة من النماذج هي الأفضل للبرمجة بشكل عام، فإن الإجابة الأوسع نطاقاً هي أفضل نموذج ذكاء اصطناعي للبرمجة تعد هذه المقارنة مادة مفيدة للقراءة التالية. إذا كان قرارك الرئيسي يقع ضمن منظومة OpenAI، فإن دليل «أفضل نموذج ChatGPT للبرمجة» يقدم مزيدًا من التفاصيل حول اختيار نماذج GPT.
ما الذي تغير في عام 2026
يجب أن تأخذ أي مقارنة مفيدة لعام 2026 في الحسبان ثلاثة تحولات.
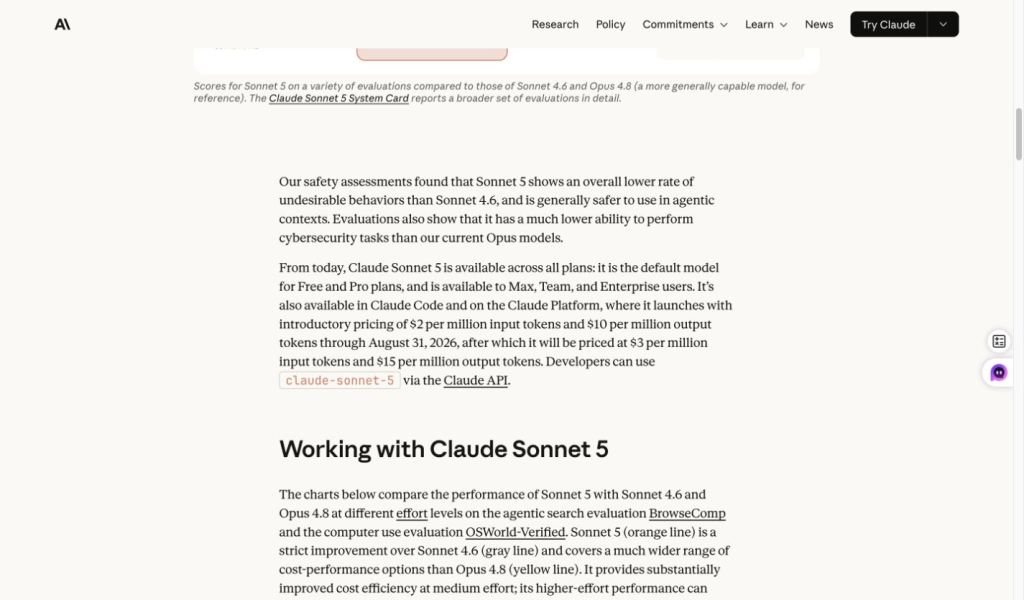
أولاً، غيّر «كلود سونيت 5» موقف «كلود» من القرار. يصف Anthropic خدمة Sonnet 5 بأنها متاحة عبر جميع الباقات وفي كود Claude، مع إمكانية وصول المطورين إلى منصة Claude. وهذا أمر مهم لأن Claude لم يعد مجرد مساعد دردشة لتوضيح أمور البرمجة؛ بل أصبح جزءًا من سير عمل وكيل البرمجة في Anthropic.
ثانياً، أصبح GPT-6 الآن عائلة النماذج الحالية التي تستخدمها OpenAI في أعمال البرمجة. تستهدف «أسترا» مجال هندسة البرمجيات المعقدة؛ بينما توفر «سول» و«لونا» خيارات أقل تكلفة. إعلان شركة OpenAI عن الإصدار في 22 سبتمبر تُدرج «سول» و«لونا» في خدمات «ChatGPT Work» و«Codex» لكل من الإصدارات Plus وPro وBusiness وEnterprise وEdu، كما تتوفر «لونا» أيضًا لمستخدمي الإصدارين Free وGo في تطبيق سطح المكتب. وتشير الخدمة صراحةً إلى أن هذه النماذج غير متوفرة بعد في «Chat». ويتم احتساب تكلفة الوصول إلى واجهة برمجة التطبيقات (API) بشكل منفصل.
ثالثًا، يقوم مساعدو الدردشة ووكلاء البرمجة بحل أجزاء مختلفة من المهمة. تعد الدردشة العادية مفيدة في عرض المقتطفات البرمجية، وتصحيح الأخطاء، وتقديم التفسيرات، والتخطيط. Claude: الرمز والمخطوطة وهي سير عمل مدمج مع ريبو ومصممة لفحص الملفات، وتشغيل الأوامر، واختبار التغييرات، والعمل على مهام أكبر. وتفصل المقارنة العادلة بين جودة مخرجات الدردشة وقدرات منتج «coding-agent».
مجموعة نماذج الترميز الحالية
اعتبارًا من 27 سبتمبر 2026، أصبحت مقارنة الترميز قرارًا يتعلق بتشكيلة من الخيارات، وليس مجرد مقارنة ثنائية بين Claude وChatGPT:
| الجانب | الطرازات الحالية التي يجب أخذها في الاعتبار | أفضل استخدام للبرمجة |
|---|---|---|
| كلود | Claude Fable 5.1، وClaude Opus 5.5، وClaude Sonnet 5، وClaude Haiku 4.5 | المراجعة في سياق واسع، والتخطيط، وتصحيح الأخطاء، والبرمجة التفاعلية، وسير عمل Claude Code. |
| ChatGPT / OpenAI | GPT-6 Astra, ، وGPT-6 Sol، وGPT-6 Luna؛ وتختلف إتاحة هذه النماذج بين إصدارات ChatGPT Work وChat وCodex وAPI | التنفيذ، وأعمال الواجهة الأمامية، والاختبارات، وسير العمل باستخدام الأدوات، ومهام Codex. |
| جلوبال جي بي تي تي | GPT-6 Astra وClaude Opus 5.5، تم التحقق منها في GlobalGPT؛ وهذا اشتراك منفصل في المنصة | مقارنة مباشرة بين المطالبات، وأسئلة برمجية يومية، وأبحاث، وتقييم الأساليب. |
إذا كنت تتابع تفاصيل الوصول إلى «كلود» وتفاصيل الخطة، فراجع المقالة المنفصلة خطط «كلود AI» لعام 2026 الدليل ودليل التسعير الأكثر تفصيلاً لـ Claude AI. إذا كنت تقارن بين باقات OpenAI، فإن تفاصيل باقات الاشتراك في ChatGPT لعام 2026 تُعد المرجع المرافق الأكثر وضوحًا.
نظرة عامة على مؤشرات الأداء: SWE-Bench وTerminal-Bench وما تعنيه
تُعد اختبارات الأداء مفيدة لأنها تُظهر كيفية تصرف النماذج في مهام البرمجة الخاضعة للرقابة. ويكمن المفتاح في فهم ما تقيسه كل اختبار أداء فعليًّا. فاختبار الأداء الخاص بمشكلة في المستودع، واختبار الأداء الخاص بالوكيل الطرفي، وجدول الإطلاق الرسمي للنموذج، ليست جميعها مؤشرات متماثلة، لذا ينبغي استخدامها جنبًا إلى جنب مع الاختبارات العملية الواردة أدناه.
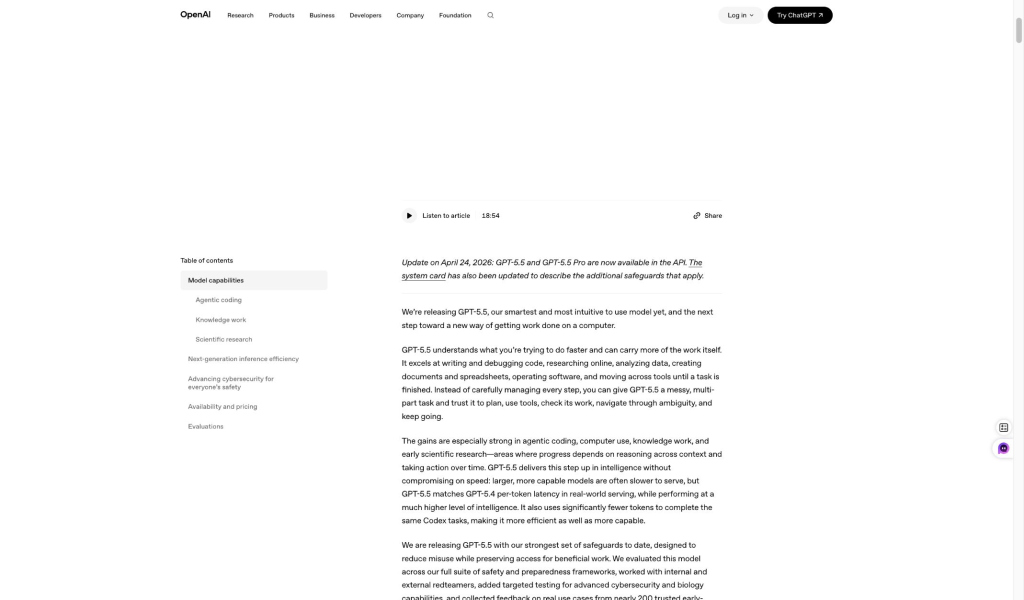
GPT-5.5: أدلة الترميز المستمدة من تاريخ الاختبار
تم الاحتفاظ بالمعلومات المتعلقة بطراز GPT-5.5 الواردة أدناه لأنها تتطابق مع النموذج المستخدم في المقارنة العملية التي أُجريت في 7 يوليو. وهي تدعم الملاحظات التي ركزت على الجوانب التنفيذية في قسم الاختبار، ولكن لا ينبغي اعتبارها بمثابة تشكيلة طرازات OpenAI الحالية؛ حيث أصبحت GPT-6 هي العائلة النشطة حاليًا، مع تباين إمكانية الوصول بين ChatGPT Work وChat العادي وCodex وواجهة برمجة التطبيقات (API).
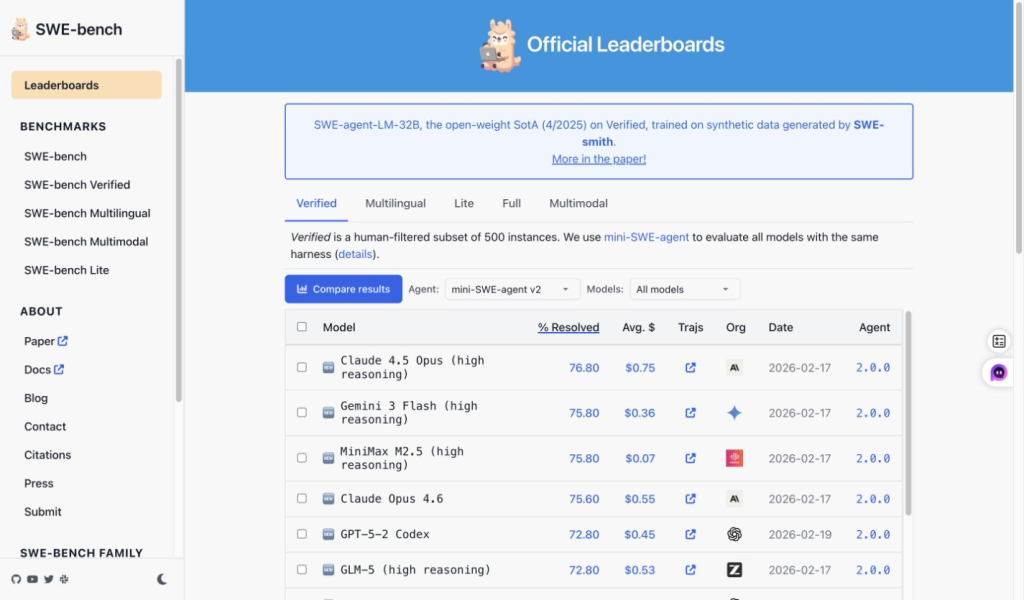
SWE-Bench: حل مشكلة المستودع
SWE-Bench وهذا مفيد لأنه أقرب إلى صيانة البرامج الفعلية مقارنةً بمطالبة قصيرة تتضمن مقتطفًا برمجيًّا. فهو يراعي المشكلات الموجودة في المستودع، وما إذا كان النموذج قادرًا على إنتاج تغييرات تحل المهمة. وبالنسبة لمقارنة كلود بـ ChatGPT، فإن هذا يوضح لك شيئًا عن قوة هندسة البرمجيات، لكنه لا يروي القصة كاملةً فيما يتعلق بجودة التفسير، أو تقييم المراجعة، أو مدى فائدة الإجابة في سياق سير عمل الدردشة.
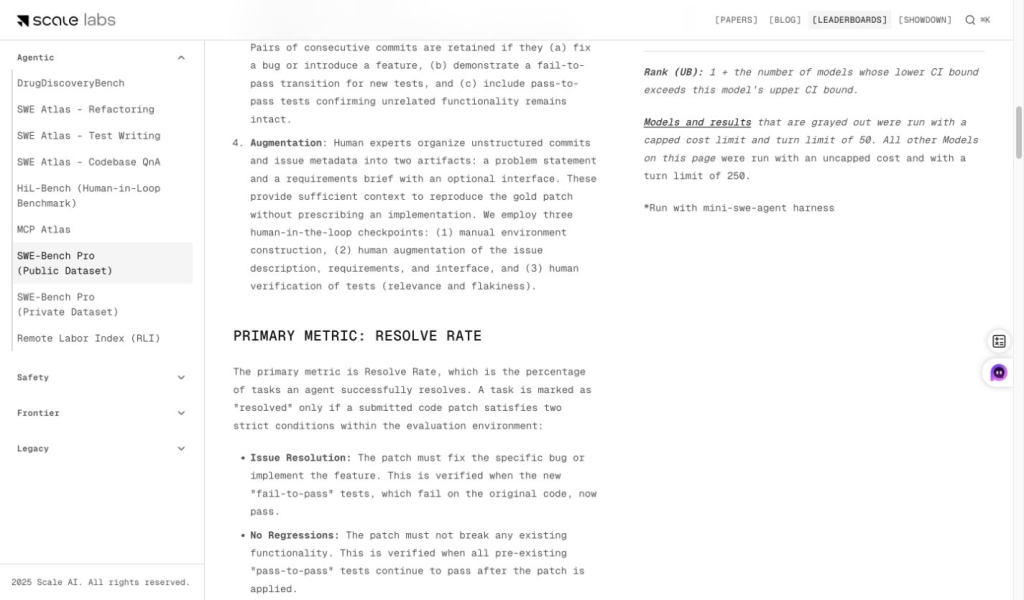
SWE-Bench Pro: مهام البرمجة الأكثر صعوبة ومعدل حل المشكلات
لوحة المتصدرين العامة لـ SWE-Bench Pro من Scale تُعد هذه الإشارة أكثر صعوبة لأنها تركز على مهام المستودع الأكثر تعقيدًا وتستخدم «معدل الحل» كمؤشر رئيسي. ويكون ذلك مفيدًا للغاية عندما تهتم بقدرات «وكيل البرمجة» الحقيقية: ليس فقط ما إذا كان النموذج قادرًا على تفسير خطأ ما، بل ما إذا كان قادرًا على توجيه المستودع نحو إصلاح فعال في ظل ظروف الاختبار المعياري.
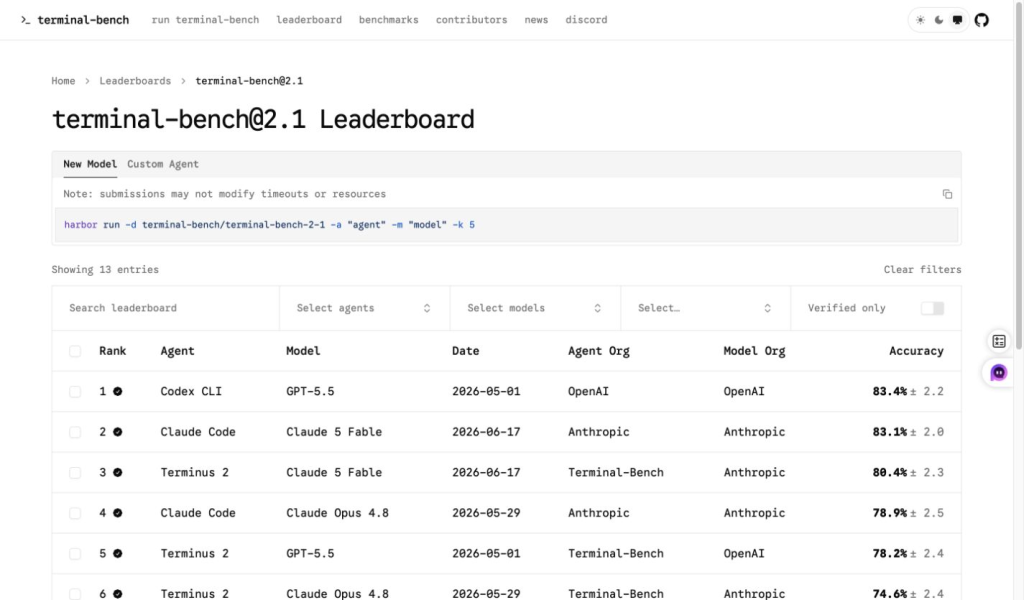
Terminal-Bench: مهام سطر الأوامر ومهام سير عمل الوكيل
المنضدة الطرفية 2.1 ويختلف عن SWE-Bench لأنه يركز على إنجاز المهام عبر واجهة الأوامر وخط الأوامر من خلال إعدادات الوكلاء/النماذج. وهذا يجعله أكثر ملاءمةً لسير العمل على غرار Claude Code وChatGPT Codex مقارنةً بمطالبة الدردشة البسيطة من نوع “اكتب هذه الدالة”. إذا كنت تختار مساعد برمجة للعمل على مستوى مستودع الكود أو سطر الأوامر، فيجب أن يُؤخذ هذا المعيار في الاعتبار عند اتخاذ القرار.
| الأدلة | أفضل قراءة لـ | النقطة العملية التي يمكن استخلاصها |
|---|---|---|
| مواد البرمجة الخاصة بـ OpenAI GPT-5.5 | البرمجة باستخدام GPT-5.5 والتوجه نحو هندسة البرمجيات القائمة على الوكلاء. | دعم قوي لـ ChatGPT باعتباره مساعدًا في البرمجة يعتمد بشكل كبير على التنفيذ. |
| SWE-Bench | مهام حل مشكلات مستودع البرمجيات وصيانة البرمجيات. | مؤشر جيد على القدرة على البرمجة، لا سيما عندما يكون سياق المستودع عاملاً مهمًا. |
| سوي-بينش برو | مهام مستودع أكثر صعوبة ومقارنة معدلات الحل. | مفيد في تقييم القدرة الجادة على الترميز الفاعلي. |
| المنضدة الطرفية 2.1 | المهام الطرفية، وتنفيذ الأوامر، وإعدادات الوكيل/النموذج. | وهذا أكثر صلة بسير عمل «كلود كود» و«كوديكس» مقارنة بمجرد مطالبات الدردشة البسيطة. |
تُعد المعايير المرجعية خيارات برمجة موثوقة لكلتا مجموعتي النماذج، لكنها لا تحسم اختيار طريقة العمل اليومية. تستخدم الأقسام أدناه نفس المطالبات الخاصة بتصحيح الأخطاء، وإعادة هيكلة الكود، والتخطيط، واختبارات الوحدات، ومراجعة الأمان، حتى تتمكن من ملاحظة الاختلافات في الإجابات على أرض الواقع.
كيف قمنا باختبار كلود وChatGPT في مجال البرمجة
أجرينا اختبارًا على GPT-5.5 وClaude Sonnet 5 في 7 يوليو 2026 على منصة GlobalGPT، باستخدام نفس الواجهة ونفس المطالبات. لم يكن الهدف هو إعادة إنشاء معيار قياسي كامل لوكيل بيئة التطوير المتكاملة (IDE)، بل كان الهدف هو مقارنة المساعدة اليومية في البرمجة: تصحيح الأخطاء، وإعادة هيكلة الكود، والاستدلال متعدد الملفات، وكتابة الاختبارات، ومراجعة الأمان.
كانت معايير التقييم بسيطة: الدقة، والتحليل المنطقي للأسباب الجذرية، وسهولة الصيانة، وتغطية الحالات الاستثنائية، والتحقق، واتباع التعليمات. وهذا يجعل المقارنة قريبة من الطريقة التي يستخدم بها المطورون فعليًّا مساعدات البرمجة التي تعتمد على الذكاء الاصطناعي.
الاختبار 1: تصحيح الأخطاء وتحليل الأسباب الجذرية
طلبت المهمة الأولى من كلا النموذجين مراجعة دالة في لغة جافا سكريبت تعمل على تجميع التذاكر حسب الأولوية. والخطأ خفي ولكنه شائع: حيث تحاول الدالة إدراج acc[ticket.priority] قبل أن يتم إنشاء هذا المصفوف.
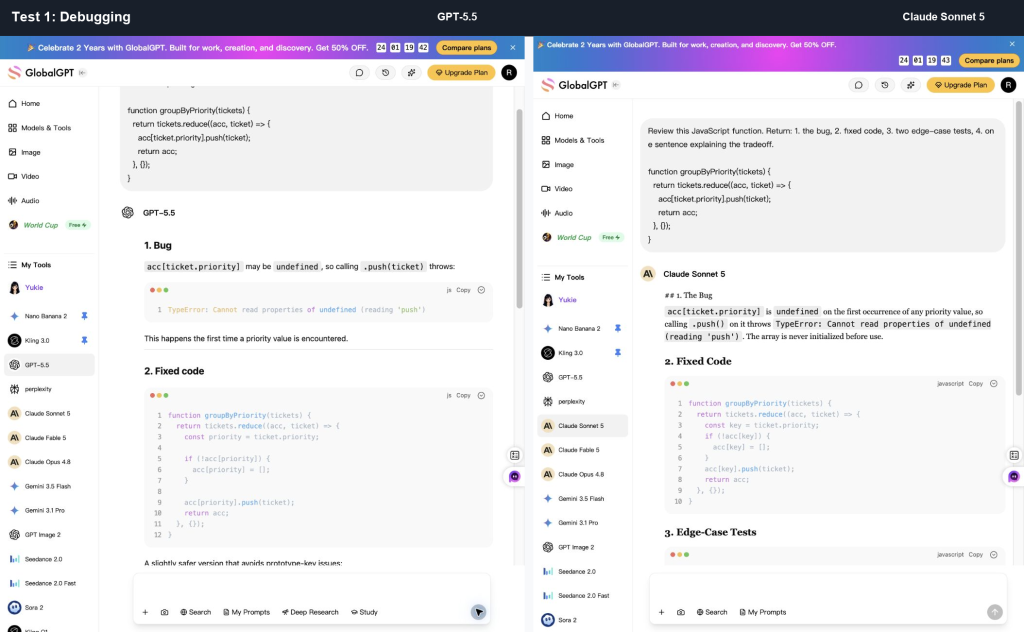
ما نجح فيه ChatGPT: اكتشف GPT-5.5 الخلل، وقدم كودًا مصححًا، وأضاف اختبارات للحالات الاستثنائية، وتضمن نهجًا أكثر تحوطًا Object.create(null) متغير. وتُعد هذه التفاصيل الإضافية المتعلقة بالتنفيذ مفيدة عندما قد تتعارض مفاتيح الكائنات مع الخصائص الموروثة.
ما برع فيه كلود: اكتشف كلود سونيت 5 نفس الخطأ وقدم إجابة أكثر دقة. كما أشار إلى حالة حدية ذات أولوية غير محددة، وهي نوع من الحدود العملية التي ينبغي للمراجع أخذها في الاعتبار.
الفائز: تعادل، مع تفوق طفيف لـ ChatGPT في دقة التنفيذ. كان أداء Claude أكثر دقة؛ بينما كان أداء GPT-5.5 أكثر اكتمالاً.
الاختبار 2: إعادة الهيكلة وقابلية الصيانة
طلبت المهمة الثانية إعادة هيكلة الكود لتحسين قابليته للقراءة دون تغيير سلوكه. ويُعد هذا اختبارًا جيدًا لأن العديد من إجابات البرمجة التي تُنتجها الذكاء الاصطناعي تبالغ في إعادة هيكلة الأدوات المساعدة الصغيرة، مما يؤدي إلى إنشاء عناصر متحركة أكثر مما يحتاجه الكود الأصلي.
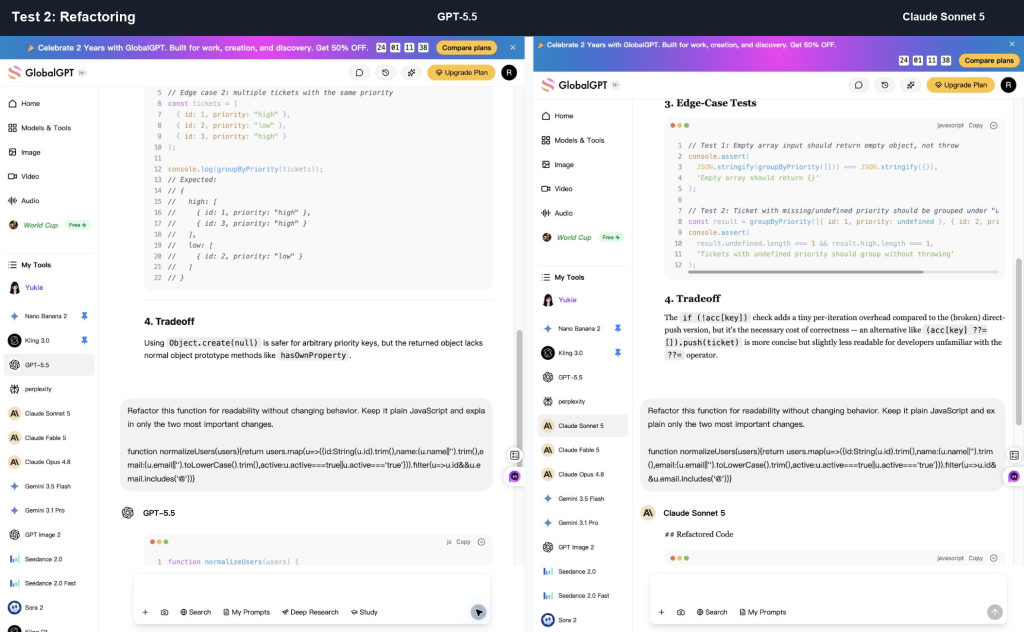
ما نجح فيه ChatGPT: حافظت GPT-5.5 على بنية قريبة من الأصل، وأدخلت قيمًا وسيطة مسماة، واتبعت تعليمات “تغييرين مهمين فقط” بدقة. وهذا أمر مهم عندما يرغب المستخدم في إعادة هيكلة متحفظة.
ما برع فيه كلود: قام «كلود سونيت 5» باستخراج وظائف مساعدة مثل أداة التوحيد وأداة التحقق من الصحة. وأدى ذلك إلى تسهيل قراءة «إنتنت»، لكنه غيّر هيكلها بدرجة أكبر مما فعله «جي بي تي-5.5».
الفائز: استخدم ChatGPT لضبط النص؛ واستخدم Claude لتحسين قابلية القراءة بشكل مرن. إذا كنت بحاجة إلى إعادة هيكلة بسيطة وآمنة، فابدأ باستخدام ChatGPT. أما إذا كنت تريد تسميات أكثر وضوحًا في المجال، فاطلب من Claude إجراء مراجعة ثانية.
الاختبار 3: الاستدلال والتخطيط متعدد الملفات
قدمت المهمة الثالثة شجرة ملفات صغيرة لـ Next.js وتقريرًا عن خطأ: يمكن للمستخدمين المسجلين تحميل الملفات الصغيرة، لكن الملفات التي يزيد حجمها عن 8 ميغابايت تفشل دون ظهور أي رسالة خطأ بعد وصول شريط التقدم إلى 100%.
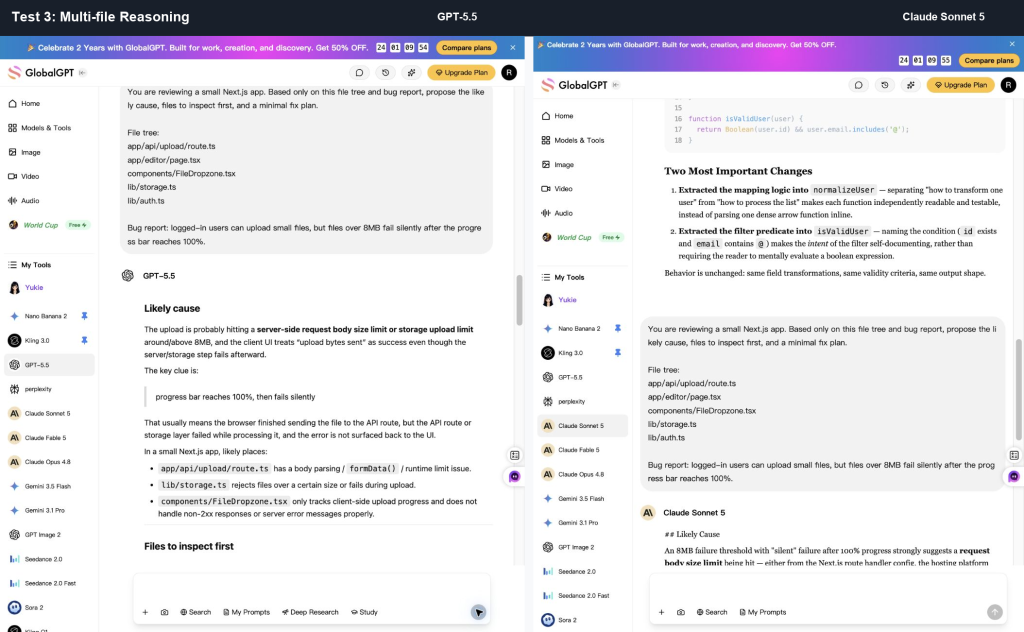
ما نجح فيه ChatGPT: أنتج GPT-5.5 خطة تفصيلية موجهة نحو التنفيذ. وتطرقت الخطة إلى عمليات التحقق من حجم الخادم، ومعالجة استجابات العملاء، وانتشار أخطاء التخزين.
ما برع فيه كلود: ركز «كلود سونيت 5» على الفور على عتبة الـ 8 ميغابايت، وربما على قيود النظام الأساسي أو حجم الجهاز، ودلالات شريط التقدم، ومسار التحقق عند 7 ميغابايت/8 ميغابايت/9 ميغابايت. وقد بدا الأمر أشبه بملاحظة مراجعة من أحد كبار المسؤولين.
الفائز: كلود. فقد حددت الأولوية للسبب المحتمل بشكل أسرع، وقدمت مسارًا أكثر دقة للفحص المبدئي.
الاختبار 4: الاختبارات الفردية والتحقق
طلبت المهمة الرابعة من كلا النموذجين كتابة اختبارات وحدة بلغة TypeScript لروتين مساعد يعرض حدود الخطة الخاصة بعمليات التحميل والوصول إلى Codex. ويهدف هذا الاختبار إلى التحقق مما إذا كان النموذج قادرًا على حماية منطق التفرع من حدوث انحدار في الأداء مستقبلاً.
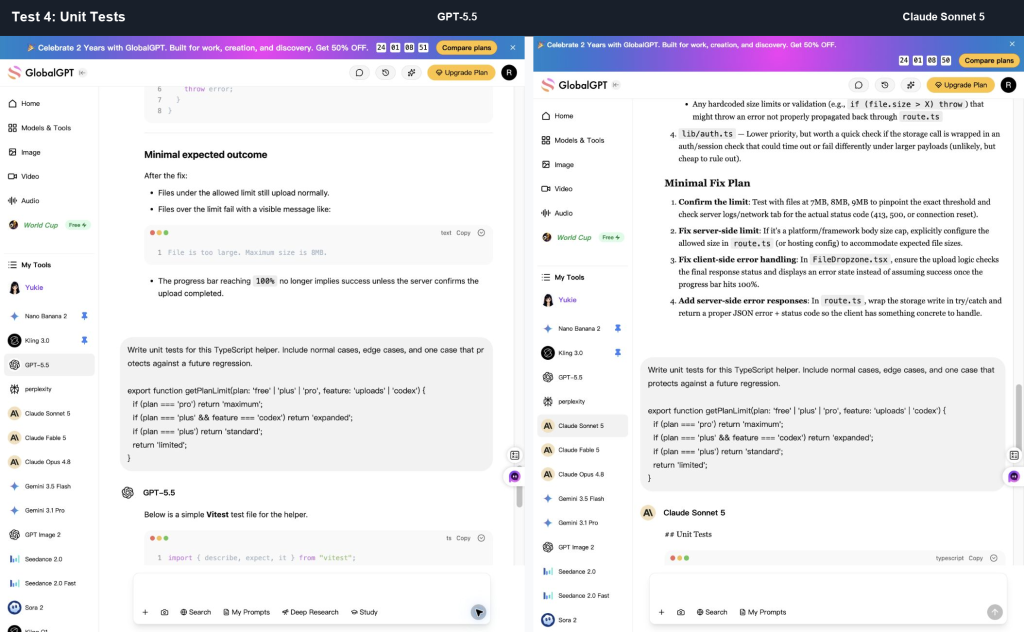
ما نجح فيه ChatGPT: تضمن GPT-5.5 استيرادات لإطار عمل الاختبار وأنتج ملف Vitest يبدو قابلاً للتشغيل. وقد غطى الملف جميع التركيبات المتوقعة وجعل من السهل لصق الإجابة في المشروع.
ما برع فيه كلود: وقد أوضح كلود سونيت 5 مخاطر الانحدار الحقيقية بشكل أفضل: pro + codex يجب أن يتم قطع الدائرة قبل إجراء الفحوصات الخاصة بالميزات. كانت هذه إجابة منطقية أقوى، على الرغم من أنها كانت أقل سهولة في الاستخدام كملف جاهز.
الفائز: يُستخدم «كلود» (Claude) لوضع منطق الاختبارات؛ ويُستخدم «تشات جي بي تي» (ChatGPT) لإنشاء ملفات الاختبارات الأولية. وفي الممارسة العملية، يُستخدم «تشات جي بي تي» لإنشاء المسودة الأولى للاختبارات، ويُستخدم «كلود» لتقييم ما إذا كانت الاختبارات تضمن السلوك الصحيح.
الاختبار رقم 5: مراجعة الأمان والموثوقية
طلبت المهمة الخامسة من كلا النموذجين مراجعة نقطة نهاية ويبهوك لـ Express. يجب أن تتناول الإجابة الجيدة التحقق من التوقيع، ومتطلبات النص الأصلي للطلب، وخاصية الإيدمبوتنس، والتحقق من الصحة، ومعالجة أخطاء قاعدة البيانات، وحدود حجم الطلب.
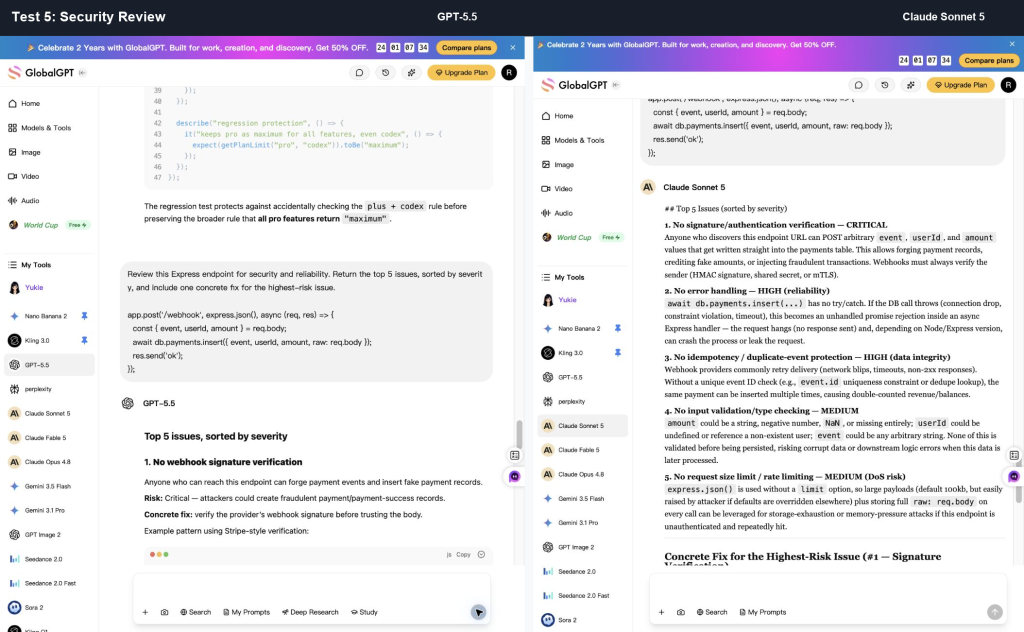
ما نجح فيه ChatGPT: قدم GPT-5.5 حلاً على غرار ما يقدمه مزودو الخدمة، بما في ذلك حل مشابه لـ Stripe express.raw() نمط. وهذا مفيد عندما تكون الخطوة التالية هي تنفيذ معالج ويبهوك ملموس.
ما برع فيه كلود: قدمت النسخة الخامسة من «كلود سونيت» منطقًا أكثر دقة في تقييم الخطورة، وتضمنت تفاصيل أكثر موثوقية لمقارنة التوقيعات باستخدام مفاهيم المقارنة في وقت ثابت. وقد أدى ذلك إلى جعل تصنيف المخاطر أكثر دقة.
الفائز: تعادل، مع تفوق طفيف لـ«كلود» في شرح الجوانب الأمنية. كان كلا النموذجين قويين بما يكفي ليكونا مفيدين، لكن لا ينبغي لأي من الإجابتين أن تحل محل المراجعة الأمنية الفعلية لعمليات الدفع أو المصادقة.
كلود كود مقابل تشات جي بي تي كوديكس
يُعد ناتج الدردشة جزءًا واحدًا فقط من عملية اتخاذ القرارات المتعلقة بالبرمجة. ويُعد كل من «Claude Code» و«Codex» مسارين منفصلين لتطوير الوكلاء، مخصصين للمهام التي تتضمن الملفات أو الأوامر أو الاختبارات أو طلبات السحب أو التغييرات الأوسع نطاقًا في قاعدة الكود.
| سير العمل | أفضل ملاءمة | حد مهم |
|---|---|---|
| دردشة كلود | التفكير المنطقي، وتصحيح الأخطاء، والمراجعة، والتوضيح، والتخطيط. | فهي لا ترى سوى السياق الذي تقدمه، ما لم تكن مرتبطة بأدوات أو بسير عمل أوسع نطاقاً. |
| دردشة ChatGPT | مسودات التنفيذ، والاختبارات، والأمثلة، والأسئلة المتعلقة باستخدام واجهة برمجة التطبيقات (API). | حتى الإجابة القوية تحتاج إلى التحقق منها في مشروعك. |
| كلود كود | البرمجة المراعية لـ Repo، والتنقل داخل قاعدة الكود، والاختبارات، وتخطيط المهام الكبيرة. | يرجى مراجعة الأذونات وسياسة الأمان والتغييرات المقترحة قبل قبول التعديلات. |
| كودكس | التنفيذ المتوافق مع معايير Repo، وتصحيح الأخطاء، والاختبارات، والمراجعة، وسير عمل البرمجة المدمجة مع OpenAI. | يختلف الوصول إلى الخطة واستخدامها وتوافر النموذج عن الدردشة العادية، وقد يتغير ذلك بمرور الوقت. |
الطريقة العملية: استخدم نماذج الدردشة للتفكير والتوضيح والمهام الصغيرة؛ واستخدم «Claude Code» أو «Codex» عندما يتطلب العمل سياق مستودع البيانات وخطوات قابلة للتنفيذ.
الأسعار: كلود، ChatGPT، Codex، و GlobalGPT
ابدأ بالسؤال عما تدفع مقابله. يتم الدفع مقابل خطة الدردشة للحصول على مساعدة تفاعلية يومية في البرمجة. أما سير عمل وكيل البرمجة فيتم الدفع مقابله مقابل المهام التي تراعي مستودعات البرمجة (repo)، مثل مهام واجهة سطر الأوامر (CLI) وبيئة تطوير المتكاملة (IDE) والويب والسحابة أو عمليات التكامل. ويتم تحديد أسعار واجهة برمجة التطبيقات (API) لكل مليون رمز. أما مساحة العمل متعددة النماذج فيتم الدفع مقابلها لتسهيل التبديل بين نماذج Claude وGPT وGemini وPerplexity وغيرها في مكان واحد.
الأسعار التي تم التحقق منها في 27 سبتمبر 2026 هي بالدولار الأمريكي قبل إضافة الضرائب المعمول بها. ويفصل الجدول بين اشتراكات المستهلكين، وأسعار الرموز القياسية لواجهة برمجة التطبيقات (API)، والخطط السنوية الخاصة بشركة GlobalGPT. صفحة الأسعار الخاصة بـ Claude المبلغ السنوي لـ «Rounds Pro» يعادل $17 شهريًّا؛ أما مبلغ $200 المدفوع مقدمًا فيعادل $16.67 شهريًّا.
| المنتج أو الباقة | السعر المعروض | ماذا يعني ذلك بالنسبة للبرمجة |
|---|---|---|
| المستهلك · Claude مجانًا | $0 | يكفي للإجابة عن أسئلة البرمجة البسيطة وتجربة أسلوب Claude قبل الدفع. |
| المستهلك · Claude Pro | $20 شهريًّا؛ $200 سنويًّا مدفوعة مقدَّمًا (ما يعادل $16.67 شهريًّا) | يتضمن الرمز Claude؛ استخدام الدردشة والرمز Claude ضمن الخطة المدفوعة. |
| المستهلك · Claude كحد أقصى | ابتداءً من $100 شهريًّا | خيارات الاستخدام الأعلى؛ يتضمن الرمز Claude. تتم فوترة وحدة التحكم في واجهة برمجة التطبيقات (API Console) بشكل منفصل. |
| المستهلك · ChatGPT مجانًا | $0/شهر | دردشة خفيفة؛ يختلف الوصول إلى GPT-6 Luna على سطح المكتب عن الدردشة العادية. |
| المستهلك · ChatGPT Go | $8/شهر في المرجع الأمريكي الأصلي؛ قد تختلف الأسعار المحلية | اشتراك شهري؛ يرجى مراجعة صفحة الأسعار المحلية لمعرفة المبلغ المطبق في سوقك. |
| المستهلك · ChatGPT Plus | $20 شهريًّا، تُفوتر شهريًّا | تلقّي مطالبات البرمجة بانتظام وإمكانية الوصول إلى Codex/Work للمستفيدين المؤهلين؛ ويتم احتساب تكاليف استخدام واجهة برمجة التطبيقات (API) بشكل منفصل. |
| المستهلك · ChatGPT Pro | $100 شهريًّا؛ وتستمر الاشتراكات الحالية بقيمة $200 شهريًّا | سيتم تعليق عمليات التسجيل الجديدة والترقيات الخاصة بخطة $200 اعتبارًا من 10 سبتمبر 2026. وتظل اشتراكات خطة $100 متاحة. |
| واجهة برمجة التطبيقات (API) · كلود سونيت 5 | مدخل $2/M؛ مخرج $10/M | السعر القياسي لواجهة برمجة التطبيقات (API) لأدوات البرمجة وسير العمل ذات السياقات الكبيرة. |
| واجهة برمجة التطبيقات (API) · Claude Opus 5.5 | مدخل $4/M؛ مخرج $20/M | السرعة القياسية. أما في الوضع السريع، فتبلغ السرعة عند الإدخال $8/M وعند الإخراج $40/M. |
| واجهة برمجة التطبيقات (API) · GPT-6 Astra | مدخل $10/M؛ مخرج $50/M | السعر القياسي لواجهة برمجة التطبيقات (API)؛ منفصل عن خطة ChatGPT. |
| واجهة برمجة التطبيقات (API) · GPT-6 Sol / Luna | Sol: مدخلات $2/M، مخرجات $10/M؛ Luna: مدخلات $0.10/M، مخرجات $0.50/M | الفوترة المنفصلة للمطورين؛ استخدم معرّف النموذج والسعر بالضبط. |
| المنصة · GlobalGPT الأساسية | ما يعادل $5.80 شهريًّا؛ $69.60 تُفوتر سنويًّا | طريقة ميسورة التكلفة لمقارنة مجموعات متعددة من النماذج في مهام البرمجة اليومية والأبحاث. |
| المنصة · GlobalGPT Pro | ما يعادل $10.80 شهريًا؛ $129.60 تُفوتر سنويًّا | توفير ملاءمة أفضل عند التبديل بين عدة مجموعات من الطرازات أثناء العمل العادي. |
| المنصة · GlobalGPT غير محدود | ما يعادل $25 شهريًّا؛ $300 تُفوتر سنويًّا | لإجراء مقارنات متكررة بين نماذج متعددة في مساحة عمل واحدة. لا تشمل هذه الباقات رصيد واجهة برمجة التطبيقات (API) الرسمية أو اشتراكات Claude Code/Codex الأصلية. |
بالنسبة لمعظم المطورين الأفراد، لا يتمثل القرار في “أي شركة هي الأرخص؟”، بل في “أي سعر يتناسب مع أسلوب العمل؟”. إذا كنت تقضي معظم وقتك في طرح الأسئلة ولصق مقتطفات من الكود، فإن Claude Pro أو ChatGPT Plus قد يكون ذلك كافياً. إذا كنت ترغب في تطبيق يدعم ميزة «repo-aware»، فقارن بين الوصول إلى Claude Code و«Codex». وإذا كنت تقارن عدة نماذج يومياً، فقد يكون GlobalGPT هو مساحة العمل اليومية الأكثر تنظيمًا، لأن التكلفة مرتبطة بخطة واحدة متعددة النماذج بدلاً من عدة اشتراكات منفصلة.
بالنسبة لأدوات البرمجة التي تعتمد بشكل كبير على واجهات برمجة التطبيقات (API)، فإن أسعار الاشتراكات ليست المعيار الصحيح للمقارنة. فالسعر لكل رمز (Token) هو العامل الأكثر أهمية نظرًا لحجم سياق الكود. كلود سونيت 5 تبلغ تكلفة الإدخال $2/M وتكلفة الإخراج $10/M، بينما تبلغ تكلفة Opus 5.5 $4/M و$20/M عند السرعة القياسية. وبالتالي، فإن مليون رمز إدخال بالإضافة إلى مليون رمز إخراج تكلف $12 على Sonnet 5 أو $24 على Opus 5.5. بالنسبة لـ OpenAI، يكلف نفس الاستخدام $60 على Astra، أو $12 على Sol، أو $0.60 على Luna بالأسعار القياسية. هذه رسوم واجهة برمجة التطبيقات (API)، وليست حصصًا مضمنة في اشتراكات ChatGPT أو Claude أو GlobalGPT.
ما هو نظام الترميز الذي ينبغي أن تختاره؟
لا تختر بناءً على اسم النموذج فقط. اختر بناءً على نوع أعمال البرمجة التي تقوم بها فعليًّا. فقد يستخدم الشخص نفسه ChatGPT للتنفيذ الأولي، وClaude للمراجعة، وCodex للعمل على مستودعات البرامج القابلة للتنفيذ، وGlobalGPT لإجراء فحوصات سريعة للنماذج جنبًا إلى جنب خلال يوم العمل العادي.
المبتدئون في تعلم البرمجة: ابدأ بـ ChatGPT. فعادةً ما يقدم هذا البرنامج المزيد من الأمثلة، والمزيد من الدعم التوجيهي، ومسارًا أسهل للانتقال من “لا أفهم هذا الخطأ” إلى “ها هو الشكل الصحيح”.”
مطور مبتدئ يعمل على إصلاح الأخطاء: ابدأ باستخدام «كلود» عندما تكون المشكلة غير واضحة. يتميز «كلود» بقدرته على تضييق نطاق الأسباب المحتملة، وتحديد ما يجب فحصه أولاً، والحفاظ على تركيز الشرح. استخدم «تشات جي بي» بعد ذلك عندما تريد الحصول على تصحيح محدد، أو حالة اختبار، أو مثال على التنفيذ.
مهندس أول يقوم بمراجعة تغيير ما: ابدأ باستخدام «كلود». فهو أكثر ملاءمة للمفاضلات، وترتيب مستويات الخطورة، والمسائل المتعلقة بالبنية، والنقد الموجز. أما بالنسبة للمهام التي تتعلق بقاعدة كود أكبر حجمًا، فانتقل من الدردشة إلى «كلود كود» أو «كوديكس» حتى يتمكن النموذج من التعامل مع الملفات والأوامر بدلاً من مقطع نصي تم لصقه.
أداة تطوير الواجهة الأمامية أو واجهة المستخدم: ابدأ باستخدام ChatGPT في المرحلة الأولى. فهو يميل إلى إنتاج كود مكونات أكثر اكتمالاً، ومعالجة للحالة، وهياكل اختبارية. ثم استخدم Claude لمراجعة قابلية الوصول، وحدود المكونات، وتسمية العناصر، وما إذا كان الكود أكثر تعقيدًا مما يتطلبه التصميم.
المسؤول عن صيانة قاعدة كود كبيرة: اختر «Claude Code» أو «Codex» بناءً على مكدسك، وإمكانية الوصول إلى حسابك، وسياسة الأمان، وسير العمل المفضل لديك. وعندما تشمل المهمة عدة ملفات، عادةً ما يكون سير عمل الوكيل أكثر أهمية من مجرد اختيار الإجابة الأفضل في الدردشة.
مؤسس يعمل بمفرده أو فريق صغير: استخدم مجموعتي النماذج معًا إذا سمحت الميزانية بذلك. ومن الأمثلة العملية على ذلك استخدام GlobalGPT لإجراء المقارنات اليومية بين النماذج وتوليد الأوامر من الفكرة إلى الكود، بالإضافة إلى استخدام Claude Code أو Codex عندما تتطلب المهمة الوصول إلى مستودع الكود وخطوات قابلة للتنفيذ.
| نوع المطور | الخيار الأول الأفضل | لماذا |
|---|---|---|
| مبتدئ يتعلم البرمجة | دردشةGPT | المزيد من الأمثلة، وتفسيرات أكثر شمولاً، ودعامات تعليمية ملائمة للمبتدئين. |
| مطور مبتدئ يعمل على إصلاح الأخطاء | كلود أولاً | تفكير أكثر وضوحًا في الأسباب الجذرية وتوجيهات أفضل من نوع “افحص هذا أولاً”. |
| مهندس أول يقوم بمراجعة تغيير ما | كلود | أكثر ملاءمةً للتوفيق بين الخيارات، وترتيب المخاطر، والنقد الموجز. |
| مطور واجهة المستخدم/منشئ واجهة المستخدم | ChatGPT أولاً، ثم كلود ثانيًا | يقوم ChatGPT بصياغة المكون؛ بينما يتولى Claude مراجعة قابلية الوصول إليه، وبنيته، وقابلية صيانته. |
| مسؤول صيانة قاعدة برمجية كبيرة | "Claude Code" أو "Codex"، حسب المكدس وطريقة الوصول | الملفات والأوامر والاختبارات والأذونات أكثر أهمية من مجرد رد واحد في الدردشة. |
| مؤسس شركة «سولو» | كلاهما، غالبًا من خلال مساحة عمل واحدة متعددة النماذج | تعد المسودات السريعة والمراجعة الدقيقة والتبديل السريع بين النماذج أمورًا مهمة عندما يكون المنتج من مسؤولية شخص واحد. |
إذا كنت تتردد بين عائلتي الطرز الأحدث Claude وGPT، فإن المقارنة بين Claude Opus 5.5 وGPT-6 Sol توفر مزيدًا من المعلومات الخاصة بكل طراز على حدة. أما إذا كنت تدرس خطط OpenAI المدفوعة، فإن ChatGPT Plus مقابل Pro يمكن أن تساعد هذه المقارنة في تحديد ما إذا كان الاستخدام المكثف يستحق العناء.
لماذا لا يزال العديد من المطورين يستخدمون كليهما
إن استخدام كل من «كلود» و«تشات جي بي» لا يُعد ترددًا. بل هو حلقة أفضل لمراقبة الجودة.
- التخطيط مع كلود، والتنفيذ باستخدام ChatGPT: يكون ذلك مفيدًا عندما تريد استخدام Claude لتقليل المخاطر وChatGPT لإنشاء النسخة الأولية.
- الصياغة باستخدام ChatGPT، والمراجعة باستخدام Claude: مفيد عندما تحتاج إلى كتابة كود بسرعة، لكنك ترغب في الحصول على رأي ثانٍ أكثر صرامة.
- اسأل عن كلا الأمرين قبل البدء في الإنتاج: مفيدة في عمليات الدفع، والمصادقة، والتحميل، وعمليات الترحيل، والتخزين المؤقت، والتغييرات الجذرية في قاعدة البيانات.
- استخدم وكيلًا عندما تتطلب المهمة ملفات: قد يكون «كود كلود» أو «كوديكس» أكثر أهمية من المحادثة العادية عندما يحتاج النموذج إلى سياق المستودع.
يتناسب نموذج GlobalGPT مع نمط “استخدام كليهما” عندما تكون المهمة تتمثل في المقارنة الفورية، أو المساعدة اليومية في البرمجة، أو التخطيط، أو البحث. وهو مفيد بشكل خاص في المقارنة اليومية بين النماذج، وتكرار المسودات، والحصول على آراء ثانية سريعة، واختيار نمط النموذج الأنسب للعمل التالي.
إذا كان الوصول إلى «كلود» هو الأمر الوحيد الذي تقوم بتقييمه، فإن أفضل بدائل كلود للذكاء الاصطناعي تعد هذه القائمة دليلاً احتياطياً أكثر شمولاً.
الأسئلة الشائعة
أيهما أفضل للبرمجة في عام 2026: كلود أم ChatGPT؟
اختر Claude أولاً لمراجعة الكود، وتصحيح الأخطاء الغامضة، وتخطيط البنية، والاستدلال في السياقات الطويلة. اختر ChatGPT أولاً لمسودات التنفيذ، والأمثلة، وأعمال الواجهة الأمامية، وبناء هيكل الاختبارات. عندما تتطلب المهمة الوصول إلى المستودع، أو الأوامر، أو الاختبارات، أو تعديلات متعددة الملفات، قارن بين Claude Code و Codex بدلاً من الاعتماد على الدردشة وحدها.
هل يُعد «كلود» أفضل من «تشات جي بي» في تصحيح الأخطاء؟
غالبًا ما يكون «كلود» الخيار الأفضل في المرحلة الأولى من عملية تصحيح الأخطاء، لأنه يميل إلى إعطاء الأولوية للسبب المحتمل وشرح مسار الفشل بوضوح. في اختباراتنا الخاصة بـ JavaScript و Next.js، أظهر «كلود سونيت 5» أداءً قويًّا بشكل خاص في التشخيص الموجز. أما «تشات جي بي» فقد ظل قويًّا عندما تطلب الإصلاح تفاصيل تنفيذ أكثر شمولاً.
هل يُعد ChatGPT Codex أفضل من Claude Code؟
ولا يُعتبر أي منهما أفضل تلقائيًا لكل فريق. يتناسب نموذج «ChatGPT Codex» مع سير العمل الذي يركز على نموذج «OpenAI» ومهام الوكلاء التي تتطلب قدرًا كبيرًا من التنفيذ. أما نموذج «Claude Code» فيُعدّ خيارًا قويًّا عندما يستفيد العمل من أسلوب «Claude» في التخطيط والمراجعة والاستدلال في سياقات طويلة المدى. يعتمد الاختيار الأفضل على الوصول إلى المستودع، والتسعير، ومجموعة التقنيات المستخدمة، والأذونات، وسياسة الفريق.
أيهما أفضل بالنسبة لقاعدة برمجية كبيرة؟
في حالة قاعدة الكود الكبيرة، يكون سير عمل الوكيل أكثر أهمية من نموذج الدردشة وحده. استخدم «Claude Code» أو «Codex» عندما يحتاج المساعد إلى فحص الملفات، أو تشغيل الأوامر، أو إجراء الاختبارات، أو تتبع السلوك عبر الوحدات النمطية. واحرص على إجراء مراجعة بشرية فيما يتعلق بالأذونات، والأوامر المحفوفة بالمخاطر، والفروق النهائية.
أيهما أفضل للمبتدئين الذين يتعلمون البرمجة؟
عادةً ما يكون ChatGPT أسهل للمبتدئين لأنه يقدم عادةً المزيد من الأمثلة، وتفسيرات أكثر شمولاً، ومقتطفات جاهزة للتشغيل. أما Claude فيمكن أن يكون خياراً أفضل عندما يواجه المبتدئ صعوبة في فهم سبب فشل شيء ما ويحتاج إلى تفسير مفاهيمي أوضح.
أيهما أفضل لكتابة كود HTML وواجهة المستخدم (UI) في الواجهة الأمامية؟
غالبًا ما يكون ChatGPT أكثر كفاءة في إنشاء المسودة الأولى لـ HTML أو CSS أو المكونات. أما Claude فهو مفيد في مراجعة البنية، وتبسيط التصميم، واكتشاف مشكلات إمكانية الوصول أو قابلية الصيانة. وللحصول على عمل واجهة مستخدم متقن، استخدم ChatGPT لكتابة المسودة وClaude لمراجعتها.
أي نموذج أفضل لكتابة الاختبارات؟
يُعد ChatGPT الخيار الأفضل عندما تريد ملف اختبار كاملًا يتضمن عمليات الاستيراد وبنية تبدو قابلة للتشغيل. أما Claude فهو الخيار الأفضل عندما تريد فهم السلوكيات التي تحتاج إلى الحماية وأهمية اختبار التراجع. ومن أفضل أساليب العمل إنشاء الاختبارات باستخدام ChatGPT ثم سؤال Claude عن الحالات الاستثنائية المفقودة.
هل تثبت اختبارات الأداء مثل SWE-Bench أي مساعد برمجة هو الأفضل؟
لا. تُعد SWE-Bench وSWE-Bench Pro وTerminal-Bench مؤشرات قيّمة، لا سيما بالنسبة لسير عمل الترميز القائم على الوكالة، لكنها لا تتنبأ بشكل كامل بمدى المساعدة اليومية في الترميز. فمعايير الأداء تقيس مجموعة اختبارات خاضعة للرقابة؛ أما المطورون الحقيقيون فيحتاجون أيضًا إلى منطق واضح، وكود قابل للاستخدام، وتغييرات قابلة للصيانة، وخطوات تحقق جيدة.
هل ينبغي للمطورين استخدام كل من «كلود» و«تشات جي بي»؟
نعم، خاصةً عندما يتعلق الأمر بالأعمال الجادة. استخدم «كلود» لوضع الخطة، ومراجعة المخاطر، والتشخيص. واستخدم «تشات جي بي» لكتابة مسودات التنفيذ، والأمثلة، وهياكل الاختبار. ثم قم بتشغيل الكود، وافحص الفروق، وتحقق من سلوك البرنامج في مشروعك الخاص.
هل يمكنني مقارنة كلود وChatGPT في GlobalGPT؟
نعم. يُعد GlobalGPT أداة مفيدة لمقارنة إجابات Claude وChatGPT في مساحة عمل واحدة عندما تكون النماذج المطلوبة متوفرة هناك. وهو يعمل بشكل جيد في الأسئلة اليومية المتعلقة بالكود، والتخطيط، والبحث، والحصول على آراء ثانية. وهي لا تحل محل Claude Code أو Codex أو بيئة تطوير متكاملة (IDE) أو واجهات برمجة التطبيقات (APIs) الرسمية أو الأدوات على مستوى المستودعات.





