Resposta rápida: Uma descrição confiável no formato Kling 3.0 descreve o que o espectador deve ver e ouvir: o tema, a ação visível, o comportamento da câmera, o cenário, a iluminação e o áudio. Considere isso como uma lista de verificação prática, e não como uma fórmula oficial rígida. Para clipes com várias tomadas, identifique cada tomada e indique um intervalo de tempo para ela.
No entanto, tentar descobrir essa fórmula adivinhando diretamente dentro de um gerador de vídeos esgota rapidamente os créditos caros. Toda vez que sua instrução falha ou é bloqueada por um filtro de segurança agressivo, você perde dinheiro e prejudica seu ritmo criativo.
Uma instrução vaga ainda pode gerar uma imagem impressionante, mas fornece menos pistas sobre movimento, continuidade, diálogo e som. Compreender como Como funcionam os créditos de vídeo com IA facilita a reserva de gerações pagas para prompts que estão prontos para serem testados.
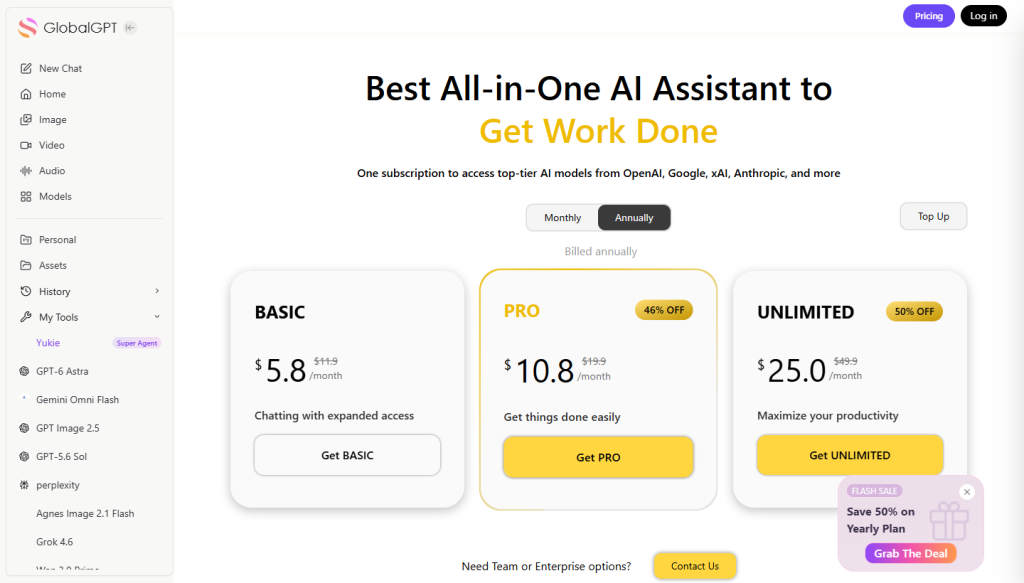
GlobalGPT mantém as etapas de planejamento e geração em uma única área de trabalho. Você pode usar GPT-5.6 Sol Para refinar uma lista de tomadas, crie uma imagem de referência com um modelo de imagem compatível e, em seguida, anime-a com o Kling 3.0. O GlobalGPT oferece seu plano Pro por $10,8 por mês, com cobrança anual; os preços e as regras de crédito estão sujeitos a alterações, portanto, verifique a página de pedidos antes de assinar.

Índice
Guia de sugestões do Kling 3.0 para melhores vídeos de IA: O que é a “mentalidade do diretor”?
A “mentalidade do diretor” significa escrever seu texto de orientação como se você estivesse dando instruções práticas a um cinegrafista e a um ator em um set de filmagem real, em vez de simplesmente descrever a aparência de uma pintura.
- Abandone o hábito de usar imagens como prompt: Uma lista como “mulher bonita, 4K, obra-prima, altamente detalhada” pode descrever a aparência, mas não indica o que muda com o tempo. Adicione uma ação clara e uma instrução para a câmera.
- Priorize ações visíveis: Em vez de “um copo quebrado no chão”, escreva “um copo cai da mesa e se estilhaça no chão”. Verbos concretos proporcionam ao modelo um evento para encenar. Isso Guia de movimentação da câmera com IA Kling é útil na hora de definir o comportamento da lente em torno desse evento.
- Aborde o assunto logo no início: Identifique a pessoa ou o objeto principal antes de acrescentar detalhes do fundo. Isso aumenta as chances de a foto manter a atenção no tema pretendido, embora não garanta uma consistência perfeita.
Como estruturar uma boa sugestão para o Kling 3.0?
Uma sugestão útil para uma tomada única pode seguir uma estrutura de cinco partes: Câmera + Cena + Ação do personagem + Aparência/Iluminação + Áudio. Trata-se de uma estrutura prática de redação, não de uma regra oficial exclusiva do Kling. Se você quiser uma sequência mais longa, opte por tomadas identificadas em vez de forçar todas as instruções a caberem em uma única frase. O fluxo de trabalho em Como usar o Kling 3.0 como um profissional mostra como essas escolhas se encaixam em um processo de geração completo.
- Comece pela câmera: Defina o enquadramento e o movimento, como “close-up estático” ou “dolly lento avançando”. Use um movimento principal por tomada, a menos que a transição seja essencial.
- Descreva o cenário e a ação: Descreva o ambiente, o personagem e o que ele está fazendo agora: “Em uma rua enevoada de Tóquio, um detetive cyberpunk levanta um copo de papel e observa o trânsito.”
- Finalize com aparência e som: Adicione iluminação, atmosfera e detalhes sonoros que possam ser descritos: “reflexos de néon, meia-noite chuvosa, tráfego distante, chuva batendo no toldo”.”
- Use tantos detalhes quanto a cena exigir: Não existe um número ideal comprovado de 20 a 50 palavras. Remova contradições e preenchimentos supérfluos, mas mantenha os detalhes que controlam o tempo, o diálogo, o som ou a continuidade.
Modelo de foto única:
[Câmera e enquadramento]. [Personagem] [ação visível] em [cenário]. [Iluminação e estilo visual]. Áudio: [diálogo, ruídos de ambiente e efeitos sonoros]. Mantenha [detalhes importantes de continuidade] consistentes.Modelo para múltiplas fotos:
Tom 1 (0-2 s), [enquadramento/movimento]: [personagem e ação].
Tom 2 (2-5 s), [enquadramento/movimento]: [próxima ação e diálogo].
Áudio: [fundo sonoro ambiente], [efeitos específicos], [locutor e entonação].
Continuidade: mantenha [rosto/roupas/adereços/composição/direção da luz] consistentes em ambas as tomadas.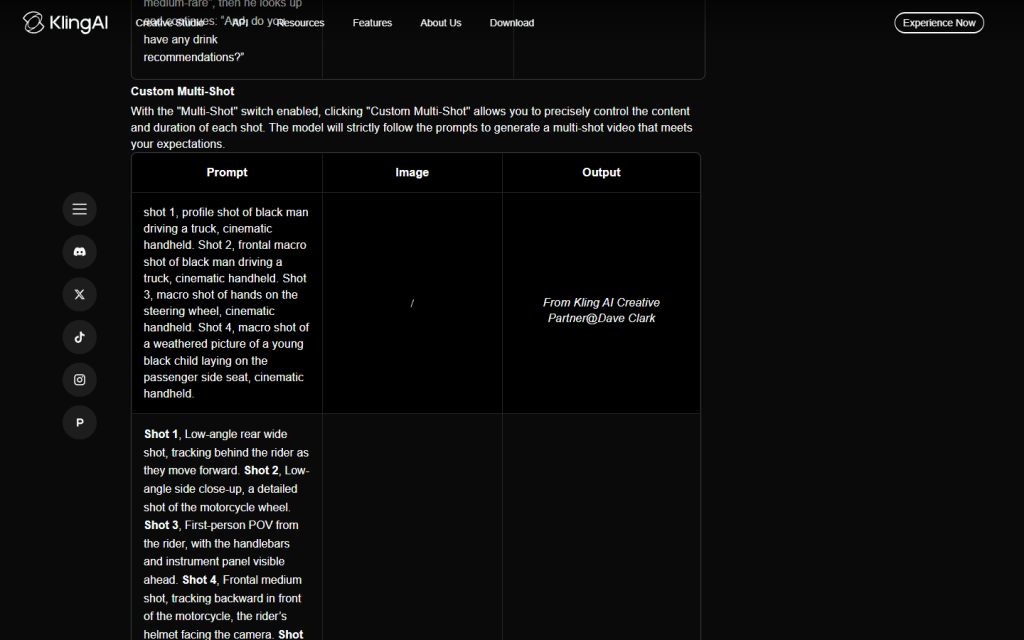
Quais são os melhores prompts para movimento de câmera e áudio nativo?
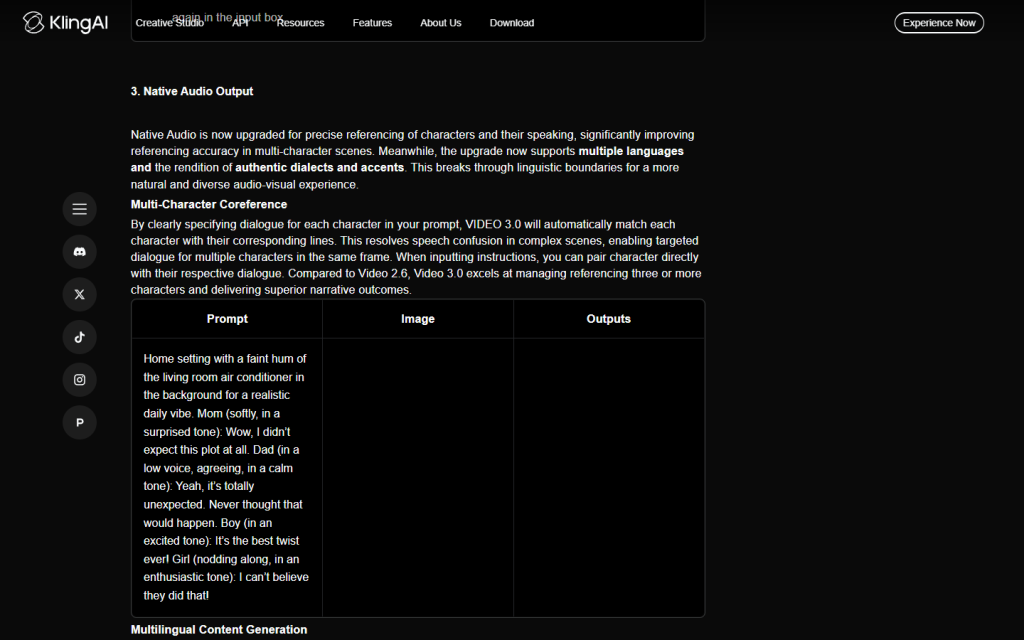
As melhores instruções para movimentos de câmera utilizam terminologia tradicional de Hollywood, como “tracking shot” ou “pan”, enquanto o áudio original é acionado colocando-se o diálogo entre aspas e descrevendo os efeitos sonoros.
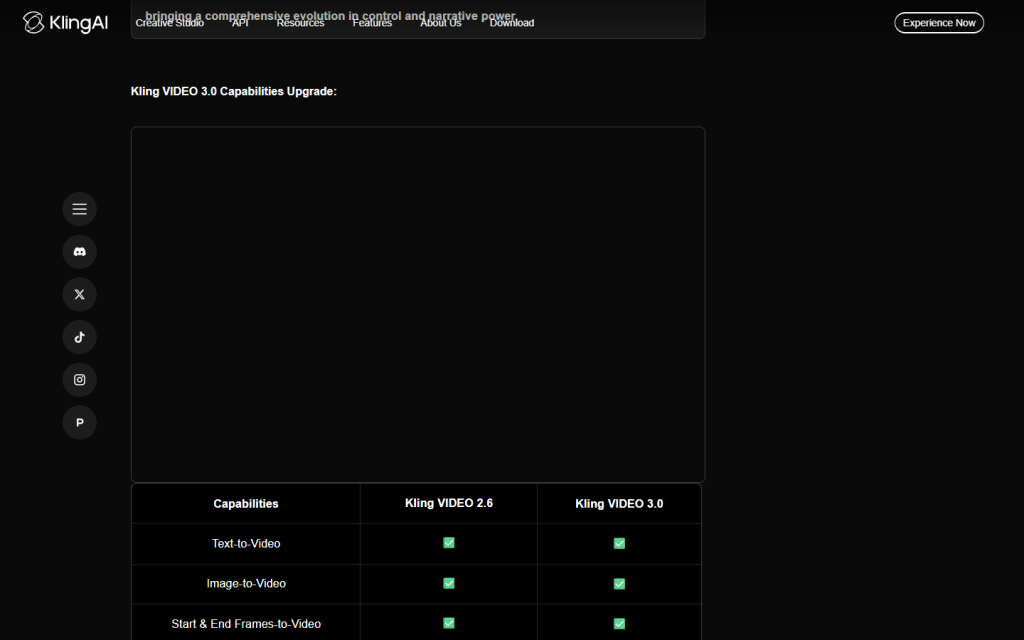
Para uma orientação mais clara do áudio, identifique quem está falando, a forma de expressão, o ambiente e os efeitos sonoros. De acordo com o Guia oficial do Kling VIDEO 3.0, O VIDEO 3.0 oferece suporte a áudio nativo e à geração personalizada de múltiplas tomadas; o áudio nativo não se limita ao modelo Omni.
- Use os termos exatos da câmera: “Tom de acompanhamento” faz com que a câmera siga o objeto. “Tom aéreo com drone” oferece uma visão aérea elevada. “Tom estático com tripé” faz com que a câmera permaneça fixa enquanto a ação ocorre dentro do quadro.
- Atribua uma função a cada tomada: Se você precisar de um plano geral e de uma reação íntima, separe-os em Plano 1 e Plano 2. Isso fica mais claro do que pedir um plano geral e um close-up extremo ao mesmo tempo.
- Nome do áudio ambiental: Adicione sons perceptíveis, como “passos pesados no cascalho molhado”, “chuva constante na lona” ou “trovões distantes”. Para cenas com ênfase na textura, o mesmo princípio se aplica a um Fluxo de trabalho do vídeo ASMR Kling.
- Atribuir um diálogo a um personagem: Escreva o nome do personagem, as palavras exatas e a forma de interpretação:
O soldado sussurra com uma voz fraca e exausta: "Finalmente vamos para casa"." - Escolha um idioma de diálogo compatível: O guia do VIDEO 3.0 do Kling lista chinês, inglês, japonês, coreano e espanhol, com vários sotaques ou dialetos indicados para o chinês e o inglês.
Modelos de prompts do Kling 3.0 de nível profissional (copiar e colar)
[Sugestão de ação e diálogo]
Close-up estático: um soldado cansado, em uma trincheira enlameada, olha para o céu, enquanto chove forte; ele sussurra: "Finalmente vamos para casa". Iluminação cinematográfica escura, clima sombrio.
[Sugestão de Física e Movimento]
Tomada em câmera lenta, um carro esportivo fazendo drift em uma curva fechada na montanha, com os pneus soltando fumaça e jogando cascalho na direção da lente, sob a luz intensa do sol da tarde, em 8K fotorrealista.[Sugestão de diálogo para múltiplas tomadas]
Tomada 1 (0-2s), close-up estático: Um soldado cansado em uma trincheira enlameada levanta o olhar lentamente enquanto a chuva forte escorre pelo seu capacete. Tom 2 (2–5 s), suave aproximação com câmera na mão: ele expira, mantém o olhar fixo no céu e sussurra com voz baixa e exausta: "Finalmente vamos para casa". Áudio: chuva constante batendo na lona, trovões distantes, leve movimento de tecido. Iluminação cinematográfica discreta, clima sombrio. Mantenha o mesmo rosto, uniforme, disposição da trincheira e direção da chuva nas duas tomadas.Como as imagens de referência melhoram a consistência dos vídeos gerados por IA?
As imagens de referência fornecem ao Kling um ponto de partida visual para rostos, roupas, adereços e estilo. Elas podem melhorar a consistência e reduzir a repetição de descrições visuais, mas não fixam permanentemente todos os detalhes. Uma referência sólida ainda funciona melhor quando combinada com uma instrução de movimento específica. Para conhecer mais técnicas de continuidade, consulte esta explicação sobre Kling: Consistência dos personagens de IA.
- Remover detalhes de aparência repetidos: Depois de anexar uma imagem útil do personagem, dedique maior parte da descrição à ação, ao movimento da câmera e aos sons, em vez de repetir detalhes sobre o cabelo, as roupas e as características faciais.
- Descreva um movimento que se encaixe na fonte: Um retrato em close é adequado para uma expressão facial contida; uma imagem de corpo inteiro oferece ao modelo mais informações para a maneira de andar ou os gestos. Isso Fluxo de trabalho de conversão de imagem em vídeo Kling aborda a preparação da imagem original com mais detalhes.
- Reafirmar as prioridades de continuidade: Se o rosto, o figurino, o adereço ou a direção da luz forem os aspectos mais importantes, especifique-os. As referências aumentam as chances de manter a continuidade; elas não eliminam as transições ou os desvios na cena.
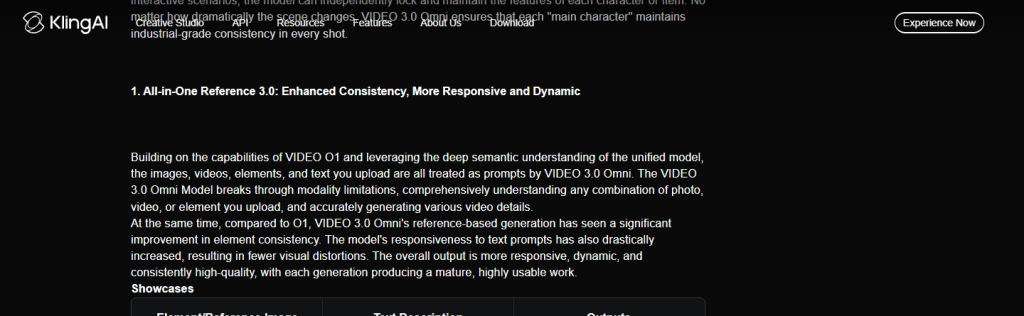
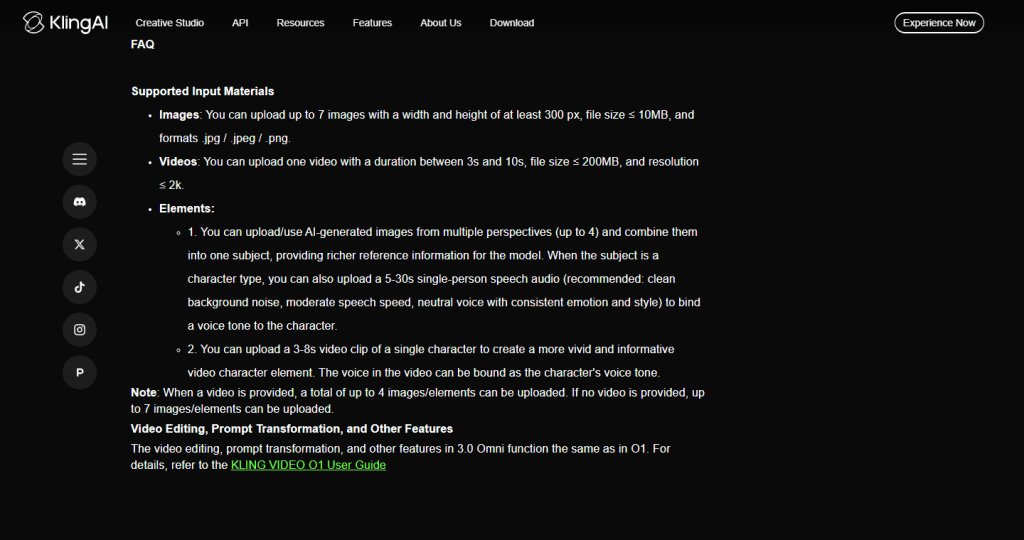
O Guia oficial do VIDEO 3.0 Omni aceita até sete imagens ou um vídeo de 3 a 10 segundos como entrada. Quando um vídeo é fornecido, o guia limita o número de imagens/elementos adicionais a quatro. Também se aplicam regras relativas ao tamanho do arquivo e às dimensões mínimas; portanto, verifique o painel de envio atual antes de preparar um lote grande.
| Entrada | Ideal para | Foco no prompt | Atenção especial |
|---|---|---|---|
| Somente texto | Exploração de conceitos e cenas sem personagens fixos | Tema, ação, câmera, cenário, iluminação, áudio | É preciso descrever mais detalhes visuais |
| Imagem de referência | Personagem, objeto, roupa ou estilo visual conhecido | Movimento, câmera, performance, som | A consistência melhora, mas não é garantida |
| Vídeo de referência no Omni | Sinais de movimento ou continuidade de um clipe existente | O que manter e o que mudar | Aplicam-se os limites atuais de duração e de contribuição do acompanhante |
Como você pode criar um fluxo de trabalho de vários modelos para economizar créditos de geração?
Você pode criar um fluxo de trabalho multimodelo usando uma IA de texto rápida para escrever seu script, uma IA de imagem de alta qualidade para gerar sua imagem de referência e, por fim, usar a IA Kling somente para a animação real, reduzindo drasticamente créditos desperdiçados.
A economia varia de acordo com o projeto, mas essa ordem antecipa as revisões de baixo custo, antes da produção do vídeo. A mesma lógica de preparação aparece neste fluxo de trabalho para transformando imagens em vídeos cinematográficos Kling.
- Escreva o briefing da filmagem: Peça ao GPT-5.6 Sol ou a outro modelo de texto competente para identificar enquadramentos contraditórios, ambiguidade na atribuição de falas, transições ausentes e tomadas sobrecarregadas. Trate o rascunho como um editor, e não como uma autoridade sobre os limites atuais do Kling.
- Crie a referência: Crie ou escolha uma imagem que mostre claramente o tema, as roupas, os adereços e o enquadramento necessários para o movimento.
- Animação no Kling 3.0: Adicione a referência e, em seguida, use o prompt principalmente para definir a ação, a câmera, o tempo e o áudio. Gere uma variação controlada antes de expandir a cena.
- Analisar falhas observáveis: Observe as variações na identidade dos personagens, as ações que faltaram, os movimentos incorretos da câmera, o equilíbrio do áudio e a continuidade. Altere um fator por vez.
Assista: Como solicitar vídeos de IA como um diretor
Veja como os cineastas profissionais de IA usam prompts cinematográficos específicos e imagens de referência para controlar movimentos complexos da câmera neste tutorial aprofundado:
Como corrigir erros e alucinações comuns de IA?
Comece removendo as instruções conflitantes e decidindo qual falha é mais importante. Algumas plataformas oferecem um campo de prompt negativo e outras não; mesmo quando esse campo está disponível, ele pode reduzir padrões indesejados, mas não consegue garantir uma renderização sem erros. Se você estiver comparando tanto o comportamento do modelo quanto os prompts, isso Comparação entre Seedance 2.0 e Kling 3.0 fornece um contexto útil.
| Problema | Motivo provável | O que experimentar |
|---|---|---|
| Estrutura empenada | A solicitação pede ângulos incompatíveis, como um close-up extremo e uma tomada de corpo inteiro ao mesmo tempo | Escolha um tamanho de quadro por tomada ou separe as imagens em tomadas identificadas |
| Ação perdida | Há muitas ações acontecendo ao mesmo tempo em um curto período | Mantenha um momento de ação principal por tomada e transfira a ação secundária para a próxima tomada |
| Emoção apática | A sugestão menciona uma emoção sem mostrá-la | Descreva comportamentos visíveis, como uma mão trêmula, o olhar baixado ou lágrimas no rosto |
| Alto-falante errado | O diálogo não está definido de forma clara | Indique o nome do orador, cite a frase exata e descreva a forma como foi proferida |
| Desvio de caracteres | Os detalhes relativos à aparência ou às prioridades de referência não estão claros | Use uma referência clara e repita apenas os detalhes de continuidade que são mais importantes |
| Fundo esmaecido ou tremulação | Movimentos rápidos, complexidade da câmera ou mudanças de cena simultâneas | Simplifique o movimento; se a interface apresentar mensagens negativas, descreva o artefato específico sem esperar uma garantia |
Perguntas frequentes
Qual é o melhor formato de prompt para o Kling 3.0?
O melhor formato é uma fórmula cinematográfica estruturada: Movimento da câmera + Descrição da cena + Ação do sujeito + Iluminação/Atmosfera + Marcadores de áudio/tempo.
Como faço para que os personagens da IA Kling falem?
Indique o nome do personagem, coloque o diálogo exato entre aspas e descreva como ele é falado. Tanto o Kling VIDEO 3.0 quanto o VIDEO 3.0 Omni oferecem suporte a áudio nativo; o guia atual do VIDEO 3.0 lista chinês, inglês, japonês, coreano e espanhol como idiomas de diálogo.
Qual é a duração máxima de um clipe no formato Kling VIDEO 3.0?
Os guias atuais do Kling, “VIDEO 3.0” e “VIDEO 3.0 Omni”, indicam que a duração da geração varia de 3 a 15 segundos. As opções disponíveis podem depender do modo selecionado e da interface da plataforma.
Qual é a diferença entre o Kling VIDEO 3.0 e o VIDEO 3.0 Omni?
Ambos os modelos oferecem suporte a áudio nativo e fluxos de trabalho com múltiplas tomadas. O VIDEO 3.0 Omni adiciona um fluxo de trabalho de referência “tudo em um” que permite combinar texto com imagens, vídeo e elementos reutilizáveis, dentro dos limites atuais de entrada.
Quantas referências posso adicionar ao Kling VIDEO 3.0 Omni?
O guia oficial do Omni permite até sete imagens ou um vídeo de 3 a 10 segundos. Quando um vídeo é fornecido, é possível usar até quatro imagens ou elementos adicionais. Verifique na interface atual os requisitos de tamanho e dimensões dos arquivos.
Por que meus vídeos de IA com o Kling ficam distorcidos ou “derretem”?
Os vídeos geralmente ficam distorcidos porque o prompt contém muitas instruções, movimentos de câmera contraditórios ou não tem uma imagem de referência estável para ancorar os detalhes físicos do personagem.
As imagens de referência são melhores do que instruções apenas com texto?
Imagens de referência são úteis quando a identidade, as roupas, os adereços ou o estilo visual precisam permanecer reconhecíveis. Prompts compostos apenas por texto continuam sendo úteis para a exploração de conceitos. Uma referência pode melhorar a consistência, mas não garante que o personagem fique perfeitamente definido.
Posso usar o Kling 3.0 até o GlobalGPT?
Sim. O GlobalGPT possui um espaço de trabalho de vídeo Kling 3.0 com controles de referência, áudio nativo, duração e resolução. Os preços da plataforma e as regras de crédito podem sofrer alterações; portanto, confirme as configurações atuais antes de gerar um lote grande.
Conclusão
As melhores orientações do Kling 3.0 não se concentram tanto em palavras-chave mágicas, mas sim em orientar escolhas observáveis. Defina o tema, atribua a cada tomada uma ação clara e uma função para a câmera, distribua os diálogos e use referências quando a identidade visual for importante. Um fluxo de trabalho estruturado pode reduzir repetições evitáveis, enquanto uma revisão final ainda deve verificar a continuidade, artefatos e som. Antes de publicar o trabalho do cliente, revise também as orientações atuais sobre Kling – Uso comercial de IA.