
Atualmente, a taxa da API Gemini 3.1 Pro do Google é de $2 por milhão de tokens de entrada e $12 por milhão de tokens de saída para prompts de até 200.000 tokens. Acima do limite de 200 mil de entrada, as taxas publicadas aumentam para $4 por milhão de tokens de entrada e $18 por milhão de tokens de saída. A entrada em cache tem o preço de $0,20/M ou $0,40/M, mais $4,50 por milhão de tokens em cache por hora para armazenamento.
A página do modelo identifica o endpoint como gemini-3.1-pro-preview, com um limite de entrada de 1.048.576 tokens e um limite de saída de 65.536 tokens. Ele oferece suporte a raciocínio, chamada de funções, fundamentação de pesquisa, contexto de URL, execução de código, API Batch, Flex e opções de prioridade. Esses recursos explicam por que o projeto de lei precisa de mais de um número de destaque.
Se o seu trabalho for interativo — pesquisar um briefing, comparar modelos, escrever código e, em seguida, entregar o resultado a um agente —GlobalGPT oferece a você um espaço de trabalho por assinatura que abrange modelos e funções de IA. Os desenvolvedores também podem recorrer à API, à CLI, ao MCP e ao agente Yukie quando for necessário transferir o trabalho de um chat para um fluxo de trabalho repetível. O preço da API abaixo continua sendo o preço por uso praticado pelo próprio Google.
- O que é o Gemini 3.1 Pro e o que significa o limite de contexto
- Preços da API Gemini 3.1 Pro por milhão de tokens
- Exemplos de custos da API do Worked Gemini 3.1 Pro
- Como o armazenamento em cache de contexto altera a conta
- Os planos para consumidores são diferentes do faturamento por API
- Quando a API, a CLI, o MCP ou um espaço de trabalho multimodelo são a opção ideal
- Os planos para consumidores e o faturamento por API atendem a finalidades diferentes
- Transforme a tabela de preços em um orçamento concreto
- O que um contexto mais amplo muda na prática
- Quando um espaço de trabalho é melhor do que um livro-razão simbólico
- PERGUNTAS FREQUENTES
O que é o Gemini 3.1 Pro e o que significa o limite de contexto
A página atual do Google sobre o modelo descreve o Gemini 3.1 Pro Preview como um modelo otimizado para raciocínio mais robusto, engenharia de software, uso preciso de ferramentas e fluxos de trabalho de agentes com várias etapas. O modelo aceita entradas de texto, imagens, vídeo, áudio e PDF, e retorna texto.
| Detalhes do modelo | Valor publicado | Por que isso é importante em termos de custo |
|---|---|---|
| ID do modelo | gemini-3.1-pro-preview | Utilize o ID exato ao associar uma conta ou uma configuração do SDK. |
| Limite de entrada | 1.048.576 tokens | É possível usar um contexto amplo, mas os tokens ainda contam como entrada. |
| Limite de saída | 65.536 tokens | Saídas longas podem representar a maior parte do custo de uma solicitação. |
| Ferramentas | Raciocínio, chamada de função, determinação da localização da pesquisa, contexto da URL, execução de código, armazenamento em cache | O uso da ferramenta pode gerar solicitações ou consumo de tokens além de um simples prompt. |
Preços da API Gemini 3.1 Pro por milhão de tokens
A página de preços do Google distingue os modos Padrão, em Lote, Flex, Prioritário e Colaborador. A tabela abaixo utiliza o plano pago padrão atual apresentado para o Gemini 3 Pro Preview, cujo link do modelo identifica gemini-3.1-pro-preview.
| Plano pago padrão | Prompt ≤ 200 mil tokens | Solicitação > 200 mil tokens |
|---|---|---|
| Tokens de entrada | $2.00 / 1M | $4.00 / 1M |
| Tokens de saída, incluindo o raciocínio | $12,00 / 1M | $18,00 / 1M |
| Entrada em cache | $0.20 / 1M | $0,40 / 1M |
| Armazenamento em cache | $4,50 / 1 milhão de tokens por hora | |
| Aterramento da Pesquisa Google | 5.000 solicitações/mês distribuídas entre os modelos Gemini 3 e mais recentes; depois, $14 por cada 1.000 solicitações | |
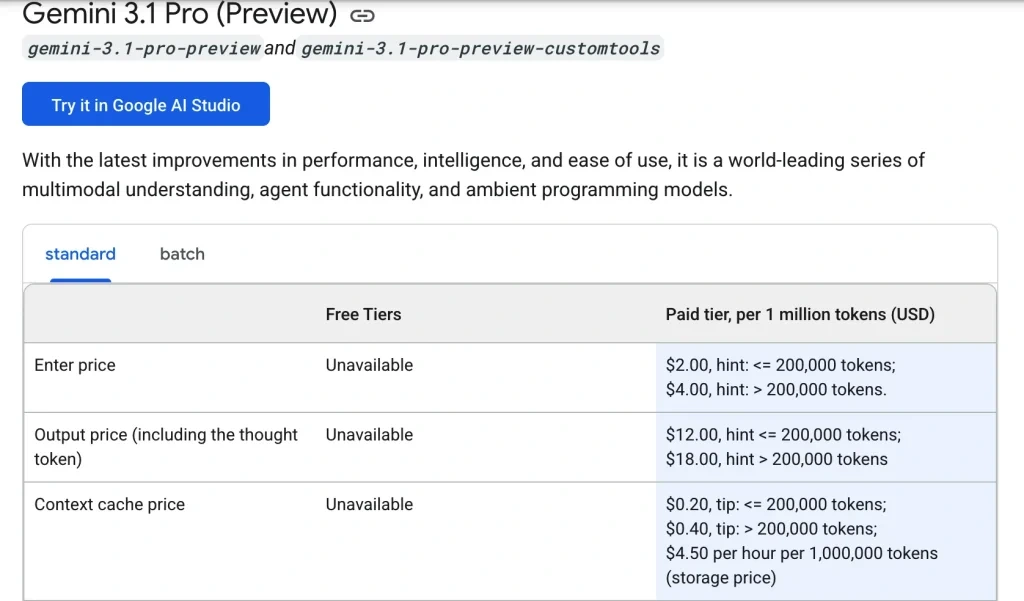
Há dois detalhes que podem passar despercebidos. Primeiro, o termo “saída” inclui tokens de raciocínio na tabela publicada. Segundo, uma solicitação que acione a validação da Pesquisa do Google pode gerar cobranças de pesquisa após o esgotamento da cota mensal compartilhada. Uma resposta modelo, por si só, não constitui uma fatura completa.
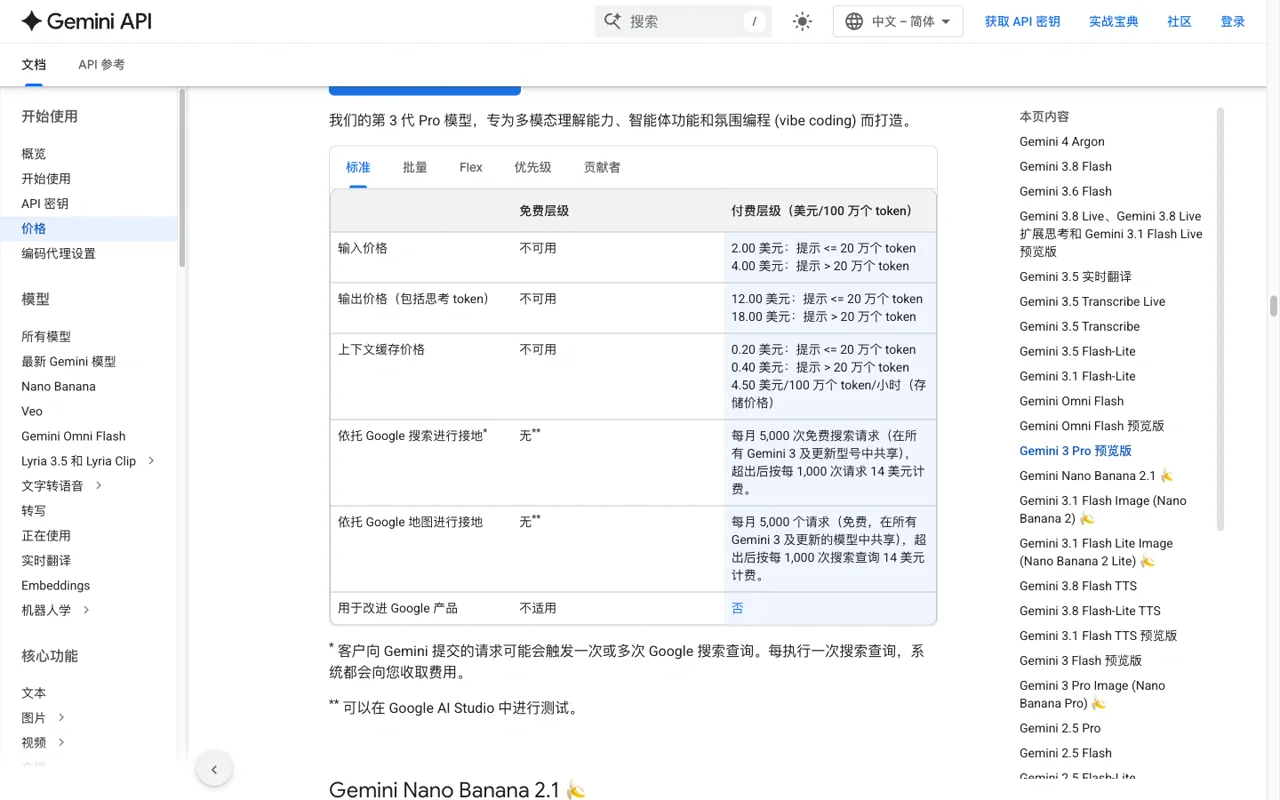
Esse limite é o que transforma uma estimativa simbólica em uma conta diferente. Se uma solicitação envolver uma base de código extensa ou um contexto repetitivo, avalie o tamanho do prompt antes de escolher o modelo ou a opção de armazenamento em cache.
Exemplos de custos da API do Worked Gemini 3.1 Pro
Utilize tokens ÷ 1.000.000 × a taxa aplicável. Os exemplos abaixo não incluem impostos, créditos e cobranças específicas da ferramenta.
| Cenário | Entrada | Saída | Custo estimado do token |
|---|---|---|---|
| Venda a descoberto | 50.000 × $2/M = $0,10 | 8.000 × $12/M = $0,096 | $0.196 |
| Prompt extenso de engenharia | 250.000 × $4/M = $1,00 | 20.000 × $18/M = $0,36 | $1.36 |
| Contexto de 1 milhão de tokens, saída de 50 mil | 1.000.000 × $4/M = $4,00 | 50.000 × $18/M = $0,90 | $4.90 |
custo estimado = (tokens de entrada ÷ 1.000.000 × taxa de entrada) + (tokens de saída ÷ 1.000.000 × taxa de saída) + taxas de ferramentas/pesquisa aplicáveis
O exemplo de 250 mil ultrapassa o limite de 200 mil; portanto, as taxas mais altas se aplicam à solicitação. Se o aplicativo enviar um prefixo grande e repetido, o armazenamento em cache pode alterar a parte da cobrança referente à entrada — mas apenas para tokens que realmente se enquadrem como entrada armazenada em cache.
Como o armazenamento em cache de contexto altera a conta
O armazenamento em cache é útil quando as mesmas instruções longas, o mesmo contexto da base de código ou o mesmo material de referência são enviados repetidamente. Para o nível padrão mostrado acima, a entrada em cache custa $0,20/M abaixo do limite de 200 mil e $0,40/M acima dele, enquanto os tokens armazenados em cache custam $4,50/M tokens por hora.
Essa é uma opção prevista na tabela de preços, e não um desconto garantido em todas as solicitações repetidas. Acompanhe o uso de tokens em cache nos dados de faturamento do provedor e inclua o tempo de armazenamento na estimativa.
Os planos para consumidores são diferentes do faturamento por API
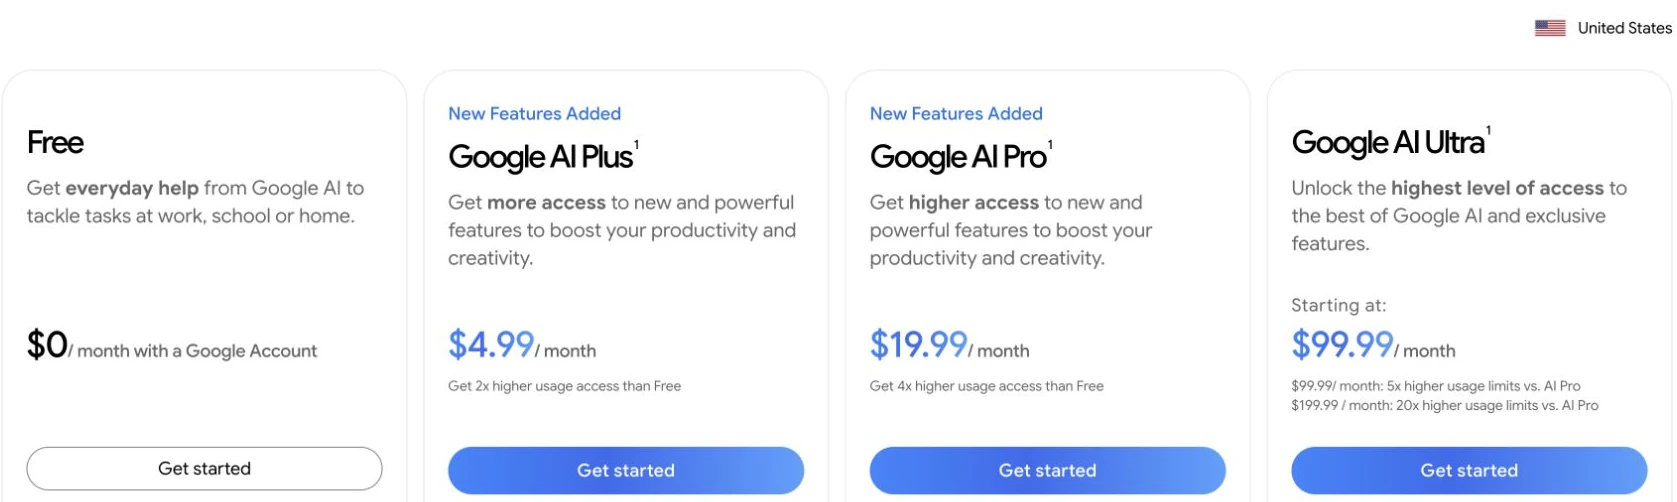
A assinatura do Google AI Pro ou Ultra é um plano para consumidores, com recursos de aplicativos e regras de acesso. O faturamento da API Gemini é medido por tokens e ferramentas. Uma assinatura para consumidores não se transforma automaticamente em crédito de API, e um projeto de API não inclui automaticamente os benefícios dos aplicativos para consumidores.
Quando a API, a CLI, o MCP ou um espaço de trabalho multimodelo são a opção ideal
Escolha a API quando seu software precisar de chamadas previsíveis e medidas, uma chave de provedor e uma fatura que você possa calcular a partir dos registros de tokens. Escolha uma rota CLI ou MCP quando o modelo precisar funcionar em conjunto com um terminal, um repositório ou um servidor de ferramentas já existente. A rota do agente Yukie é útil quando a tarefa envolve várias etapas que exigem planejamento e transferências de responsabilidade, em vez de uma conclusão isolada.
GlobalGPT atende ao aspecto interativo dessa decisão: comparar modelos, criar rascunhos, analisar resultados e passar para a codificação ou outras funções de IA em um único painel. Seu preço e os termos do plano constituem uma decisão de produto à parte; a tabela de preços do Google acima continua sendo a fonte de referência para o custo da API Gemini.

Os planos para consumidores e o faturamento por API atendem a finalidades diferentes
O Gemini 3.1 Pro pode aparecer tanto em um plano de aplicativo para consumidores quanto em um fluxo de trabalho de API para desenvolvedores, mas não se trata da mesma fatura. Um plano para consumidores dá acesso a um aplicativo e aos limites nele incluídos. A API cobra pelo uso de tokens, armazenamento em cache e qualquer uso de ferramentas ou infraestrutura no âmbito de um projeto de desenvolvedor.
| Se você precisar… | Use a rota que corresponder a ela | Orçamento em torno de |
|---|---|---|
| Acesso ao aplicativo interativo | Plano para o consumidor | Preço do plano, acesso incluído e limites de uso atuais. |
| Um script ou integração de produto | API Gemini | Entrada, saída, entrada em cache, armazenamento e custos com ferramentas. |
| Trabalho com repositórios ao lado de um terminal | CLI ou uma ferramenta conectada à API | Chamadas de modelo e o fluxo de trabalho que as invoca. |
| Um fluxo de várias etapas, da pesquisa à produção | MCP ou um agente da Yukie | Utilização do modelo, ferramentas aprovadas e número de transferências. |
Não descreva uma assinatura de consumidor como crédito de API e não utilize as taxas de tokens de API para prometer acesso a um recurso do aplicativo.
Transforme a tabela de preços em um orçamento concreto
Comece pelo tamanho do prompt, e não pelo nome do modelo. Conte os tokens de entrada, verifique se a solicitação ultrapassa o limite de 200.000 tokens, faça uma estimativa da saída incluindo os tokens de reflexão, caso a tabela de preços os inclua, e acrescente quaisquer taxas de pesquisa ou de contextualização.
- Solicitação resumida: tokens de entrada ÷ 1.000.000 × a taxa de entrada mais baixa.
- Solicitação longa: aplique as taxas de entrada e saída mais altas à solicitação que ultrapassar o limite.
- Contexto repetido: conte apenas os tokens que se enquadram como entrada em cache e inclua o tempo de armazenamento em cache.
- Base de cálculo: acrescente a taxa publicada por solicitação após a cota compartilhada, quando for o caso.
- Previsão de produção: adicionar tentativas repetidas e chamadas de ferramentas, em vez de multiplicar apenas a primeira resposta.
Uma calculadora de tokens é útil quando seus dados de entrada ficam visíveis. Mantenha o limite, a unidade de cobrança e a data ao lado do resultado, para que quem ler posteriormente possa entender o que esse número significa.
O que um contexto mais amplo muda na prática
Um limite de entrada de um milhão de tokens não significa que toda solicitação deva incluir o repositório inteiro. Solicitações muito grandes aumentam o custo e podem dificultar a identificação do arquivo relevante. Comece com um índice, envie a menor parte relevante e adicione o próximo arquivo somente quando a primeira resposta indicar que ele é necessário.
- Crie um breve mapa do repositório antes de enviar os arquivos-fonte.
- Separe as instruções estáveis da alteração do contexto da tarefa.
- Armazene em cache um prefixo repetido somente quando o relatório de uso confirmar uma correspondência.
- Peça os nomes dos arquivos e as referências das linhas para que o resultado possa ser verificado.
- Utilize uma segunda verificação para testes ou casos extremos, em vez de solicitar uma reescrita sem limites.
É aí que a API, a CLI e o MCP se tornam úteis: o modelo pode funcionar paralelamente ao projeto, enquanto o fluxo de trabalho controla qual contexto é enviado e qual ferramenta é chamada.
Quando um espaço de trabalho é melhor do que um livro-razão simbólico
Use a API quando precisar de chamadas previsíveis ao aplicativo e de controle de uso no nível do token. Use a CLI quando o desenvolvimento for realizado em um terminal. Use o MCP quando a tarefa exigir o uso de ferramentas externas aprovadas. Use um agente Yukie quando o trabalho envolver planejamento, uso de ferramentas e transferências de tarefas.
Para trabalhos de descoberta interativa e de mídia mista, Área de trabalho Gemini 3.1 Pro da GlobalGPT oferece um ambiente para comparar um modelo, escrever código e prosseguir para etapas relacionadas a imagens, vídeos, áudio ou agentes. A vantagem financeira decorre da cobertura de uma parte maior do fluxo de trabalho por meio de uma única assinatura; a tarifa da API do Google continua sendo uma cobrança separada do provedor.
PERGUNTAS FREQUENTES
Quanto custa o Gemini 3.1 Pro por milhão de tokens?
Para o plano pago padrão, o Google indica uma taxa de entrada de $2/M e uma taxa de saída de $12/M quando o prompt tem 200 mil tokens ou menos. Acima de 200 mil, as taxas são de $4/M de entrada e $18/M de saída.
Existe um plano gratuito da API Gemini 3.1 Pro?
A página de preços do Google apresenta um plano gratuito com acesso limitado a modelos específicos. Verifique a linha correspondente ao modelo antes de presumir que o Gemini 3.1 Pro tenha acesso gratuito à API.
A API cobra pela integração com a Pesquisa do Google?
A página atual de preços indica 5.000 solicitações de pesquisa gratuitas por mês, distribuídas entre os modelos Gemini 3 e mais recentes, e, a partir daí, $14 por cada 1.000 solicitações. Cada consulta de pesquisa pode ser cobrada separadamente após o esgotamento da cota.
A assinatura do Google AI Pro inclui crédito de API?
Não presuma isso. Os preços dos planos para consumidores e o faturamento de tokens de API são processos distintos e devem ser verificados em suas respectivas páginas oficiais.
Qual é a maneira mais barata de usar o Gemini 3.1 Pro?
Para chamadas de produção programáveis, compare a estimativa de tokens, o armazenamento em cache e as opções de lote ou Flex que você pode realmente utilizar. Para trabalhos interativos envolvendo vários modelos e funções, compare um plano de espaço de trabalho atual separadamente, em vez de tratá-lo como crédito de API.
Use a tabela de preços como uma calculadora, não como um slogan: identificar o ID exato do modelo, verificar o limite de 200 mil, contar os tokens de pensamento gerados e manter os planos dos consumidores separados dos gastos com a API.





