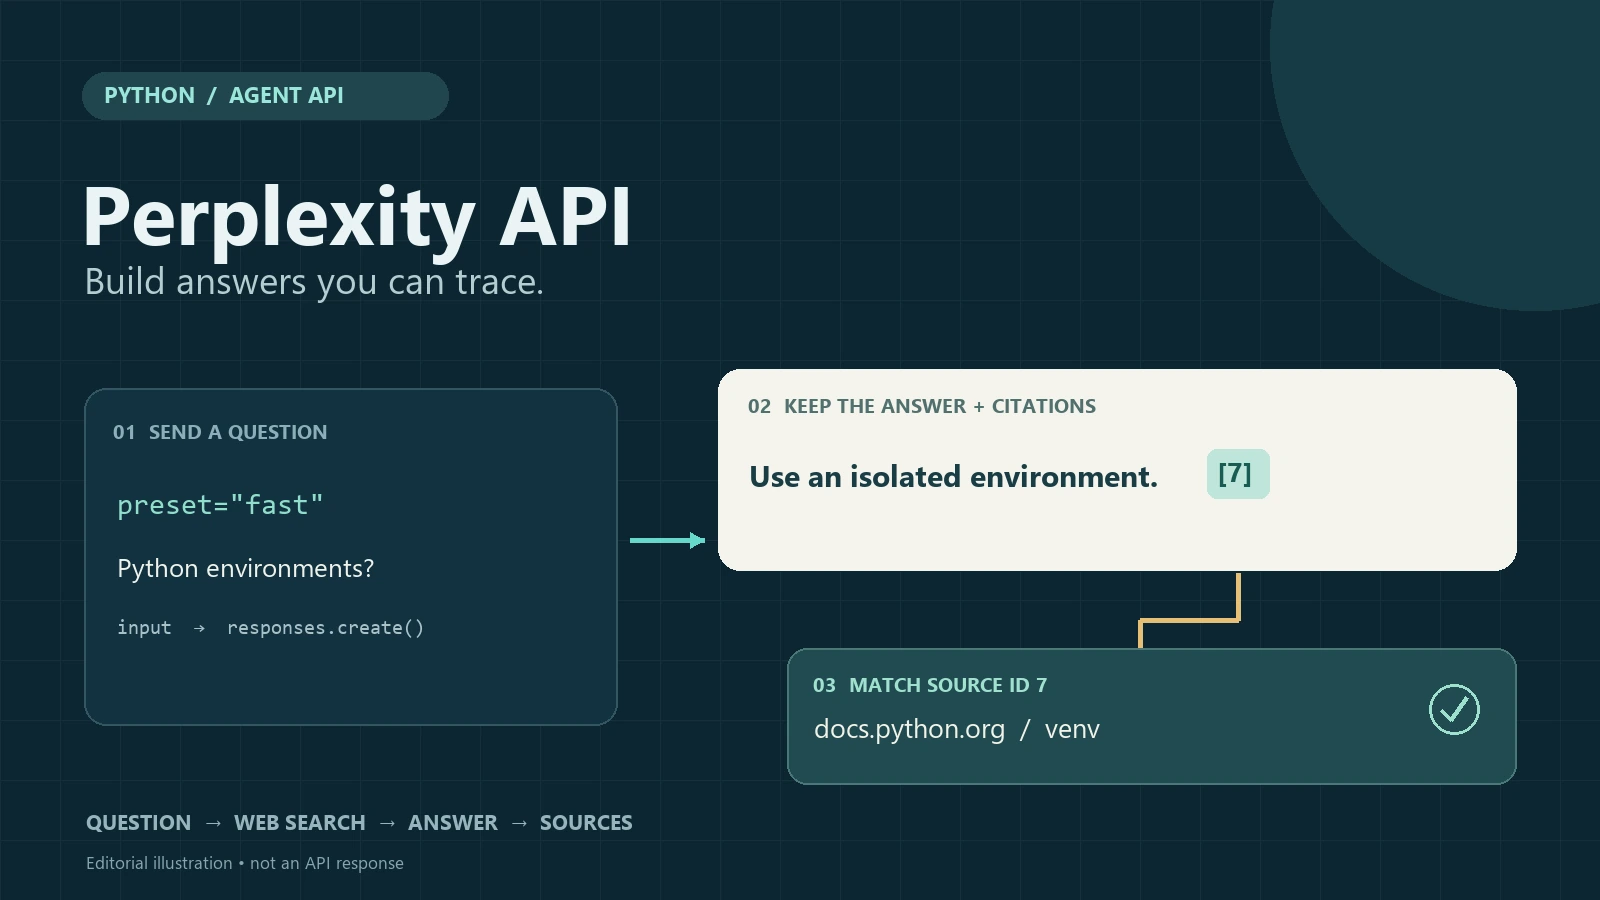
API PERPLEXITY · TUTORIAL IN PYTHON · 2026
Questo tutorial sull'API Perplexity illustra come creare uno script Python che restituisca una risposta con fonti web cliccabili. Utilizza l'API Agent per inviare una domanda, leggere la risposta, associare i marcatori di citazione agli ID delle fonti ed esportare un file Markdown che potrai esaminare.
Useremo una sola domanda per tutto il testo: In che modo un piccolo progetto in Python dovrebbe utilizzare gli ambienti virtuali e gestire le dipendenze? Inizia con una richiesta di base, poi aggiungi l'analisi della sorgente e i filtri di dominio. Sono necessarie conoscenze di base di Python e un account sviluppatore Perplexity con la fatturazione API configurata.
Se anche tu utilizzi l'intelligenza artificiale per le tue ricerche e i tuoi scritti quotidiani, Perplexity su GlobalGPT offre l'accesso all'interno di un unico spazio di lavoro basato sull'intelligenza artificiale, riducendo la necessità di passare da uno strumento all'altro. Tale flusso di lavoro per gli utenti finali è distinto dalla chiave di sviluppo e dalla fatturazione delle API utilizzate in questo contesto.
Risposta rapida: Utilizza il veloce Impostazione predefinita dell'agente per una prima risposta basata sul web, leggi response.output_text per la risposta, e leggi il risultati_della_ricerca voce in risposta.output per le fonti. Abbina ciascun indicatore in linea a una fonte in base al valore restituito id. Una citazione significa che “la risposta porta a questo risultato”; non garantisce che la pagina dimostri ogni affermazione.
Esempio di stato: La sintassi della richiesta è conforme alla documentazione ufficiale consultata il 28 settembre 2026. Lo strumento di citazione è stato verificato utilizzando dati di esempio offline; per questo tutorial non è stata effettuata alcuna richiesta API a pagamento. I record di origine mostrati nell'illustrazione sono esempi illustrativi.
- Quale API Perplexity dovresti utilizzare?
- Passaggio 1: Ottenere una chiave API e configurare Python
- Fase 2: Invia la tua prima richiesta con messa a terra alla sorgente
- Fase 3: Estrarre la risposta e abbinarla alle relative fonti
- Passaggio 4: Migliora la risposta con i filtri di ricerca
- Passaggio 5: Salva una risposta completa con fonti cliccabili
- Streaming e output strutturato
- Costi ed errori comuni
- Passaggio da un vecchio tutorial su Sonar
- Domande frequenti
Tutorial sull'API Perplexity: come scegliere l'API giusta
Si tratta di interfacce per sviluppatori. Il prodotto di chat potrebbe integrare funzionalità simili in modo diverso; la nostra panoramica su Caratteristiche di Perplexity descrive l'esperienza dell'utente.
Di Perplexity Guida rapida all’API ufficiale raggruppa i suoi prodotti per sviluppatori in base all'attività che devi svolgere. Scegli la superficie più piccola che generi i dati di cui la tua applicazione ha effettivamente bisogno.
| API | La migliore vestibilità | Cosa riceve il tuo codice |
|---|---|---|
| Agente | Una risposta completa basata su ricerche sul web o altri strumenti | Elementi di output digitati, testo delle risposte e record dei risultati di ricerca |
| Ricerca | L'applicazione provvederà autonomamente a ordinare, filtrare o riassumere i risultati | Risultati della ricerca senza chiedere a Perplexity di scrivere la risposta definitiva |
| Router | Indirizzare le richieste verso un modello adeguato | Una risposta modello selezionata tramite il router |
| Incorporamenti | Ricerca semantica e indice RAG | Vettori per il proprio livello di ricerca |
Questo tutorial sceglie Agent perché il risultato desiderato è una risposta completa corredata delle relative fonti. Per un quadro più ampio del flusso di lavoro di ricerca, consulta la nostra guida a utilizzo di Perplexity a fini di ricerca.
Informazioni su Sonar: L'attuale Panoramica sulla migrazione afferma che Sonar Chat Completions continua a essere supportato e raccomanda l’uso di Agent per tutti i nuovi progetti. Questo tutorial utilizza quindi Agent. Non si deve dedurre che una vecchia integrazione abbia smesso di funzionare solo perché in un tutorial precedente era indicata una scadenza.
Passaggio 1: Ottenere una chiave API e configurare Python
Creare la chiave e preparare la fatturazione
Apri la console dell'API Perplexity, scegli o crea il progetto che intendi utilizzare, configura la fatturazione delle API e crea una chiave. Conservala sul lato server. Le API per sviluppatori vengono fatturate separatamente dagli abbonamenti per gli utenti; controlla il saldo del tuo progetto prima di effettuare richieste.
Installa l'SDK ufficiale
python -m venv .venv

# macOS/Linux: scegli questo comando di attivazione
source .venv/bin/activate

# Windows PowerShell: usa invece questo comando
.venv\Scripts\Activate.ps1

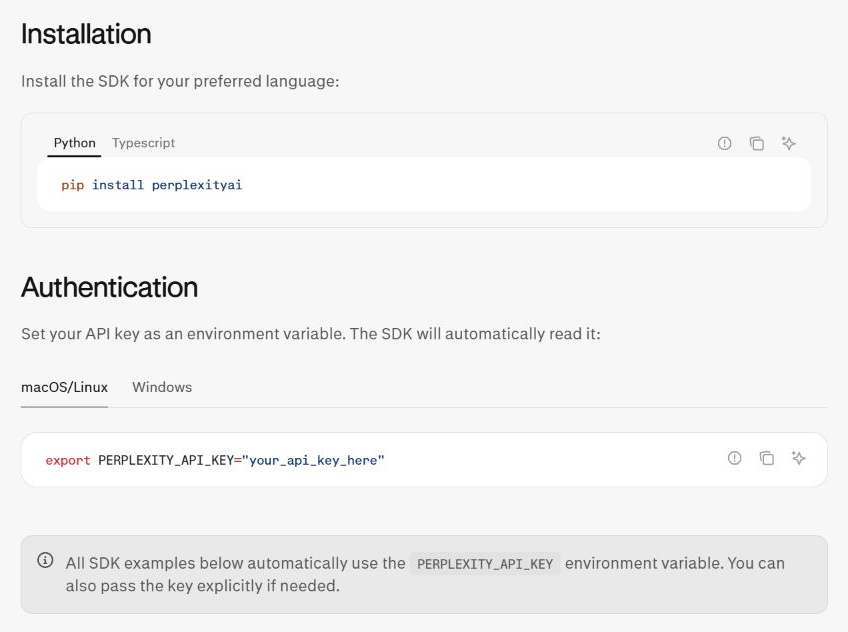
python -m pip install --upgrade perplexityai
Per il codice riportato di seguito, utilizzare Python 3.10 o versioni successive. Attivare l'ambiente utilizzando il comando corrispondente al proprio sistema operativo, quindi installare l'SDK. Se PowerShell blocca l'attivazione, utilizzare .venv\Scripts\python.exe al posto di python per l'installazione e l'esecuzione dello script.
Il nome del pacchetto è perplexityai, mentre l'importazione in Python è perplessità. Utilizza un ambiente virtuale in modo che le dipendenze di questo tutorial non modifichino un altro progetto.
L'esempio utilizza una domanda relativa alla programmazione perché le sue affermazioni possono essere verificate sulla base della documentazione aggiornata. La nostra guida a Perplexity per la codifica spiega come il supporto alla ricerca si integri con la verifica autonoma del codice.
Imposta la chiave API come variabile d'ambiente
# macOS/Linux
export PERPLEXITY_API_KEY="la-tua-chiave-qui"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "la-tua-chiave-qui"
L'SDK legge PERPLEXITY_API_KEY al momento della creazione del client. Non incollare la chiave in un blocco note, non salvarla su Git né inviarla a un browser. Se utilizzi un file .env in locale, mantieni tale file fuori dal controllo di versione e caricalo utilizzando la libreria di variabili d’ambiente che hai scelto.
Fase 2: Invia la tua prima richiesta con messa a terra alla sorgente
Guida rapida all'API Agent documenti POST https://api.perplexity.ai/v1/agent. Il suo client Python incapsula la richiesta con client.responses.create(). Il veloce L'impostazione predefinita abilita la ricerca sul Web, il che permette di mantenere breve il primo esempio.
da perplexity import Perplexity

client = Perplexity()

question = (
    "In che modo un piccolo progetto Python dovrebbe utilizzare gli ambienti virtuali "
    "e gestire le dipendenze?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
Salva il frammento di codice come first_request.py, quindi eseguire python first_request.py nello stesso terminale in cui hai impostato la chiave. Se la chiamata va a buon fine, dovrebbe comparire un testo di risposta non vuoto. Se hai bisogno di una conferma del risultato, passa alla fase di estrazione del codice sorgente; il testo da solo non costituisce una verifica completa.
La proprietà "convenienza" testo_di_uscita ti fornisce il testo della risposta finale. Conserva anche l'intero oggetto della risposta: i record di origine e i dettagli sull'utilizzo si trovano nell'output digitato, non solo nel paragrafo stampato.
La stessa richiesta con cURL
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "In che modo un piccolo progetto Python dovrebbe utilizzare gli ambienti virtuali e gestire le dipendenze?"
  }'
Questo esempio di cURL utilizza la sintassi Bash per macOS/Linux o una shell compatibile con Bash. Ogni esecuzione genera una nuova richiesta a pagamento. Utilizzalo solo quando devi isolare un problema relativo all'endpoint da un problema relativo a Python; non eseguire tutte le versioni solo per seguire l'esempio.
Equivalente in JavaScript lato server
Node.js 18+ include recuperare, quindi un "smoke test" lato server non richiede alcuna libreria aggiuntiva. Leggi il codice sorgente output elementi presenti nella risposta JSON; l’SDK Python offre la comoda testo_di_uscita accessorio.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "In che modo un piccolo progetto Python dovrebbe utilizzare gli ambienti virtuali e gestire le dipendenze?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
Fase 3: Estrarre la risposta e abbinarla alle relative fonti
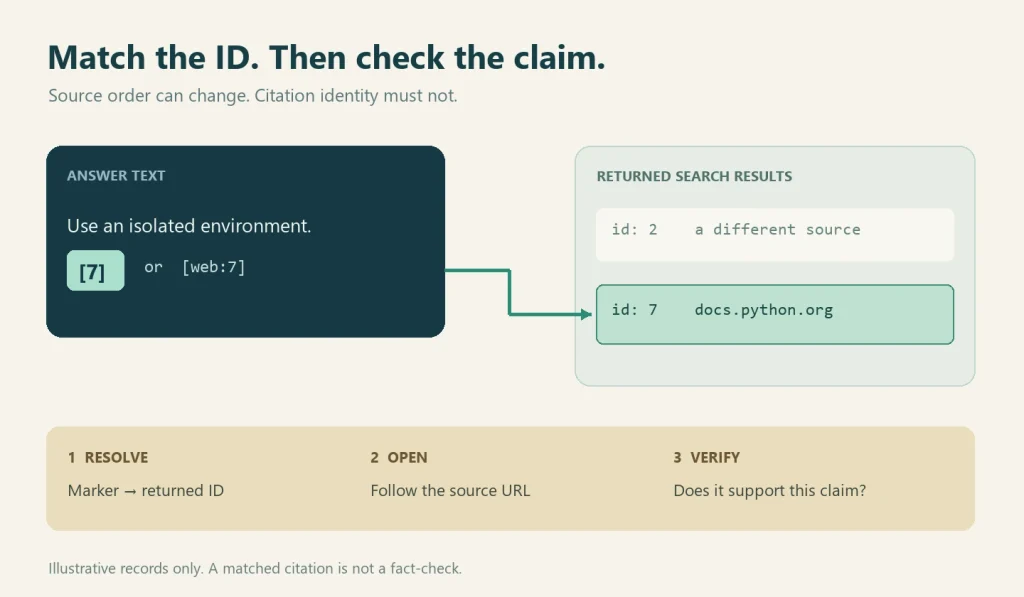
Le linee guida ufficiali sulla citazione distingue la prosa dai relativi atti processuali. Le fonti giungono in un output elemento di tipo risultati_della_ricerca. Leggi l'articolo risultati e abbinare ciascun indicatore di citazione al risultato corrispondente id. Un risultato ha un titolo e un URL; gestisci i valori mancanti prima di visualizzarlo.
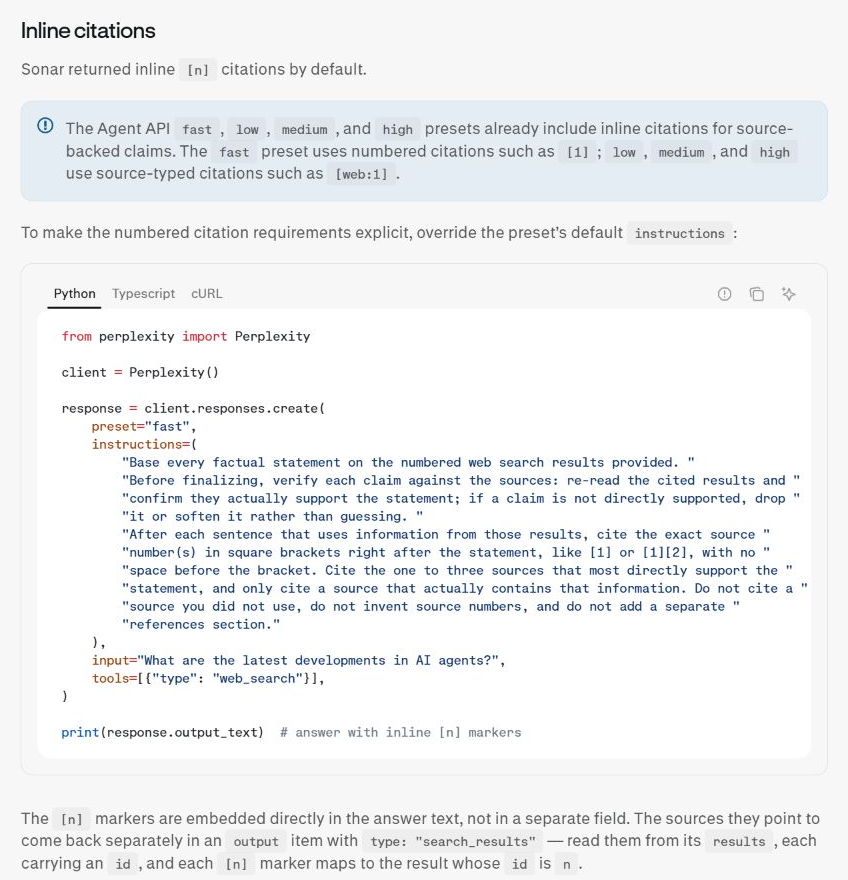
Quest'ultimo dettaglio è importante. Non dare per scontato che la “citazione 1” sia sempre il primo elemento di un array dopo che un altro strumento ha aggiunto un elemento. Crea una ricerca in base all’ID, quindi identifica gli indicatori che compaiono effettivamente nella risposta.
def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 se sid è None:
 continua
 key = str(sid)
 se key è in sources e field(sources[key], "url") != url:
                raise ValueError(f"URL in conflitto per l'ID sorgente {key}")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # Un ID sorgente, non la posizione 7 dell'array
Il codice completo riportato di seguito riconosce [1] e [web:1], i modelli di citazione documentati per le impostazioni predefinite più comuni. La funzione di supporto sopra riportata gestisce sia gli oggetti SDK che i dizionari e rifiuta gli URL in conflitto assegnati allo stesso ID. Non rinumera i risultati né ipotizza una fonte mancante.
Per un approfondimento sul tema della qualità delle citazioni, consulta il nostro Guida alla precisione delle citazioni Perplexity. Una citazione costituisce una traccia di controllo; la tua applicazione necessita comunque di una politica per le pagine non aggiornate, gli URL duplicati e le affermazioni non comprovate.
Ad esempio, se l'array restituito contiene l'ID 2 seguito dall'ID 7, il marcatore [7] deve rimandare all’ID 7. Se lo stesso URL compare sia sotto l’ID 7 che sotto l’ID 9, è possibile visualizzare quell’URL una sola volta, mantenendo entrambi gli ID. Se l’ID 8 non viene mai generato, mantenere [8] visibile e contrassegnarlo come non corrispondente.
Passaggio 4: Migliora la risposta con i filtri di ricerca
Una volta che la ricerca di base funziona, restringi il campo di ricerca quando la tua domanda ha un ambito di riferimento ben definito. Per quanto riguarda la creazione di pacchetti in Python, la documentazione del linguaggio e la guida alla creazione di pacchetti sono punti di partenza migliori rispetto a un tutorial qualsiasi.
response = client.responses.create(
    preset="fast",
    input=(
 "In che modo un piccolo progetto Python dovrebbe utilizzare gli ambienti virtuali "
 "e gestire le dipendenze? Cita le linee guida che utilizzi."
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
Il filtro va inserito nella configurazione dello strumento di ricerca sul web. La documentazione sulla migrazione descrive inoltre filtro_per_data_di_pubblicazione per domande in cui il fattore tempo è determinante. Ricorri al criterio della recency quando la domanda dipende da pubblicazioni o notizie recenti; una combinazione troppo ristretta di ambito e data potrebbe lasciarti con prove insufficienti.
Per una domanda relativa alle pubblicazioni dell'ultimo mese, aggiungi "search_recency_filter": "mese" accanto a filtro_dominio_ricerca. Non includerlo nell'esempio dell'ambiente virtuale: la documentazione stabile potrebbe riportare una data di pubblicazione precedente. Se si passa da un modello predefinito a uno selezionato direttamente, includere esplicitamente lo strumento di ricerca sul web.
Durante lo sviluppo, confronta i risultati filtrati con quelli non filtrati. Se la risposta cambia, registra il motivo: un filtro potrebbe eliminare contesti utili oppure pagine con scarsa autorevolezza che distraevano il modello. Si tratta di una scelta di qualità, non di una garanzia che ogni pagina rimanente sia corretta.
Se la tua applicazione richiede solo link ordinati per rilevanza e snippet, chiama la funzione API di ricerca ed eseguire la sintesi autonomamente. Tale separazione può facilitare la revisione e la memorizzazione nella cache. Per un confronto più ampio con Google, si veda In che modo Perplexity si differenzia da Google.
Passaggio 5: Salva una risposta completa con fonti cliccabili
Salva quanto segue con il nome perplexity_tutorial.py. È un sistema autonomo: include l’helper per le fonti, applica il filtro di dominio della documentazione Python, trasforma i marcatori di citazione corrispondenti in link, raggruppa gli URL duplicati senza perdere gli ID e salva la risposta completa dell’SDK insieme al Markdown.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
 "In che modo un piccolo progetto Python dovrebbe utilizzare gli ambienti virtuali "
 "e gestire le dipendenze?"
)
# Supporta i formati documentati [1] e [web:1] nelle risposte in prosa.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
 return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
 sources = {}
 for item in output or []:
 if field(item, "type") != "search_results":
 continue
 for result in field(item, "results", []) or []:
 sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
 raise ValueError(f"URL in conflitto per l'ID della fonte {key}")
 sources[key] = result
 return sources

def safe_url(value):
 if not isinstance(value, str):
 return None
 parsed = urlsplit(value)
 if parsed.scheme not in ("http", "https") or not parsed.netloc:
 return None
 # Proteggi una destinazione tra parentesi angolari in Markdown.
 return value.replace("", "").replace(" ", "")

def md_label(value):
 return re.sub(r"([\\\[\]])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(risposta, output, domanda=DOMANDA):
 fonti = source_index(output)
 citate = list(dict.fromkeys(CITATION_RE.findall(risposta)))
 missing = [
 sid for sid in cited
 if sid not in sources or not safe_url(field(sources[sid], "url"))
 ]
 def link(match):
 sid = match.group(1)
 url = safe_url(field(sources.get(sid, {}), "url"))
 return f"[{match.group(0)[1:-1]}]()" if url else match.group(0)

 # Conservare ogni ID quando lo stesso URL compare sotto ID diversi.
 grouped = defaultdict(list)
 titles = {}
 for sid in cited:
 source = sources.get(sid, {})
 url = safe_url(field(source, "url"))
 if url:
 grouped[url].append(sid)
 titles.setdefault(url, field(source, "title") or url)

 lines = ["# Risposta basata sulle fonti", "", question, "",
 CITATION_RE.sub(link, answer), "", "## Fonti citate", ""]
 for url, ids in grouped.items():
 lines.append(f"- ID {', '.join(ids)}: [{md_label(titles[url])}]()")
 if missing:
 lines.append("- ID delle fonti non corrispondenti o inutilizzabili: " + ", ".join(missing))
 if not cited:
 lines.append("- Nessuna citazione in linea riconosciuta; prove non verificate.")
 lines.extend(["", "I link alle fonti richiedono una revisione; la corrispondenza degli ID non conferma le affermazioni."])
 return "\n".join(lines) + "\n"

def main():
 from perplexity import Perplexity
 response = Perplexity().responses.create(
 preset="fast",
 input=QUESTION,
 tools=[{"type": "web_search", "filters": {
 "search_domain_filter": ["docs.python.org", "packaging.python.org"]
 }}],
 )
 answer = response.output_text or ""
 if not answer.strip():
 raise RuntimeError("Nessun testo di risposta restituito; controllare lo stato della risposta e gli errori.")
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 Path("perplexity-answer.md").write_text(
 export_markdown(answer, response.output), encoding="utf-8"
 )
 print("Salvati i file perplexity-answer.md e perplexity-response.json")

if __name__ == "__main__":
 main()
Esegui python perplexity_tutorial.py dalla directory del progetto. Scrive perplexity-answer.md e perplexity-response.json lì, sostituendo i file precedenti con quelli che hanno gli stessi nomi. Il file Markdown contiene la domanda, la risposta collegata, le fonti citate ed eventuali ID non corrispondenti. Il file JSON conserva l'output restituito e le informazioni sull'utilizzo a fini diagnostici.
Il parser è progettato per analizzare le forme con un singolo marcatore documentate nella prosa. Non si tratta di un parser Markdown completo: se la vostra applicazione richiede Markdown arbitrario, esempi di codice o citazioni come [1,2], aggiungere un renderer che riconosca la sintassi e dei test per quel formato. Non reinterpretare silenziosamente i marcatori sconosciuti.
Verifica se la pagina collegata conferma la risposta
In questo esempio, verifica se la documentazione citata spiega effettivamente l’isolamento dell’ambiente e l’installazione delle dipendenze. Un link alla homepage di Python è meno utile rispetto alla sezione pertinente della documentazione. Se una risposta consiglia un comando specifico, controlla il sistema operativo e la versione di Python prima di eseguirlo. Mark sostiene che il testo citato non giustifichi il contrassegno “irrisolto”.
Aggiungere un output in streaming o strutturato quando necessario
Streaming
Lo streaming migliora la latenza percepita in un'interfaccia di chat. La guida alla migrazione degli agenti descrive gli eventi delta di testo quali response.output_text.delta. Visualizza quei delta man mano che arrivano, ma raccogli anche gli elementi della risposta finale, in modo che l'interfaccia utente possa mostrare le fonti una volta completata la risposta. Un semplice flusso di testo non costituisce di per sé un elenco di fonti.
Quanto segue è solo una visualizzazione testuale. Conserva l'esportazione non in streaming per il tuo primo record sorgente completo; un'implementazione di streaming in produzione deve inoltre raccogliere gli eventi relativi agli strumenti e all'output e gestire le esecuzioni interrotte o non riuscite.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
Output strutturato
Utilizzare una risposta strutturata quando il codice a valle richiede campi quali risposta, nota_di_fiducia e domande_di_approfondimento. Mantieni gli ID di origine in un campo separato oppure conserva l'output originale di Agent, in modo che lo schema non nasconda le prove. Verifica lo schema sui tuoi casi di test prima di utilizzarlo in un flusso di lavoro.
Il riferimento alla migrazione mantiene formato_risposta con tipo: "json_schema" per un output strutturato. Definire i campi obbligatori e, ove opportuno, impedire l'uso di proprietà non previste. I controlli di validità dello schema riguardano la forma, non la verità: gli ID di origine devono comunque corrispondere ai record effettivamente restituiti, e un'etichetta di affidabilità generata dal modello non costituisce una misura di accuratezza.
Costi dell'API Perplexity ed errori comuni
Pagina ufficiale dei prezzi di Perplexity, verificato il 28 settembre 2026, separa i token del modello Agent dalle chiamate agli strumenti. Di seguito sono riportati i costi in USD relativi agli strumenti e alle ricerche. Il veloce Impostazioni predefinite dell'agente e search_type: "fast" Esistono diverse opzioni di configurazione; non dedurre la velocità di ricerca dal nome del preset.
| Azione fatturabile | USD per azione | USD per 1.000 |
|---|---|---|
| Ricerca web standard dell'agente | $0.0025 | $2.50 |
| Chiamata della funzione "Agent Fast Search" | $0.001 | $1.00 |
| Recupero dell'URL dell'agente | $0.0005 | $0.50 |
| Richiesta API di ricerca riuscita | $0.005 | $5.00 |
| API di ricerca con Fast Search | $0.001 | $1.00 |
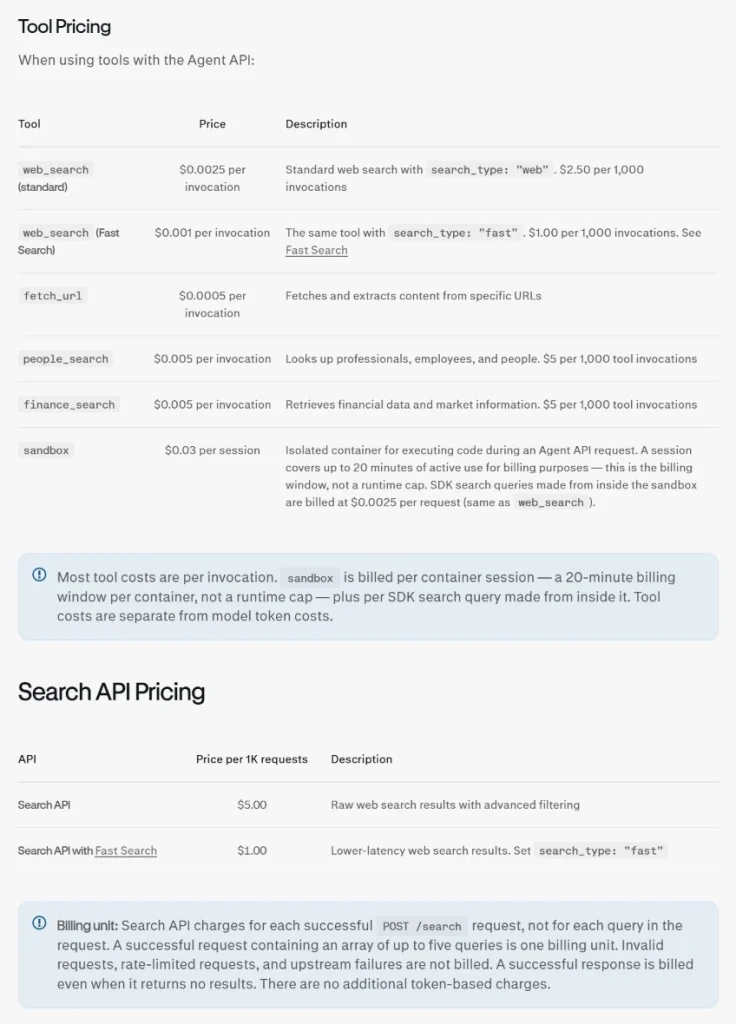
Esempio: Il costo di 1.000 richieste standard di ricerca sul web più 1.000 recuperi di URL $3.00 nelle spese per gli utensili ($2.50 + $0.50), al netto dei token del modello o di altri costi. Si tratta di un carico di lavoro ipotetico, non di un costo effettivo rilevato per il tutorial. Una singola richiesta dell’Agente può attivare più strumenti. Se disponibile, verificare utilizzo.costo.costo_totale sulla risposta completata.
| Sintomo | Cosa controllare per prima cosa |
|---|---|
| 401 o 403 | Nome della variabile d'ambiente, validità della chiave, accesso all'account e se la richiesta sta raggiungendo l'endpoint corrente. |
| Errore di fatturazione o di quota | Crediti API, configurazione dei pagamenti, costi relativi a modelli/strumenti e limiti dell'account. Un piano consumer Perplexity non comporta automaticamente l'assegnazione di crediti API. |
| 429 | Limiti di frequenza e comportamento dei tentativi di riprova. Utilizzare un backoff esponenziale limitato ed evitare di ripetere ciecamente una richiesta già evasa. |
| Timeout | Impostazioni relative al percorso di rete, alla dimensione del prompt, al numero di strumenti e al timeout del client. Registrare l'ID della richiesta se l'SDK ne fornisce uno, ma non registrare mai la chiave. |
| La risposta non ha fonti corrispondenti | Esaminare la materia prima risposta.output, sintassi delle citazioni e ID delle fonti; contrassegnare la risposta come non verificata invece di inventare link. |
L'API di ricerca fattura le richieste andate a buon fine, comprese quelle che non restituiscono risultati; il costo della richiesta non comporta alcun addebito aggiuntivo per i token. I costi degli agenti dipendono dai token dei modelli e dagli strumenti. È importante tenere separate queste unità di fatturazione quando si confronta un flusso di lavoro con risposta con un flusso di lavoro solo di ricerca.
Per un confronto tra i costi delle API, il nostro Guida ai costi dell'API Perplexity fornisce ulteriori informazioni, mentre la pagina ufficiale dei prezzi rimane il riferimento ufficiale per le tariffe attuali.
Passaggio da un vecchio tutorial su Sonar
Molti risultati di ricerca mostrano ancora la vecchia forma dei "Chat Completions". La guida alla migrazione per gli agenti utilizza una mappatura concettuale diretta. Se state confrontando le etichette del modello consumer con le impostazioni predefinite dell'API, la nostra guida esplicativa su cosa usa LLM Perplexity fornisce un contesto, ma non sostituisce la documentazione dell'API Agent.
| Modello Sonar precedente | Modello API dell'agente |
|---|---|
messaggi | input |
modello | preimpostazione |
choices[0].message.content | testo_di_uscita |
| Ipotesi precedenti relative alle matrici di citazioni | risultati_della_ricerca elemento di output e corrispondenza basata sull'ID |
| Parametri di ricerca nella richiesta | tools=[{"type":"web_search","filters":{...}}] |
Leggi la diretta Panoramica sulla migrazione e dettagli sulla migrazione prima di modificare il codice di produzione. Le mappature predefinite rappresentano un punto di partenza, non una garanzia che i modelli vecchi e nuovi producano risultati identici in termini di qualità, latenza o costo.
Domande frequenti
L'API Perplexity è gratuita?
Le API prevedono un modello di pagamento "pay-as-you-go", come indicato nella documentazione attuale relativa alla guida rapida e ai prezzi. Non dare per scontato che un abbonamento consumer, una versione di prova o un credito promozionale rendano gratuite tutte le richieste API.
Devo avere Perplexity Pro per poter utilizzare l'API?
L'accesso all'API e il piano Pro per gli utenti finali sono prodotti distinti. Crea le credenziali API e verifica la fatturazione relativa all'API per l'account sviluppatore che intendi utilizzare.
È meglio usare l'API Agent o l'API Search?
Scegli "Agente" quando desideri una risposta completa e ben fondata, corredata di fonti. Scegli "Ricerca" quando la tua applicazione deve gestire autonomamente il ranking, il filtraggio e la sintesi. Puoi combinare la "Ricerca" con il tuo modello personalizzato se hai bisogno di un controllo rigoroso su ogni fase del processo di generazione.
Posso chiamare Perplexity da JavaScript?
Sì. Utilizza l'esempio Node.js lato server riportato sopra oppure l'SDK ufficiale JavaScript. Conserva la chiave sul server. Quando leggi il JSON grezzo, esamina gli elementi di output tipizzati e applica le stesse regole di mappatura degli ID di origine.
È garantita la correttezza delle citazioni Perplexity?
No. Una citazione indica a quale risultato restituito si riferisce la risposta. La tua applicazione o il revisore devono comunque verificare l'attualità, l'autorevolezza e se la pagina supporti effettivamente l'affermazione in questione.
Perché il mio parser non ha trovato alcuna fonte?
Esamina i tipi di elementi dell'output grezzo, verifica che la ricerca sul web sia stata eseguita e controlla se l'espressione regolare corrisponde al formato di citazione predefinito. Se non compare alcun indicatore, salva la risposta come "non verificata" e approfondisci la richiesta, invece di aggiungere un link ipotetico.
Il codice GlobalGPT può sostituire una chiave API Perplexity?
GlobalGPT è uno spazio di lavoro AI "tutto in uno" pensato per l'uso quotidiano dell'intelligenza artificiale. L'abbonamento e l'accesso ai modelli sono separati dall'account sviluppatore Perplexity, dalla chiave API e dai crediti API; questo tutorial su Python utilizza l'account sviluppatore.
Una pratica lista di controllo per il lancio
- Crea una chiave lato server e conferma la fatturazione dell'API.
- Esegui la versione minima
velocerichiesta prima di aggiungere filtri o avviare lo streaming. - Salva la risposta completa, non solo il testo visibile della risposta.
- Abbinare i marcatori di citazione agli ID delle fonti restituiti e contrassegnare i marcatori non abbinati.
- Controlla le pagine citate per verificare la fondatezza delle affermazioni, l'attualità dei contenuti e la presenza di URL duplicati.
- Prima di procedere con l'implementazione, ricontrolla la documentazione relativa all'Agent live, ai prezzi e alla migrazione.
Ora disponi dello schema di base per un'integrazione affidabile dell'API Perplexity: poni una domanda mirata, lascia che l'API dell'agente effettui la ricerca, mantieni la risposta e le prove insieme e rendi ogni citazione verificabile. Da qui, aggiungi la memorizzazione nella cache, i tentativi di ripetizione e le tue regole di revisione relative allo stesso flusso di lavoro basato sull'ID della fonte.