

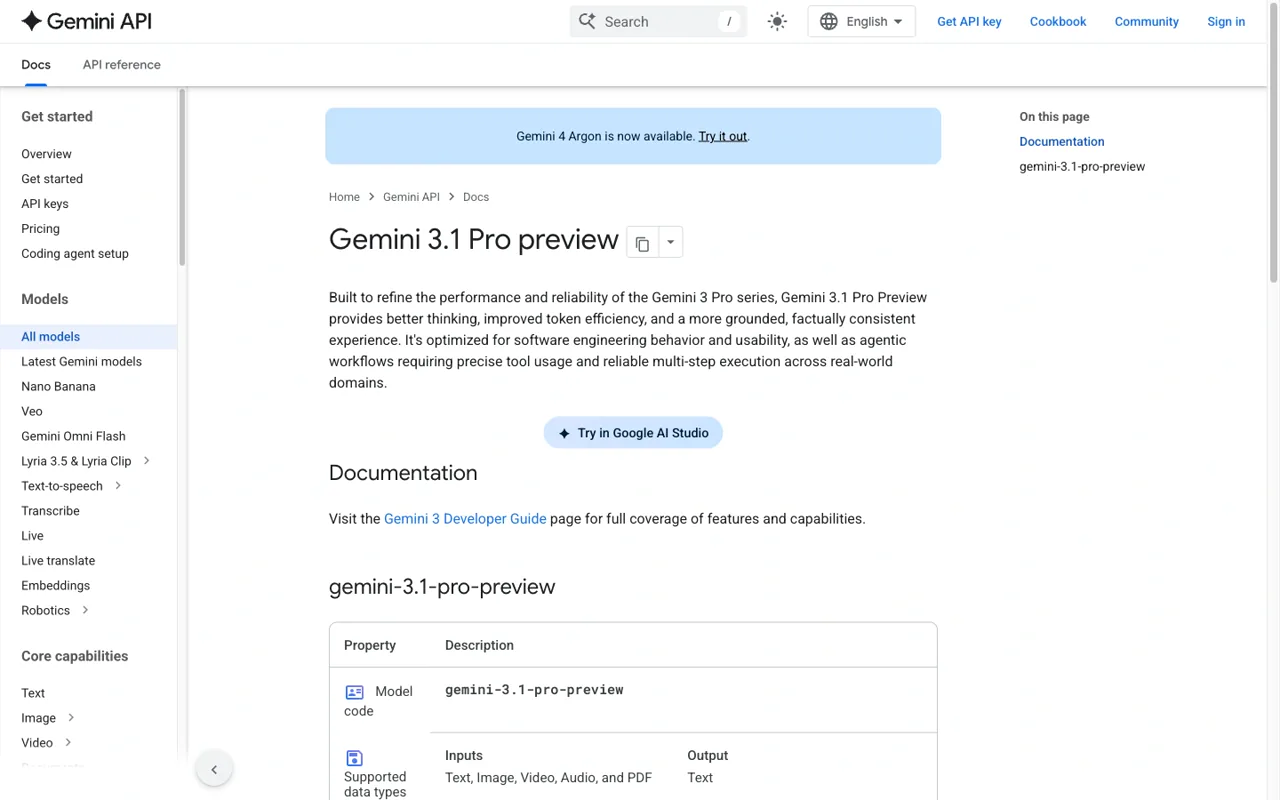
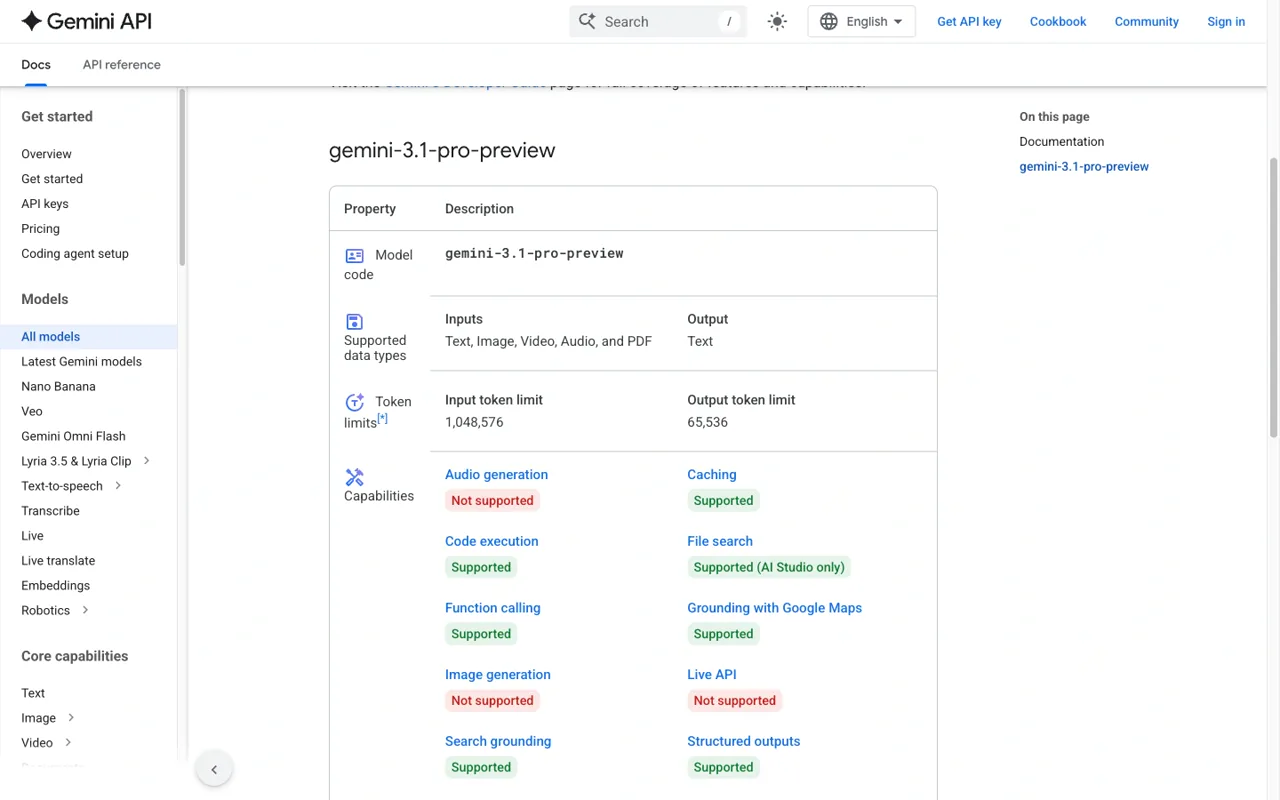
Angka yang paling jelas saat ini adalah batas konteks model: Gemini 3.1 Pro Preview dapat menerima hingga 1.048.576 token masukan dan menghasilkan hingga 65.536 token keluaran. Hal itu tidak sama dengan akun API tanpa batas. Proyek Anda tetap dapat terkena batasan laju, kuota, pembatasan tingkatan penagihan, atau batas penggunaan Google Gemini Apps.
Panduan ini memisahkan lapisan-lapisan tersebut dan menggantikan pendekatan “bypass” yang lama dengan solusi praktis: mengidentifikasi batasannya, memperpendek atau menggabungkan permintaan, mencoba kembali dengan strategi backoff jika terjadi masalah pada lapisan transportasi, serta memilih rute yang tepat untuk tugas tersebut.
Jika Anda perlu melanjutkan alur kerja pemrograman atau penelitian yang panjang sementara salah satu jalur sedang dibatasi, GlobalGPT Menyatukan Gemini 3.1 Pro bersama model-model lain dan fungsi-fungsi AI dalam satu ruang kerja. API, CLI, MCP, dan rute agen Yukie-nya berguna ketika suatu tugas memerlukan serah terima yang dapat diulang; hal-hal tersebut tidak memengaruhi kuota Google sendiri.
Apa saja batasan Gemini 3.1 Pro?
| Lapisan batas | Bukti terkini | Apa yang dikendalikannya |
|---|---|---|
| Konteks masukan model | 1.048.576 token | Berapa banyak teks, media, dan konteks percakapan yang dapat dimuat dalam satu permintaan. |
| Hasil model | 65.536 token | Berapa banyak teks, termasuk token pemikiran jika ada, yang dapat dikembalikan oleh satu respons. |
| Batas harga API | 200.000 token masukan | Tarif input/output mana yang berlaku pada paket berbayar standar?. |
| Kuota proyek | Tergantung pada sistem penagihan dan kuota Google Cloud / AI Studio | Berapa banyak permintaan atau token yang dapat dikirimkan oleh proyek tersebut dalam suatu periode. |
| Penggunaan Aplikasi Gemini | Berbasis komputasi; diperbarui setiap 5 jam hingga batas mingguan tercapai | Akses aplikasi konsumen, fitur, dan penggunaan sesuai paket. |
Tidak ada satu pun sakelar “Gemini 3.1 Pro limit”. Sebuah permintaan bisa saja muat di dalam jendela konteks namun tetap menerima kode kesalahan 429 karena proyek tersebut mengirimkan terlalu banyak permintaan, kuota akun telah habis, atau layanan sedang sibuk untuk sementara waktu.
Batas token dan konteks
Halaman contoh Google mengidentifikasi titik akhir tersebut sebagai gemini-3.1-pro-preview. Fitur ini menerima masukan berupa teks, gambar, video, audio, dan PDF, serta menghasilkan keluaran berupa teks. Halaman tersebut mencantumkan dukungan untuk pemrosesan logika, penyimpanan dalam cache, eksekusi kode, pemanggilan fungsi, integrasi dengan Pencarian Google dan Google Maps, konteks URL, keluaran terstruktur, Batch API, Flex, serta opsi Prioritas.


Batas laju API dan tingkatan kuota
Batas API ditetapkan pada tingkat proyek dan penagihan, bukan hanya berdasarkan nama model. Periksa halaman kuota proyek untuk mengetahui jumlah permintaan per menit, token per menit, batas harian, dan tingkatan penagihan yang berlaku. Google dapat mengubah nilai-nilai yang tersedia berdasarkan wilayah, akun, dan tingkatan layanan, sehingga angka yang tercantum dalam postingan blog lama tidak dapat dijadikan acuan kuota terkini yang akurat.
- RPM: permintaan per menit. Banyak panggilan kecil dapat mencapai batas ini sebelum kapasitas token habis.
- TPM: token per menit. Beberapa permintaan dengan konteks yang besar dapat menghabiskannya dengan cepat.
- Kuota harian atau bulanan: kuota dengan periode yang lebih panjang yang dapat tetap habis meskipun telah dilakukan upaya ulang singkat.
- Status penagihan: Sebuah proyek mungkin perlu mengaktifkan fitur penagihan agar dapat memperoleh batas yang lebih tinggi atau akses ke lingkungan produksi.
- Penggunaan alat: Pencarian grounding, pemetaan grounding, panggilan fungsi, dan alat-alat lainnya dapat menambah beban kerja dan biaya.
Batas harga 200 ribu merupakan batas penagihan, bukan batas konteks yang mutlak. Permintaan sebesar 250 ribu token dapat masuk ke dalam jendela konteks 1 juta, namun akan dikenakan tarif standar yang lebih tinggi.
Cara memperbaiki kesalahan Gemini 3.1 Pro 429

- Baca rincian tanggapannya. Catat ID model, proyek, kode status, nilai "retry-after", dan nama kuota jika API mengembalikannya.
- Hentikan semburan itu. Jangan mengirimkan permintaan yang sama dalam loop yang berulang-ulang; hal itu dapat memperpanjang jangka waktu pembatasan.
- Coba lagi dengan penundaan eksponensial. Gunakan jumlah percobaan ulang yang terbatas dan patuhi nilai Retry-After jika ada.
- Kurangi jumlah permintaan. Persingkat riwayatnya, hapus file yang berulang, kurangi anggaran produksi, atau bagi pekerjaan menjadi beberapa tahap.
- Periksa kuota proyek dan tagihan. Upaya ulang tidak dapat memulihkan kuota yang sudah habis.
- Lakukan tugas tersebut dengan penuh kesadaran. Untuk pekerjaan interaktif yang sangat bergantung pada tenggat waktu, lanjutkan brief tersebut di model atau ruang kerja lain, daripada berpura-pura bahwa batasan penyedia telah hilang.
Langkah-langkah ini mengatasi masalah transportasi dan beban kerja. Langkah-langkah ini tidak mengabaikan kontrol yang diterapkan oleh penyedia layanan, dan tidak boleh digunakan untuk menghindari batasan keamanan atau batasan akun.
Cara mengirim pekerjaan dengan konteks yang panjang tanpa memboroskan anggaran
Konteks yang panjang paling efektif jika permintaan tersebut memiliki tujuan yang jelas. Letakkan materi referensi bersama dalam prefiks yang stabil, minta indeks atau ekstraksi terlebih dahulu, lalu kirimkan hanya bagian-bagian yang relevan ke tahap berikutnya.
- Mulailah dengan membuat garis besar atau merangkum fakta-fakta utama, alih-alih langsung meminta naskah tersebut ditulis ulang sepenuhnya.
- Pastikan deskripsi proyek tetap konsisten dan sampaikan ringkasan status yang ringkas di antara setiap langkah.
- Gunakan caching jika awalan yang sama dan panjang dikirim berulang kali dan data penagihan penyedia layanan mengonfirmasi adanya cache hit.
- Gunakan Batch atau Flex jika pekerjaan bersifat asinkron dan lapisan layanan Anda mendukungnya.
- Pastikan batas keluaran cukup tinggi untuk pekerjaan tersebut, namun cukup rendah untuk mencegah respons yang sangat besar secara tidak sengaja.

Ketika rute API, CLI, MCP, atau ruang kerja sesuai
Gunakan API jika aplikasi Anda memerlukan panggilan yang dapat diprogram, log, dan tagihan penyedia layanan. Gunakan CLI jika model perlu dijalankan di samping terminal atau repositori. Gunakan MCP jika tugas tersebut memerlukan alat yang telah disetujui, seperti pencarian berkas, akses kode, atau layanan internal. Gunakan agen Yukie jika pekerjaan mencakup perencanaan, panggilan alat, dan serah terima tugas.

GlobalGPT hal ini paling berguna di sini sebagai lapisan kesinambungan: bandingkan sebuah tanggapan, lanjutkan penyusunan draf, serahkan brief tersebut ke tim pengembang kode atau tim kreatif, dan pisahkan keputusan terkait biaya dari kuota API Google. Untuk perhitungan harga saat ini, lihat Panduan Harga Gemini 3.1 Pro.
PERTANYAAN YANG SERING DIAJUKAN
Berapa nilai input maksimum Gemini 3.1 Pro?
Halaman model Google saat ini mencantumkan 1.048.576 token masukan untuk gemini-3.1-pro-preview.
Berapa daya keluaran maksimumnya?
Halaman yang sama mencantumkan 65.536 token keluaran. Token keluaran dan token pemikiran harus dimasukkan dalam pembahasan perencanaan dan penagihan.
Apakah jendela konteks 1M berarti penggunaan tanpa batas?
Tidak. Hal ini menggambarkan ukuran konteks satu permintaan. Kuota proyek, batasan laju, penagihan, dan aturan penggunaan aplikasi tetap berlaku.
Bagaimana cara mengatasi kesalahan 429 Too Many Requests?
Baca rincian respons, patuhi nilai Retry-After, lakukan penundaan, kurangi ukuran atau frekuensi permintaan, serta periksa kuota proyek dan tagihan. Siklus percobaan ulang bukanlah peningkatan kuota.
Apakah GlobalGPT dapat menghapus batasan pada Gemini 3.1 Pro?
Hal ini tidak dapat mengubah batasan yang ditetapkan Google. Namun, hal ini dapat menawarkan model dan alur kerja alternatif ketika pekerjaan harus dilanjutkan.
Diagnosis lapisan tersebut terlebih dahulu: Kapasitas konteks, anggaran keluaran, kuota proyek, penggunaan aplikasi, dan pembatasan sementara memerlukan solusi yang berbeda-beda.





