Muse Spark 1.3 是 Meta 迄今为止性能最强的 Muse Spark 版本:其公开的 xhigh 模型在人工智能分析指数(Artificial Analysis Intelligence Index)中达到 61 分,保持着 100 万令牌的上下文窗口,并在我们的首次响应 API 测试中通过了全部三项中等难度的编码任务。. 需要特别注意的是,Meta的标题基准图表使用了“max reasoning”功能,而截至本评测撰写之时,“max reasoning”功能仍在等待经过进一步安全测试后进行更广泛的发布。.

Muse Spark 1.3 评测:简评
我们的结论
对于编程代理、长上下文处理以及对成本敏感的自动化任务而言,Muse Spark 1.3 值得一试。其公开的 xhigh 结果已具备前沿竞争力,但请不要将 Meta 的最高得分视为当前每位 API 用户都能复现的结果。.
Meta 于 2026 年 9 月 2 日发布了 Muse Spark 1.3, ,使其能够适应长期代理工作流、生成更简洁的代码输出,并实现更可靠的协作。这延续了向 基于工具使用模型构建的AI代理. Meta 表示,当需求不明确时,系统会提出澄清问题;遇到困难时会发出提示;在执行重要操作前会进行确认。在与 1.2 版本的内部对比中,Meta 工程师观察到工具调用次数减少了约 20% 次,令牌使用量减少了 25%。这些是提供商声称的数据,并非我们测试的结果。.
与 Muse Spark 1.2 相比有哪些变化?
人工分析:xhigh上的57至61。.
Meta在DeepSWE上的报告数据为75.4与55.0,但将1.3 max与1.2 xhigh进行了比较。.
1M窗口依然存在;在Meta的图表中,高频段MRCR分数大幅上升。.
代币率保持不变,而AA的指标为每项评估任务$0.55,相比之下,此前为$0.40。.
Muse Spark 1.3 基准测试:Max 和 Xhigh 并不相同
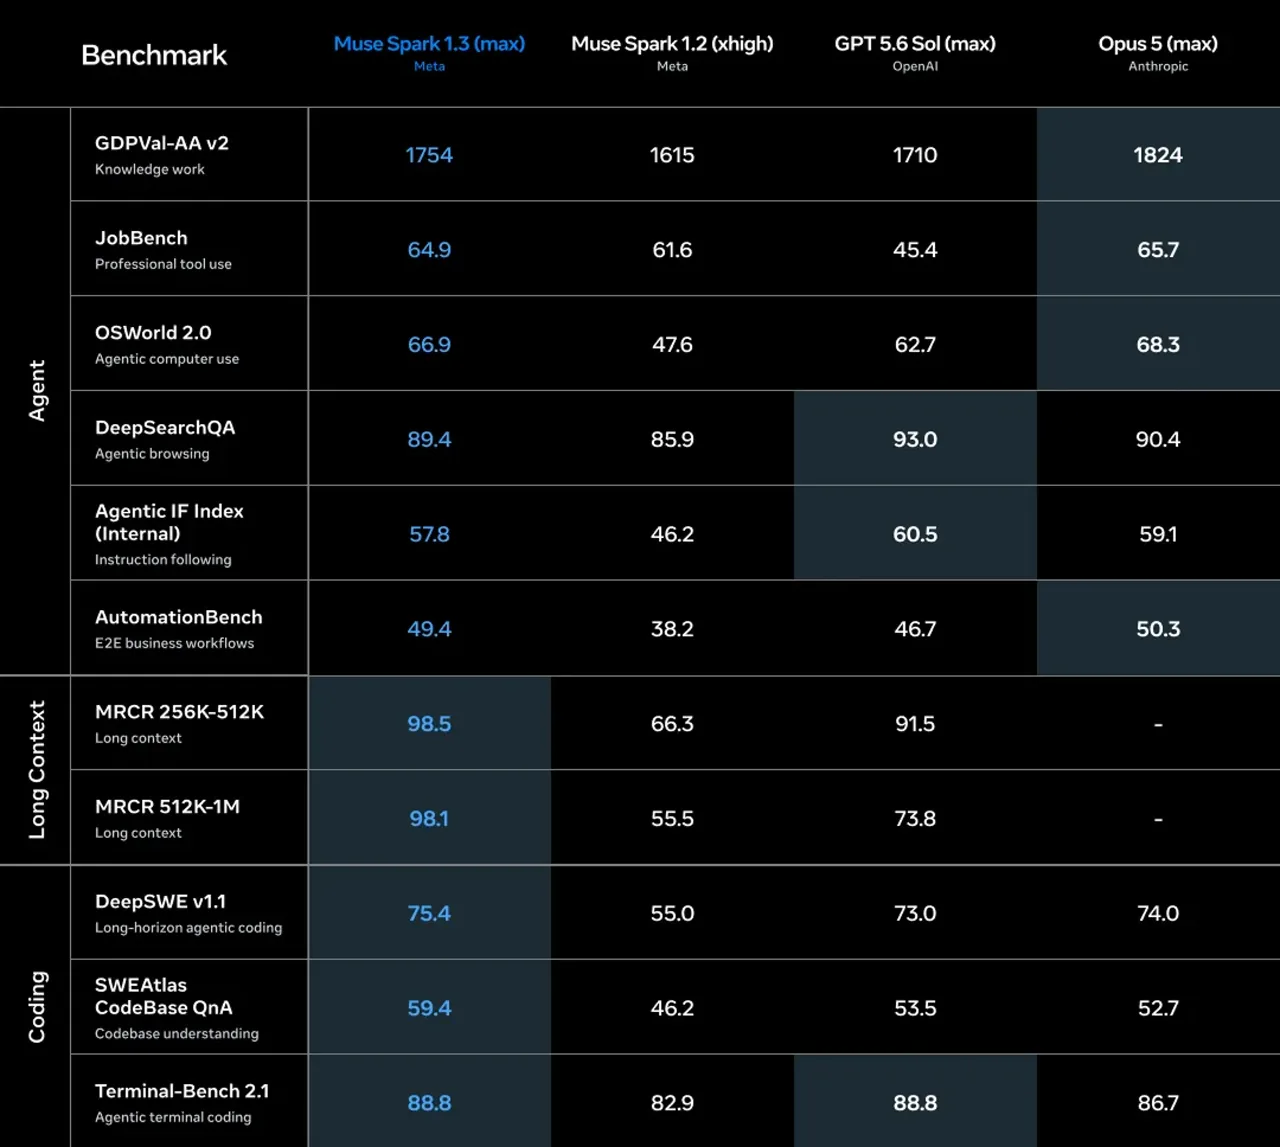
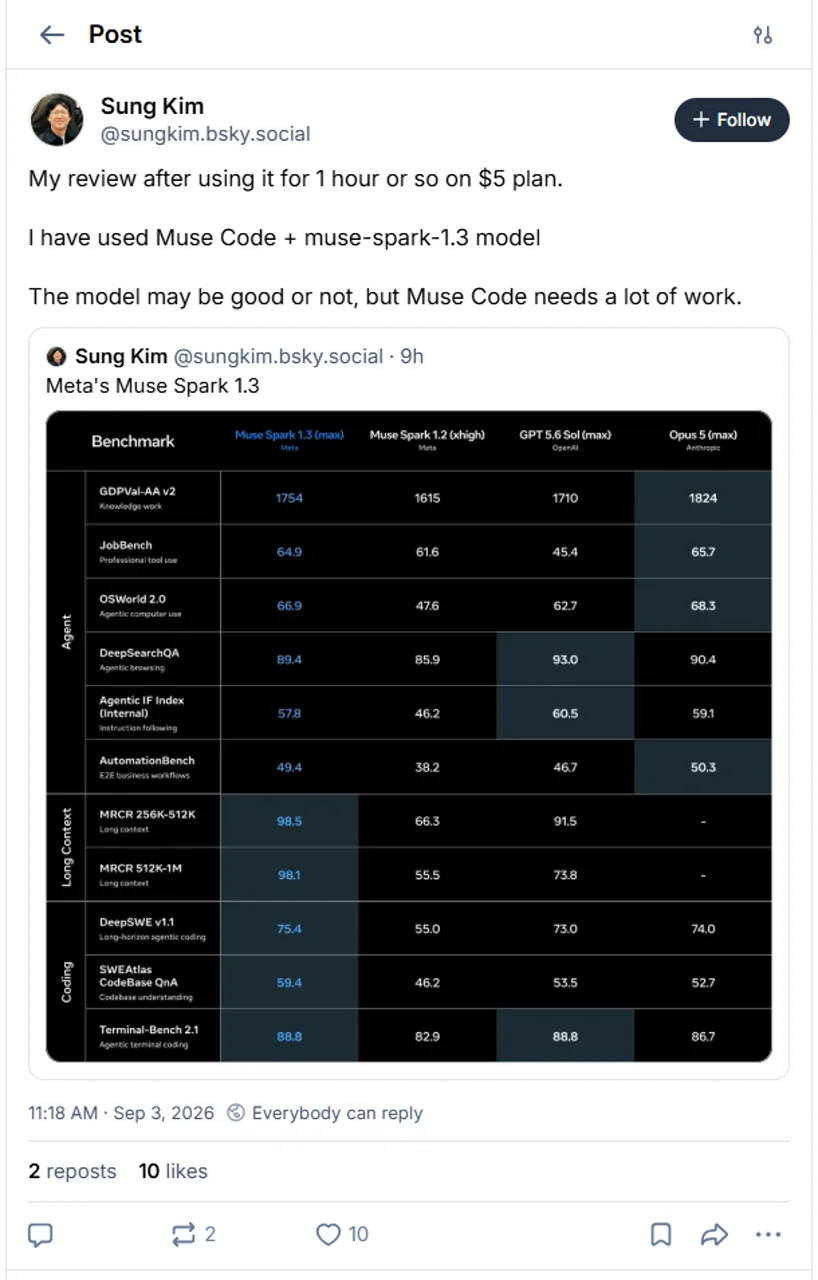
Meta的官方图表 表现令人印象深刻。Muse Spark 1.3 在 Terminal-Bench 2.1 上的最高得分为 88.8,在 DeepSWE v1.1 上为 75.4,在 MRCR 512K-1M 上为 98.1,在 OSWorld 2.0 上为 66.9。 它在 Terminal-Bench 测试中与 GPT-5.6 Sol 并列最高分,并在两个长上下文 MRCR 测试中领先于所列竞争对手。开发者若需对比更广泛的市场情况,可参考我们的 coding-agent 概述 作为补充背景信息。.
元报告,最大推理
| 基准 | 1.3 最大值 | 1.2 ×高 | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| 终端平台 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | 不适用 |
不同的努力设置、代理框架和OSWorld版本限制了直接可比性。Meta还将“Agentic IF指数”描述为一个内部综合指标。.
如何阅读图表
1.3、GPT-5.6 Sol 和 Opus 5 使用 max;1.2 使用 xhigh。.
命名代理和固定连接器在不同评估中有所不同。.
1.3 和 1.2 版本运行时使用的环境版本不同。.
Agentic IF 指数是 Meta 编制的综合指数,并非单一的公开基准指数。.
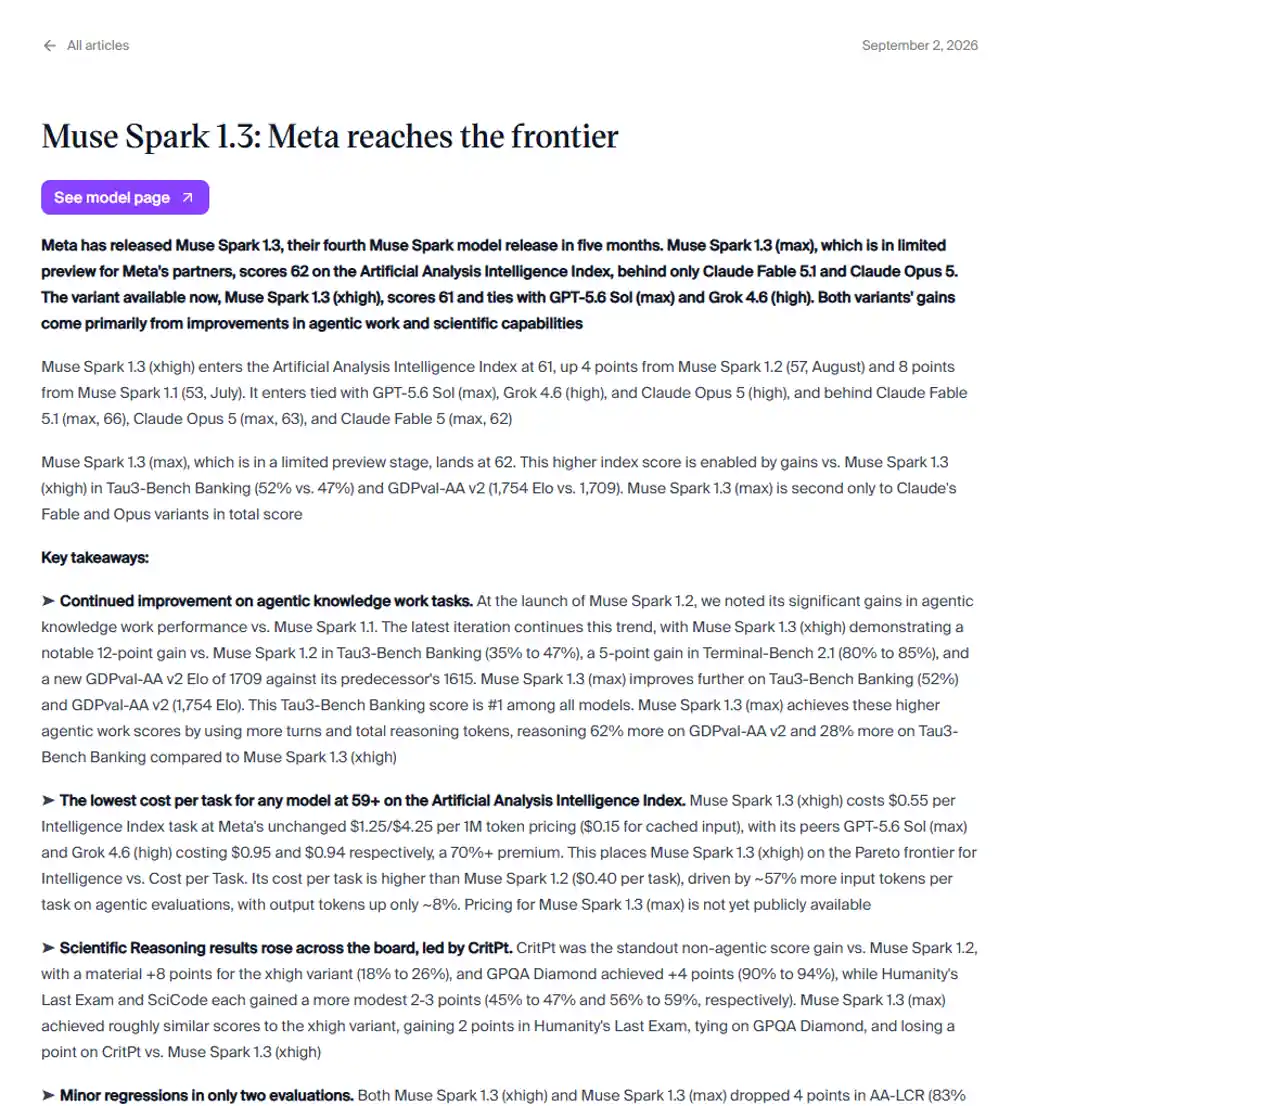
“人工分析”提供了更清晰的视角 用户目前可以访问的内容。 Muse Spark 1.3 xhigh 得分达到 61,高于 1.2 版本的 57。其 Terminal-Bench 测试结果为 85%,GDPval-AA v2 为 1709 Elo,Tau3-Bench Banking 为 47%。 限时预览版中的最高配置版本总分达到62。但也存在性能倒退:AA-LCR从83%降至79%,而AA-Omniscience Accuracy在xhigh模式下的得分从45%降至42%。.
Muse Spark 1.3 定价
撰稿人
muse-spark-1.3-contributor
$0.10 输入 / $0.002 缓存 / $0.20 输出 每百万代币。.
提示词可用于改进 Meta 的产品。.
标准
muse-spark-1.3
$1.25 输入 / $0.15 缓存 / $4.25 输出 每百万代币。.
Meta表示,该层级并非用于改进其产品。.
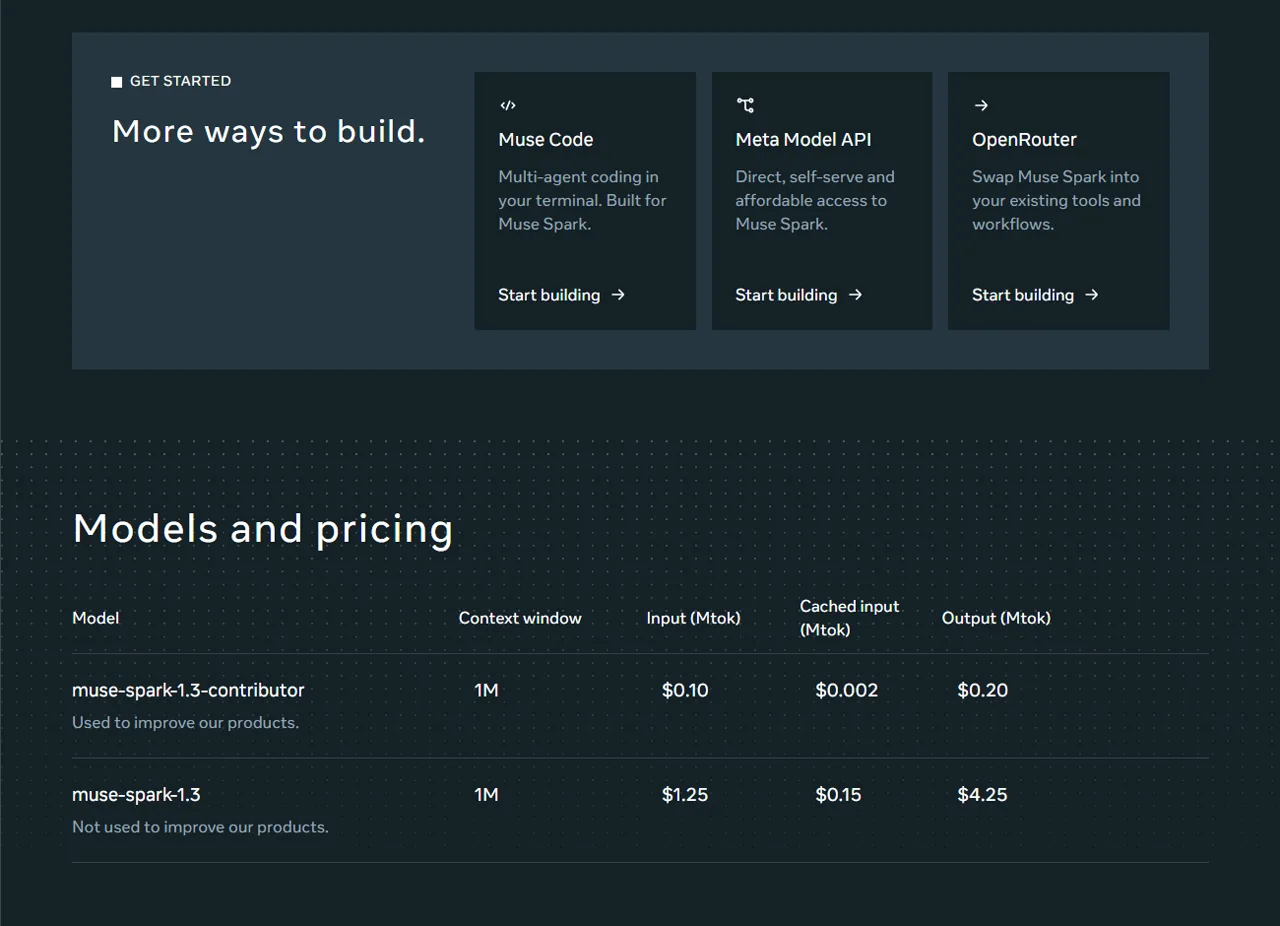
"(《世界人权宣言》) 官方代币价格 与 1.2 版本相比没有变化,但每项任务的成本却有所不同。我们的 一体化AI平台评测 解释了为何应分别评估访问成本和工作流成本。人工分析测得,每个“智能指数”任务的消耗为$0.55(1.3倍于基准值),而1.2倍于基准值的消耗为$0.40,这主要归因于代理评估中约57%的额外输入令牌。 贡献者层级的价格极其低廉,但其数据使用条款是产品选择中的关键考量,而非可忽略不计的细则。.
Muse Spark 1.3 API 访问
Meta的 官方食谱 现在使用 muse-spark-1.3 作为默认设置,并记录了 1,048,576 个令牌的上下文窗口。该 API 与 OpenAI SDK 兼容。Muse Code 和 Meta Model API 已被确认是当前可用的访问途径。 Meta 的模型页面还显示了 OpenRouter,尽管点击其按钮时仍指向 1.2 版本的 URL,因此部署前请核实访问路径。有关代理互操作性的背景信息,请参阅我们的指南: MCP 和 AI 工具.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "请审查此补丁是否存在回归问题。"}],
)

print(response.choices[0].message.content)
实操编程测试:3/3 通过
我们在温度为零的条件下,通过 API 对三个中等难度的仓库任务进行了测试,每个任务仅生成一个响应。每个响应都必须以结构化 JSON 格式返回完整的文件。随后,我们将这些文件放入可丢弃目录中,并执行了公开和隐藏检查。这些只是小型受控测试,不能替代 Terminal-Bench 或生产环境仓库的测试。.
5/5 个测试;18.4 秒;2,473 个标记;$0.00905。该模型发现了未使用的已处理 ID 集合,添加了一个早期重复检查机制,并编写了一个回归测试。.
通过了类型检查和两项运行时检查;耗时 47.6 秒;4,945 个令牌;$0.01661。在不破坏事务边界的情况下,将验证、持久化和审计日志记录进行了分离。.
9/9 项测试;20.3 秒;3,789 个标记;$0.01446。CSV 兼容性、行号错误、原子输出、干跑安全性、帮助和文档均通过。.
共计 11,207 个代币和 $0.04013。时间指端到端请求时间,而非 Meta 原生 API 的延迟或 TTFT。.
结果比单纯的“3/3”所显示的要好:这三个首轮响应均可复现,且考虑到了约束条件。在阅读我们的论文时,同样的证据标准同样重要: GPT-5 评测. 不过,该示例并未测试工具调用的重复可靠性、大型代码库的导航功能,以及 Muse Code 的协调层。正在评估经济型替代方案的读者或许还会发现我们的 预算编码模型比较 有用的。.
开发者们的初步反响
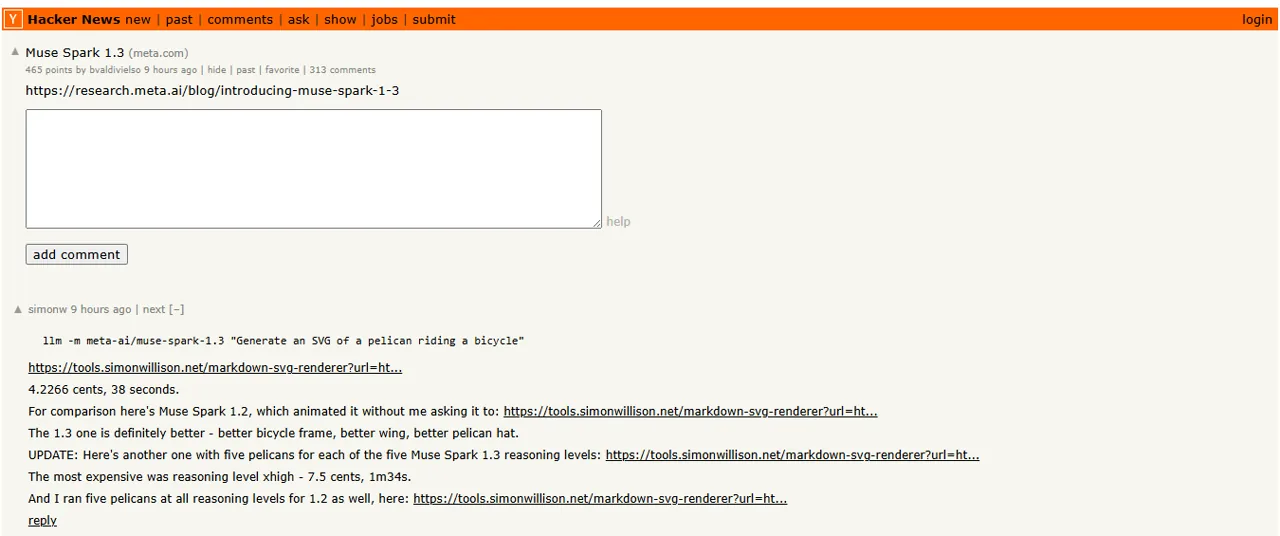
初步反响褒贬不一,且数量太少,尚无法形成共识。在一篇 Hacker News 测试, 西蒙·威利森报告了一次耗时38秒、耗费4.2266分的SVG测试,并认为1.3版本的测试结果“绝对比”他之前1.2版本的对比结果更好。. 达克斯对此次发布进行了说明 以此提醒自己,他有多么想念那些身材火辣的模特。. 金成, ……在体验了大约一小时的Muse Code后,他表示该模型或许不错,但Muse Code的产品“还有很多改进空间”。最后这条评论针对的是代理体验,而非纯粹的模型测试。.
利与弊
哪些方法奏效了
- 公众评分很高
- 1M-token上下文窗口
- 兼容 OpenAI 的 API
- 三项编程任务均通过了首次响应
- 贡献者级别的代币奖励率极低
看什么
- “标题最大显示结果”并非默认的公开体验
- 独立任务成本较1.2有所上升
- 两个独立指标的回归分析
- 贡献者数据可能有助于改进Meta的产品
- 针对“Early Muse Code”的初期反馈褒贬不一
哪些人适合使用 Muse Spark 1.3?
用途:
编码代理评估、大规模语境库工作、工具驱动的自动化,以及在数据政策可接受的情况下进行的成本敏感型实验。.
何时跳过或等待
您需要经过验证的长期生产可靠性,需要立即获得最大容量,或者无法接受“贡献者”级别的数据使用方式,且认为标准定价缺乏竞争力。.
Muse Spark 1.3 评测结论
Muse Spark 1.3 值得推荐进行评估。. 它集成了前沿水平的公共高性能计算能力、出色的长上下文处理效果、直观易用的 API 设计以及极具竞争力的定价。我们设计的三个应急编程任务进一步证明,它能够遵循多文件约束条件,并生成可测试的补丁。.
对于敏感代码,请选择标准级别。有关另一项前沿比较,请参阅 GPT-5 与 Claude 4 对比. 在该推理级别得到广泛应用之前,应将最高基准测试结果视为预览性证据。同时,应将 Muse Code 与模型 API 分开评估:代理的用户体验、工具循环和存储库控制,其成败与基础模型无关。.
Muse Spark 1.3 常见问题解答
什么是 Muse Spark 1.3?
Muse Spark 1.3 是 Meta 于 2026 年 9 月 2 日发布的编程与代理工作流模型,具备 100 万令牌的上下文窗口,并支持原生图像、视频和文档感知。.
Muse Spark 1.3 的价格是多少?
标准模型的费用为:每百万个输入代币 $1.25,缓存输入 $0.15,输出 $4.25。 贡献者模型的费用分别为 $0.10、$0.002 和 $0.20,但其数据可能会被用于改进 Meta 的产品。.
是否支持 Max Reasoning?
Meta表示,现有推理模式将在上线时提供,而“max”模式将在经过进一步的安全测试后推出。在认为该功能已全面上线之前,请先查阅最新的API文档。.
Muse Spark 1.3 通过了编码测试吗?
是的。其首次响应通过了我们针对 Python 漏洞修复、TypeScript 重构以及 JSONL 功能测试的所有可执行性检查。该示例仅包含三个受控任务,并不代表一般的可靠性率。.
Muse Spark 1.3 比 1.2 更好吗?
总体而言,根据现有证据来看。公开的xhigh智能得分从57升至61,Meta报告称在代理能力和长上下文处理方面取得了显著进步,但Artificial Analysis还发现任务成本有所增加,且在长上下文检索和事实校准方面出现了轻微退步。.
我应该使用“贡献者”模式还是“标准”模式?
对于敏感或专有提示词,请使用标准选项,因为Meta表示这些数据不会用于改进其产品。Contributor选项虽然价格低廉得多,但其提示词可能会被用于产品改进。.