Claude Opus 5.5 评测:价格、基准测试及实际 API 测试
Claude Opus 5.5 将 100 万令牌的上下文窗口与每百万令牌 $4 / $20 的 API 价格相结合。 本评测将 Anthropic 的公开声明、独立基准测试快照以及通过 Messages API 途径进行的五项直接任务运行结果进行了区分。.
测量结果是具体的。. 有三项任务返回了清晰、可用的答案;编程任务虽然给出了有用的答案,但触及了1,024个令牌的上限;中文写作任务在测试路径上生成了乱码文本。该示例展示了具体的运行表现和路径限制,而非普遍的成功率。.
简答
- 性能: Anthropic在大部分任务中表现达到Fable 5.1水平,而“人工分析”在全力以赴的情况下记录的智力指数得分为58。METR在判断能力方面的证据范围较窄,其表现相较于Fable 5.1并未出现显著提升。.
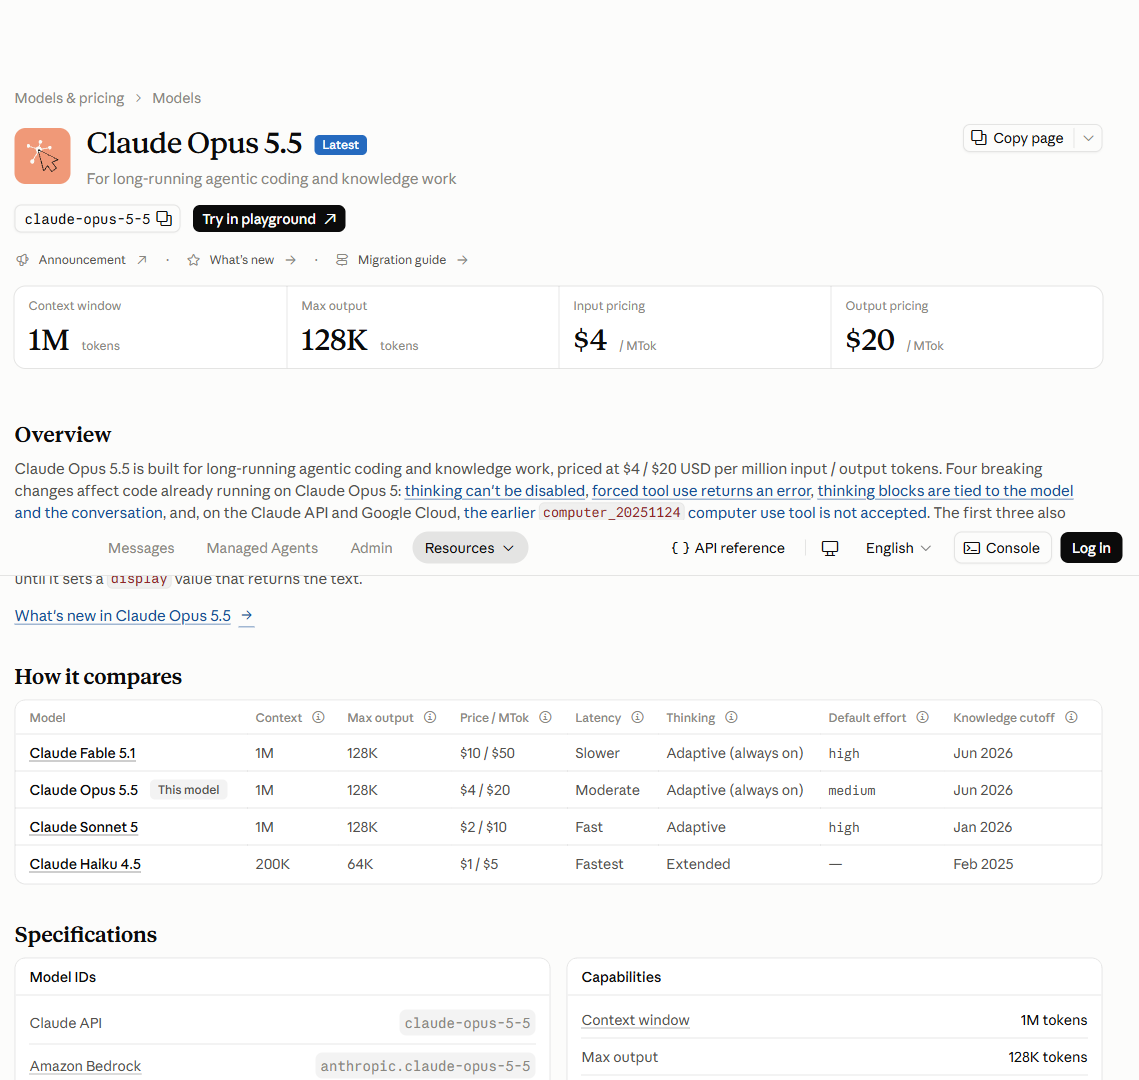
- 价格 官方API汇率是 每百万输入代币为 $4,每百万输出代币为 $20. 每百万次缓存读取消耗 $0.20;每百万次 5 分钟缓存写入消耗 $5。.
- 实际操作结果: 在记录的运行中,长文本提取、严格JSON和算术推理均通过测试。编码功能虽有帮助,但在初始上限处被截断。中文结果被记录为路由/编码问题,而非模型层面的语言判定。.
- API 警告: 无法禁用思考功能,强制使用工具会引发错误,思考模块与模型及对话相关联,而较早的
computer_20251124该工具不支持 Claude API 和 Google Cloud 路径。.
官方文档是怎么说的
Anthropic 的发布页面将 Claude Opus 5.5 的发布日期定为 2026 年 9 月 22 日,并将其描述为 Claude 5.5 系列中的首个型号。 该公告称,该产品在多数任务上的性能可媲美 Claude Fable 5.1,典型工作负载成本比 Opus 5 低 40%,且输出速度比 Opus 5 快 30% 以上。 以上均为供应商宣称的数据,因此与下文的独立测试及实际体验证据分开呈现。.
"(《世界人权宣言》) Claude 平台文档 将 API 模型 ID 列为 克劳德-作品第5号-第5首, ,100万个代币的上下文窗口,12.8万的最大输出,以及始终启用的自适应推理功能。文档中还列出了影响现有 Opus 5 集成方案的变更,相关内容将在下文的迁移部分中详细说明。.
绩效证据
这里并没有一个单一的“性能”数值。这三个公开来源衡量的指标各不相同,因此每张卡片都清晰地展示了其衡量标准和数据范围。.
Anthropic公告
已发布的信号: Anthropic 表示,在大多数工作负载下,Opus 5.5 的性能与 Claude Fable 5.1 相当;在典型工作负载下,其成本比 Opus 5 低 40%,且生成结果的速度比 Opus 5 快 30% 以上。.
边界: 由供应商发布的定位和测试案例,并非独立基准测试。.
人工分析
已发布的信号: 在 Terminal-Bench 4.0 测试中,最大努力快照的成绩为 59.6%;在“人类的最后一场考试”测试中为 61.4%;在 SciCode 测试中为 66.9%。.
边界: 得分取决于投入的努力、模型、日期以及指标的定义。它们无法预测每个API提示。.
METR部署前评估
已发布的信号: METR表示,其证据并未显示在所考察的判断能力方面,该方法相较于Fable 5.1有显著提升,但仍预计在某些研发工作中能实现有意义的提速。.
边界: 这是一项针对判断力和任务处理速度的更狭义的评估,并非完整的质量排名。.
综合来看,这些卡片支持一个有限的结论:Opus 5.5 在多项过时的公开评估中表现优异,但其优势程度会因任务、计算量设置和评估设计而异。这些卡片并未得出一个放之四海皆准的“最佳模型”结论。.
Claude Opus 5.5 价格和计费单位
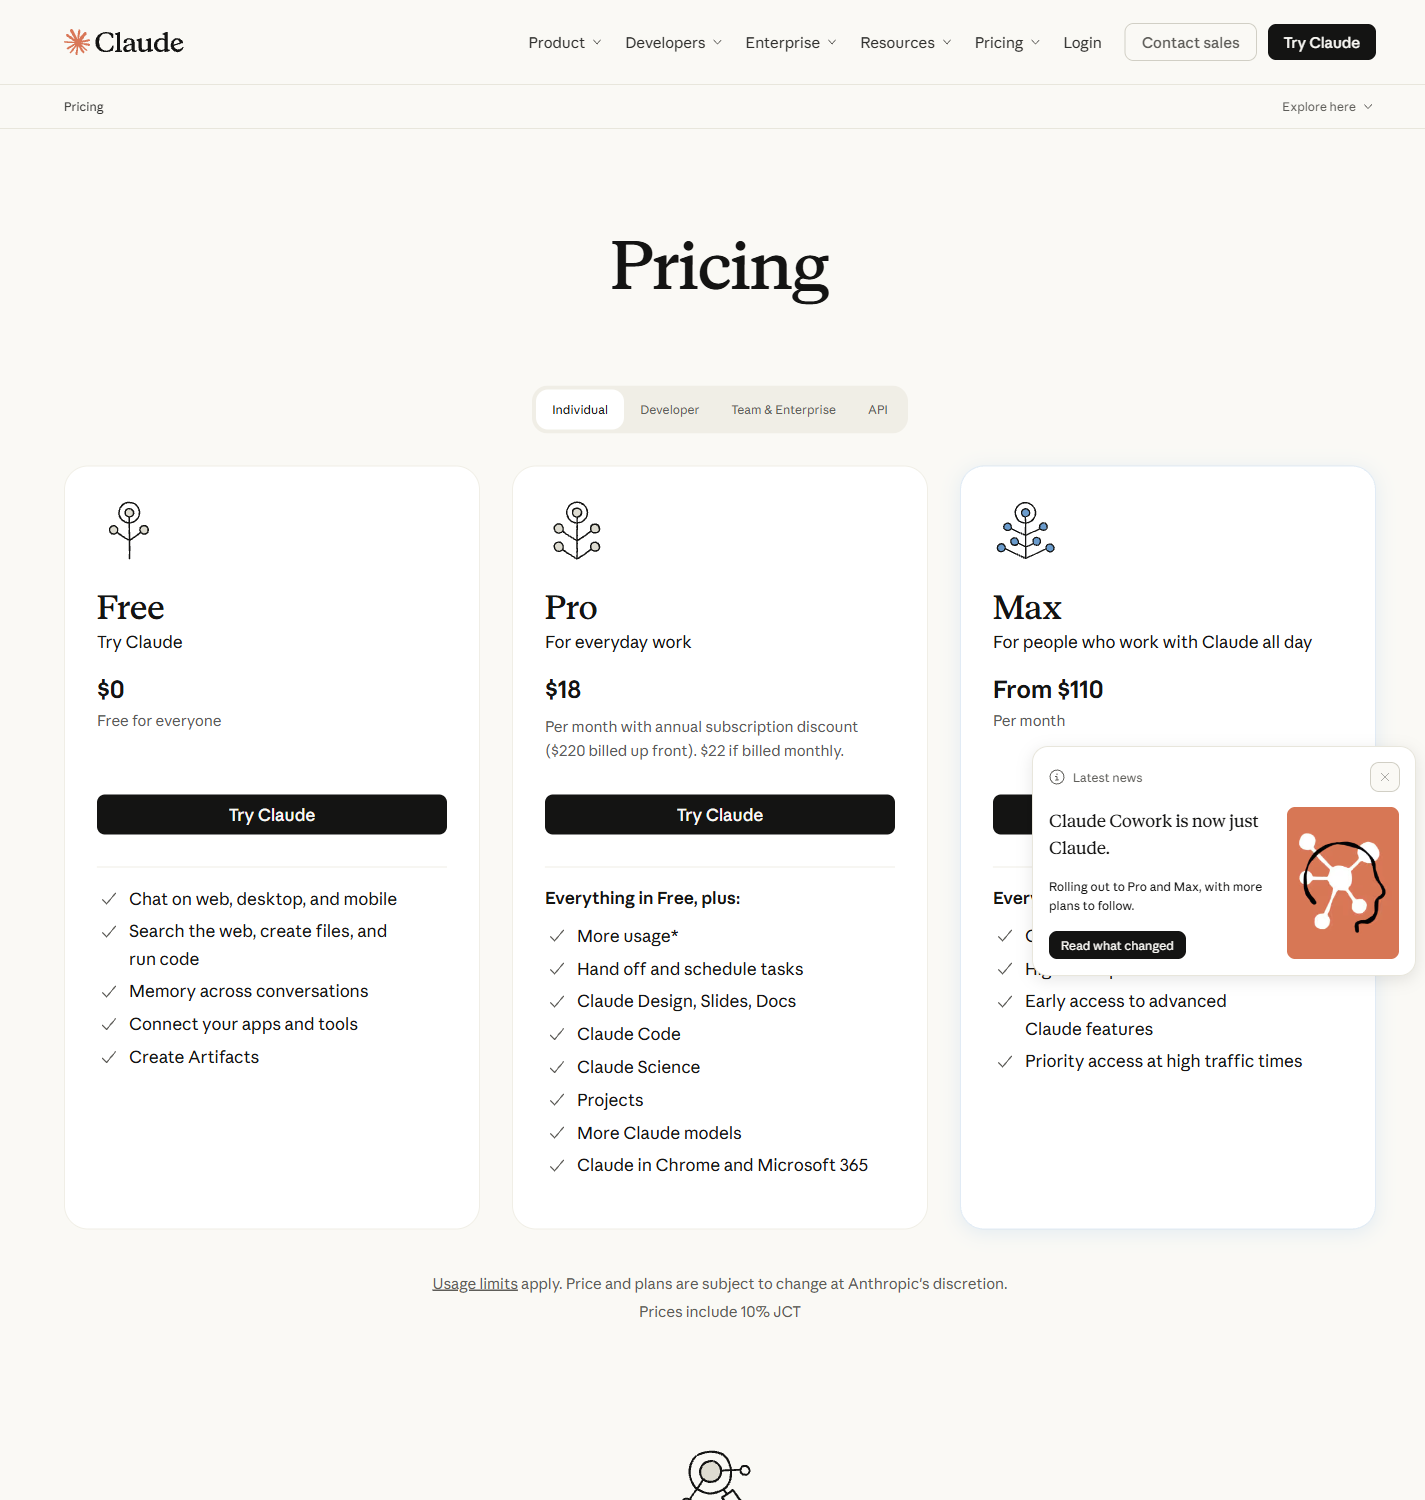
API 价格和消费者订阅价格是不同的产品。下方的 API 数据是用于代币预算的单价;消费者数据则是捕获的浏览器区域中显示的套餐卡。.
官方应用程序接口定价
简单估算:10,000个输入代币加上2,000个输出代币,按标准费率计算约为$0.08,此价格未包含缓存、批次、税费或平台加价。.
消费者套餐截图
截图中还显示了一张10% JCT票据。这些是因地区而异的显示值,并非全球性的价格承诺。.
有关令牌计费和上下文窗口成本的单独说明,请参阅 GPT-5.5 定价与背景指南. 服务提供商的 API 费率、订阅费用以及任何多模型平台的信用余额应在您的预算中分别列示。.
实测:五张任务结果卡
2026年9月23日,我们通过同一条受控的消息API路由,使用模型ID发送了五条独立的提示 克劳德-作品第5号-第5首. 第一轮处理使用了 max_tokens:1024. 我们记录了本地耗时、输入/输出令牌数、停止原因、正确性以及字面格式符合性。在首次运行揭示了该路径的输出问题后,我们重新运行了中文书写任务,并将上限设为4,096个令牌。这是一个包含五项任务的样本,而非可靠性估计。.
它能修复混合型去重功能吗?
任务设置
找出 Python 中的错误 去重 实现该函数,处理非字符串和不可哈希的值,保留首种拼写形式,并提供测试用例。.
该答复指出了 .lower() 对非字符串值处理失败,已将字符串改为 casefold(), ,添加了一个不可哈希的备用方案,并提交了修正后的代码和测试用例。.
该回答因达到1,024个令牌的上限而中断。虽然这个修复方案很有用,但配置规模太小,无法进行全面的代码审查。.
卡片评价: 返回了技术上有效的答案;由于令牌上限导致结果被截断,因此本次运行无法支持延迟性或完备性的主张。.
它能否保留事实并检验其局限性?
任务设置
从一份简短的评估备忘录中提取五项编号的结论,包括所采用的方法以及下一轮评估未涉及的测量内容。.
返回了正好五个编号项目。它保留了助理比较、20个提示法,以及关于长期保留率和客户转化率方面的空白。.
这是一个简短的源代码包,因此并未测试 1M 的上下文窗口。.
卡片评价: 根据指定条目数进行干净提取,同时保留源备忘录的证据边界。.
它能在不进行清理的情况下返回机器可读的输出吗?
任务设置
返回一个固定的 JSON 对象,其中包含标题、受众、两点优点、两点缺点以及结论。不允许使用 Markdown 围栏。.
返回了包含请求键值、两点优点、两点缺点以及一条简明建议的可解析 JSON。其中未包含 Markdown 包裹标签。.
一个有效的响应并不能证明该模式在更大规模或嵌套对象中的可靠性。.
卡片评价: 本次运行通过了字面 JSON 合规性测试。.
它能否正确应用重复舍入规则?
任务设置
从12个项目开始,每增加一批就将其数量乘以1.25,每批计算后向下取整,并报告四批的总数。.
返回了 12、15、18 和 22,然后将它们相加得到 67. 中间的计算过程清晰可见。.
该任务具有确定性且规模较小;它不能代表广泛的推理能力。.
卡片评价: 正确的结果和清晰的中间步骤。.
测试的路径是否返回了可用的中文文本?
任务设置
起草一篇中文评测的开篇,将官方宣传、价格、基准测试数据和实际测试结果区分开来。.
响应结构虽然存在,但在保存的结果中,通过测试路径返回的汉字显示为乱码。.
该证据并未区分模型语言质量与路径或编码行为。未给出中文质量评分。.
卡片评价: 该路径返回的文本无法使用;在对语言质量做出评价之前,请使用经过验证的 UTF-8 路径重新运行。.
在四次语言中立或英语测试中,本地平均值为6.24秒。该数值描述的是同一条路由上的五个连续请求,并非提供商侧的延迟。 观察到的最显著表现包括:提取结果简洁、严格遵循 JSON 规范以及算术运算正确;尚未解决的两个问题是编码时受输出配额限制,以及在测试路径上出现中文输出乱码。.
API 和迁移注意事项
简而言之,之所以将这些因素纳入考虑,是因为即使模型生成的文本质量看似不错,它们仍可能影响集成效果。.
- 思考永不停息。. 使用文档中所述的“effort”参数来控制深度、延迟和成本;该功能没有关闭开关。.
- 强制使用工具会返回错误。. 需要强制选择工具的现有代码需要进行单独的迁移测试。.
- 思维块必然与模型和对话相关。. 不要认为在更换模型后,思考模块还可以被重复使用。.
computer_20251124不被接受 关于文档中列出的 Claude API 和 Google Cloud 路径。.- 产出上限很重要。. 编码卡显示,即使是一个微小的干扰,也可能导致有用的响应被截断
max_tokens值。. - 批处理模式和快速模式属于不同的计费路径。. 将这些折扣或附加费与标准代币价格区分开来。.
基于证据的判决
Claude Opus 5.5 拥有可靠的过往公开基准测试数据,且其公布的标准 API 速率低于 Anthropic 公告中显示的 Opus 5 数据。 在记录的五次任务运行中,它生成了干净的提取结果、符合规范的 JSON 数据以及正确的算术运算结果;代码答案虽有参考价值,但因初始上限限制而被截断;而通过测试路径输出的中文内容则无法使用。.
因此,可以得出的合理结论范围有限:该模型在几项小型任务中表现出了对指令的良好遵循能力,但所采用的路径和配置存在明显的局限性。任何迁移决策都应使用适当的输出预算重复相同的提示词,验证工具调用,并将官方代币费率与订阅或平台积分区分开来。.
如果你想找另一条路线进行比较,那么 DeepSeek V4 Pro 与 Flash 测试格式对比 展示了任务级判定如何与模型级主张保持独立。该 GPT-5.5 用例指南 增加了以任务为导向的参考点,而 Gemini 闪存基准测试说明 和 AI模型对比指南 提供附近的模型上下文。有关多模型访问,请参阅 一站式人工智能订阅服务 和 多模型平台对比.
常见问题
Claude Opus 5.5 的价格是多少?
官方 API 费率为:每百万输入代币 $4,每百万输出代币 $20。缓存读取费率为每百万代币 $0.20,5 分钟缓存写入费率为每百万代币 $5。.
什么是 Claude Opus 5.5 上下文窗口?
Claude 平台文档中列出了 100 万令牌的上下文窗口和 128K 令牌的最大输出。另一条已记录的测试版路径支持消息批处理中最多 300K 个输出令牌。.
Claude Opus 5.5 比 Opus 5 更好吗?
Anthropic 报告称其典型工作负载成本更低且输出速度更快,而独立评估显示其在多项过时的任务上表现优异。质量提升的程度取决于基准测试、工作量设置、提示词和处理路径。.
思考可以被关闭吗?
不。当前模型的文档中提到,自适应思考功能始终处于开启状态。请使用“effort”参数来控制思考的深度、延迟和成本。.
这五项API任务是否证明了其可靠性?
不。这些卡片展示了具体的行为和配置限制,但仅凭五项任务无法估算总体成功率。编码上限问题和中国路线问题已分别报告。.
这篇评论是否证明了中国产品的质量?
不。测试的路径返回了乱码的中文文本,因此该结果被记录为编码或路径问题,需待经验证的 UTF-8 重新运行后再作定论。.