Muse Spark 1.3 是 Meta 迄今為止最強大的 Muse Spark 版本:其公開版 xhigh 模型在人工智慧分析指數(Artificial Analysis Intelligence Index)中達到 61 分,維持 100 萬個代號的上下文視窗,並在我們的首次回應 API 測試中通過了全部三項中等難度的編碼任務。. 需要特別注意的是,Meta 的主要基準測試圖表採用的是「max reasoning」功能,而當本評測撰寫時,「max」功能仍在等待經過額外安全測試後才正式廣泛推出。.

Muse Spark 1.3 評測:快速評析
我們的結論
對於程式設計代理、長上下文處理以及成本敏感的自動化應用而言,Muse Spark 1.3 值得一試。其公開的 xhigh 結果已具備前沿競爭力,但請勿將 Meta 的最高分視為當今每位 API 使用者都能複製的成績。.
Meta 於 2026 年 9 月 2 日發布了 Muse Spark 1.3, ,使其能適用於長期視野的自主工作流程、產生更簡潔的程式碼輸出,並實現更可靠的協作。這延續了朝向 基於工具使用模型所建構的人工智慧代理. Meta 表示,當需求含糊不清時,系統會提出澄清問題;遇到瓶頸時會發出警示;在執行具重大影響的動作前則會進行確認。在與 1.2 版的內部比較中,Meta 工程師觀察到工具呼叫次數減少了約 20%,標記數量也減少了 25%。這些是服務供應商的聲稱,並非我們測試所得的結果。.
與 Muse Spark 1.2 相比,有哪些變化?
人工分析:xhigh 上的 57 至 61。.
Meta 在 DeepSWE 上的報告數值為 75.4 對 55.0,但將 1.3(max)與 1.2(xhigh)進行了比較。.
1M 窗口依然存在;在 Meta 的圖表中,高頻段 MRCR 分數急劇上升。.
代幣率維持不變,而 AA 的數值為 $0.55,相較之下,每項經評估的任務則為 $0.40。.
Muse Spark 1.3 效能測試:Max 與 Xhigh 並非同一回事
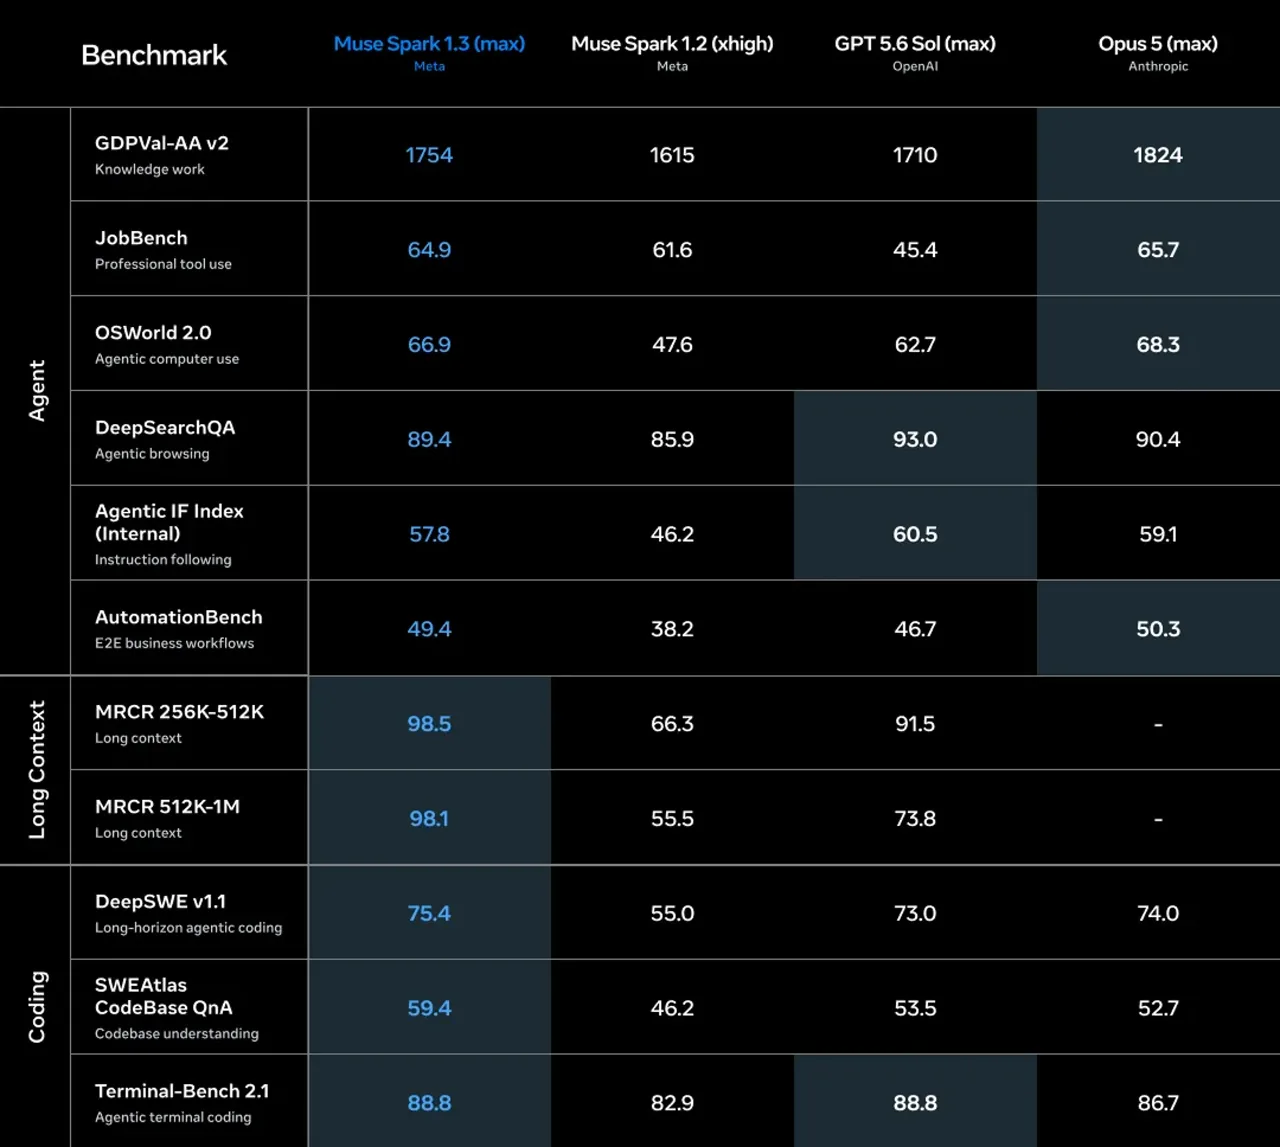
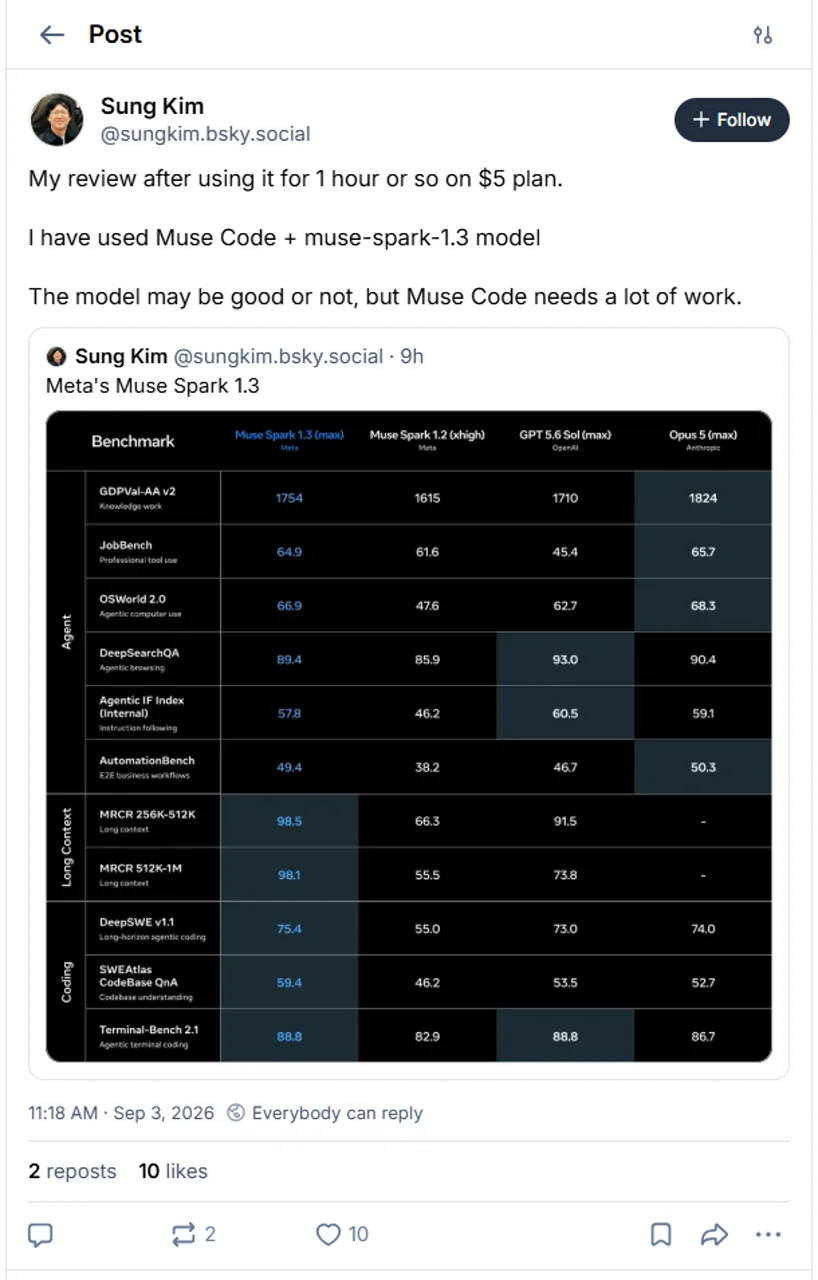
Meta 的官方圖表 表現令人印象深刻。Muse Spark 1.3 在 Terminal-Bench 2.1 上的最高分數為 88.8,在 DeepSWE v1.1 上有 75.4,在 MRCR 512K-1M 上有 98.1,而在 OSWorld 2.0 上有 66.9。 它在 Terminal-Bench 測試中與 GPT-5.6 Sol 並列最高分,並在兩個長語境 MRCR 測試區間中領先於列出的競爭對手。開發者若欲比較更廣泛的市場情況,可參考我們的 coding-agent 概覽 作為補充背景資訊。.
元報告,最大推理
| 基準 | 1.3 最大值 | 1.2 × 高度 | GPT-5.6 太陽能最大值 | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | 不適用 |
不同的努力設定、代理程式束縛方式以及 OSWorld 版本,限制了直接可比性。Meta 亦將「Agentic IF 指數」描述為一項內部複合指標。.
如何閱讀圖表
1.3、GPT-5.6 Sol 及 Opus 5 採用 max;1.2 則採用 xhigh。.
命名代理與固定連接器會因評估而異。.
1.3 版與 1.2 版的執行使用不同的環境版本。.
「Agentic IF 指數」是 Meta 編製的綜合指數,並非單一公開基準指數。.
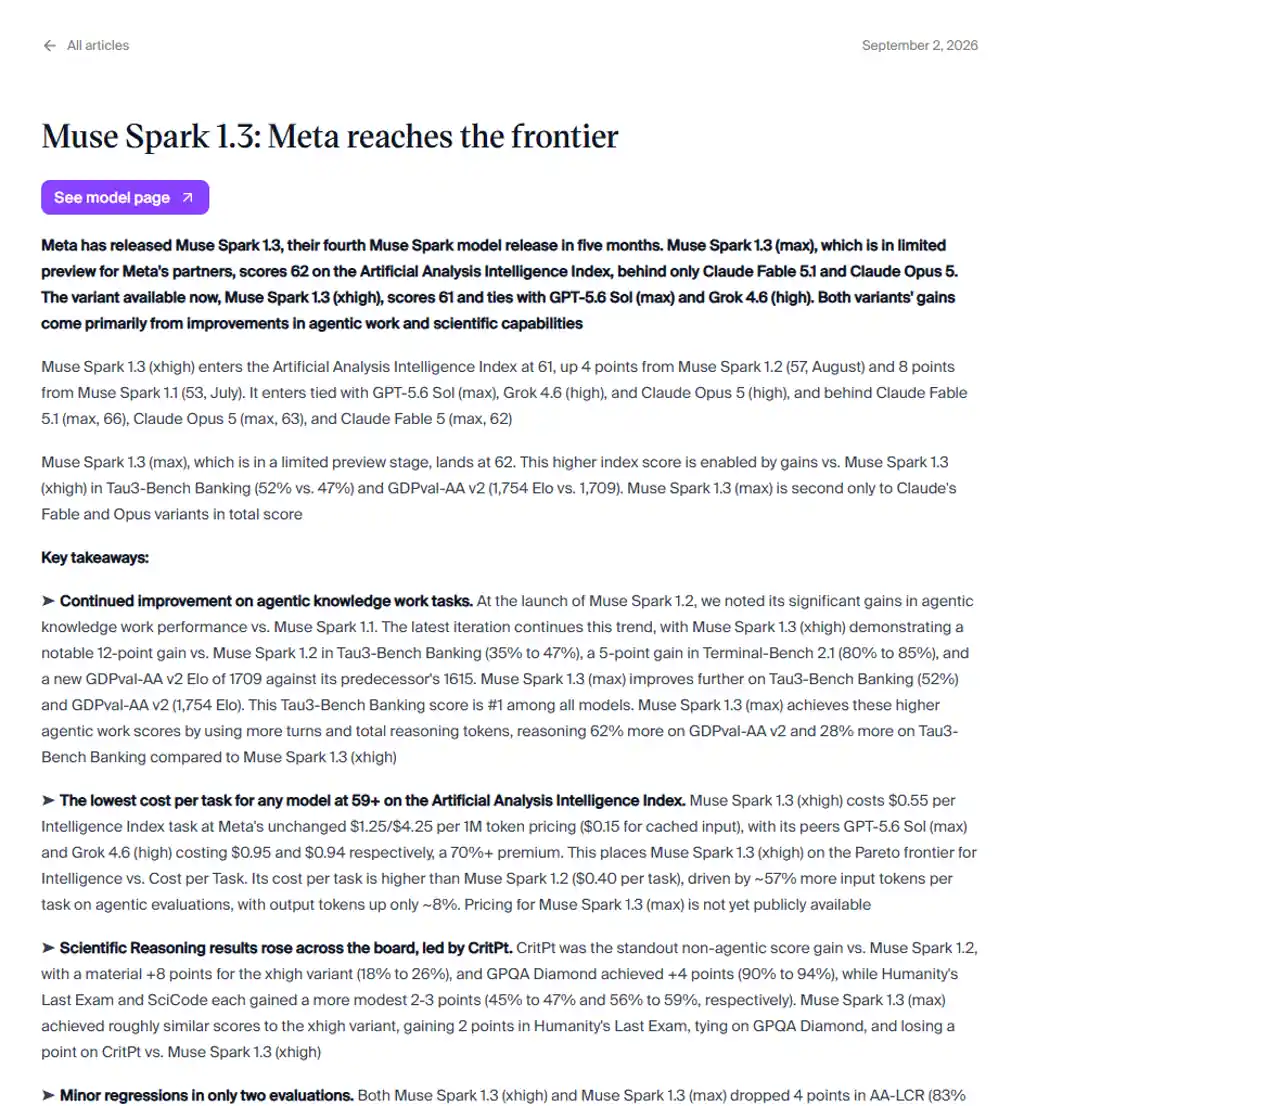
「人工分析」提供更清晰的視角 目前使用者可存取的內容。 Muse Spark 1.3 的 xhigh 得分為 61,較 1.2 版的 57 有所提升。其 Terminal-Bench 結果為 85%,GDPval-AA v2 為 1709 Elo,而 Tau3-Bench Banking 則為 47%。 限時預覽版的 max 變體總分達到 62。此外也出現了一些退步:AA-LCR 從 83% 降至 79%,而 AA-Omniscience Accuracy 在 xhigh 模式下的表現則從 45% 降至 42%。.
Muse Spark 1.3 定價
貢獻者
muse-spark-1.3-貢獻者
$0.10 輸入 / $0.002 快取 / $0.20 輸出 每百萬個代幣。.
提示語可用於改進 Meta 的產品。.
標準
muse-spark-1.3
$1.25 輸入 / $0.15 快取 / $4.25 輸出 每百萬個代幣。.
Meta 表示,此層級並非用於改善其產品。.
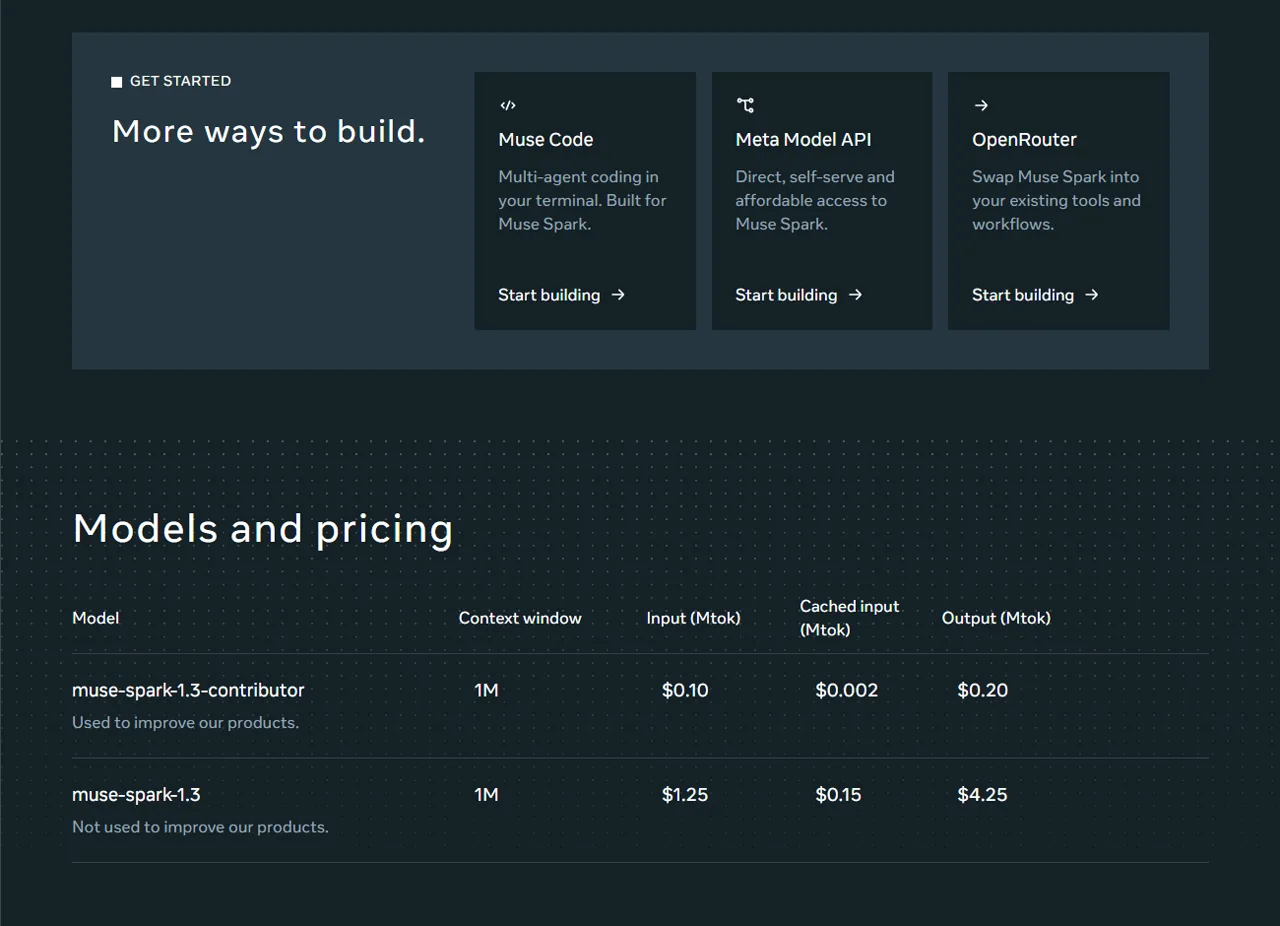
的 官方代幣價格 與 1.2 版本相比並無變化,但每項任務的成本卻有所不同。我們的 全能型 AI 平台評測 解釋了為何應分別評估存取成本與工作流程成本。人工分析顯示,每項「情報指數」任務的消耗量為 $0.55(對應 1.3 xhigh),而 1.2 的消耗量則為 $0.40,主要原因在於代理評估任務的輸入標記數量大約多出 57%。 貢獻者級別的價格極為低廉,但其數據使用條款是真正的產品選擇,而非僅是附帶註腳。.
Muse Spark 1.3 API 存取
Meta 的 官方食譜 現在使用 muse-spark-1.3 設為預設值,並記錄 1,048,576 個標記的上下文視窗。此 API 與 OpenAI SDK 相容。Muse Code 和 Meta Model API 已確認為目前的存取途徑。 Meta 的模型頁面亦顯示 OpenRouter,但點選該按鈕時,其連結仍指向 1.2 版本的網址,因此請在部署前確認路徑是否正確。關於代理程式互通性的背景資訊,請參閱我們的指南: MCP 與 AI 工具.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "請審查此修補程式是否存在回歸問題。"}],
)

print(response.choices[0].message.content)
實作程式設計測驗:3/3 通過
我們透過 API,在溫度為零的條件下,針對三項中等難度的儲存庫任務進行測試,每項任務僅提交一次回應。每項回應都必須以結構化 JSON 格式回傳完整的檔案。隨後,我們將這些檔案套用至可拋棄式目錄中,並執行公開與隱藏的檢查。這些僅是小規模的受控測試,無法取代 Terminal-Bench 或生產環境儲存庫的測試。.
5/5 項測試;18.4 秒;2,473 個標記;$0.00905。該模型找出未使用的已處理 ID 集合,新增了早期重複檢查機制,並編寫了一項回歸測試。.
通過型別檢查及兩項執行時檢查;耗時 47.6 秒;4,945 個字元;$0.01661。驗證、持久化與稽核記錄功能已分開實作,且未破壞交易邊界。.
9/9 項測試;20.3 秒;3,789 個標記;$0.01446。CSV 相容性、行號錯誤、原子輸出、模擬執行安全性、說明文件及文件均通過。.
總計: 11,207 個代幣和 $0.04013。時間值為端到端請求時間,而非 Meta API 的原生延遲或 TTFT。.
結果比單純的「3/3」所顯示的更為理想:這三項首輪回應皆可進行審查,且能考量各種限制條件。在閱讀我們的文章時,同樣的證據嚴謹性原則也至關重要: GPT-5 評測. 儘管如此,此範例並未測量工具呼叫的重複可靠性、大型儲存庫的導覽功能,或是 Muse Code 的協調層。正在評估經濟實惠替代方案的讀者,或許也會發現我們的 預算編碼模型比較 很有用。.
開發者們的初步反應
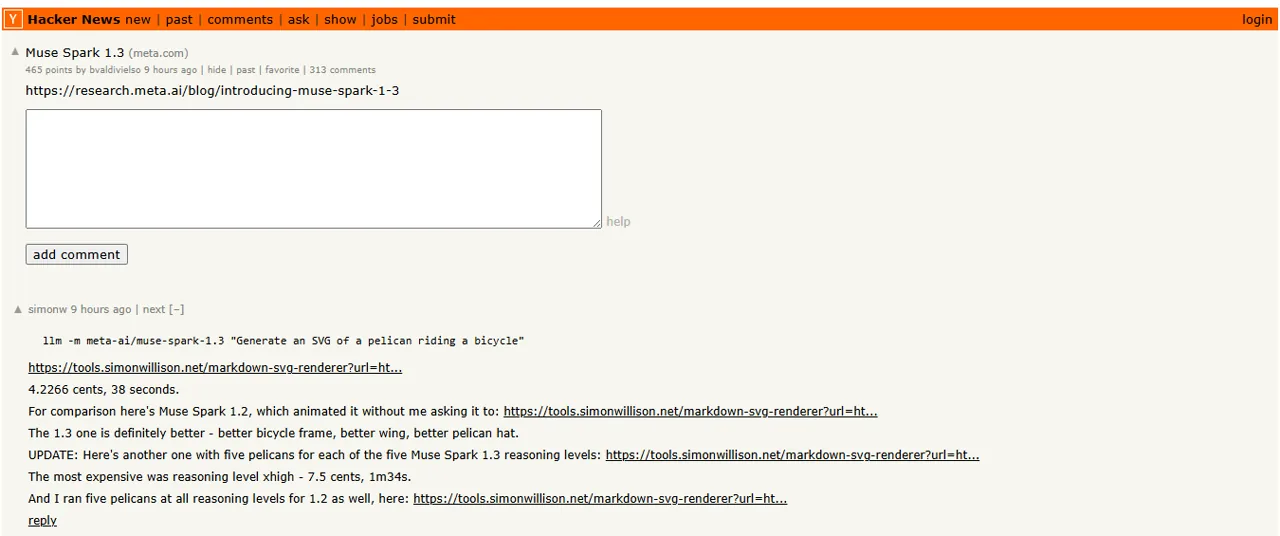
初步反應褒貶不一,且數量過少,尚無法形成共識。在一篇 Hacker News 測試, 西蒙·威利森(Simon Willison)報告了一項耗時 38 秒、耗電量為 4.2266 分的 SVG 測試結果,並認為 1.3 版的表現「絕對比」他先前的 1.2 版對照測試「更好」。. Dax 描述了這次發布 以此提醒自己,他有多麼想念那些性感的模特兒。. 金成, 在與 Muse Code 互動約一小時後,他表示該模型或許不錯,但 Muse Code 的產品「還有很多需要改進的地方」。這最後的評論是針對代理體驗,而非純粹針對模型本身的測試。.
優點與缺點
哪些方法奏效了
- 公眾評價極高
- 1M-token 語境視窗
- 相容於 OpenAI 的 API
- 這三項編碼任務均通過了首次回應
- 貢獻者級別的代幣匯率極低
看什麼
- 「Headline max」的搜尋結果並非預設的公開體驗
- 獨立任務成本較 1.2 有所上升
- 兩項獨立指標出現回歸
- 貢獻者的資料可能有助於改善 Meta 的產品
- 針對 Muse Code 的初期反饋褒貶不一
哪些人適合使用 Muse Spark 1.3?
適用於
程式碼代理評估、大型語境儲存庫相關工作、工具驅動的自動化,以及在資料政策可接受範圍內進行的成本敏感型實驗。.
何時該跳過或等待
您需要經過實證的長期生產可靠性;需要立即獲得最大容量;或者無法接受「貢獻者級」的資料使用方式,且認為標準定價缺乏競爭力。.
Muse Spark 1.3 評測結論
Muse Spark 1.3 值得推薦進行評估。. 它結合了尖端級的公開高效能表現、強大的長上下文處理能力、直覺易用的 API 設計,以及極具競爭力的定價。我們進行的三項第一響應編碼任務進一步證實,它能夠遵循多檔案限制,並產出可測試的修補程式。.
對於敏感程式碼,請選擇標準層級。如需另一項前沿比較,請參閱 GPT-5 對比 Claude 4. 在該推理層級廣泛普及之前,應將最佳基準測試結果視為預覽性證據。此外,應將 Muse Code 與模型 API 分開評估:代理程式的使用者體驗、工具迴圈及儲存庫控制,其成敗皆可獨立於基礎模型而定。.
Muse Spark 1.3 常見問題集
什麼是 Muse Spark 1.3?
Muse Spark 1.3 是 Meta 於 2026 年 9 月 2 日發布的編碼與代理工作流程模型,具備 100 萬個代幣的上下文視窗,並原生支援圖像、影片及文件的感知能力。.
Muse Spark 1.3 的售價是多少?
標準模型的費用為每百萬個輸入代幣 $1.25、快取輸入為 $0.15,以及輸出為 $4.25。 貢獻者模型的費用分別為 $0.10、$0.002 及 $0.20,但其資料可能會被用於改善 Meta 的產品。.
是否提供「最大推理」功能?
Meta 表示,現有的推理模式將於上線時提供,而「max」功能則會在進行額外的安全測試後推出。在假設該功能已全面開放之前,請先查閱最新的 API 文件。.
Muse Spark 1.3 是否通過了編碼測試?
是的。其首次回應通過了我們所有 Python 錯誤修正、TypeScript 重構以及 JSONL 功能測試中的可執行性檢查。此範例僅包含三項受控任務,並不代表一般的可靠性比率。.
Muse Spark 1.3 比 1.2 更好嗎?
總體而言,根據現有證據來看。公開的 xhigh 智力分數從 57 上升至 61,而 Meta 報告指出在自主性與長上下文處理方面有顯著提升,但「人工分析」也發現任務成本有所增加,且在長上下文檢索與事實校準方面出現輕微退步。.
我該使用「貢獻者」模式還是「標準」模式?
對於敏感或專有提示語,請使用「標準」選項,因為 Meta 表示該資料不會用於改善其產品。雖然「貢獻者」選項的費用低廉得多,但其提示語可能會被用於產品改進。.