
Claude Opus 5.5 評測:價格、效能測試與實際 API 測試
Claude Opus 5.5 結合了 100 萬個標記的上下文視窗,以及每百萬個標記 $4 / $20 的 API 價格。 本評測將 Anthropic 所發布的聲明、獨立的基準測試快照,以及透過 Messages API 路徑執行的五項直接任務運行結果加以區分。.
測量結果是具體的。. 有三項任務回傳了清晰、可用的答案;編碼任務雖回傳了有用的答案,但觸及了首個 1,024 個標記的上限;而中文寫作任務在測試路徑上產出了亂碼。此範例顯示了具體的行為與路徑限制,而非普遍的成功率。.
快速回答
- 表現: Anthropic 在多數工作任務中表現達 Fable 5.1 級別,而「人工分析」在全力以赴的情況下,智商指數得分為 58。METR 較狹義的判斷能力評估結果顯示,其表現相較於 Fable 5.1 並未顯著提升。.
- 價格: 官方 API 匯率是 每百萬個輸入代幣為 $4,每百萬個輸出代幣為 $20. 每百萬次快取讀取的代價為 $0.20;每百萬次 5 分鐘的快取寫入代價為 $5。.
- 實際操作結果: 在記錄的執行結果中,長文本提取、嚴格 JSON 以及算術推理均通過測試。編碼功能雖有幫助,但因初始上限而受到限制。中文結果被記錄為路徑/編碼問題,而非模型層級的語言判定。.
- API 警告: 思考功能無法停用,強制使用工具會引發錯誤,思考區塊與模型及對話相關聯,而較舊的
computer_20251124此工具不適用於 Claude API 及 Google Cloud 路徑。.

官方文件是怎麼說的
Anthropic 的發佈頁面將 Claude Opus 5.5 的發佈日期定為 2026 年 9 月 22 日,並將其描述為 Claude 5.5 系列中的首款型號。 該公告聲稱,在大多數工作負載上,其效能可媲美 Claude Fable 5.1;典型工作負載成本比 Opus 5 低 40%;且輸出速度比 Opus 5 快 30% 以上。 上述數據均為供應商宣稱,因此將與下文所述的獨立測試及實際操作證據分開呈現。.
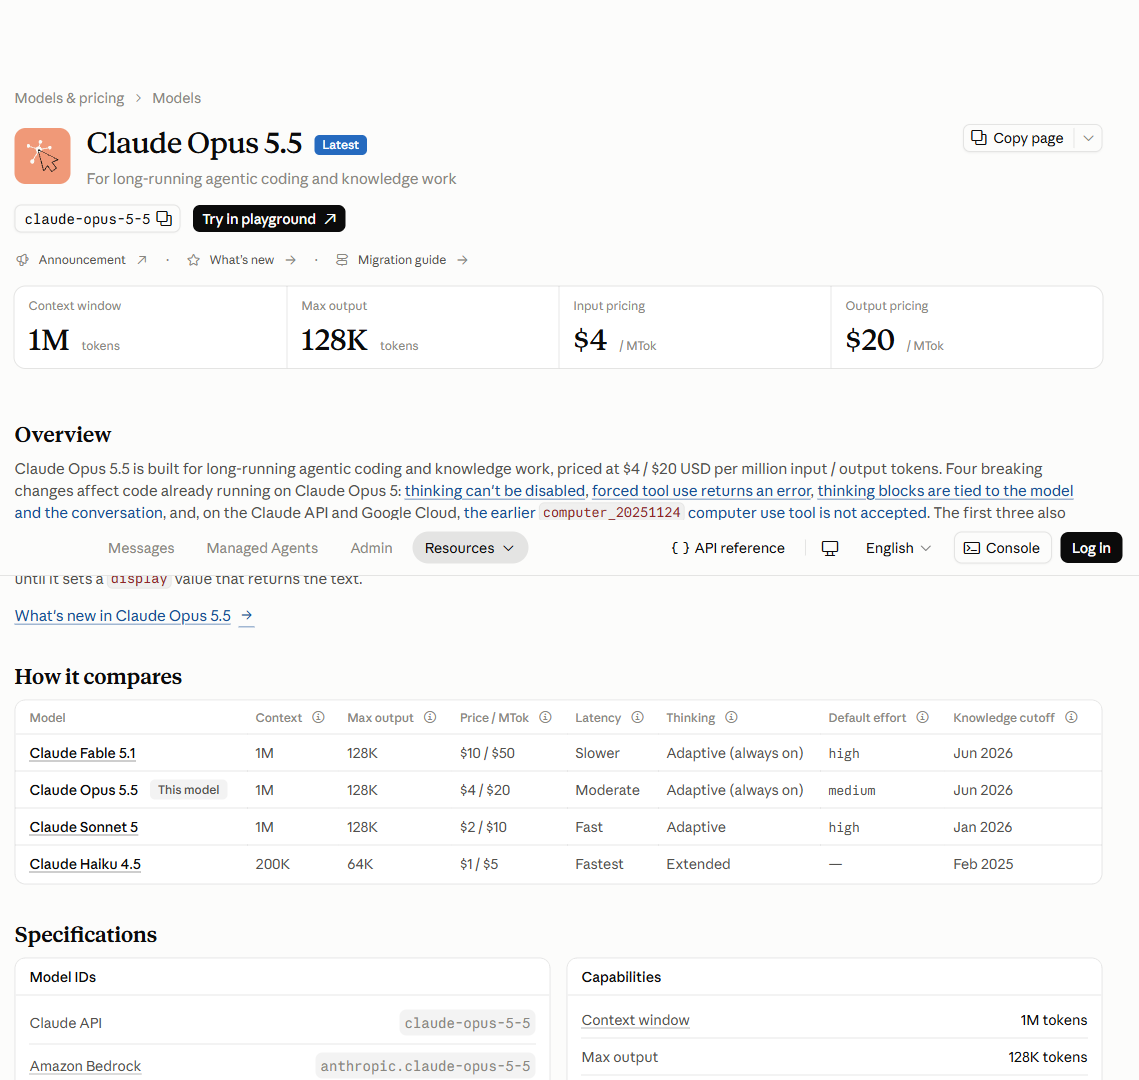
的 Claude 平台文件 將 API 模型 ID 列為 克勞德作品第5號第5首, 、100 萬個代幣的上下文視窗、128K 的最大輸出量,以及始終啟用的自適應思考功能。文件中亦列出了影響現有 Opus 5 整合功能的變更,相關內容將在下方的「遷移」章節中詳述。.
績效證據
這裡並沒有單一的「效能」數值。這三項公開資料來源所衡量的指標各不相同,因此每張卡片都會明確標示其衡量標準與數據範圍。.
Anthropic 公告
已發布的訊號: Anthropic 指出,Opus 5.5 在大多數工作上表現可媲美 Claude Fable 5.1,在典型工作負載下比 Opus 5 節省 40%,且產出速度快上 30% 以上。.
邊界: 由供應商發布的定位與測試範例,並非獨立的基準測試。.
人工分析
已發布的訊號: 在 Terminal-Bench 4.0 測試中,最大努力快照的成績為 59.6%;在「人類的最後一場考試」測試中為 61.4%;而在 SciCode 測試中則為 66.9%。.
邊界: 評分取決於投入的努力程度、模型、日期以及指標的定義。這些評分無法預測每個 API 提示的結果。.
METR 部署前評估
已發布的訊號: METR 表示,其證據並未顯示在所評估的判斷能力方面,相較於 Fable 5.1 有顯著改善,但仍預期在某些研發工作上能帶來有意義的加速效果。.
邊界: 這是一項針對判斷力與任務執行效率的較狹義評估,而非完整的品質排名。.
綜合這些資料來看,只能得出一個有限的結論:Opus 5.5 在多項過時的公開評估中表現優於其他模型,但其優勢的程度會因任務、計算資源設定及評估設計的不同而有所變化。這些資料並未確立一個通用的「最佳模型」結果。.
Claude Opus 5.5 價格與計費單位
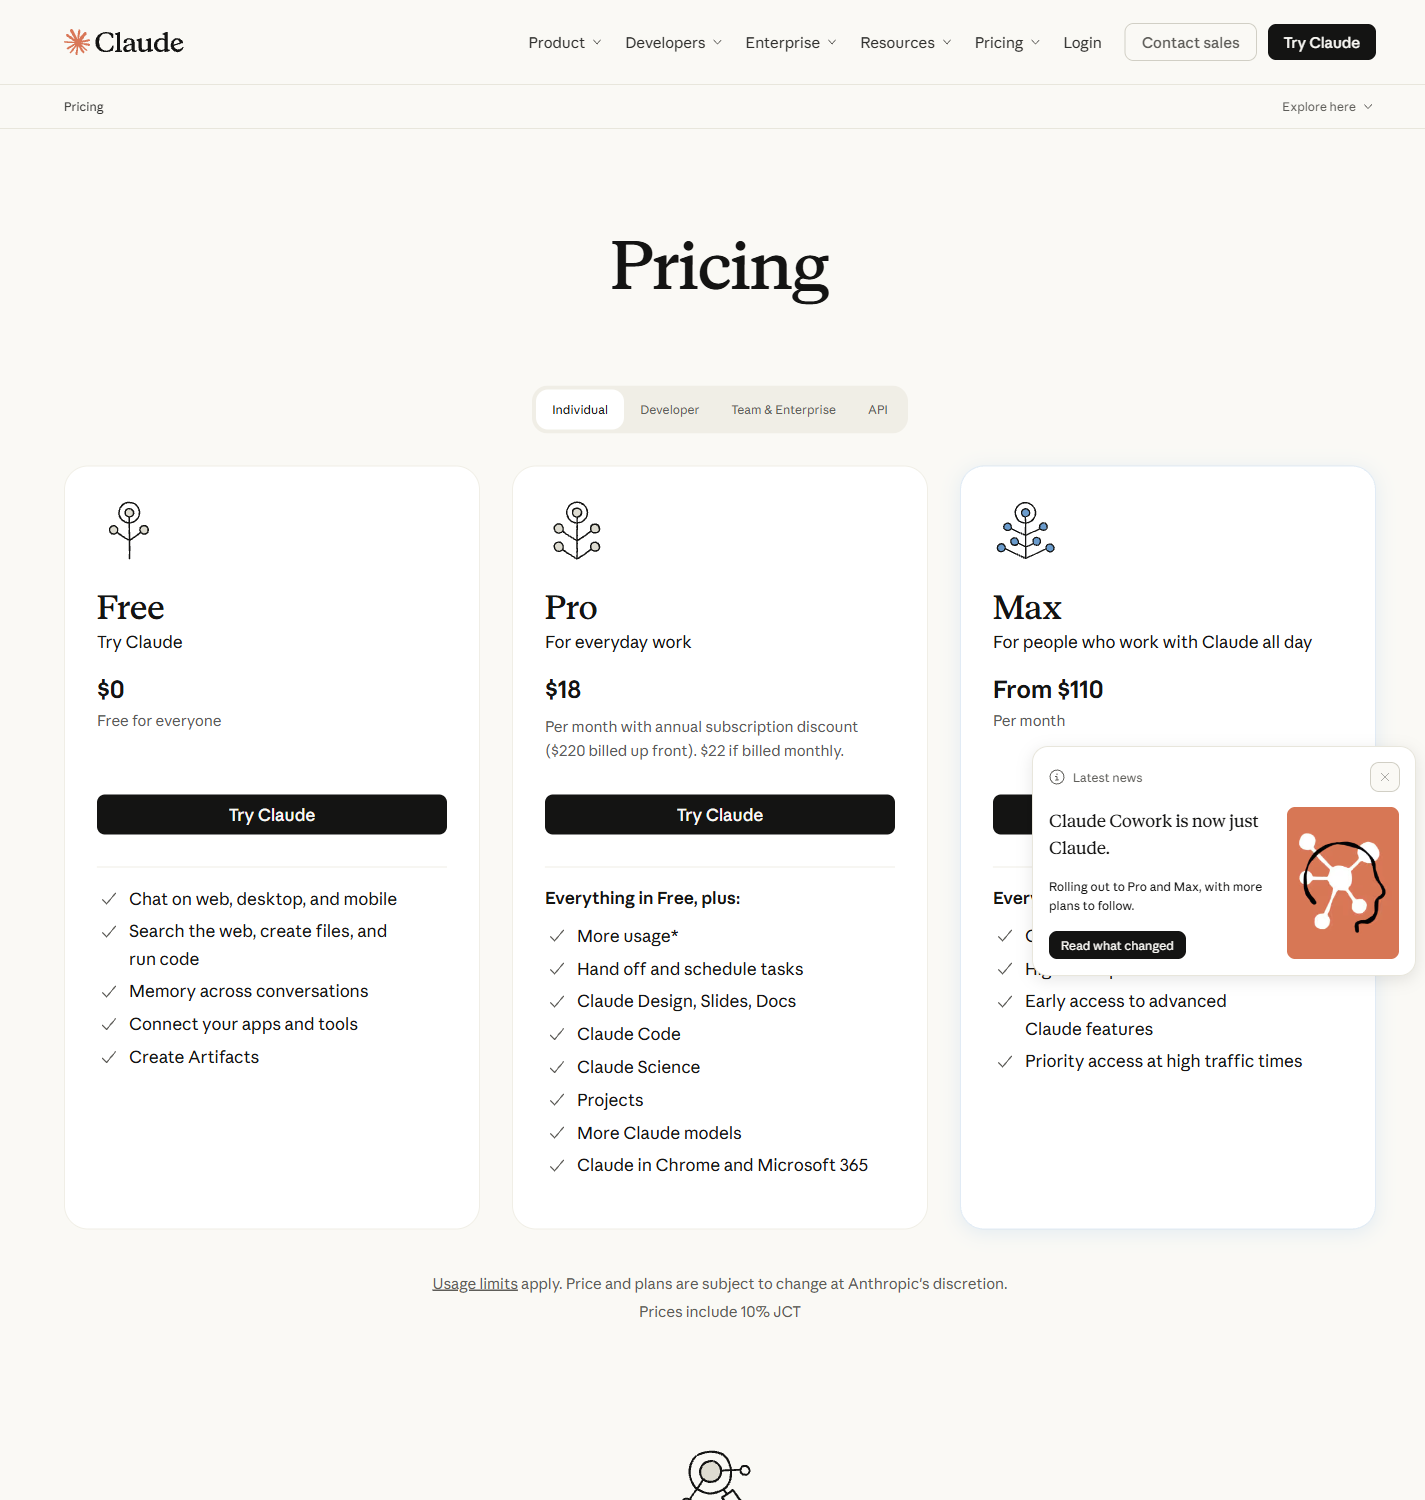
API 價格與消費者訂閱價格屬於不同的產品。下方的 API 數據是用於代幣預算規劃的單價;消費者數據則是擷取的瀏覽器區域中可見的方案卡片。.
官方 API 定價
簡單估算:10,000 個輸入代幣加上 2,000 個輸出代幣,按標準費率計算約為 $0.08,此價格尚未包含快取、批次處理、稅金或平台加價。.
消費者方案螢幕截圖
該截圖頁面還顯示了一張 10% JCT 票據。這些是受地區影響的顯示值,並非全球價格承諾。.
有關代幣計費與上下文視窗成本的詳細說明,請參閱 GPT-5.5 定價與背景指南. 供應商的 API 費率、訂閱費用,以及任何多模型平台的信用餘額,應在您的預算中分別列示。.
實機測試:五張任務結果卡
我們於 2026 年 9 月 23 日透過相同的受控 Messages API 路由,使用模型 ID 發送了五個獨立的提示 克勞德作品第5號第5首. 第一輪處理採用了 max_tokens:1024. 我們記錄了當地經過時間、輸入/輸出標記、中止原因、正確性,以及字面格式符合性。在首次執行時發現路徑的輸出問題後,我們將中文書寫任務的上限調整為 4,096 個標記並重新執行。這是一個包含五項任務的樣本,並非可靠性估計。.
它能否修復混合型重複資料刪除功能?
任務設定
找出 Python 程式中的錯誤 去重 函式、處理非字串及無法進行雜湊運算的值、保留原始拼寫,並提供測試。.
該回應指出了 .lower() 在非字串值上發生錯誤,已將字串改為 casefold(), 新增了一個無法進行雜湊運算的備用方案,並回傳了修正後的程式碼及測試案例。.
答案在 1,024 個字元限額處中斷。這個解決方案雖有幫助,但配置規模過小,無法進行完整的程式碼審查。.
卡片評語: 回傳了技術上有效的答案;由於代幣上限導致結果被截斷,因此本次執行無法支持延遲性或完備性的主張。.
它能否保留事實並檢驗其局限性?
任務設定
從一份簡短的評估備忘錄中,摘錄五項編有編號的發現,內容應包含研究方法,以及下一輪評估未測量的項目。.
回傳了精確五個編號的要點。它保留了助理比較、20 個提示法,以及關於長期保留率與客戶轉化率的相關空白處。.
這是一個簡短的原始碼套件,因此並未測試 1M 的上下文視窗。.
卡片評語: 以指定數量進行乾淨的擷取,並保留來源備忘錄的證據邊界。.
它能在不進行清理的情況下,返回可由機器讀取的輸出嗎?
任務設定
回傳一個固定的 JSON 物件,其中包含標題、受眾、兩項優點、兩項缺點以及結論。不允許使用 Markdown 圍欄。.
回傳了包含所請求鍵值、兩項優點、兩項缺點以及簡明建議的可解析 JSON。其中未包含 Markdown 包覆標籤。.
一個有效的回應並不能證明該模式在較大或嵌套物件上的可靠性。.
卡片評語: 本次執行中通過了 JSON 字面值合規性檢查。.
它能否正確地套用重複四捨五入規則?
任務設定
從 12 項開始,每批數量乘以 1.25,每批計算後向下取整,並報告四批的總計。.
返回 12、15、18 和 22,然後將它們相加得到 67. 中間的算式清晰可見。.
這項任務具有確定性且規模較小;它並不能代表廣泛的推理能力。.
卡片評語: 正確的結果與清晰透明的中間步驟。.
測試過的路徑是否回傳了可用的中文文字?
任務設定
撰寫一篇中文評測的開頭,將官方宣稱、價格、基準測試數據及實際測試結果分開闡述。.
回應結構雖然存在,但在儲存的結果中,透過測試路徑傳回的中文字元卻出現亂碼。.
該證據並未區分模型語言品質與路徑或編碼行為。未賦予任何中文品質分數。.
卡片評語: 此路徑回傳的文字無法使用;在對語言品質做出評估前,請先使用經驗證的 UTF-8 路徑重新執行。.
在四次語言中立或英文測試中,當地平均值為 6.24 秒。該數值描述的是單一路徑上的五個連續請求,並非服務端延遲。 觀察到的最顯著表現包括:精簡的資料擷取、嚴格遵循 JSON 規範,以及正確的算術運算;尚未解決的兩個問題則是:編碼過程面臨的輸出預算壓力,以及在測試路徑上出現的中文輸出亂碼現象。.
API 與遷移注意事項
簡要的答案之所以包含這些因素,是因為即使模型生成的文字品質看似良好,這些因素仍可能影響整合結果。.
- 思考從未停止。. 請使用文件中記載的「effort」參數來控制深度、延遲和成本;此功能沒有關閉開關。.
- 強制使用工具會引發錯誤。. 現有需要強制選擇工具的程式碼,需要進行獨立的遷移測試。.
- 思考方塊必然與模型和對話息息相關。. 請勿假設在變更模型後,思考模組仍可重複使用。.
computer_20251124不被接受 關於文件中列出的 Claude API 及 Google Cloud 路徑。.- 產出上限至關重要。. 編碼卡顯示,即使只有一小部分,有用的回應仍可能被截斷
max_tokens值。. - 批次模式與快速模式屬於不同的計費途徑。. 請將其折扣或附加費與標準代幣價格分開計算。.
基於證據的判決
Claude Opus 5.5 擁有強而有力的過往公開基準測試數據,且其公布的標準 API 速率低於 Anthropic 公告中顯示的 Opus 5 數據。 在五次記錄的任務執行中,它產出了乾淨的提取結果、符合嚴格規範的 JSON 格式以及正確的算術運算結果;程式碼答案雖具實用性,但因初始上限限制而遭截斷;而透過測試途徑產出的中文輸出則無法使用。.
因此,可辯護的結論範圍有限:該模型在數項小型任務中展現出強烈的指令遵循能力,但其路徑與配置卻顯露出明顯的限制。任何遷移決策都應在適當的輸出預算下重複相同的提示語、驗證工具調用,並將官方代幣匯率與訂閱或平台積分區分開來。.
若您想參考另一種路線進行比較,該 DeepSeek V4 Pro 與 Flash 測試格式比較 說明了任務層級的判斷如何與模型層級的主張保持獨立。該 GPT-5.5 應用案例指南 增添了一個以任務為導向的參考點,而 Gemini 快閃記憶體效能測試筆記 和 AI 模型比較指南 提供鄰近模型的背景資訊。有關多模型存取,請參閱 一站式 AI 訂閱服務 和 多模型平台比較.
常見問題
Claude Opus 5.5 的價格是多少?
官方 API 費率為每百萬個輸入代幣 $4,每百萬個輸出代幣 $20。快取讀取費率為每百萬個代幣 $0.20,而 5 分鐘快取寫入費率為每百萬個代幣 $5。.
什麼是 Claude Opus 5.5 上下文視窗?
Claude 平台文件中列出,其上下文視窗為 100 萬個標記,最大輸出為 128K 個標記。另一條已記錄的測試版路徑則支援訊息批次最多 300K 個輸出標記。.
Claude Opus 5.5 是否比 Opus 5 更好?
Anthropic 報告顯示其典型工作負載成本較低且產出速度較快,而獨立評估則顯示其在數項過時的任務上表現優異。品質提升的幅度取決於基準測試、工作量設定、提示詞及處理路徑。.
思考可以被關掉嗎?
不。根據目前的模型文件,適應性思考功能始終處於開啟狀態。請使用「effort」參數來控制思考深度、延遲時間及成本。.
這五項 API 任務是否已證明其可靠性?
不。這些卡片顯示的是具體的行為與配置限制,但僅憑五項任務無法估算整體的成功率。「編碼上限」問題與「中文路徑」問題已分別另行報告。.
這篇評論是否證明了中國產品的品質?
不。經測試的路徑回傳了亂碼的中文文字,因此將此結果記錄為編碼或路徑問題,待經確認的 UTF-8 重新執行後再行處理。.









