Claude 機型比較:Haiku 對比 Sonnet 對比 Opus,以及 Fable 的定位

claude-模型-比較-英雄

一份實用的 2026 年指南,內容涵蓋如何根據速度、API 成本、使用情境、任務複雜度以及錯誤答案的代價來進行選擇。.

對於大多數日常的寫作、分析、編碼及工具使用工作,請從 Claude Sonnet 5 開始。當低延遲與高處理量比處理棘手的邊緣案例更重要時,請選擇 Haiku 4.5。 當任務複雜、難以驗證,或出錯代價高昂時,請選擇 Opus 5。Fable 5.1 作為專門的升級路徑,地位高於 Opus,但並非預設選項。.

這些建議適用於一般的混合工作負載。Anthropic 的生產指南指出,大多數工作負載應從 Opus 5 開始,而其自身的任務矩陣則另行將 Sonnet 定位於日常需要速度與效能的工作。因此,合適的起點取決於您的風險承受能力與評估流程,而不僅僅取決於型號名稱。.

GlobalGPT 構成了更廣泛的工作流程 透過單一經濟實惠的訂閱方案即可輕鬆上手:Claude、GPT-5.6 Sol、Gemini 3 Pro、Kimi K3 以及多項 AI 功能,皆共享同一個儀表板,適用於研究、撰寫、分析、編碼及優化。 其命令列介面 (CLI) 還能將這些模型整合至您的終端機、開發工作流程及現有的生產工具中。比較輸出結果是工作流程中極具實用價值的一環;若需更廣泛的模型系列選擇,請參閱我們的 ChatGPT 與 Claude 與 Gemini 的比較. 本指南的其餘部分將著重於在 Claude 範圍內進行選擇。.

Claude 型號:快速解答

目前的四個層級旨在解決不同的經濟問題。最便宜的呼叫不一定代表最經濟的任務完成方式,而最強大的模型也不一定代表預算的最佳運用方式。.

Claude 型號選購指南

根據工作負載與故障成本進行選擇

在日常工作需要平衡表現時使用 Sonnet;若追求效率,則選擇較低階的規格;當驗證困難或錯誤代價高昂時,則升級至更高階的規格。.

俳句 4.5

效率至上

若要處理處理量大、對延遲敏感、範圍明確且錯誤檢測與修正成本低廉的任務,請從這裡開始。.

何時該向上移動邊緣案例或審查員的修正時間會抵銷代幣價格的優勢。.

第5首十四行詩

日常的平衡

適用於混合型寫作、分析、編碼、視覺理解及工具運用等作業,此類作業仍將接受常規評審。.

何時該向上移動長遠的推理、驗證或失敗成本便成為限制因素。.

作品第5號

能力至上

若您面臨複雜的行為編碼、企業級專案、棘手的診斷,或是一旦判斷錯誤便會造成重大損失的決策,請從這裡開始。.

在以下情況下向下移動一款較便宜的機型屢次通過相同的驗收測試。.

Fable 5.1

例外路徑

僅在需要複雜推理或代理程式執行時間過長,且投入更多資源的 Opus 仍無法通過您的評估時,才應將問題升級。.

不要妄下結論在考量品質、審查時間及重試次數後,較高的層級通常會自動更便宜。.

實務準則

選定一項具代表性的任務及其驗收檢查,並將其固定下來。選擇能穩定通過測試且成本最低的模型,然後計算修正與驗證所需的時間,再將其視為最經濟的方案。.

來源快照:Anthropic’s 選擇合適的型號 和 型號總覽, ,經 2026 年 9 月 8 日核實。Anthropic 指出,多數工作負載皆以 Opus 5 為起點;其任務矩陣另將 Sonnet 5 定位於日常工作,並將 Haiku 4.5 定位於最低延遲與最低價格。.

當前的 Claude 產品系列

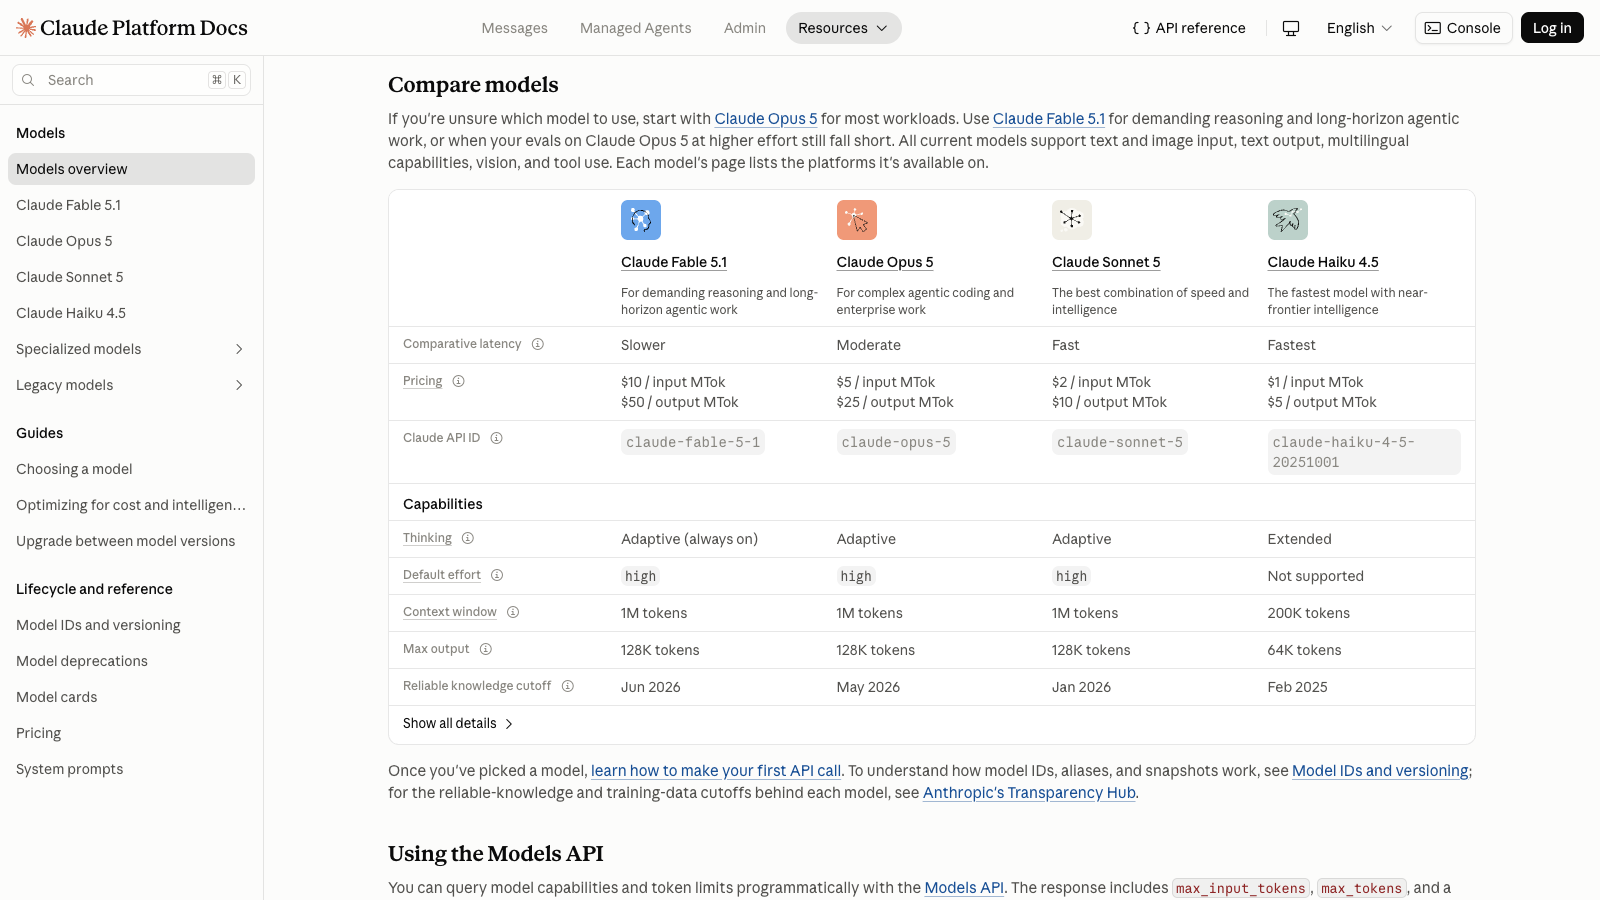
截至 2026 年 9 月 8 日,Anthropic 的現役產品線包含 Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5 以及 Claude Fable 5.1。 Haiku、Sonnet 和 Opus 雖是歷久不衰的產品系列名稱,但各系列所對應的版本會隨時間更迭。請務必標記您在生產環境中實際評估過的精確型號 ID,而非假設某個系列名稱永遠會對應到相同的快照。.

現行型號官方速度標示API 背景最大輸出基礎 API 輸入/輸出
俳句 4.5最快二十萬64K每 MTok 為 $1 / $5
第5首十四行詩快速1M128K每 MTok 為 $2 / $10
作品第5號適度1M128K每 MTok 為 $5 / $25
Fable 5.1較慢1M128K每 MTok 為 $10 / $50
Anthropic 當前 Claude 型號系列,包含定價、延遲、上下文及輸出限制
Anthropic 的型號概覽中列出 Haiku 4.5、Sonnet 5、Opus 5 以及 Fable 5.1,作為 2026 年 9 月 8 日當前的產品陣容。.

Claude.ai 的存取方式與 API 規格並不相同

Claude.ai 方案表說明了使用者存取權限,目前列出各方案的上下文視窗長度為 200K。API 文件列出了各模型的特定上下文與輸出限制,包括 Sonnet 5、Opus 5 及 Fable 5.1 的 1M 上下文長度。 請勿根據 API 方案表推斷特定 Claude.ai 方案的內容,亦請勿根據消費者方案表推斷 API 模型的限制。請參閱 Claude 定價與方案指南 關於計畫層級的區分。.

Claude Haiku 對比 Sonnet 對比 Opus:主要差異

主要的取捨並非單純的品質排名。隨著選用的模型等級提升,雖然能處理更複雜的工作,但基礎代幣成本也會隨之增加,且通常會降低處理速度。此外,上下文限制與推理控制機制也各不相同。.

實際上的權衡取捨

官方標籤與基礎 API 規格,搭配適用於常見工作負載的實用起點。.

維度俳句 4.5第5首十四行詩作品第5號
最佳起點快速、重複且受限的工作混合型日常知識工作複雜且影響重大的工作
官方速度標示最快快速適度
API 上下文/輸出200K / 64K1M / 128K1M / 128K
推理控制手動延伸思考適應性思維與努力適應性思維與努力
API 基準價格$1 輸入 / $5 輸出$2 輸入 / $10 輸出$5 輸入 / $25 輸出

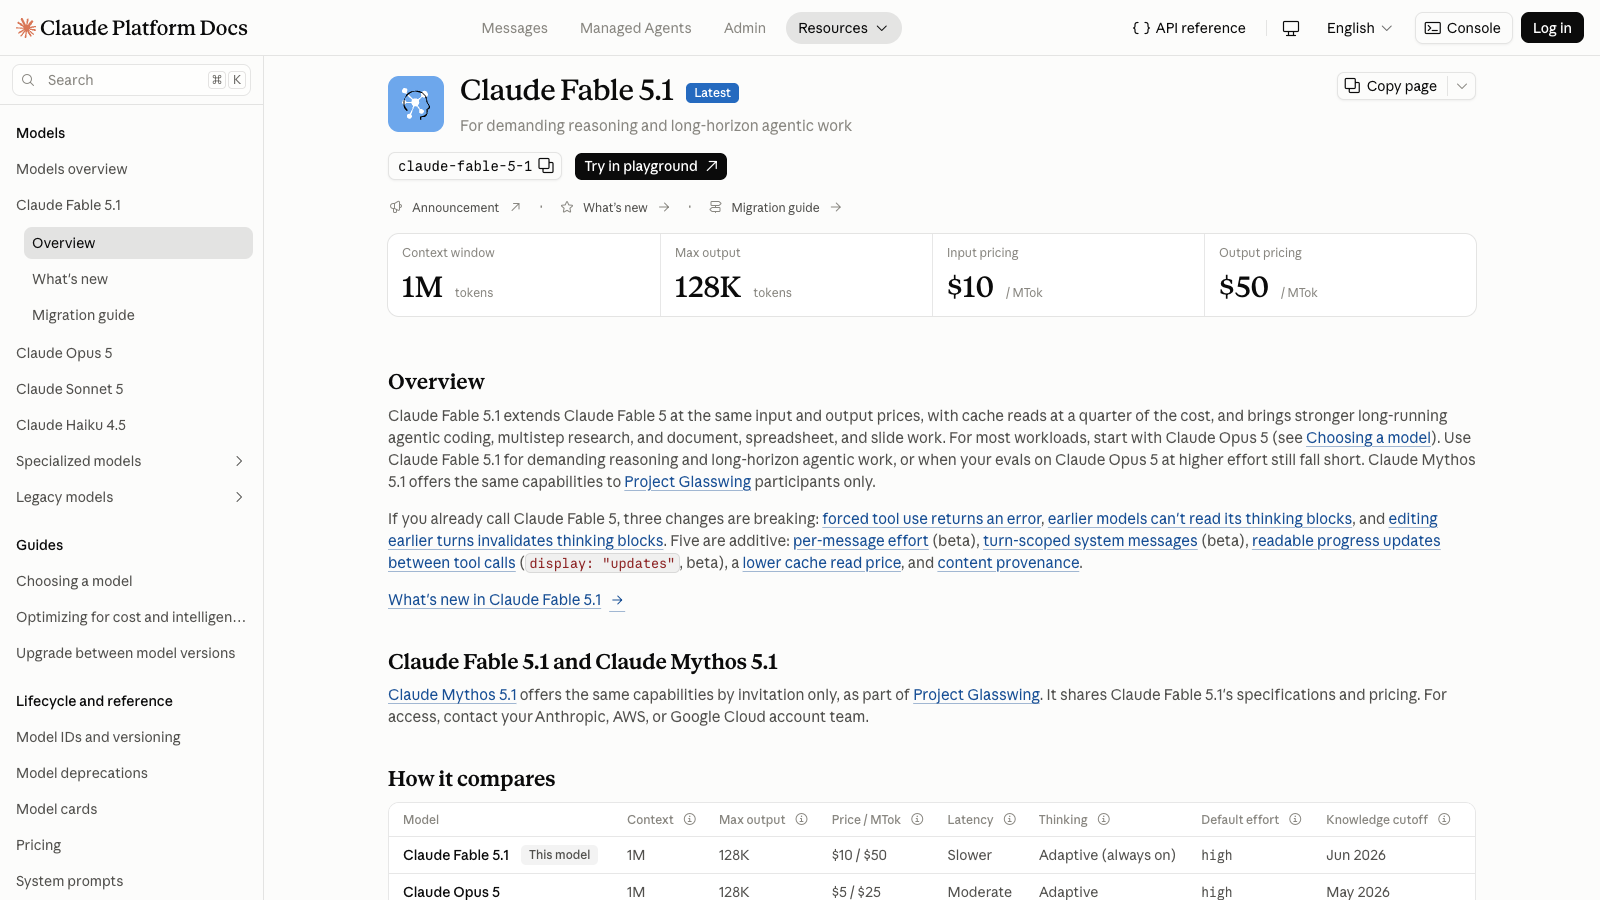
《Fable》適合哪些玩家: Fable 5.1 正式標示為「較慢」等級,具備 1M 上下文容量、128K 最大輸出量,並採用 $10 / $50 每百萬代幣的基礎輸入/輸出定價。當 Opus 在投入更多資源後仍無法通過您的評估時,請將其視為升級選項。.

速度與延遲

Anthropic 將 Haiku 4.5 標記為「最快」、Sonnet 5 標記為「快」、Opus 5 標記為「中等」,以及 Fable 5.1 標記為「較慢」。 這些是定性的產品標籤,並非以毫秒或每秒令牌數為單位的實測數值。實際延遲取決於請求大小、推理設定、工具、負載及服務模式。.

上下文、輸出與推理控制項

Haiku 較小的 200K API 上下文與 64K 最大輸出量,對於許多受限的任務而言仍相當可觀。 Sonnet 和 Opus 將這兩項限制分別擴展至 1M 和 128K。Haiku 4.5 採用手動擴展推理,而 Sonnet 5 和 Opus 5 則支援自適應推理與努力控制。這項差異正是為何單一且相同的推理設定,無法在所有模型上創建完全等效的測試之一。.

針對各項任務,您應該選用哪一款 Claude 型號?

工作量從以下開始:為何升級時
分類、提取、轉送、支援分流俳句 4.5低延遲與低基礎代幣成本,適合執行清晰且可重複的工作。.邊緣情況或校正時間會抵銷省下的成本。.
寫作、分析、視覺理解、日常編程第5首十四行詩在混合工作模式下,在速度、效能、情境與成本之間取得平衡。.長遠的推理或驗證便成了瓶頸。.
複雜的編碼、困難的診斷、自主代理作品第5號能力比每代幣的最低價格更為重要。.即使投入更多心力,Opus 仍未能通過一項嚴苛的代表性評估。.
極具特色、篇幅冗長或邏輯推演繁複的作品Fable 5.1這是 Opus 上方的當前升級路徑。.僅在所測得的效益足以抵銷其較高成本時才應採用。.

這些只是起點,並非放諸四海皆準的解決方案。舉例來說,對於短小但影響重大的程式碼變更,使用 Opus 或許是合理的選擇;而對於耗時較長但結構高度明確的程式碼提取任務,Haiku 可能依然是合適的選擇。如需實際工作流程的範例,請參閱我們的指南: 使用 Claude 進行編碼.

當您的候選清單超出 Claude 範圍時,GlobalGPT 可讓您在同一個工作區中,將相同的代表性提示語分別套用至 Claude、GPT-5.6 Sol、Gemini 3 Pro 以及 Kimi K3。 請保持接受標準一致:對於重複性工作而言,速度至關重要;而答案品質與修正時間則決定了低成本的結果是否真的更划算。.

應根據失敗的代價來選擇,而不僅僅是根據任務類型

「任務標籤」掩蓋了最重要的變數:當答案錯誤時會發生什麼事?下方的框架是一套基於 Anthropic「效率優先」與「能力優先」指引的編輯決策工具,並非 Anthropic 的基準。.

失效成本階梯

當偵測錯誤的成本較低時,應從較低的起始值開始;當驗證尚未完成或成本較高時,則應從較高的起始值開始。.

低成本

範例
標記、路由、草稿清理、可逆摘要

開始
俳句 4.5

升級
當修正時間抵消了效率提升時

材料

範例
面向客戶的草稿、經審核的分析報告、經過測試的生產代碼

開始
第5首十四行詩

升級
當審查無法可靠地發現重要錯誤時

昂貴

範例
高度自主性的變化、診斷困難、影響深遠的決策

開始
作品第5號

升級
僅在「Opus」耗費較多資源的評估失敗後,才會轉為「Fable」

何時該升級或降級您的 Claude 型號

僅在出現已量測的限值時才向上移動

俳句與十四行詩

當邊緣情況、指令遺漏或審閱者修正所需的時間超過所節省的時間時,應進行升級。.

獻給《Opus》的十四行詩

當執行週期較長、推理複雜、需進行驗證,或失敗成本成為限制因素時,應進行升級。.

Opus 在更高強度下

在移轉至最高層級之前,請先透過凍結的驗收檢查來測試高負載工作量。.

《Opus to Fable》

僅在耗費較多資源的 Opus 仍無法通過代表性評估,且收益足以抵銷成本時,才應將問題升級處理。.

降級規則: 當較便宜的機型能以符合要求的延遲和可靠性,反覆通過相同的驗收測試時,請改用該機型。.

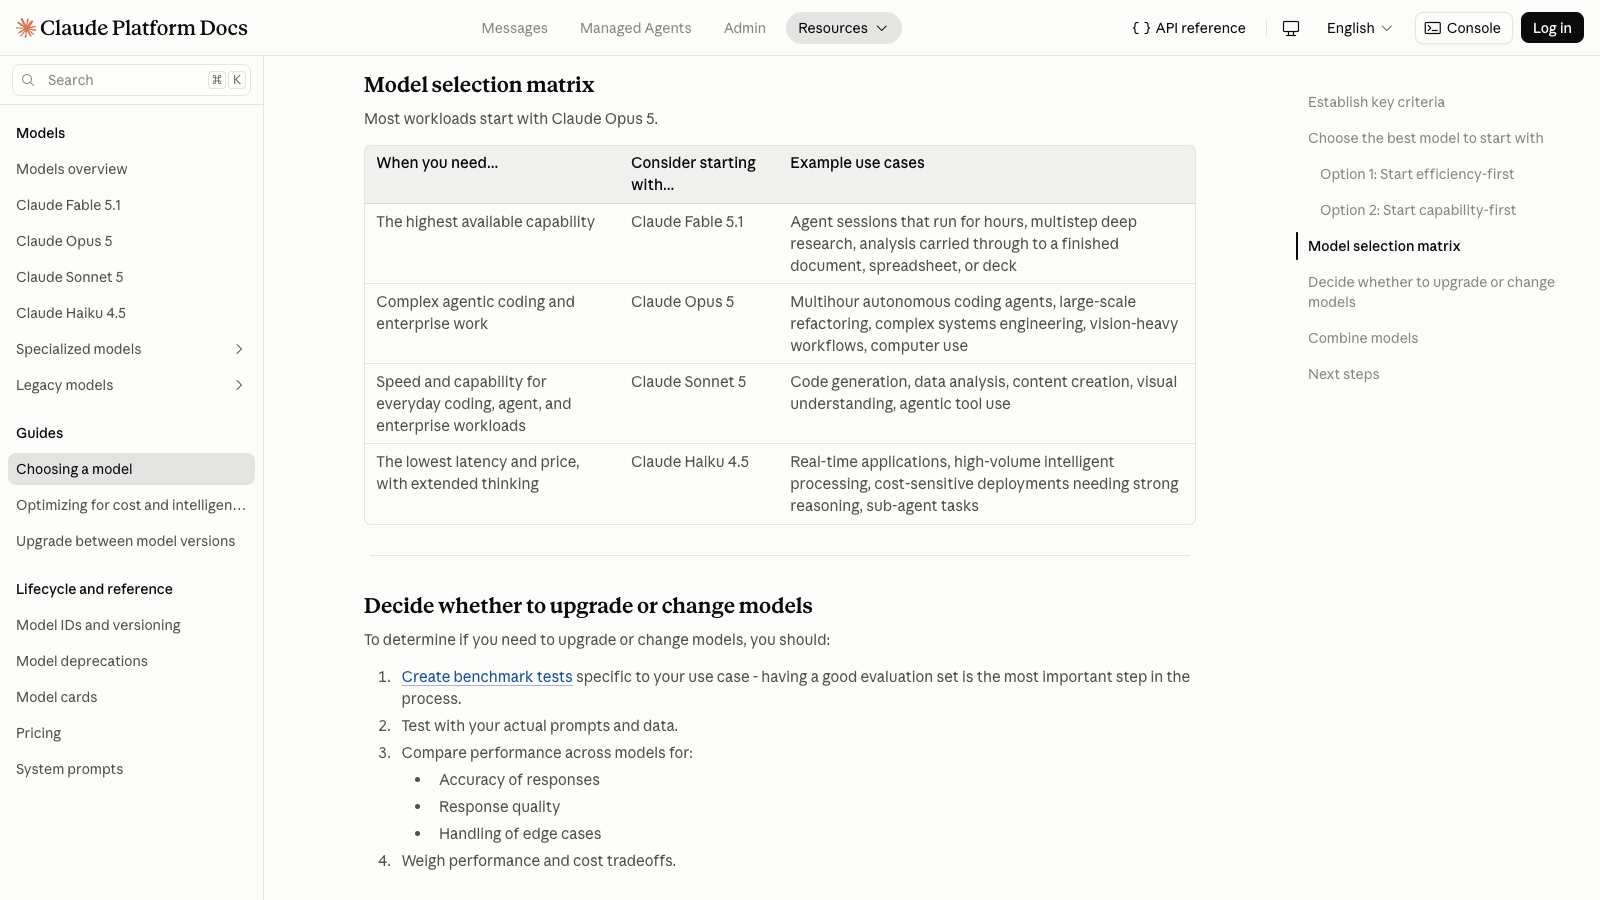
Haiku、Sonnet、Opus 和 Fable 的 Anthropic 模型選擇矩陣
Anthropic 的矩陣將四款現有的 Claude 機型,對應至不同的效能、速度及工作負載需求。.

一個固定 Claude API 費用的範例

針對橫跨多個標準 API 請求、總計 100 萬個輸入代幣加上 10 萬個輸出代幣的固定總工作負載,基礎代幣成本範圍從 Haiku 4.5 的 $1.50 到 Fable 5.1 的 $15.00 不等。 這並非單一請求,且不會凌駕於每請求的輸出限制之上。.

單一工作負載,四台 Claude 機型

隨著您在當前等級中晉升,相同代幣的數量所需成本將分別為 Haiku 總量的 2 倍、5 倍或 10 倍。.

工作量
1.0M 輸入 + 0.1M 輸出
橫跨多個請求
模型輸入計算輸出計算總計
俳句 4.51.0 × $10.1 × $5$1.50
第5首十四行詩1.0 × $20.1 × $10$3.00
作品第5號1.0 × $50.1 × $25$7.50
Fable 5.11.0 × $100.1 × $50$15.00

包含: 根據一個 Anthropic 價格快照得出的標準基準輸入與輸出代幣匯率。.

不包括: 提示緩存、批次 API、快速模式、地理位置、工具費用、稅金、折扣以及 GlobalGPT 點數。.

Anthropic 的每百萬代幣美元基準利率 模型定價, ,經 2026 年 9 月 8 日核實。Sonnet 5 的 $2 輸入/$10 輸出費率為標準定價。.

價格表列出的是代幣的成本,而非最終成果的成本。若重試、修正及驗證所耗費的人力時間,超過因使用代幣所節省的成本,那麼原本較便宜的方案反而可能變得更昂貴。.

實作 Claude 模型測試:相同提示,不同失敗模式

2026年9月9日,我們透過 Anywhere API 將相同的三个提示語傳送至 Claude Haiku 4.5、Sonnet 5、Opus 5 以及 Fable 5.1。 這些任務涵蓋了結構化支援分流、以證據為導向的寫作,以及可稽核的 JavaScript 除錯。我們保留了每個模型的第一個有效輸出,並依據在審閱回覆前已凍結的規則進行評估。.

結果並非單純的排名。Sonnet、Opus 和 Fable 的得分均為 30 分中的 26.5 分,但三者的優勢與不足卻截然不同。Haiku 在每項任務的兩次允許嘗試中均返回 HTTP 503 錯誤,因此本次測試中其輸出品質仍屬未知。.

測試設定與整體結果

三個凍結的提示詞、相同的任務層級代幣限制、不允許使用工具或搜尋功能,且每個模型僅保留第一個有效的輸出結果。.

活動地點Anywhere API
日期2026年9月9日
任務結構化分流、啟動筆記、JavaScript 除錯
重試規則傳輸時發生一次錯誤,代碼 429/5xx,內容為空,或回應格式錯誤
模型已完成的任務總品質分數最有用的訊號
克勞德俳句 4.50/3未計分所有六項獲准的請求均返回 503 錯誤;僅限路由可用性。.
克勞德·索內特 第五首3/326.5/30唯一一款完全符合所有發佈說明要求的機型。.
Claude Opus 53/326.5/30除錯深度足夠;遺漏了一項寫入長度限制。.
Claude Fable 5.13/326.5/30結構化的輸出結果清晰;啟動筆記在出現一個空回應後被截斷。.
這三個被評分的模型均以 26.5/30 分並列,但原因各不相同。這是針對特定任務的評分結果,並非通用模型排名。Haiku 未被列入並列名單,因為其沒有可供評分的輸出結果。.

結構化輸出

測試 1:支援單分類處理

任務結果:Fable 5.1,10/10

在所有模型中,唯有 Fable 能直接回傳可解析的 JSON 格式,且其中六項標籤與操作皆正確無誤。Opus 和 Sonnet 雖然標籤正確,但添加了 Markdown 圍欄;兩者皆強化了其中一個既定的截止期限,而 Sonnet 則過早承諾會進行修正或退款。.

模型狀態得分任何地點的延遲已通報的代幣發生了什麼事
克勞德俳句 4.5路線不可用未計分不可用不可用兩則 503 回應;無品質分數。.
克勞德·索內特 第五首保留輸出內容7.5/1010.39 秒1005標籤雖正確,但 JSON 格式被封裝,且退款/更正結果為虛構。.
Claude Opus 5保留輸出內容8.5/1011.87 秒1051標籤正確且採取了強力措施,但採用了封裝的 JSON 格式,並加強了截止期限。.
Claude Fable 5.1保留輸出內容10/108.55 秒680可直接解析的 JSON;所有凍結檢查均通過。.
完整的測試輸入
您負責管理一個 SaaS 支援信箱。 請將以下每張工單進行分類。回傳的 JSON 僅需包含一個名為 `tickets` 的頂層欄位。`tickets` 必須是依原始順序排列的陣列,且每個項目必須精確包含 `ticket_id`、`category`、`urgency` 及 `action` 四項資料。`category` 必須為 `billing`、`access`、`bug` 或 `feature` 之一;`urgency` 必須為 `low`、`medium` 或 `high` 之一。 僅使用工單內容;請勿杜撰政策結果或客戶事實。

#481:同一筆年度續約費用被重複收取。薪資結算期為週五,我需要在此之前查明此事。
#482:密碼重設頁面顯示已寄送電子郵件,但未收到任何郵件。我已檢查垃圾郵件匣並重新嘗試一次。
#483:CSV 匯出檔會將所有貨幣金額四捨五入至整美元,但儀表板仍顯示分。
#484:請在分析儀表板上新增深色模式。
#485:今早本公司網域變更後,每位員工都收到單一登入(SSO)存取遭拒的訊息。
#486:能否請您寄送上個月的發票副本給我?
Claude Haiku 4.5:完整營運成果
未產生任何模型輸出。兩次對 Anywhere API 的嘗試均返回 HTTP 503 狀態碼,因此此路徑被標記為不可用,並從品質評分中排除。.
Claude Sonnet 5:全輸出
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "類別": "帳單",
 "緊急程度": "高",
 "行動": "調查重複的年度續約費用,並在客戶本週五薪資結算截止前完成更正/退款。"
    },
    {
 "ticket_id": "#482",
      "類別": "存取權限",
 "緊急程度": "中等",
 "處理方式": "驗證該帳戶的電子郵件地址及郵件送達狀況,然後手動觸發或重新發送密碼重設郵件。"
    },
    {
 "ticket_id": "#483",
      "類別": "錯誤",
 "緊急程度": "中等",
 "處理方式": "將問題升級至工程團隊,以修正 CSV 匯出時的四捨五入問題,確保貨幣數值與儀表板上顯示的分位精確度相符。"
    },
    {
 "ticket_id": "#484",
 "category": "功能",
 "urgency": "低",
 "action": "記錄分析儀表板的深色模式需求,並將其加入產品功能待辦清單。"
    },
    {
 "ticket_id": "#485",
      "類別": "存取權限",
 "緊急程度": "高",
 "行動": "立即調查與變更後公司網域相關的 SSO 配置,並為所有受影響的員工恢復存取權限。"
    },
    {
      "ticket_id": "#486",
 "category": "billing",
 "urgency": "low",
 "action": "找出上個月的發票,並將副本寄送給客戶。"
    }
  ]
}
```
Claude Opus 5:全輸出
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "帳單",
 "urgency": "高",
 "action": "將此問題升級至計費部門,以核實重複的年度續約費用,並在客戶本週五薪資結帳截止前確認已解決。"
    },
    {
 "ticket_id": "482",
      "category": "存取權限",
 "urgency": "中等",
 "action": "檢查電子郵件傳送記錄,確認寄送至該地址的重設通知是否送達;若未送達,則為該使用者觸發經驗證的重設流程。"
    },
    {
 "ticket_id": "483",
      "類別": "錯誤",
 "緊急程度": "中等",
 "行動": "針對 CSV 匯出貨幣四捨五入問題提交錯誤報告,註明與儀表板數值不符之處,並要求提供重現步驟或匯出範例。"
    },
    {
 "ticket_id": "484",
 "category": "功能",
 "urgency": "低",
 "action": 「將此問題記錄為分析儀表板的深色模式功能請求,並確認已收到,但不承諾具體時程。」
    },
    {
 "ticket_id": "485",
      "category": "存取權限",
 "urgency": "高",
 "action": "將此問題升級為與網域變更相關的全組織單一登入(SSO)中斷事件;請身分識別/認證團隊立即審查 SSO 網域設定。"
    },
    {
      "ticket_id": "486",
 "category": "billing",
 "urgency": "low",
 "action": "將所要求的上月發票副本寄送給已驗證的帳戶聯絡人。"
    }
  ]
}
```
Claude Fable 5.1:全輸出
{"tickets":[{"ticket_id":"481","category":"帳單","urgency":"高","action":"調查所通報的年度續約費用重複收費問題,並在客戶週五的發薪截止期限前予以回覆。"},{"ticket_id":"482","category":"存取權限","urgency":"中等","action":"檢查該用戶密碼重設電子郵件的送達記錄,確認其信箱地址,並重新寄送或提供其他重設途徑。"},{"ticket_id":"483","類別":"錯誤","緊急程度":"中等","動作":"重現 CSV 匯出時貨幣金額被四捨五入至整美元的狀況,並向上級工程團隊通報以進行修復。"},{"票證編號":"484","類別":"功能","urgency":"low","action":"將分析儀表板的深色模式需求記錄並轉交產品團隊,同時確認已收到該需求。"},{"ticket_id":"485","category":"access","urgency":"high","action":"將因網域變更而導致的全公司範圍 SSO 存取遭拒錯誤上報,並檢視 SSO 網域設定。"},{"ticket_id":"486","category":"billing","urgency":"低","action":"查找並將上個月的發票副本寄送給客戶。"}]}

「首次有效輸出」政策。延遲時間指經由 Anywhere 的實際時間,而非原生 Anthropic 延遲。代幣計數由服務供應商回報;無法由此路由推斷出直接的 API 成本。.

約束跟隨

測試 2:以證據為導向的發布說明

任務結果:Sonnet 5,10/10

Sonnet 是唯一一款能滿足所有「凍結」要求的模型。Opus 產出了內容充實的說明,但超出了字數限制,並推斷所有未回應者皆為在籍學生。Fable 的首次回應為空;其允許的重試則返回了一則明顯被截斷的說明,其中未包含任何建議或注意事項。.

模型狀態得分任何地點的延遲已通報的代幣發生了什麼事
克勞德俳句 4.5路線不可用未計分不可用不可用兩則 503 回應;無品質分數。.
克勞德·索內特 第五首保留輸出內容10/109.94 秒796已符合「字數範圍」、「結構」、「證據」、「建議」及「注意事項」等要求。.
Claude Opus 5保留輸出內容8/109.49 秒826分析縝密,但採用「固定字數計數法」後仍少223個字,且有一處缺乏依據的推論。.
Claude Fable 5.1保留輸出內容6.5/1019.27 秒1685首次回應為空;保留的重試內容在建議與注意事項之前即被截斷。.
完整的測試輸入
請根據以下事實,為產品總監撰寫一篇 180 至 220 字的內部發布備忘錄。內容須包含:主旨、簡短的開頭段落、精確三項要點、一項建議,以及一項標示明確的注意事項。請勿杜撰預算決議、百分比、統計顯著性或因果關係。

事實:
- 該試點計畫共招募了 120 名學生。
- 截至 3 月 31 日的進度檢查點,已有 96 名學生參加了至少三場課程。
- 71 名受訪者的問卷評分平均為 4.3 分(滿分 5 分)。
- 計畫運作表列出的預算為 $18,000。
- 財務核准備註列出 $20,000。未說明此差異是經修訂所致,還是記錄錯誤。
- 參與者並非隨機分組,且未蒐集基線分數。
- 決策重點在於是否啟動第二輪試行計畫,而非是否正式推行。.
Claude Haiku 4.5:完整營運成果
未產生任何模型輸出。兩次對 Anywhere API 的嘗試均返回 HTTP 503 狀態碼,因此此路徑被標記為不可用,並從品質評分中排除。.
Claude Sonnet 5:全輸出
**主旨:試行計畫成果 — 建議推進第二階段試行**

首輪試行計畫已完成第一個階段性評估期,初步的參與度與滿意度指標均相當令人鼓舞。在決定是否展開第二階段試行之前,團隊應共同檢視以下幾項數據與待處理事項。

- 截至 3 月 31 日的檢點期,在 120 名註冊學生中,有 96 人至少參加了三場課程。
- 71 名受訪者填寫的課後問卷,平均評分達 4.3 分(滿分 5 分)。
- 各文件中的預算數字不一致:計畫運作表列出 $18,000,而財務核准備註則列出 $20,000;目前尚不清楚這是否反映了修訂或記錄錯誤。

**建議:** 鑒於出席率及問卷調查結果,我們建議先進行第二輪試點計畫,以蒐集更系統化的數據——理想情況下應包含明確的對照組與基線測量——再考慮是否進行更廣泛的推行。這第二輪試點計畫亦應作為在資金最終確認前,與財務部門核對預算差異的契機。

**注意事項:** 應謹慎解讀這些結果。由於參與者並非隨機分配,且未收集基線分數,因此我們無法將問卷調查結果或出席模式歸因於該計畫本身。此為針對第二輪試行計畫的範圍界定決策,而非關於永久實施的決策。.
Claude Opus 5:全輸出
**主題:試行計畫結果及關於第二批試行對象的建議**

首輪試行計畫已完成 3 月 31 日的階段性評估,目前我們已掌握足夠資訊,可據此決定是否進行第二輪試行。本備忘錄概述了我們的觀察結果、相關建議,以及解讀時的主要限制。 現階段尚未就正式推行一事作出任何決定。

- **報名與參與度:** 共有 120 名學生報名。截至 3 月 31 日的階段性評估,其中 96 人至少參加了三場課程。
- **參與者回饋:** 根據 71 位受訪者的回覆,參與後問卷調查的平均分數為 4.3 分(滿分 5 分)。其餘已註冊學生未回覆問卷,因此該分數僅反映該子群體的意見。
- **預算差異:** 計畫運作表列出的預算為 $18,000,而財務核准備註則列為 $20,000。 財務備註未說明此差異是經修訂所致,還是記錄錯誤,且我們尚未釐清應以哪一數字為準。

**建議:** 繼續規劃第二輪試點計畫,但須以財務部門與計畫運作部門核對兩項預算數字,並在我們承諾支出前確認單一有效數字為前提。 第二次試點計畫亦應在參與者入組時收集基線分數。

**注意事項:** 參與者並非隨機分組,且未收集基線分數。因此,參與度與問卷調查數據僅描述該群體的行為及回報內容;無法告訴我們該計畫產生的效果,亦無法說明該計畫在不同受眾群體中的表現。.
Claude Fable 5.1:全輸出
**主旨:** 試行計畫檢查點摘要及第二階段試行建議

您好,[主任],

以下是截至 3 月 31 日檢查點時,試行計畫現況的摘要,以及關於是否應推進至第二階段試行的建議。本備忘錄僅針對第二階段試行的決策,不涉及正式推行事宜。

- **報名與出席情況:** 共有 120 名學生報名。截至 3 月 31 日評估點,其中 96 名學生至少出席了三場課程。
- **參與者回饋:** 問卷調查顯示,71 名受訪者的平均評分達 4.3 分(滿分 5 分)。
- **預算紀錄:** 計畫運作表列出的預算為 $18,000,而財務核准備註則列為 $20,000。該財務備註未說明此差異係屬修正或記錄錯誤。

**

「首次有效輸出」政策。延遲時間指經由 Anywhere 的實際時間,而非原生 Anthropic 延遲。代幣計數由服務供應商回報;無法由此路由推斷出直接的 API 成本。.

程式碼正確性

測試 3:可稽核的 JavaScript 除錯

任務結果:Opus 5 與 Fable 5.1 並列第一,10/10

三款可用的模型均發現了缺陷,並產出了能通過八個可執行案例的替代方案。Opus 和 Fable 回傳了有效的 JSON,並以 10/10 的成績並列第一。Sonnet 的程式碼雖然也通過測試,但周圍的 Markdown 圍欄違反了「直接 JSON」的要求。.

模型狀態得分任何地點的延遲已通報的代幣發生了什麼事
克勞德俳句 4.5路線不可用未計分不可用不可用兩則 503 回應;無品質分數。.
克勞德·索內特 第五首保留輸出內容9/1013.17 秒1471替代方案通過了 8/8 個案例;帶有圍欄的輸出則在 JSON 格式這一點上失分。.
Claude Opus 5保留輸出內容10/1020.17 秒1826JSON 格式有效,已識別出所有缺陷,且 8 個可執行案例全數通過。.
Claude Fable 5.1保留輸出內容10/1015.89 秒1409JSON 格式正確、診斷簡明扼要,且 8 個可執行案例全數通過。.
完整的測試輸入
請診斷並修復此 JavaScript 函式。僅回傳包含精確四個欄位的 JSON:root_cause(字串)、replacement(包含完整替換函式的字串)、tests(測試案例字串的陣列)以及 remaining_risk(字串)。請勿聲稱已執行測試。請提供最簡潔且符合合約要求的修復方案。

合約:
- `tasks` 是一個由零參數函式組成的陣列,這些函式會傳回 Promise。
- 依輸入順序回傳第一個已履行(fulfilled)的值,即使該值為 0、false 或空字串亦然。
- 忽略被拒絕(rejected)的任務。
- 當所有任務均被拒絕或陣列為空時,回傳 null。

目前程式碼:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5:完整營運成果
未產生任何模型輸出。兩次對 Anywhere API 的嘗試均返回 HTTP 503 狀態碼,因此此路徑被標記為不可用,並從品質評分中排除。.
Claude Sonnet 5:全輸出
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5:全輸出
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1:全輸出
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const first = results.find((result) => result.status === 'fulfilled');\n  return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}

「首次有效輸出」政策。延遲時間指經由 Anywhere 的實際時間,而非原生 Anthropic 延遲。代幣計數由服務供應商回報;無法由此路由推斷出直接的 API 成本。.

這些 Anywhere 的結果顯示,為何模型選擇應依據任務本身,而非僅參考單一排行榜。在 GlobalGPT 中,您可以將相同的比較方法應用於您自己的提示詞,並將其與 Claude 及其他領先模型進行對比,進而選擇最符合您的品質標準、速度需求及審核工作量的輸出結果。.

如何公平地重現這項比較

  1. 將一項具代表性的任務凍結。. 請採用相同的意圖、原始資料、工具存取權限,以及目標接受性檢查。.
  2. 記錄第一個有效的輸出結果。. 請勿在主要比較中,悄悄地讓某個模型獲得額外的重試次數。.
  3. 將品質與可用性區分開來。. 驗證、容量及路由故障應列於可用性說明中,而非品質分數中。.
  4. 測量整個工作流程。. 計算已耗費的時間、審閱人員所投入的工時、修正時間,以及任務失敗後的恢復時間。.
  5. 選擇最便宜的通過模型。. 當提示、工具、模型版本或失敗成本發生變更時,請重新進行測試。.

GlobalGPT 的定位

關於何時應選擇 Claude Fable 5.1 而非 Opus 5 的 Anthropic 指引
當更高難度的 Opus 5 評估仍無法滿足需求時,Anthropic 便能勝任 Fable 5.1 的嚴苛任務。.

若想更深入了解高階產品,請繼續瀏覽我們的 進階 Claude 模型比較 或探索專屬的 Claude Fable 5.1 指南.

常見問題

目前有哪些 Claude 型號?

截至 2026 年 9 月 8 日,Anthropic 的現役產品陣容包含 Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5 以及 Claude Fable 5.1。 確切的版本與型號 ID 可能會有所變動,因此在部署前請務必再次查閱官方型號概覽。.

Claude Haiku、Sonnet 和 Opus 之間有什麼區別?

Haiku 著重速度與低基礎代幣成本;Sonnet 則在速度與處理能力之間取得平衡,適用於日常工作;而 Opus 則著重處理能力,適用於複雜或影響重大的任務。正確的選擇取決於您的工作負載與驗證成本,而非絕對排名。.

對於大多數任務,我應該使用哪一款 Claude 型號?

對於大多數日常的寫作、分析、程式設計、視覺理解及工具應用工作,建議先使用 Sonnet 5。若失敗代價高昂,或工作需要更深入的推理與更嚴格的驗證,則建議改用 Opus 5。.

哪一款 Claude 型號最適合編碼?

Sonnet 5 是日常編碼的實用起點,可配合常規審查與測試。若需進行困難的診斷、複雜的代理編碼、長時程執行,或是可能因錯誤而造成高昂代價的變更,請使用 Opus 5。.

哪一款 Claude 機型最適合書寫?

Sonnet 5 是大多數起草與編輯工作的均衡起點。Haiku 4.5 適合處理篇幅龐大且結構嚴謹的文本,而對於難以整合或難以驗證的重要內容,則值得試用 Opus 5。.

Claude Sonnet 是否比 Opus 更好?

並非絕對如此。以基礎 API 費率而言,Sonnet 5 速度更快且成本更低,而 Anthropic 則讓 Opus 5 能處理更複雜的工作。較佳的模型,就是能可靠通過您自身驗收測試,且價格最低的選項。.

Claude Fable 是否正在取代 Opus?

第 Anthropic 將 Fable 5.1 定位為當工作量較大的 Opus 5 仍無法滿足需求時,用於處理複雜推理或長期運行的代理任務的升級層級,而非 Opus 的通用替代方案。.

Claude.ai 與 Claude API 的語境視窗是否相同?

Claude.ai 方案的限制與 API 模型規格是分開的。Anthropic 的個別方案表目前列出 200K 的上下文視窗,而 API 文件則列出 Sonnet 5、Opus 5 及 Fable 5.1 的上下文大小為 1M。.

我應該在什麼時候從 Haiku 升級到 Sonnet 或 Opus 呢?

當驗收檢查失敗、棘手的邊界案例、修正時間、驗證工作量或錯誤成本,其總和超過較低階模型在速度與代幣價格上的優勢時,應進行升級。當較低成本的模型能反覆通過相同的凍結檢查時,則應降回原模型。.

透過 API 調用,Claude Haiku、Sonnet 和 Opus 的費用分別是多少?

根據 2026 年 9 月 8 日驗證的 Anthropic 基準費率,Haiku 4.5 的輸入成本為 $1,輸出成本為 $5;Sonnet 5 的輸入成本為 $2,輸出成本為 $10; 而 Opus 5 每百萬個代幣的成本分別為 $5 和 $25。詳見 Anthropic 的 官方定價頁面 欲了解現行費率及其他計價方式。.

最終結論:從最便宜且符合標準的型號開始

對於一般混合型作業而言,Sonnet 5 仍是實用性最高的預設選擇,且它是我們測試中唯一通過所有啟動註解限制的機型。 Opus 5 和 Fable 5.1 憑藉各自的優勢,總分均與 Sonnet 的 26.5/30 持平;而 Haiku 4.5 則無法評分,因為每次允許的嘗試中,「Anywhere」路徑均返回 503 錯誤。請將這些結果視為工作負載的參考依據,而非永久性的通用排名。.

接下來的步驟很簡單:選定一項實際任務,定義何謂「通過」的標準,在可比條件下測試每個有力的候選模型,並將修正時間納入最終成本計算。最終勝出的模型,應是成本最低且能穩定通過測試的那個,而非代幣率最低或層級名稱最響亮的模型。.

GlobalGPT 將該方法整合至更廣泛且經濟實惠的人工智慧工作流程中。 您可在單一儀表板中使用 Claude、GPT-5.6 Sol、Gemini 3 Pro、Kimi K3 及其他具備多項 AI 功能的頂尖模型,並透過 GlobalGPT CLI 將工作整合至您的終端機、開發工作流程及現有生產工具中。 並行測試有助於您做出選擇;而更大的優勢在於能保持完整工作流程的連貫性。.

分享文章:

相關文章