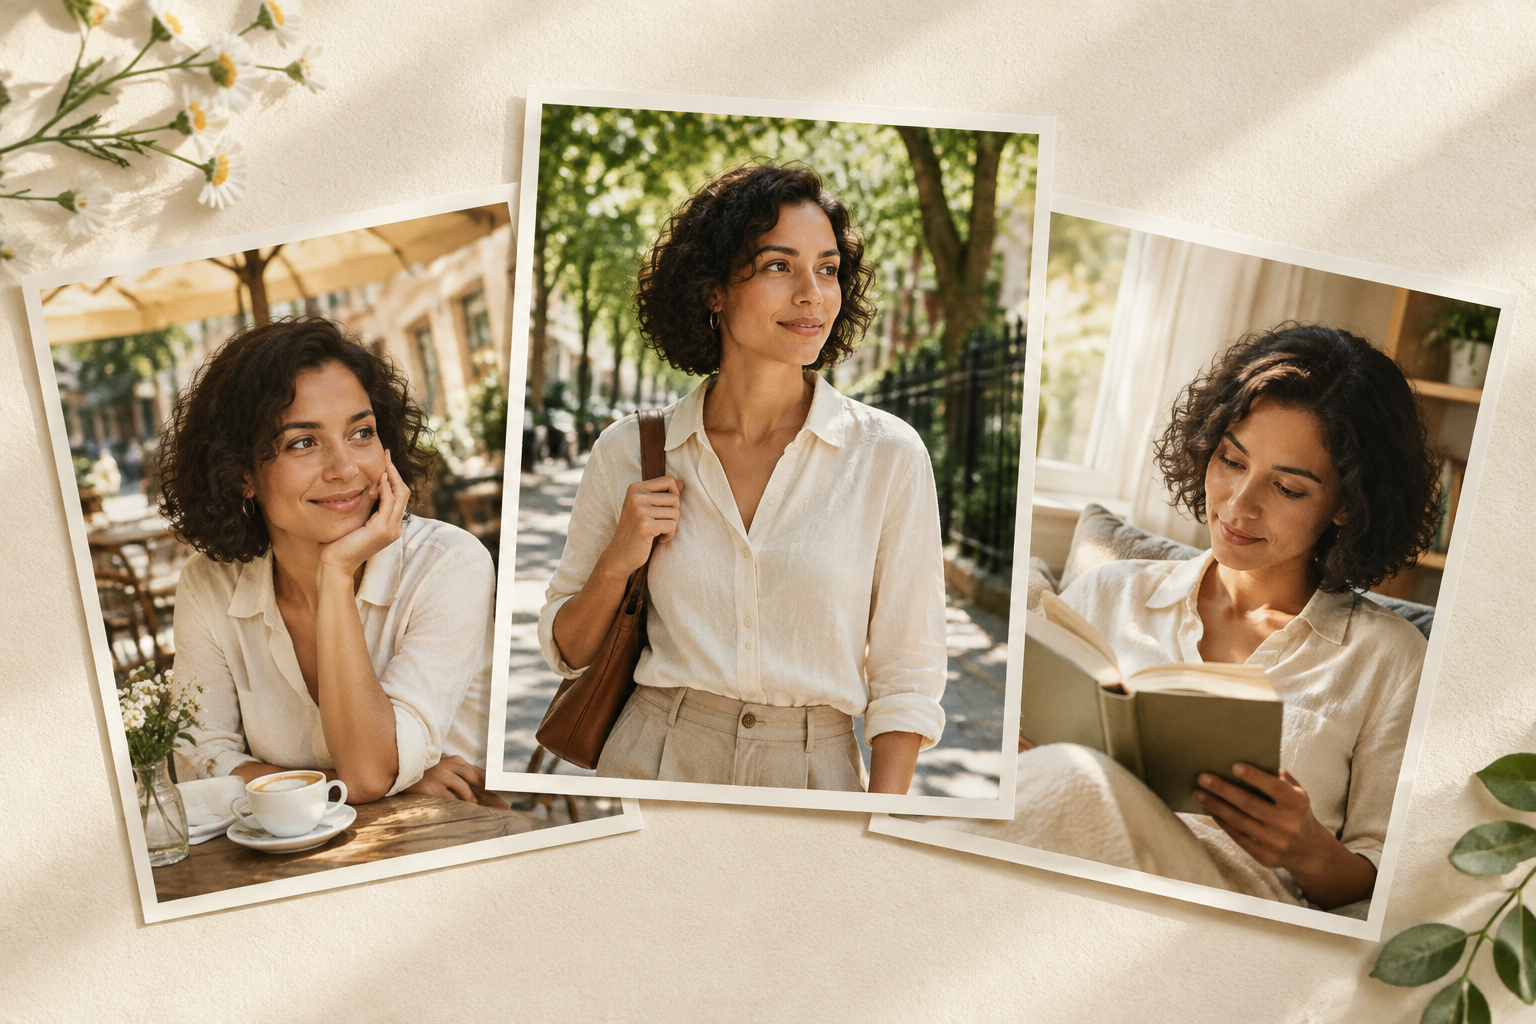
AI 隨拍風格的攝影作品之所以成功,在於這些影像必須讓人感覺像是某個人生活中的片段,而非六張互不相關的肖像照。要達到這種效果的可靠方法是:先確立一套簡潔的個人風格框架,然後每次只改變一個主要變因:地點、姿勢、服裝或構圖。.
GlobalGPT 對於此工作流程非常實用,因為其影像工作區讓您能以參考影像為起點,並隨著工作需求變化在不同的影像模型之間切換。您可以 使用 Nano Banana 2 創作一套攝影系列, 接著在檢視每一幀時,請維持相同的提示與參考資料。.
一場 AI 照片大放送的攝影棚拍攝需要什麼
「照片合集」是一組經過精心搭配的社群媒體圖片。其中可能包含一張精心修飾的人像照、一張看似自然的場景照、一張特寫鏡頭,以及一張更廣角的環境全景照。這組照片無需固定張數,但必須具備可辨識的主體、刻意營造的變化,以及一貫的視覺節奏。.
有用的定義
所謂的「AI 照片合集」,是指透過數張以同一主題拍攝的照片來講述一個小故事,這些照片既要有足夠的變化,讓人感覺生活化;同時也要有足夠的連貫性,讓人感覺是經過刻意安排的。.
針對每個生成的集合,依據以下四個基準進行審查:
- 身分: 臉型、髮型、膚色、眼色、身體比例,以及一兩處小斑點。.
- 衣櫥: 對於「身份錨點」而言,哪些部分是固定不變的,哪些部分則是刻意允許改變的。.
- 場景與光線: 每幀畫面中,光線的位置、時間以及方向都應一目瞭然。.
- 社會框架: 裁切後的圖片應呈現出可直接發佈的樣貌,並為您計畫使用的平台預留足夠的留白空間。.
為什麼同一個人會出現在多張 AI 生成的照片中?
影像模型能同時解決多個視覺問題。當提示語同時改變人物、服裝、地點、姿勢、鏡頭角度和光線時,模型就有更多機會以某個身份特徵來換取另一個。一套新服裝可以改變輪廓;側面輪廓會改變鼻型和下巴的視覺效果;而從鏡子中裁切的特寫畫面,則能讓臉上的小瑕疵消失。.
這並不表示你應該讓每張照片都一模一樣。這意味著你應該將變數分開處理。首先製作一張可靠的基準照片。接著在保持人物與服裝不變的前提下,變換場景;接著在保持人物特徵不變的前提下,變換服裝;最後嘗試近距離裁切或鏡像效果,因為在這些情況下,細微的瑕疵會更容易被察覺。.
Google 的圖像生成指引遵循相同的實用邏輯:明確指出必須保持一致的部分、使用參考圖片,並在重要細節出現偏差時進行迭代。若要了解更深入的參考照片工作流程,請參閱這份指南: 在不同場景中保持角色的一致性.
在產生之前,先建立一個小型參考資料包
您無需龐大的訓練資料集來測試此工作流程。請先從一個特徵鮮明的虛構成人角色開始,並選用一張未經強烈濾鏡處理、能清晰展現臉部、髮型、膚色及上半身比例的參考圖片。僅在獲得授權且有明確理由的情況下,才可使用真實人物的肖像。.
- 建立一個身份錨點。. 請使用均勻的光線、素色背景、中性表情,並將畫面裁切得能清楚呈現臉部與頭髮。.
- 請將該恆等式包寫下來。. 請用淺顯易懂的語言描述頭髮顏色、膚色、眼色、顯著特徵、耳環以及身體比例。.
- 請選擇第一個受控變更。. 要辨識一家新開的咖啡館,比同時辨識一個新潮流、一套新服裝、一個新時代和一種新髮型來得容易。.
- 搭建場景前請先檢查。. 如果第一個成果改變了臉部造型,或是設計出會分散注意力的配件,請在拍攝更多畫面之前先修正這個變數。.
在 GlobalGPT 中,參考影像路徑是將此套件從一個影像傳輸至下一個影像的實用途徑。若工作內容以直式影像為主,這份配套指南將能協助您 撰寫更優質的 AI 人像攝影提示語 用於光線、構圖及面部細節。.
使用「什麼保留/什麼改變」的引導問題
可複製的提示模式
請先列出識別錨點。接著說明單一變更。最後說明攝影機與畫質限制。.
顯示完整圖案
請根據所附的參考圖片,為同一位虛構成年女性創作一張逼真的方形社群媒體照片。請保留她的臉部、及肩深棕色鮑伯頭、溫暖的橄欖色肌膚、棕色眼睛、左眼下方的美人痣、身體比例、銀色圈形耳環,以及 [固定服裝]。僅可變更 [一項主要變數]。 場景:[地點]、[姿勢]、[光線]、[鏡頭構圖]。肌膚質感需自然,構圖需符合裁切安全範圍,不得出現文字或標誌。.「僅變更」這個詞組雖非魔法,卻能讓驗收測試更為清晰。你可以藉此確認模型是否確實僅變更了場景,而非在背後悄悄地也變更了人物。.
首次產出測試的結果顯示
我使用了一個合成成人角色,並在 GPT Image 2.5 以及 Nano Banana 2 in GlobalGPT 上輸入了相同的三个提示詞。 每個模型都接收了相同的參考圖像,並針對三項任務各產生一個初始輸出:穿著固定服裝的雨中咖啡廳場景、更換服裝後的黃金時刻屋頂場景,以及酒店浴室鏡面裁切畫面。過程中未採用「最佳 N 張」篩選或穩定性重複測試。.
測試設定
- 參考資料: 一張 1024×1024 像素的虛構成年女性合成肖像。.
- 模型: GPT Image 2.5 與 Nano Banana 2.
- 任務: 咖啡廳、屋頂更衣,以及在浴室鏡子前自拍。.
- 規則: 保留第一個有效的輸出結果;遇到瑕疵時應記錄下來,而非為了獲得更完美的畫面而重新擲骰。.
任務 1:固定穿搭,雨中的咖啡館
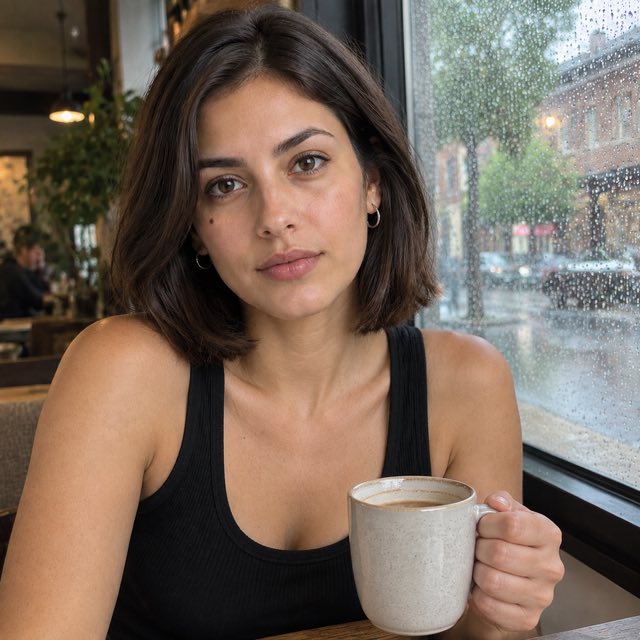
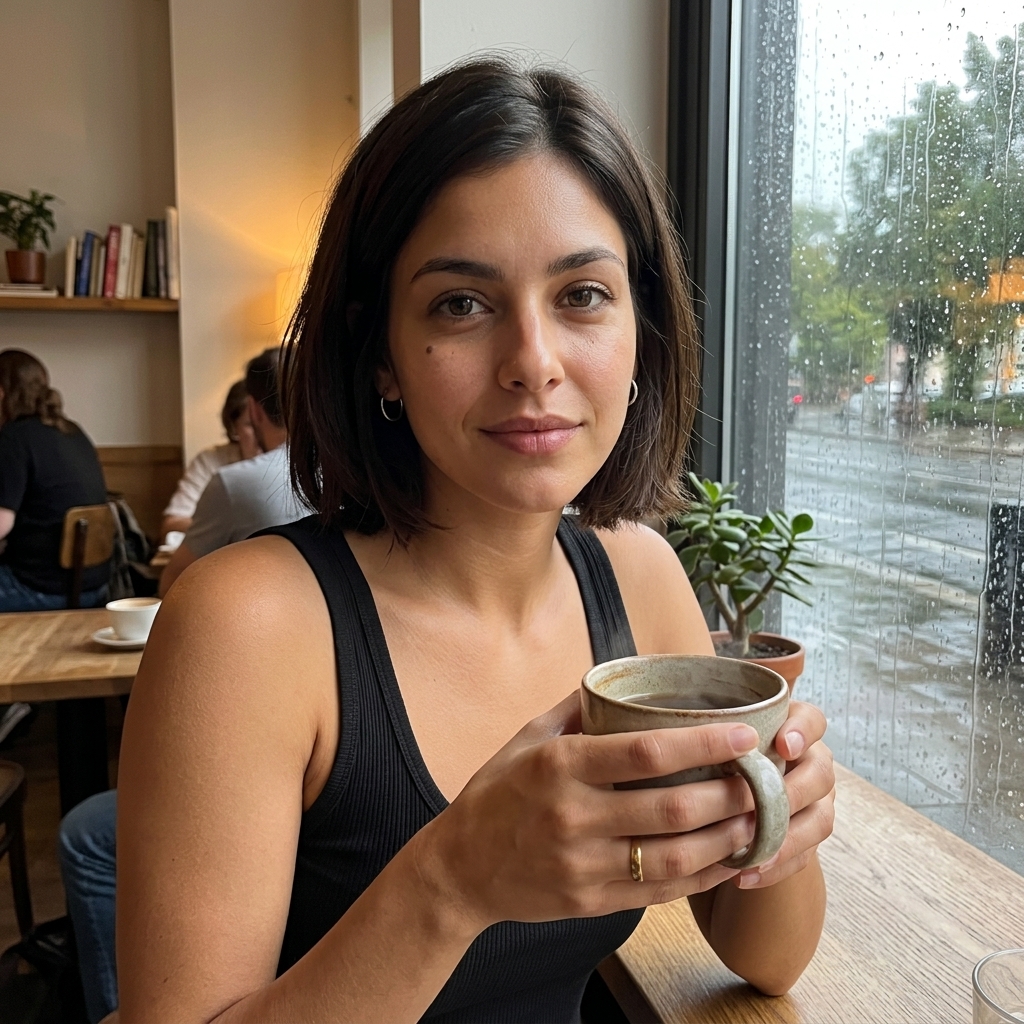
咖啡館任務要求兩個模型都保留那件黑色條紋背心,僅變更場景與姿勢。兩組輸出結果均保留了臉部、鮑伯頭、暖橄欖色肌膚以及美人痣。 GPT Image 2.5 採用了更緊湊的抓拍構圖,其中一隻手環抱著馬克杯。Nano Banana 2 則呈現了一幅令人信服的咖啡廳場景,窗戶上布滿雨滴,但人物卻用雙手握著馬克杯。.
實務判決
這兩款模型都拍出了可用的第一幀畫面。如果姿勢的準確性很重要,請在將圖片加入輪播圖之前,先檢查雙手與物體的接觸狀況。原本只是「單手」的簡單指示,可能會變成雙手的構圖。.
查看確切的提示
請根據附上的參考圖片,為同一位虛構成年女性創作一張寫實的方形社群媒體照片。請保留她的臉部特徵、及肩深棕色鮑伯頭、暖色調橄欖色肌膚、棕色眼睛、左眼下方的美人痣、身體比例、銀色圈形耳環,以及黑色羅紋背心。 僅可變更場景與姿勢:雨中的社區咖啡館窗邊,坐姿三四分之三視角,一手環抱陶瓷馬克杯,以智慧型手機自然抓拍的構圖,柔和的陰天窗邊光線,呈現自然的肌膚質感,不得出現文字或標誌。.任務 2:換裝,黃金時段的屋頂
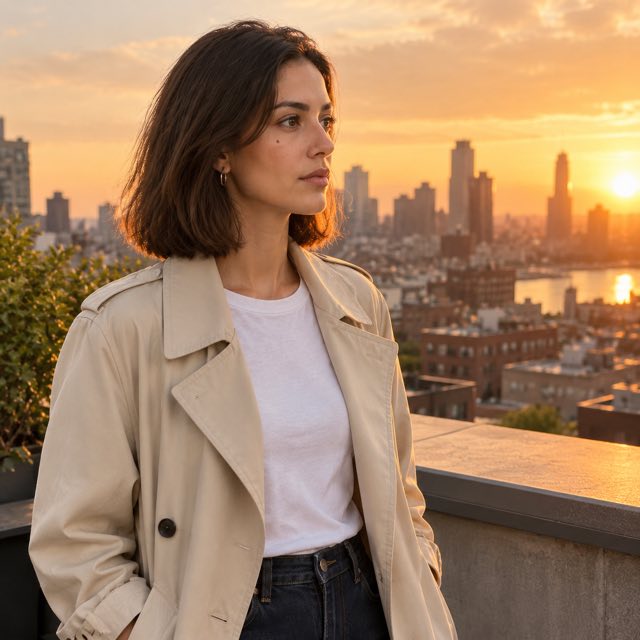
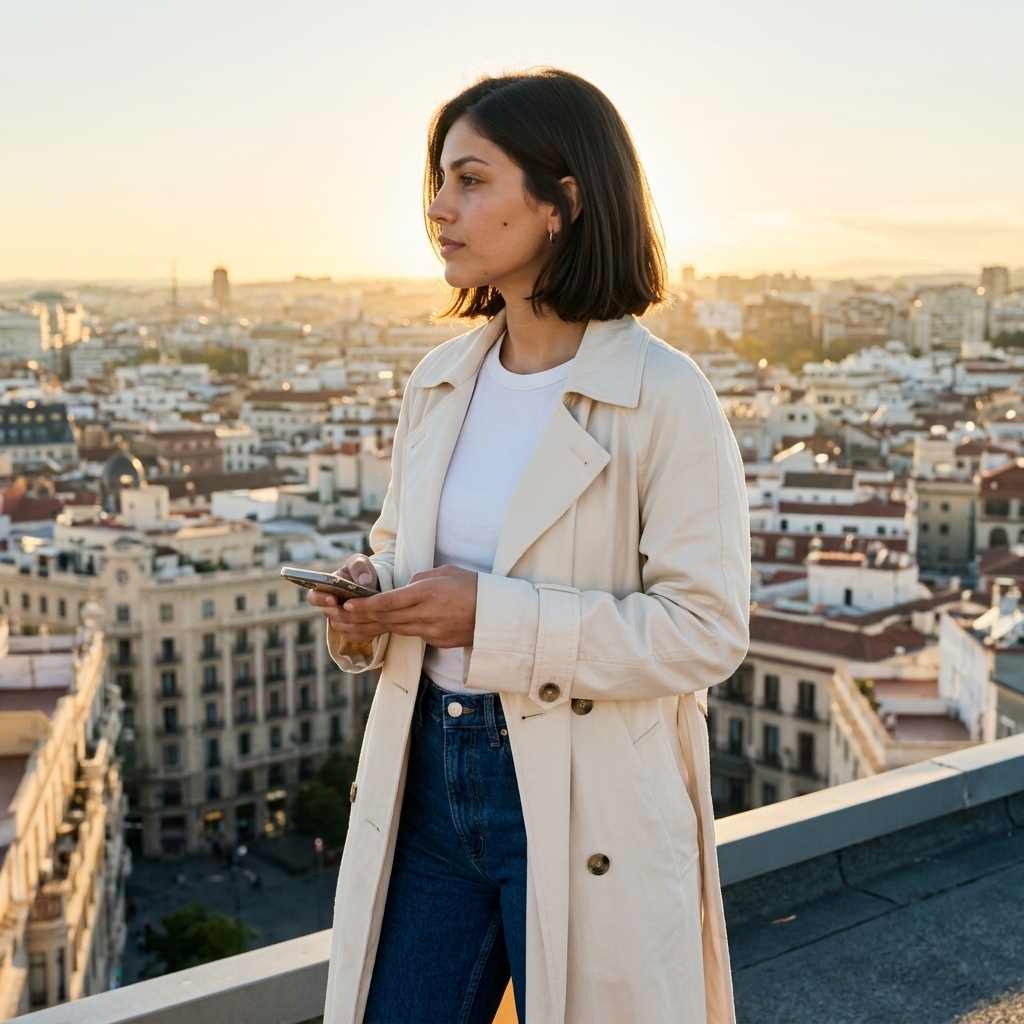
屋頂場景的拍攝任務中,服裝改為米色風衣、白色T恤和深色直筒牛仔褲,但人物與髮型保持不變。兩張照片均保留了那顆美人痣及整體形象特徵。 無論哪張成果,屋頂、城市景觀、側臉輪廓以及溫暖的逆光效果都清晰可見。Nano Banana 2 在人物手中添加了一支手機;雖然這並未破壞場景的整體感,但這提醒我們,即使未經要求,額外的道具仍可能出現在畫面中。.
實務判決
當身分特徵組合重複出現時,更衣情況仍可作為判斷依據。應綜合檢視輪廓、髮際線及臉部細微特徵;僅憑單一相符的特徵,尚不足以證明是同一人。.
查看確切的提示
請根據附上的參考圖片,為同一位虛構成年女性創作一張寫實的方形社群媒體照片。請保留她的臉部、及肩深棕色鮑伯頭、溫暖的橄欖色肌膚、棕色眼睛、左眼下方的美人痣,以及身體比例。 將服裝改為米色風衣,內搭白色 T 恤,下身搭配深色直筒牛仔褲;請勿變更她的身分或髮型。場景:黃金時段的屋頂,以側臉姿態站立並望向城市,呈現編輯風格但自然的手機攝影效果,暖色調逆光,構圖需符合裁切安全範圍,無文字,無標誌。.任務 3:特寫鏡頭,飯店浴室鏡子
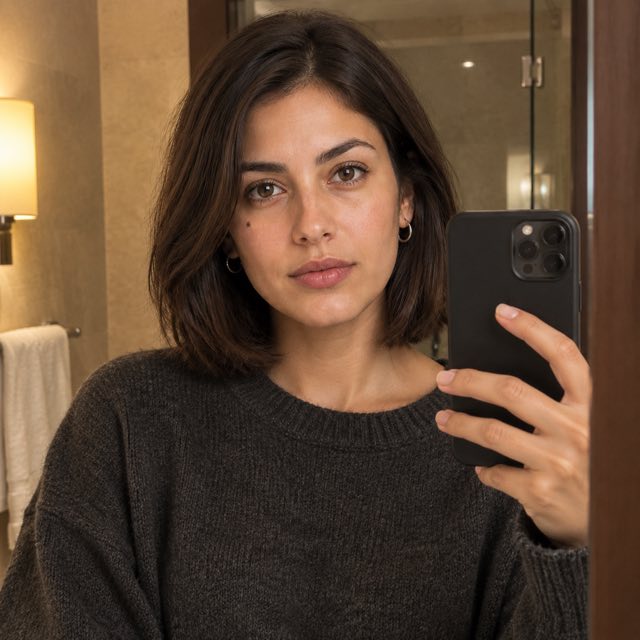
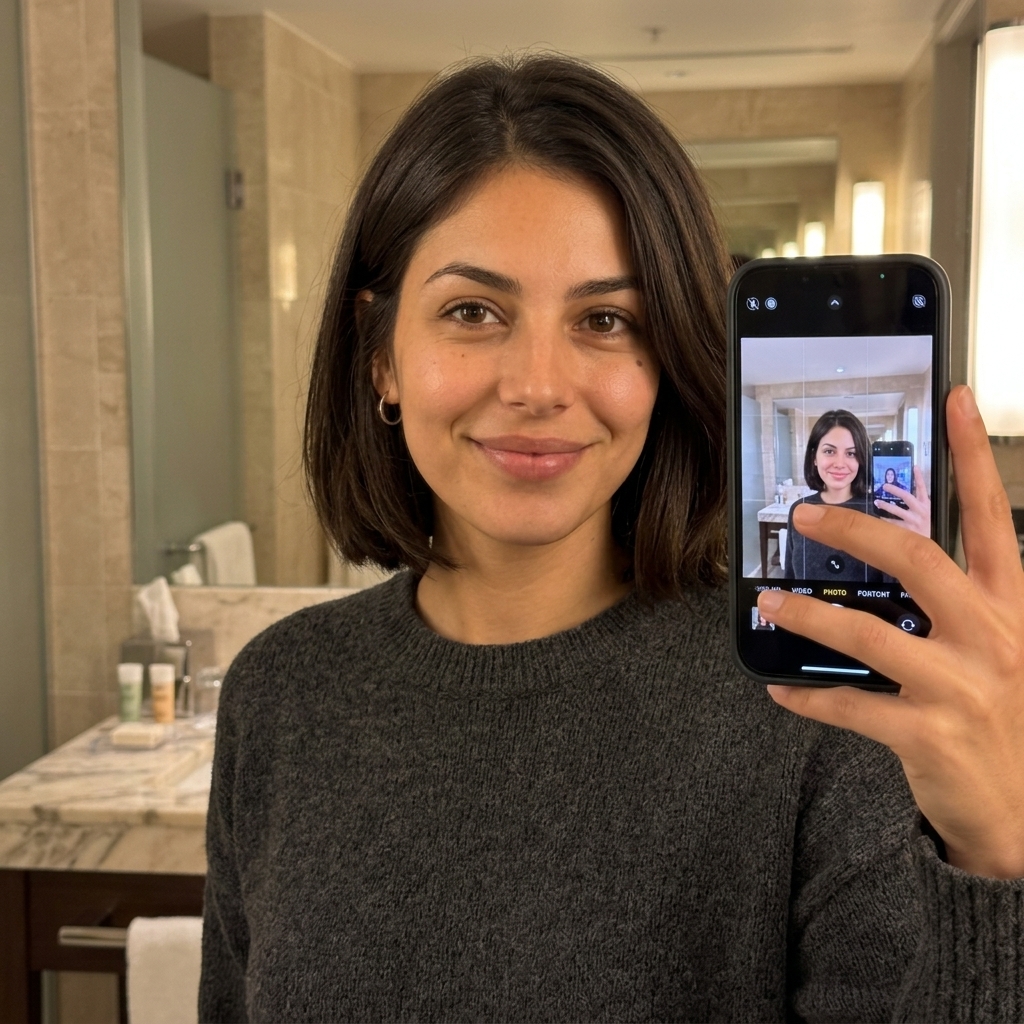
浴室任務的社交情境設定較為困難,因為鏡子和手機引入了第二個視覺系統。GPT Image 2.5 生成了張清晰的半身自拍照,其中手機部分遮擋了右側。Nano Banana 2 雖然保留了人物身分和毛衣,但讓手機更為突出,並在螢幕上顯示了一張遞迴自拍照。 該輸出結果仍可被辨識為浴室自拍,但鏡中倒影與螢幕內容在發布前,仍需由人類進行更仔細的審查。.
實務判決
在特寫鏡頭中,您應格外嚴格把關。請放大檢視手部、手機邊緣、鏡面邊界,以及任何類似文字的細節。只有當瑕疵不會分散觀眾對輪播圖欲傳達故事的注意力時,才保留該畫面。.
查看確切的提示
請根據附上的參考圖片,為同一位虛構成年女性創作一張逼真的方形社群媒體照片。請保留她的臉部、及肩深棕色鮑伯頭、暖橄欖色肌膚、棕色眼睛、左眼下方的美人痣,以及身體比例。服裝:炭灰色針織毛衣。 場景:舒適的飯店浴室鏡前,一幅輕鬆的半身自拍照,手機部分可見,柔和的鎢絲燈光,構圖略有不完美,真實的鏡中倒影,自然的肌膚紋理,無文字,無標誌。.從這項比較中能得到什麼啟示
前六項輸出結果支持工作流程的結論,而非永久性的模型排名。兩款模型在咖啡廳、屋頂和浴室這三個場景中,均保留了核心的身份錨點。 差異體現在細微的限制條件上:Nano Banana 2 在咖啡廳場景中使用了雙手,並在浴室場景中讓手機更為突出;GPT Image 2.5 則在咖啡廳和鏡子任務中,使其與要求的構圖匹配得稍為精準。.
| 決策維度 | 這次跑程所顯示的意義 | 應自行檢查的事項 |
|---|---|---|
| 身分 | 這兩條路線在三個場景中,都保留了臉部輪廓、鮑伯頭髮型、膚色以及那顆美人痣。. | 請比較整組照片中的臉部和髮際線,而不是逐張比較。. |
| 衣櫥 | 這兩套造型都遵循了固定款背心與奶油色壕溝風服裝的搭配方式。. | 尋找額外的配件和出人意料的道具。. |
| 姿勢與物件 | 簡單的指示也可能產生偏差:Nano Banana 2 雙手捧著馬克杯。. | 檢查雙手、與物體的接觸狀況,以及可見手指的數量。. |
| 特寫鏡頭 | 兩人都拍出了一張還算像樣的浴室自拍;但 Nano 的手機和那塊自反式螢幕反而更令人分心。. | 請以全尺寸檢視後視鏡、手機、倒影以及類似文字的雜訊。. |
整理最終的輪播圖
排版僅是工作的一半。一個好的輪播圖應具備視覺節奏感,因此請避免將三張幾乎一模一樣的頭像並列在一起。.
- 以最鮮明的身份錨點或最強烈的環境框架作為開場。.
- 接著以一個中景鏡頭接續,並轉換場景或服裝。.
- 確認解剖結構後,加入一個自然隨意的物件或手部動作,例如馬克杯。.
- 使用一個特寫鏡頭來營造親密感,但如果手機、鏡子或畫面裁切方式看起來會分散注意力,請將其移除。.
- 在匯出最終資料集之前,請先檢視平台裁切處的序列。.
最終的數量應保持彈性。一套數量較少但邏輯連貫的框架,比填滿了乏味變體的固定配額更具說服力。.
GlobalGPT 的適用範圍
GlobalGPT 作為多模型影像工作區,非常適合此工作流程。您可以在測試某個場景、換裝或特寫鏡頭的影像路徑時,將參考檔與身分識別套件一併保留。當您希望比較實際輸出結果,卻無需在每次實驗時於不同的影像工具之間來回切換時,此功能便十分實用。.

公開的 Nano Banana 2 頁面是進行參考驅動式影像創作的自然起點。請選用與任務相符的模型,確保提示語明確說明哪些部分應保留、哪些部分應變更,並在確定採用輪播圖集之前,先評估整組作品。.
試試使用 Nano Banana 2 進行「參考圖優先」的攝影工作流程 2.
常見問題
什麼是 AI 照片合集?
所謂的「AI 照片合集」,是指一組經協調生成的社群媒體圖片,呈現同一主題在不同時刻、地點、構圖或穿著下的樣貌。.
如何讓 AI 生成的照片中保持相同的臉部?
首先選取一張清晰的參考圖片,在每個提示中重複使用相同的標記點,並每次僅調整一個主要變數。檢視整組圖像中的臉部、髮際線、膚色及特徵標記。.
在保持人物可辨識的前提下,服裝能否有所改變?
是的。請將新服裝與角色設定包分開處理,並保持髮型、臉部、膚色及身體比例不變。接著檢查結果,確認是否有額外的配飾或輪廓變化。.
我應該為輪播圖生成多少張圖片?
並沒有一個放諸四海皆準的數字。先拍出足夠多的畫面,營造出廣角、中景、抓拍與特寫交替的節奏,然後只保留那些連貫且可用的影像。.
我該重抽這張較弱的首張卡嗎?
首先找出出錯的變數。如果圖像本身有效,但手部、裁切或反射效果不佳,請將此視為對提示詞與工作流程的反饋。切勿假設每次重新生成都會更好,而試圖掩蓋瑕疵。.