การทดสอบดำเนินการเมื่อวันที่ 7 และ 11 กันยายน 2569; แหล่งข้อมูลได้รับการตรวจสอบซ้ำเมื่อวันที่ 16 กันยายน 2569.
ชื่อรุ่นนี้จำเป็นต้องชี้แจงเพิ่มเติมเล็กน้อย ผู้คนยังคงค้นหาคำว่า “Grok 4” แต่รุ่นที่เราทดสอบคือ Grok 4.6, ไม่ใช่การเปิดตัวเดิมในเดือนกรกฎาคม 2025 แต่เป็นเวอร์ชันปัจจุบัน แคตตาล็อกโมเดล xAI แนะนำให้ใช้ Grok 4.6 สำหรับโค้ด ส่วนเวอร์ชันเดิม grok-4-0709 ชื่อ API ดังกล่าวได้ถูกยกเลิกแล้ว ผมจะแยกผลิตภัณฑ์และวันที่เหล่านั้นออกจากกันตลอดการทบทวนนี้.
หากคุณกำลังเปรียบเทียบผู้ช่วยหลายตัวก่อนที่จะเลือกตัวหนึ่ง ให้เริ่มจากภาพรวมก่อน โมเดล AI ที่ดีที่สุดสำหรับการเปรียบเทียบการเขียนโค้ด. ในที่นี้ คำถามที่แคบลงคือว่า Grok สามารถเปลี่ยนข้อกำหนดการเขียนโค้ดที่ชัดเจนเป็นผลงานที่คุณสามารถตรวจสอบได้จริงหรือไม่.
คำตอบสั้นๆ: Grok 4 เหมาะสำหรับการเขียนโค้ดหรือไม่?
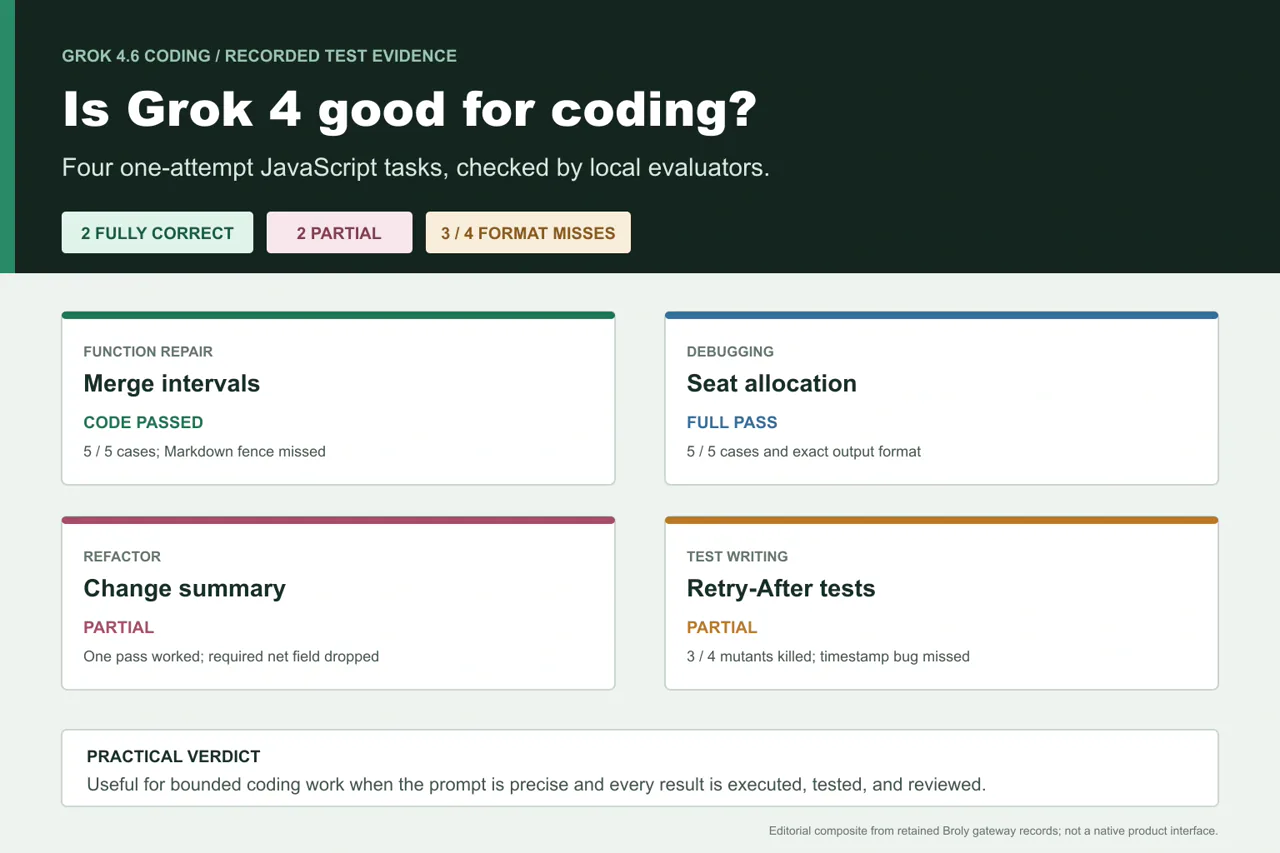
Grok 4.6 ดีพอที่จะใช้ประโยชน์ได้ในการดีบักฟังก์ชันที่ถูกบรรจุไว้ การสร้างการนำไปใช้ครั้งแรก การอธิบายโค้ดที่ไม่คุ้นเคย และการร่างการทดสอบ แต่มันยังไม่เชื่อถือได้พอที่จะยอมรับได้โดยไม่ต้องรันก่อน ข้อผิดพลาดในชุดการทดสอบเล็กๆ ของเราไม่ใช่ความไม่เห็นด้วยเรื่องสไตล์ที่เข้าใจยาก: การรีแฟกเตอร์หนึ่งครั้งทำให้ เน็ต จากทุกผลลัพธ์ที่ไม่ว่าง และชุดการทดสอบที่สร้างขึ้นหนึ่งชุดไม่สามารถแยกความแตกต่างระหว่างความล่าช้ากับเวลาที่แน่นอนได้.
มาตรฐานในทางปฏิบัติมีอยู่เพียงอย่างเดียว: ให้กำหนดสัญญาที่แคบ ขอเปลี่ยนแปลงเพียงหนึ่งข้อ และดำเนินการตรวจสอบอย่างอิสระ แบบจำลองที่สามารถสร้างโค้ดที่ดูสมเหตุสมผลได้อย่างรวดเร็ว ก็อาจลบฟิลด์หนึ่งออก ทำให้เงื่อนไขไม่เปลี่ยนแปลงอ่อนลง หรือปฏิบัติตามข้อกำหนดของโค้ด แต่กลับเพิกเฉยต่อข้อกำหนดเกี่ยวกับรูปแบบการตอบสนอง.
คุณสามารถ ลองใช้ Grok 4.6 บน GlobalGPT สำหรับคำสั่งที่มีขอบเขตจำกัดและการเปรียบเทียบแบบเคียงข้างกัน GlobalGPT เป็นแพลตฟอร์มอิสระ; มันไม่แทนที่ Grok Build, IDE, การเข้าถึงรีโพสิตอรี, คอนโซล API ของ xAI หรือ CI pipeline ของคุณ.
สิ่งที่เราได้ทดสอบจริง
เราได้ประเมินงาน JavaScript ขนาดเล็กสี่งาน ได้แก่: การแก้ไขปัญหาการรวมช่วงเวลารวมกัน, การดีบักระบบจัดที่นั่งตามลำดับความสำคัญ, การปรับโครงสร้างฟังก์ชันสรุปการเปลี่ยนแปลง, และการเขียนการทดสอบสำหรับ ลองใหม่หลังจาก parser. แต่ละงานมีคำสั่งที่คงที่และตัวประเมินท้องถิ่นแบบกำหนดได้ สามงานได้ดำเนินการเมื่อวันที่ 11 กันยายน 2026; ส่วนงานแบบช่วงเวลาได้นำผลการดำเนินการเมื่อวันที่ 7 กันยายนมาใช้ซ้ำ โดยเราได้ตรวจสอบซ้ำกับคำสั่งที่เก็บไว้ คำตอบดิบ และตัวประเมิน.
- สถานที่จัดงาน: API การรวมข้อมูล Broly ที่ได้รับอนุญาตจากผู้ใช้, Chat Completions.
- แบบที่ขอและส่งคืน:
grok-4.6. - จำนวนครั้งที่ลอง: ขอหนึ่งครั้งต่องาน และไม่มีการลองใหม่.
- การดำเนินการ: JavaScript ที่ได้รับกลับมาถูกแยกออกมาและรันในระบบท้องถิ่นกับ fixtures หรือ mutants ที่กำหนดไว้ล่วงหน้า.
- ไม่สามารถใช้ได้กับโมเดลนี้: IDE, ระบบเก็บข้อมูล, การเข้าถึงอินเทอร์เน็ต, การทำงานของเครื่องมือ xAI และระบบผลิต.
ป้ายกำกับเกตเวย์เป็นข้อมูลที่มาที่ไปที่มีประโยชน์ แต่ไม่สามารถพิสูจน์การปรับใช้ในระบบต้นทางได้อย่างอิสระ เวลาที่ผ่านไปรวมถึงค่าใช้จ่ายเพิ่มเติมจากเครือข่ายและเกตเวย์ และจำนวนโทเคนที่รายงานมาไม่สามารถใช้เป็นหลักฐานสำหรับการเรียกเก็บเงินอย่างเป็นทางการของ xAI ได้ สำหรับมุมมองที่กว้างขึ้นในระดับผลิตภัณฑ์ โปรดดูเอกสารแยกต่างหาก Grok 4.6: บทวิจารณ์และผลการทดสอบจริง.
ผลการทดสอบการเขียนโค้ดในภาพรวม
เน็ต.ผลลัพธ์ที่ดีที่สุดไม่ใช่คำตอบที่ยาวที่สุด แต่คือการแก้ไขการจัดที่นั่ง: สั้นกระชับ จัดรูปแบบถูกต้อง และครบถ้วนในแง่พฤติกรรม ส่วนความล้มเหลวที่ให้บทเรียนมากที่สุดคือการปรับโครงสร้างโค้ด เพราะการเขียนโค้ดดูสะอาดตาและตรงตามข้อกำหนด one-pass แต่กลับเปลี่ยนแปลงสัญญาผลลัพธ์โดยไม่ได้แจ้งให้ทราบ.
การทดสอบ 1: การแก้ไขฟังก์ชันช่วงการรวม
ฟังก์ชันแรกได้เปลี่ยนแปลงค่าอินพุตของตัวเอง, เกิดข้อผิดพลาดเมื่อพบอาร์เรย์ว่าง, ไม่สามารถรวมจุดปลายที่ติดกันได้, และอาจทำให้ช่วงที่ใหญ่กว่าหดตัวลงเมื่อมีช่วงที่ซ้อนกันปรากฏขึ้นในภายหลัง ข้อความแจ้งเตือนได้ทำให้คุณสมบัติคงที่เหล่านั้นชัดเจนขึ้น.
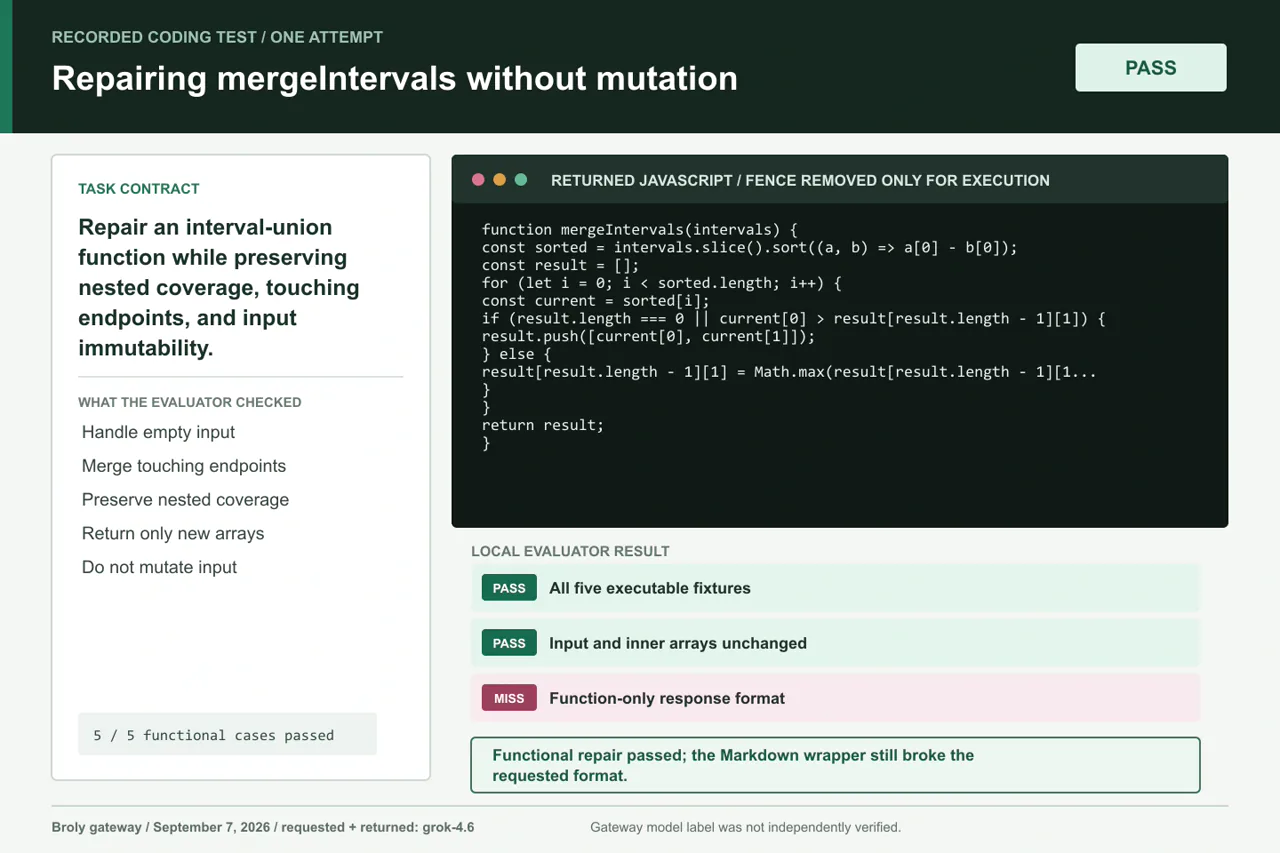
ขอบเขตหลัก: การซ่อมแซมฟังก์ชันได้ผ่านแล้ว หลังจากลบเพียงรั้ว Markdown ด้านนอกออกเพื่อดำเนินการ.
ผลลัพธ์: ทั้งห้ากรณีที่สามารถรันได้ผ่านทั้งหมด ฟังก์ชันนี้คืนค่าเป็นอาร์เรย์ใหม่ ไม่เปลี่ยนแปลงข้อมูลเข้า รักษาความครอบคลุมของโค้ดที่ซ้อนกัน และรวมจุดสิ้นสุดที่สัมผัสกัน อย่างไรก็ตาม มันยังล้มเหลวในคำสั่งที่ระบุไว้อย่างชัดเจนหนึ่งคำสั่ง เนื่องจากมีการห่อโค้ดด้วย Markdown หลังจากลบเพียงรั้วภายนอกสำหรับการรันนั้น ผลลัพธ์การทำงานก็ถูกต้อง.
ข้อสรุปที่สามารถนำไปใช้ได้จริง: Grok ได้จัดการการซ่อมแซมแบบกะทัดรัดได้อย่างดี เมื่อพรอมต์ระบุกรณีขอบที่ซ่อนอยู่ การผิดพลาดในรูปแบบนี้อาจดูเล็กน้อยสำหรับผู้ใช้ แต่สามารถทำให้ท่อประมวลผลที่คาดหวังข้อความที่สามารถดำเนินการได้โดยตรงเกิดข้อผิดพลาดได้.
การทดสอบ 2: การแก้ไขข้อผิดพลาดในการจัดที่นั่งตามลำดับความสำคัญ
งานนี้รวมการจัดการค่าเท่ากันที่เสถียร ลำดับความสำคัญแบบลดหลั่น การไม่เปลี่ยนแปลงค่า ความจุที่แม่นยำ และกฎ “ข้ามและดำเนินการต่อ” โค้ดเดิมจัดเรียงในทิศทางที่ผิด เปลี่ยนแปลงอาร์เรย์ข้อมูลเข้า และหยุดทำงานเร็วเกินไปเมื่อมีคำขอหนึ่งมีขนาดเกินกำหนด.
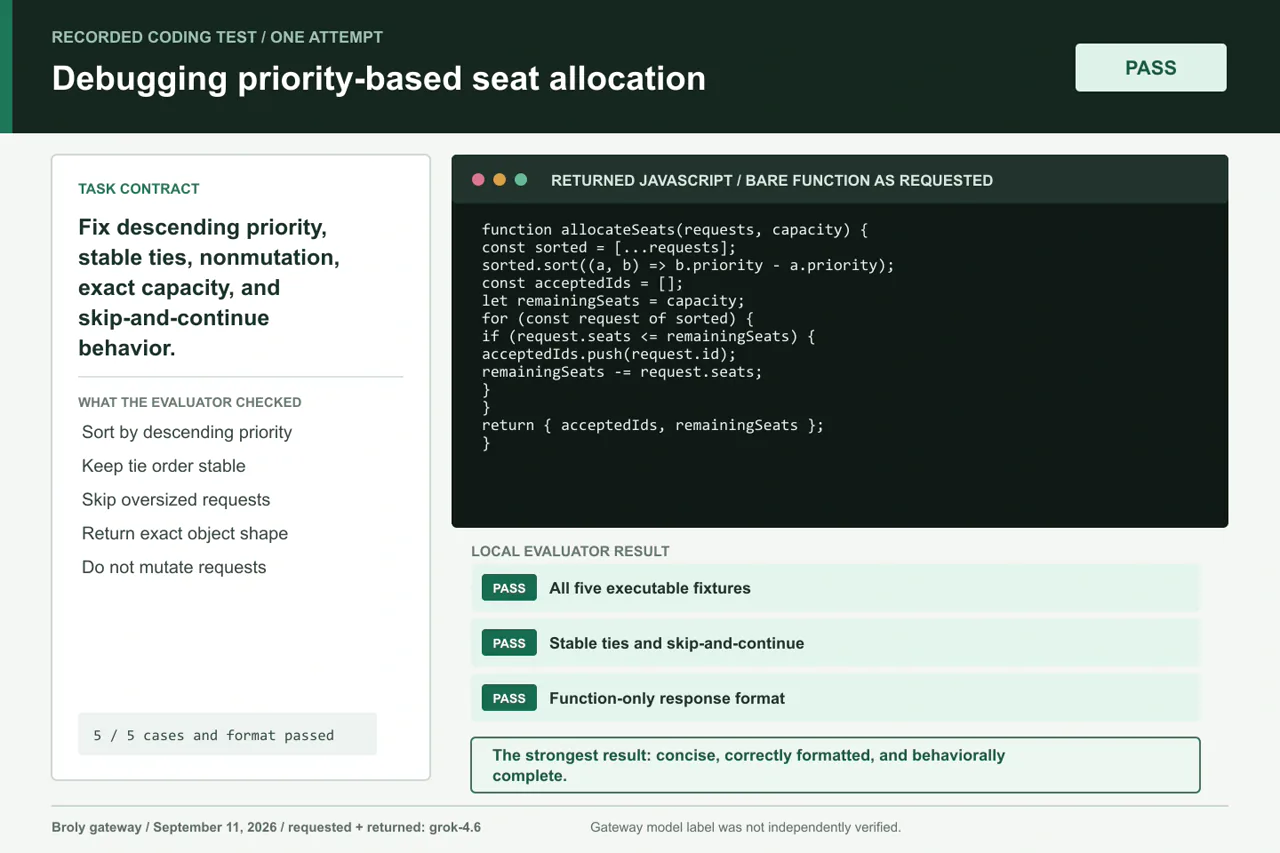
ขอบเขตหลัก: นี่คือคำตอบเดียวที่ตรงตามทั้งสัญญาพฤติกรรมและรูปแบบผลลัพธ์ที่ถูกต้อง.
ผลลัพธ์: ทั้งห้ากรณีผ่านการทดสอบทั้งหมด รวมถึงกรณีที่มีลำดับความสำคัญเท่ากัน คำขอหลักที่มีขนาดใหญ่เกินไป ความจุที่พอดี ความจุเป็นศูนย์ และรายการว่าง ข้อมูลเข้ายังคงไม่เปลี่ยนแปลง, ID ที่ได้รับการยอมรับ เป็นอาร์เรย์ใหม่ และโมเดลได้ส่งคืนเพียงฟังก์ชันที่ขอมาเท่านั้น.
ข้อสรุปที่สามารถนำไปใช้ได้จริง: นี่คือประเภทงานที่ Grok เหมาะสมอย่างยิ่ง: มีฟังก์ชันเดียว สัญญาที่ชัดเจน และกรณีขอบเขตที่สามารถดำเนินการได้ทันที.
การทดสอบที่ 3: การปรับโครงสร้างโค้ดโดยไม่สูญเสียพฤติกรรม
คำสั่งที่สามขอให้ Grok แทนที่การสแกนซ้ำๆ ด้วยขั้นตอนการรวมข้อมูลเพียงครั้งเดียว โดยยังคงรักษาลำดับ ชื่อไฟล์ที่ไม่ธรรมดา และรูปแบบผลลัพธ์ที่แม่นยำไว้ นี่คือความเสี่ยงที่อาจเกิดขึ้นได้จริงในการปรับโครงสร้างโค้ด: โค้ดอาจทำงานได้เร็วขึ้นและสะอาดขึ้น แต่ในขณะเดียวกันอาจสูญเสียพฤติกรรมเดิมไป.
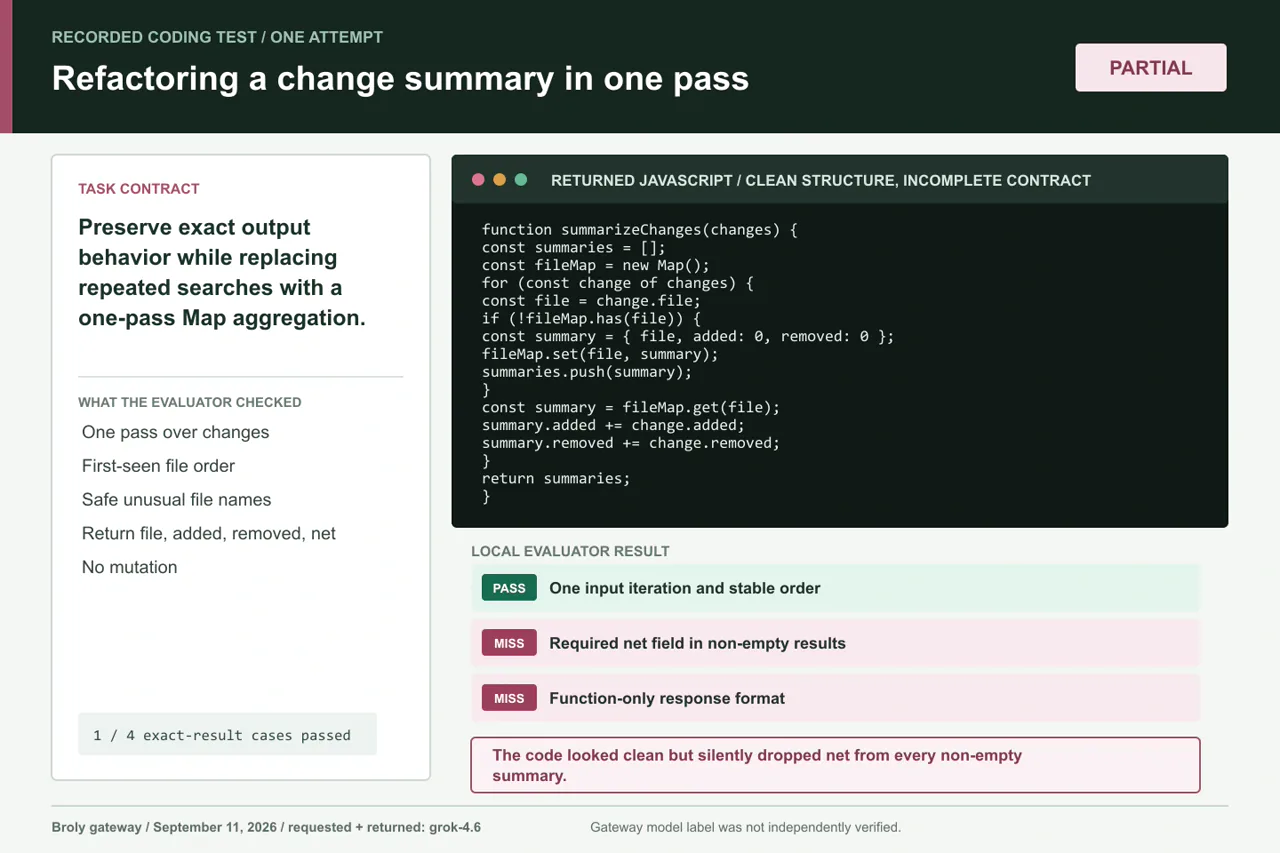
ขอบเขตหลัก: วิธีการ Map แบบ one-pass ดูเหมือนถูกต้อง แต่ได้ละทิ้งฟิลด์ net ที่จำเป็นไปโดยไม่ได้แจ้งเตือน.
ผลลัพธ์: การตอบสนองนี้ใช้การผ่านหนึ่งครั้ง, a แผนที่, การจัดเรียงตามลำดับที่เห็นครั้งแรกอย่างถูกต้อง, การจัดการอย่างปลอดภัยของ __proto__ และ ตัวสร้าง, และไม่มีการเปลี่ยนแปลงข้อมูลเข้า แต่ระบบไม่เคยคำนวณหรือส่งคืน เน็ต. กรณีที่ว่างผ่านเพราะไม่มีวัตถุผลลัพธ์; ส่วนกรณีทั้งสามที่ไม่ว่างล้วนล้มเหลวในการเปรียบเทียบแบบตรงกัน.
ข้อสรุปที่สามารถนำไปใช้ได้จริง: อย่าตัดสินการปรับโครงสร้างโค้ดเพียงจากความซับซ้อนของอัลกอริทึมหรือความสะอาดของโค้ดเท่านั้น ให้บันทึกผลลัพธ์เดิมไว้ ตรวจสอบให้แน่ใจว่าทุกฟิลด์ที่จำเป็นได้รับการเติมเต็ม และเปรียบเทียบพฤติกรรมก่อนที่จะยอมรับเวอร์ชันใหม่.
การทดสอบที่ 4: การเขียนการทดสอบเพื่อตรวจจับข้อผิดพลาดที่อาจเกิดขึ้นได้
งานสุดท้ายได้กลับทิศทางจากวิธีการปกติ: Grok เป็นผู้เขียนชุดทดสอบ และระบบทดสอบของเราได้รันชุดทดสอบดังกล่าวกับหนึ่งเวอร์ชันอ้างอิงที่เคร่งครัด พร้อมทั้งสี่เวอร์ชันที่ถูกออกแบบให้ผิดอย่างจงใจ เป้าหมายไม่ใช่การวัดความครอบคลุมของบรรทัดโค้ด แต่เพื่อตรวจสอบว่าข้อมูลเข้าที่เลือกมาสามารถแยกแยะความหมายที่ดูคล้ายกันได้หรือไม่.
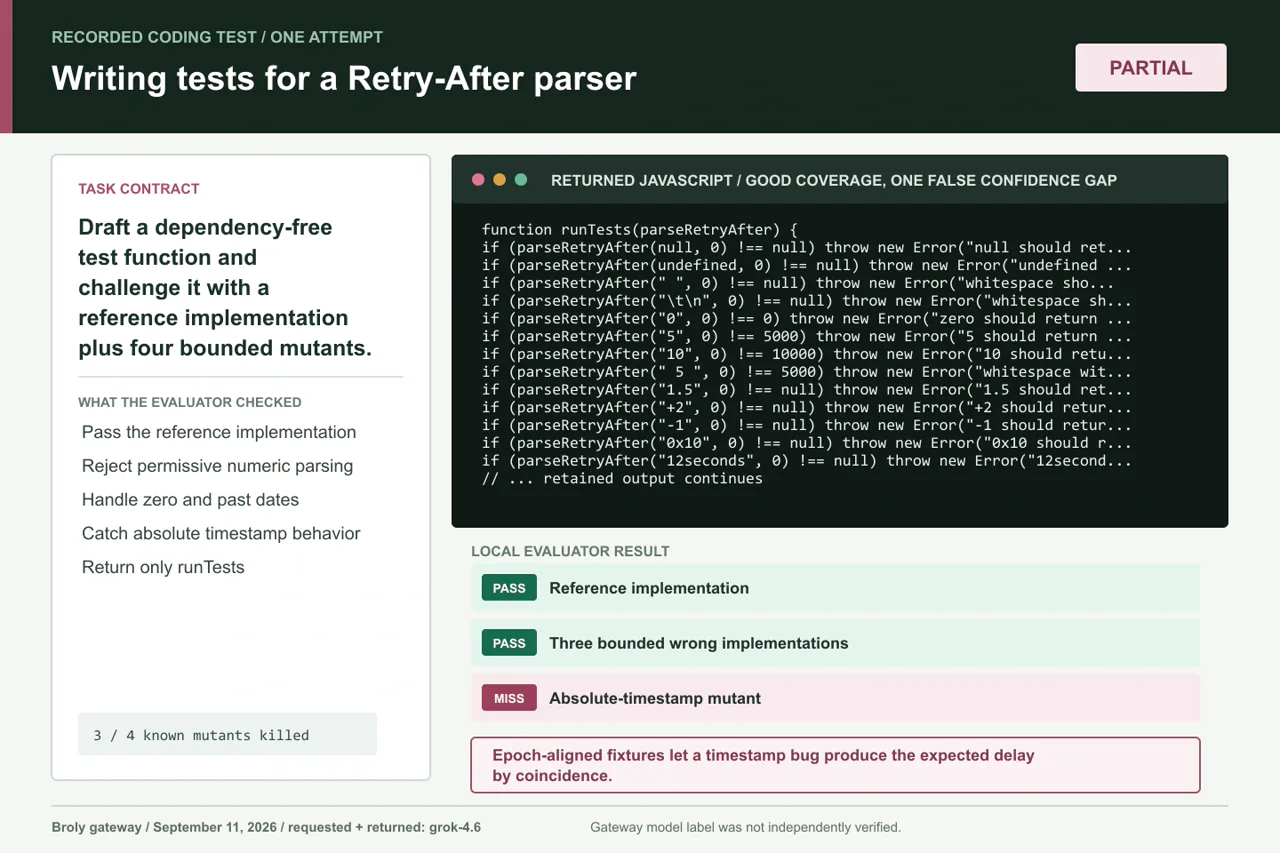
ขอบเขตหลัก: ตัวช่วยกำหนดวันที่ที่ปรับให้สอดคล้องกับยุค (epoch-aligned date fixtures) ทำให้ข้อผิดพลาดที่เกี่ยวข้องกับเวลาแบบสัมบูรณ์ (absolute timestamp) ยังคงอยู่ได้โดยบังเอิญ.
ผลลัพธ์: ชุดทดสอบนี้ผ่านการตรวจสอบอ้างอิงและตรวจพบการวิเคราะห์ตัวเลขแบบผ่อนปรน (permissive numeric parsing) โดยค่าศูนย์ถูกพิจารณาเป็นค่าเท็จ (falsy) รวมถึงการหน่วงเวลาเชิงลบสำหรับวันที่ในอดีต อย่างไรก็ตาม ชุดทดสอบนี้ไม่สามารถตรวจพบกรณีที่ผิดปกติ (mutant) ซึ่งคืนค่า timestamp แบบสัมบูรณ์ของวันที่ที่ผ่านการวิเคราะห์ ทั้งสองการทดสอบวันที่ใช้ค่าที่ปรับให้สอดคล้องกับ epoch ดังนั้นการหน่วงเวลาที่คาดไว้จึงเท่ากับ timestamp.
ข้อสรุปที่สามารถนำไปใช้ได้จริง: การทดสอบที่เขียนโดย AI เป็นขั้นตอนแรกที่มีประโยชน์ แต่ไม่ใช่หลักฐานของความถูกต้อง ให้ถามว่าแต่ละ fixture สามารถแยกแยะอะไรได้บ้าง การทดสอบการกลายพันธุ์ (mutation testing) การทดสอบคุณสมบัติ (property tests) และค่าที่ไม่ได้จัดให้สอดคล้องกันโดยเจตนา สามารถเปิดเผยชุดการทดสอบที่ดูเหมือนจะครอบคลุมอย่างละเอียด แต่แท้จริงแล้วไม่ครบถ้วน.
Grok 4, Grok 4.6 และ Grok Build ไม่ใช่สิ่งเดียวกัน
บริบทการเปิดตัวในเดือนกรกฎาคม 2025. slug ของ API เก่าได้ถูกยกเลิกการใช้งานในเวลาต่อมา.
ป้ายกำกับที่เกตเวย์ส่งกลับมาในสี่งานที่ทำงานแบบแยกกันนี้.
เอเจนต์แยกต่างหากที่สามารถทำงานผ่านกระบวนการทำงานของรีโพซิทอรีแบบโต้ตอบหรือแบบไม่มีส่วนติดต่อผู้ใช้.
เครื่องมือ Python ที่ทำงานในสภาพแวดล้อมแบบแซนด์บ็อกซ์ ซึ่งต้องถูกเปิดใช้งานในคำขอที่ได้รับการสนับสนุน.
The ประกาศต้นฉบับ Grok 4 เป็นบริบทการเปิดตัวในอดีต ซึ่งไม่ได้อธิบายถึงแบบจำลองที่ใช้ในการทดสอบของเราในปี 2026.
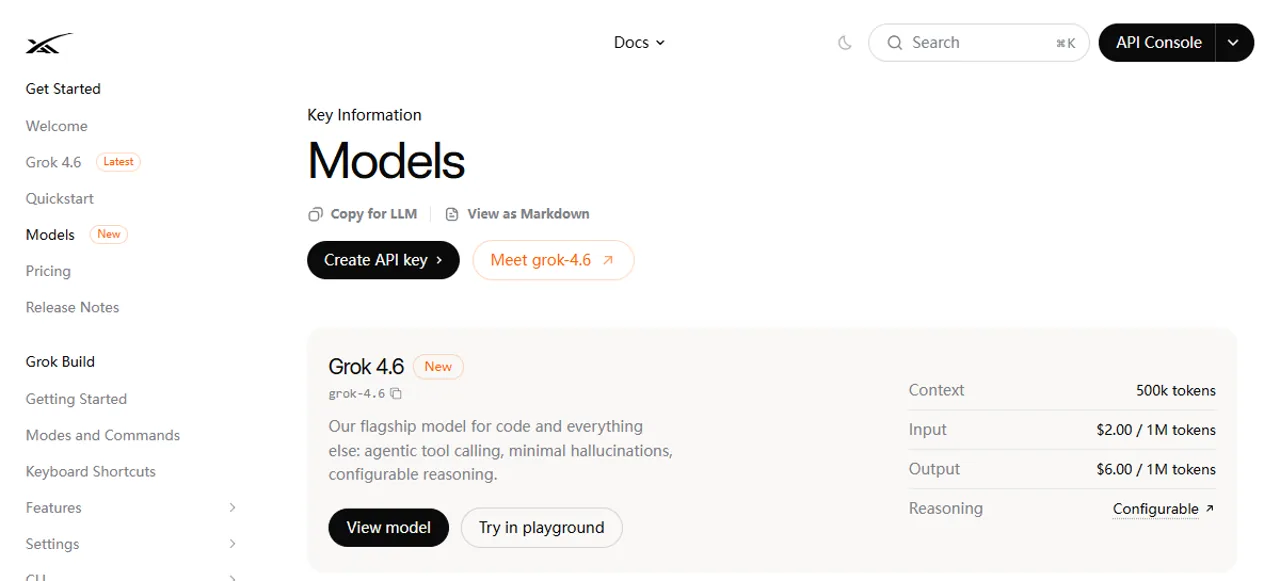
xAI’s ประกาศการย้ายระบบ วันที่ 15 พฤษภาคม 2569 กล่าวว่า grok-4-0709 ตอนนี้ถูกเปลี่ยนเส้นทางไปยัง Grok 4.3 ด้วยระดับการวิเคราะห์ที่ต่ำ ซึ่งไม่ได้หมายความว่าผลิตภัณฑ์ทุกชิ้นที่มีชื่อตระกูล Grok 4 จะหายไปทั้งหมด แต่หมายความว่าหมายเลขรุ่นที่แม่นยำนั้นมีความสำคัญ.
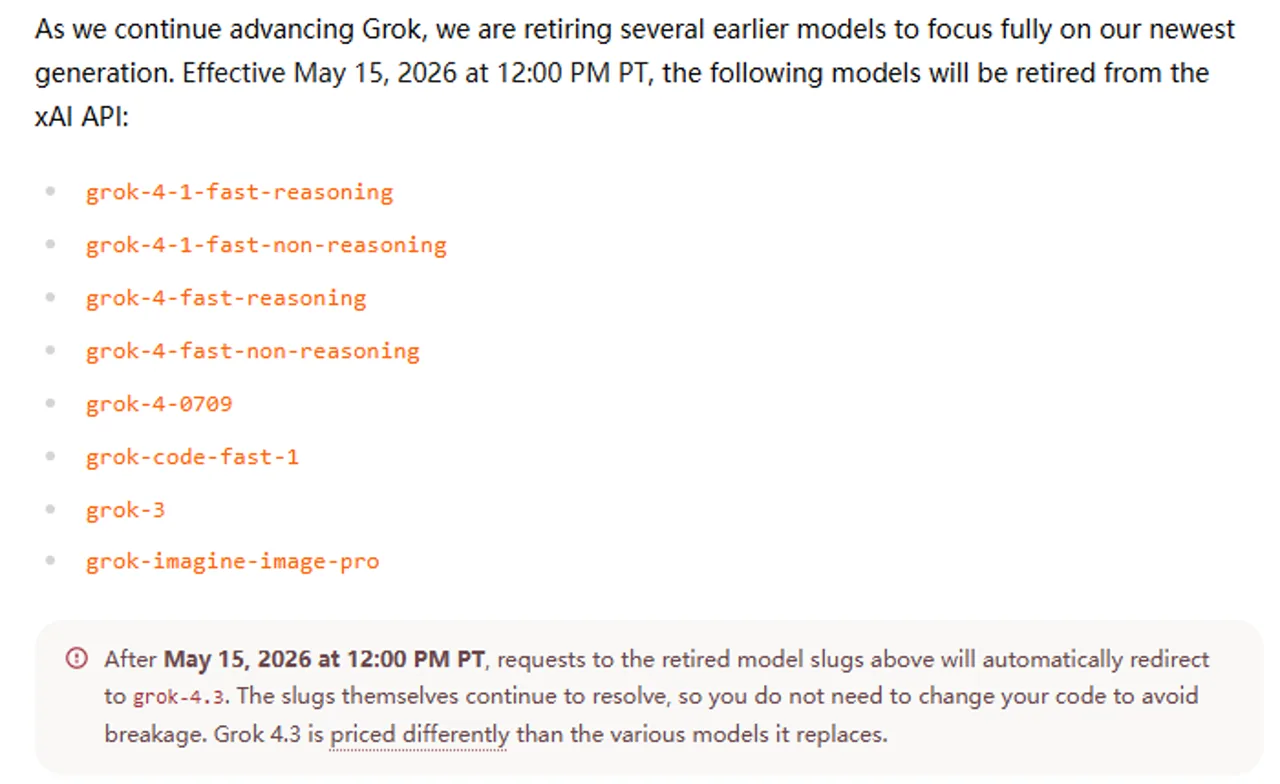
Grok 4.6 เป็นรุ่นที่ xAI แนะนำให้ใช้สำหรับโค้ดในปัจจุบัน ส่วนข้อมูลอย่างเป็นทางการ Grok 4.6 สเปค เครื่องมือที่ได้รับการสนับสนุน ได้แก่ การเรียกใช้ฟังก์ชัน การค้นหาบนเว็บ การค้นหาใน X และการดำเนินการโค้ด การสนับสนุนนี้ไม่เท่ากับการเปิดใช้งานอัตโนมัติ: ผลิตภัณฑ์ที่เรียกใช้หรือคำขอ API ยังคงเป็นปัจจัยที่กำหนดว่าโมเดลสามารถเห็นและทำอะไรได้บ้าง.
The ประกาศเกี่ยวกับ Grok 4.6 กำหนดโมเดลสำหรับเอเจนต์ที่ทำงานต่อเนื่องเป็นเวลานานและงานพัฒนาโค้ด นี่เป็นคำกล่าวอ้างอย่างเป็นทางการของผลิตภัณฑ์ ไม่ใช่ผลจากการวัดอย่างอิสระของงาน JavaScript สี่งานที่ทำงานแยกกัน.
การประกอบ Grok คือเครื่องมือเขียนโค้ดที่ทำงานแยกต่างหาก ด้วยอินเทอร์เฟซเทอร์มินัลแบบโต้ตอบและโหมดไม่มีหน้าจอ (headless mode) ที่สามารถทำงานได้ภายในกระบวนการทำงานของรีโพสิตอรี หากคุณกำลังเลือกจากชื่อโมเดลแทนที่จะเลือกผลิตภัณฑ์การเขียนโค้ด, แล้ว รุ่น Grok ที่ดีที่สุดตามงาน คู่มือนี้อธิบายเกี่ยวกับครอบครัวปัจจุบัน.
The เครื่องมือการดำเนินการโค้ด xAI เป็นสภาพแวดล้อม Python แบบแซนด์บ็อกซ์ที่เลือกใช้ได้ มันไม่ได้ถูกเปิดใช้งานในการทดสอบ Broly ของเรา ดังนั้นโมเดลจึงไม่ได้รัน JavaScript ของตัวเองหรือตรวจสอบข้อมูลย้อนกลับจากตัวประเมินก่อนที่จะให้คำตอบ.
ตัวอย่างการใช้งานการเขียนโค้ดที่ดีที่สุดสำหรับ Grok
การแก้ไขข้อผิดพลาดที่เกิดขึ้นภายในระบบ
Grok มีประโยชน์มากที่สุดเมื่อสามารถลดปัญหาลงเป็นฟังก์ชัน สแต็กเทรซ ฟิกเจอร์ที่ล้มเหลว หรือ diff สั้นๆ ให้ระบุสิ่งที่ควรเกิดขึ้น สิ่งที่เกิดขึ้นจริง และขอบเขตที่คุณไม่ต้องการให้เปลี่ยนแปลง ผลลัพธ์ของการจัดที่นั่งแสดงให้เห็นว่ากรณีขอบที่แม่นยำสามารถเปลี่ยนคำขอที่คลุมเครืออย่าง “แก้ไขสิ่งนี้” ให้กลายเป็นแพตช์ที่สามารถตรวจสอบได้.
สร้างเวอร์ชันแรก
สำหรับตัวแปลง ตัววิเคราะห์ ฟังก์ชันแปลง และตัวอย่าง API Grok สามารถช่วยลดความยุ่งยากในการเริ่มต้นได้ ขอหน่วยที่สมบูรณ์ขนาดเล็กที่สุด ระบุเวอร์ชันของไลบรารี pin และรันโค้ดตัวอย่าง คู่มือการบูรณาการ API สำหรับ Grok 4 คือขั้นตอนต่อไป เมื่องานเกี่ยวข้องกับ API แทนที่จะเป็นคำตอบจากโค้ดที่แยกออกมา.
การตรวจสอบหรือร่างข้อสอบ
ให้ใช้ Grok เพื่อค้นหากรณีขอบเขตที่ขาดหายไป, อินวาร์เรียนท์ และตัวกลายพันธุ์ที่เป็นไปได้ จากนั้นตรวจสอบว่าแต่ละข้อมูลเข้าสามารถแยกแยะพฤติกรรมที่อ้างว่าจะทดสอบได้หรือไม่ ชุดทดสอบ Retry-After ดูเหมือนจะครอบคลุมอย่างกว้างขวางบนกระดาษ แต่คู่ของ timestamp ที่จัดเรียงให้ตรงกันเพียงคู่เดียวก็ทำให้ข้อผิดพลาดทางความหมายยังคงอยู่.
การเปรียบเทียบวิธีการต่าง ๆ
Grok ยังเป็นประโยชน์ในการขอความคิดเห็นเพิ่มเติมเกี่ยวกับอัลกอริทึม โครงสร้างข้อมูล หรือสมมติฐานในการแก้ไขข้อผิดพลาด เมื่อการตัดสินใจเกี่ยวข้องกับการปรับให้เหมาะสมของระบบช่วยมากกว่าการแก้ไขจุดเดียว, การ การเปรียบเทียบการเข้ารหัสระหว่าง Grok และ ChatGPT เพิ่มมุมมองข้ามรุ่น.
กรณีที่การเขียนโค้ด Grok จำเป็นต้องมีการกำกับดูแล
การปรับโครงสร้างโค้ดที่รักษาพฤติกรรม: โมเดลนี้สามารถทำงานตามอัลกอริทึมที่ร้องขอได้ แม้จะขาดฟิลด์ผลลัพธ์หนึ่งตัวไปก็ตาม ให้ดำเนินการทดสอบการถดถอย และเปรียบเทียบผลลัพธ์ที่ถูกซีเรียลไลซ์ ข้อผิดพลาด ลำดับ การเปลี่ยนแปลง และผลข้างเคียง.
การเปลี่ยนแปลงในคลังเก็บหลายไฟล์: หลักฐานของเราไม่ครอบคลุมการค้นพบความพึ่งพา ระบบการสร้าง การค้นหาโค้ด ไฟล์ที่สร้างขึ้น การย้ายข้อมูล หรือการแก้ไขแบบประสานงาน ให้ใช้เอเจนต์การเขียนโค้ดจริงที่มีสิทธิ์เข้าถึงรีโพสิตอรีในขอบเขตที่กำหนด แล้วตรวจสอบคำสั่งและ diff ของมัน การเปรียบเทียบตัวแทนรหัส Codex กับ Claude แสดงให้เห็นว่ากระบวนการทำงานโดยรอบมีความสำคัญไม่แพ้ตัวแบบ.
งานด้านความปลอดภัยและการผลิต: อย่าถือว่าการตอบกลับที่มั่นใจเป็นแบบจำลองภัยคุกคาม การตรวจสอบความพึ่งพา หรือการอนุมัติการปรับใช้ ให้รวม CI การวิเคราะห์แบบสถิต การสแกนข้อมูลลับ การจัดเตรียมในสภาพแวดล้อม staging การย้อนกลับ และการตรวจสอบโดยมนุษย์ เข้าไว้ในกระบวนการ.
รูปแบบการสื่อสารระหว่างเครื่องกับเครื่องที่เคร่งครัด: สามในสี่ของคำตอบดิบได้ใช้ Markdown fence ถึงแม้จะมีคำสั่งห้ามใช้ Markdown อย่างชัดเจน ให้ตรวจสอบความถูกต้องและวิเคราะห์ผลลัพธ์ที่ขอบเขต; อย่าส่งข้อความของโมเดลเข้าไปในกระบวนการทำงานโดยตรง เพราะมันดูเหมือนโค้ด.
ค่าใช้จ่ายและกระบวนการให้เหตุผลที่ยาว: เกตเวย์ของเราได้รายงานโทเค็นการเสร็จสิ้นจำนวน 4,260 สำหรับคำขอที่มี max_tokens: 4096, ส่วนใหญ่ใช้เป็นโทเคนสำหรับการให้เหตุผล การสังเกตนี้ไม่ได้พิสูจน์พฤติกรรมการเรียกเก็บเงินหรือการจำกัดของ xAI โปรดตรวจสอบช่องทางอย่างเป็นทางการปัจจุบันและเปรียบเทียบกับ Grok 4 คู่มือการกำหนดราคาและตั้งค่า API ก่อนที่จะประมาณการงบประมาณการผลิต.
ขั้นตอนการทำงานที่ใช้งานได้จริงในการใช้ Grok กับโค้ด
1. ลดปัญหา
ให้ Grok ตัวอย่างการจำลองที่เล็กที่สุดที่ยังเกิดข้อผิดพลาดอยู่ พร้อมทั้งข้อผิดพลาด รหัสที่เกี่ยวข้อง และผลลัพธ์ที่คาดไว้หนึ่งอย่าง ให้ลบประวัติโครงการและข้อมูลลับที่ไม่เกี่ยวข้องออกไป.
2. เขียนสัญญา ไม่ใช่ความปรารถนา
ระบุชื่อฟังก์ชัน ข้อมูลนำเข้าที่รับได้ รูปแบบผลลัพธ์ที่แน่นอน ลำดับการประมวลผล กฎการเปลี่ยนแปลงข้อมูล ขีดจำกัดการพึ่งพา และรูปแบบผลลัพธ์ วิธีใช้ Grok 4 คู่มือ ครอบคลุมกระบวนการบัญชีและขั้นตอนการทำงานโดยรวม.
3. ขอเงินทอนเล็กน้อย
ควรเลือกใช้ฟังก์ชันเดียวหรือการปรับเปลี่ยนที่มุ่งเน้นเฉพาะจุด แทนที่จะเขียนใหม่ทั้งหมด ให้ขอให้มันรักษาพฤติกรรมที่เปิดเผยต่อสาธารณะไว้ และระบุข้อสมมติใดๆ ที่มันต้องใช้.
4. ดำเนินการตรวจสอบอย่างอิสระ
ดำเนินการรันโค้ดนอกการตอบสนองของโมเดล เพิ่มกรณีขอบเขตที่ช่วยแยกความหมายที่ใกล้เคียงกัน ตรวจสอบการเปลี่ยนแปลงของข้อมูลเข้า เปรียบเทียบทุกฟิลด์ของข้อมูลออก และทดสอบความผิดพลาดที่คาดการณ์ไว้ สำหรับชุดการทดสอบที่สร้างขึ้น ให้รันข้อมูลเข้าที่เปลี่ยนแปลงอย่างจงใจเมื่อความเสี่ยงนั้นสมเหตุสมผล.
5. ตรวจสอบความแตกต่างและรับผิดชอบในการตัดสินใจ
อ่านไฟล์ diff สุดท้ายเหมือนว่ามันถูกสร้างขึ้นโดยผู้ร่วมพัฒนาที่เป็นมนุษย์ ตรวจสอบการเปลี่ยนแปลงในส่วนที่ขึ้นอยู่กับกัน ขอบเขตความปลอดภัย ความสามารถในการตรวจสอบ และกระบวนการย้อนกลับ ผู้ที่ทำการรวมหรือปรับใช้ยังคงรับผิดชอบต่อผลลัพธ์ที่เกิดขึ้น.
สิ่งที่นักพัฒนารายงานต่อสาธารณะ
ประสบการณ์ของผู้ใช้มีความหลากหลายและขึ้นอยู่กับงาน ผลิตภัณฑ์ คำแนะนำ และวันที่เป็นอย่างมาก ความคิดเห็นสองข้อบน Hacker News แสดงให้เห็นถึงความหลากหลายนี้ แต่ทั้งสองข้อไม่ได้เป็นมาตรฐานอ้างอิงหรือการสำรวจที่เป็นตัวแทน.
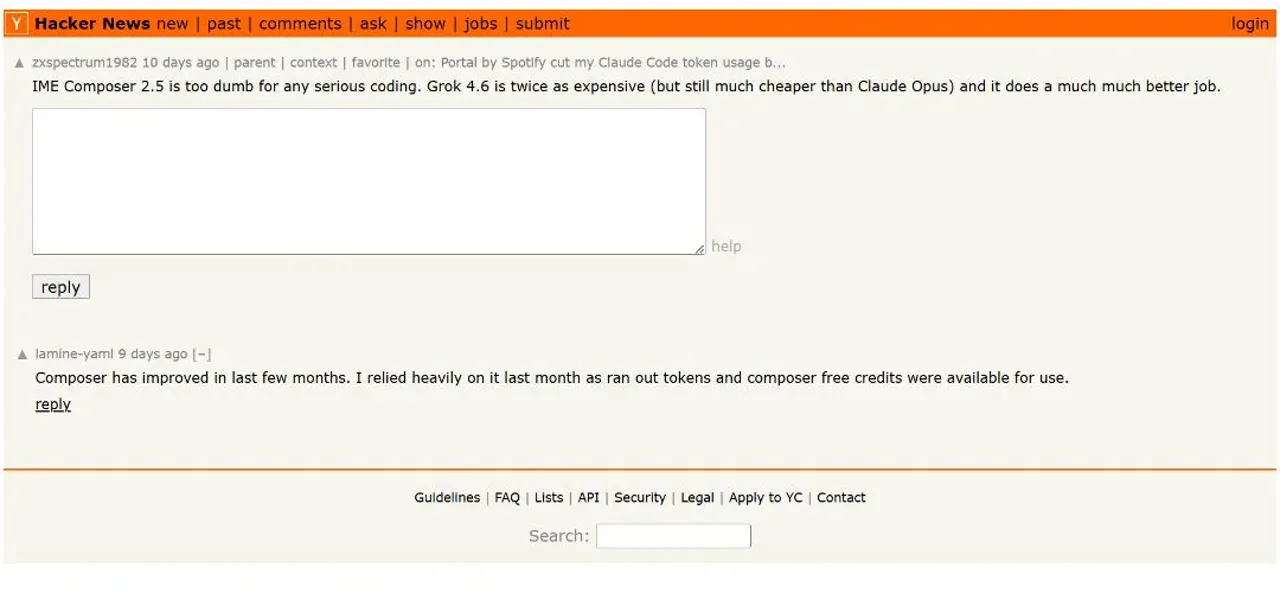
เมื่อวันที่ 5 กันยายน 2569 ผู้ใช้ Hacker News zxspectrum1982 ได้อธิบายว่า Grok 4.6 ทำงานได้ดีกว่า Composer 2.5 อย่างมากในการเขียนโค้ดที่ซับซ้อน แต่ในขณะเดียวกันก็ระบุว่าค่าใช้จ่ายสูงกว่าด้วย นี่เป็นการเปรียบเทียบจากผู้ใช้คนหนึ่งเท่านั้น ไม่ใช่คำกล่าวอ้างเกี่ยวกับประสิทธิภาพโดยทั่วไป.
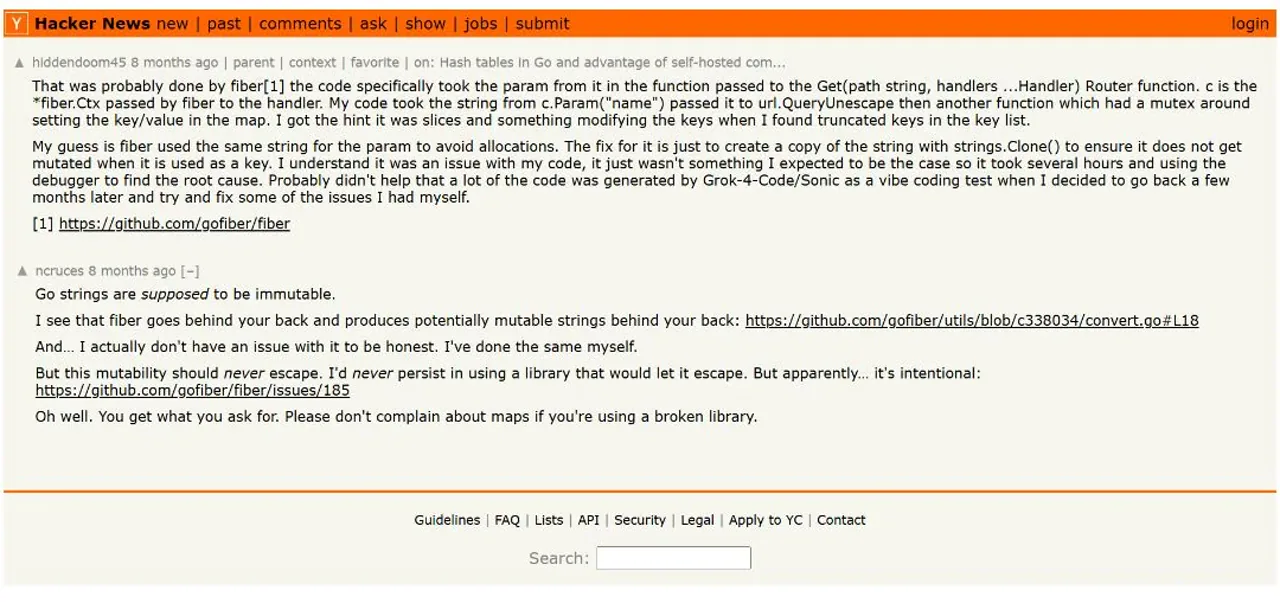
เมื่อวันที่ 20 ธันวาคม 2568 ผู้ใช้ Hacker News hiddendoom45 ได้อธิบายถึงการค้นพบข้อผิดพลาดที่ละเอียดอ่อนเกี่ยวกับอายุการใช้งานของสตริงใน Go/Fiber ในภายหลังโดยใช้ตัวดีบักเกอร์ หลังจากที่โค้ดได้ถูกสร้างขึ้นระหว่างการทดลอง Grok-4-Code/Sonic เรื่องราวทางประวัติศาสตร์นี้สนับสนุนการดีบักด้วยมือและการตรวจสอบที่คำนึงถึงอายุการใช้งาน; แต่ไม่ได้กำหนดอัตราความล้มเหลวของ Grok 4.6.
จุดร่วมไม่ใช่ว่า Grok จะประสบความสำเร็จหรือล้มเหลวเสมอไป แต่เป็นเพราะคุณภาพการเขียนโค้ดจะปรากฏให้เห็นได้ชัดเจนก็ต่อเมื่อโค้ดนั้นถูกนำไปใช้กับงานที่เฉพาะเจาะจง ชุดเครื่องมือ และผู้ตรวจสอบแล้ว สิ่งเดียวกันนี้ก็เกิดขึ้นในส่วนที่แยกต่างหาก การตรวจสอบความเป็นจริงของการเขียนโค้ด ChatGPT: คุณภาพของงานผู้ช่วยไม่สามารถแยกออกจากกระบวนการตรวจสอบได้.
คำถามที่มักถูกถาม
Grok 4 เหมาะสำหรับผู้เริ่มต้นเรียนการเขียนโปรแกรมหรือไม่?
ใช่ครับ สำหรับการอธิบาย ตัวอย่างสั้นๆ และการแก้ไขข้อผิดพลาดภายใต้การแนะนำ ผู้เริ่มต้นควรยังคงรันทุกสแนปเพต ถามว่าแต่ละบรรทัดเปลี่ยนแปลงอะไร และหลีกเลี่ยงการคัดลอกข้อมูลลับหรือการปรับใช้โค้ดที่ไม่คุ้นเคยโดยไม่ผ่านการตรวจสอบ.
ควรใช้รุ่น Grok รุ่นไหนสำหรับการเขียนโค้ด?
ตามข้อมูลที่ตรวจสอบเมื่อวันที่ 11 กันยายน 2026 xAI แนะนำให้ใช้ Grok 4.6 สำหรับโค้ด โปรดตรวจสอบ ID ของโมเดลที่ถูกต้องในผลิตภัณฑ์ของคุณ เนื่องจาก slug API ของ grok-4-0709 ฉบับเดิมได้ถูกยกเลิกแล้ว.
Grok 4.6 สามารถแก้ไขรีโพสิตอรีทั้งหมดได้หรือไม่?
โมเดลนี้สามารถสนับสนุนการทำงานกับรีโพซิทอรีได้เมื่อใช้ภายในเอเจนต์ที่มีการจำกัดสิทธิ์การเข้าถึงไฟล์และคำสั่ง การทดสอบของเราเป็นการทดสอบแบบแยกส่วน ดังนั้นจึงไม่สามารถยืนยันความสามารถในการทำงานแบบอัตโนมัติกับหลายไฟล์หรือความพร้อมสำหรับการใช้งานในสภาพแวดล้อมจริงได้.
การสร้าง Grok นั้นเหมือนกับการใช้ Grok ในแชทหรือไม่?
No. Grok Build เป็นเอเจนต์การเขียนโค้ดแบบโต้ตอบหรือแบบไม่มีอินเทอร์เฟซผู้ใช้ (headless) ที่ทำงานแยกต่างหาก การใช้งานแชทหรือการเติมคำอัตโนมัติผ่าน API ปกติจะไม่ได้รับบริบทของรีโพสิตอรี เทอร์มินัล สิทธิ์การเข้าถึง หรือวงจรเครื่องมือโดยอัตโนมัติ.
ผมสามารถใช้ Grok 4.6 เพื่อเขียนโค้ดบน GlobalGPT ได้ไหม?
ใช่ครับ GlobalGPT ให้บริการเส้นทาง Grok 4.6 ที่ได้รับการตรวจสอบแล้ว สำหรับคำสั่งการเข้ารหัสแบบจำกัดและการเปรียบเทียบโมเดล นี่เป็นแพลตฟอร์มอิสระ และไม่แทนที่ Grok Build IDE หรือเครื่องมือ API ของ xAI เอง.
ผมควรเชื่อถือโค้ดที่สร้างขึ้นโดย Grok โดยไม่ต้องทดสอบมันหรือไม่?
ไม่ครับ ให้รันโค้ด เพิ่มกรณีขอบเขต ตรวจสอบความแตกต่าง และรันการตรวจสอบ lint, type, security และ CI ตามปกติ การปรับโครงสร้างโค้ดของเราดูเรียบร้อย แต่กลับละเว้นฟิลด์ที่จำเป็นในทุกผลลัพธ์ที่ไม่ว่าง.
คำตัดสินสุดท้าย
Grok 4 เหมาะสำหรับการเขียนโค้ดหรือไม่? รุ่น Grok 4.6 ปัจจุบันเป็นผู้ช่วยเขียนโค้ดที่มีประสิทธิภาพสำหรับการแก้ไขข้อผิดพลาดในขอบเขตจำกัด ฟังก์ชันขนาดเล็ก การอธิบาย และการทดสอบรอบแรก ในชุดงานสี่งานของเรา มันได้สร้างผลลัพธ์ที่ถูกต้องสมบูรณ์สองชุด การปรับโครงสร้างโค้ดที่ทำให้พฤติกรรมผิดปกติหนึ่งครั้ง และชุดการทดสอบที่ไม่สมบูรณ์หนึ่งชุด นอกจากนี้ มันยังเพิกเฉยต่อคำสั่งห้ามใช้ Markdown อย่างเคร่งครัดในคำตอบสามครั้ง.
ใช้มันในสถานการณ์ที่การตรวจพบข้อผิดพลาดมีค่าใช้จ่ายต่ำ: ขอบเขตที่จำกัด, สัญญาที่ชัดเจน, ชุดทดสอบที่สามารถรันได้ และการตรวจสอบโดยมนุษย์ อย่าถือว่าหลักฐานนี้เป็นใบอนุญาตสำหรับการเปลี่ยนแปลงในรีโพสิตอรีโดยไม่มีการกำกับดูแล, การอนุมัติด้านความปลอดภัย หรือการปรับใช้ในระบบผลิต.
เพื่อทดลองใช้จริง, เปิด Grok 4.6 บน GlobalGPT, ลองรันคำสั่งใดคำสั่งหนึ่งจากตัวอย่างที่ครบถ้วนข้างต้น และเปรียบเทียบผลลัพธ์กับผลการทดสอบของคุณเอง ก่อนที่จะตัดสินใจว่ามันควรถูกเพิ่มเข้าไปในกระบวนการทำงานของคุณหรือไม่.