
รีวิว Claude Opus 5.5: ราคา, ผลทดสอบประสิทธิภาพ, และการทดสอบ API ในสภาพจริง
Claude Opus 5.5 ผสมผสานหน้าต่างบริบทขนาด 1 ล้านโทเคน กับราคา API $4 / $20 ต่อ 1 ล้านโทเคน บทวิเคราะห์นี้แยกแยะระหว่างข้อมูลที่ Anthropic ได้เผยแพร่ไว้ ผลการทดสอบประสิทธิภาพจากแหล่งอิสระ และผลการทดสอบโดยตรง 5 ครั้งผ่านทาง Messages API.
ผลการวัดนั้นเป็นค่าเฉพาะ. สามงานให้ผลลัพธ์ที่ชัดเจนและใช้งานได้; งานเขียนโค้ดให้ผลลัพธ์ที่มีประโยชน์ แต่ถึงขีดจำกัด 1,024 โทเคนแรก; ส่วนการเขียนภาษาจีนให้ผลลัพธ์เป็นข้อความที่ผิดเพี้ยนบนเส้นทางที่ทดสอบ ตัวอย่างนี้แสดงพฤติกรรมและขีดจำกัดของเส้นทางอย่างชัดเจน ไม่ใช่สัดส่วนความสำเร็จทั่วไป.
คำตอบสั้นๆ
- ประสิทธิภาพ: Anthropic แสดงประสิทธิภาพระดับ Fable 5.1 ในงานส่วนใหญ่ ส่วน Artificial Analysis ได้คะแนนดัชนีความฉลาด (Intelligence Index) 58 เมื่อทำงานด้วยความพยายามสูงสุด ส่วนหลักฐานเกี่ยวกับทักษะการตัดสินใจของ METR ซึ่งมีความเฉพาะเจาะจงมากขึ้น ไม่แสดงให้เห็นถึงการปรับปรุงที่ชัดเจนเมื่อเทียบกับ Fable 5.1.
- ราคา: อัตรา API อย่างเป็นทางการคือ $4 ต่อหนึ่งล้านโทเคนเข้า และ $20 ต่อหนึ่งล้านโทเคนออก. การอ่านแคชมีค่าใช้จ่าย $0.20 ต่อหนึ่งล้านครั้ง; การเขียนแคชทุก 5 นาทีมีค่าใช้จ่าย $5 ต่อหนึ่งล้านครั้ง.
- ผลลัพธ์จากการทดลองจริง: การสกัดข้อความยาว, JSON แบบเคร่งครัด และการให้เหตุผลทางคณิตศาสตร์ ได้ผ่านการทดสอบในรอบที่บันทึกไว้ การเขียนโค้ดมีประโยชน์ แต่ถูกตัดสั้นที่ขีดจำกัดเริ่มต้น ผลลัพธ์สำหรับภาษาจีนถูกบันทึกว่าเป็นปัญหาด้านเส้นทาง/การเข้ารหัส ไม่ใช่การตัดสินระดับภาษาของโมเดล.
- คำเตือน API: ไม่สามารถปิดฟังก์ชันการคิดได้ การบังคับใช้เครื่องมือจะก่อให้เกิดข้อผิดพลาด บล็อกการคิดถูกผูกติดกับโมเดลและการสนทนา และเวอร์ชันเก่า
computer_20251124เครื่องมือนี้ไม่ได้รับการยอมรับบน API Claude และ Google Cloud route.

เนื้อหาในเอกสารอย่างเป็นทางการระบุว่า
หน้าประกาศของ Anthropic ระบุวันที่ Claude Opus 5.5 เป็นวันที่ 22 กันยายน 2026 และอธิบายว่าเป็นโมเดลแรกในตระกูล Claude 5.5 ประกาศดังกล่าวระบุว่าประสิทธิภาพของรุ่นนี้อยู่ในระดับเดียวกับ Claude Fable 5.1 สำหรับงานส่วนใหญ่ มีค่าใช้จ่ายสำหรับงานทั่วไปต่ำกว่า Opus 5 ถึง 40% และให้ผลลัพธ์เร็วกว่า Opus 5 มากกว่า 30% ข้อมูลดังกล่าวเป็นคำกล่าวอ้างจากผู้ผลิต ดังนั้นจึงแสดงแยกต่างหากจากหลักฐานอิสระและผลการทดสอบจริงที่นำเสนอด้านล่าง.
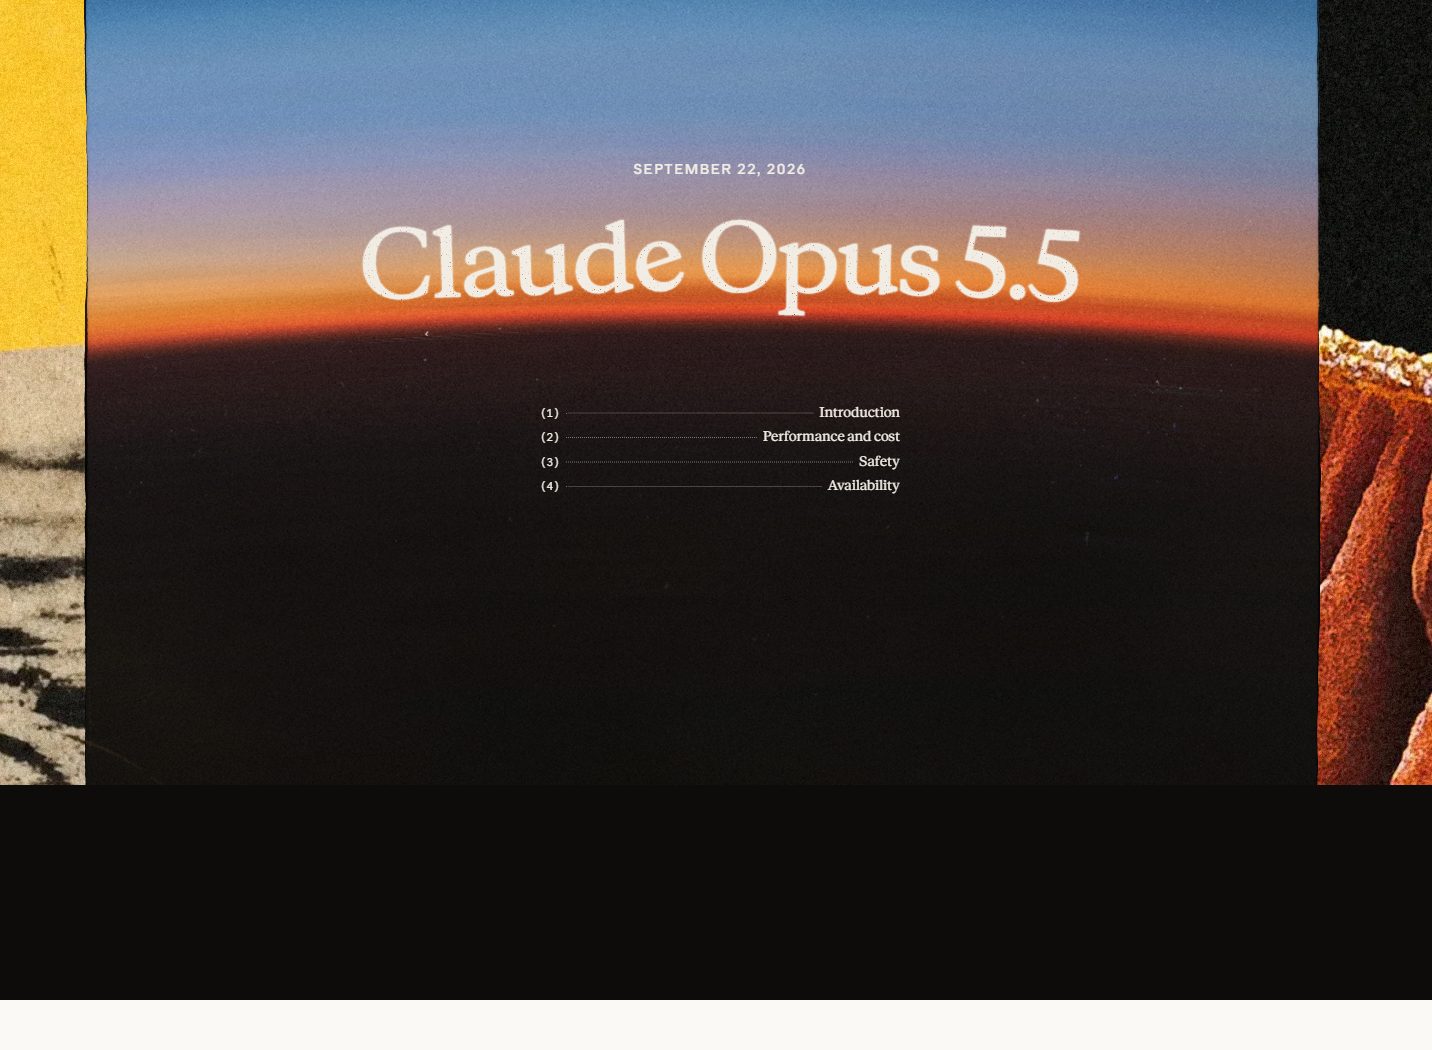
The เอกสารเกี่ยวกับแพลตฟอร์ม Claude ระบุ ID ของโมเดล API เป็น claude-opus-5-5, หน้าต่างบริบทขนาด 1 ล้านโทเคน, ปริมาณผลลัพธ์สูงสุด 128K, และระบบคิดแบบปรับตัวที่ทำงานอยู่ตลอดเวลา เอกสารยังระบุถึงการเปลี่ยนแปลงที่ส่งผลต่อการผสานรวม Opus 5 ที่มีอยู่ ซึ่งได้อธิบายไว้ในส่วนการย้ายระบบด้านล่าง.
หลักฐานด้านประสิทธิภาพ
ที่นี่ไม่มีตัวเลข “ประสิทธิภาพ” เดียวที่ชัดเจน แหล่งข้อมูลสาธารณะทั้งสามนี้วัดสิ่งต่างกัน ดังนั้นแต่ละการ์ดจึงแสดงตัวชี้วัดและขอบเขตข้อมูลอ้างอิงของตัวเองให้เห็นได้ชัดเจน.
ประกาศ Anthropic
สัญญาณที่เผยแพร่: Anthropic ระบุว่า Opus 5.5 มีประสิทธิภาพเทียบเท่ากับ Claude Fable 5.1 ในงานส่วนใหญ่ มีค่าใช้จ่ายน้อยกว่า Opus 5 ถึง 40% สำหรับงานทั่วไป และให้ผลลัพธ์เร็วกว่ามากกว่า 30%.
ขอบเขต: ตัวอย่างการกำหนดตำแหน่งและตัวอย่างการทดสอบที่เผยแพร่โดยผู้ให้บริการ ไม่ใช่การทดสอบประสิทธิภาพแบบอิสระ.
การวิเคราะห์เทียม
สัญญาณที่เผยแพร่: ผลวัดประสิทธิภาพสูงสุด (max-effort snapshot) แสดงค่า 59.6% บน Terminal-Bench 4.0, 61.4% บน Humanity’s Last Exam และ 66.9% บน SciCode.
ขอบเขต: คะแนนขึ้นอยู่กับความพยายาม, การใช้ฮาร์เนส, วันที่ และคำนิยามของตัววัด คะแนนเหล่านี้ไม่สามารถคาดการณ์ทุกคำสั่งของ API ได้.
การประเมินก่อนการติดตั้ง METR
สัญญาณที่เผยแพร่: METR ระบุว่าหลักฐานที่บริษัทรวบรวมได้ไม่แสดงให้เห็นถึงการปรับปรุงที่ชัดเจนเมื่อเทียบกับ Fable 5.1 ในด้านทักษะการตัดสินใจที่บริษัทได้ตรวจสอบ แต่ยังคงคาดการณ์ว่าจะมีการเร่งความเร็วอย่างมีนัยสำคัญสำหรับงานวิจัยและพัฒนาบางด้าน.
ขอบเขต: นี่เป็นการประเมินที่จำกัดกว่าเกี่ยวกับความสามารถในการตัดสินใจและการเร่งความเร็วในการทำงาน ไม่ใช่การจัดอันดับคุณภาพอย่างครบถ้วน.
เมื่อพิจารณาข้อมูลทั้งหมดร่วมกัน ข้อมูลเหล่านี้สนับสนุนข้อสรุปที่จำกัดว่า: Opus 5.5 เป็นแบบจำลองชั้นนำในหลายการประเมินสาธารณะที่ดำเนินการในอดีต แต่ขนาดของข้อได้เปรียบจะเปลี่ยนแปลงไปตามประเภทงาน ระดับความพยายาม และรูปแบบการประเมิน ข้อมูลเหล่านี้ไม่ได้ชี้ให้เห็นถึงผลลัพธ์ของ “แบบจำลองที่ดีที่สุด” ที่ใช้ได้ทั่วไป.
Claude Opus 5.5 ราคาและหน่วยการคิดค่าบริการ
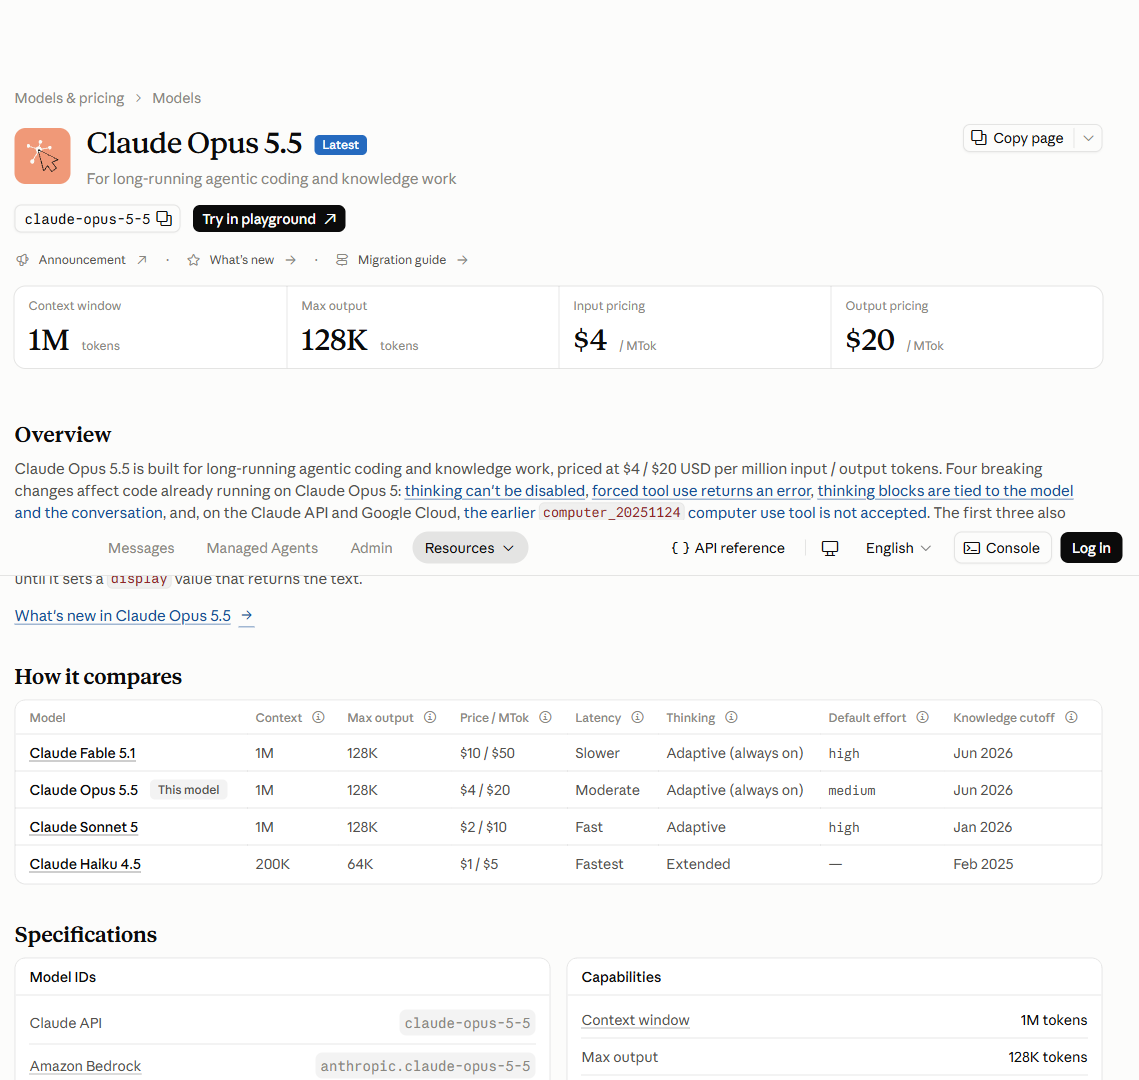
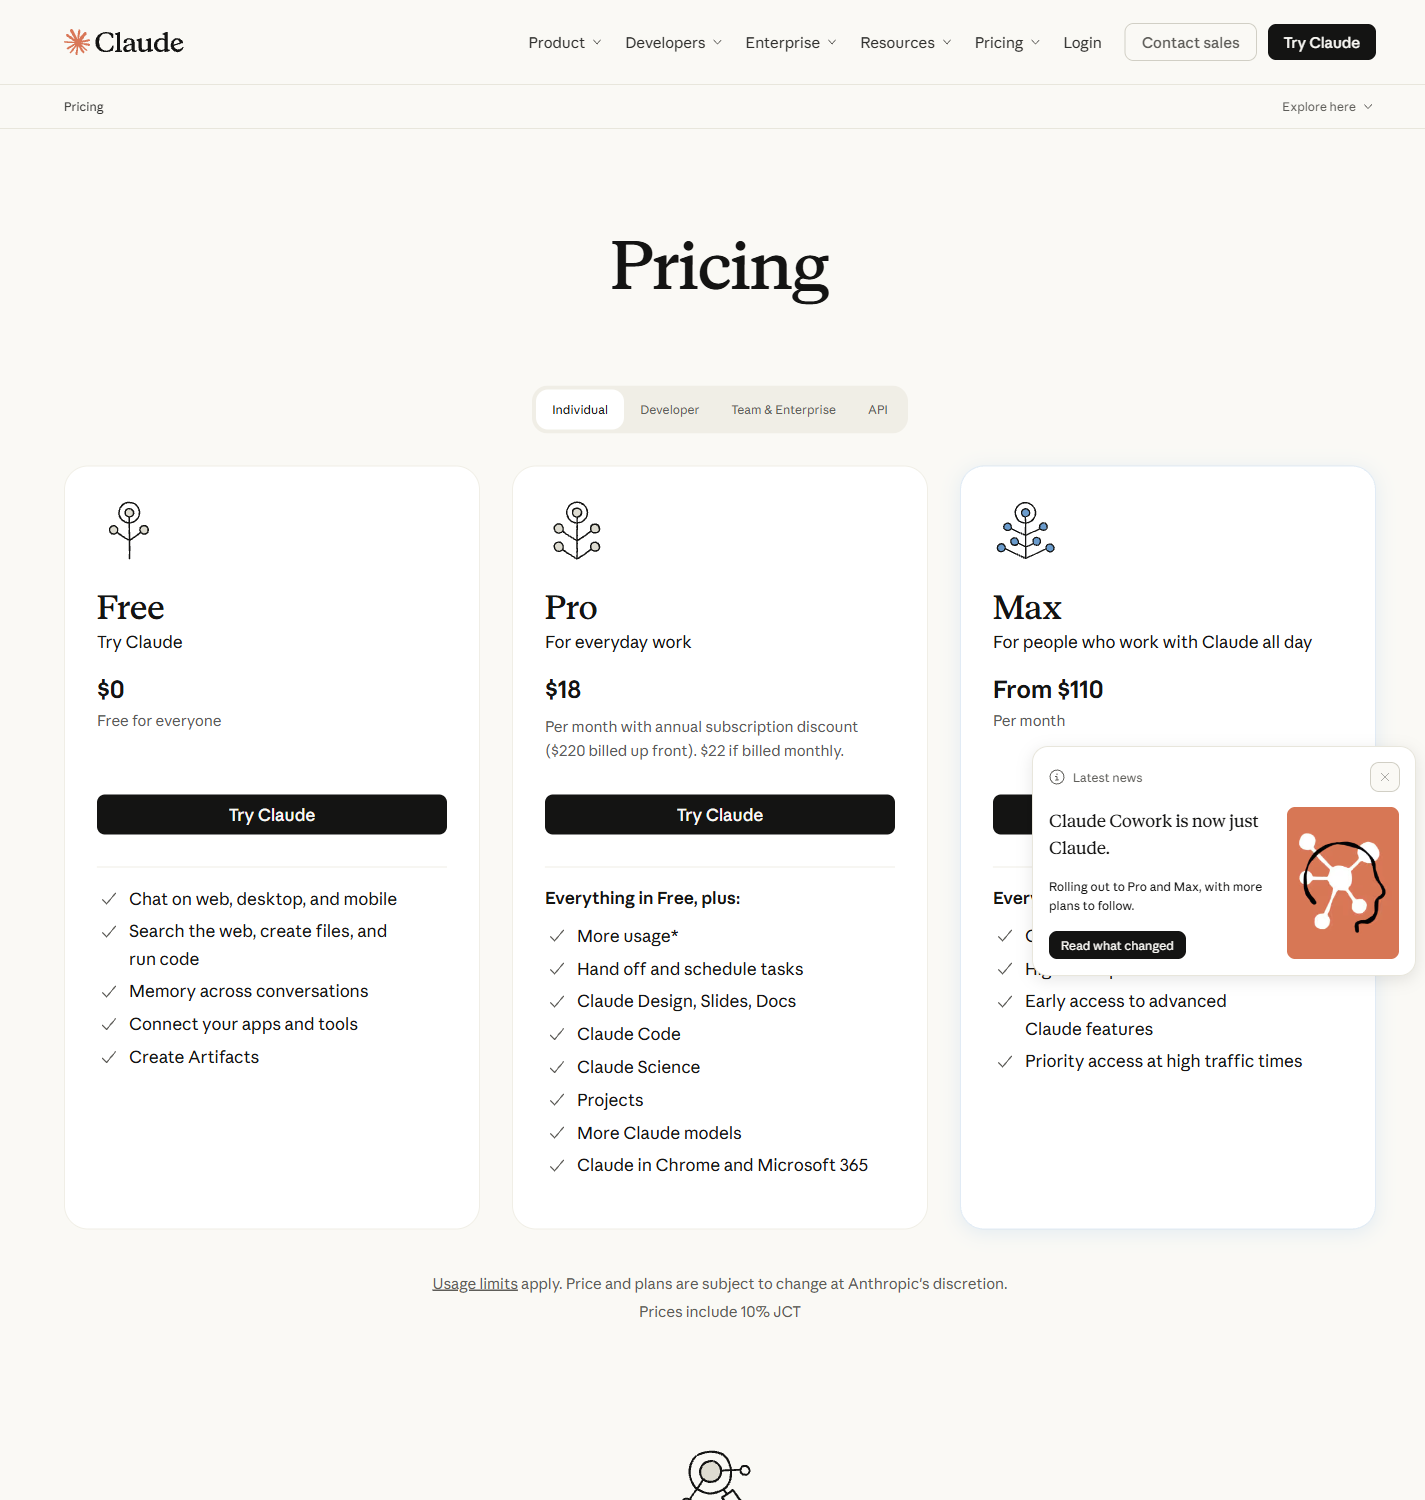
ราคา API และราคาสมัครสมาชิกของผู้ใช้ เป็นผลิตภัณฑ์ที่ต่างกัน ตัวเลข API ด้านล่างคือราคาต่อหน่วยที่ใช้ในการจัดงบประมาณโทเคน ส่วนตัวเลขของผู้ใช้คือบัตรแผนบริการที่ปรากฏในบริเวณเบราว์เซอร์ที่ถูกจับภาพ.
ราคา API อย่างเป็นทางการ
การประมาณการอย่างง่าย: 10,000 โทเคนเข้าบวกกับ 2,000 โทเคนออก เท่ากับประมาณ $0.08 ตามอัตราปกติ ก่อนหักค่าแคช ค่าแบทช์ ภาษี หรือค่าเพิ่มของแพลตฟอร์ม.
ภาพหน้าจอของแผนบริการสำหรับผู้บริโภค
หน้าเว็บที่บันทึกไว้ยังแสดงหมายเหตุ 10% JCT ด้วย ซึ่งค่าที่แสดงเหล่านี้เป็นค่าที่ขึ้นอยู่กับภูมิภาค ไม่ใช่คำมั่นสัญญาด้านราคาแบบทั่วโลก.
หากต้องการคำอธิบายเพิ่มเติมเกี่ยวกับระบบการคิดค่าบริการแบบโทเคนและค่าใช้จ่ายของหน้าต่างบริบท โปรดดูที่ คู่มือราคาและบริบทของ GPT-5.5. อัตราค่าบริการ API ของผู้ให้บริการ ราคาการสมัครสมาชิก และยอดเครดิตของแพลตฟอร์มแบบหลายโมเดล ควรถูกแยกไว้อย่างชัดเจนในงบประมาณของคุณ.
การทดสอบแบบปฏิบัติจริง: บัตรผลลัพธ์ 5 ภารกิจ
เมื่อวันที่ 23 กันยายน 2569 เราได้ส่งคำสั่งห้าคำสั่งที่อิสระผ่านเส้นทาง API Messages ที่ได้รับการควบคุมเดียวกัน โดยใช้ ID ของโมเดล claude-opus-5-5. การประมวลผลครั้งแรกใช้ max_tokens: 1024. เราได้บันทึกเวลาที่ผ่านไปในแต่ละขั้นตอน จำนวนโทเคนเข้า/ออก เหตุผลที่ระบบหยุดทำงาน ความถูกต้อง และการปฏิบัติตามรูปแบบตัวอักษรอย่างเคร่งครัด หลังจากรอบแรกเผยให้เห็นปัญหาในการออกผลลัพธ์ของเส้นทางนี้ เราได้ดำเนินการทดสอบงานเขียนภาษาจีนอีกครั้ง โดยกำหนดขีดจำกัดสูงสุดที่ 4,096 โทเคน นี่เป็นตัวอย่างจาก 5 งาน ไม่ใช่การประเมินความน่าเชื่อถือ.
มันสามารถซ่อมแซมฟังก์ชันการลบข้อมูลซ้ำแบบผสมได้หรือไม่?
การตั้งค่างาน
หาข้อผิดพลาดในโค้ด Python dedupe ฟังก์ชัน, จัดการค่าที่ไม่ใช่สตริงและค่าที่ไม่สามารถแฮชได้, รักษาการสะกดแบบแรกไว้ และจัดเตรียมการทดสอบ.
คำตอบดังกล่าวได้ระบุถึง .lower() เกิดข้อผิดพลาดเมื่อใช้ค่าที่ไม่ใช่สตริง จึงเปลี่ยนสตริงเป็น casefold(), ได้เพิ่มตัวเลือกสำรองที่ไม่สามารถแฮชได้ และส่งคืนโค้ดที่แก้ไขแล้วพร้อมทั้งกรณีทดสอบ.
คำตอบหยุดอยู่ที่ขีดจำกัด 1,024 โทเคน การแก้ไขนี้มีประโยชน์ แต่การตั้งค่ามีขนาดเล็กเกินไปสำหรับการตรวจสอบโค้ดอย่างครบถ้วน.
คำตัดสินของ Card: ได้รับคำตอบที่มีประโยชน์ทางเทคนิคแล้ว; การรันครั้งนี้ไม่สามารถสนับสนุนข้ออ้างเกี่ยวกับความล่าช้าหรือความครบถ้วนได้ เนื่องจากขีดจำกัดของโทเค็นได้ตัดข้อมูลออก.
มันสามารถรักษาข้อเท็จจริงและทดสอบข้อจำกัดได้หรือไม่?
การตั้งค่างาน
คัดลอกข้อค้นพบ 5 ข้อที่มีหมายเลขจากบันทึกการประเมินสั้น ๆ โดยรวมถึงวิธีการและสิ่งที่รอบการประเมินถัดไปไม่ได้วัด.
ได้ผลลัพธ์เป็นลูกกระสุนที่มีหมายเลขทั้งหมดห้าลูกอย่างแม่นยำ โดยยังคงรักษาการเปรียบเทียบของผู้ช่วย วิธี 20 ข้อแนะนำ และช่องว่างที่เกี่ยวข้องกับการเก็บรักษาข้อมูลในระยะยาวและการเปลี่ยนลูกค้าเป็นลูกค้าจริง.
นี่เป็นแพ็กแหล่งข้อมูลขนาดเล็ก ดังนั้นจึงไม่ทดสอบหน้าต่างบริบทขนาด 1M.
คำตัดสินของ Card: การสกัดข้อมูลที่สะอาด โดยรักษาจำนวนที่ขอไว้และขอบเขตหลักฐานของบันทึกต้นฉบับ.
มันสามารถส่งผลลัพธ์ที่เครื่องอ่านได้โดยไม่ต้องทำความสะอาดหรือไม่?
การตั้งค่างาน
ส่งคืนอ็อบเจ็กต์ JSON แบบคงที่ ซึ่งประกอบด้วยชื่อเรื่อง กลุ่มเป้าหมาย ข้อดีสองข้อ ข้อเสียสองข้อ และข้อสรุป ไม่ได้รับอนุญาตให้ใช้เครื่องหมายล้อม Markdown.
ส่งคืน JSON ที่สามารถวิเคราะห์ได้ พร้อมด้วยคีย์ที่ขอไว้ ข้อดีสองข้อ ข้อเสียสองข้อ และคำแนะนำที่กระชับ ไม่มีการใช้ Markdown wrapper.
คำตอบที่ถูกต้องเพียงหนึ่งข้อ ไม่สามารถพิสูจน์ความน่าเชื่อถือของสคีมาในวัตถุที่มีขนาดใหญ่กว่าหรือวัตถุที่ซ้อนกันได้.
คำตัดสินของ Card: การตรวจสอบความสอดคล้องกับ JSON ตามตัวอักษรได้ผ่านในการรันครั้งนี้.
มันสามารถใช้กฎการปัดเศษแบบซ้ำได้อย่างถูกต้องหรือไม่?
การตั้งค่างาน
เริ่มด้วย 12 รายการ คูณแต่ละชุดถัดไปด้วย 1.25 ปัดลงหลังแต่ละชุด และรายงานผลรวมของทั้งสี่ชุด.
ได้ผลลัพธ์เป็น 12, 15, 18 และ 22 แล้วนำมารวมกันเป็น 67. การคำนวณระดับกลางนั้นเห็นได้ชัดเจน.
งานนี้มีความแน่นอนและขนาดเล็ก; มันไม่สะท้อนถึงประสิทธิภาพการคิดวิเคราะห์อย่างกว้างขวาง.
คำตัดสินของ Card: ผลลัพธ์ที่ถูกต้องและขั้นตอนระหว่างทางที่โปร่งใส.
เส้นทางที่ทดสอบแล้วให้ผลลัพธ์เป็นข้อความภาษาจีนที่สามารถใช้งานได้หรือไม่?
การตั้งค่างาน
เขียนบทนำสำหรับบทรีวิวภาษาจีนที่แยกส่วนคำกล่าวอ้างอย่างเป็นทางการ ราคา ข้อมูลการเปรียบเทียบประสิทธิภาพ และการทดสอบจริง.
โครงสร้างการตอบกลับมีอยู่ แต่ตัวอักษรจีนในผลลัพธ์ที่บันทึกไว้ถูกส่งกลับมาในสภาพผิดเพี้ยนผ่านเส้นทางที่ทดสอบ.
หลักฐานดังกล่าวไม่แยกแยะคุณภาพภาษาของโมเดลออกจากเส้นทางหรือพฤติกรรมการเข้ารหัส ไม่มีการกำหนดคะแนนคุณภาพภาษาจีน.
คำตัดสินของ Card: ข้อความที่ส่งกลับมาในเส้นทางนี้ใช้ไม่ได้; โปรดรันใหม่ด้วยเส้นทาง UTF-8 ที่ได้รับการตรวจสอบแล้ว ก่อนที่จะอ้างว่าคุณภาพภาษาถูกต้อง.
ในทั้งสี่รอบการทดสอบที่ไม่ขึ้นอยู่กับภาษาหรือใช้ภาษาอังกฤษ ค่าเฉลี่ยท้องถิ่นอยู่ที่ 6.24 วินาที ตัวเลขนี้แสดงถึงคำขอห้าครั้งติดต่อกันบนเส้นทางเดียว และไม่ใช่ความล่าช้าด้านผู้ให้บริการ พฤติกรรมที่สังเกตได้ชัดเจนที่สุด ได้แก่ การสกัดข้อมูลที่กระชับ การปฏิบัติตามรูปแบบ JSON ตามตัวอักษร และการคำนวณทางคณิตศาสตร์ที่ถูกต้อง ส่วนปัญหาสองข้อที่ยังไม่ได้รับการแก้ไข ได้แก่ ความกดดันด้านงบประมาณผลลัพธ์ในการเขียนโค้ด และผลลัพธ์ภาษาจีนที่ผิดเพี้ยนบนเส้นทางที่ทดสอบ.
ข้อควรระวังเกี่ยวกับ API และการย้ายระบบ
คำตอบสั้นๆ นี้รวมถึงปัจจัยเหล่านี้ เพราะพวกมันสามารถส่งผลต่อการผสานรวมได้ แม้คุณภาพข้อความของโมเดลจะดูดีก็ตาม.
- สมองทำงานอยู่ตลอดเวลา. ใช้พารามิเตอร์ effort ที่ระบุไว้ในเอกสารเพื่อควบคุมความลึก ความล่าช้า และค่าใช้จ่าย; ไม่มีปุ่มปิด.
- การใช้เครื่องมือแบบบังคับจะส่งผลให้เกิดข้อผิดพลาด. โค้ดที่มีอยู่ซึ่งต้องการการเลือกเครื่องมือแบบบังคับ ต้องมีการทดสอบการย้ายระบบแยกต่างหาก.
- บล็อกความคิดนั้นเกี่ยวข้องกับการสร้างแบบจำลองและการสนทนา. อย่าคิดว่าบล็อกการคิดสามารถใช้ซ้ำได้หลังจากเปลี่ยนโมเดลแล้ว.
computer_20251124ไม่ได้รับการยอมรับ ตาม API Claude และเส้นทาง Google Cloud ที่ระบุไว้ในเอกสาร.- การกำหนดขีดจำกัดผลผลิตนั้นสำคัญ. บัตรรหัสแสดงให้เห็นว่าคำตอบที่มีประโยชน์อาจถูกตัดออกได้แม้เพียงเล็กน้อย
จำนวนโทเค็นสูงสุดค่า. - โหมด Batch และโหมด Fast เป็นระบบการคิดค่าบริการที่แยกกัน. ให้แยกส่วนลดหรือค่าเพิ่มออกจากราคาโทเคนมาตรฐาน.
คำพิพากษาที่อิงตามหลักฐาน
Claude Opus 5.5 มีข้อมูลผลการทดสอบประสิทธิภาพสาธารณะที่ชัดเจนและอัตรา API มาตรฐานที่ประกาศไว้ต่ำกว่าตัวเลขของ Opus 5 ที่แสดงในประกาศของ Anthropic ใน 5 ครั้งการทดสอบที่บันทึกไว้ ระบบนี้ให้ผลลัพธ์การสกัดข้อมูลที่ชัดเจน JSON ที่ถูกต้องตามมาตรฐาน และการคำนวณทางคณิตศาสตร์; คำตอบด้านการเขียนโค้ดมีประโยชน์แต่ถูกตัดทอนเนื่องจากข้อจำกัดของเพดานเริ่มต้น; และผลลัพธ์ภาษาจีนไม่สามารถใช้งานได้ผ่านวิธีการที่ทดสอบ.
ดังนั้น ข้อสรุปที่สามารถสนับสนุนได้จึงมีขอบเขตที่จำกัด: โมเดลนี้แสดงให้เห็นถึงความสามารถในการปฏิบัติตามคำสั่งอย่างแข็งแกร่งในหลายงานขนาดเล็ก ในขณะที่เส้นทางและโครงสร้างที่นำมาใช้ก่อให้เกิดข้อจำกัดที่เห็นได้ชัด การตัดสินใจเกี่ยวกับการย้ายระบบใด ๆ ควรทำซ้ำคำสั่งเดียวกันด้วยงบประมาณผลลัพธ์ที่เหมาะสม ตรวจสอบการเรียกใช้เครื่องมือ และแยกอัตราโทเค็นอย่างเป็นทางการออกจากเครดิตการสมัครสมาชิกหรือเครดิตของแพลตฟอร์ม.
หากต้องการเส้นทางอื่นเพื่อเปรียบเทียบ, การเปรียบเทียบรูปแบบการทดสอบ DeepSeek V4 Pro กับ Flash แสดงให้เห็นว่าผลการตัดสินในระดับงานสามารถแยกออกจากข้ออ้างที่ครอบคลุมทั้งโมเดลได้อย่างไร ส่วน คู่มือกรณีการใช้งาน GPT-5.5 เพิ่มจุดอ้างอิงที่เน้นไปที่งาน ส่วน หมายเหตุเกี่ยวกับผลการทดสอบประสิทธิภาพ Flash ของ Gemini และ คู่มือเปรียบเทียบแบบจำลอง AI ให้บริบทของโมเดลที่อยู่ใกล้เคียง สำหรับการเข้าถึงหลายโมเดล ดูที่ แพ็กเกจสมัครสมาชิก AI แบบครบวงจร และ การเปรียบเทียบแพลตฟอร์มแบบหลายโมเดล.
คำถามที่มักถูกถาม
ราคาของ Claude Opus 5.5 เป็นเท่าไร?
อัตรา API อย่างเป็นทางการคือ $4 ต่อหนึ่งล้านโทเคนเข้า และ $20 ต่อหนึ่งล้านโทเคนออก การอ่านแคชมีอัตรา $0.20 ต่อหนึ่งล้านโทเคน ส่วนการเขียนแคชทุก 5 นาทีมีอัตรา $5 ต่อหนึ่งล้านโทเคน.
หน้าต่างบริบท Claude Opus 5.5 คืออะไร?
เอกสารของแพลตฟอร์ม Claude ระบุว่ามีหน้าต่างบริบทขนาด 1 ล้านโทเคน และปริมาณผลออกสูงสุด 128K โทเคน ส่วนเส้นทางเบต้าที่ได้รับการบันทึกไว้แยกต่างหากนั้น รองรับปริมาณผลออกสูงสุด 300K โทเคน สำหรับ Message Batches.
Claude Opus 5.5 ดีกว่า Opus 5 หรือไม่?
Anthropic รายงานว่าค่าใช้จ่ายในการทำงานทั่วไปต่ำลงและผลลัพธ์ออกเร็วขึ้น ส่วนการประเมินจากฝ่ายอิสระแสดงให้เห็นผลลัพธ์ที่ดีในหลายงานที่เก่าแล้ว ขนาดของการปรับปรุงคุณภาพขึ้นอยู่กับเกณฑ์การวัดผล การตั้งค่าความพยายาม ข้อความคำสั่ง และวิธีการ.
สามารถปิดการคิดได้หรือไม่?
ไม่ครับ เอกสารของรุ่นปัจจุบันระบุว่า การคิดแบบปรับตัวจะเปิดอยู่ตลอดเวลา ให้ใช้พารามิเตอร์ effort เพื่อควบคุมความลึกของการคิด ความล่าช้า และค่าใช้จ่าย.
งาน API ทั้งห้าได้พิสูจน์ความน่าเชื่อถือแล้วหรือไม่?
ไม่ครับ การ์ดเหล่านี้แสดงพฤติกรรมและข้อจำกัดในการกำหนดค่าอย่างชัดเจน แต่การทดสอบห้าภารกิจไม่สามารถประเมินอัตราความสำเร็จโดยทั่วไปได้ ส่วนปัญหาขีดจำกัดการเขียนโค้ดและปัญหาเส้นทางภาษาจีนถูกรายงานแยกกัน.
บทวิจารณ์นี้พิสูจน์ได้หรือไม่ว่าสินค้าจีนมีคุณภาพดี?
ไม่ครับ เส้นทางที่ทดสอบแล้วแสดงข้อความภาษาจีนที่ผิดเพี้ยน ดังนั้นผลลัพธ์จึงถูกบันทึกไว้ว่าเป็นปัญหาด้านการเข้ารหัสหรือเส้นทาง จนกว่าจะมีการทดสอบใหม่ด้วย UTF-8 ที่ได้รับการยืนยันแล้ว.









