GPT-5.5 คือโมเดลแนวหน้าของ OpenAI สำหรับงานระดับมืออาชีพที่ซับซ้อน, โดยเฉพาะอย่างยิ่ง วิศวกรรมซอฟต์แวร์ การวิเคราะห์บริบทระยะยาว ตัวแทนที่ใช้เครื่องมือหนัก การสังเคราะห์งานวิจัย และกระบวนการทำงานที่ติดต่อกับลูกค้า ตามที่ เอกสารประกอบโมเดล GPT-5.5 ของ OpenAI, รหัสแบบจำลองคือ gpt-5.5, พร้อมการป้อนข้อมูลทั้งข้อความและรูปภาพ, การส่งออกข้อความ, หน้าต่างบริบทขนาด 1,050,000 โทเคน, และโทเคนผลลัพธ์สูงสุด 128,000 โทเคน.
สำหรับผู้ที่ค้นหาคำว่า “GPT-5.5 คืออะไร?” นี่คือ ประเด็นสำคัญ:
- มันคืออะไร: GPT-5.5 คือโมเดลแนวหน้าของ OpenAI สำหรับงานระดับมืออาชีพที่ซับซ้อน.
- การเข้าถึง: OpenAI รายการ
gpt-5.5ในเอกสาร API อย่างเป็นทางการ. - การกำหนดราคา: GPT-5.5 มีราคาสูงกว่า GPT-5.4 และ GPT-5.4 mini.
- ข้อจำกัด: มันไม่เหมาะสำหรับทุกงาน; ค่าใช้จ่าย, ความล่าช้า, ข้อจำกัดในการปรับแต่ง, และข้อจำกัดของรูปแบบข้อมูลต้นฉบับมีความสำคัญ.
- เมื่อเปรียบเทียบกับ GPT-5.4: GPT-5.5 มีความแข็งแกร่งมากขึ้นสำหรับการเขียนโค้ดที่ยากขึ้น การใช้เครื่องมือ การทำงานในบริบทยาว และการให้เหตุผล.
สำหรับผู้ใช้ส่วนใหญ่ คำถามที่แท้จริงคือ ที่ GPT-5.5 สามารถนำไปใช้ในกระบวนการทำงานจริงได้. หากคุณกำลังเปรียบเทียบ GPT-5.5 กับ Claude, Gemini, Perplexity หรือโมเดล AI อื่นๆ, นี่คือพื้นที่ทำงานแบบหลายโมเดล — โกลบอลจีพีที. คุณสามารถทดสอบข้ามรุ่นต่างๆ เพื่อดูว่ารุ่นใดทำงานได้ดีที่สุดสำหรับงานของคุณด้วยแผนพื้นฐานที่เริ่มต้นประมาณ $5.8.

GPT-5.5 คืออะไร
GPT-5.5 เหมาะสมมากกว่าสำหรับ กระบวนการทำงานในการผลิต มากกว่าการทดลองแบบไม่เป็นทางการเพียงอย่างเดียว มันมีประโยชน์มากที่สุดเมื่อภารกิจประกอบด้วย:
- ข้อจำกัดหลายประการ ซึ่งต้องปฏิบัติตามในเวลาเดียวกัน
- เนื้อหาต้นฉบับยาว, เช่น รายงาน สัญญา เอกสาร หรือฐานโค้ด
- การเรียกใช้เครื่องมือ, เช่น การค้นหา การเรียกคืนไฟล์ การประมวลผลโค้ด หรือผลลัพธ์ที่มีโครงสร้าง
- ผลงานสุดท้ายคุณภาพสูง, เช่น แผนงาน สรุป การเปรียบเทียบ บทวิจารณ์ หรือคำตอบที่ส่งถึงลูกค้า
งาน GPT-5.5 ที่มีความซับซ้อนมักจะเริ่มต้นอย่างยุ่งเหยิง ผู้ใช้อาจมีบริบทที่ไม่สมบูรณ์ ข้อกำหนดที่ขัดแย้งกัน หรือจำเป็นต้องอ้างอิงหลักฐาน GPT-5.5 สร้างคุณค่าโดยการเปลี่ยนความซับซ้อนนั้นให้กลายเป็นขั้นตอนถัดไปที่ชัดเจน.
พื้นฐานของแบบจำลองอย่างเป็นทางการ
โอเพ่นเอไอ‘หน้าอย่างเป็นทางการของโมเดลระบุว่า GPT-5.5 มีคุณสมบัติหลักดังต่อไปนี้:
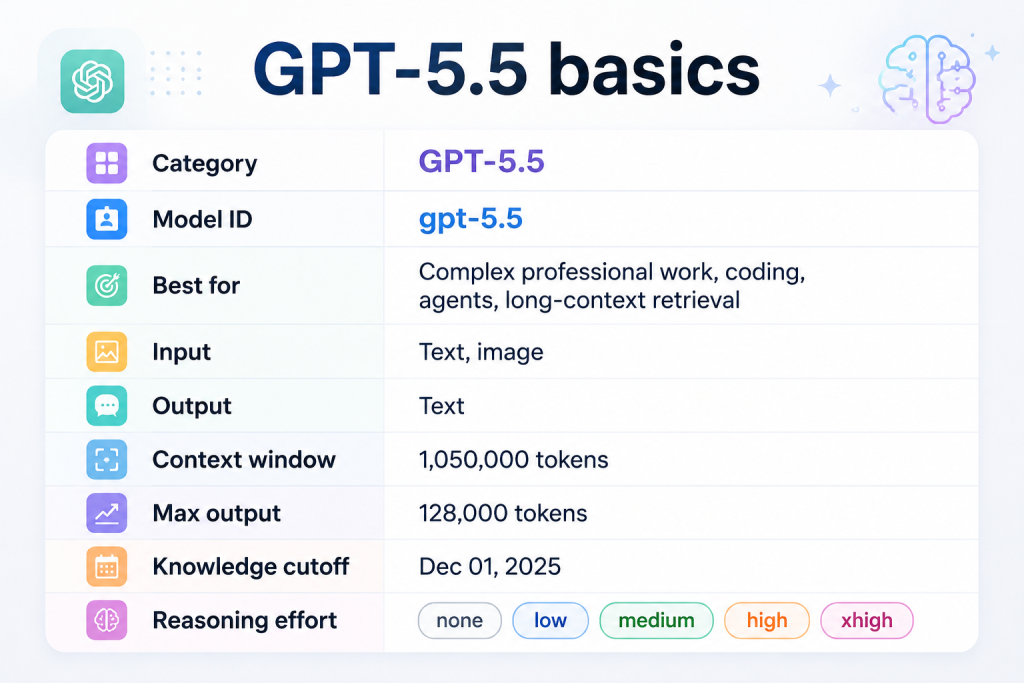
รายละเอียดเหล่านี้มีความสำคัญเพราะพวกมันกำหนด สิ่งที่ GPT-5.5 สามารถทำได้และไม่สามารถทำได้:
- ความพยายามในการให้เหตุผลที่ปรับแต่งได้ ช่วยให้ทีมสามารถบาลานซ์คุณภาพ, ความล่าช้า, และค่าใช้จ่ายได้.
- การป้อนข้อความและรูปภาพ หมายความว่า GPT-5.5 สามารถประมวลผลข้อมูลภาพในกระบวนการทำงานที่รองรับได้.
- ข้อความที่แสดง หมายความว่าไม่ควรอธิบายว่าเป็นโปรแกรมสร้างวิดีโอหรือเสียงแบบเนทีฟ.
- บริบทขนาดใหญ่ ทำให้มีประโยชน์สำหรับเอกสารยาวและบริบทโครงการที่กว้าง.
GPT-5.5 เป็นสิ่งใหม่เพราะมันรวม การให้เหตุผลที่มีประสิทธิภาพมากขึ้น, พฤติกรรมที่เน้นการใช้เครื่องมือมากขึ้น, และ ผลลัพธ์ที่เอื้อต่อการผลิตโดยตรงมากขึ้น.
| การปรับปรุง | ความหมาย |
|---|---|
| การให้เหตุผลที่มีประสิทธิภาพมากขึ้น | สามารถลดโทเค็นการให้เหตุผลที่สูญเปล่าในกระบวนการทำงานที่ซับซ้อน |
| การดำเนินงานที่มุ่งเน้นผลลัพธ์เป็นสำคัญ | ช่วยเปลี่ยนเจตนาของผู้ใช้ให้กลายเป็นงานที่เป็นรูปธรรม |
| การใช้เครื่องมือที่แข็งแกร่งขึ้น | ปรับปรุงความน่าเชื่อถือของตัวแทนและระบบอัตโนมัติ |
| รูปแบบการผิดนัดโดยตรง | มีประโยชน์ต่อประสิทธิภาพการทำงาน แต่อาจต้องปรับโทนเสียง |
| การประสานงานการเขียนโค้ด | เหมาะสำหรับการวางแผน, แก้ไข, ทดสอบ, และตรวจสอบ |
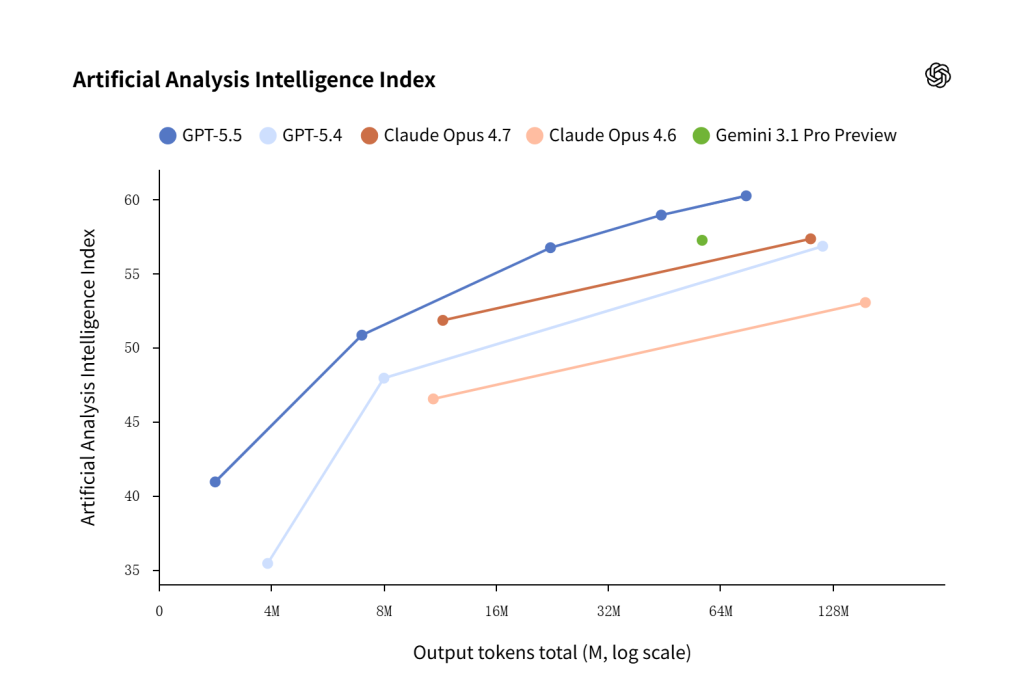
GPT‑5.5 ไม่เพียงแต่ฉลาดขึ้นเท่านั้น แต่ยังทำงานได้อย่างมีประสิทธิภาพมากขึ้นในการแก้ไขปัญหา โดยมักจะให้ผลลัพธ์ที่มีคุณภาพสูงกว่าด้วยจำนวนโทเคนและการลองซ้ำที่น้อยลง ในดัชนีการเขียนโปรแกรมของ Artificial Analysis, GPT‑5.5 มอบความฉลาดล้ำสมัย ครึ่งราคา ของแบบจำลองการเขียนโค้ดที่อยู่ในแนวหน้าของการแข่งขัน.
การเข้าถึง GPT-5.5 และความพร้อมใช้งานของโมเดล
ณ วันที่ 17 มิถุนายน 2569, เอกสารประกอบโมเดล GPT-5.5 ของ OpenAI ระบุ GPT-5.5 เป็นโมเดล API อย่างเป็นทางการพร้อมรหัสโมเดล gpt-5.5. ของ OpenAI หน้าเปิดตัว GPT-5.5 ยังอธิบายถึงความพร้อมใช้งานที่กว้างขึ้นของโมเดลและตัวอย่างจากโลกจริง.
สำหรับนักพัฒนา สามารถประเมินโมเดลนี้ได้ผ่าน API surfaces ของ OpenAI คำแนะนำของ GPT-5.5 ของ OpenAI เน้นย้ำถึงการย้ายข้อมูลอย่างระมัดระวัง การอัปเดตคำสั่ง การปรับแต่งความพยายามในการให้เหตุผล และความชัดเจนในการอธิบายเครื่องมือ มากกว่าการเปลี่ยนชื่อโมเดลในระบบการรวมข้อมูลเก่าเพียงอย่างเดียว.
การเข้าถึง API เทียบกับการเข้าถึง ChatGPT
การเข้าถึง API และ การเข้าถึง ChatGPT ไม่ใช่สิ่งเดียวกัน.
| ประเภทการเข้าถึง | หมายความว่า | แหล่งข้อมูลที่ดีที่สุดในการตรวจสอบ |
|---|---|---|
| การเข้าถึง API | นักพัฒนาสามารถเรียก gpt-5.5 ในแอปพลิเคชันหรือกระบวนการทำงาน | เอกสารโมเดล API ของ OpenAI |
| การเข้าถึง ChatGPT | ผู้ใช้สามารถเลือกโมเดลภายในผลิตภัณฑ์ ChatGPT ได้ | ตัวเลือกโมเดล ChatGPT, การตั้งค่าแผน หรือบันทึกการเผยแพร่ของ OpenAI |
| การเข้าถึงพื้นที่ทำงานแบบหลายโมเดล | ผู้ใช้เปรียบเทียบพฤติกรรมของโมเดลภายในสภาพแวดล้อมการทำงานที่มีประสิทธิภาพเพียงหนึ่งเดียว | รายการโมเดลสดของพื้นที่ทำงานและเครื่องมือที่รองรับ |
ทำไมภาพตัวอย่างแบบจำลองจึงมีความสำคัญ
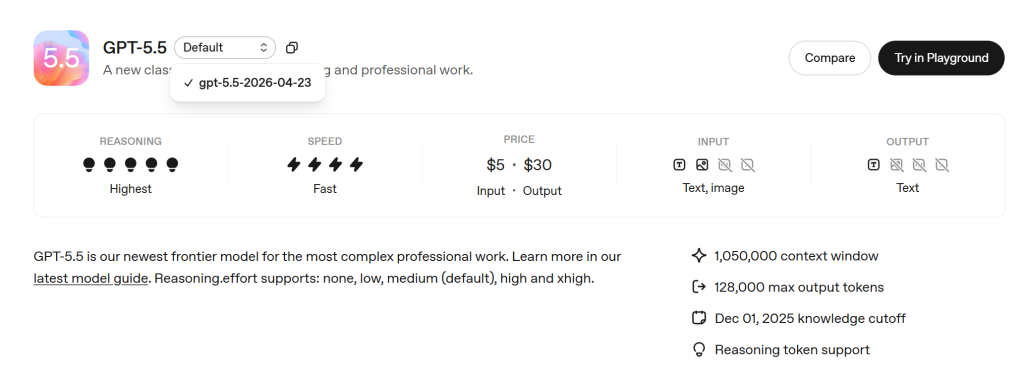
หน้าโมเดลของ OpenAI แสดงภาพรวม gpt-5.5-2026-04-23. ภาพตัวอย่างของแบบจำลองคือ รุ่นที่ล้าสมัยของแบบจำลอง ที่ช่วยลดการเบี่ยงเบนพฤติกรรมของทีม.
สแนปช็อตมีประโยชน์เมื่อความเสถียรเป็นสิ่งสำคัญ เช่น:
- ผู้ช่วยฝ่ายสนับสนุนลูกค้า
- เครื่องมือตรวจสอบโค้ด
- กระบวนการทำงานด้านการปฏิบัติตามข้อกำหนด
- ระบบการวิเคราะห์เอกสาร
- ปัจจัยภายในที่ส่งผลต่อประสิทธิภาพการทำงาน
นายพล gpt-5.5 รหัสโมเดลมีประโยชน์เมื่อทีมต้องการ เวอร์ชันเริ่มต้นปัจจุบัน. ภาพถ่ายเก่ามีประโยชน์เมื่อทีมต้องการความซ้ำได้ระหว่างการทดสอบ, การปล่อยระบบ, หรือการตรวจสอบการผลิต.
GPT-5.5 ข้อมูลทางเทคนิค
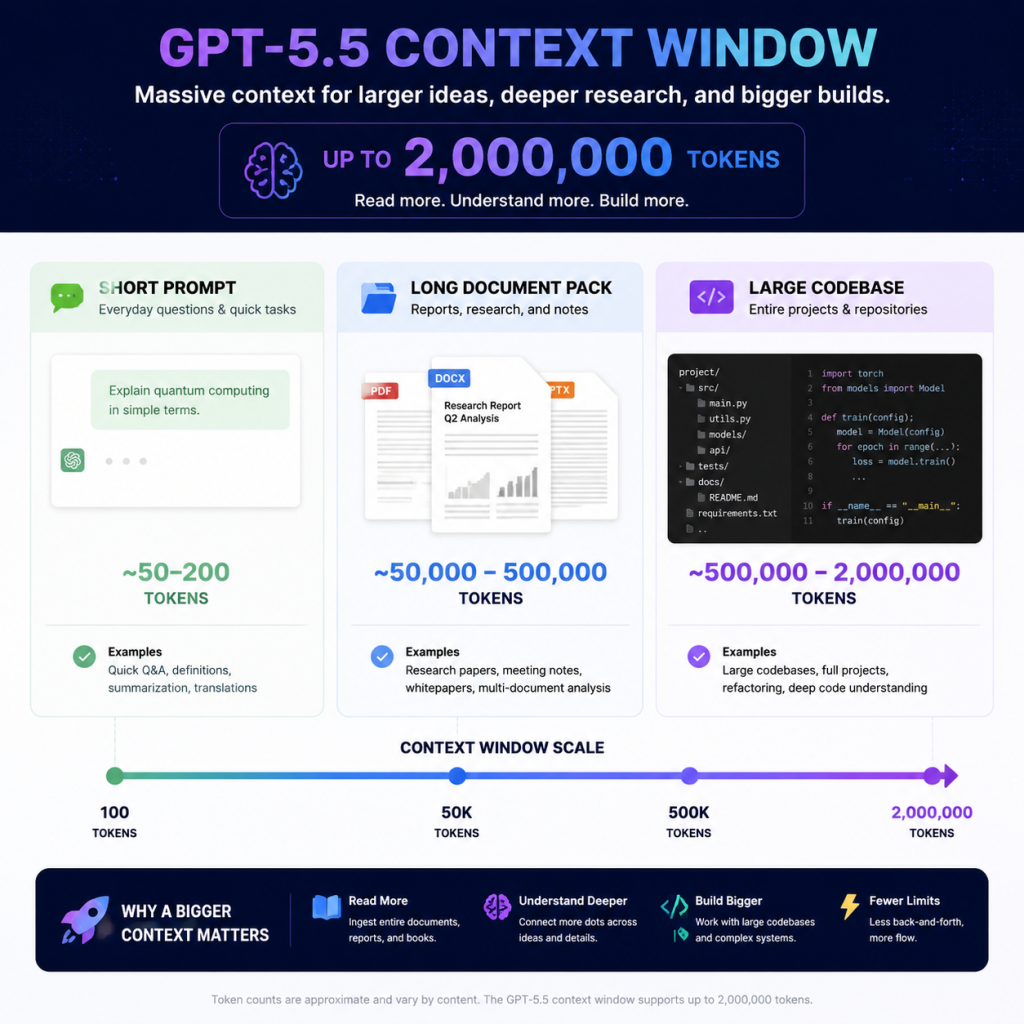
ข้อมูลทางเทคนิคของ GPT-5.5 อธิบายว่าทำไมโมเดลนี้จึงมีประโยชน์สำหรับกระบวนการทำงานที่ซับซ้อน ตัวเลขสำคัญสองตัวคือ:
- หน้าต่างบริบทที่มีโทเค็น 1,050,000 โทเค็น
- จำนวนโทเค็นสูงสุด 128,000 รายการ
ตัวเลขเหล่านั้นทรงพลัง แต่ไม่ควรกระตุ้นให้เกิดการป้อนข้อมูลที่ยุ่งเหยิง หน้าต่างบริบทขนาดใหญ่เป็นเพียงขีดความสามารถ ไม่ใช่เหตุผลที่จะนำทุกอย่างมาวางในโมเดล.
1.หน้าต่างบริบทและความยาวของผลลัพธ์
หน้าต่างบริบทที่มีโทเค็น 1,050,000 โทเค็น ช่วยให้ GPT-5.5 สามารถทำงานกับ อินพุตขนาดใหญ่, เช่น:
- คู่มือทางเทคนิคที่ยาว
- เอกสารทางกฎหมาย
- ชุดข้อมูลวิจัย
- ข้อมูลจำเพาะของสินค้า
- ฐานความรู้ภายใน
- บริบทของโค้ดเบสที่กว้างขวาง
จำนวนโทเค็นสูงสุด 128,000 หน่วยก็มีความสำคัญเช่นกัน แต่ส่วนใหญ่แล้วเวิร์กโฟลว์ไม่ต้องการการตอบสนองที่ยาวมาก พวกเขาต้องการ รูปแบบผลลัพธ์ที่ถูกต้อง:
- บันทึกการตัดสินใจ
- ตารางเปรียบเทียบ
- สรุปอย่างกระชับ
- ผลลัพธ์ JSON ที่มีโครงสร้าง
- การตรวจสอบโค้ด
- แผนการดำเนินการทีละขั้นตอน
กฎปฏิบัติ: ใช้บริบทยาวเฉพาะเมื่อคำตอบขึ้นอยู่กับหลักฐานหลายชิ้นเท่านั้น หากมีเพียงข้อความบางส่วนก็เพียงพอ การเรียกคืนและการเลือกบริบทเฉพาะจุดมักจะได้ผลดีกว่า.
คำแนะนำด่วนสำหรับบริบทยาว:
| เป้าหมาย | คำแนะนำในการพิมพ์ข้อความ |
|---|---|
| หลีกเลี่ยงการมีบริบทมากเกินไป | “ใช้เฉพาะส่วนที่เกี่ยวข้องกับ [การตัดสินใจ/คำถาม] และละเว้นส่วนที่ซ้ำกัน” |
| บังคับใช้หลักฐาน | “ให้ระบุแหล่งที่มาหรือชื่อไฟล์หลังจากแต่ละข้ออ้างสำคัญ” |
| ควบคุมเอาต์พุตที่ยาว | “ส่งสรุป 300 คำก่อน จากนั้นตามด้วยตารางหลักฐานที่สนับสนุน” |
| ปรับปรุงคุณภาพการค้นหา | “ก่อนตอบคำถาม ให้ระบุข้อความที่เกี่ยวข้องมากที่สุด 5 ข้อ และอธิบายว่าทำไมข้อความเหล่านั้นจึงมีความสำคัญ” |
ตัวอย่างสั้น:
วิเคราะห์เอกสารนโยบายที่แนบมา ใช้เพียงหลักฐานจากเอกสารเท่านั้น.
ผลลัพธ์: 1) คำตอบโดยตรง, 2) ตารางหลักฐาน, 3) ความเสี่ยง, 4) การดำเนินการถัดไป.
โปรดให้คำตอบไม่เกิน 700 คำ เว้นแต่หลักฐานจะขัดแย้ง.
2.รูปแบบและผลลัพธ์ตามธรรมชาติ
| ความสามารถ | จีพีที-5.5 |
|---|---|
| การป้อนข้อความ | ได้รับการสนับสนุน |
| การป้อนภาพ | ได้รับการสนับสนุน |
| ข้อความที่แสดง | ได้รับการสนับสนุน |
| เสียง | ไม่ได้ระบุว่าเป็นรูปแบบพื้นเมือง |
| วิดีโอ | ไม่ได้ระบุว่าเป็นรูปแบบพื้นเมือง |
GPT-5.5 สามารถเป็นส่วนหนึ่งของกระบวนการทำงานที่ใช้การสร้างภาพ, การสร้างวิดีโอ, หรือเครื่องมือเสียงได้ แต่ ไม่ได้หมายความว่า GPT-5.5 เองเป็นโมเดลวิดีโอหรือเสียงแบบเนทีฟ.
แต่สำหรับผู้ใช้ที่ต้องการสร้างภาพ GPT-5.5 สามารถมีส่วนร่วมในกระบวนการสร้างภาพได้ ผ่าน API การตอบสนอง, แม้ว่าการสร้างภาพจะดำเนินการโดยเครื่องมือสร้างภาพเฉพาะทาง.
คำแนะนำด่วนสำหรับภาพและรูปแบบ:
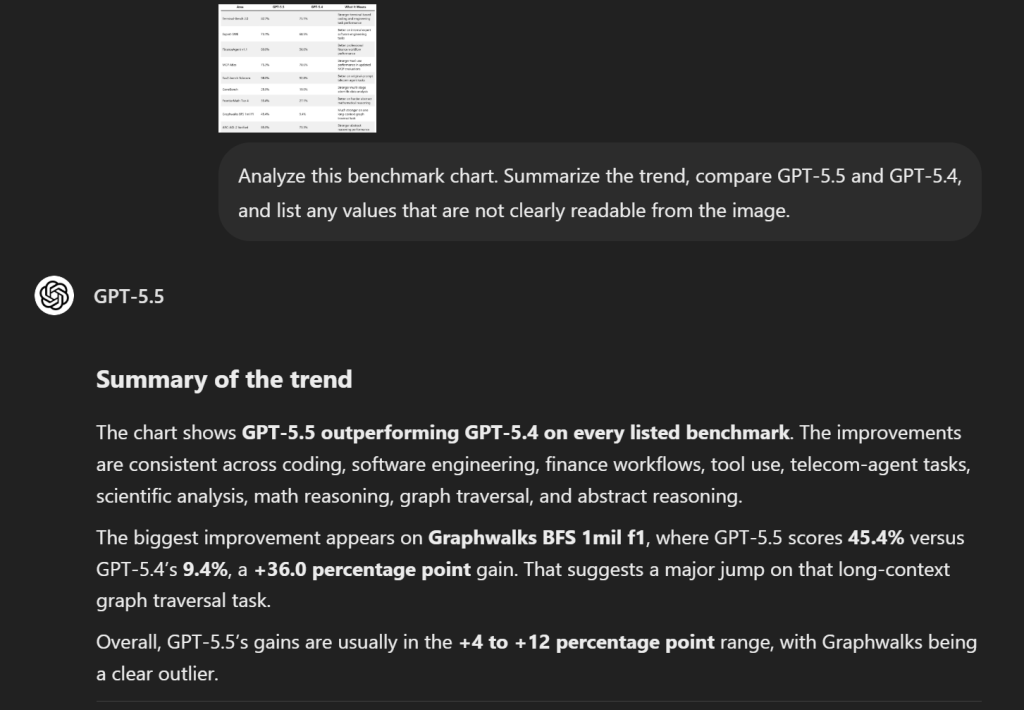
- สำหรับการวิเคราะห์ภาพ: “อธิบายสิ่งที่มองเห็นได้ จากนั้นแยกข้อเท็จจริงออกจากข้อสมมติ”
- สำหรับภาพหน้าจอแผนภูมิ: “ดึงข้อมูลที่คุณสามารถอ่านได้ออกมา และทำเครื่องหมายค่าที่ไม่ชัดเจนว่าไม่แน่นอน”
- สำหรับการสร้างภาพ: “ใช้เครื่องมือสร้างภาพเพื่อสร้าง...” แทนที่จะบ่งบอกว่า GPT-5.5 เองเป็นโมเดลภาพ.
- สำหรับความต้องการด้านวิดีโอหรือเสียง: ระบุเครื่องมือภายนอกหรือโมเดลที่ควรใช้ในการสร้างสื่อ.
ตัวอย่างสั้น:
3.เครื่องมือ, ผลลัพธ์ที่มีโครงสร้าง, และการปรับแต่งให้ละเอียด
GPT-5.5 รองรับคุณสมบัติสำหรับนักพัฒนาที่มีความสำคัญต่อระบบการผลิต:
| หมวดหมู่เครื่องมือ | การใช้งานจริง |
|---|---|
| การค้นหาเว็บ | ยืนยันข้อมูลปัจจุบัน |
| การค้นหาไฟล์ | ดึงหลักฐานจากเอกสาร |
| ตัวแปลรหัส | วิเคราะห์ข้อมูลหรือรันโค้ด |
| เชลล์โฮสต์ | สนับสนุนกระบวนการทำงานทางเทคนิคที่ใช้เครื่องมือ |
| ติดตั้งแพตช์ | ช่วยงานการแก้ไขโค้ด |
| การใช้คอมพิวเตอร์ | ทำงานกับงานที่ขับเคลื่อนด้วย UI |
| การค้นหา MCP และเครื่องมือ | เชื่อมต่อกับเครื่องมือและระบบภายนอก |
การปรับแต่งอย่างละเอียดถูกระบุไว้ว่า ไม่รองรับ สำหรับ GPT-5.5 หากทีมต้องการพฤติกรรมที่ปรับแต่งเฉพาะ ควรพิจารณาการออกแบบ prompt การดึงข้อมูล การสร้างผลลัพธ์ที่มีโครงสร้าง การประเมินผล หรือโมเดลอื่นที่รองรับการปรับแต่งเพิ่มเติม.
คำแนะนำด่วนสำหรับเครื่องมือและผลลัพธ์ที่มีโครงสร้าง:
| ต้องการ | คำแนะนำในการพิมพ์ข้อความ |
|---|---|
| การใช้เครื่องมือ | “ใช้การค้นหาเว็บสำหรับข้อเท็จจริงปัจจุบันเท่านั้น; ใช้การค้นหาไฟล์สำหรับเอกสารที่อัปโหลด” |
| ผลลัพธ์ที่มีโครงสร้าง | “ส่งคืน JSON ที่ถูกต้องพร้อมฟิลด์เหล่านี้: สรุป, หลักฐาน, ความเสี่ยง, คำแนะนำ.” |
| การตรวจสอบโดยมนุษย์ | “ให้ติดธงไว้ที่คำกล่าวอ้างใด ๆ ที่ต้องการการตรวจสอบจากมนุษย์ก่อนการเผยแพร่” |
| การปรับแต่งทางเลือก | “ปฏิบัติตามคู่มือสไตล์นี้และใช้ตัวอย่างทั้ง 3 เป็นรูปแบบผลลัพธ์” |
ราคาของ GPT-5.5 และค่าใช้จ่ายสำหรับบริบทยาว
GPT-5.5 เป็นโมเดลพรีเมียม ตามที่ โอเพ่นเอไอ, ราคาปกติคือ:
- $5.00 / 1M โทเค็นอินพุต
- $0.50 / 1M โทเค็นอินพุตที่แคชไว้
- $30.00 / โทเค็นผลลัพธ์ 1M
สิ่งนี้ทำให้การวางแผนต้นทุนมีความสำคัญ GPT-5.5 สามารถมีคุณค่าสำหรับกระบวนการทำงานระดับผู้เชี่ยวชาญ แต่ไม่ได้เป็นโมเดลที่เหมาะสมโดยอัตโนมัติสำหรับทุกคำขอ.
ราคา API มาตรฐาน
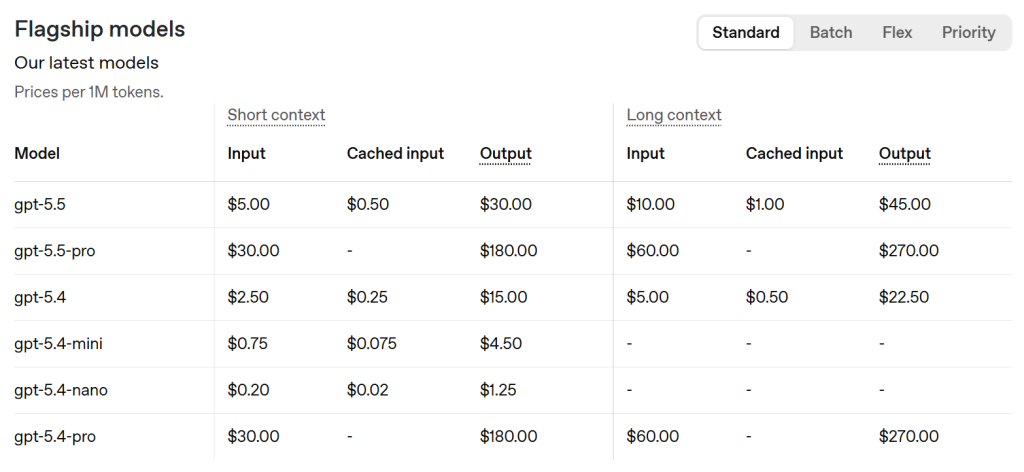
การแลกเปลี่ยนนั้นชัดเจน:
- GPT-5.5 มีราคาสูงกว่า.
- GPT-5.4 อาจเพียงพอสำหรับกระบวนการทำงานมาตรฐานหลายอย่าง.
- GPT-5.4 mini อาจเหมาะสำหรับงานปริมาณมากที่มีความซับซ้อนต่ำ.
โทเค็นผลลัพธ์มีความสำคัญที่สุด. ผลลัพธ์ของ GPT-5.5 มีราคาสูงกว่าข้อมูลนำเข้า ดังนั้นทีมควรควบคุมความยาวของคำตอบ หลีกเลี่ยงการเขียนร่างที่ไม่จำเป็นและยืดยาว และมอบหมายงานที่ง่ายกว่าให้กับโมเดลที่มีราคาถูกกว่า.
ข้อควรระวังเกี่ยวกับการกำหนดราคาตามบริบทระยะยาว
หน้าการกำหนดราคาของ OpenAI รวมถึงข้อควรระวังเกี่ยวกับบริบทที่ยาว: คำแนะนำด้านบน 272K โทเค็นอินพุต มีราคาอยู่ที่ อินพุต 2 ช่อง และ กำลังการผลิต 1.5 เท่า สำหรับเซสชันเต็ม.
นั่นไม่ได้หมายความว่าบริบทที่ยาวนั้นไม่ดี หมายความว่ากระบวนการทำงานที่มีบริบทยาวต้องการวินัย.
ใช้บริบทที่กว้างเมื่อ:
- คำตอบขึ้นอยู่กับเอกสารหลายฉบับ.
- โมเดลต้องเปรียบเทียบไฟล์หรือนโยบายหลายรายการ.
- หลักฐานถูกกระจายอยู่ในชุดแหล่งข้อมูลขนาดใหญ่.
- งานนี้มีคุณค่าเพียงพอที่จะคุ้มค่ากับค่าใช้จ่าย.
หลีกเลี่ยงบริบทที่กว้างเกินไปเมื่อ:
- มีเพียงบางส่วนเท่านั้นที่มีความสำคัญ.
- งานนี้มีความซ้ำซากหรือมีความเสี่ยงต่ำ.
- การค้นคืนสามารถค้นหาวัสดุที่เกี่ยวข้องได้ก่อน.
- รุ่นที่เล็กกว่าสามารถตอบสนองมาตรฐานคุณภาพได้.
GPT-5.5 เทียบกับ GPT-5.4
คำถามที่มีประโยชน์ไม่ใช่เพียงแค่ “GPT-5.5 ดีกว่า GPT-5.4 หรือไม่?” คำถามที่ดีกว่าคือ: GPT-5.5 มีจุดที่พัฒนาขึ้นมากพอที่จะคุ้มค่ากับราคาที่สูงกว่าหรือไม่?
OpenAI เปรียบเทียบ GPT-5.5 และ GPT-5.4 โดยตรงในด้านการเขียนโค้ด งานมืออาชีพ การใช้เครื่องมือ การให้เหตุผลทางวิชาการ ความปลอดภัยทางไซเบอร์บริบทยาว และการให้เหตุผลเชิงนามธรรม รูปแบบที่ได้มีความสอดคล้องกัน: GPT-5.5 มักจะนำหน้า GPT-5.4 ในงานที่ต้องใช้เหตุผลและการดำเนินการที่ยากขึ้น, ในขณะที่ GPT-5.4 ยังคงสามารถเข้าใจได้เมื่อต้นทุนและขนาดมีความสำคัญมากกว่า.
ความแตกต่างหลัก
ความแตกต่างหลักคือ ความน่าเชื่อถือในการทำงานที่ยาก. ในภาษาที่เข้าใจง่าย: GPT-5.5 เป็นโมเดลที่แข็งแกร่งกว่าสำหรับงานที่ยาก; GPT-5.4 ยังคงมีประโยชน์สำหรับงานมาตรฐานที่การควบคุมต้นทุนมีความสำคัญ.
OpenAI ยังระบุด้วยว่า GPT-5.5 มีราคาสูงกว่า GPT-5.4 แต่มีประสิทธิภาพในการใช้โทเค็นมากกว่าใน Codex ซึ่งสามารถให้ผลลัพธ์ที่ดีกว่าด้วยจำนวนโทเค็นที่น้อยกว่าสำหรับผู้ใช้จำนวนมาก นั่นหมายความว่าการเปรียบเทียบต้นทุนที่แท้จริงควรรวมถึงไม่เพียงแต่ราคาโทเค็นเท่านั้น แต่ยังรวมถึง:
- จำนวนครั้งที่งานต้องลองใหม่
- ไม่ว่าคำตอบแรกจะสามารถใช้งานได้หรือไม่
- ต้องมีการแก้ไขจากมนุษย์มากเพียงใด
- การเรียกใช้เครื่องมือสำเร็จหรือไม่
- ไม่ว่าโมเดลจะหยุดเร็วเกินไปหรือไม่
ต้นทุน ขนาด และการแลกเปลี่ยนในทางปฏิบัติ
OpenAI รายงานความแตกต่างหลายประการจากการประเมิน GPT-5.5 กับ GPT-5.4 โดยตรง:
| พื้นที่ | จีพีที-5.5 | GPT-5.4 | หมายความว่า |
|---|---|---|---|
| เทอร์มินัล-เบนช์ 2.0 | 82.7% | 75.1% | ประสิทธิภาพในการทำงานด้านการเขียนโค้ดและวิศวกรรมที่แข็งแกร่งยิ่งขึ้นบนระบบเทอร์มินัล |
| ผู้เชี่ยวชาญ-SWE | 73.1% | 68.5% | ดีกว่าในงานวิศวกรรมซอฟต์แวร์สำหรับผู้เชี่ยวชาญภายในองค์กร |
| FinanceAgent v1.1 | 60.0% | 56.0% | ประสิทธิภาพการทำงานของกระบวนการทางการเงินระดับมืออาชีพที่ดีขึ้น |
| MCP Atlas | 75.3% | 70.6% | ประสิทธิภาพการใช้เครื่องมือที่แข็งแกร่งขึ้นในการประเมิน MCP ที่อัปเดต |
| Tau2-bench Telecom | 98.0% | 92.8% | ดีกว่าในงานตัวแทนโทรคมนาคมตามคำสั่งเดิม |
| จีเนเบ็นช์ | 25.0% | 19.0% | การวิเคราะห์ข้อมูลทางวิทยาศาสตร์แบบหลายขั้นตอนที่แข็งแกร่งขึ้น |
| FrontierMath ระดับ 4 | 35.4% | 27.1% | เก่งกว่าในการใช้เหตุผลทางคณิตศาสตร์เชิงนามธรรมที่ยากขึ้น |
| Graphwalks BFS 1mil f1 | 45.4% | 9.4% | แข็งแกร่งมากขึ้นในภารกิจการท่องกราฟบริบทยาวแบบหนึ่ง |
| ARC-AGI-2 ได้รับการตรวจสอบแล้ว | 85.0% | 73.3% | ความสามารถในการคิดเชิงนามธรรมที่แข็งแกร่งขึ้น |
ผลลัพธ์ของ Terminal-Bench 2.0 มีความเกี่ยวข้องเป็นพิเศษสำหรับนักพัฒนา เนื่องจากเป็นการทดสอบงานวิศวกรรมที่ใช้ผ่านเทอร์มินัล ไม่ใช่เพียงแค่การตอบคำถามการเขียนโค้ดสั้น ๆ.
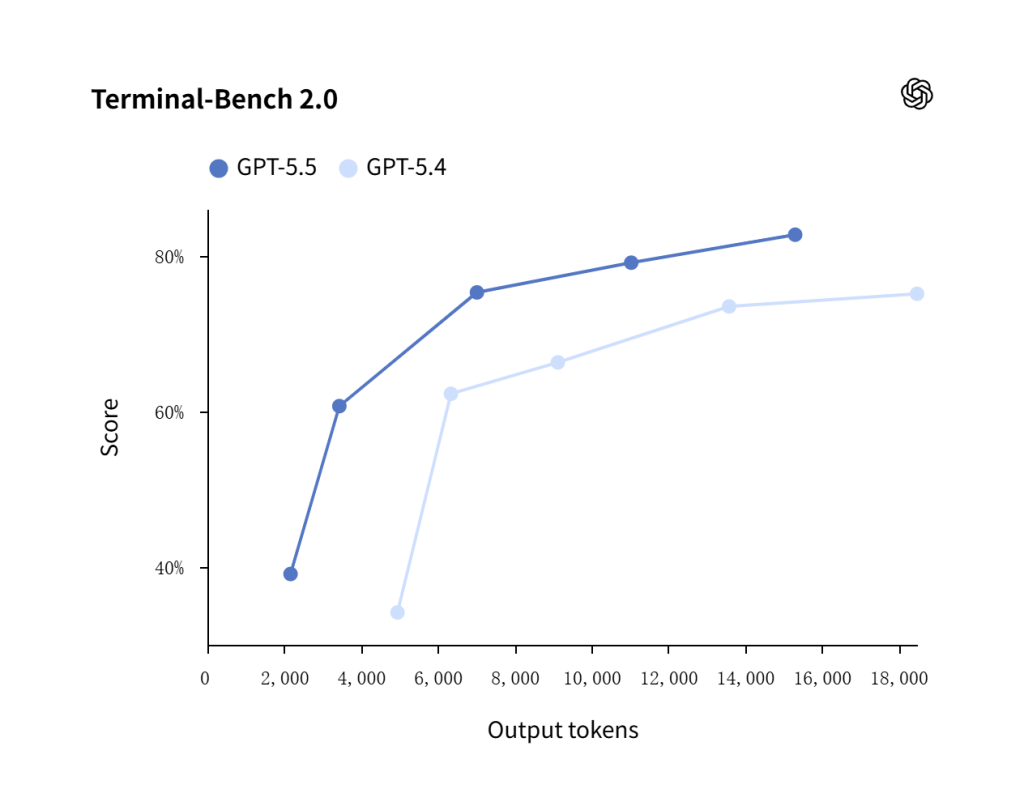
GPT-5.5 แสดงประสิทธิภาพทางวิศวกรรมที่อิงตามจุดสิ้นสุดที่แข็งแกร่งกว่า GPT-5.4 ในทุกช่วงของโทเค็นผลลัพธ์ที่ทดสอบ ซึ่งสนับสนุนการวางตำแหน่งให้เป็นโมเดลที่แข็งแกร่งกว่าสำหรับตัวแทนการเขียนโค้ดและกระบวนการทำงานของซอฟต์แวร์.
| กรณีการใช้งาน | จุดเริ่มต้นที่ดีกว่า | ทำไม |
|---|---|---|
| ตัวแทนการเข้ารหัสที่ซับซ้อน | จีพีที-5.5 | OpenAI รายงานผลลัพธ์ที่แข็งแกร่งขึ้นในการเขียนโค้ดและงานในเทอร์มินัล |
| การสังเคราะห์งานวิจัยระยะยาว | จีพีที-5.5 | การประเมินบริบทยาวแสดงให้เห็นถึงการเพิ่มขึ้นอย่างมีนัยสำคัญเมื่อเทียบกับ GPT-5.4 |
| การวิเคราะห์ทางวิทยาศาสตร์หรือคณิตศาสตร์ | จีพีที-5.5 | ผลลัพธ์ของ GeneBench และ FrontierMath ชี้ว่า GPT-5.5 ดีกว่า |
| ตัวแทนการผลิตที่ใช้เครื่องมือหนัก | จีพีที-5.5 | การประเมินการใช้เครื่องมือ เช่น MCP Atlas และ Tau2-bench ให้ความสำคัญกับ GPT-5.5 |
| ร่างเอกสารสนับสนุนอย่างง่าย | GPT-5.4 หรือ มินิ | ต้นทุนที่ต่ำกว่าอาจมีความสำคัญมากกว่าการคิดแบบจุดสูงสุด |
| ตัวแปรเนื้อหาแบบจำนวนมาก | GPT-5.4 หรือ มินิ | งานปริมาณมากต้องการการควบคุมต้นทุน |
การเปรียบเทียบนี้ยังแสดงให้เห็นว่าทำไมกลยุทธ์ที่ใช้โมเดลเดียวจึงมักไม่มีประสิทธิภาพ กระบวนการทำงานของ AI ที่มีความสมบูรณ์จะจัดเส้นทางงานตามระดับความยากแทนที่จะส่งทุกอย่างไปยังโมเดลที่ทรงพลังที่สุด.
การอพยพไม่ใช่การเปลี่ยนแทนที่ทันที
การย้ายจาก GPT-5.4 ไปยัง GPT-5.5 ไม่ควรถูกมองว่าเป็นการเปลี่ยนชื่อโมเดลอย่างง่าย แผนการย้ายที่ใช้งานได้จริง:
- ให้ดำเนินการเฉพาะงานที่ GPT-5.5 สามารถปรับปรุงผลลัพธ์ได้อย่างชัดเจนเท่านั้น.
- เลือก 20 ถึง 50 ตัวอย่างจริง จากการผลิตหรือการใช้งานภายใน.
- รัน GPT-5.4 และ GPT-5.5 ควบคู่กัน.
- เปรียบเทียบความถูกต้อง, ความล่าช้า, ค่าใช้จ่าย, และประโยชน์สุดท้าย.
- ปรับความพยายามในการให้เหตุผลและความยาวของข้อความให้เหมาะสม.
- อัปเดตคำอธิบายเครื่องมือและรูปแบบผลลัพธ์.
หรือคุณอาจ เปรียบเทียบ GPT-5.5 พร้อม GPT-5.4 หรือโมเดลอื่น ๆ เช่น Claude, Gemini, Perplexity บนแพลตฟอร์มเดียวที่ครอบคลุมทุกอย่าง — GlobalGPT คุณสามารถทดสอบข้ามโมเดลต่าง ๆ เพื่อตัดสินใจเลือกโมเดลที่ต้องการด้วยแผนพื้นฐานเริ่มต้นที่ประมาณ $5.8.
กรณีการใช้งานที่ดีที่สุดสำหรับ GPT-5.5
GPT-5.5 เหมาะสมที่สุดในการใช้งานเมื่อ เหตุผล, บริบท, และคุณภาพการดำเนินการ สร้างคุณค่าที่สามารถวัดได้.
การเขียนโปรแกรมและวิศวกรรมซอฟต์แวร์
การเขียนโค้ดเป็นหนึ่งในกรณีการใช้งานที่แข็งแกร่งที่สุดของ GPT-5.5 เนื่องจากงานซอฟต์แวร์มักผสมผสาน:
- ข้อกำหนดด้านภาษาธรรมชาติ
- โค้ด
- ไฟล์
- การทดสอบ
- เครื่องมือ
- กรณีขอบเขต
GPT-5.5 สามารถช่วยในเรื่องต่อไปนี้:
การแปลงข้อกำหนดผลิตภัณฑ์เป็นงานทางวิศวกรรม
- การแก้ไขข้อผิดพลาด
- การวางแผนการดำเนินการ
- การตรวจสอบคำขอดึง
- การสร้างแบบทดสอบ
- ข้อเสนอแนะในการปรับปรุงโครงสร้างโค้ด
- การนำทางในฐานโค้ด
เกณฑ์มาตรฐานภายใน Expert-SWE ของ OpenAI ให้มุมมองที่เฉพาะเจาะจงกับวิศวกรรมซอฟต์แวร์เกี่ยวกับข้อได้เปรียบของ GPT-5.5 เมื่อเทียบกับ GPT-5.4.
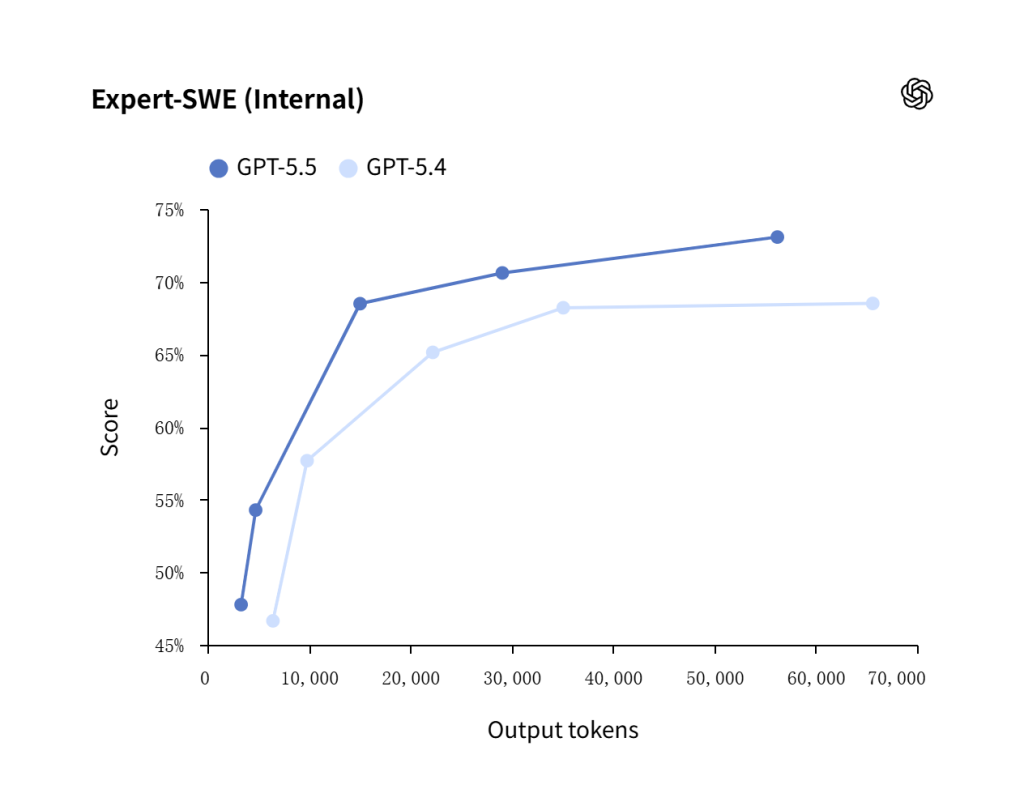
GPT-5.5 มีประสิทธิภาพเหนือกว่า GPT-5.4 ในงานวิศวกรรมซอฟต์แวร์ที่ดำเนินการโดยผู้เชี่ยวชาญภายในองค์กร ซึ่งทำให้เป็นจุดเริ่มต้นที่แข็งแกร่งกว่าสำหรับ การแก้ไขข้อบกพร่อง, การนำทางฐานโค้ด, การรวมสาขา, และการวางแผนการนำไปใช้.
ตัวแทน, เครื่องมือ, และงานที่มีบริบทยาว
GPT-5.5 เหมาะอย่างยิ่งสำหรับตัวแทนที่ต้องการใช้เครื่องมือและบริบทร่วมกัน.
GeneBench เชื่อมโยงจุดแข็งด้านบริบทยาวและการให้เหตุผลของ GPT-5.5 เข้ากับกระบวนการทำงานทางวิทยาศาสตร์.
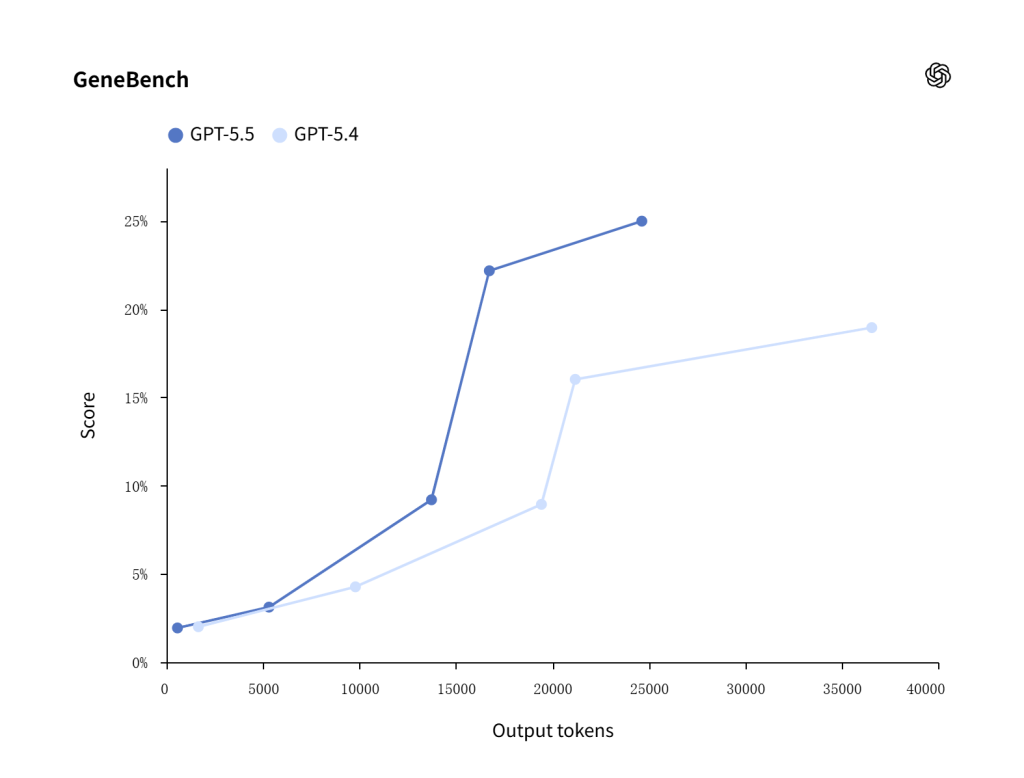
GPT-5.5 ได้คะแนนสูงกว่า GPT-5.4 บน GeneBench แสดงให้เห็นถึงประสิทธิภาพที่แข็งแกร่งกว่าในการทำงานวิเคราะห์ทางวิทยาศาสตร์หลายขั้นตอน เช่น การตีความข้อมูลการแสดงออกของยีน.
ตัวอย่างคำสั่งที่ใช้งานได้จริงสำหรับตัวแทนและงานที่มีบริบทยาว:
คำแนะนำสำหรับการทบทวนเอกสารระยะยาว:
ตรวจสอบชุดเอกสารที่อัปโหลดและตอบคำถามของผู้ใช้โดยใช้แหล่งข้อมูลที่ให้ไว้เท่านั้น.
ก่อนอื่นให้ระบุ 5 ส่วนที่เกี่ยวข้องมากที่สุด.
จากนั้นให้ตอบกลับ: คำตอบโดยตรง, ตารางหลักฐาน, ข้อขัดแย้งหรือข้อมูลที่ขาดหาย, และขั้นตอนต่อไปที่แนะนำ.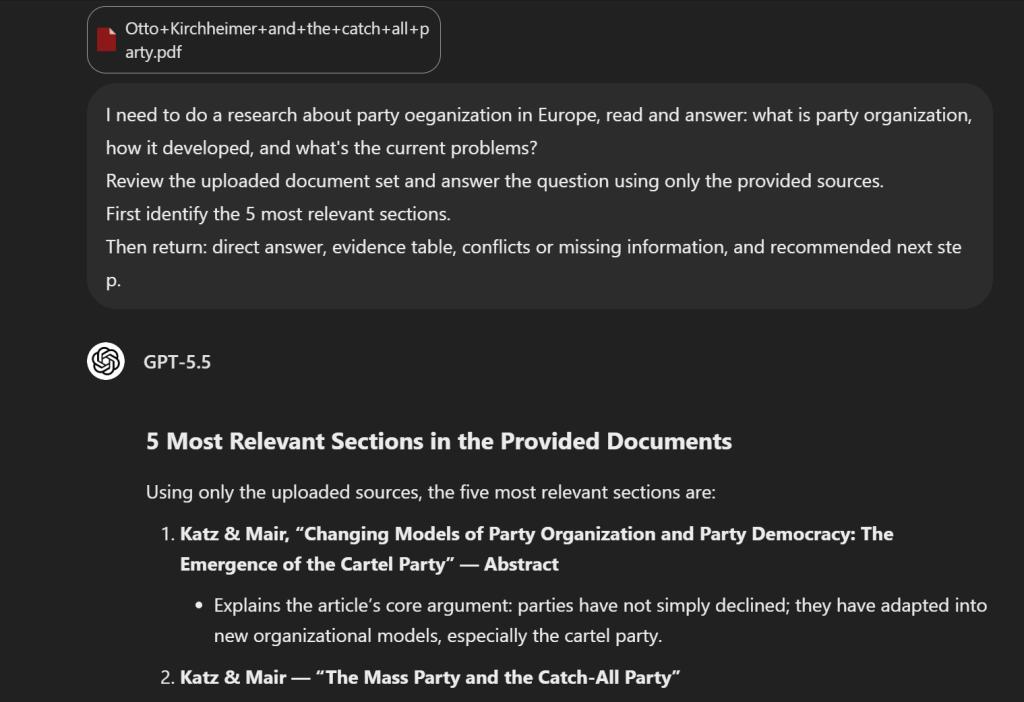
OpenAI ยังให้ตัวอย่างบริบทยาวที่ชัดเจนสองตัวอย่าง:
| ตัวอย่าง | รายละเอียดที่ต้องใช้ด้วยความระมัดระวัง |
|---|---|
| การตรวจสอบแบบฟอร์มภาษี K-1 | OpenAI อธิบายการใช้ GPT-5.5 เพื่อช่วยตรวจสอบแบบฟอร์มภาษี K-1 จำนวน 24,771 ฉบับ รวมทั้งหมด 71,637 หน้า ภายในระยะเวลาประมาณสองสัปดาห์ |
| รายงานธุรกิจรายสัปดาห์ | OpenAI อธิบายว่า GPT-5.5 ช่วยในการทำให้รายงานประจำสัปดาห์เป็นอัตโนมัติ ซึ่งก่อนหน้านี้ใช้เวลา 5-10 ชั่วโมง |
ตัวอย่างเหล่านี้แสดงให้เห็นว่า ทำไมบริบทที่ยาวจึงมีความสำคัญ. คุณค่าไม่ได้อยู่ที่ GPT-5.5 สามารถรับข้อมูลขนาดใหญ่ได้เพียงเพื่อประโยชน์ของตัวมันเอง คุณค่าอยู่ที่ว่ามันสามารถช่วยจัดระเบียบ, ทบทวน, และสังเคราะห์ชุดข้อมูลขนาดใหญ่ได้เมื่อกระบวนการทำงานมีโครงสร้างเพียงพอ.
กระบวนการทำงานแบบมืออาชีพและมุ่งเน้นลูกค้า
GPT-5.5 สามารถรองรับกระบวนการทำงานระดับมืออาชีพ เช่น:
- กระบวนการทำงานด้านการสื่อสาร: ช่วยจัดการคำขอในการพูดโดยทำงานข้ามบริบทและข้อจำกัดต่างๆ
- กระบวนการทำงานทางการเงิน: สนับสนุนการรายงานที่เกิดขึ้นซ้ำและการตรวจสอบเอกสารจำนวนมาก
- กระบวนการทำงานทางวิทยาศาสตร์: ช่วยเหลือในการวิเคราะห์ข้อมูลการแสดงออกของยีนที่เกี่ยวข้องกับตัวอย่าง 62 ตัวอย่าง และยีน 28,000 ยีน
- การมองเห็นทางคณิตศาสตร์: ช่วยสร้างแอปพลิเคชันเรขาคณิตเชิงพีชคณิตในเซสชันแบบโต้ตอบสั้นๆ
สำหรับกระบวนการทำงานที่ติดต่อกับลูกค้า GPT-5.5 สามารถช่วยในการให้คำตอบที่สมบูรณ์แบบได้ แต่ระบบโดยรอบยังคงต้องการ:
- กฎเกณฑ์ของโทน
- กฎการยกระดับ
- ขอบเขตของนโยบาย
- แหล่งความรู้ที่ได้รับการอนุมัติ
- การตรวจสอบโดยมนุษย์สำหรับกรณีที่มีความเสี่ยงสูง
ตัวอย่างคำแนะนำเชิงปฏิบัติสำหรับกระบวนการทำงานระดับมืออาชีพ:
สรุปผู้บริหาร:
เปลี่ยนบันทึกเหล่านี้ให้เป็นบทสรุปสำหรับผู้บริหารหนึ่งหน้า
ประกอบด้วย: บริบท, การตัดสินใจที่จำเป็น, ตัวเลือก, ความเสี่ยง, ข้อเสนอแนะ, และการดำเนินการถัดไป
ใช้ภาษาธุรกิจที่กระชับและหลีกเลี่ยงการกล่าวอ้างที่ไม่มีหลักฐานสนับสนุน.
ข้อความสำหรับฝ่ายสนับสนุนลูกค้า:
ตอบลูกค้าโดยใช้ข้อความนโยบายที่ได้รับการอนุมัติด้านล่างนี้เท่านั้น
น้ำเสียง: ชัดเจน สุภาพ และให้ความช่วยเหลือ
หากนโยบายไม่สามารถตอบคำถามได้ ให้แจ้งข้อมูลที่ขาดหายไปและส่งต่อให้ผู้รับผิดชอบ
จำกัดคำตอบไม่เกิน 150 คำ.ข้อความกระตุ้นฐานความรู้ภายใน:
สร้างคำตอบจากฐานความรู้โดยใช้เอกสารต้นฉบับเหล่านี้
ส่งคืน: คำตอบสั้น ๆ, ขั้นตอนทีละขั้นตอน, ข้อยกเว้น, และลิงก์หรือชื่อแหล่งข้อมูล
ทำเครื่องหมายข้อมูลที่ล้าสมัยหรือขัดแย้ง.ข้อจำกัดและความเสี่ยงของ GPT-5.5
บทความ GPT-5.5 ที่มีความจริงจังควรอธิบายว่าเมื่อใดที่โมเดลนี้ไม่ใช่ตัวเลือกที่เหมาะสม ความเสี่ยงที่ใหญ่ที่สุดคือ ค่าใช้จ่าย, ความหน่วง, คุณภาพการย้ายถิ่น, และ ขอบเขตความสามารถ.
ความเสี่ยงด้านต้นทุนและความล่าช้า
GPT-5.5 มีค่าใช้จ่ายสูงกว่า GPT-5.4 และ GPT-5.4 mini การใช้งานในบริบทที่ยาวสามารถมีค่าใช้จ่ายสูงได้เช่นกันหากคำสั่งเกินขีดจำกัดของบริบทที่ยาวของ OpenAI.
ระวังความเสี่ยงเหล่านี้:
- การพยายามใช้เหตุผลในระดับที่สูงขึ้นอาจเพิ่มค่าความหน่วง.
- ผลลัพธ์ที่ยาวสามารถเพิ่มค่าใช้จ่ายได้อย่างรวดเร็ว.
- ข้อความคำสั่งขนาดใหญ่สามารถกระตุ้นให้เกิดการคิดราคาตามบริบทที่ยาว.
- งานง่าย ๆ อาจไม่คุ้มค่าพอที่จะใช้ GPT-5.5.
กฎปฏิบัติ: ใช้การคิดวิเคราะห์ที่สูงขึ้นเพียงเมื่อภารกิจต้องการจริง ๆ วัดคุณภาพ, ความหน่วง, และค่าใช้จ่ายก่อนที่จะทำให้ GPT-5.5 เป็นค่าเริ่มต้น.
ความเสี่ยงด้านการย้ายข้อมูลและการประเมินผล
คำสั่ง GPT-5.4 รุ่นเก่าอาจไม่ทำงานได้อย่างมีประสิทธิภาพสูงสุดกับ GPT-5.5 การสลับชื่อโมเดลโดยตรงอาจทำให้พลาดจุดเด่นของโมเดลหรือสร้างการเปลี่ยนแปลงที่ไม่คาดคิดในสไตล์ พฤติกรรมของเครื่องมือ หรือรูปแบบผลลัพธ์.
ก่อนการใช้งานจริง ให้ประเมิน:
- ตัวอย่างจริง ไม่ใช่คำสั่งเล่น
- กรณีขอบเขตและข้อมูลที่ไม่ชัดเจน
- พฤติกรรมการเรียกใช้เครื่องมือ
- ความยาวและรูปแบบของผลลัพธ์
- ผลลัพธ์จากการตรวจสอบโดยมนุษย์
- ต้นทุนต่อภารกิจที่สำเร็จ
ทีมการผลิตยังคงต้องการการประเมินผล. แบบจำลองที่แข็งแกร่งอาจยังคงทำผิดพลาด ใช้เครื่องมือไม่ถูกต้อง หรือให้คำตอบที่มั่นใจโดยไม่มีหลักฐานเพียงพอ.
วิธีกระตุ้น GPT-5.5 อย่างมีประสิทธิภาพ
GPT-5.5 ทำงานได้ดีที่สุดเมื่อคำสั่งระบุงานอย่างชัดเจน คำสั่งที่แข็งแกร่งจะตอบคำถามสี่ข้อ:
- ควรบรรลุอะไร?
- อะไรที่ถือว่าเป็นคำตอบที่ดี?
- ข้อมูลหรือเครื่องมือใดบ้างที่อาจนำมาใช้ได้?
- ผลลัพธ์สุดท้ายควรมีลักษณะอย่างไร?
เริ่มต้นด้วยผลลัพธ์ ไม่ใช่ขั้นตอนที่ยืดยาว
การกระตุ้นผลลัพธ์ก่อนหมายถึงการกำหนดผลลัพธ์สุดท้ายและขอบเขต ไม่ใช่การเขียนสคริปต์ขั้นตอนยาวๆ.
ตัวอย่าง:
เป้าหมาย: เปรียบเทียบ GPT-5.5 และ GPT-5.4 สำหรับผู้ช่วยสนับสนุนลูกค้า.
เกณฑ์ความสำเร็จ: แนะนำหนึ่งโมเดลสำหรับตั๋วที่ให้ความสำคัญกับคุณภาพ และอีกหนึ่งโมเดลสำหรับตั๋วที่มีปริมาณมากและเป็นเรื่องปกติ.
กฎเกี่ยวกับพยานหลักฐาน: ใช้เฉพาะราคาอย่างเป็นทางการและพฤติกรรมของรุ่นที่มีการบันทึกไว้เท่านั้น.
ผลลัพธ์: ตารางการตัดสินใจสั้น ๆ ตามด้วยคำแนะนำ 150 คำ.
ปรับความพยายามในการหาเหตุผลอย่างมีเจตนา
ความพยายามในการคิดควรเหมาะสมกับงาน อย่าใช้ระดับสูงสุดเป็นนิสัย.
| ความพยายามในการใช้เหตุผล | เหมาะที่สุดสำหรับ |
|---|---|
ไม่มี | งานที่ต้องการความไวต่อความหน่วงซึ่งไม่จำเป็นต้องใช้การคิดวิเคราะห์ |
ต่ำ | การให้เหตุผลอย่างมีประสิทธิภาพสำหรับงานที่ค่อนข้างง่าย |
ปานกลาง | ค่าเริ่มต้นที่สมดุลสำหรับหลายกระบวนการทำงานมืออาชีพ |
สูง | การวิเคราะห์เชิงซับซ้อน การเขียนโค้ด และงานของตัวแทน |
xสูง | งานที่ไม่เป็นไปตามลำดับเวลาหรือมีขั้นตอนการประเมินผลที่ซับซ้อนที่สุด |
วัด:
- ความถูกต้อง
- ความหน่วง
- คุณภาพการเรียกใช้เครื่องมือ
- ค่าใช้จ่าย
- ผลลัพธ์จากการตรวจสอบโดยมนุษย์
หาก ปานกลาง การให้เหตุผลให้คุณภาพที่เท่ากันกับ สูง, ปานกลาง อาจเป็นสภาพแวดล้อมการผลิตที่ดีกว่า.
ควบคุมความยาว รูปแบบ และเสียง
GPT-5.5 สามารถสร้างผลลัพธ์ที่ยาวได้ แต่ยาวกว่าไม่ได้หมายความว่าจะดีกว่าเสมอไป ควบคุมคำตอบด้วย:
- ข้อจำกัดจำนวนคำ
- รูปแบบตาราง
- จำนวนลูกกระสุน
- ข้อกำหนดของสคีมา
- คำแนะนำเกี่ยวกับโทนเสียง
- กฎการอ้างอิง
ตัวอย่าง:
- “ตอบภายใน 120 คำ และรวมขั้นตอนถัดไปหนึ่งขั้นตอน”
- “ส่งคืนตารางการตัดสินใจพร้อมคำแนะนำสั้น ๆ”
- “อ้างอิงแหล่งที่มาหลังจากแต่ละข้อเท็จจริงที่กล่าวอ้าง”
- “ใช้ภาษาที่กระชับ เป็นทางการทางเทคนิค และไม่ส่งเสริมการขาย”
คำถามที่พบบ่อยเกี่ยวกับ GPT-5.5
GPT-5.5 ดีกว่า GPT-5.4 หรือไม่?
GPT-5.5 เหมาะสมกว่าสำหรับ งานวิชาชีพที่ซับซ้อน, โดยเฉพาะการเขียนโค้ด การเรียกคืนบริบทยาว ตัวแทนที่ใช้เครื่องมือมาก และเวิร์กโฟลว์ที่ต้องใช้การให้เหตุผลมาก GPT-5.4 อาจยังคงเหมาะสมกว่าสำหรับงานที่คำนึงถึงต้นทุนหรืองานที่มีความซับซ้อนต่ำกว่า.
GPT-5.5 มีค่าใช้จ่ายเท่าไร?
หน้าการกำหนดราคา API ของ OpenAI รายการ GPT-5.5 ที่ $5.00 ต่อ 1M โทเค็นอินพุต, $0.50 ต่อ 1M ของโทเค็นอินพุตที่แคชไว้, และ $30.00 ต่อโทเค็นผลลัพธ์ 1 ล้าน. ข้อความที่เกิน 272K โทเคนอินพุตจะมีกฎการกำหนดราคาสำหรับบริบทยาวเพิ่มเติม.
GPT-5.5 รองรับรูปภาพหรือไม่?
ใช่. เอกสารประกอบโมเดล GPT-5.5 ของ OpenAI รายการ การป้อนข้อความและรูปภาพ. รายการ ข้อความแสดงผล, ดังนั้น การสนับสนุนการป้อนข้อมูลภาพไม่ควรสับสนกับการสร้างภาพแบบเนทีฟ.
GPT-5.5 สร้างภาพได้หรือไม่?
GPT-5.5 ทำได้ ไม่สามารถสร้างภาพโดยตรงในฐานะโมเดลเอาต์พุตภาพแบบเนทีฟที่ทำงานได้ด้วยตัวเอง. อย่างไรก็ตาม มันสามารถช่วยผู้ใช้สร้างภาพได้โดยการเรียกใช้ เครื่องมือสร้างภาพ ใน API การตอบสนอง หรือโดยการทำงานร่วมกับโมเดลการสร้างภาพเฉพาะทาง OpenAI คู่มือการสร้างภาพ อธิบายเครื่องมือที่ใช้ในการสร้างภาพ.
GPT-5.5 รองรับเสียงหรือวิดีโอหรือไม่?
หน้าข้อมูลของโมเดล GPT-5.5 ของ OpenAI ไม่ได้ระบุเสียงหรือวิดีโอว่าเป็นรูปแบบที่รองรับโดยกำเนิดสำหรับโมเดลนี้ GPT-5.5 อาจถูกใช้ภายในกระบวนการทำงานที่กว้างขึ้นซึ่งรวมถึงเครื่องมือสื่อ แต่ตัวโมเดลเองได้รับการบันทึกไว้ว่ารองรับการป้อนข้อมูลเป็นข้อความและภาพ และการให้ผลลัพธ์เป็นข้อความ.
ฉันควรเปลี่ยน GPT-5.4 เป็น GPT-5.5 หรือไม่?
ไม่อัตโนมัติ ทดสอบ GPT-5.5 กับ GPT-5.4 บนตัวอย่างจริง เปรียบเทียบ ความถูกต้อง, ความล่าช้า, คุณภาพของการเรียกใช้เครื่องมือ, ความมีประโยชน์ของผลลัพธ์, และค่าใช้จ่าย. ใช้ GPT-5.5 ในกรณีที่สามารถปรับปรุงผลลัพธ์ได้ดีพอที่จะคุ้มค่ากับราคาที่สูงขึ้น.