
คู่มือหลักฐาน · อัปเดตเดือนกันยายน 2026
AI Perplexity สามารถช่วยคุณค้นหาแหล่งข้อมูลและสร้างคำตอบเบื้องต้นได้ แต่การอ้างอิงของมันไม่รับประกันว่าคำตอบนั้นถูกต้อง. ความแม่นยำขึ้นอยู่กับคำถาม วิธีการค้นหา และคุณภาพของแหล่งข้อมูล นี่เป็นจุดเริ่มต้นที่มีประโยชน์สำหรับการวิจัย แต่ข้ออ้างสำคัญยังคงต้องตรวจสอบกับหน้าต้นฉบับ.
การอ้างอิงที่มีหมายเลขอาจนำไปยังหน้าที่แท้จริงและเกี่ยวข้อง แต่ไม่มีการสนับสนุนข้อมูลสถิติ วันที่ คำพูด หรือข้อสรุปที่แม่นยำอยู่ข้างเคียง ดังนั้น ความแม่นยำในการอ้างอิง Perplexity จึงไม่ใช่เพียงการตรวจสอบว่าลิงก์ทำงานได้หรือไม่ แต่แหล่งข้อมูลต้องสนับสนุนข้อกล่าวอ้างในบริบทเดียวกัน.
ก่อนที่จะเผยแพร่ข้อมูลสถิติ อ้างอิงบทความ หรือใช้คำตอบเพื่อตัดสินใจ ให้เปิดแหล่งข้อมูลที่แนบมา ค้นหาส่วนที่เกี่ยวข้อง และเปรียบเทียบคำใช้ วันที่ และขอบเขตกับคำตอบ หากหลักฐานขาดหายไป หรือมีเนื้อหาที่แตกต่าง ให้ถือว่าข้อกล่าวอ้างนั้นยังไม่ได้รับการยืนยัน.
ความแม่นยำ Perplexity นั้นหมายความว่าอย่างไรกันแน่?
ความแม่นยำของ Perplexity มีอย่างน้อยสองระดับ: คือคำตอบนั้นถูกต้องหรือไม่ และแหล่งข้อมูลที่ใช้สนับสนุนคำตอบนั้นหรือไม่ โดยปกติแล้ว เปอร์เซ็นต์หนึ่งมักซ่อนการทดสอบหลายประเภทไว้ภายใน ลิงก์หนึ่งอาจเปิดได้สำเร็จ แต่ยังคงไม่ผ่านการทดสอบที่สำคัญที่สุด คือหน้าเว็บนั้นสนับสนุนข้อกล่าวอ้างที่แนบมากับลิงก์นั้นหรือไม่.
| มิติ | คำถาม | ข้อผิดพลาดที่พบบ่อย |
|---|---|---|
| การแก้ไขการอ้างอิง | URL นี้เปิดได้และชี้ไปยังหน้าที่ต้องการหรือไม่? | URL ที่ถูกทำลาย ถูกเปลี่ยนเส้นทาง หรือถูกสร้างขึ้น |
| ความเกี่ยวข้องของแหล่งข้อมูล | หน้านี้เกี่ยวข้องกับหัวข้อนั้นจริงหรือไม่? | หน้าเว็บแบบสดที่กล่าวถึงหัวข้อนี้เท่านั้น |
| ขอรับการสนับสนุน | มันรองรับประโยค ตัวเลข หรือวันที่ที่ระบุไว้อย่างแม่นยำหรือไม่? | การอ้างอิงที่เกินขอบเขต หรือสถิติผี |
| คุณภาพและความสดใหม่ | เนื้อหานี้เป็นเนื้อหาต้นฉบับ มีแหล่งอ้างอิงที่น่าเชื่อถือ และทันสมัยหรือไม่? | หน้าเว็บที่ล้าสมัย หรือเนื้อหาที่คัดลอกมาจากแหล่งอื่น |
สำหรับผู้เผยแพร่และแบรนด์ การปรากฏในคำอ้างอิงเป็นเรื่องที่แยกต่างหาก เครื่องมือสามารถแจ้งให้คุณทราบว่า Perplexity ได้กล่าวถึงบริษัทของคุณ แต่ไม่สามารถบอกได้ว่าคำตอบนั้นอธิบายบริษัทของคุณอย่างถูกต้องหรือไม่ การปรากฏวัดระดับความมองเห็น ส่วนความถูกต้องวัดว่าแหล่งข้อมูลและคำกล่าวอ้างนั้นสอดคล้องกันหรือไม่.
ของเรา คู่มือสำหรับผู้เริ่มต้นในการใช้ AI Perplexity อธิบายขั้นตอนการทำงานพื้นฐาน บทความนี้เน้นไปที่สิ่งที่เกิดขึ้นหลังจากคำตอบปรากฏขึ้น: การตรวจสอบหลักฐาน.
การศึกษาการอ้างอิง Perplexity ที่เป็นที่รู้จักมากที่สุดนั้น ได้ทดสอบอะไรกันแน่?
ศูนย์ Tow และวิธีการวิจัยของ CJR
เกณฑ์มาตรฐานสาธารณะที่มีประโยชน์ที่สุดคือการศึกษาของ Tow Center for Digital Journalism ที่เผยแพร่โดย Columbia Journalism Review เมื่อวันที่ 6 มีนาคม 2568 นักวิจัยได้เลือกผู้เผยแพร่ข่าว 20 แห่ง โดยนำบทความ 10 บทความจากแต่ละแห่ง และส่งส่วนคัดลอกของบทความเหล่านั้นไปยังเครื่องมือค้นหา AI 8 ระบบ แต่ละระบบต้องระบุหัวข้อข่าว ผู้เผยแพร่ วันที่เผยแพร่ และ URL ของบทความ.
ผลลัพธ์ที่ได้คือ 1,600 คำถาม: 20 ผู้เผยแพร่ คูณด้วย 10 บทความ และ 8 เครื่องมือ การศึกษานี้มีประโยชน์เพราะนักวิจัยมีบทความต้นฉบับที่เป็นที่รู้จักและสามารถเปรียบเทียบคำตอบแต่ละข้อกับบทความต้นฉบับได้ การศึกษานี้มีขอบเขตจำกัดเพราะมุ่งทดสอบการระบุแหล่งที่มาของข้อความข่าว ไม่ใช่ทุกคำถามที่เกี่ยวข้องกับการวิจัย การซื้อสินค้า การศึกษา การเขียนโค้ด หรือการสังเคราะห์ข้อมูล.
ผลการศึกษาเกี่ยวกับ Perplexity
| เครื่องมือ | ผลลัพธ์ของงานที่ทดสอบ | วิธีอ่าน |
|---|---|---|
| ความสับสน | 37% ไม่ถูกต้อง | งานระบุแหล่งข่าวเฉพาะ |
| การค้นหาด้วย ChatGPT | 67% ไม่ถูกต้อง | งานเดียวกันและกรอบการเปรียบเทียบ |
| กร็อก 3 | 94% ไม่ถูกต้อง | งานเดียวกันและกรอบการเปรียบเทียบ |
แหล่งข้อมูลหลัก: ระบบค้นหาด้วย AI มีปัญหาเกี่ยวกับการอ้างอิง, Tow Center / Columbia Journalism Review, เผยแพร่เมื่อวันที่ 6 มีนาคม 2568.
สิ่งที่การวิจัยนี้ไม่ได้พิสูจน์
- มันไม่ได้ทดสอบทุกคำถามหรือโหมด Perplexity.
- มันไม่ได้สร้างคะแนนถาวรสำหรับเวอร์ชันในอนาคต.
- สิ่งนี้ไม่ได้พิสูจน์ว่าทุกการอ้างอิง Perplexity ล้วนผิด.
- มันไม่ได้พิสูจน์ว่าเป็นผู้ชนะระดับโลกสำหรับทุกหัวข้อ.
- ไม่ควรเขียนใหม่เป็น “63% ความแม่นยำในการอ้างอิงโดยรวม”
การวิเคราะห์ของ Prompt Architects ชี้ให้เห็นประเด็นสำคัญเดียวกัน: ตัวเลขจะมีความหมายก็ต่อเมื่อผู้อ่านสามารถเห็นตัวอย่าง กฎการให้คะแนน คำนิยามของงาน และวันที่ที่เกี่ยวข้องได้.
ทำไมการอ้างอิงแบบ Perplexity ถึงดูถูกต้อง แต่กลับผิดได้?
การไม่ตรงกันของแหล่งอ้างอิงนั้นสังเกตได้ยากกว่าลิงก์ที่เสีย หน้าเว็บโหลดขึ้นได้ หัวข้อดูเกี่ยวข้อง และคำตอบอาจดูน่าเชื่อถือ แต่ปัญหาจะปรากฏขึ้นเมื่อคุณเปรียบเทียบคำกล่าวนั้นกับข้อความและบริบทบนหน้าแหล่งที่มา.
| รูปแบบความล้มเหลว | ดูเหมือนอย่างไร | ตรวจสอบ |
|---|---|---|
| ความไม่ตรงกันระหว่างคำกล่าวอ้างกับแหล่งข้อมูล | แหล่งข้อมูลต้นฉบับไม่สนับสนุนคำกล่าวดังกล่าวตามที่เขียนไว้. | หาประโยคหรือตัวเลขที่ตรงกัน. |
| การอ้างอิงที่เกินขอบเขต | แหล่งข้อมูลนำเสนอข้อโต้แย้งที่เรียบง่าย ส่วนคำตอบนำเสนอข้อโต้แย้งที่หนักแน่นกว่า. | เปรียบเทียบความแรงและทิศทางของคำ. |
| การเบี่ยงเบนจากหัวข้อ | ลิงก์ทำงานได้ แต่บทความนั้นกล่าวถึงเรื่องอื่น. | อ่านหัวข้อและส่วนต้นของบทความ. |
| สถิติผี | หมายเลขปรากฏในคำตอบ แต่ไม่ปรากฏบนหน้า. | ค้นหาตัวเลขและหน่วย. |
| ความสับสนเกี่ยวกับการเผยแพร่เนื้อหา | โพสต์ซ้ำโดยอ้างอิงแหล่งที่มาแทนผู้เผยแพร่ต้นฉบับ. | ค้นหาเวอร์ชันและวันที่จากผู้พัฒนาโดยตรง. |
| แหล่งข้อมูลที่ล้าสมัยหรือเสียหาย | หน้าถูกเปลี่ยนแปลง หายไป หรือเกิดข้อผิดพลาด. | เปิดในเซสชันใหม่. |
ความสับสน แนวทางเกี่ยวกับป้ายกำกับแหล่งที่มา ยังกำหนดความคาดหวังที่มีประโยชน์ด้วย: ป้ายกำกับนั้นอธิบายเว็บไซต์โดยรวม ไม่ใช่ความจริงของบทความหรือคำกล่าวอ้างแต่ละชิ้น.
วงกลมรอบตัวเลข วันที่ ชื่อ คำพูด หรือคำแนะนำ.
คลิกที่แหล่งที่มาที่แนบไว้กับประโยคนั้น.
ค้นหาคำวลี หมายเลข หรือหลักฐาน.
ตรวจสอบบริบท ขอบเขต วันที่ และที่มา.
วิธีตรวจสอบการอ้างอิง Perplexity ในเวลาสองนาที
เริ่มจากข้อมูลที่หากผิดแล้วจะก่อให้เกิดความเสียหายมากที่สุด: ราคา, เปอร์เซ็นต์, วันที่, คำกล่าวอ้าง, เงื่อนไขทางกฎหมาย, คำชี้แจงทางการแพทย์ หรือการเปรียบเทียบกับคู่แข่ง.
- เลือกคำร้อง. คัดลอกประโยคหรือตัวเลขนั้นมาอย่างถูกต้อง.
- เปิดเอกสารอ้างอิงที่แนบมา. ใช้แหล่งข้อมูลที่เชื่อมโยงกับประโยคนั้น.
- ค้นหาในหน้านี้. ใช้คำสั่ง find เพื่อค้นหาหมายเลข วลี หรือชื่อการศึกษา.
- อ่านย่อหน้านี้. ตรวจสอบหัวข้อ วันที่ ขอบเขต หน่วย และทิศทาง.
- ตรวจสอบที่มา. ให้ใช้เวอร์ชันต้นฉบับและเวอร์ชันปัจจุบันเป็นหลัก หากการจับคู่ไม่สำเร็จ ให้ทำเครื่องหมายว่ายังไม่ได้รับการยืนยัน.
ข้อความแจ้งเตือนการยืนยันที่สามารถใช้ซ้ำได้: เปิดแหล่งข้อมูลที่คุณอ้างอิงสำหรับ “[ข้อกล่าวอ้าง]” ขึ้นมา และนำประโยคที่สนับสนุนข้อกล่าวอ้างนั้นมาอ้างอิงอย่างถูกต้อง หากแหล่งข้อมูลดังกล่าวไม่มีประโยคใดที่สนับสนุนข้อกล่าวอ้างตามที่ระบุไว้ ให้ระบุอย่างตรงไปตรงมา และอย่ากล่าวซ้ำข้อกล่าวอ้างนั้น.
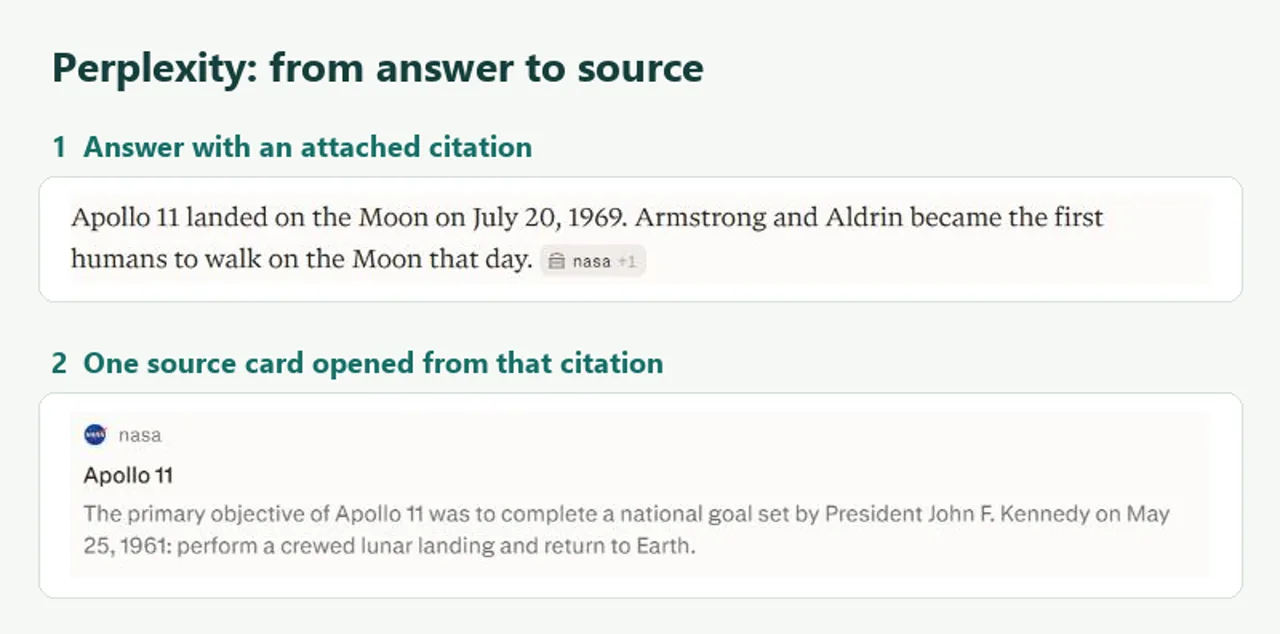
คำสั่งนี้ไม่ได้ทำให้ผลการค้นหาต้นฉบับมีความแม่นยำมากขึ้น แต่บังคับให้โมเดลแสดงขั้นตอนการทำงานของมัน คุณยังคงต้องอ่านแหล่งข้อมูลต้นฉบับเมื่อคำตอบถูกเผยแพร่หรือนำไปใช้ในการตัดสินใจที่มีความสำคัญสูง.
การวิจัยเชิงลึก Perplexity มีความแม่นยำกว่าการค้นหาแบบมาตรฐานหรือไม่?
รายงานที่ยาวกว่าและมีแหล่งข้อมูลมากขึ้นอาจมีประโยชน์มากขึ้น แต่ความยาวไม่ใช่เกณฑ์การประเมินความถูกต้อง การวิจัยเชิงลึกมีโอกาสมากขึ้นในการค้นหา รวมข้อมูล และจัดประเภทข้อมูลผิด ตัวอย่างสาธารณะสามารถแสดงให้เห็นว่าปัญหาการอ้างอิงเกิดขึ้นได้ แต่ไม่ได้กำหนดเปอร์เซ็นต์ความแม่นยำที่คงที่สำหรับทุกครั้ง.
ปรับระดับความละเอียดของการทบทวนให้สอดคล้องกับผลลัพธ์ที่ต้องการ ตรวจสอบแบบสุ่มสำหรับบทสรุปที่มีระดับความเสี่ยงต่ำ สำหรับการทบทวนวรรณกรรม บันทึกการตรวจสอบอย่างละเอียด หรือรายงานที่มีข้อมูลสถิติที่ชัดเจน ให้ตรวจสอบตัวเลขแต่ละตัวและอ่านแหล่งข้อมูลต้นฉบับของเรา คู่มือแบบจำลองและโหมด อธิบายความแตกต่างในกระบวนการทำงาน; แต่ไม่สามารถแทนที่การตรวจสอบได้.
Perplexity มีความแม่นยำกว่า ChatGPT สำหรับการอ้างอิงหรือไม่?
ในภารกิจระบุแหล่งข่าวเฉพาะของ Tow Center, Perplexity ให้คำตอบผิดน้อยกว่า ChatGPT Search นี่เป็นการเปรียบเทียบที่ยุติธรรมสำหรับภารกิจเดียวกันเท่านั้น ไม่ใช่การตัดสินโดยรวมเกี่ยวกับทุกโมเดล ทุกคำค้นหา ทุกวันที่ หรือทุกโหมด.
การเปรียบเทียบที่ยุติธรรมจำเป็นต้องใช้คำสั่ง ชุดข้อมูลต้นทาง ช่วงเวลากฎการให้คะแนน และวิธีการจัดการกับการไม่ลงคะแนนที่เหมือนกัน สำหรับบริบทของกระบวนการทำงานที่กว้างขึ้น โปรดดู การทดสอบ Perplexity กับ ChatGPT.
เมื่อใดจึงสามารถใช้การอ้างอิงแบบ Perplexity ได้อย่างปลอดภัย?
| กรณีการใช้งาน | วิธีจัดการกับการอ้างอิง |
|---|---|
| การค้นพบหัวข้อและแหล่งข้อมูล | จุดเริ่มต้นที่ดี; แหล่งข้อมูลเปิด. |
| การเน้นข่าวล่าสุด | ตรวจสอบวันที่ เอกสารต้นฉบับ และการอัปเดต. |
| สรุปแบบไม่จริงจัง | ตรวจสอบแบบสุ่มต่อคำกล่าวที่มีข้อสรุป. |
| การทบทวนวรรณกรรมทางวิชาการ | อ่านและอ้างอิงบทความต้นฉบับ. |
| การตัดสินใจด้านทางการแพทย์ กฎหมาย การเงิน หรือความปลอดภัย | ให้ถือว่าผลลัพธ์เป็นเพียงข้อมูลเบื้องต้นเท่านั้น. |
| การติดตามแบรนด์และ AEO | ติดตามการปรากฏตัวและความแม่นยำอย่างแยกกัน. |
ก่อนที่จะอัปโหลดเอกสารภายในหรือข้อมูลส่วนตัวเพื่อใช้ในงานวิจัย AI โปรดตรวจสอบนโยบายที่เกี่ยวข้องและมาตรการควบคุมในพื้นที่ทำงานก่อน โดยคู่มือของเราเกี่ยวกับ ความเป็นส่วนตัวของข้อมูล AI ในนโยบายของโมเดลต่าง ๆ เป็นจุดเริ่มต้นที่มีประโยชน์.
คุณสามารถตรวจสอบข้อมูลที่กล่าวอ้างเกี่ยวกับแบรนด์ได้อย่างไร?
“We were cited” เป็นเพียงบรรทัดแรกของรายงานการตรวจสอบเท่านั้น ให้บันทึกคำถาม คำตอบเกี่ยวกับข้ออ้าง URL ที่อ้างอิง ประเภทแหล่งข้อมูล และว่าหน้านั้นสนับสนุนข้ออ้างดังกล่าวหรือไม่ ให้เพิ่มโหมดและวันที่ทดสอบด้วย เนื่องจากระบบเว็บและระบบการค้นหาอาจมีการเปลี่ยนแปลง.
| สนามตรวจสอบ | ควรบันทึกอะไร |
|---|---|
| คำถาม | คำสั่งที่แม่นยำ และตลาดหรือภาษา |
| คำเรียกร้อง | ประโยค หมายเลข หรือคำอธิบายที่ต้องการตรวจสอบ |
| การอ้างอิง | URL, ชื่อ, ผู้เผยแพร่ และวันที่เข้าถึง |
| สถานะการสนับสนุน | ได้รับการสนับสนุน, ส่วนหนึ่ง, ถูกคัดค้าน, หรือไม่พบ |
| ที่มา | ต้นฉบับ, ที่เผยแพร่ร่วมกัน, อย่างเป็นทางการ, ระดับรอง หรือของชุมชน |
| บริบท | โหมด, รุ่น, วันที่ และหมายเหตุการเปลี่ยนแปลง |
หากคุณกำลังตรวจสอบคำตอบเกี่ยวกับบริษัทของคุณหรือบริษัทคู่แข่ง ให้เปรียบเทียบราคา คุณสมบัติ และข้อจำกัดแต่ละข้อกับหน้าผลิตภัณฑ์ต้นฉบับ ตัวอย่างเช่น การอ้างอิงถึงหน้ากำหนดราคาไม่สามารถสนับสนุนคำกล่าวอ้างว่าคุณสมบัติดังกล่าวถูกรวมอยู่ได้ เว้นแต่หน้านั้นจะระบุคุณสมบัติดังกล่าวไว้ในแผนบริการเดียวกัน ให้บันทึกความไม่ตรงกันไว้ก่อนที่จะนำคำตอบดังกล่าวไปใช้ซ้ำในรายงานหรือคำแนะนำ.
สำหรับการตัดสินใจเกี่ยวกับผลิตภัณฑ์ที่เกี่ยวข้อง โปรดดู ทางเลือกที่สร้างความสับสน, คู่มือสำหรับ วิธีทำงานของ Perplexity เมื่อเทียบกับ Google และ ChatGPT, และภาพรวมของ คุณสมบัติการวิจัยและการอ้างอิงของ Perplexity.
คำถามที่มักถูกถาม
Perplexity ให้ข้อมูลที่ถูกต้องหรือไม่?
Perplexity สามารถให้ข้อมูลที่มีประโยชน์และทันสมัยได้ โดยเฉพาะอย่างยิ่งในการค้นหาแหล่งข้อมูล ความถูกต้องของข้อมูลขึ้นอยู่กับคำค้นหา ชุดแหล่งข้อมูล รูปแบบการค้นหา และคำกล่าวอ้าง ควรถือว่าตัวเลข วันที่ คำพูด และคำแนะนำที่สำคัญยังไม่ได้รับการยืนยัน จนกว่าหน้าอ้างอิงจะสนับสนุนข้อมูลดังกล่าว.
แหล่งข้อมูล Perplexity เชื่อถือได้หรือไม่?
บางแหล่งข้อมูลมีความน่าเชื่อถือ บางแหล่งไม่มีความน่าเชื่อถือ ป้ายกำกับแหล่งข้อมูลสามารถช่วยคุณประเมินเว็บไซต์ได้ แต่ไม่สามารถพิสูจน์ได้ว่าบทความนั้นสนับสนุนข้อความใดข้อความหนึ่งได้ ตรวจสอบวันที่ แหล่งที่มา และบริบทของข้อมูล.
ความแม่นยำของ AI Perplexity เป็นอย่างไร?
ไม่มีค่าเปอร์เซ็นต์เดียวในปัจจุบันที่สามารถครอบคลุมทุกการค้นหาและทุกโหมดได้ มาตรฐานการวัดประสิทธิภาพสาธารณะที่รู้จักกันดีที่สุดได้พบอัตราการผิดพลาด 37% ในงานระบุแหล่งข่าวหนึ่งงาน โปรดรายงานผลนี้พร้อมตัวอย่างและงานที่เกี่ยวข้อง ไม่ใช่ในฐานะคะแนนที่ใช้ได้ทั่วไป.
การอ้างอิงแบบ Perplexity หมายความว่าข้อกล่าวอ้างนั้นได้รับการยืนยันแล้วหรือไม่?
ไม่ การอ้างอิงหมายถึงการระบุแหล่งที่มา ส่วนการตรวจสอบต้องดูว่าแหล่งที่มาดังกล่าวมีหลักฐานที่สนับสนุนคำกล่าวนั้นอย่างแม่นยำในบริบทและขอบเขตเดียวกันหรือไม่.
Perplexity เหมาะสำหรับการเขียนงานวิชาการหรือไม่?
มันสามารถช่วยค้นหาบทความและสร้างรายชื่อบทความที่จะอ่านได้ เปิดบทความต้นฉบับ ตรวจสอบคำอ้างอิงหรือผลลัพธ์ และอ้างอิงบทความนั้นเอง.
Perplexity มีความแม่นยำกว่า ChatGPT หรือไม่?
Perplexity มีผลการทดสอบที่ดีกว่า ChatGPT Search ในการทดสอบการระบุแหล่งข่าวเฉพาะของ Tow Center อย่างไรก็ตาม สิ่งนี้ไม่ได้หมายความว่า Perplexity จะเป็นผู้ชนะในทุกหัวข้อหรือรูปแบบ.
ทำอย่างไรเพื่อตรวจสอบว่าการอ้างอิงแบบ Perplexity นั้นถูกต้องหรือไม่?
เปิดการอ้างอิงที่ถูกต้อง ค้นหาคำสำคัญหรือหมายเลข อ่านย่อหน้าโดยรอบ และเปรียบเทียบหัวข้อ ขอบเขต วันที่ และทิศทาง ทำเครื่องหมายว่า "ยังไม่ได้รับการยืนยัน" สำหรับการจับคู่ที่ไม่ตรงกัน.
Perplexity สามารถอ้างอิงแหล่งข้อมูลที่ผิดได้หรือไม่ แม้ลิงก์นั้นจะทำงานได้?
ใช่ครับ หน้าเว็บนั้นอาจถูกเผยแพร่และมีความเกี่ยวข้องได้ แม้จะยังไม่สามารถสนับสนุนคำกล่าวอ้างนั้นได้อย่างถูกต้อง การตรวจสอบความสอดคล้องระหว่างคำกล่าวอ้างกับแหล่งที่มา มีประโยชน์มากกว่าการตรวจสอบเพียงว่า URL นั้นสามารถเข้าถึงได้หรือไม่.
ต้องการพื้นที่ทำงานสำหรับงานวิจัยที่มีการอ้างอิงหรือไม่? ลองสำรวจ Perplexity ถึง GlobalGPT เมื่อคุณต้องการเส้นทางตรงสู่ประสบการณ์การวิจัย และสถานที่เดียวเพื่อเปรียบเทียบกระบวนการทำงานของ AI.
เปิด Perplexity ใน GlobalGPTสรุป: ให้ถือการอ้างอิงเป็นข้อมูลนำ แล้วตรวจสอบความถูกต้องของข้อกล่าวอ้าง
การอ้างอิงของ Perplexity ช่วยให้การวิจัยดำเนินไปอย่างรวดเร็วขึ้น เพราะมันให้เส้นทางกลับไปยังเว็บไซต์ต้นทาง แต่ไม่ได้ทำให้การอ่านแหล่งข้อมูลต้นทางไม่จำเป็น ผลลัพธ์จาก Tow Center/CJR เป็นหลักฐานที่มีประโยชน์ แต่ตัวเลข 37% นั้นเกี่ยวข้องกับงานเฉพาะด้านแหล่งข่าวที่กำหนดไว้เท่านั้น มันไม่ใช่คะแนนการอ้างอิง Perplexity ที่ถาวรและใช้ได้ทั่วไป.
เมื่อมีข้ออ้างที่สำคัญ ให้ระบุข้ออ้างนั้น เปิดแหล่งอ้างอิง ค้นหาหลักฐาน และเปรียบเทียบบริบท นิสัยนี้จะช่วยตรวจพบข้อผิดพลาดที่อินเทอร์เฟซที่ดูดีอาจซ่อนไว้ และให้คุณมีบันทึกที่สามารถอธิบายได้อย่างชัดเจน เมื่อจำเป็นต้องชี้แจงที่มาของคำตอบ.









