Тесты проводились 7 и 11 сентября 2026 года; источники были перепроверены 16 сентября 2026 года.
В названии нужно внести одно уточнение. Люди по-прежнему ищут “Grok 4”, но модель, которую мы тестировали, была Grok 4,6, а не первоначальная дата выпуска — июль 2025 года. Текущая Каталог моделей xAI рекомендует использовать код Grok 4.6, тогда как в оригинале grok-4-0709 Название API больше не используется. В данном обзоре я буду рассматривать эти продукты и даты отдельно.
Если вы сравниваете несколько помощников перед тем, как выбрать одного из них, начните с более общего лучшая модель искусственного интеллекта для сравнения кода. В данном случае более узкий вопрос заключается в том, может ли Grok преобразовать четкое техническое задание на программирование в результат, который можно реально проверить.
Краткий ответ: подходит ли Grok 4 для программирования?
Версия Grok 4.6 достаточно хороша, чтобы использовать её для отладки изолированной функции, создания первоначальной реализации, разъяснения незнакомого кода и составления тестов. Однако она недостаточно надёжна, чтобы принимать результаты без их выполнения. Ошибки, обнаруженные в нашем небольшом наборе тестов, не были связанны с неочевидными стилистическими несоответствиями: один рефакторинг привёл к нетто из каждого непустого результата, и один из сгенерированных наборов тестов не смог отличить задержку от абсолютной временной метки.
Практический принцип прост: задайте узкие рамки контракта, попросите внести одно изменение и проведите независимую проверку. Даже модель, которая быстро генерирует правдоподобный код, может удалить одно поле, ослабить один инвариант или выполнить требование к коду, но при этом проигнорировать требование к формату ответа.
Вы можете попробуйте Grok 4.6 на GlobalGPT для ограниченных подсказок и параллельных сравнений. GlobalGPT — это независимая платформа; она не заменяет Grok Build, IDE, доступ к репозиторию, собственную консоль API xAI или ваш конвейер непрерывной интеграции.
Что мы на самом деле тестировали
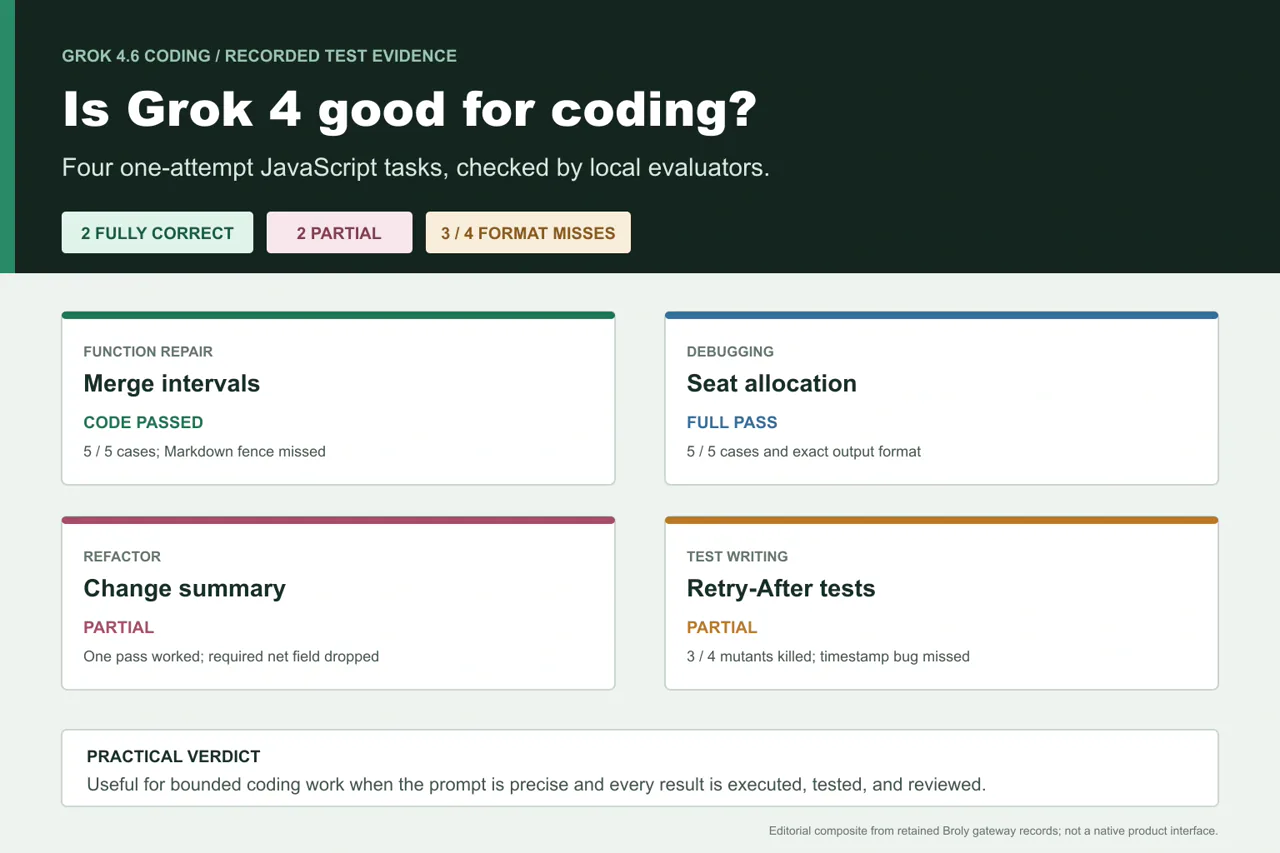
Мы провели анализ четырёх небольших задач на JavaScript: исправление слияния интервалов, отладка алгоритма распределения мест с учётом приоритетов, рефакторинг функции, формирующей сводку изменений, и написание тестов для Retry-After анализатор. Каждая задача имела фиксированную запросную строку и детерминированный локальный оцениватель. Три задачи были запущены 11 сентября 2026 года; для задачи «интервал» был повторно использован запуск от 7 сентября, который мы перепроверили по сравнению с сохраненными данными: запросной строкой, исходным ответом и оценивателем.
- Место проведения: API агрегации Broly, авторизованное пользователем, — «Завершение ввода в чате».
- Запрошенная и возвращенная модель:
grok-4.6. - Попытки: один запрос на каждую задачу, без повторных попыток.
- Выполнение: возвращаемый JavaScript изолировался и запускался локально с использованием заранее объявленных фикстур или мутантов.
- Недоступно для данной модели: IDE, репозиторий, доступ в Интернет, средства запуска инструментов xAI и производственные системы.
Метка шлюза является полезной информацией о происхождении, но сама по себе не подтверждает развертывание на вышестоящем уровне. Время выполнения включает сетевые задержки и накладные расходы шлюза, а указанное количество токенов не является основанием для официального выставления счетов xAI. Для получения более полной картины на уровне продукта см. отдельный Обзор и реальные тесты Grok 4.6.
Краткий обзор результатов теста по программированию
нетто.Лучшим результатом оказался не самый длинный ответ. Им стал вариант исправления алгоритма распределения мест: лаконичный, правильно отформатированный и полный с точки зрения поведения. Наиболее поучительной ошибкой стал вариант рефакторинга, поскольку реализация выглядела аккуратно и соответствовала требованию «одного прохода», но при этом незаметно изменяла контракт вывода.
Тест 1: исправление функции интервала слияния
Первая функция изменяла значение входных данных, давала сбой при работе с пустым массивом, не могла объединить соприкасающиеся конечные точки и могла сократить более широкий интервал, если позже появлялся вложенный интервал. Подсказка позволила явно сформулировать эти инварианты.
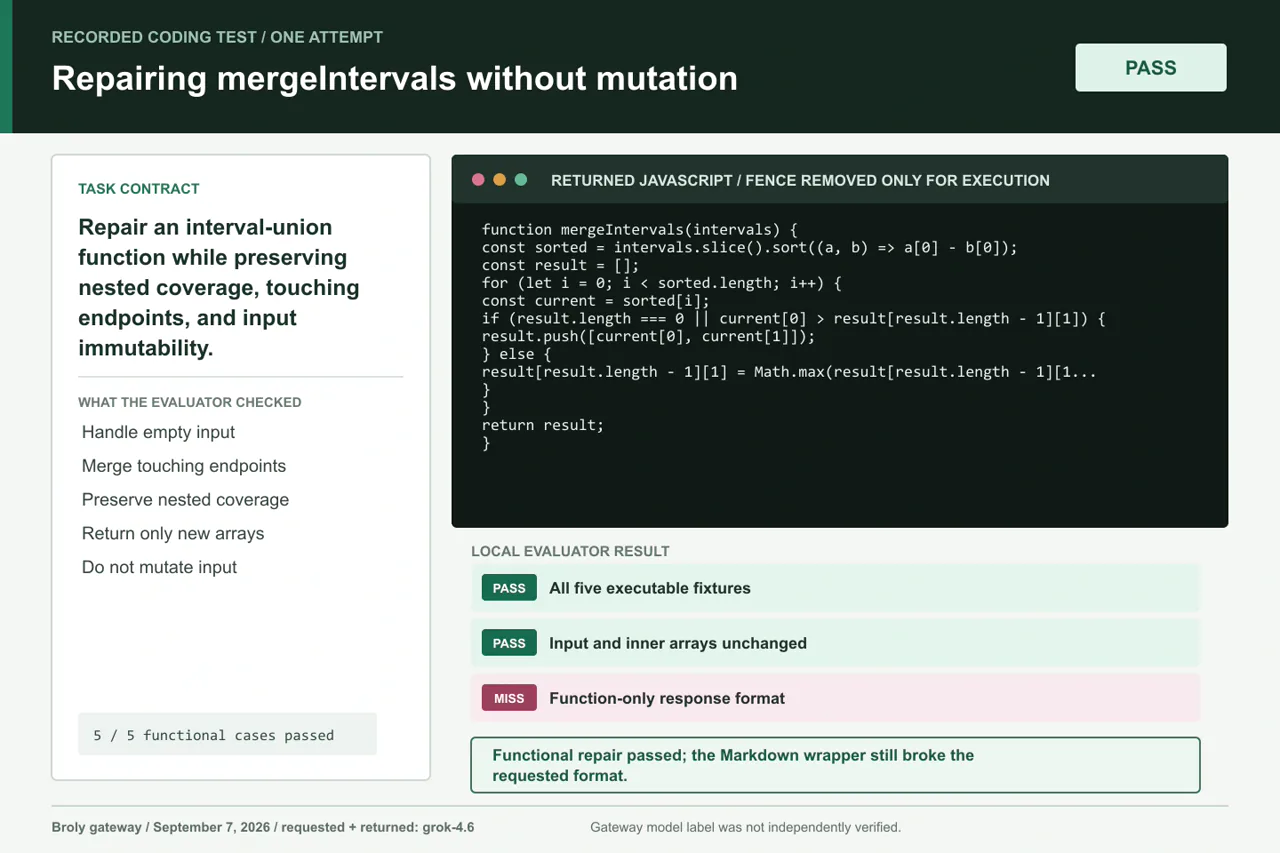
Ключевая граница: Функциональное восстановление прошло успешно после удаления только внешнего ограждения Markdown для выполнения.
Результат: Все пять тестовых случаев прошли успешно. Функция возвращала новые массивы, не изменяла входные данные, сохраняла вложенное покрытие и объединяла соседние конечные точки. При этом она по-прежнему не прошла тест на одну явную инструкцию из-за обертывания кода в Markdown. После удаления только этого внешнего ограждения для выполнения функциональный результат оказался правильным.
Практический вывод: Grok справился с небольшой исправлением, когда подсказка указала на скрытые крайние случаи. Нарушение форматирования незначительно для человека, но может привести к сбою конвейера, который ожидает текст, готовый к непосредственному выполнению.
Тест 2: отладка распределения мест на основе приоритетов
В этой задаче сочетались следующие условия: обработка стабильных равных значений, приоритет по убыванию, отсутствие мутаций, точная пропускная способность и правило “пропустить и продолжить”. Исходный код сортировал в неправильном направлении, изменял входной массив и останавливался слишком рано, когда один запрос превышал допустимый размер.
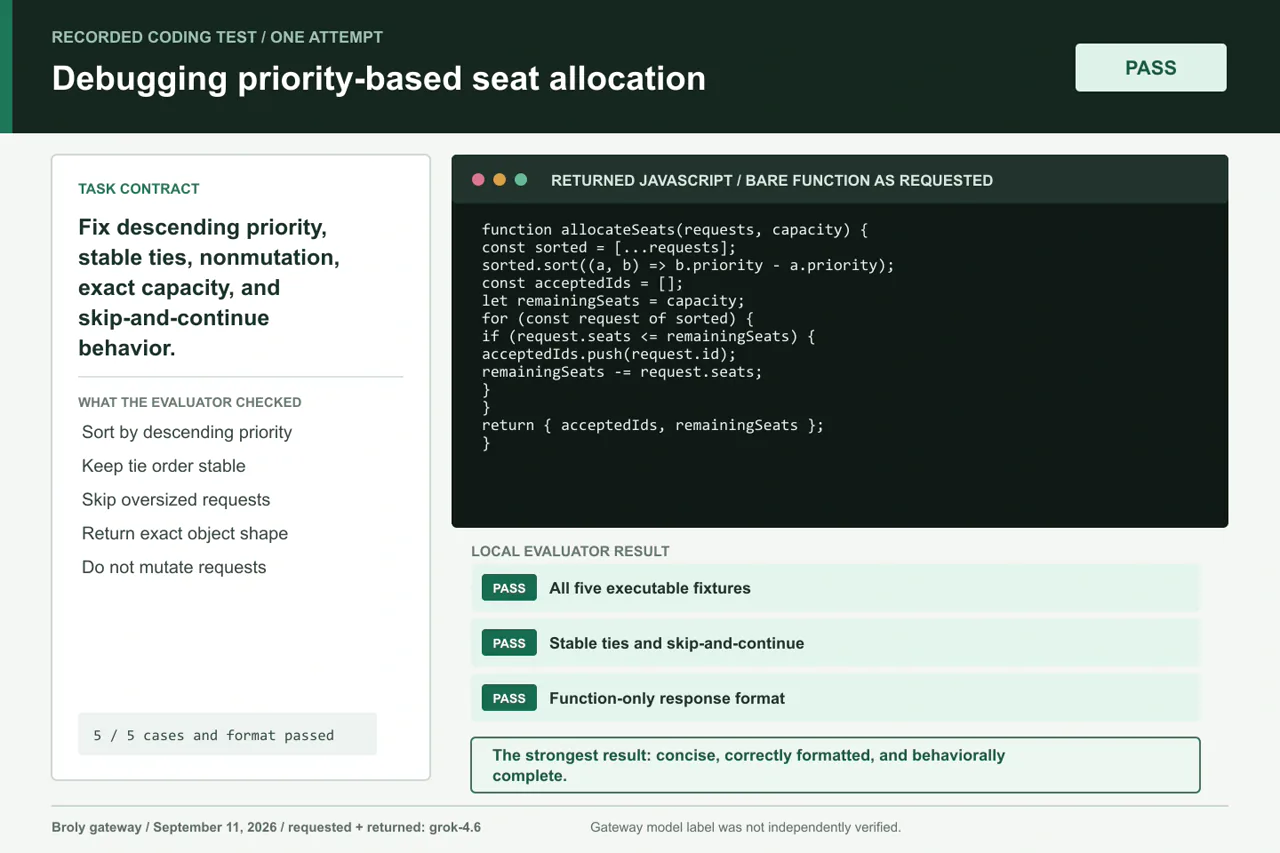
Ключевая граница: Это был единственный ответ, который соответствовал как условиям поведенческого контракта, так и точному формату вывода.
Результат: Все пять тестов прошли успешно, включая случаи с одинаковым приоритетом, запрос с превышением размера, точную емкость, нулевую емкость и пустой список. Входные данные остались неизменными, принятые_идентификаторы был новым массивом, а модель вернула только запрошенную функцию.
Практический вывод: Именно для таких задач Grok подходит как нельзя лучше: одна функция, четкий контракт и пограничные случаи, которые можно реализовать сразу же.
Тест 3: рефакторинг без потери функциональности
В третьем задании Grok было предложено заменить повторяющиеся прогоны сканирования одним прогоном агрегации, сохранив при этом порядок, необычные имена файлов и точную структуру выходных данных. Это реальный риск рефакторинга: код может стать быстрее и лаконичнее, но при этом утратить часть функциональности.
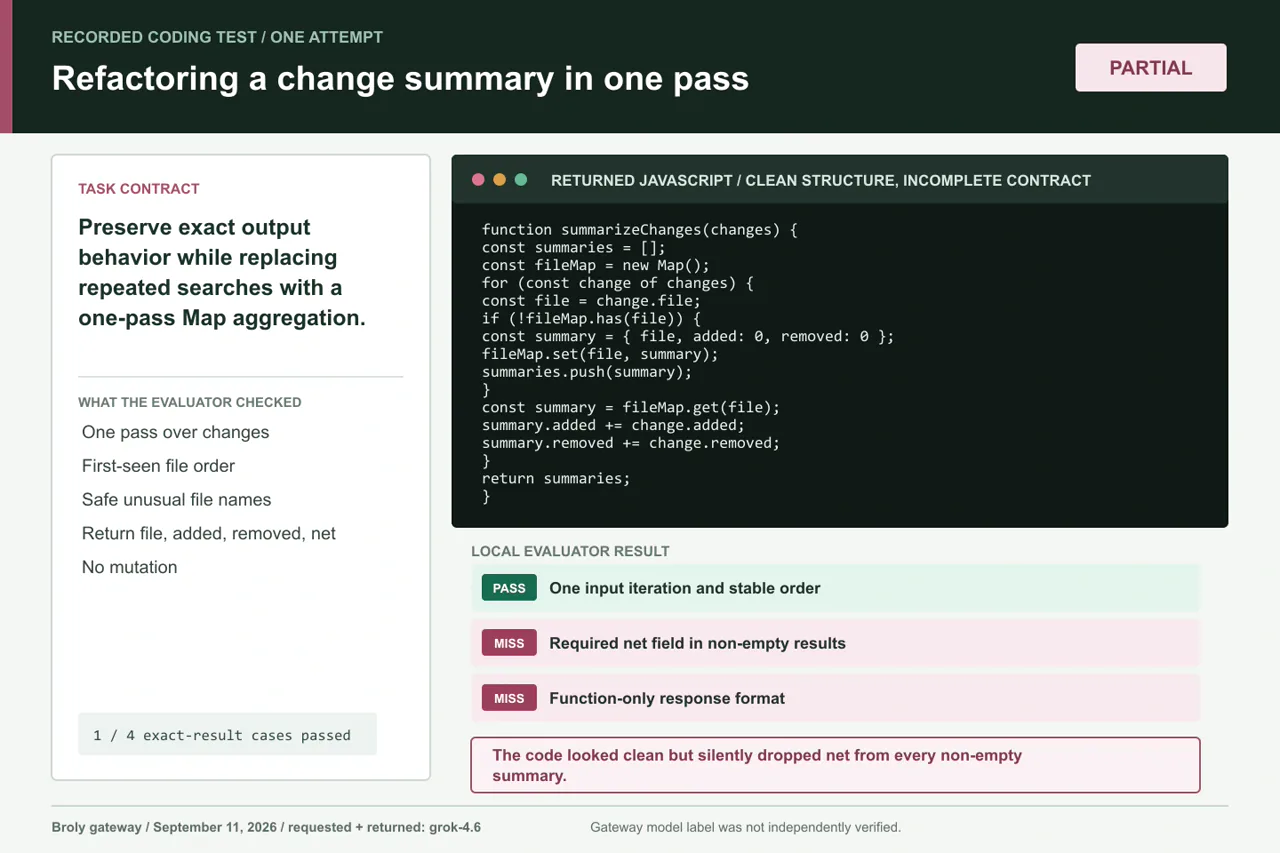
Ключевая граница: Подход с использованием карты в один проход выглядел правильным, но незаметно исключил требуемое поле «net».
Результат: в ответе использовался один проход, а Карта, правильный порядок отображения новых элементов, безопасная обработка __proto__ и конструктор, и мутаций входных данных не было. Но он так и не вычислил и не вернул нетто. Пустой случай прошел проверку, поскольку в нём не было объектов результата; все три непустых случая не прошли точное сравнение.
Практический вывод: Никогда не оценивайте рефакторинг исключительно по алгоритмической сложности или «чистоте» кода. Сделайте снимок старых результатов вывода, проверьте все обязательные поля и сравните поведение, прежде чем принимать новую версию.
Тест 4: написание тестов, выявляющих вероятные ошибки
В заключительном задании обычная схема была перевернута: Grok написал тесты, а наша тестовая среда запустила их на одной строгой эталонной реализации и четырёх намеренно некорректных реализациях. Целью было не покрытие кода. Речь шла о том, позволяют ли выбранные входные данные различить внешне схожие семантики.
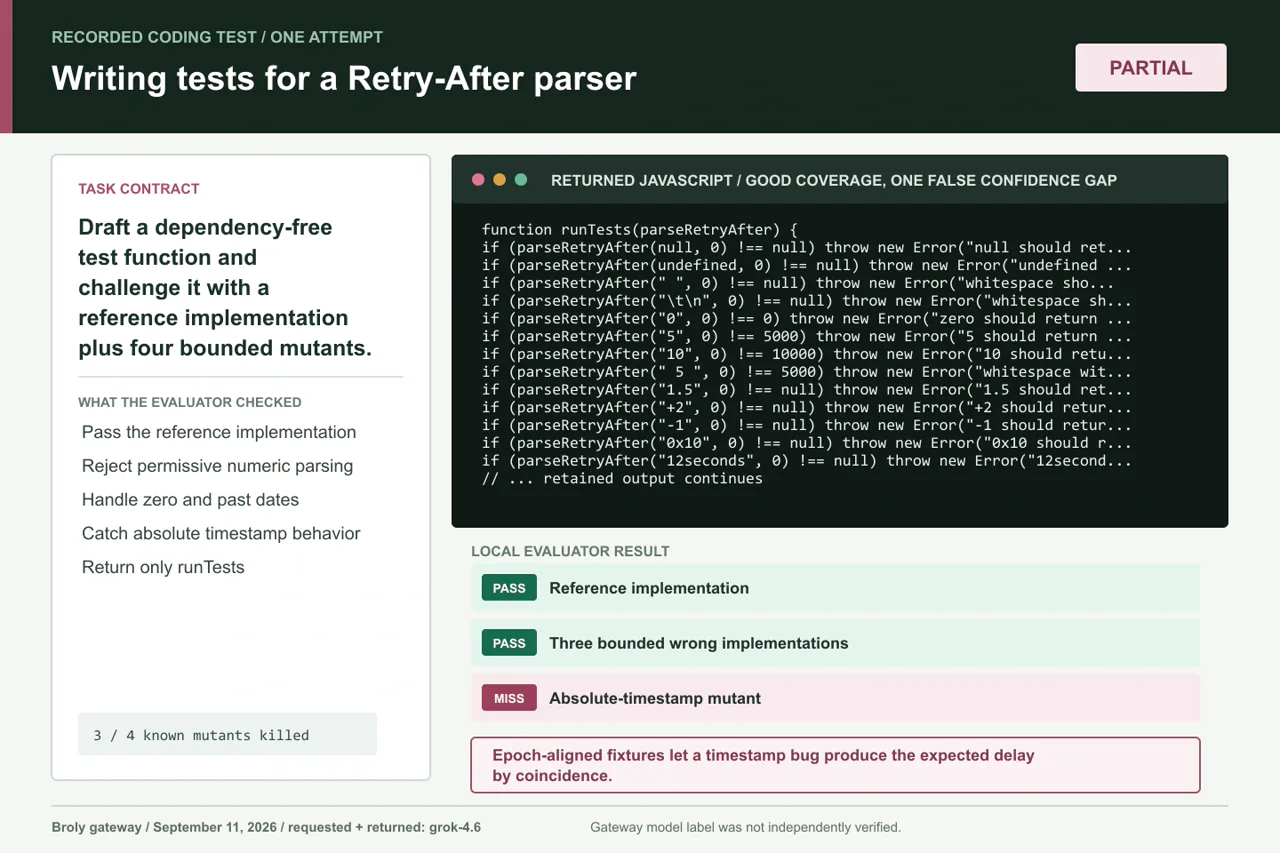
Ключевая граница: Фиксаторы даты, привязанные к эпохе, позволяют ошибке с абсолютной временной меткой остаться незамеченной по стечению обстоятельств.
Результат: Набор тестов прошел базовую проверку и выявил ошибки при разрешительном числовом разборе, когда ноль рассматривался как значение, не равное true, а также отрицательную задержку для даты, лежащей в прошлом. Он не зафиксировал мутант, который возвращал абсолютную временную метку разобранной даты. В обоих тестах с датами использовались значения, выровненные по эпохе, поэтому ожидаемая задержка оказалась равной временной метке.
Практический вывод: Тесты, написанные с помощью ИИ, — это полезный первый этап, но не доказательство правильности. Спросите, что именно выявляет каждый фикст. Мутационное тестирование, тесты свойств и намеренно несогласованные значения могут выявить набор тестов, который лишь на первый взгляд кажется исчерпывающим.
Grok 4, Grok 4.6 и Grok Build — это не одно и то же
Контекст запуска в июле 2025 года. Старый слог API впоследствии был выведен из обращения.
Метка, возвращаемая шлюзом в этих четырёх изолированных задачах.
Отдельный агент, способный работать в рамках рабочего процесса репозитория как в интерактивном режиме, так и в режиме без интерфейса.
Инструмент на языке Python, работающий в изолированной среде, который необходимо включить в поддерживаемом запросе.
Сайт оригинальное объявление Grok 4 Это исторический контекст запуска. В нём не описывается модель, использованная в наших испытаниях 2026 года.
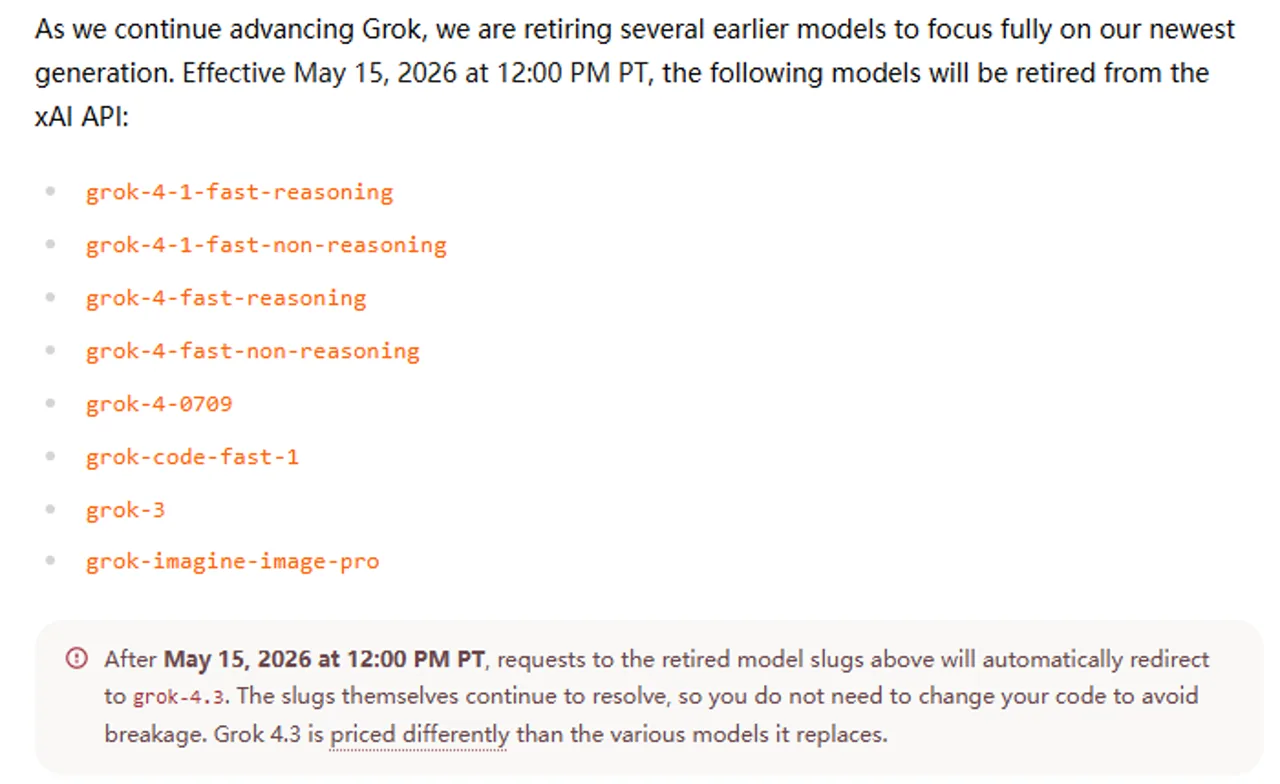
xAI’s Уведомление о миграции от 15 мая 2026 года говорит grok-4-0709 Теперь происходит перенаправление на Grok 4.3 с низким уровнем логического вывода. Это не означает, что все продукты с обозначением серии Grok 4 исчезли; это означает, что важно точное идентификационное обозначение модели.
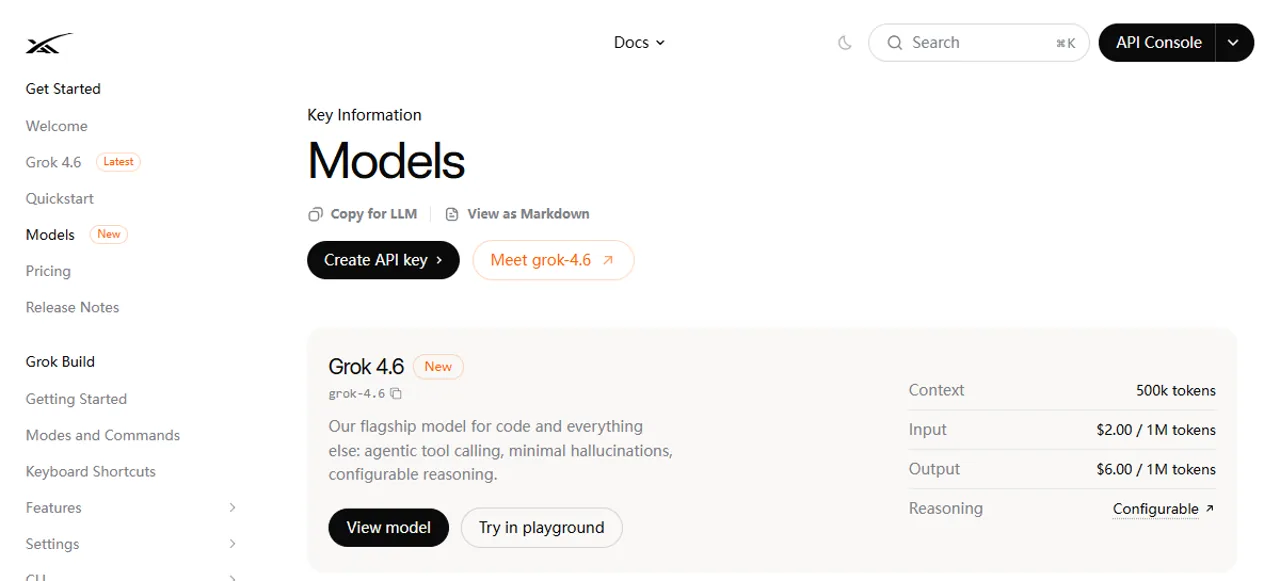
Grok 4.6 — это текущая модель, которую xAI рекомендует для кодирования. Официальная Технические характеристики Grok 4.6 Среди поддерживаемых инструментов указаны вызов функций, веб-поиск, поиск в X и выполнение кода. Поддержка не означает автоматическую активацию: вызывающий продукт или запрос API по-прежнему определяют, что модель может видеть и делать.
Сайт Объявление о модели Grok 4.6 определяет позицию модели в контексте долгосрочных агентов и работы с кодовой базой. Это официальное заявление о продукте, а не результат независимых измерений, проведенных нашими четырьмя изолированными задачами на JavaScript.
Сборка Grok является отдельным средством кодирования. Благодаря интерактивному интерфейсу терминала и режиму без графического интерфейса оно может работать в рамках рабочего процесса репозитория. Если вы выбираете из списка названий моделей, а не из продуктов кодирования, то Лучшая модель Grok для конкретной задачи В этом руководстве рассказывается о нынешней семье.
Сайт Инструмент для выполнения кода xAI представляет собой опциональную изолированную среду Python. В ходе наших тестов с Broly она не была активна, поэтому модель не запускала собственный JavaScript и не анализировала отзывы оценщика перед тем, как дать ответ.
Лучшие примеры применения кодирования для Grok
Отладка локализованного сбоя
Grok наиболее эффективен в тех случаях, когда сбой можно свести к функции, трассировке стека, неработающему фикстуру или небольшому диффу. Укажите, что должно было произойти, что произошло на самом деле и какие границы поведения не должны изменяться. Результат распределения мест демонстрирует, как конкретный пограничный случай может превратить расплывчатую просьбу “исправьте это” в проверяемый патч.
Создание первой реализации
Что касается адаптеров, парсеров, функций преобразования и примеров использования API, Grok позволяет устранить трудности, связанные с «пустыми страницами». Запросите минимальный полный модуль, версии библиотек выводов и запустите фрагмент кода. Руководство по интеграции Grok 4 API это следующий шаг, когда работа связана с API, а не с отдельным кодовым решением.
Проверка или составление тестов
Обратитесь к Grok для выявления пропущенных пограничных случаев, инвариантов и возможных мутаций. Затем проверьте, позволяет ли каждое входное значение различить поведение, которое оно якобы тестирует. Набор тестов Retry-After на бумаге казался обширным, однако одна пара совпадающих временных меток позволила семантической ошибке остаться незамеченной.
Сравнение альтернативных подходов
Grok также полезен в качестве «второго мнения» по поводу алгоритма, структуры данных или гипотезы об отладке. Когда речь идет о подборе подходящего помощника, а не о конкретном исправлении, то Сравнение кодировок Grok и ChatGPT добавляет представление, объединяющее несколько моделей.
В случаях, когда кодирование Grok требует контроля
Рефакторинг с сохранением поведения: Модель может поддерживать требуемый алгоритм, несмотря на отсутствие одного поля вывода. Запустите регрессионные тесты и сравните сериализованные выводы, ошибки, порядок, мутации и побочные эффекты.
Изменения в репозитории с несколькими файлами: Наши данные не охватывают обнаружение зависимостей, системы сборки, поиск кода, сгенерированные файлы, миграции и скоординированное редактирование. Воспользуйтесь настоящим агентом для программирования с ограниченным доступом к репозиторию, а затем просмотрите его команды и сравните изменения. Сравнение агентов «Codex» и «Claude» показывает, почему сопутствующий рабочий процесс имеет такое же большое значение, как и сама модель.
Работа в сфере безопасности и производства: Не рассматривайте уверенный ответ как модель угроз, аудит зависимостей или одобрение развертывания. Обязательно включайте в процесс непрерывную интеграцию (CI), статический анализ, сканирование секретных данных, промежуточную среду, откат и проверку специалистом.
Строгие форматы обмена данными между машинами: В трёх из четырёх необработанных ответов использовался разделитель Markdown, несмотря на явные инструкции об отказе от использования Markdown. Проверяйте и анализируйте вывод на границе; никогда не передавайте текст модели напрямую на выполнение, поскольку он выглядит как код.
Расходы и длинные цепочки рассуждений: наш шлюз сообщил о 4 260 токенах завершения для запроса с max_tokens: 4096, в основном в качестве токенов рассуждений. Это наблюдение не доказывает поведение xAI в отношении выставления счетов или ограничений. Ознакомьтесь с текущей официальной платформой и сравните её с Grok 4. Руководство по ценообразованию и настройке API прежде чем рассчитывать бюджет производства.
Практический алгоритм работы с Grok при написании кода
1. Упростить задачу
Предоставьте для Grok минимальный вариант воспроизведения, при котором ошибка по-прежнему возникает. Укажите суть ошибки, соответствующий код и один ожидаемый результат. Удалите не относящуюся к делу историю проекта и конфиденциальные данные.
2. Составьте договор, а не просто список пожеланий
Укажите название функции, принимаемые входные данные, точную структуру возвращаемого значения, порядок вычисления, правила изменения значений, ограничения на зависимости и формат вывода. Укажите Инструкция по эксплуатации Grok, 4 страницы охватывает общий процесс ведения учета и формирования запросов.
3. Попросите мелочь
Отдавайте предпочтение одной функции или целенаправленному изменению, а не радикальной переработке. Попросите сохранить внешнее поведение и указать все допущения, которые пришлось сделать.
4. Провести независимые проверки
Выполняйте код вне ответа модели. Добавляйте пограничные случаи, позволяющие различать схожие семантические значения, проверяйте изменения входных данных, сравнивайте каждое поле вывода и тестируйте ожидаемые сбои. При использовании сгенерированных наборов тестов запускайте известные мутанты, если это оправдано с точки зрения риска.
5. Проанализируйте разницу и примите решение
Просмотрите итоговый файл diff так, как если бы он был подготовлен человеком. Проверьте изменения в зависимостях, границы безопасности, наблюдаемость и возможность отката. Ответственность за результат несет тот, кто выполняет слияние или развертывание.
О чем разработчики сообщают публично
Мнения пользователей неоднозначны и в значительной степени зависят от задачи, продукта, формулировки вопроса и даты. Два комментария на Hacker News иллюстрируют весь спектр мнений, однако ни один из них не является эталоном или репрезентативным опросом.
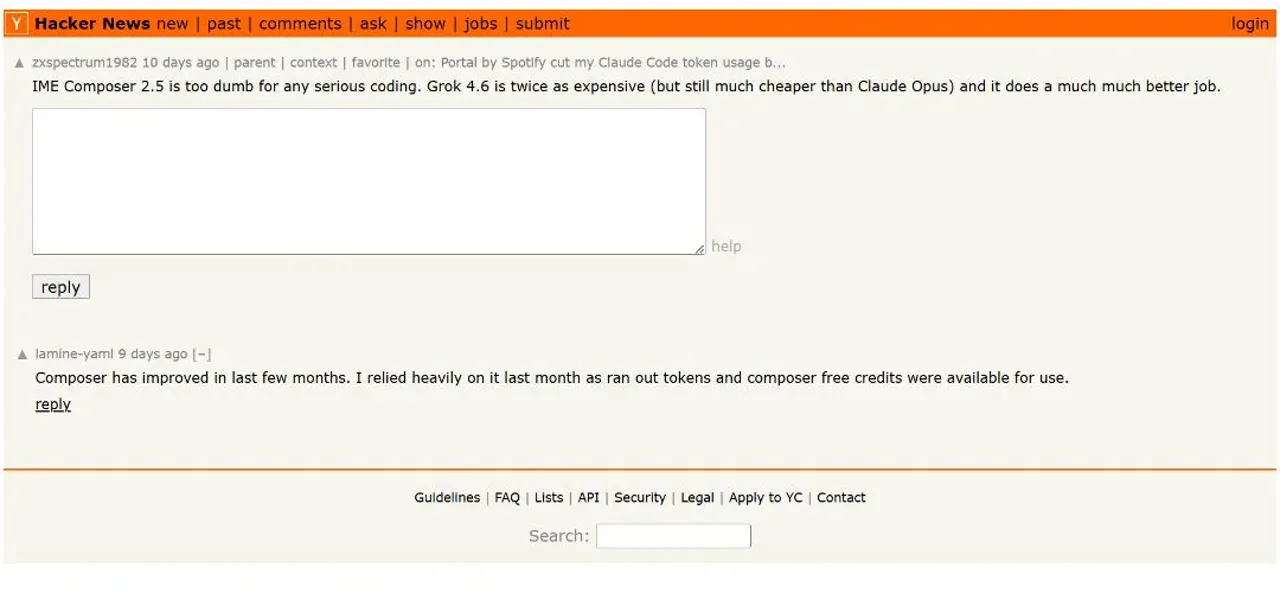
5 сентября 2026 года пользователь Hacker News zxspectrum1982 отметил, что Grok 4.6 справляется с серьезными задачами программирования гораздо лучше, чем Composer 2.5, хотя и отметил, что он стоит дороже. Это сравнение одного пользователя, а не общее утверждение о производительности.
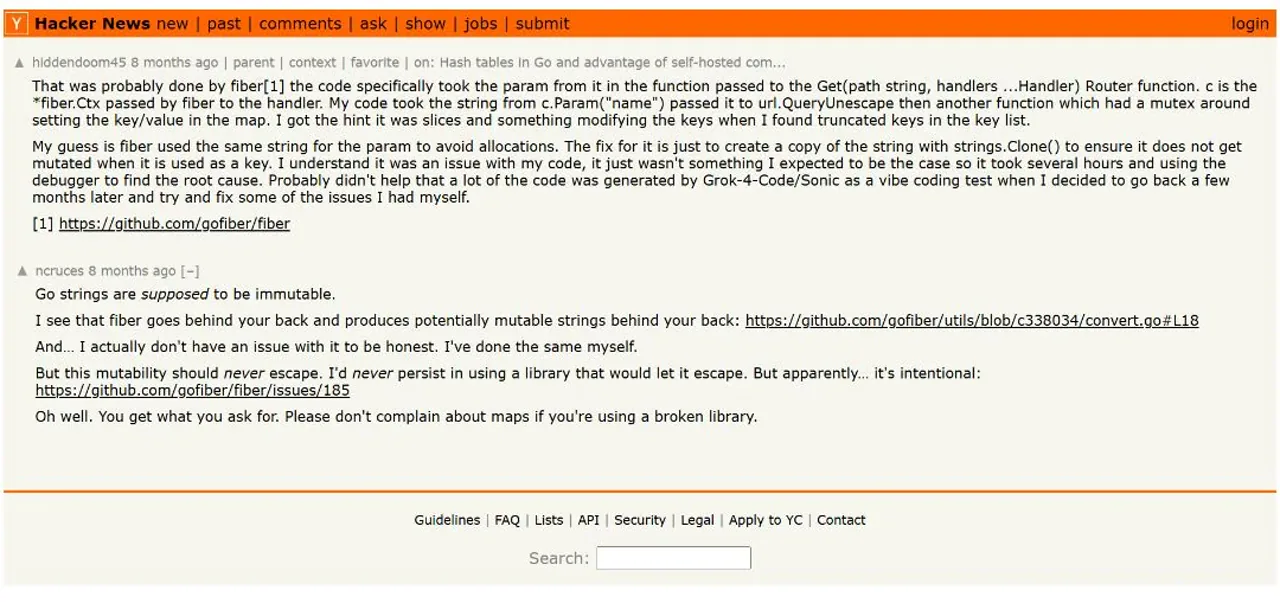
20 декабря 2025 года пользователь Hacker News hiddendoom45 описал обнаружение незаметной ошибки, связанной со сроком жизни строк в Go/Fiber, которое произошло позже с помощью отладчика после генерации кода в ходе эксперимента Grok-4-Code/Sonic. Этот исторический отчет свидетельствует в пользу ручной отладки и проверки с учетом срока жизни объектов; он не подтверждает показатель отказов Grok 4.6.
Общее заключается не в том, что подход Grok всегда приводит к успеху или провалу. Дело в том, что качество кода становится очевидным только после того, как код проходит проверку в контексте конкретной задачи, набора инструментов и рецензента. То же самое верно и в отдельных Проверка реалистичности кодирования ChatGPT: Качество работы помощника неразрывно связано с проверкой.
Часто задаваемые вопросы
Подходит ли Grok 4 для начинающих программистов?
Да, для пояснений, небольших примеров и отладки под руководством. Новичкам всё же следует запускать каждый фрагмент кода, спрашивать, что изменяет каждая строка, и избегать вставки конфиденциальных данных или развертывания незнакомого кода без предварительной проверки.
Какую модель Grok следует использовать для программирования?
По данным на 11 сентября 2026 года xAI рекомендует использовать код Grok 4.6. Уточните точный идентификатор модели вашего продукта, поскольку исходный API-слаг grok-4-0709 больше не используется.
Может ли Grok 4.6 редактировать весь репозиторий?
Модель может поддерживать работу с репозиторием при использовании в рамках агента с ограниченным доступом к файлам и командам. Наши тесты представляли собой изолированные запросы, поэтому они не подтверждают готовность модели к автономной работе с несколькими файлами или к использованию в производственной среде.
Формат «Grok Build» — это то же самое, что и использование «Grok» в чате?
No. Grok Build — это отдельный интерактивный или «безголовый» агент для написания кода. Обычный чат или функция автозаполнения API не получают автоматически контекст его репозитория, терминал, права доступа или цикл инструментов.
Можно ли использовать Grok 4.6 для программирования на GlobalGPT?
Да. GlobalGPT предоставляет проверенный маршрут Grok 4.6 для заданий с ограниченным кодированием и сравнения моделей. Это независимая платформа, которая не заменяет Grok Build, IDE или набор инструментов на базе собственного API xAI.
Стоит ли доверять коду, сгенерированному Grok, не проверив его?
Нет. Запустите код, добавьте пограничные случаи, просмотрите результаты сравнения и выполните обычные проверки на наличие ошибок, типизацию, безопасность и в рамках CI. Наш рефакторинг выглядел корректно, но в каждом непустом результате было пропущено обязательное поле.
Окончательный вердикт
Подходит ли Grok 4 для программирования? Текущая версия модели Grok 4.6 является эффективным помощником в написании кода для ограниченных исправлений, небольших функций, пояснений и тестов первого прохода. В нашем наборе из четырёх задач она выдала два полностью правильных решения, один рефакторинг, нарушающий поведение кода, и один неполный набор тестов. Кроме того, в трёх ответах она проигнорировала строгую инструкцию об отказе от использования Markdown.
Используйте этот подход там, где выявление ошибок обходится недорого: при узкой сфере применения, наличии четко сформулированных соглашений, исполняемых тестовых наборов и проверки специалистами. Не рассматривайте эти данные как разрешение на внесение изменений в репозиторий без контроля, одобрение с точки зрения безопасности или развертывание в производственной среде.
Для проведения практического испытания, открыть позицию Grok 4,6 на GlobalGPT, запустите одну из приведённых выше полных команд и сравните результат с данными ваших собственных тестов, прежде чем решать, стоит ли включать её в ваш рабочий процесс.
Протестируйте Grok 4.6 с помощью собственного приспособления