O Muse Spark 1.3 é a versão mais avançada do Muse Spark da Meta até o momento: o modelo público xhigh atinge 61 no Índice de Inteligência de Análise Artificial, mantém uma janela de contexto de 1 milhão de tokens e foi aprovado em todas as três tarefas de programação de dificuldade média em nosso teste de API de resposta imediata. É importante ressaltar que o gráfico de referência principal da Meta utiliza o “max reasoning”, embora, no momento em que esta análise foi elaborada, o “max” ainda estivesse aguardando um lançamento mais amplo, após a realização de testes de segurança adicionais.

Análise do Muse Spark 1.3: Veredicto rápido
Nosso veredicto
Vale a pena testar o Muse Spark 1.3 para a programação de agentes, trabalhos com contextos extensos e automação sensível a custos. Seu resultado público na categoria “xhigh” já é competitivo em relação aos melhores resultados do mercado, mas não cite as pontuações máximas da Meta como se todos os usuários da API pudessem reproduzi-las hoje.
A Meta lançou o Muse Spark 1.3 em 2 de setembro de 2026, preparando-o para fluxos de trabalho autônomos de longo prazo, código mais limpo e colaboração mais confiável. Isso dá continuidade à mudança em direção a Agentes de IA desenvolvidos com base em modelos de uso de ferramentas. A Meta afirma que o sistema faz perguntas para esclarecer dúvidas quando os requisitos são ambíguos, sinaliza quando fica bloqueado e confirma antes de realizar ações com consequências. Em comparações internas com a versão 1.2, os engenheiros da Meta observaram cerca de 20% a menos de chamadas à ferramenta e 25% a menos de tokens. Essas são afirmações do fornecedor, não resultados de nosso teste.
O que mudou em relação ao Muse Spark 1.2?
Análise Artificial: de 57 a 61 no xhigh.
A Meta apresenta resultados de 75,4 contra 55,0 no DeepSWE, mas compara 1,3 (máximo) com 1,2 (xhigh).
A janela de 1M permanece; os índices MRCR da faixa alta apresentam um aumento acentuado no gráfico da Meta.
As taxas de tokens permanecem estáveis, enquanto o AA registrou $0,55 contra $0,40 por tarefa avaliada.
Testes de desempenho do Muse Spark 1.3: “Max” e “Xhigh” não são a mesma coisa
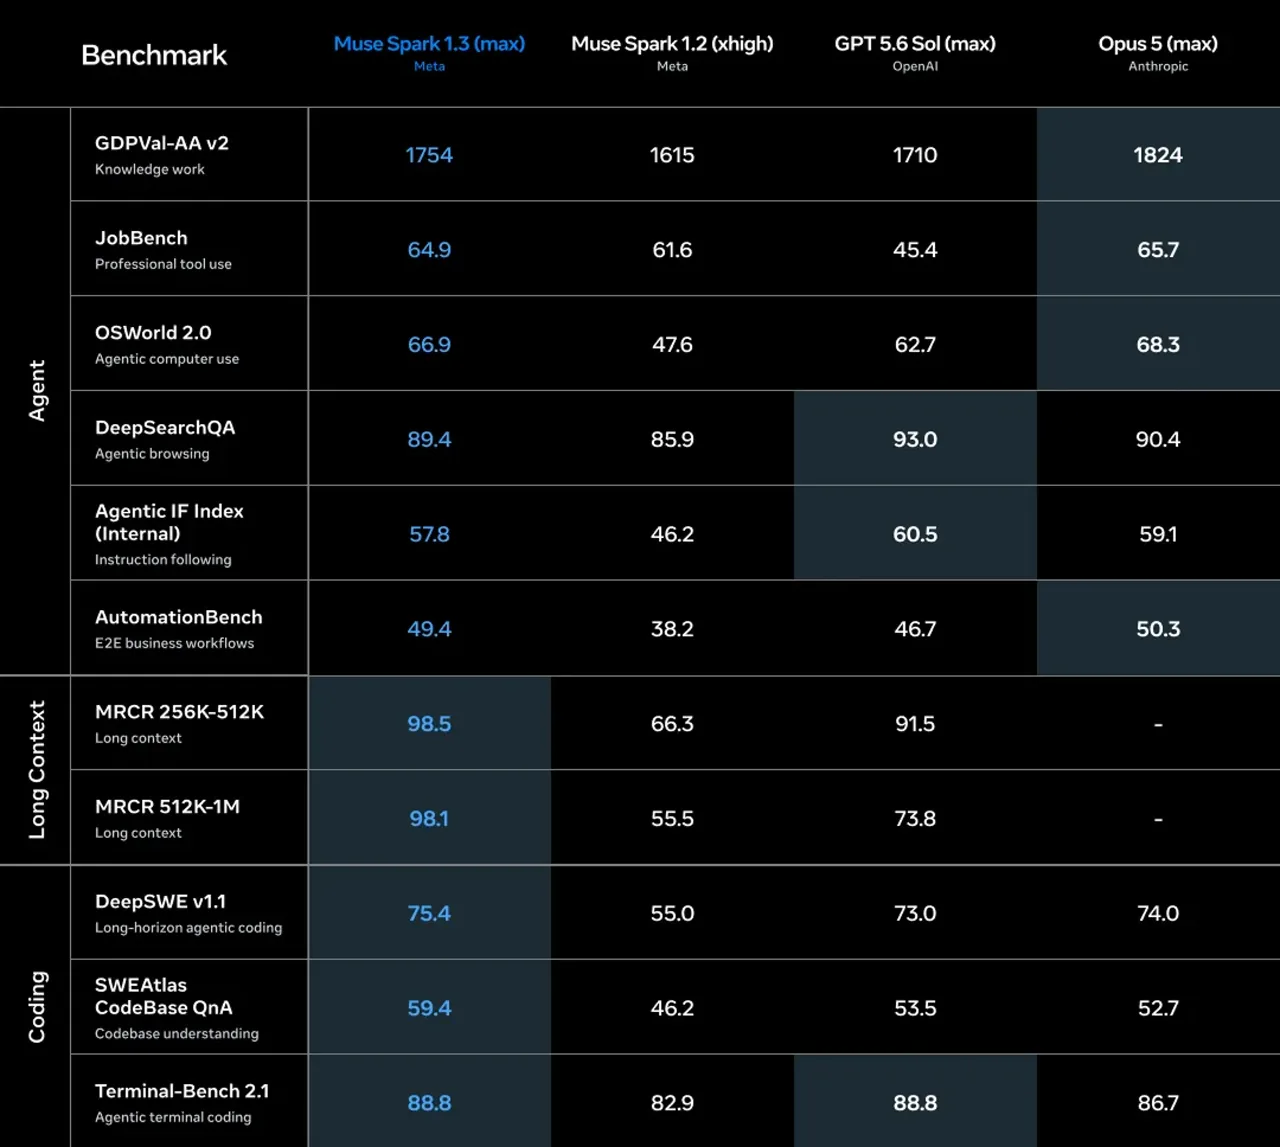
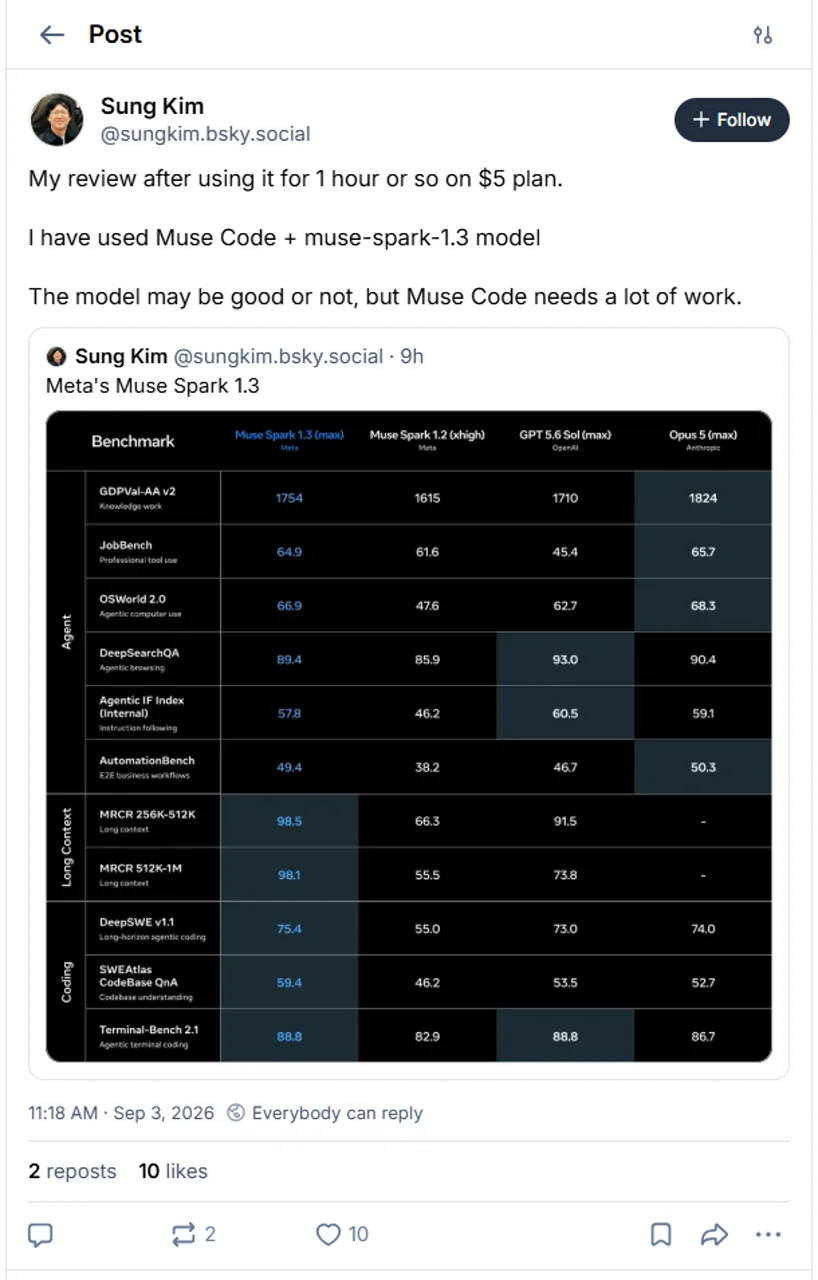
Gráfico oficial da Meta É impressionante. O Muse Spark 1.3 alcança pontuações máximas de 88,8 no Terminal-Bench 2.1, 75,4 no DeepSWE v1.1, 98,1 no MRCR 512K-1M e 66,9 no OSWorld 2.0. Ele empata com o GPT-5.6 Sol na pontuação máxima do Terminal-Bench e lidera entre os concorrentes listados nas duas faixas de contexto longo do MRCR. Desenvolvedores que desejam comparar o mercado de forma mais ampla podem usar nosso Visão geral do Coding-Agent como contexto adicional.
RELATÓRIO METACOGNITIVO, RAZIONAMENTO MÁXIMO
| Referência | 1,3 no máximo | 1,2 x alto | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Banco de terminais 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | Não se aplica |
Diferentes configurações de esforço, arneses de agentes e versões do OSWorld limitam a comparabilidade direta. A Meta também descreve o Índice IF Agentic como um indicador composto interno.
Como interpretar o gráfico
1.3, GPT-5.6 Sol e Opus 5 utilizam o valor “max”; 1.2 utiliza o valor “xhigh”.
Os agentes designados e os conjuntos fixos variam de acordo com a avaliação.
As execuções 1.3 e 1.2 utilizam versões diferentes do ambiente.
O Índice Agentic IF é um índice composto da Meta, e não um único índice de referência público.
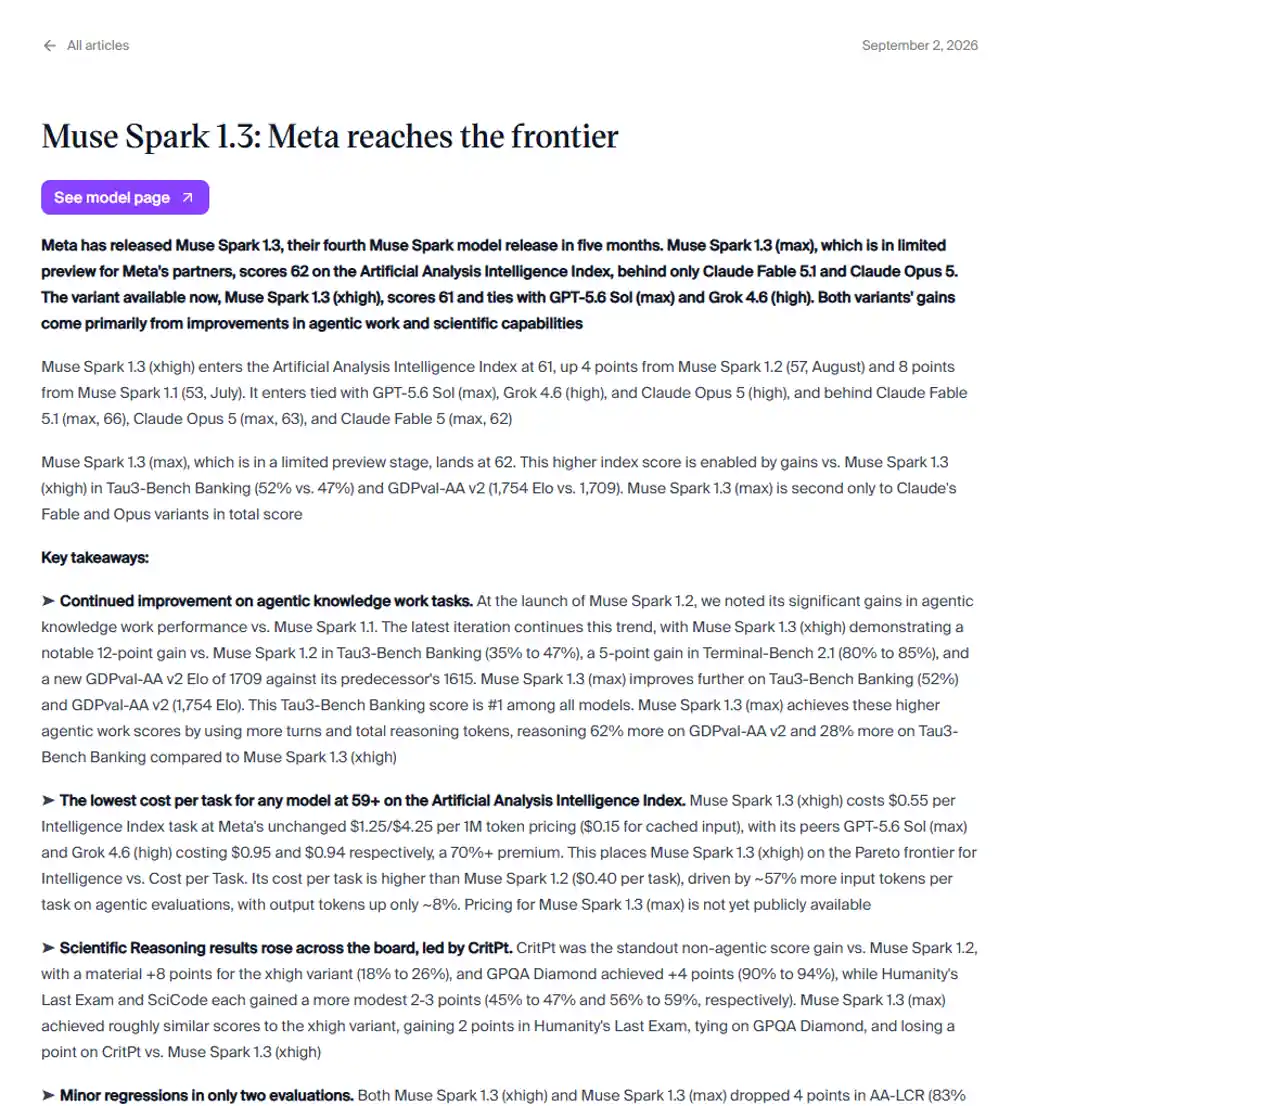
A Análise Artificial oferece uma visão mais clara do que os usuários podem acessar atualmente. O Muse Spark 1.3 xhigh alcança 61 pontos, um aumento em relação aos 57 da versão 1.2. Seu resultado no Terminal-Bench é de 85%, no GDPval-AA v2 é de 1.709 Elo e no Tau3-Bench Banking é de 47%. A variante “max” da prévia limitada atinge 62 no total. Também há regressões: o AA-LCR cai de 83% para 79%, enquanto a precisão do AA-Omniscience passa de 45% para 42% no xhigh.
Preços do Muse Spark 1.3
Colaborador
muse-spark-1.3-colaborador
$0.10 de entrada / $0.002 em cache / $0.20 de saída por milhão de tokens.
As sugestões podem ser usadas para aprimorar os produtos do Meta.
Padrão
muse-spark-1.3
$1,25 de entrada / $0,15 em cache / $4,25 de saída por milhão de tokens.
A Meta afirma que esse nível não é utilizado para aprimorar seus produtos.
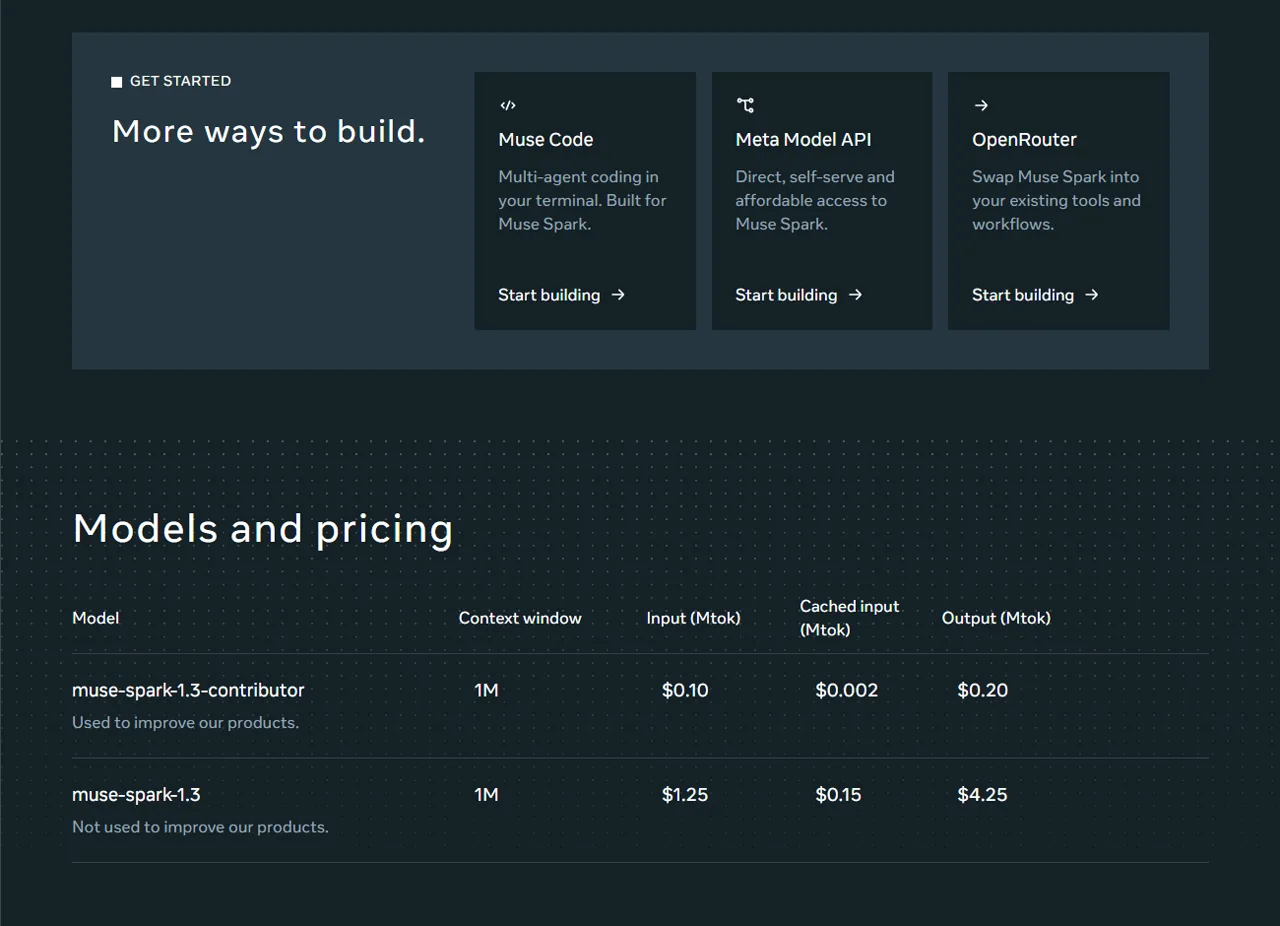
O preços oficiais dos tokens permanecem inalterados em relação à versão 1.2, mas o custo por tarefa não. Nosso Análise da plataforma de IA “tudo em um” explica por que o preço de acesso e o custo do fluxo de trabalho devem ser avaliados separadamente. A Análise Artificial registrou $0,55 por tarefa do Índice de Inteligência para 1,3 xhigh, contra $0,40 para 1,2, impulsionado principalmente por aproximadamente 57% a mais de tokens de entrada nas avaliações de agência. O nível “contributor” é excepcionalmente barato, mas sua cláusula de uso de dados é uma escolha real do produto, e não apenas uma nota de rodapé.
Acesso à API do Muse Spark 1.3
Da Meta livro de receitas oficial agora usa muse-spark-1.3 como padrão e define uma janela de contexto de 1.048.576 tokens. A API é compatível com o SDK OpenAI. O Muse Code e a API do Meta Model são as vias de acesso atuais confirmadas. A página de modelos do Meta também exibe o OpenRouter, embora seu botão ainda apontasse para uma URL da versão 1.2 quando clicado; portanto, verifique a rota antes da implantação. Para obter informações básicas sobre a interoperabilidade de agentes, consulte nosso guia sobre MCP e ferramentas de IA.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Analise este patch para verificar se há regressões."}],
)

print(response.choices[0].message.content)
Testes práticos de programação: 3/3 aprovados
Testamos três tarefas de repositório de dificuldade média por meio de uma API na temperatura zero, utilizando uma resposta por tarefa. Cada resposta precisava retornar arquivos completos em JSON estruturado. Em seguida, aplicamos esses arquivos em diretórios descartáveis e realizamos verificações públicas e ocultas. Trata-se de pequenos testes controlados, que não substituem o Terminal-Bench nem um teste em repositório de produção.
5/5 testes; 18,4 s; 2.473 tokens; $0,00905. O modelo identificou o conjunto de IDs processados não utilizados, adicionou uma verificação antecipada contra duplicatas e criou um teste de regressão.
A verificação de tipos e duas verificações em tempo de execução foram aprovadas; 47,6 s; 4.945 tokens; $0.01661. A validação, a persistência e o registro de auditoria foram separados sem romper o limite da transação.
9 de 9 testes; 20,3 s; 3.789 tokens; $0,01446. Compatibilidade com CSV, erros com numeração de linhas, saída atômica, segurança na execução simulada, ajuda e documentação: todos aprovados.
Total: 11.207 tokens e $0,04013. Os tempos referem-se aos tempos de solicitação de ponta a ponta, e não à latência nativa da API do Meta nem ao TTFT.
O resultado foi melhor do que um simples “3/3” sugere: todas as três primeiras respostas eram passíveis de revisão e levavam em conta as restrições. Essa mesma rigorosa abordagem em relação às evidências é importante ao ler nosso Análise do GPT-5. No entanto, a amostra não avalia a confiabilidade de chamadas repetidas de ferramentas, a navegação em repositórios de grande porte nem a camada de orquestração do Muse Code. Os leitores que estiverem avaliando alternativas econômicas também podem consultar nosso comparação de modelos de codificação orçamentária útil.
Primeiras reações dos desenvolvedores
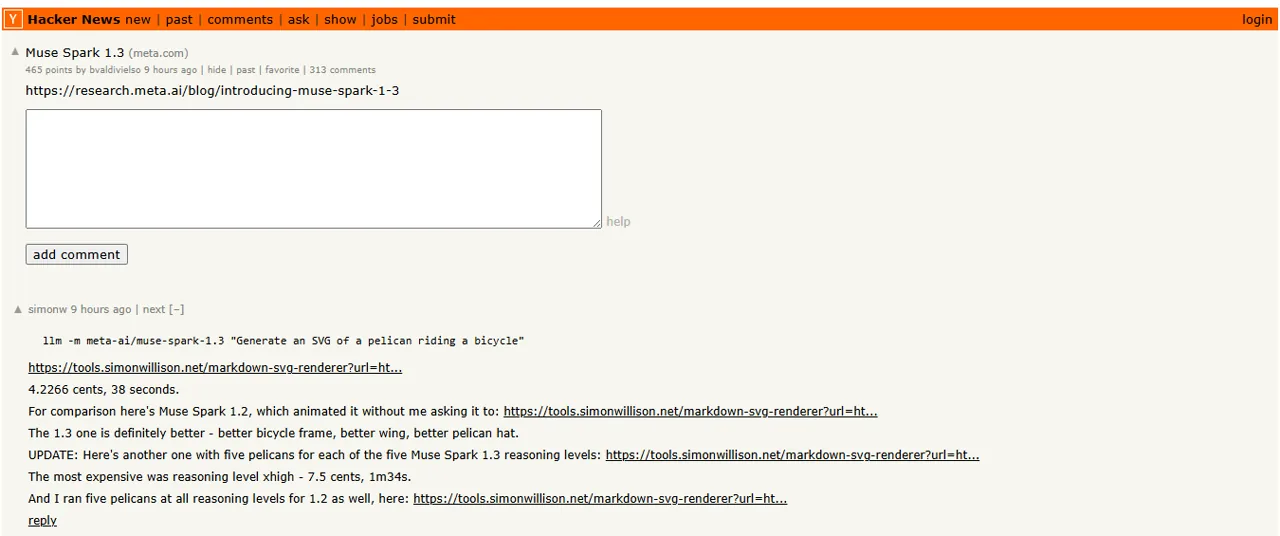
As primeiras reações são mistas e muito esparsas para se chegar a um consenso. Em um Teste do Hacker News, Simon Willison registrou um tempo de 38 segundos e 4,2266 centes de SVG e considerou o resultado da versão 1.3 “definitivamente melhor” do que o da versão 1.2, com a qual fez a comparação. Dax descreveu o lançamento como uma lembrança de como ele sentia falta das modelos rápidas. Sung Kim, após cerca de uma hora com o Muse Code, afirmou que o modelo pode ser bom, mas que o produto Muse Code “precisa de muito trabalho”. Esse último comentário refere-se à experiência do agente, e não a um teste isolado apenas do modelo.
Prós e contras
O que deu certo
- Público forte x pontuação alta
- Janela de contexto de 1 milhão de tokens
- API compatível com OpenAI
- Todas as três tarefas de programação foram aprovadas na primeira resposta
- Taxas de tokens muito baixas para o nível de contribuintes
O que assistir
- Os resultados do “Headline Max” não são a experiência pública padrão
- O custo das tarefas independentes aumentou em relação a 1,2
- Duas métricas independentes foram submetidas a uma análise de regressão
- Os dados dos colaboradores podem ajudar a melhorar os produtos do Meta
- As primeiras reações ao Muse Code são mistas
Quem deve usar o Muse Spark 1.3?
USE ISSO PARA
Avaliações de agentes de programação, trabalho com repositórios de contexto amplo, automação orientada por ferramentas e experimentos com foco no custo, nos quais a política de dados é aceitável.
PULAR OU ESPERAR QUANDO
Você precisa de confiabilidade comprovada na produção a longo prazo, precisa do máximo agora, ou não pode aceitar o uso de dados no nível “contributor” e considera os preços padrão pouco competitivos.
Veredicto da análise do Muse Spark 1.3
O Muse Spark 1.3 recebe uma recomendação para avaliação. Ele combina desempenho público de ponta, excelentes resultados em contextos longos, uma API com ergonomia familiar e preços competitivos. Nossas três tarefas de codificação de primeira resposta reforçam a ideia de que ele é capaz de seguir restrições envolvendo vários arquivos e produzir patches testáveis.
Escolha o nível padrão para código confidencial. Para outra comparação de fronteiras, consulte GPT-5 x Claude 4. Considere os resultados máximos dos benchmarks como evidências preliminares até que esse nível de raciocínio esteja amplamente disponível. E avalie o Muse Code separadamente da API do modelo: a experiência do usuário (UX), o ciclo de ferramentas e o controle do repositório de um agente podem ter sucesso ou fracassar independentemente do modelo base.
Perguntas frequentes sobre o Muse Spark 1.3
O que é o Muse Spark 1.3?
O Muse Spark 1.3 é o modelo de codificação e fluxo de trabalho autônomo da Meta, lançado em 2 de setembro de 2026, com uma janela de contexto de 1 milhão de tokens e percepção nativa de imagens, vídeos e documentos.
Quanto custa o Muse Spark 1.3?
O modelo padrão custa $1,25 por milhão de tokens de entrada, $0,15 para entradas em cache e $4,25 para saídas. O modelo de colaborador custa $0,10, $0,002 e $0,20, respectivamente, mas seus dados podem ser usados para melhorar os produtos da Meta.
O Max Reasoning está disponível?
A Meta informou que os modos de raciocínio existentes estavam disponíveis no lançamento e que o “max” seria disponibilizado após testes adicionais de segurança. Verifique a documentação atual da API antes de presumir que o recurso esteja disponível para o público em geral.
O Muse Spark 1.3 foi aprovado nos testes de programação?
Sim. Suas primeiras respostas foram aprovadas em todas as verificações de executabilidade em nossos testes de correção de bugs em Python, refatoração em TypeScript e testes de funcionalidades em JSONL. A amostra contém apenas três tarefas controladas e não representa uma taxa de confiabilidade geral.
O Muse Spark 1.3 é melhor do que o 1.2?
De modo geral, com base nas evidências disponíveis. A inteligência pública xhigh subiu de 57 para 61, e a Meta relata grandes avanços na capacidade de ação e na compreensão de contextos longos; no entanto, a Artificial Analysis também constatou um custo mais elevado nas tarefas e pequenas regressões na recuperação de contextos longos e na calibração factual.
Devo usar o modelo de colaborador ou o modelo padrão?
Use a opção “padrão” para prompts confidenciais ou exclusivos, pois a Meta afirma que esses dados não são utilizados para aprimorar seus produtos. A opção “colaborador” é bem mais barata, mas seus prompts podem ser utilizados para o aprimoramento dos produtos.