O Muse Spark 1.2 combina um custo por token excepcionalmente baixo com uma janela de contexto de 1 milhão de tokens e foi aprovado em todas as três tarefas de codificação do modelo básico em nosso conjunto de testes de API na primeira tentativa. A Meta lançou o modelo em 5 de agosto de 2026, com uma janela de contexto de 1 milhão de tokens, dois níveis de preços para a API e um agente de terminal independente chamado Muse Code. Os resultados dos testes de desempenho da Meta são promissores; os rankings públicos independentes de programação ainda não verificaram as mesmas combinações de modelo e agente.
Esta análise distingue o modelo do agente, as pontuações oficiais das evidências independentes e os preços padrão do equilíbrio entre uso de dados e benefícios do nível Contributor. Em nossos testes, o modelo concluiu uma correção de idempotência em Python, uma refatoração em TypeScript que preservou a compatibilidade e um recurso JSONL em todo o repositório, sem a necessidade de novas tentativas. A execução do agente Muse Code não foi testada, assim como a confiabilidade das chamadas às ferramentas. Se você estiver comparando primeiro o campo mais amplo, nosso guia para o melhores modelos de IA para codificação apresenta o contexto competitivo mais amplo.
Análise do Muse Spark 1.2: Resposta rápida
A versão resumida: O Muse Spark 1.2 é um modelo Meta voltado para programação, com uma janela de 1 milhão de tokens, acesso à API compatível com o SDK OpenAI e um nível “Contributor” que chama a atenção. Seu principal diferencial é o custo: $0,10 de entrada e $0,20 de saída por milhão de tokens no modelo Contributor. Esse nível pode ser usado para aprimorar os produtos da Meta, enquanto o modelo padrão, mais caro, não é utilizado para essa finalidade.
Os dados de desempenho precisam ser interpretados com mais cautela. A Meta relata 82,91 TP40T no Terminal-Bench 2.1 para o Muse Spark 1.2 com o Muse Code e 59,31 TP40T no DeepSWE. Esses são resultados obtidos pela Meta. As tabelas públicas do Terminal-Bench e do DeepSWE ainda não listavam o Muse Spark 1.2 quando verificadas em 26 de agosto de 2026. Análise Artificial oferece uma verificação cruzada independente: seu Índice de Inteligência permanece em 57, acima da mediana de 35 dos modelos comparáveis.
- O melhor motivo para experimentar agora: Preços acessíveis para colaboradores, contexto abrangente e uma API que segue o padrão familiar de cliente OpenAI.
- O melhor motivo para manter a cautela: Três tarefas controladas com o modelo básico não comprovam a confiabilidade do agente Muse Code, a qualidade das chamadas à ferramenta nem o desempenho em um grande repositório de produção.
- Opção importante relacionada à privacidade: Utilize o modelo padrão para códigos ou prompts que você não deseja que sejam usados para aprimorar os produtos do Meta.
Muse Spark 1.2 em resumo
Especificações verificadas
A Meta descreve o Muse Spark 1.2 como um modelo com maior precisão na codificação na primeira tentativa e uma seleção de ferramentas mais confiável do que o Muse Spark 1.1. Essas são as alegações do fornecedor, conforme consta no página oficial do modelo Muse Spark, e não conclusões da nossa própria sessão de codificação.
Muse Spark 1.2 x Muse Code
O Muse Spark 1.2 é o modelo. O Muse Code é um agente de terminal em versão beta independente, baseado nesse modelo. Essa distinção é importante porque um agente pode incorporar funcionalidades como planejamento, orquestração de ferramentas, navegação no repositório, isolamento da árvore de trabalho, registro em log e comportamento de repetição de tentativas em torno do modelo subjacente.
Mantenha as camadas separadas
Muse Spark 1.2
Contexto, raciocínio, comportamento da API, faturamento por token, resultados e decisões sobre a chamada de ferramentas.
IDs dos modelos1M contextoPreços da API
Código Muse
Experiência do usuário no terminal, subagentes, árvores de trabalho do Git, log de eventos, retomada do fluxo, habilidades agrupadas e orquestração.
Fluxo de trabalho do agenteResultados do sistema de meta-execução
O página oficial do Muse Code chama o produto de “agente de codificação beta”. Isso torna as comparações com produtos como o Claude Code e o Codex mais úteis do que fingir que todas as diferenças observadas no fluxo de trabalho se devem apenas a uma chamada de modelo simples. Nosso Comparação entre o Codex e o código Claude explica por que o ambiente pode influenciar a experiência do desenvolvedor tanto quanto o modelo.
Testes de desempenho do Muse Spark 1.2: o que os resultados realmente revelam
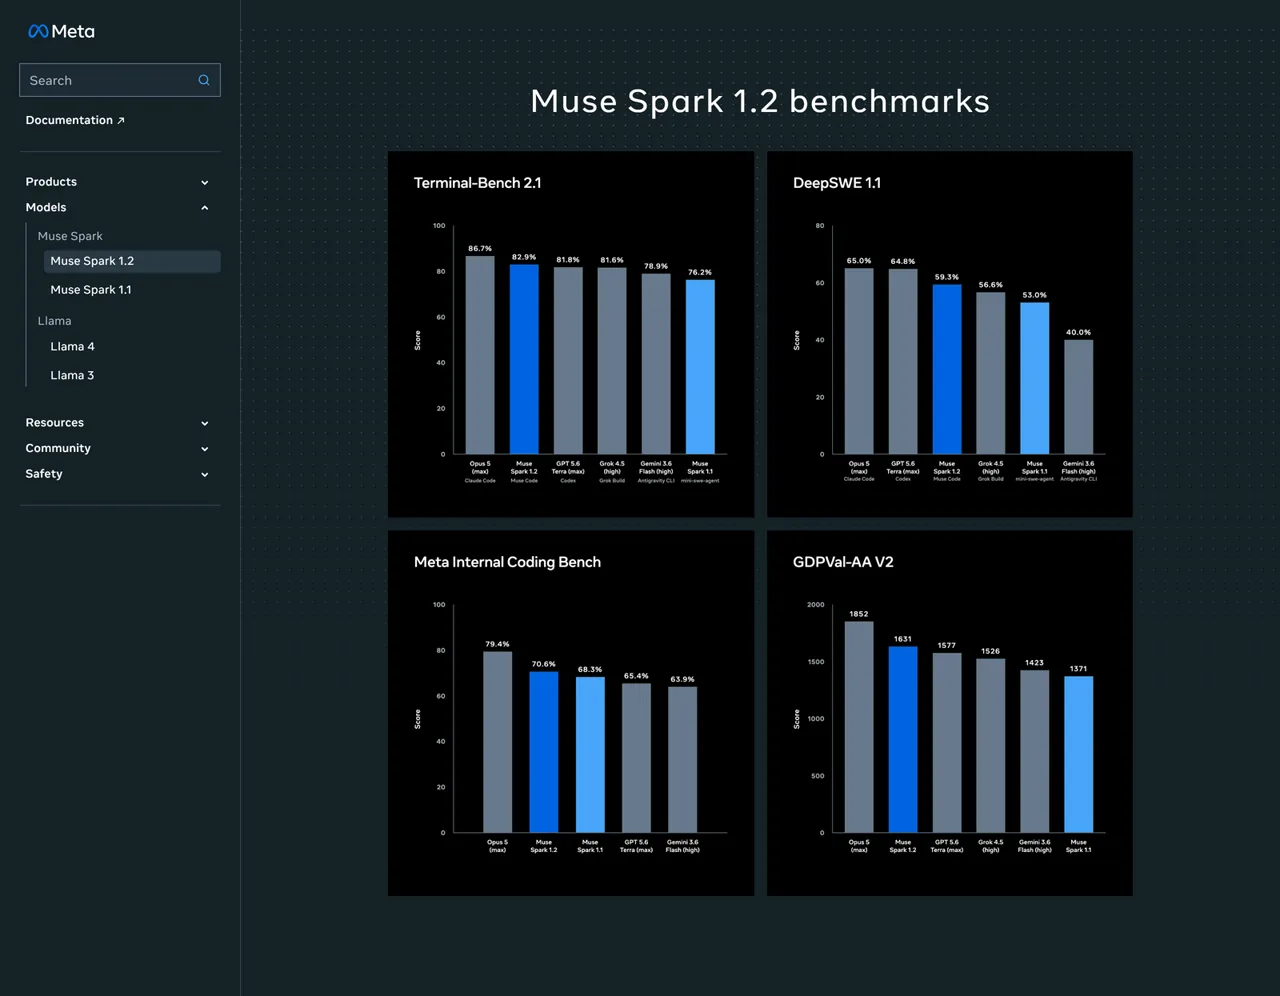
O gráfico de referência da Meta coloca o Muse Spark 1.2 entre os primeiros colocados em várias avaliações de programação. Vale a pena examinar os números, mas eles não constituem um ranking único e claro da qualidade bruta do modelo. O modelo, o agente, o conjunto de testes, a capacidade de raciocínio e o protocolo da tarefa podem variar em conjunto.
Meta-relatório do Terminal-Bench 2.1
Painel de referência Meta
Banco de terminais 2.1
Todas as 89 tarefas · aprovação em 1 das cinco tentativas · combinações selecionadas de modelo e agente
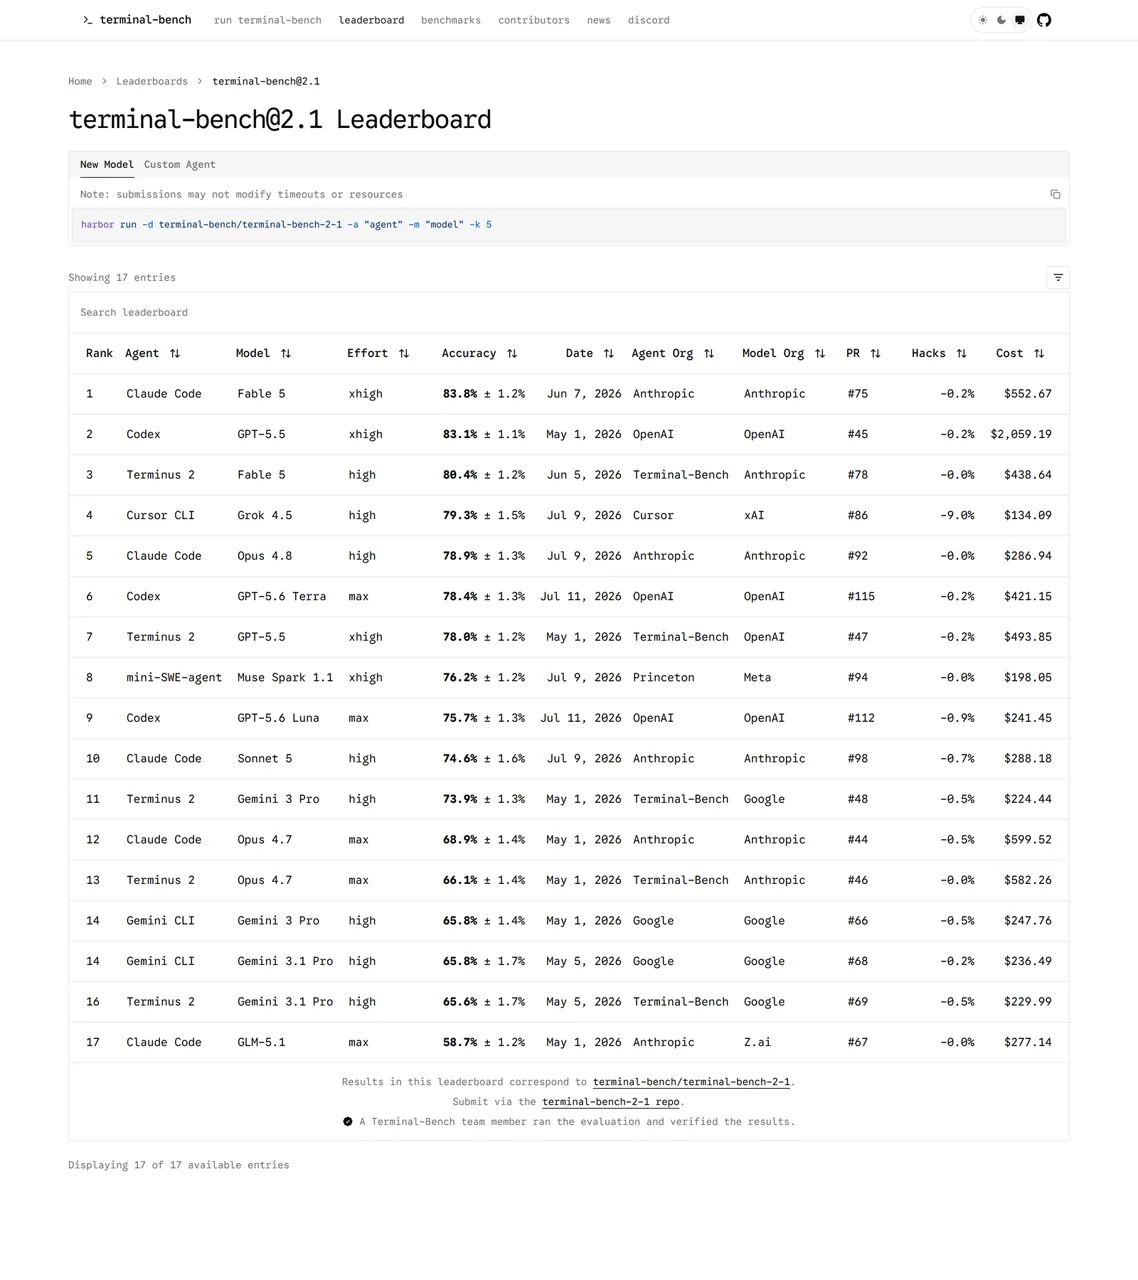
O valor 82,9% é um Resultado da execução do código Muse. O Classificação pública do Terminal-Bench 2.1 não incluiu o Muse Spark 1.2 na lista em 26 de agosto de 2026, portanto, ele é não é uma inscrição verificada na tabela de classificação pública. O quadro público listou o Muse Spark 1.1 com o mini-SWE-agent em 76,2% ±1,2%.
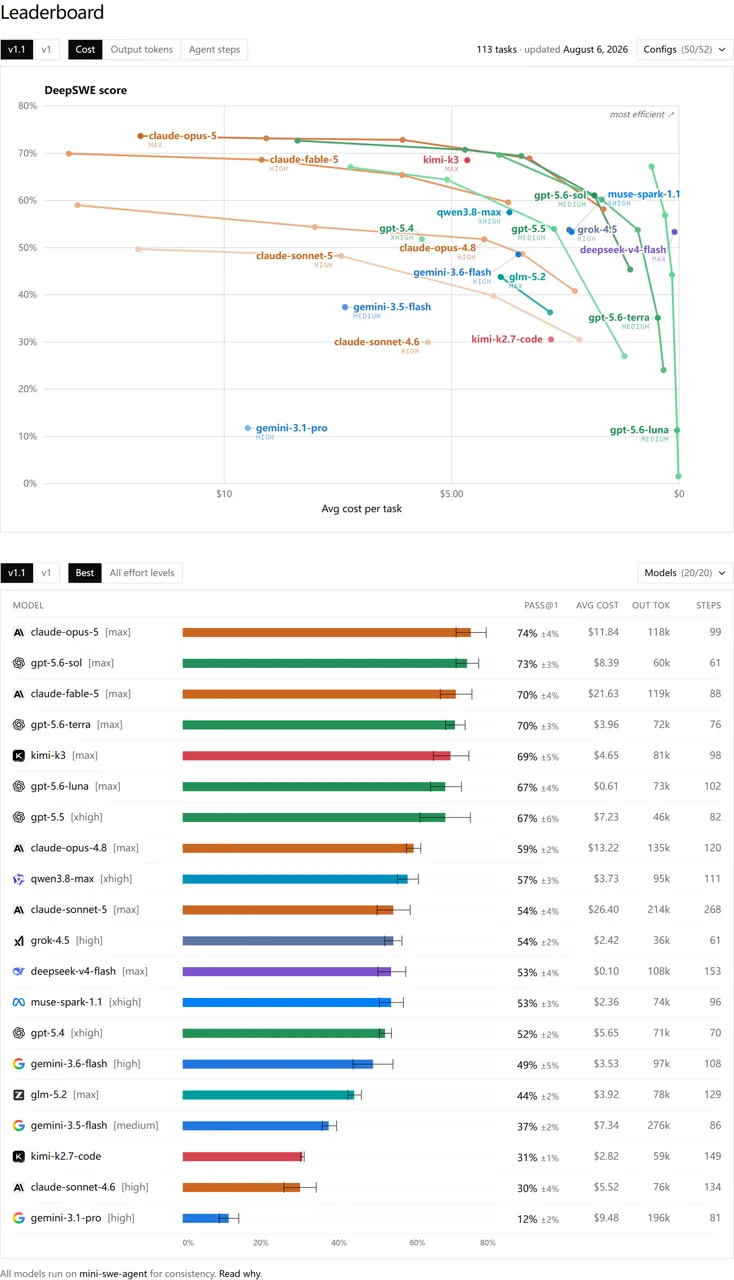
Relatório meta do DeepSWE 1.1
Painel de referência Meta
DeepSWE 1.1
113 tarefas · 91 repositórios · cinco idiomas · aprovação na primeira tentativa após cinco tentativas
O tabela de classificação pública do DeepSWE v1.1 utiliza o mini-swe-agent em todos os modelos listados para garantir a consistência. O Muse Spark 1.2 ainda não havia sido adicionado no momento da verificação; o Muse Spark 1.1 estava listado como 53%. O resultado de 59,3% da Meta utiliza o Muse Code, portanto, os dois números não são idênticos em termos de ambiente de teste.
Avaliações internas e de agentes gerais da Meta
Duas escalas de avaliação diferentes
Bancada de codificação interna da Meta
440 tarefas internas · duas tentativas por tarefa
| Modelo | Pontuação |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3,6 Flash | 63.9% |
| Grok 4,5 | Não mostrado |
GDPVal-AA v2
Avaliação geral de tarefas agentísticas · Valores no estilo Elo
| Modelo | Pontuação |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3,6 Flash | 1423 |
Da Meta metodologia de avaliação Afirma que o Terminal-Bench utiliza todas as 89 tarefas e alcança pass@1 em cinco tentativas. O DeepSWE abrange 113 tarefas em 91 repositórios e cinco linguagens, também alcançando pass@1 em cinco tentativas. A Meta também observa que sua configuração pode não estar otimizada para modelos de terceiros. Para uma comparação atual com concorrentes baseada em decisões reais sobre produtos, consulte Claude Opus 5 x GPT-5.6.
A metodologia altera o significado
Modelo + agente selecionado
89 tarefas, cinco tentativas, configurações máximas de raciocínio diferentes, e o ambiente de teste da Meta pode não estar ajustado da mesma forma para sistemas de terceiros.
Entradas verificadas
O Muse Spark 1.2 não foi encontrado na verificação. As configurações da placa e o status da verificação devem ser consultados separadamente na tabela da Meta.
Agente mini-swe comum
113 tarefas distribuídas por 91 repositórios e cinco linguagens. O Muse Spark 1.2 não constava; o Muse Spark 1.1 estava listado como 53%.
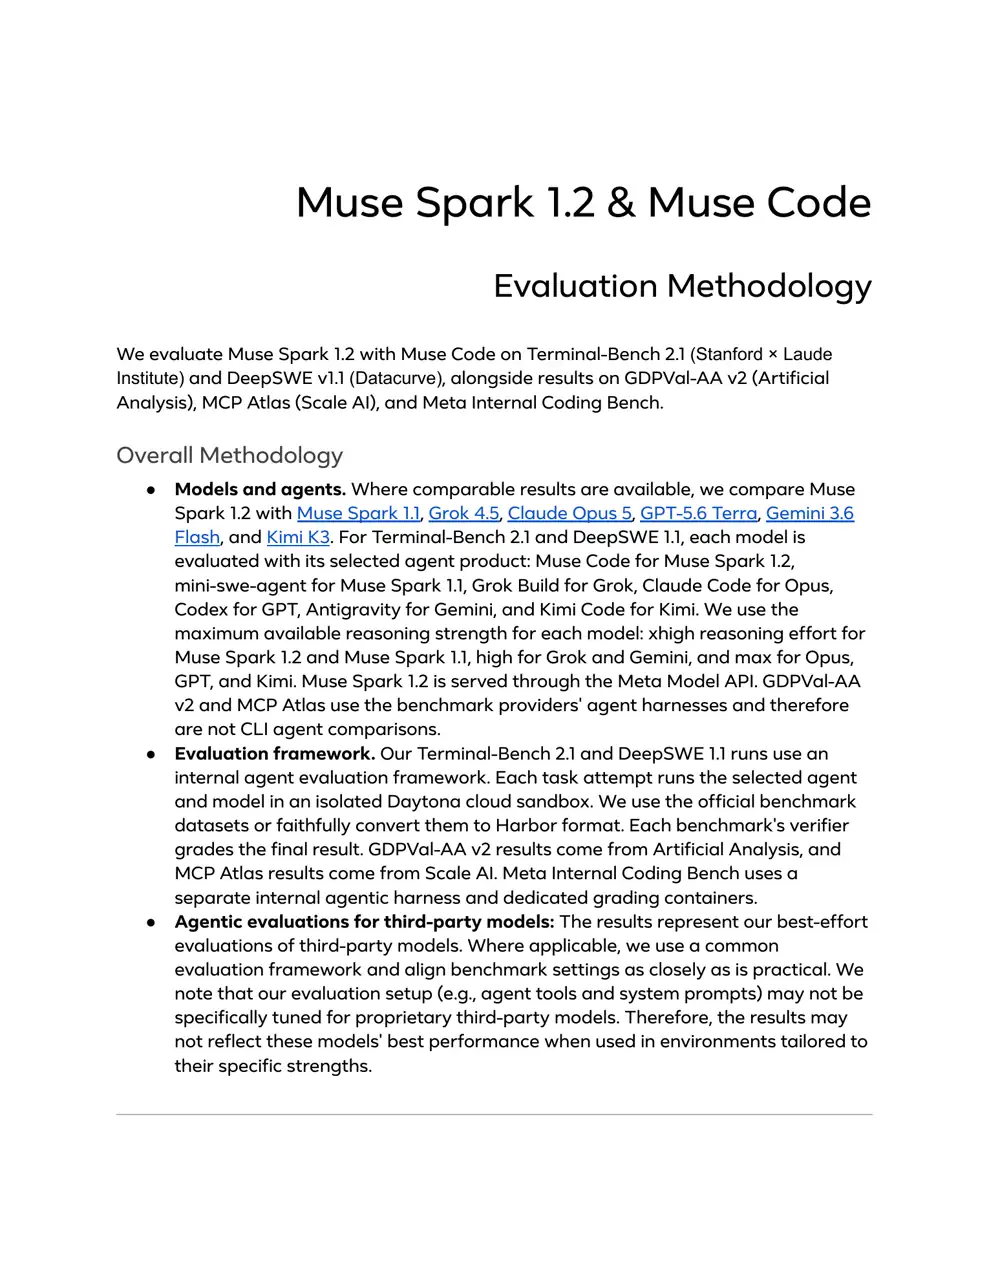
Análise Artificial: contexto independente útil
O Página do modelo de análise artificial atribui ao Muse Spark 1.2 um Índice de Inteligência de 57, acima da mediana de 35 para modelos comparáveis, conforme verificado em 26 de agosto de 2026. Seu conjunto de testes apresenta 80% no Terminal-Bench v2.1, 57% normalizado no GDPVal-AA v2, 56% no SciCode e 83% na avaliação de contexto longo AA-LCR.
Desvio de versão na Análise Artificial
A lição prática é simples: o Muse Spark 1.2 parece competitivo, mas nenhuma pontuação isolada define o modelo. Considere o gráfico da Meta como evidência do sistema Muse Code, os rankings públicos como uma verificação cruzada separada e a Artificial Analysis como uma avaliação independente, porém configurada de maneira diferente.
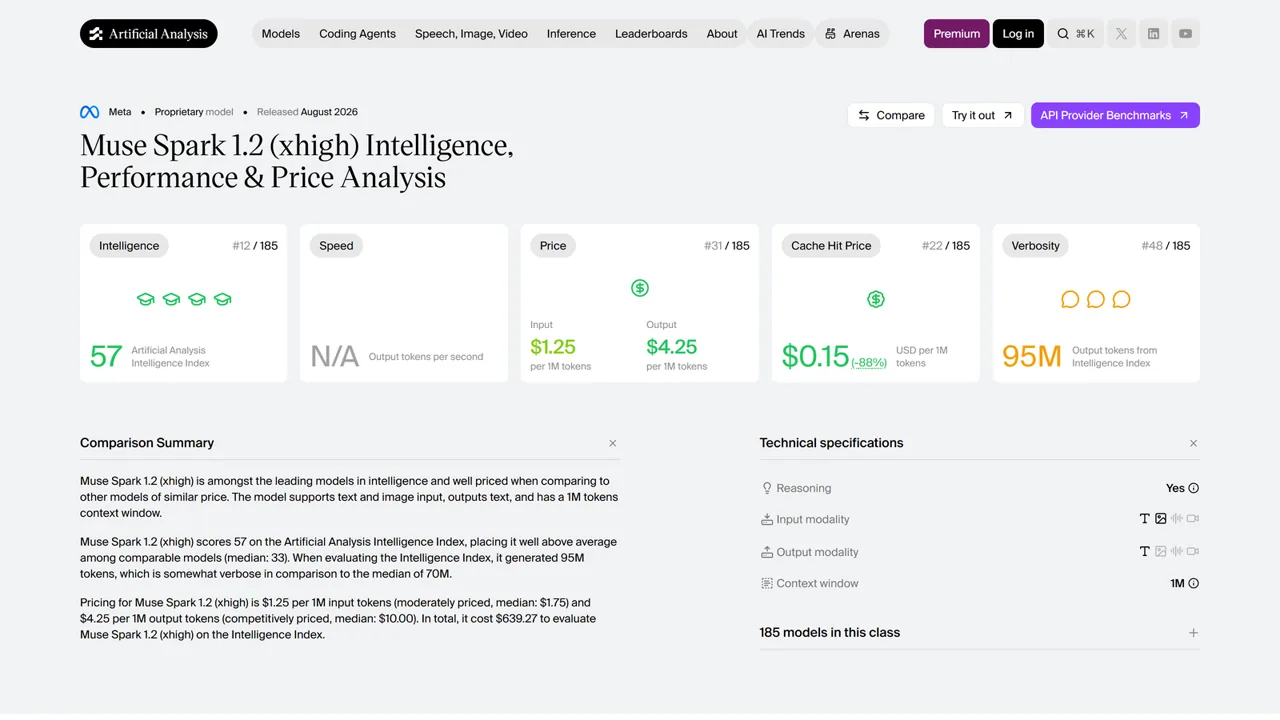
Muse Spark 1.2: Preços e compromissos em relação à privacidade
A Meta oferece dois IDs de modelo de API com preços significativamente diferentes. A opção mais barata não é apenas um desconto: ela altera a forma como os dados enviados podem ser utilizados.
USD por um milhão de tokens · Contexto de 1M
Não é utilizado para o aprimoramento do produto
Não é utilizado para aprimorar os produtos da Meta
Mais barato, mas com uma restrição no uso de dados
Dados podem ser usados para aprimorar os produtos da Meta
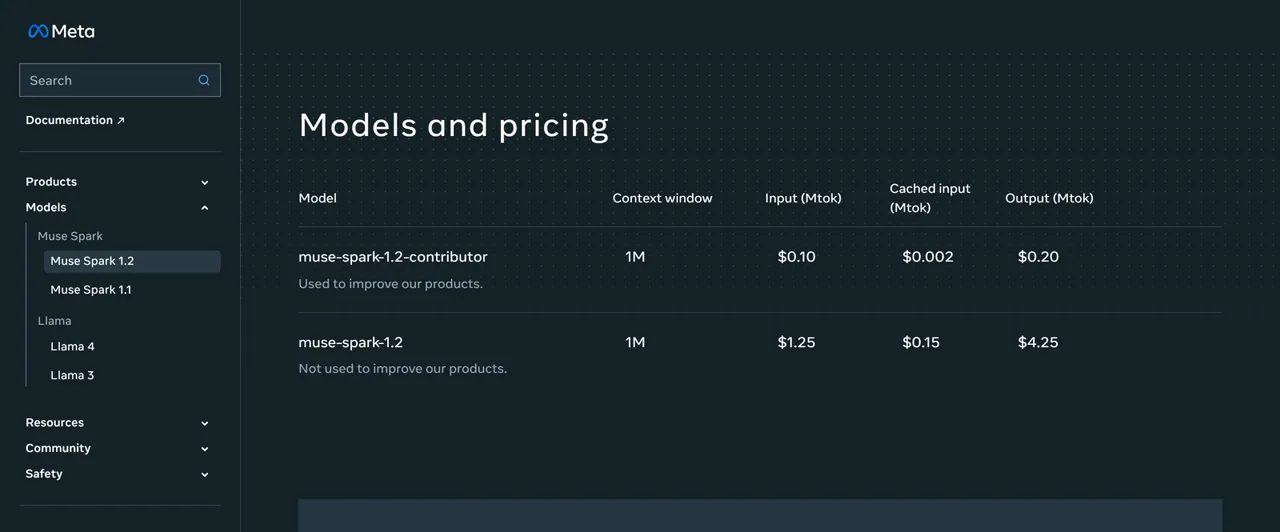
O preço do plano Contributor é 12,5 vezes mais barato para entradas, 75 vezes mais barato para entradas em cache e 21,25 vezes mais barato para saídas do que o plano padrão. Não existe uma única porcentagem de desconto que descreva todos os tipos de tokens.
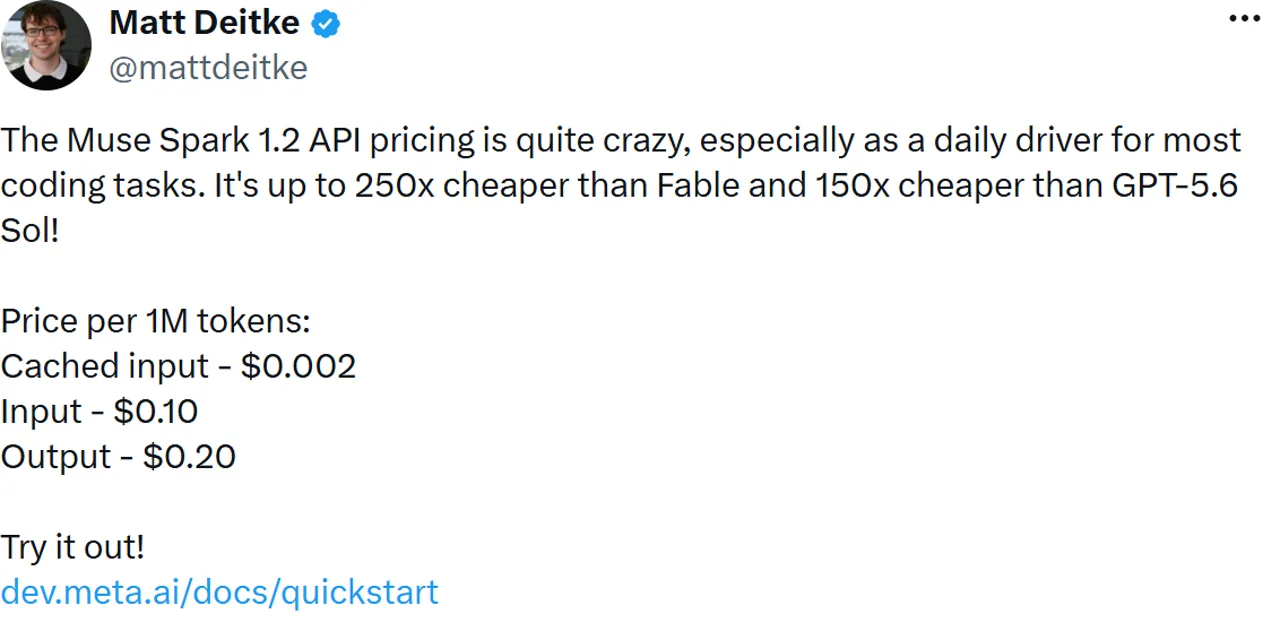
Um pesquisador da Meta promoveu o nível “Contributor” como “até 250 vezes mais barato” que o Fable e “150 vezes mais barato” que o GPT-5.6 Sol. Isso comparação social utiliza os preços do Contributor, e não o modelo padrão, e deve sempre incluir a ressalva relativa ao uso de dados. Os leitores que desejarem comparar os custos atuais dos concorrentes podem utilizar nossa seção separada Guia de preços do GPT-5.6 e Discriminação dos preços do código Claude.
Para repositórios públicos, tarefas sintéticas ou ambientes de avaliação descartáveis, o plano Contributor pode ser uma opção atraente. Para código privado, dados de clientes, credenciais ou arquitetura proprietária, o plano padrão é a opção padrão mais segura. A Meta também afirma que está começando a aceitar solicitações de retenção zero de dados por meio da equipe de vendas, o que constitui um canal de acesso separado, em vez da configuração padrão de autoatendimento.
Acesso à API do Muse Spark 1.2 e exemplos
Três vias de acesso oficiais
URL oficial do livro de receitas: https://api.meta.ai/v1 · 1.2 solicitação nesta revisão: não executada
O API do Meta Modelo oferece suporte a um fluxo de trabalho compatível com o SDK OpenAI. O guia oficial da Meta utiliza a URL base https://api.meta.ai/v1 e lê a chave de MODEL_API_KEY. A página do produto também descreve o “search grounding”, enquanto o manual aborda autocompletos em bate-papo, streaming, chamada de ferramentas, saída estruturada, armazenamento em cache de prompts, controles de raciocínio, visão, contexto longo, novas tentativas e receitas de pesquisa.
Exemplo de livro de receitas oficial — versão capturada: O livro de receitas oficial do GitHub ainda usa muse-spark-1.1. Isso comprova a estrutura do cliente e a URL base, e não que o exemplo tenha sido atualizado para a versão 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Olá, mundo!"}],
)

print(response.choices[0].message.content)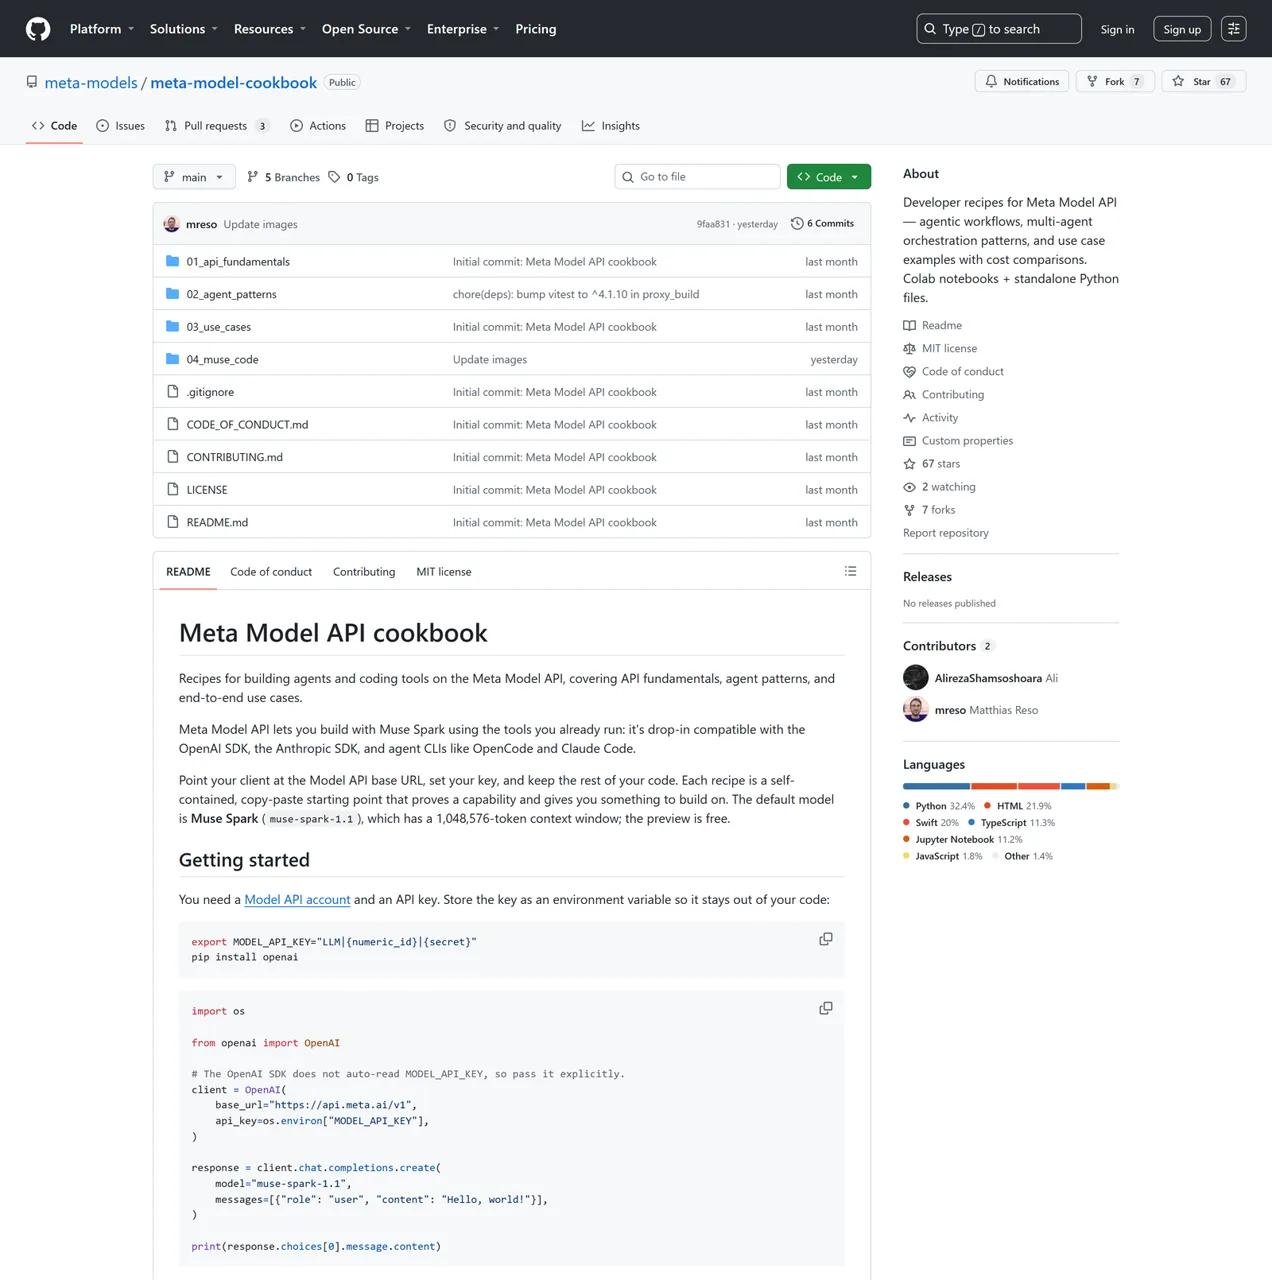
Adaptação documentada — não executada: A Meta lista separadamente muse-spark-1.2 como o ID padrão do modelo 1.2. A substituição mínima abaixo combina dois fatos oficiais, mas nenhuma solicitação paga foi enviada durante esta revisão.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
O Muse Spark é um modelo de raciocínio, e os tokens de raciocínio são contabilizados como saída. Isso torna a taxa de saída padrão $4.25 mais importante do que parece à primeira vista: uma resposta aparentemente curta ainda pode conter um raciocínio subjacente significativo. A latência real, o tempo até o primeiro token, a taxa de repetição de tentativas e o custo por tarefa continuam sem serem medidos aqui.
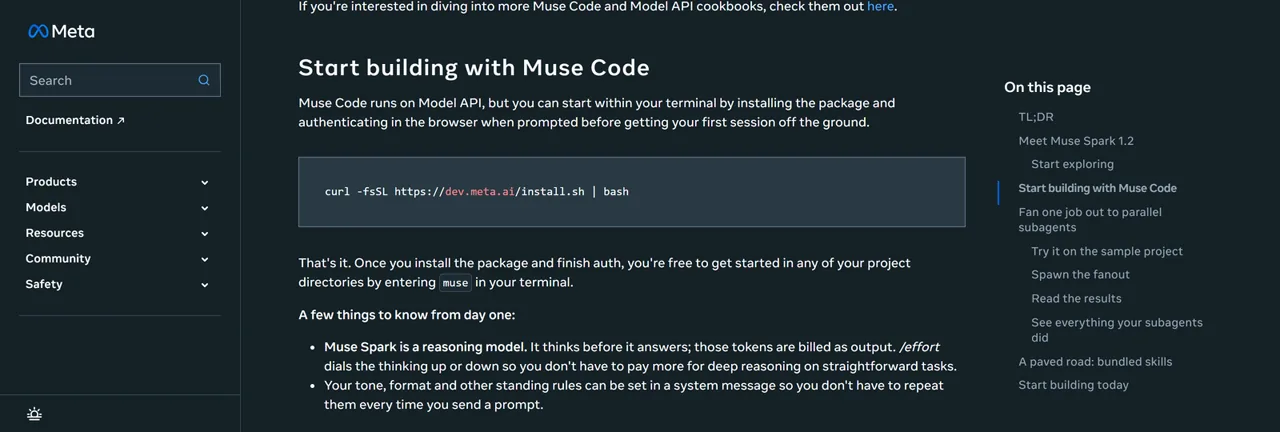
/esforço O comando altera a profundidade do raciocínio. Fonte: Guia do desenvolvedor do Meta.O que o Muse Code oferece
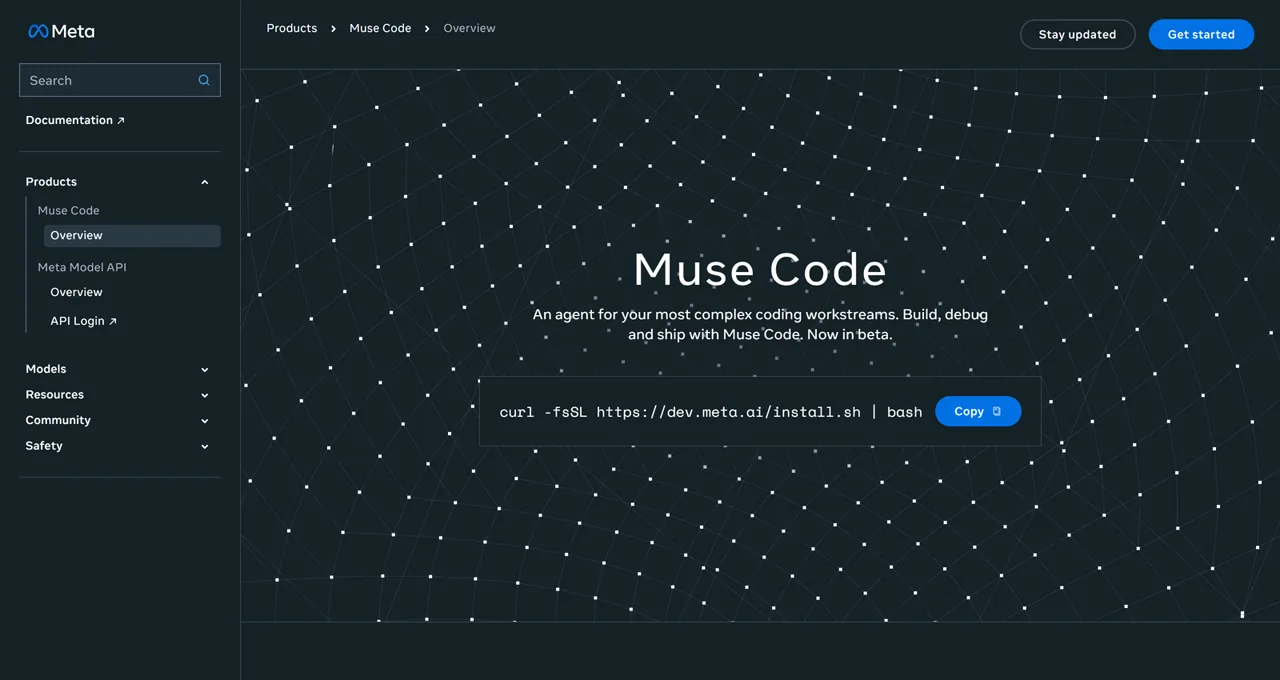
O Muse Code é instalado a partir do terminal e integra o Muse Spark 1.2 a um fluxo de trabalho de agente. A Meta’s análise aprofundada para desenvolvedores descreve vários comportamentos que não fazem parte de uma chamada simples de API:
- Agentes paralelos: As tarefas podem ser executadas em árvores de trabalho do Git isoladas.
- Registro de eventos somente para adição: As sessões e ações são gravadas em um arquivo JSONL local para fins de auditoria e reprodução.
- Retomar o fluxo:
currículo da Musepode retomar sessões interrompidas. - Controle de raciocínio: o
/esforçoO comando ajusta a intensidade do raciocínio. - Competências explícitas: Nomes de meta
/sabor,/grelhar,/churrasqueira-com-documentação, e/plano.
Recursos do produto do agente
Subagentes
As tarefas independentes podem se ramificar.
Árvores de trabalho
Os ramos permanecem separados durante o trabalho paralelo.
Log do JSONL
Os eventos locais do tipo “somente adição” oferecem suporte à reprodução.
Currículo
currículo da Muse dá continuidade às sessões interrompidas.
Habilidades
/sabor, /grelhar, /churrasqueira-com-documentação, /plano.
Esse conjunto de recursos torna o Muse Code relevante para o mercado mais amplo de agentes de programação, onde o planejamento, o isolamento, a reprodução e a disciplina no uso de ferramentas são tão importantes quanto a inteligência do modelo. O Guia comparativo entre OpenClaw, Claude e OpenCode é um contexto útil para essas diferenças no nível do produto.
Afirmações sobre o lançamento e primeiros sinais da comunidade
Reação não é validação
Treinamento + horizonte de longo prazo
Mais recursos de computação para programação, diversidade de ambientes, treinamento conjunto e um teste de estresse com mais de 1.000 chamadas de ferramentas.
Preço e OpenCode
Um usuário do Reddit elogiou uma experiência inicial com programação e o valor que ela trouxe.
Privacidade + confiabilidade
Outros usuários levantaram questões relacionadas ao uso de dados, ao preço padrão, à disponibilidade e à confiabilidade inicial.
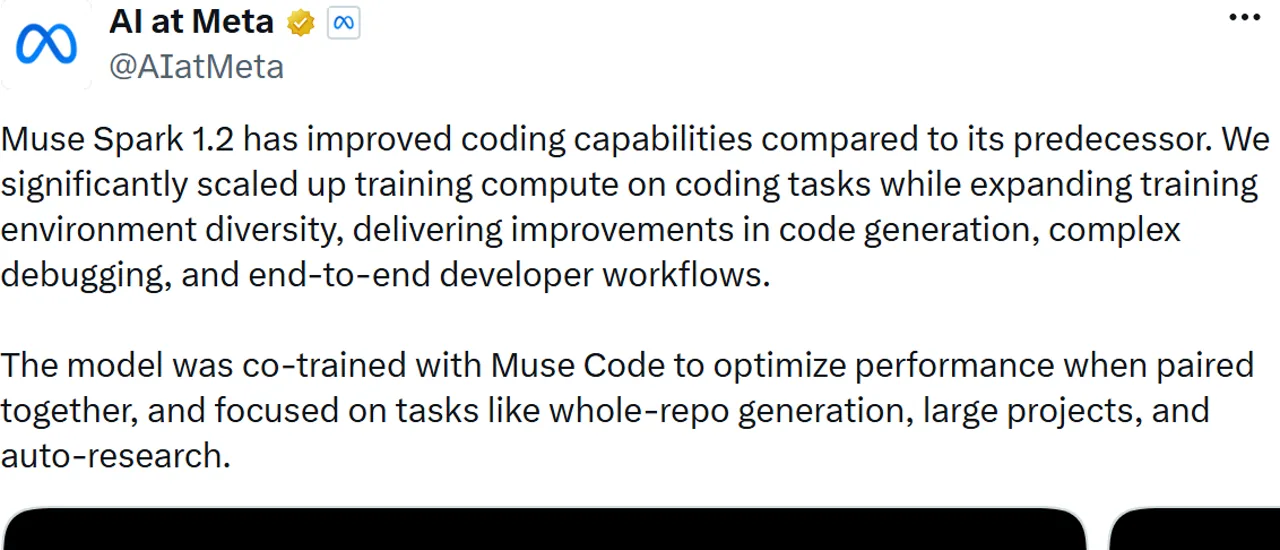
A equipe de IA da Meta afirma que o Muse Spark 1.2 recebeu mais recursos computacionais para treinamento em programação, ambientes mais variados, maior ênfase na geração e depuração de repositórios completos e treinamento conjunto com o Muse Code. Um outro tópico de lançamento descreve um teste de estresse com duração de até 24 horas, envolvendo mais de 1.000 chamadas de ferramentas em GPUs NVIDIA Hopper.
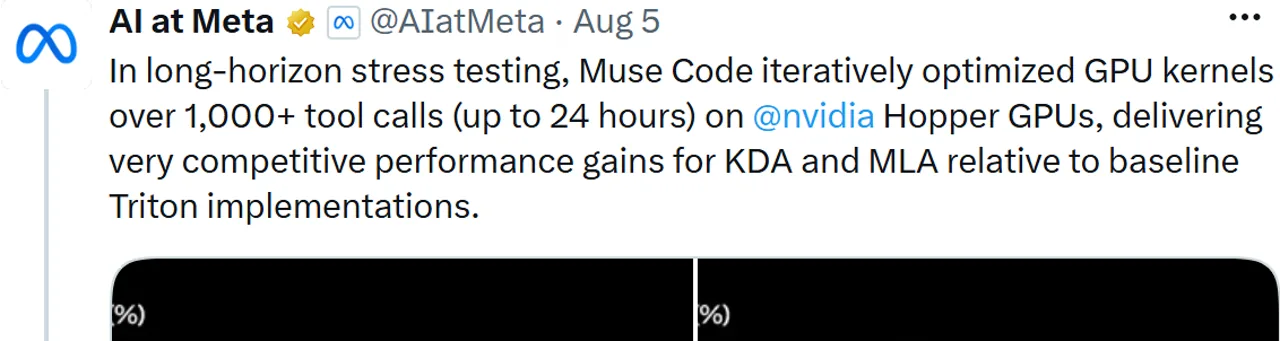
Essa é uma demonstração impressionante, mas não se trata de uma taxa de sucesso geral quantificada. Ela não nos diz com que frequência o agente escolheu a ferramenta certa, se recuperou de erros, evitou chamadas duplicadas ou concluiu uma tarefa normal do repositório sem precisar de orientação.
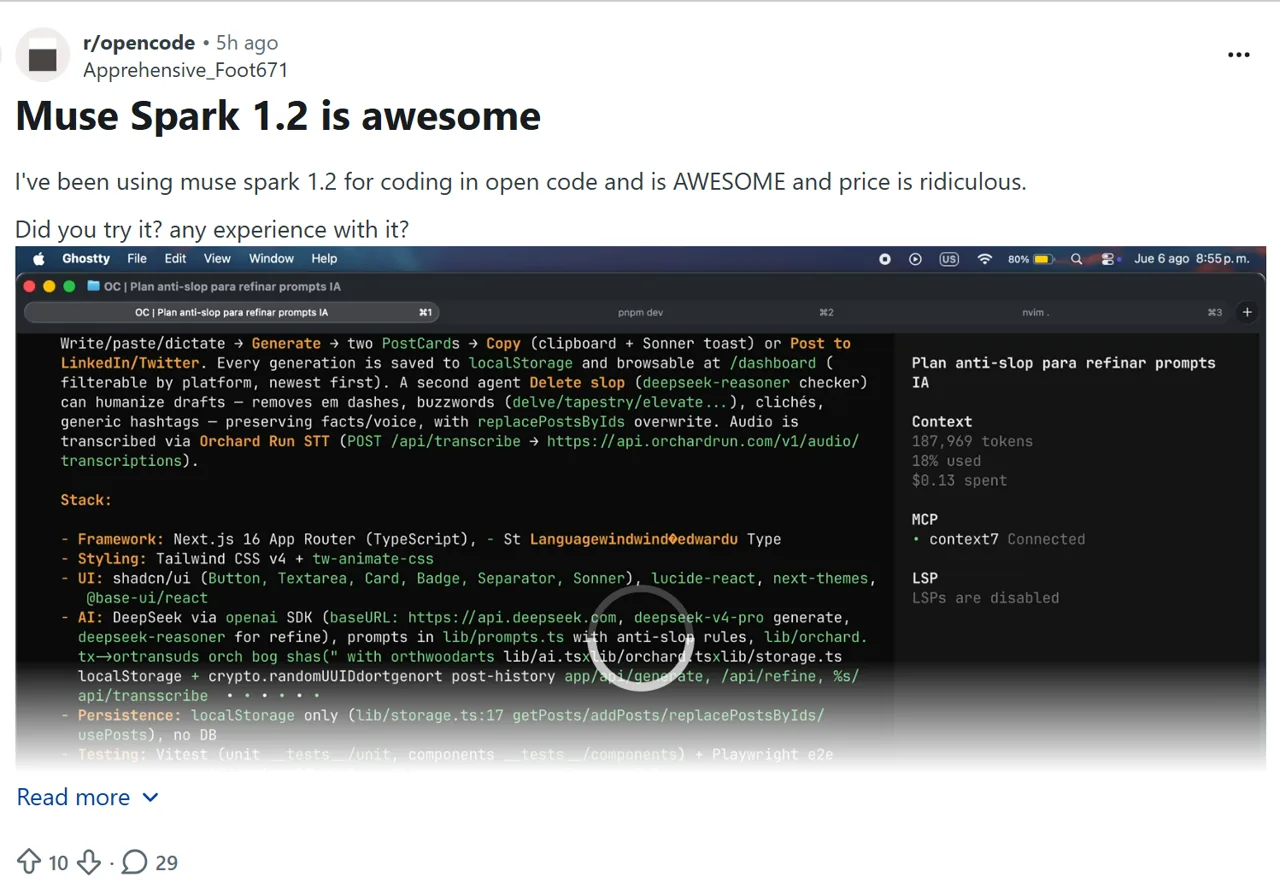
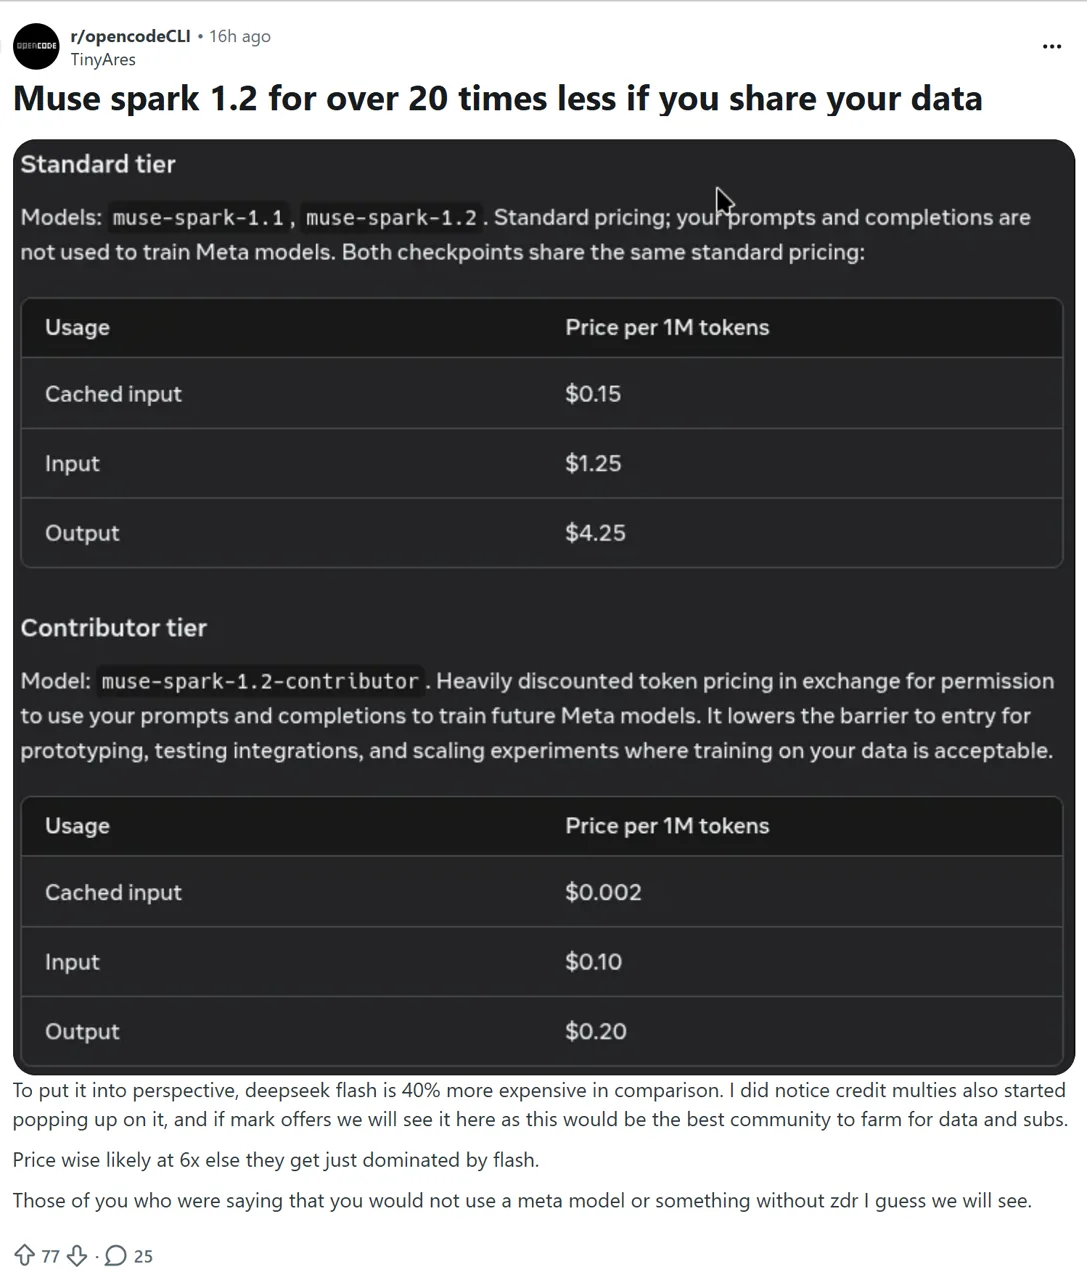
As primeiras postagens no Reddit também apresentam opiniões contraditórias. Uma delas Um usuário do r/opencode relatou uma experiência positiva com o OpenCode e elogiou o preço. Um outro Discussão sobre preços para colaboradores levantaram questões relacionadas ao uso de dados, ao custo do plano padrão, à disponibilidade e à confiabilidade. Trata-se de reações individuais, e não de um consenso da comunidade.
Testes de programação do Muse Spark 1.2: 3 de 3 tarefas aprovadas
Em nossos testes, o modelo básico do Muse Spark 1.2 realizou três tarefas controladas de codificação por meio de uma API de autocompletamento de chat compatível com OpenAI. Cada tarefa teve direito a uma tentativa, sem repetições e sem intervenção humana. Avaliamos os arquivos retornados em repositórios descartáveis por meio de verificações públicas e ocultas. A execução do agente Muse Code não foi testada, assim como a confiabilidade das chamadas de ferramentas; portanto, esses resultados não devem ser interpretados como um benchmark do agente.
Resultado de uma única tentativa
As respostas utilizaram 6.618 unidades de raciocínio. As três razões finais foram pare, e o campo “provedor” indicava “Meta”.
Teste 1: Correção de bug de idempotência no Python — Aprovado
Evite transferências duplicadas sem alterar a API pública
O modelo identificou a falta da proteção do ID da solicitação, adicionou a correção mínima necessária e forneceu um teste de regressão, preservando as atualizações atômicas do balanço.
O avaliador oculto original exigia, incorretamente, uma chamada duplicada para retornar Falso, embora a tarefa exigisse apenas que não fosse cobrado duas vezes do remetente. Após corrigir essa exigência inventada relativa ao valor de retorno, a primeira resposta, que permaneceu inalterada, passou em todos os seis testes. Não repetimos a tentativa nem editamos a saída do modelo.
Teste 2: Refatoração de vários arquivos em TypeScript — Aprovado
Separação entre validação, persistência e registro de auditoria
Os arquivos devolvidos mantiveram o contrato de rota pública, o TypeScript estrito e a transação única que abrange tanto as gravações de pedidos quanto as de auditoria. Além disso, foram adicionados testes de validação específicos, sem dependência de tempo de execução.
O primeiro avaliador comparou os objetos com os dados brutos JSON.stringify, de modo que objetos equivalentes com ordem de inserção de chaves diferente pareciam diferentes; seu Windows npx A execução também falhou antes da verificação de tipos. Com um comparador que não leva em conta a ordem e uma invocação de comando compatível com o Windows, a resposta original passou em todas as verificações. Mais uma vez, não houve repetição do modelo.
Teste 3: Recurso de repositório JSONL — Aprovado
Seguimento de instruções em todo o repositório
Adicionar JSONL sem comprometer o CSV
O modelo implementou detecção de extensões, erros de linha malformada com contagem a partir de 1, saída atômica, segurança em execução simulada, testes direcionados, texto de ajuda e um exemplo no arquivo README.
O que os exames revelam: O Muse Spark 1.2 é capaz de gerar patches utilizáveis para vários arquivos, respeitar restrições de compatibilidade, adicionar testes e lidar com um recurso de escopo moderado em todo o repositório em uma única execução. O custo médio relatado foi de cerca de $0,0151 por tarefa, mas esses casos de teste eram pequenos e não devem ser usados para estimar o custo de uma base de código de grande porte.
Quem deve usar o Muse Spark 1.2?
Guia de decisão
Avaliação controlada
Código público ou sintético, tarefas mensuráveis, necessidades em contextos amplos e um resultado promissor de 3/3 no modelo básico.
É necessário comprovar a identidade do agente
O comportamento do Muse Code, limites de taxa estáveis, chamadas repetidas à ferramenta ou benchmarks abrangentes do repositório são critérios decisórios.
Código sensível ou alto rendimento
Utilize o nível padrão ou compare alternativas quando a privacidade e o custo dos tokens de raciocínio forem fatores determinantes.
Utilize o modelo padrão para códigos confidenciais, a menos que sua organização tenha aprovado separadamente os termos do Contribuinte. Se o preço de saída padrão alterar o cálculo do valor, compare-o com o valor atual Preços do Codex, o código Claude e outros custos relacionados a agentes de codificação antes de definir um fluxo de trabalho.
Veredicto da análise do Muse Spark 1.2
O Muse Spark 1.2 conquistou um lugar na lista de finalistas da avaliação, mas não uma recomendação automática para produção. O contexto do token 1M, o formato familiar da API, os preços acessíveis para colaboradores, as três tentativas de codificação na primeira tentativa e as excelentes pontuações do Muse Code na avaliação da Meta tornam difícil ignorá-lo. A Meta também se saiu melhor do que muitos outros lançamentos ao divulgar detalhes da metodologia.
As ressalvas são igualmente concretas. O preço para colaboradores envolve uma compensação em relação ao uso de dados. Os tokens padrão de saída e de raciocínio podem elevar o custo real. Os principais números de codificação da Meta não foram reproduzidos como entradas correspondentes nos quadros públicos do Terminal-Bench ou do DeepSWE, e nossa amostra prática abrange três tarefas do modelo básico, em vez da execução do agente Muse Code.
A medida mais sensata é realizar um teste controlado em código não confidencial, com os dados brutos de uso e a verificação local salvos. Considere o custo e a latência medidos como uma amostra de tarefas pequenas e, em seguida, teste o tamanho do seu próprio repositório, a recuperação de falhas e o fluxo de trabalho do agente antes de optar por utilizá-lo em produção.
Perguntas frequentes sobre o Muse Spark 1.2
O que é o Muse Spark 1.2?
O Muse Spark 1.2 é o modelo da Meta voltado para programação, lançado em 5 de agosto de 2026, com uma janela de contexto de 1 milhão de tokens e acesso por meio do Muse Code, da API do Meta Model e do OpenRouter.
O Muse Spark 1.2 é o mesmo que o Muse Code?
Não. O Muse Spark 1.2 é o modelo; o Muse Code é um agente de terminal beta independente que funciona com base nele. O Muse Code adiciona recursos ao produto, como subagentes, árvores de trabalho isoladas do Git, registro de eventos, retomada e habilidades integradas.
Quanto custa a API do Muse Spark 1.2?
O modelo padrão custa $1,25 de entrada, $0,15 de entrada em cache e $4,25 de saída por milhão de tokens. O modelo Contributor custa $0,10 de entrada, $0,002 de entrada em cache e $0,20 de saída.
A Meta utiliza dados da API do Muse Spark para treinamento?
A Meta afirma que os dados do nível padrão não são utilizados para aprimorar os produtos da Meta. Os dados do nível “colaborador” podem ser utilizados para aprimorar os produtos da Meta; portanto, códigos privados ou proprietários devem seguir a rota padrão, a menos que uma organização aprove o contrário.
O Muse Spark 1.2 está nas tabelas de classificação públicas do Terminal-Bench ou do DeepSWE?
Não constava em nenhum dos fóruns públicos quando verificado em 7 de agosto de 2026. A Meta relata 82,91 TP40T no Terminal-Bench 2.1 com o Muse Code e 59,31 TP40T no DeepSWE, mas esses são resultados obtidos pela própria Meta.
O Muse Spark 1.2 foi testado na prática nesta análise?
Sim. Em três testes com o modelo básico, realizados em uma única tentativa, o Muse Spark 1.2 foi aprovado em uma correção de bug em Python, uma refatoração em TypeScript e um recurso de repositório JSONL. A latência média foi de 12,98 segundos e o custo total relatado foi de $0,045362. A confiabilidade do agente Muse Code e das chamadas de ferramentas não foi testada.
Como os desenvolvedores podem acessar o Muse Spark 1.2?
A Meta lista três opções: o agente de terminal do Muse Code (versão beta), a API do Meta Model e o OpenRouter. O guia oficial utiliza um cliente compatível com o SDK OpenAI, cuja URL base é https://api.meta.ai/v1.