O GLM-5.3 Flash é o modelo que eu recomendaria se você se preocupa com o desempenho da codificação, mas não quer pagar o preço de um modelo top de linha a cada chamada de API. A Z.AI o posiciona como um modelo multimodal nativo da série GLM-5, e a diferença de preço oficial é bastante evidente: a tarifa promocional atual é de $0,075 por 1 milhão de tokens de entrada e $0,25 por 1 milhão de tokens de saída, enquanto o GLM-5.3 e o GLM-5.2 estão listados a $1,40 na entrada e $4,40 na saída por 1 milhão de tokens na mesma página de preços da Z.AI.
Isso não significa que o GLM-5.3 Flash seja a escolha óbvia para todas as tarefas. Em nossos testes controlados de API, ele parecia econômico, mas também se mostrou sensível às configurações de raciocínio e saída. Várias solicitações padrão compatíveis com OpenAI retornaram o código de status HTTP 200, gastando a maior parte dos tokens de conclusão no raciocínio e produzindo pouca ou nenhuma resposta visível. Após mudar para configurações de raciocínio no estilo GLM e um limite máximo de saída maior, a tarefa de depuração de código tornou-se utilizável.
Este guia detalha Preço promocional do GLM-5.3, acesso à API, especificações oficiais, sinais de benchmark e resultados de testes práticos. Se o seu objetivo é comparar modelos antes de se decidir por uma pilha, GLBGPT é a maneira mais simples de comparar resultados entre vários modelos, enquanto a documentação e a página de preços do próprio Z.AI continuam sendo a fonte oficial de informações sobre a API Flash do GLM-5.3.
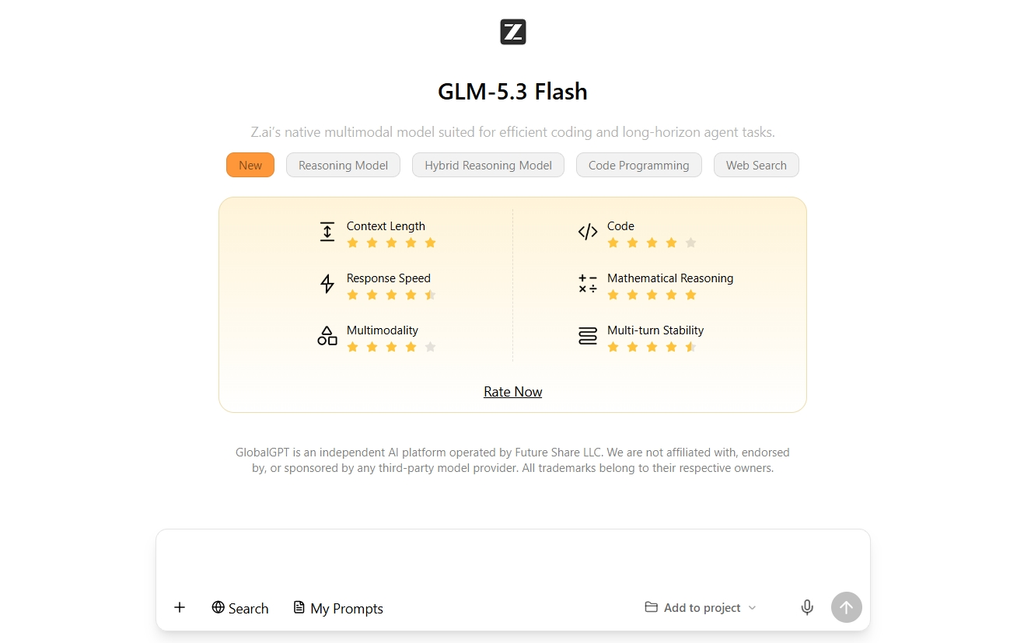
Resposta rápida: O que é o GLM-5.3 Flash?
O GLM-5.3 Flash é o modelo GLM-5 de baixo custo da Z.AI, destinado à codificação, tarefas de agentes, trabalho com contextos longos e entradas multimodais. O oficial Documentação do GLM-5.3-Flash apresenta o código do modelo da API da seguinte forma: glm-5.3-flash, suporta uma janela de contexto de 1 milhão de tokens e descreve a entrada de imagens por meio de url_da_imagem blocos de conteúdo.
O importante é a relação custo-benefício. O GLM-5.3 Flash não é apenas um rótulo menor na mesma página do modelo. A Z.AI o descreve como o primeiro modelo multimodal nativo da série GLM-5, com 320 bilhões de parâmetros no total e 18 bilhões de parâmetros ativados. Ele foi desenvolvido com base em uma arquitetura híbrida destinada a reduzir o custo de execução, mantendo ao mesmo tempo o comportamento em contextos longos.
Minha conclusão prática: o GLM-5.3 Flash é mais interessante para tarefas de codificação e de agentes em que o custo é um fator importante e nas quais é possível chamar o modelo várias vezes. Ele é menos convincente como modelo de redação casual, a menos que sua rota de API e suas configurações de raciocínio estejam ajustadas, pois a saída visível pode ficar oculta pelo uso de tokens de raciocínio quando o limite máximo de saída é muito baixo.
Preço promocional do GLM-5.3
O oficial Página de preços do Z.AI é a fonte mais confiável para Preço promocional do GLM-5.3. Conforme verificado em 27 de agosto de 2026, a Z.AI apresenta o GLM-5.3-Flash com um desconto promocional de 50%. Os preços com desconto são de $0,075 por 1 milhão de tokens de entrada e $0,25 por 1 milhão de tokens de saída. Os preços de tabela riscados são $0,15 de entrada e $0,50 de saída por 1 milhão de tokens.
A Z.AI também informa que a promoção termina às 24h do dia 9 de setembro de 2026, horário de Cingapura (UTC+8). Isso é importante para os leitores que estão comparando custos de longo prazo: o desconto de lançamento é real, mas não deve ser considerado como uma base permanente, a menos que a Z.AI o prorrogue.
| Modelo | Entrada / 1 milhão de tokens | Entrada em cache | Saída / 1 milhão de tokens | Nota sobre preços |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (promoção); $0.15 (preço de tabela) | $0.015 (promoção); $0.03 (lista) | $0.25 (preço promocional); $0.50 (preço de tabela) | Desconto no 50% até 9 de setembro de 2026 (UTC+8) |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | Linha do modelo principal GLM-5.3 na tabela de preços da Z.AI |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Linha anterior do modelo GLM sobre preços do Z.AI |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | Listado nos modelos de texto do Z.AI |
Comparação oficial dos preços de venda da Z.AI
Fonte: página oficial de preços da Z.AI, consultada em 27 de agosto de 2026. Os preços promocionais são válidos por tempo limitado.
Então, sim, o GLM-5.3 Flash é barato em comparação com o GLM-5.3 e o GLM-5.2, de acordo com os preços oficiais por token. A questão mais relevante é se ele continua sendo barato depois de incluir suas instruções, configurações de raciocínio, chamadas de ferramentas e novas tentativas. Nossa seção prática aborda esse assunto.
Se você quiser conhecer o contexto de preços da geração anterior, consulte nosso artigo separado Preço do GLM-5.2 guia. Eu manteria essa página focada no GLM-5.2 e deixaria que este artigo abordasse o preço do GLM-5.3 Flash, a API e os objetivos dos benchmarks.
GLM-5.3 Acesso à API do Flash
O código oficial do modelo da API é glm-5.3-flash. O Z.AI afirma que os parâmetros de texto são compatíveis com o GLM-5.3, suporta uma janela de contexto de 1 milhão de tokens e aceita imagens como entrada por meio de url_da_imagem blocos no interior mensagens[].conteúdo[]. Isso faz com que o GLM-5.3 Flash seja mais do que um simples modelo de codificação baseado apenas em texto.
A nota sobre as configurações não é um detalhe sem importância. A documentação recomenda temperatura: 1, top_p: 0,95, e esforço_de_raciocínio: máximo. Eles também dizem que thinking.type oferece suporte a ativado, e recomendo thinking.clear_thinking: false. Em nossos próprios testes, esse tipo de configuração fez diferença.
| Item da API | O que usar | Por que é importante |
|---|---|---|
| Código modelo | glm-5.3-flash |
Use o ID exato do modelo, em vez de tentar adivinhar o nome de uma variante. |
| Contexto | 1 milhão de tokens | Útil para grandes bases de código, documentos extensos e memória de agentes, mas ainda assim com boa relação custo-benefício. |
| Entrada de imagem | url_da_imagem blocos de conteúdo |
Oferece suporte a fluxos de trabalho de conversão de capturas de tela em código e de depuração visual. |
| Pensando | thinking.type: ativado |
O raciocínio não pode ser tratado como um pequeno detalhe oculto; ele pode determinar o uso dos tokens. |
Para quem não é desenvolvedor, é aí que uma plataforma multimodelo pode ajudar. Você pode usar GLBGPT para comparar o comportamento dos modelos antes de investir tempo na configuração da API de um provedor. Para obter informações oficiais sobre faturamento por tokens e parâmetros dos modelos, consulte sempre a tabela de preços e a documentação da própria Z.AI.
GLM-5.3: Testes de desempenho do Flash e indicadores de capacidade
Os benchmarks são úteis nesse contexto, mas somente se você indicar a fonte. A documentação do Z.AI fornece informações oficiais sobre o modelo e detalhes da arquitetura. Análise Artificial fornece dados de benchmark de terceiros. OpenRouter fornece dados sobre o mercado de prestadores de serviços. Esses são três tipos diferentes de evidência.
A Análise Artificial apresenta o GLM-5.3-Flash com um Índice de Inteligência de 57, classificação #3 entre 110 no grupo exibido, uma janela de contexto de 1M e 50,2 tokens de saída por segundo. Também indica que a modalidade de entrada é texto e imagem, com saída em texto. Esse é um forte indicador de capacidade para um modelo com preço Flash, mas ainda se trata de um benchmark de terceiros, e não de uma garantia oficial de velocidade da Z.AI.
Visão geral de preços e recursos
| Modelo | Preço oficial | Sinal de referência | Contexto | Limite da fonte |
|---|---|---|---|---|
| GLM-5.3-Flash | Promoção de $0.075 de entrada / $0.25 de saída por 1 milhão de tokens | Índice de Inteligência 57; 50,2 tokens de saída/s | 1 milhão de tokens | Preço da Z.AI; referência da Artificial Analysis |
O OpenRouter é útil para verificar a disponibilidade no marketplace e os números específicos de cada provedor, mas eu não incluiria esses valores em uma tabela de preços oficiais. Se um provedor no OpenRouter apresentar uma taxa de transferência diferente ou uma tarifa temporária diferente, identifique-a como “dados do provedor no marketplace”.
Teste prático da API: prompts, uso de tokens e resultados
Realizamos um teste controlado da API em cinco modelos disponíveis: glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, e kimi-k3. Este não foi um teste de desempenho oficial e não deve ser interpretado como um ranking global de modelos. O objetivo era mais específico e mais útil para este artigo: diante das mesmas instruções, o GLM-5.3 Flash retornou resultados úteis, como se comportaram seus tokens de raciocínio e quais campos de custo foram retornados pela resposta da API?
O desenho do teste foi propositalmente simples. Utilizamos uma tarefa de programação, uma tarefa de saída estruturada rigorosa e uma tarefa curta de redação. Essa combinação é importante porque um modelo pode apresentar um desempenho excelente na programação e, mesmo assim, ser problemático para JSON rigoroso ou textos curtos, caso a rota esgote o orçamento de saída em raciocínios ocultos.
Como ler os cartões de teste
- Passe significa que o modelo retornou uma saída visível que respondeu à tarefa.
- Erro de formatação significa que o conteúdo foi útil, mas não se tratava de uma saída estritamente legível por máquina.
- Inconclusivo significa que a solicitação foi bem-sucedida do ponto de vista técnico, mas a rota testada retornou pouca ou nenhuma resposta visível.
- Campos de custo são valores informados na resposta desta consulta controlada à API, e não promessas oficiais de preço do provedor.
A execução padrão utilizada temperatura: 0,2 e um limite máximo de saída por tarefa. Cada modelo/tarefa foi executado uma vez, sem repetição automática. Em seguida, realizamos um teste complementar apenas para o GLM-5.3 Flash nas tarefas de codificação e redação com configurações de raciocínio no estilo GLM, pois as respostas padrão do Flash apresentavam uso intenso de tokens de raciocínio e exigiam uma verificação mais justa da configuração.
Tarefa A
Depuração de código: o modelo detectou o erro no agrupamento de clientes?
Tarefa: Identifique o erro em uma função do TypeScript, explique por que ele ocorre e apresente uma implementação corrigida.
Prompt exato
Você está analisando uma função em TypeScript que deve agrupar os pedidos por ID do cliente e calcular o valor total gasto por cada cliente. Encontre o erro, explique por que ele ocorre e forneça uma implementação corrigida. Código: type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const order of orders) { if (!result[order.id]) result[order.id] = { count: 0, total: 0 }; result[order.id].count += 1; result[order.id].total += order.total; } return result; }
| Modelo | Visão geral dos resultados | Nota sobre o token/custo | Resultado |
|---|---|---|---|
glm-5.3-flash |
A execução padrão retornou um código HTTP 200, mas não houve resposta visível do assistente, pois o raciocínio utilizou 1.196 dos 1.200 tokens de conclusão. Na análise de acompanhamento das configurações recomendadas, foi identificado corretamente que order.id deveria ser order.customerId e apresentou uma implementação corrigida. |
Padrão: 1.348 tokens no total, campo de custo $0.0003111. Acompanhamento: 2.584 tokens no total, campo de custo $0.00124007598. | Aprovação após nova execução |
glm-5.3 |
Identifiquei o erro na chave de agrupamento e expliquei por que os IDs de pedido exclusivos impedem a agregação no nível do cliente. O código corrigido utilizado customerId como chave do objeto. |
1.348 tokens no total, campo de custo $0,00534128. | Passe |
glm-5.2 |
Também encontrei o order.id versus customerId identificou o problema e produziu uma implementação corrigida que funciona corretamente. |
1.304 tokens no total. O custo em dólares americanos não foi retornado no mesmo campo da resposta. | Passe |
gpt-5.6-luna |
Deu a explicação mais clara e concisa: o acumulador era indexado por ID do pedido, de modo que cada pedido se tornava seu próprio bucket. Ele retornou o código TypeScript corrigido. | 509 tokens no total. Custo em dólares americanos pendente/não devolvido. | Passe |
kimi-k3 |
Encontrei o mesmo bug e forneci uma explicação detalhada, além de uma implementação corrigida. A resposta era útil, mas mais longa do que a do GPT. | 1.423 tokens no total. Custo em dólares americanos pendente/não devolvido. | Passe |
Conclusão: Para a depuração do código, o GLM-5.3 Flash só apresentou bons resultados após ajustes de configuração baseados na lógica do GLM e um limite máximo de saída maior. O GLM-5.3, o GLM-5.2, o GPT-5.6 Luna e o Kimi K3 retornaram respostas visíveis e utilizáveis já na primeira execução.
Tarefa B
JSON estrito: o modelo seguiu um formato legível por máquina?
Tarefa: Retorne apenas JSON estrito, com chaves fixas e sem formatação Markdown.
Prompt exato
Retorne apenas JSON estrito. Compare os modelos principais GLM-5.3-Flash, GLM-5.3 e do tipo GPT para um desenvolvedor que esteja escolhendo um assistente de codificação. Use as chaves: best_for, tradeoffs, cost_warning, recommendation. Não use markdown.
| Modelo | Visão geral dos resultados | Nota sobre o token/custo | Resultado |
|---|---|---|---|
glm-5.3-flash |
Retornou um conteúdo parcial semelhante a JSON, mas não era um JSON estritamente analisável sem uma limpeza prévia. Isso é utilizável para um leitor humano, mas não para automação direta. | 1.267 tokens no total, campo de custo $0,000305025. | Erro de formatação |
glm-5.3 |
Não retornou nenhum conteúdo visível do assistente abaixo do limite de saída testado, com quase todos os tokens de conclusão consumidos pelo raciocínio. | 1.267 tokens no total, campo de custo $0,00530084. | Inconclusivo |
glm-5.2 |
Retornou uma resposta semelhante a JSON, mas ela estava incompleta/não podia ser analisada sem um processamento de limpeza. | 1.268 tokens no total. O custo em dólares americanos não foi retornado no mesmo campo da resposta. | Erro de formatação |
gpt-5.6-luna |
Retornou um JSON analisável com as chaves solicitadas e sem a delimitadora de Markdown. | 541 tokens no total. Custo em dólares americanos pendente/não devolvido. | Passe |
kimi-k3 |
O conteúdo retornado era semelhante a JSON e continha informações úteis, mas não era um JSON estritamente analisável sem uma limpeza prévia. | 1.339 tokens no total. Custo em dólares americanos pendente/não devolvido. | Erro de formatação |
Conclusão: Para uma saída estritamente estruturada, o GPT-5.6 Luna apresentou o resultado mais limpo nesta pequena série de testes. O GLM-5.3 Flash ainda pode funcionar com controles mais rígidos de formato de resposta, mas essa solicitação padrão não estava pronta para automação.
Tarefa C
Breve observação sobre o produto: o modelo produziu textos utilizáveis?
Tarefa: Escreva uma nota específica e não promocional de 120 palavras explicando em que situações o GLM-5.3 Flash é melhor do que um modelo top de linha mais pesado.
Prompt exato
Escreva uma descrição do produto com 120 palavras explicando em que situações o GLM-5.3-Flash é uma escolha melhor do que um modelo top de linha mais pesado. Seja específico, sem tom promocional.
| Modelo | Visão geral dos resultados | Nota sobre o token/custo | Resultado |
|---|---|---|---|
glm-5.3-flash |
A execução padrão não retornou nenhum conteúdo visível após o raciocínio ter utilizado 895 dos 900 tokens de conclusão. A execução subsequente com as configurações recomendadas também não retornou nenhum conteúdo visível após o raciocínio ter utilizado 1.798 dos 1.800 tokens de conclusão. | Padrão: 946 tokens no total, campo de custo $0.00022845. Acompanhamento: 1.846 tokens no total, campo de custo $0.00045345. | Inconclusivo |
glm-5.3 |
Não retornou nenhum conteúdo visível abaixo do limite de saída testado. | 946 tokens no total, campo de custo $0,0040244. | Inconclusivo |
glm-5.2 |
Não retornou nenhum conteúdo visível na rota testada. | 947 tokens no total. O custo em dólares americanos não foi retornado no mesmo campo de resposta. | Inconclusivo |
gpt-5.6-luna |
Entreguei uma nota prática com exemplos concretos, como geração de alto rendimento, latência previsível, resumos de suporte, extração, classificação e roteamento. O texto ficou próximo do comprimento solicitado de 120 palavras. | 983 tokens no total. Custo em dólares americanos pendente/não devolvido. | Passe |
kimi-k3 |
Não retornou nenhum conteúdo visível na rota testada. | 1.019 tokens no total. Custo em dólares americanos pendente/não devolvido. | Inconclusivo |
Conclusão: Para gravações curtas nessa rota, o GLM-5.3 Flash não produziu uma cópia visível utilizável, embora o custo retornado fosse mínimo. Eu não o escolheria para gravação apenas com base na tabela de preços; testaria primeiro as configurações exatas.
O que os testes realmente revelaram
- O GLM-5.3 Flash é realmente interessante em termos de custo de programação. A tarefa de codificação funcionou após a configuração com base no raciocínio do modelo GLM, e o custo registrado ainda foi mínimo para a execução.
- A rota padrão não era do tipo “plug-and-play”. Várias respostas do Flash retornaram o código HTTP 200, tendo utilizado quase todo o limite de conclusão em tokens de raciocínio.
- O JSON estrito requer validação adicional. Uma resposta que se parece com JSON não é o mesmo que um JSON que possa ser analisado, especialmente se a saída for utilizada em um processo de automação.
- Os textos curtos não são o que eu levaria em conta em primeiro lugar ao avaliar o Flash. Neste teste, a sugestão de redação não recebeu uma resposta visível do Flash, mesmo após as configurações de acompanhamento.
Minha opinião é simples: o GLM-5.3 Flash é promissor para codificação com foco no custo, mas você não deve tratá-lo como uma solução “plug-and-play” em todas as rotas compatíveis com OpenAI. Defina um orçamento de saída suficiente, verifique o comportamento dos tokens de raciocínio e teste exatamente o tipo de tarefa que você planeja executar antes de transferir volume real para ele.
Melhores casos de uso para o GLM-5.3 Flash
O GLM-5.3 Flash faz mais sentido quando a tarefa se beneficia de entradas multimodais, contexto extenso e muitas chamadas repetidas. Não é o modelo que eu escolheria apenas porque a tabela de preços parece boa. Eu o escolheria quando a natureza da tarefa se alinhasse ao modelo.
- Agentes de codificação com muitas chamadas de ferramentas: Preços mais baixos por token facilitam o processo de planejamento, edição, teste e correção.
- Trabalho de front-end a partir de capturas de tela: A capacidade de importação de imagens e o foco na codificação fazem com que seja uma opção ideal para a depuração de interfaces de usuário e tarefas de conversão de capturas de tela em código.
- Revisão de código com contexto extenso: A janela de contexto de 1M é útil quando você precisa incluir mais informações de contexto do projeto em uma única solicitação.
- Trabalho profissional que envolve muitos documentos: O Z.AI descreve casos de uso envolvendo arquivos do Office, pesquisas financeiras e processamento de documentos profissionais.
- Experimentos com APIs que levam em conta o orçamento: A diferença de preço oficial faz com que o Flash seja uma boa opção como primeiro modelo para testar antes de passar para um modelo mais robusto.
Se você costuma escrever principalmente textos curtos de marketing, não presuma que o Flash seja a melhor opção padrão só porque é mais barato. Nosso teste de redação não foi conclusivo, tanto na execução padrão do Flash quanto nas configurações recomendadas, pois o conteúdo visível não foi exibido corretamente dentro do limite de saída escolhido. Eu testaria primeiro tarefas de codificação e engenharia estruturada e, depois, decidiria se o Flash também merece um lugar em seu conjunto de ferramentas de redação.
Gatilhos de custo e configurações de API a serem monitorados
O maior risco de custo do GLM-5.3 Flash não é o preço oficial do token. O preço oficial é baixo. O risco está na diferença entre uma solicitação barata e uma resposta utilizável.
- Tokens de raciocínio: Em nossos testes, os tokens de raciocínio consumiram a maior parte do orçamento de conclusão em várias execuções.
- Limite máximo de produção: Um limite baixo pode fazer com que nenhum conteúdo visível seja retornado, mesmo quando a solicitação HTTP for bem-sucedida.
- Loops de agentes: cada ciclo de planejamento-edição-teste pode multiplicar os tokens de contexto e de saída.
- Contexto geral: 1 milhão de tokens é útil, mas enviar mais contexto do que o necessário ainda afeta o custo e a latência.
- Novas tentativas: Repetir uma alteração de configuração que falhou ou não gerou resultados altera o custo real por resultado utilizável.
Para tarefas de codificação, meu ponto de partida seria: usar o código-modelo oficial, seguir as configurações de raciocínio no estilo GLM, dar ao modelo espaço suficiente para a saída visível e registrar os tokens de raciocínio separadamente dos tokens de resposta final. Se você estiver comparando abordagens, avalie o custo por tarefa concluída, em vez do custo por solicitação.
Vale a pena atualizar para o GLM-5.3?
Vale a pena testar o GLM-5.3 Flash se sua carga de trabalho envolver muita programação, for sensível a custos e for orientada por API. O preço oficial é atraente, o sinal de referência de terceiros é forte e o modelo possui especificações úteis: entrada multimodal nativa, contexto de 1M e uma arquitetura da série GLM-5 projetada para uma execução eficiente.
Eu teria mais cuidado se o seu principal caso de uso fosse a redação em geral, uma saída estritamente estruturada ou um fluxo de trabalho em que a saída de raciocínio invisível pudesse representar um problema grave. Nesses casos, teste o caminho e as configurações exatas antes de transferir o volume para o Flash. Um modelo pode ser barato e, mesmo assim, exigir disciplina na configuração.
Para os leitores que desejam explorar o comportamento dos modelos antes de escolher uma pilha de APIs, GLBGPT oferece uma maneira prática de comparar os resultados dos modelos sem precisar abrir uma aba separada para cada provedor. Depois de saber qual modelo é o mais adequado para a sua tarefa, fica mais fácil avaliar a API oficial e a documentação sobre preços.
PERGUNTAS FREQUENTES
O que é o GLM-5.3 Flash?
O GLM-5.3 Flash é um modelo da série GLM-5 da Z.AI com o código de modelo da API glm-5.3-flash. A Z.AI o descreve como um modelo multimodal nativo com suporte a contexto de 1 milhão de tokens e uma arquitetura econômica.
Quanto custa o GLM-5.3 Flash?
Conforme verificado em 27 de agosto de 2026, a Z.AI lista o GLM-5.3 Flash a $0,075 por 1 milhão de tokens de entrada e $0,25 por 1 milhão de tokens de saída durante uma promoção de 50%. Os preços normais listados são $0,15 na entrada e $0,50 na saída por 1 milhão de tokens.
O GLM-5.3 Flash é gratuito?
A página oficial de preços apresenta os valores dos tokens de API pagos. Ela também mostra um desconto por tempo limitado, e não um modelo gratuito permanente. Algumas rotas ou planos podem oferecer regras de cota distintas, mas é preciso verificar isso na interface de acesso que você realmente utiliza.
Qual é o código do modelo da API Flash GLM-5.3?
O código oficial do modelo é glm-5.3-flash.
O GLM-5.3 Flash suporta a importação de imagens?
Sim. A documentação do Z.AI descreve a entrada de imagens por meio de url_da_imagem blocos de conteúdo dentro da matriz de conteúdo das mensagens do chat.
O que é a janela de contexto do GLM-5.3 Flash?
A documentação do Z.AI descreve o suporte a uma janela de contexto de 1 milhão de tokens. O OpenRouter e o Artificial Analysis também exibem cerca de 1 milhão de tokens de contexto, mas essas são páginas independentes de terceiros.
O GLM-5.3 Flash é melhor do que o GLM-5.3?
Não necessariamente. O GLM-5.3 é o modelo mais robusto para codificação complexa e tarefas de longo prazo, enquanto o GLM-5.3 Flash é bem mais econômico e oferece posicionamento multimodal nativo. Escolha de acordo com o tipo de tarefa e a tolerância a custos.
O GLM-5.3 Flash é bom para programação?
Parece promissor para codificação, especialmente para codificação com restrições de custo. Em nosso teste controlado de API com configurações baseadas na abordagem do GLM e um limite máximo maior de tokens, ele corrigiu corretamente um erro de agrupamento no TypeScript. Com limites padrão de saída mais baixos, várias execuções não foram conclusivas porque a resposta apresentava pouco ou nenhum conteúdo visível.
Como o GLM-5.3 Flash se compara aos modelos GPT?
O GLM-5.3 Flash é bem mais barato do que muitas opções de codificação de ponta, considerando o preço oficial do token, mas o preço não é o único fator. Em nosso pequeno teste com configurações padrão, o GPT-5.6 Luna apresentou resultados úteis para todas as três tarefas, enquanto o GLM-5.3 Flash precisou de uma nova execução com as configurações recomendadas para a tarefa de codificação.
Como o GLM-5.3 Flash se compara ao Kimi?
O Kimi K3 foi aprovado na tarefa de codificação e depuração em nosso teste, mas não atendeu aos critérios rigorosos de JSON sem limpeza e não retornou nenhum conteúdo visível para a tarefa de redação curta na rota testada. Isso não significa que o Kimi seja pior no geral; trata-se apenas de uma descrição desse conjunto de tarefas e dessa configuração.
Onde posso experimentar o GLM-5.3 Flash?
Para obter acesso oficial à API, consulte a documentação do GLM-5.3 Flash e as páginas de preços da Z.AI. Para uma comparação mais abrangente entre modelos antes de tomar uma decisão, você pode usar uma plataforma multimodelo, como o GLBGPT, para comparar os resultados de diferentes modelos em um único lugar.
Devo usar o GLM-5.3 Flash para produção?
Utilize-o em ambiente de produção somente após testar sua tarefa específica, rota, configurações, limites de saída e registro de custos. O preço é atraente, mas nossos testes mostraram que os detalhes da configuração podem determinar se a resposta é utilizável.
Conclusão final
O GLM-5.3 Flash não é apenas uma nota de rodapé de baixo custo do GLM-5.3. É uma nova opção séria para codificação com foco em custo, entrada multimodal e trabalho com API de contexto extenso. O preço oficial é atraente, e os resultados dos benchmarks são sólidos o suficiente para justificar a realização de testes.
Minha principal ressalva é de natureza prática: não o avalie apenas com base no código de status HTTP 200. Verifique a saída exibida, o uso de tokens de raciocínio e o custo por resposta utilizável. Se esses aspectos parecerem satisfatórios em suas tarefas reais, o GLM-5.3 Flash pode ser um dos modelos com melhor relação custo-benefício na pilha de codificação atual.