Verificado em 27 de agosto de 2026. O Qwen3.8 Flash é o modelo de produção gerenciado do Qwen com o ID de API qwen3.8-flash. Ele se diferencia do artefato Qwen3.8-Flash-Next de peso aberto. O Qwen Cloud apresenta taxas básicas de $0,15 por milhão de tokens de entrada e $0,47 por milhão de tokens de saída. A resposta curta é que vale a pena fazer um teste controlado quando você precisa de processamento multimodal de baixo custo e uma grande janela de contexto listada, mas você deve verificar os limites da rota e a qualidade das evidências antes de confiar nele em produção.
O apelo prático é bem direto: uma janela de contexto listada de 1 milhão de tokens, entrada de texto/imagem/vídeo, saída estruturada e recursos da ferramenta, além de taxas básicas de tokens baixas. É uma excelente opção para síntese de documentos longos, análise multimodal e trabalho operacional estruturado; para um fluxo de trabalho de alto risco, comece com uma tarefa representativa e decida com base na saída que você realmente pode utilizar.
O GlobalGPT é um ambiente de trabalho independente e multimodelo—não é um canal oficial do Alibaba ou do Qwen—, mas é útil se o seu trabalho não se encaixar em nenhum modelo. Em um único site, você pode comparar o Qwen3.8 Flash com famílias de modelos amplamente utilizadas, como ChatGPT, Claude, Gemini e Grok, e, em seguida, manter a pesquisa, a elaboração de rascunhos, a ajuda na programação, a análise de documentos e os testes de prompts no mesmo fluxo de trabalho. Isso é especialmente prático quando uma tarefa precisa dos pontos fortes do Qwen em contexto longo ou multimodal, enquanto outra se beneficia do estilo de redação, raciocínio ou programação de um modelo diferente.
O que é o Flash Qwen3.8?
O Qwen3.8 Flash é um modelo multimodal hospedado, oferecido pela Qwen Cloud para trabalhos rápidos e de alto volume. A página oficial lista texto, imagem e vídeo como entradas e texto como saída. Também menciona chamada de funções, saídas estruturadas, armazenamento em cache de prompts, processamento em lote, pesquisa na web e ajuste fino. Essas são as funcionalidades oficiais do serviço; uma interface de terceiros pode expor apenas parte dessas funcionalidades.
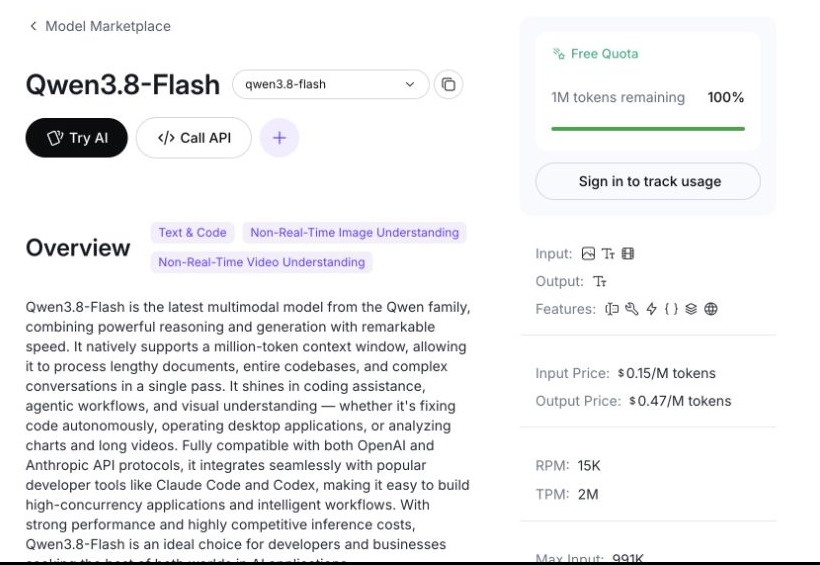
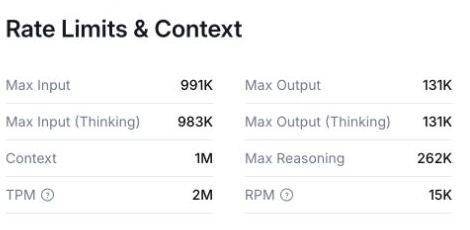
A janela de contexto listada é de 1 milhão de tokens. O Qwen Cloud também exibe limites específicos para cada rota, em vez de um único limite ilimitado: o caminho padrão indica um máximo de 991 mil tokens de entrada e 131 mil tokens de saída, enquanto o modo de reflexão possui seu próprio limite de entrada. Uma janela de contexto ampla só ajuda quando a rota aceita o arquivo, a estrutura de recuperação está correta e o modelo consegue rastrear as evidências relevantes.
- Considere o ID exato da API como parte da reprodutibilidade.
- Distinga as funcionalidades documentadas do modelo básico das ferramentas disponibilizadas pela plataforma escolhida.
- Utilize um contexto extenso para trabalhos repletos de evidências, mas exija citações ou verificações estruturadas, em vez de confiar apenas no envio de um texto extenso.
Qwen3.8 Flash vs Qwen3.8 Flash-Next
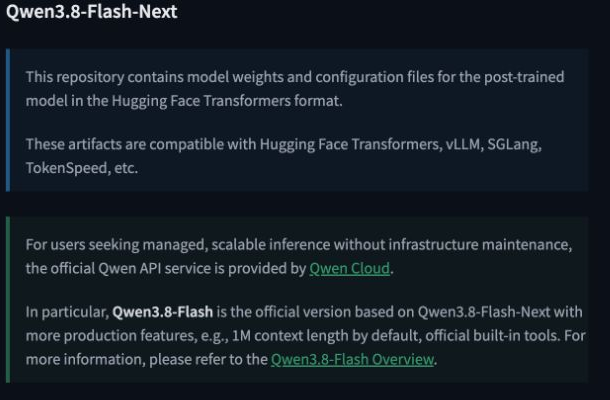
É fácil simplificar a nomenclatura para um único produto, mas a distinção é importante. A ficha técnica oficial do Qwen descreve o Qwen3.8-Flash como a versão de produção baseada no Qwen3.8-Flash-Next. O Flash-Next é o artefato de peso aberto, com detalhes públicos de arquitetura e pesos; o Flash é o serviço de produção gerenciado, com ferramentas oficiais integradas e uma janela de contexto padrão de 1M.
| Pergunta | Qwen3.8 Flash | Qwen3.8 Flash-Next |
|---|---|---|
| O que é isso? | Modelo de produção gerenciada e API | Lançamento técnico e de artefatos de peso aberto |
| Identificador exato | qwen3.8-flash | Qwen3.8-Flash-Next |
| Pesos | Não são apresentados como pesos para download na página de produção | Artefato de modelo público |
| Ferramentas integradas | Listado pela Qwen Cloud; depende da rota | Não é equivalente a um conjunto de ferramentas hospedadas |
| Evidências de referência | Não foi encontrada nenhuma tabela de classificação independente e verificada de produção exata | Tabelas informadas pelo fornecedor no cartão do modelo |
Isso significa que uma pontuação do Flash-Next pode explicar a direção de engenharia do Qwen, mas não deve ser reclassificada como um resultado independente do modelo de produção. O local do teste, o conjunto de cabos e o nome exato do modelo devem constar ao lado de cada número.
Onde é possível utilizar o chip Qwen3.8 Flash?
Existem três rotas verificadas neste projeto, e elas atendem a diferentes funções. Apenas a Qwen Cloud é a rota oficial da API Qwen. A GlobalGPT é uma plataforma independente de assinaturas multimodelo. A Anywhere foi a rota da API utilizada para a verificação de prontidão e as tarefas práticas; ela é uma prova de disponibilidade testada, não um destino oficial para o consumidor.
| Rota | Status | O que foi verificado | Limite importante |
|---|---|---|---|
| Qwen Cloud | Oficial | Página do modelo, ID da API, preços, contexto e lista de recursos | Os termos do serviço nativo e a disponibilidade regional continuam em vigor |
| GlobalGPT | Plataforma independente | Página do modelo Visible Qwen3.8 Flash e preços do plano anual | O mapeamento exato entre o plano e o modelo ainda está pendente |
| Em qualquer lugar | Rota da API testada | ID exato do modelo listado e respostas bem-sucedidas obtidas | A semântica do custo em dólares público e do limite de uso ainda não foi verificada |
O GlobalGPT é a opção mais indicada para quem deseja alternar entre modelos dentro de um único espaço de trabalho, em vez de utilizar contas de API separadas. Use o página atual de preços do GlobalGPT para confirmar o pacote em vigor antes de efetuar o pagamento; a página exibia os preços dos planos anuais durante a pesquisa, mas a lista de planos disponível não associava explicitamente o Qwen3.8 Flash a um nível específico.
Qwen3.8 Preços e valor do Flash
A página oficial do Qwen Cloud indica $0,15 por milhão de tokens de entrada e $0,47 por milhão de tokens de saída como taxas básicas. Ela também apresenta taxas mais baixas para leitura de cache e preços separados para a criação explícita de cache. As estimativas de custo devem, portanto, indicar qual tarifa está sendo utilizada e evitar dar a entender que as taxas de ferramentas, buscas na web ou de outras plataformas estão incluídas.
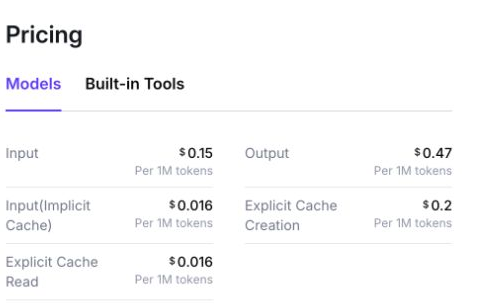
O que significam as taxas básicas dos tokens
100 mil de entrada + 10 mil de saída, de acordo com as taxas básicas indicadas.
1 milhão de entradas + 100 mil saídas nas taxas básicas indicadas.
Os exemplos de cálculo não incluem ferramentas, opções de armazenamento em cache, taxas de plataforma e quaisquer cobranças específicas da rota.
O primeiro exemplo é uma solicitação de análise de um documento extenso: 100 mil tokens de entrada custam $0,015 e 10 mil tokens de saída custam $0,0047, totalizando $0,0197 de acordo com as taxas básicas listadas. O segundo exemplo utiliza 1 milhão de tokens de entrada e 100 mil de saída: $0,15 mais $0,047, ou seja, $0,197. Trata-se de exemplos aritméticos, e não de faturas ou promessas relativas a uma rota de terceiros.
O preço do token é apenas uma parte do valor. Uma taxa baixa é mais importante quando o resultado é confiável o suficiente para reduzir o tempo de revisão e quando o armazenamento em cache ou o processamento em lote se adequam à carga de trabalho. Para um pipeline de extração, calcule o custo das repetições, da validação e da correção humana juntamente com os tokens. Para uma equipe interativa, compare a assinatura mensal com o tempo economizado ao manter vários modelos em um único espaço de trabalho. A métrica de decisão mais honesta é o custo por resultado aceito, e não o custo por token gerado. Como esta análise não executou uma carga de trabalho de produção nem verificou a semântica pública do dólar do Anywhere, ela não aponta um vencedor universal em termos de custo.
O GlobalGPT utiliza um modelo de assinatura, em vez de cobrança direta por token. Em 27 de agosto de 2026, sua tabela anual apresentava o plano Básico a $5,8 por mês, o Pro a $10,8 e o Ilimitado a $25. Uma assinatura pode facilitar o planejamento do orçamento ao alternar entre vários modelos, mas não é diretamente comparável aos preços dos tokens de API, pois os créditos, o acesso aos modelos e os controles da plataforma diferem.
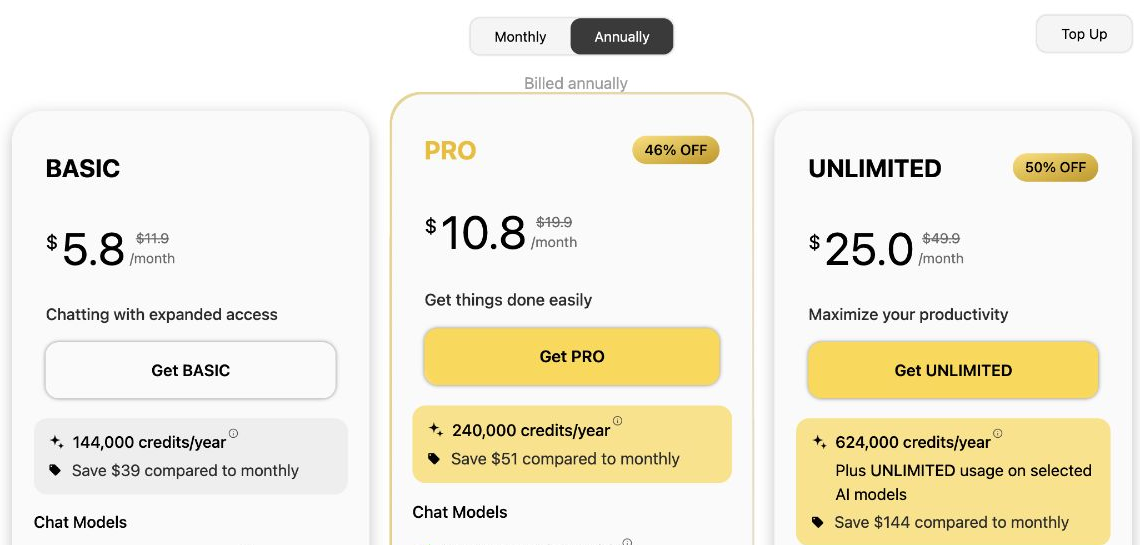
- Escolha o faturamento por token quando precisar de volume programático, registros e controles de API nativos.
- Escolha uma assinatura multimodelo quando o principal benefício for o acesso interativo e a alternância entre modelos.
- Não calcule o custo em dólares “Anywhere” com base em índices de preços não documentados; a semântica do dólar público não foi verificada.
Competências que fazem a diferença no trabalho real
Documentos extensos e bases de código
A capacidade de listar 1 milhão de tokens torna o Qwen3.8 Flash interessante para revisões de repositórios, coleções de documentos e transcrições longas. A questão relevante não é se um arquivo grande cabe, mas se o modelo é capaz de identificar conflitos, preservar os dados desconhecidos e remeter à fonte. A tarefa de rastreabilidade de 15 páginas, apresentada mais adiante nesta análise, testa esse comportamento mais específico, e não a janela máxima.
Programação e fluxos de trabalho dos agentes
O Qwen define o modelo para tarefas de codificação e tarefas agênicas, e o cartão Flash-Next apresenta resultados sólidos em diversos conjuntos de testes de codificação. Esses resultados são indicadores úteis sobre o que testar em seguida, mas não substituem a execução de seu próprio repositório, política de ferramentas e testes de aceitação. Para uma base de decisão mais ampla, consulte nosso guia sobre o melhores modelos de IA para codificação.
Análise multimodal
O serviço oficial aceita imagens e vídeos como dados de entrada. Na prática, isso permite a análise de prontuários, a interpretação de telas, imagens de documentos e questões com vídeos longos. O tamanho do arquivo, a duração, a qualidade da extração e os limites da interface do usuário específicos para cada rota ainda são importantes. Nossa pequena tarefa de análise de imagens verifica um prontuário com um conflito deliberado no relatório; ela não avalia a qualidade geral do raciocínio visual.
Ferramentas e saída estruturada
A chamada de funções e a saída estruturada são especialmente relevantes para o trabalho em produção, pois fornecem ao aplicativo elementos que podem ser testados. Os recursos de cache e processamento em lote podem alterar a economia em escala. A pesquisa na web pode agregar atualidade, mas os fatos pesquisados precisam de seu próprio rastro de fontes. Confirme cada recurso na rota que você realmente planeja utilizar.
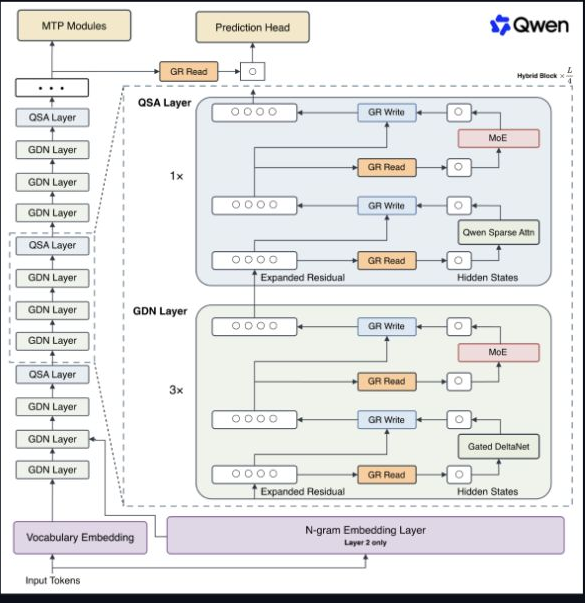
O que os dados comparativos realmente revelam
A evidência de referência mais sólida e visível no conjunto de fontes atual é a própria placa modelo Flash-Next da Qwen. Ela apresenta 58,7 no DeepSWE 1.1, 62,5 no SWE-bench Pro e 81,0 na linha exibida sobre engenharia de software multilíngue. A ficha também inclui notas sobre o conjunto de testes e o contexto. Esses detalhes tornam a tabela mais útil, mas não transformam os relatórios do fornecedor em uma validação independente.
Resultados da codificação do Flash-Next divulgados pelo fornecedor
Esses três valores são provenientes do cartão do modelo Flash-Next da Qwen. Não se trata de resultados independentes para o modelo de produção gerenciado.
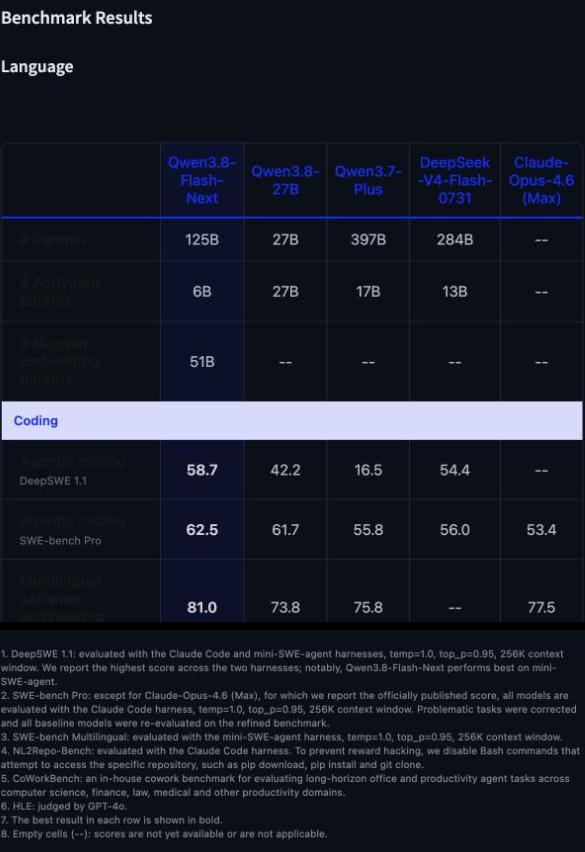
Em 27 de agosto, não foi verificada nenhuma entrada madura e confiável no ranking independente para o modelo exato Qwen3.8-Flash. Essa lacuna deve permanecer visível. Uma atualização responsável acrescentaria um resultado independente somente quando o ranking identificasse o modelo exato e divulgasse o conjunto de fios, a data e o trajeto.
- Não transfira pontuações do Flash-Next para o Flash de produção sem uma declaração de equivalência.
- Não compare números entre versões diferentes do chicote elétrico como se elas usassem a mesma escala.
- Use a tabela de fornecedores para selecionar os casos de teste e, em seguida, valide-os em sua própria carga de trabalho.
Nossa pequena verificação prática
Como foi realizada a verificação
- Modelo exato:
qwen3.8-flashpor meio da rota testada de autocompletar mensagens do Anywhere. - Um único resultado inicial por tarefa ativa; sem repetições de qualidade nem execuções de estabilidade.
- As verificações automáticas rigorosas permanecem separadas da análise, feita pelo coordenador, dos requisitos visíveis em cada solicitação.
- O uso relatado excedeu os limites de saída solicitados; portanto, a semântica dos limites de uso e o custo público em dólares permanecem não verificados.
Três tarefas iniciais abrangem auditoria estruturada, análise de gráficos e rastreabilidade. Elas servem como base para observações específicas, e não como um parâmetro de referência geral.
Uma tarefa JavaScript aposentada atingiu o tempo limite duas vezes, sem status HTTP, conteúdo ou uso. Ela não recebeu pontuação e não constitui evidência de capacidade.
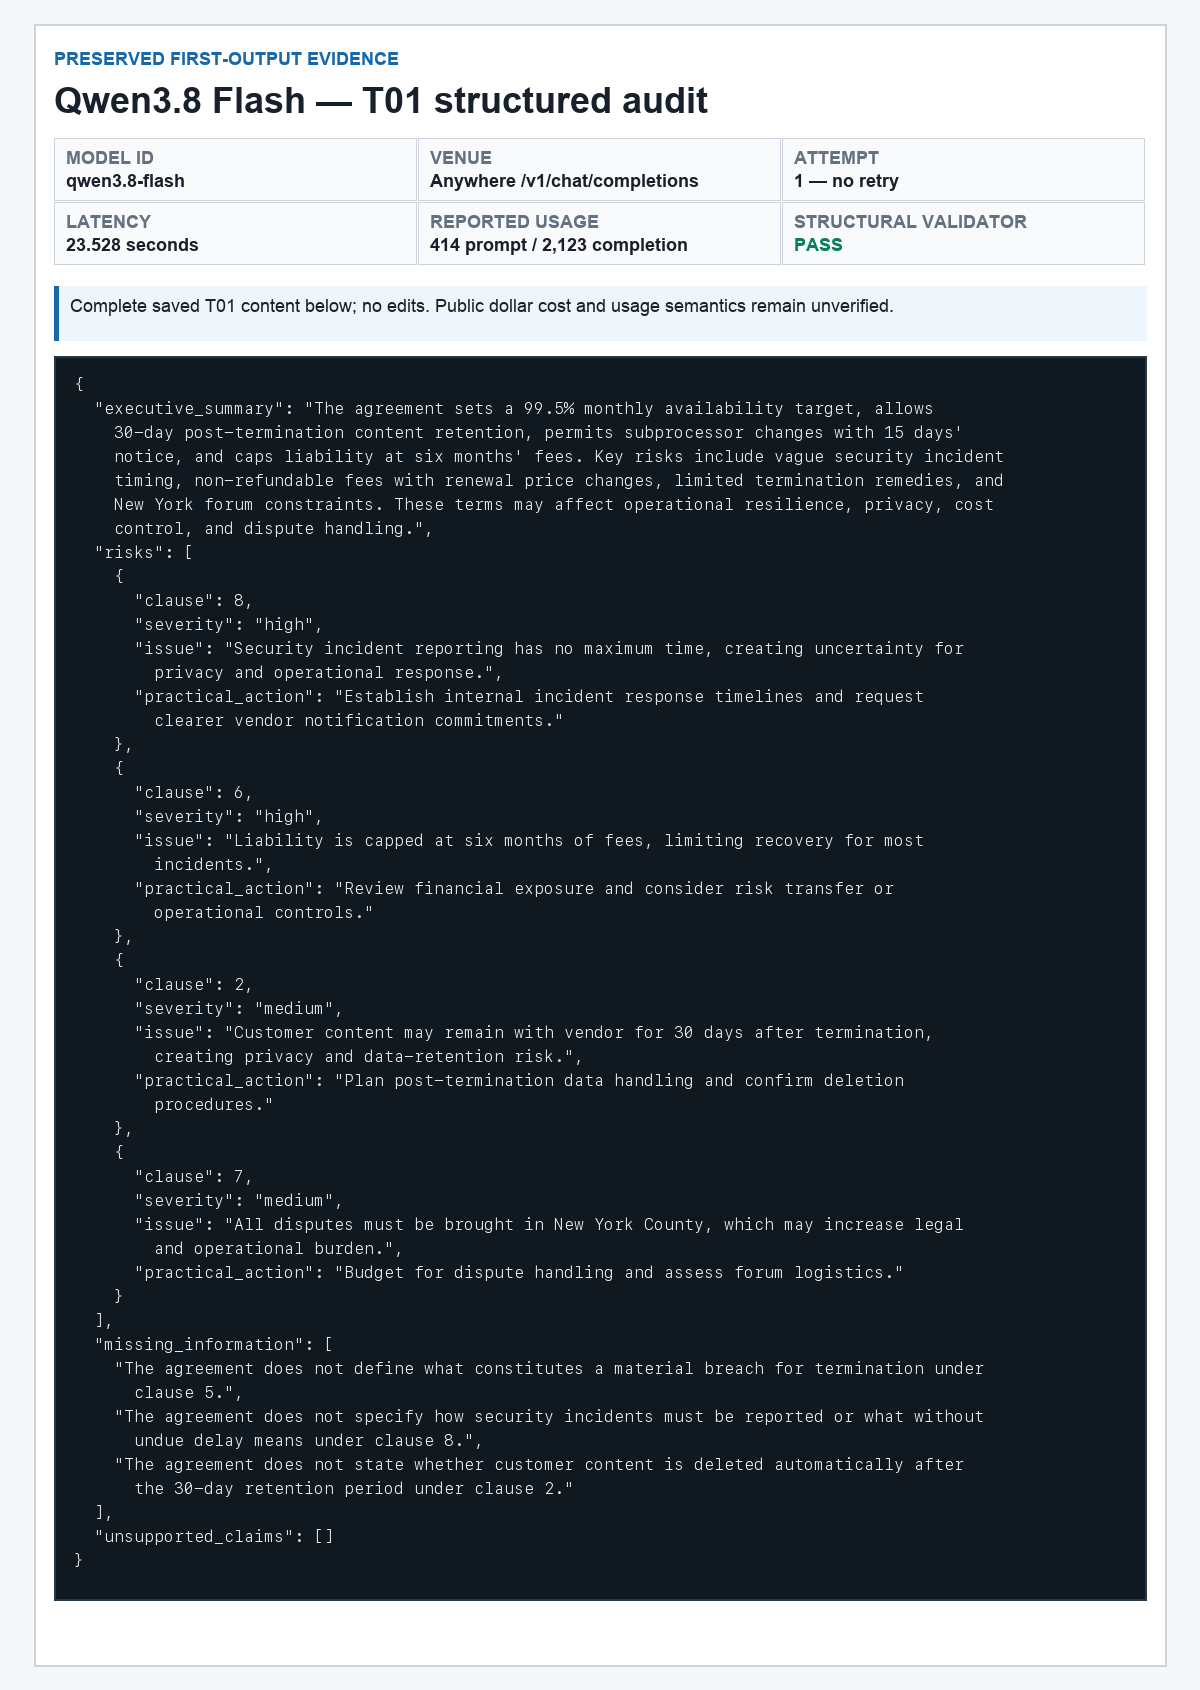
T01 · Auditoria estruturada de riscos contratuais
Ele foi aprovado na tarefa de risco contratual congelado; isso não é uma pontuação geral de qualidade.
Validador automático: APROVADO. Revisão de tarefas congeladas: 10/10. Semântica do limite de uso e custo em dólares: não verificado.
Ver o prompt exato
Você está analisando um contrato fictício com um fornecedor de SaaS. Utilize apenas as cláusulas numeradas abaixo. Não acrescente fatos externos.

[1] A meta de disponibilidade do serviço é de 99,5% por mês civil. Estão excluídas as manutenções programadas anunciadas com 48 horas de antecedência.
[2] O conteúdo do cliente poderá ser retido por até 30 dias após o encerramento da conta para fins de restauração de backup.
[3] O fornecedor poderá utilizar subprocessadores e publicará alterações significativas relacionadas a subprocessadores pelo menos 15 dias antes de elas entrarem em vigor.
[4] As taxas não são reembolsáveis, exceto quando exigido por lei. O fornecedor poderá alterar os preços de renovação com aviso prévio de 30 dias.
[5] Qualquer uma das partes poderá rescindir o contrato por violação substancial não sanada, mediante notificação por escrito com 20 dias de antecedência.
[6] A responsabilidade total do fornecedor está limitada às taxas pagas nos seis meses anteriores ao evento, exceto em casos de fraude ou conduta dolosa.
[7] O contrato é regido pela legislação de Nova York. As disputas devem ser submetidas aos tribunais estaduais ou federais do condado de Nova York.
[8] Incidentes de segurança que afetem o conteúdo do cliente devem ser comunicados sem demora injustificada, mas não é especificado um número máximo de horas.

Retorne um objeto JSON válido com exatamente estas chaves:
- executive_summary: string, no máximo 70 palavras
- risks: matriz com exatamente 4 objetos, cada um com cláusula (inteiro), gravidade ('alta'|"média"|"baixa"), problema (string), ação_prática (string)
- missing_information: matriz com exatamente 3 strings
- unsupported_claims: matriz vazia

Priorize riscos concretos de natureza comercial, de privacidade, operacional e jurídica. Cada risco deve citar um dos números de cláusula. Não forneça aconselhamento jurídico e não utilize markdown.
Ver o JSON completo preservado
{
  "executive_summary": "O contrato estabelece uma meta de disponibilidade mensal de 99,5%, permite a retenção de conteúdo por 30 dias após a rescisão, autoriza mudanças de subprocessadores com aviso prévio de 15 dias e limita a responsabilidade ao valor de seis meses de taxas. Os principais riscos incluem prazos vagos para a notificação de incidentes de segurança, taxas não reembolsáveis com alterações no preço de renovação, recursos limitados em caso de rescisão e restrições quanto à jurisdição de Nova York. Esses termos podem afetar a resiliência operacional, a privacidade, o controle de custos e o tratamento de disputas.',
  'riscos": [
    {
 "cláusula": 8,
 "gravidade": "alta",
 "problema": "A notificação de incidentes de segurança não tem prazo máximo, o que gera incerteza quanto à privacidade e à resposta operacional.",
      "ação_prática": "Estabelecer prazos internos para resposta a incidentes e solicitar compromissos mais claros de notificação por parte do fornecedor."
    },
    {
 "cláusula": 6,
 "gravidade": "alta",
 "problema": "A responsabilidade civil é limitada a seis meses de taxas, restringindo a indenização para a maioria dos incidentes.",
      "medida_prática": "Analisar a exposição financeira e considerar a transferência de risco ou controles operacionais."
    },
    {
 "cláusula": 2,
 "gravidade": "média",
 "problema": "O conteúdo do cliente pode permanecer com o fornecedor por 30 dias após o término do contrato, criando riscos à privacidade e à retenção de dados.",
      "medida_prática": "Planeje o tratamento dos dados após a rescisão e confirme os procedimentos de exclusão."
    },
    {
 "cláusula": 7,
 "gravidade": "média",
 "problema": "Todas as disputas devem ser apresentadas no Condado de Nova York, o que pode aumentar a carga jurídica e operacional.",
      "ação_prática": "Estabeleça um orçamento para o tratamento de disputas e avalie a logística do foro."
    }
  ],
  "informações_ausentes": [
    "O contrato não define o que constitui uma violação material para rescisão nos termos da cláusula 5.",
    "O contrato não especifica como os incidentes de segurança devem ser relatados nem o que significa "sem demora indevida" nos termos da cláusula 8.",
    "O contrato não indica se o conteúdo do cliente é excluído automaticamente após o período de retenção de 30 dias previsto na cláusula 2."
  ],
  "unsupported_claims": []
}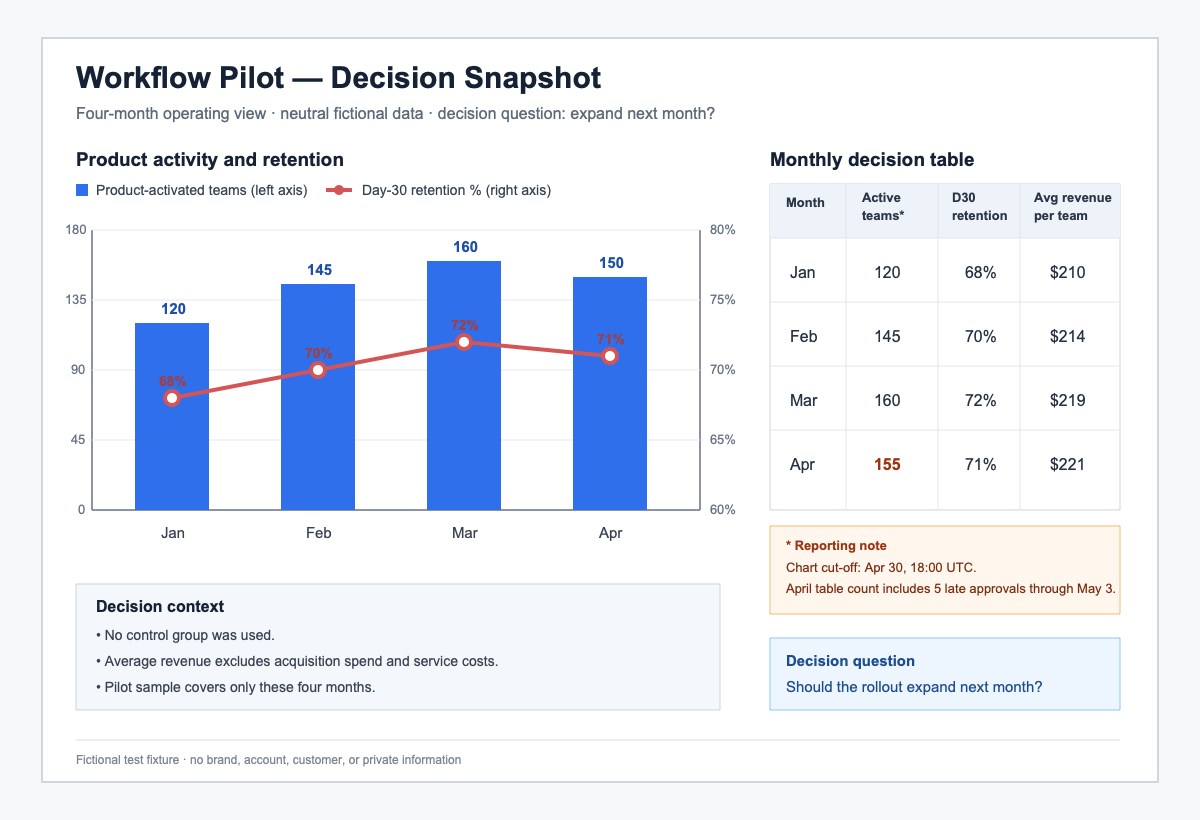
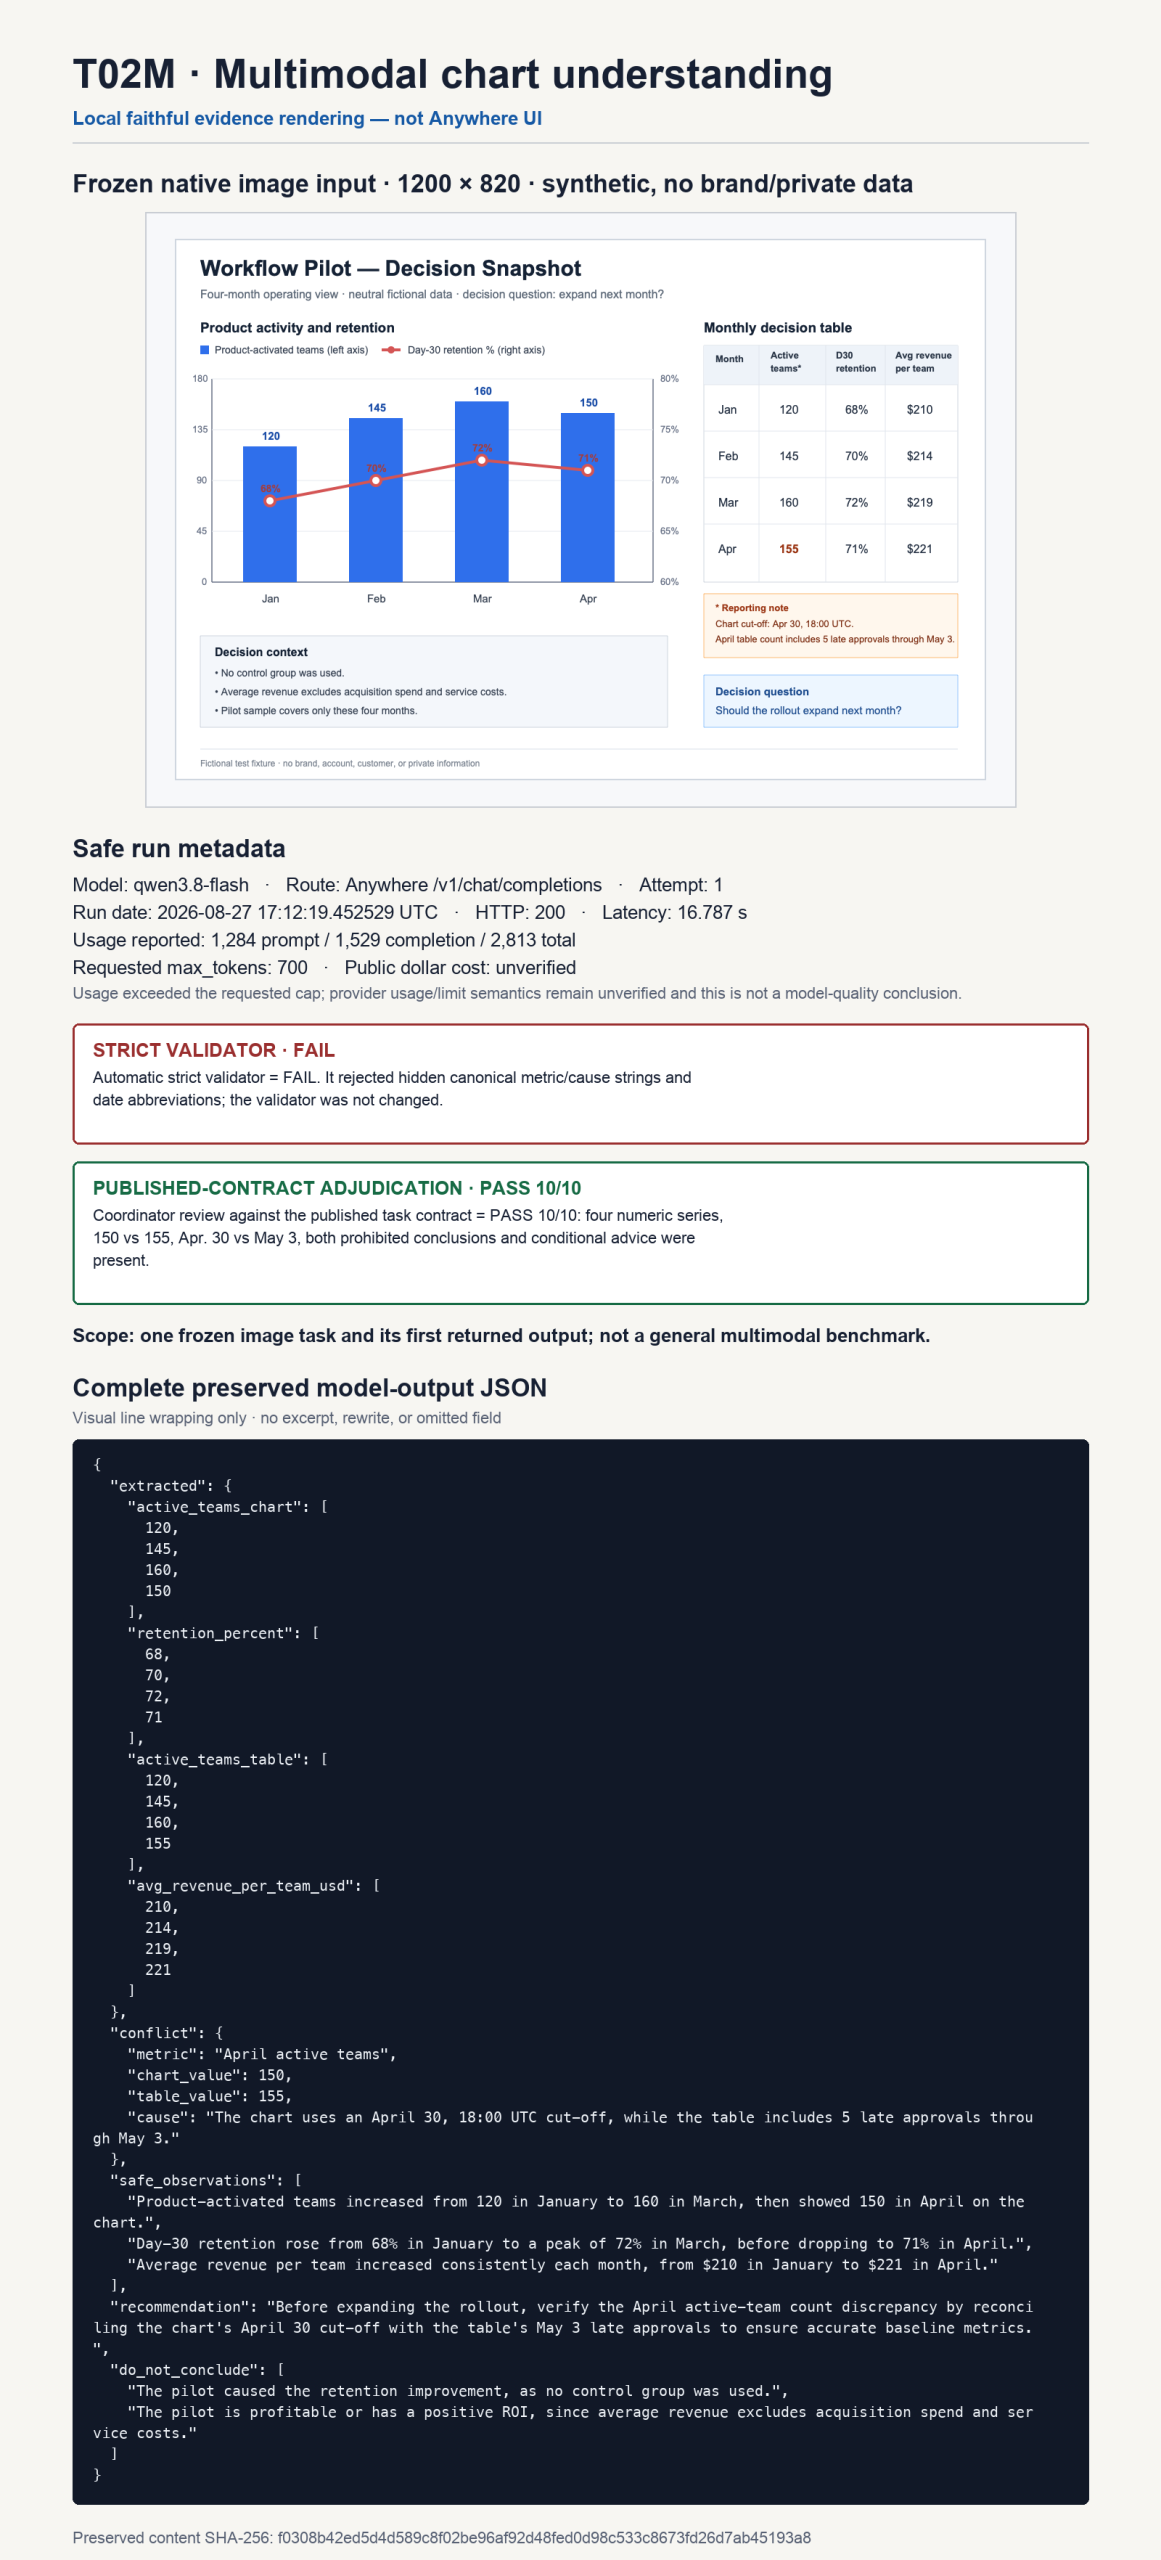
T02M · Extração de gráficos e julgamento empresarial dentro de limites
O órgão identificou todas as séries, o conflito relacionado ao limite de 150/155, e manteve a recomendação condicional.
Validador automático rigoroso: REPROVADO sobre preferências ocultas de string/data canônica. Análise do coordenador em relação ao contrato de tarefa publicado: APROVADO 10/10. O resultado estrito não é sobrescrito.
Ver o prompt exato
Utilize apenas a imagem anexada. Não acrescente informações externas. A imagem contém um gráfico de barras/linhas de quatro meses, uma tabela de decisão, uma nota de relatório e o contexto da decisão.

Retorne um objeto JSON válido com exatamente estas chaves de nível superior:
- extracted: objeto contendo exatamente active_teams_chart, retention_percent, active_teams_table, avg_revenue_per_team_usd; cada valor é uma matriz com exatamente quatro números na ordem: jan, fev, mar, abr
- conflict: objeto contendo exatamente metric, chart_value, table_value, cause
- safe_observations: matriz contendo exatamente 3 strings
- recommendation: string, com no máximo 60 palavras
- do_not_conclude: matriz contendo exatamente 2 strings

Requisitos:
1. Transcreva todas as séries numéricas exatamente como mostradas.
2. Identifique o conflito de equipes ativas em abril e explique os dois limites de corte do relatório.
3. Mantenha as observações descritivas e fundamentadas na imagem.
4. A recomendação deve indicar o que deve ser verificado antes de expandir a implementação.
5. Os dois itens “não concluir” devem abordar a melhoria causal na retenção e a lucratividade/ROI.
6. Gerar apenas JSON, sem markdown. Mantenha a resposta completa dentro de 700 tokens de saída.
Ver o JSON completo preservado
{
  "extracted": {
    "active_teams_chart": [
 120,
 145,
 160,
 150
    ],
    "retention_percent": [
 68,
 70,
 72,
 71
    ],
    "active_teams_table": [
 120,
 145,
 160,
 155
    ],
    "receita_média_por_equipe_usd": [
 210,
 214,
 219,
 221
    ]
  },
  "conflict": {
    "metric": "Equipes ativas em abril",
    "valor_do_gráfico": 150,
    "valor_da_tabela": 155,
    "causa": "O gráfico usa como data de corte 30 de abril, às 18h UTC, enquanto a tabela inclui 5 aprovações tardias até 3 de maio."
  },
  "observações_seguras": [
    "As equipes ativadas pelo produto aumentaram de 120 em janeiro para 160 em março, mas apareceram como 150 em abril no gráfico.",
    "A retenção no 30º dia subiu de 68% em janeiro para um pico de 72% em março, antes de cair para 71% em abril.",
    "A receita média por equipe aumentou consistentemente a cada mês, passando de $210 em janeiro para $221 em abril."
  ],
  "recomendação": "Antes de expandir a implementação, verifique a discrepância no número de equipes ativas de abril, conciliando a data de corte de 30 de abril do gráfico com as aprovações tardias de 3 de maio da tabela, para garantir a precisão das métricas de referência.",
  "não_concluir": [
    "O projeto-piloto causou a melhoria na retenção, já que nenhum grupo de controle foi utilizado.",
    "O projeto-piloto é lucrativo ou apresenta um ROI positivo, uma vez que a receita média exclui os gastos com aquisição e os custos de serviço."
  ]
}
Pacote de entrada: 3 arquivos sintéticos · 15 páginas lógicas · 60 IDs de parágrafo endereçáveis
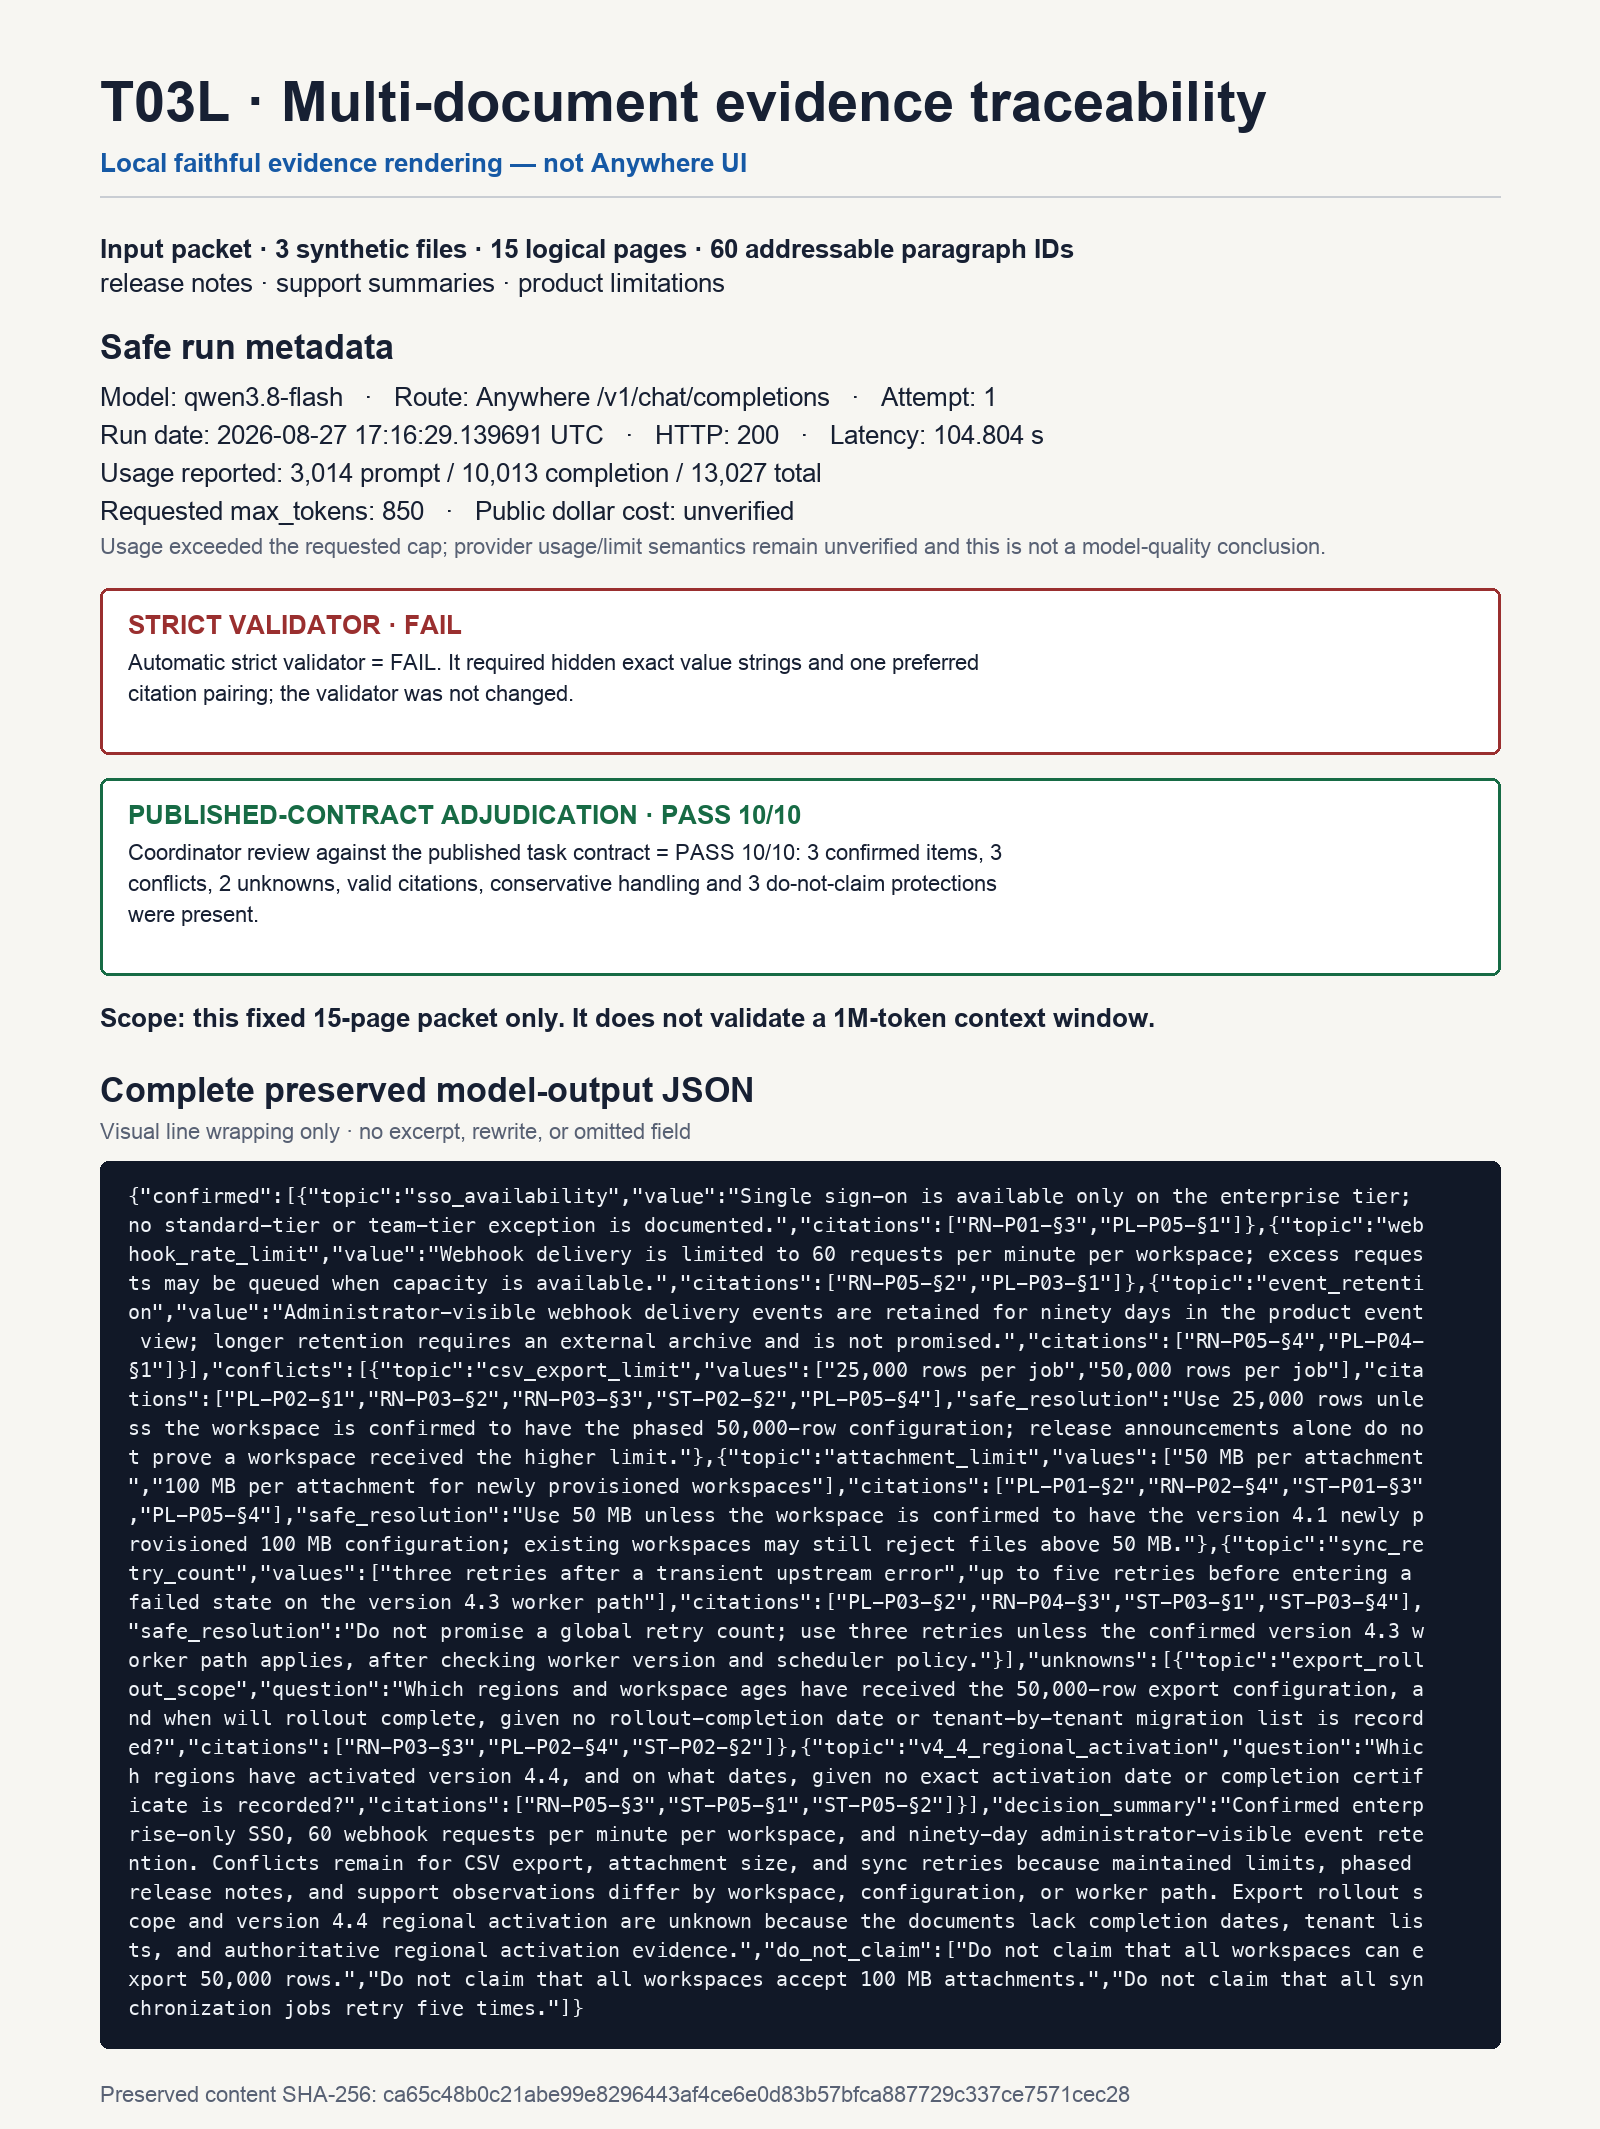
T03L · Rastreabilidade de múltiplos documentos e síntese de conflitos
Ela preservou fatos confirmados, conflitos e incógnitas; não analisa o contexto do 1M.
Validador automático rigoroso: REPROVADO sobre preferências ocultas relativas a sequências exatas e citações. Análise do coordenador em relação ao contrato de tarefa publicado: APROVADO 10/10. Ambos os status permanecem visíveis.
Ver o prompt exato
Utilize apenas os três documentos sintéticos anexados após este prompt. Toda afirmação factual deve ser rastreável até os IDs dos parágrafos fornecidos. Não resolva um conflito escolhendo o valor mais recente, maior ou mais favorável, a menos que os documentos justifiquem explicitamente essa escolha.

Retorne um objeto JSON válido com exatamente estas chaves de nível superior:
- confirmed: matriz contendo exatamente 3 objetos com os campos topic, value e citations
- conflicts: matriz contendo exatamente 3 objetos com os campos topic, values, citations e safe_resolution
- unknowns: matriz contendo exatamente 2 objetos com os campos topic, question e citations
- decision_summary: string, com no máximo 100 palavras
- do_not_claim: matriz com exatamente 3 strings

Utilize exatamente estes nomes de tópicos:
- confirmed: sso_availability, webhook_rate_limit, event_retention
- conflicts: csv_export_limit, attachment_limit, sync_retry_count
- incógnitas: export_rollout_scope, v4_4_regional_activation

Regras de citação:
1. Cada citação deve reproduzir exatamente o ID de um parágrafo real.
2. Cada item confirmado precisa de pelo menos duas citações de apoio provenientes de documentos diferentes.
3. Cada conflito deve preservar ambos os valores incompatíveis e citar todos os lados necessários.
4. Os itens desconhecidos devem permanecer desconhecidos; indique quais evidências estão faltando.
5. O comando `do_not_claim` deve bloquear afirmações genéricas sobre exportações de 50.000 linhas, anexos de 100 MB e cinco tentativas de replicação.
6. Gerar apenas JSON, sem markdown. Manter a resposta completa dentro de 850 tokens de saída.

Não afirme que esta tarefa valida qualquer janela de contexto máxima. Ela mede a rastreabilidade apenas neste pacote fixo de comprimento médio.
Ver o JSON completo preservado
{"confirmed":[{"topic":"sso_availability","value":"O login único está disponível apenas no plano Enterprise; não há nenhuma exceção documentada para os planos Standard ou Team.","citations":["RN-P01-§3","PL-P05-§1"]},{"topic":"webhook_rate_limit","value":"A entrega de webhooks é limitada a 60 solicitações por minuto por espaço de trabalho; solicitações excedentes podem ser enfileiradas quando houver capacidade disponível.","citations":["RN-P05-§2","PL-P03-§1"]},{"topic":"event_retention","value":"Os eventos de entrega de webhooks visíveis ao administrador são retidos por noventa dias na visualização de eventos do produto; uma retenção mais longa requer um arquivo externo e não é garantida.","citations":["RN-P05-§4","PL-P04-§1"]}],"conflicts":[{"topic":"csv_export_limit","values":["25.000 linhas por tarefa","50.000 linhas por tarefa"],"citations":["PL-P02-§1","RN-P03-§2","RN-P03-§3","ST-P02-§2","PL-P05-§4"],"resolução_segura":"Utilize 25.000 linhas, a menos que se confirme que o espaço de trabalho possui a configuração gradual de 50.000 linhas; os anúncios de lançamento, por si só, não comprovam que um espaço de trabalho tenha recebido o limite mais alto."},{"tópico":"limite_de_anexos","valores":["50 MB por anexo","100 MB por anexo para espaços de trabalho recém-provisionados"],"referências":["PL-P01-§2","RN-P02-§4","ST-P01-§3","PL-P05-§4"],"safe_resolution":"Use 50 MB, a menos que se confirme que o espaço de trabalho possui a configuração de 100 MB para novos espaços de trabalho provisionados na versão 4.1; os espaços de trabalho existentes ainda podem rejeitar arquivos com mais de 50 MB."},{"topic":"sync_retry_count","values":["três tentativas após um erro transitório no upstream","até cinco tentativas antes de entrar em estado de falha no caminho do worker da versão 4.3"],"citations":["PL-P03-§2","RN-P04-§3","ST-P03-§1","ST-P03-§4"],"safe_resolution":"Não prometa um número global de tentativas; use três tentativas, a menos que o caminho do trabalhador da versão 4.3 confirmado se aplique, após verificar a versão do trabalhador e a política do agendador."}],"unknowns":[{"topic":"export_rollout_scope","question":"Quais regiões e idades de espaços de trabalho receberam a configuração de exportação de 50.000 linhas, e quando a implantação será concluída, considerando que não há data de conclusão da implantação nem lista de migração por locatário registrada?","citations":["RN-P03-§3","PL-P02-§4","ST-P02-§2"]},{"topic":"v4_4_regional_activation","question":"Quais regiões ativaram a versão 4.4 e em quais datas, considerando que não há registro de data exata de ativação nem certificado de conclusão?","citations":["RN-P05-§3","ST-P05-§1","ST-P05-§2"]}],"resumo_da_decisão":"Confirmado o SSO exclusivo para empresas, 60 solicitações de webhook por minuto por espaço de trabalho e retenção de eventos visível ao administrador por noventa dias. Ainda há conflitos em relação à exportação em CSV, ao tamanho de anexos e às tentativas de sincronização, pois os limites mantidos, as notas de lançamento em fases e as observações de suporte variam de acordo com o espaço de trabalho, a configuração ou o caminho do usuário. O escopo da implementação da exportação e a ativação regional da versão 4.4 são desconhecidos, pois os documentos não contêm datas de conclusão, listas de locatários e evidências oficiais da ativação regional.","do_not_claim":["Não afirme que todos os espaços de trabalho podem exportar 50.000 linhas.","Não afirme que todos os espaços de trabalho aceitam anexos de 100 MB.","Não afirme que todas as tarefas de sincronização tentam novamente cinco vezes."]}O T01 foi aprovado pelo validador. O T02M e o T03L foram aprovados em seus contratos publicados, mas não passaram nas verificações mais rigorosas de preferências de representação ocultas. O uso relatado de conclusão excedeu todos os limites solicitados; portanto, a contabilização da rota permanece sem solução.
Pontos fortes, limites e considerações práticas
Onde o argumento é mais convincente
- Taxas básicas oficiais baixas para fluxos de trabalho com grande volume de texto.
- Uma janela de contexto ampla e com lista para trabalhar com documentos e código-fonte.
- Envio de texto, imagens e vídeos no serviço oficial.
- Saída estruturada, ferramentas, armazenamento em cache e recursos de processamento em lote na rota Qwen documentada.
- Uma opção do Flash-Next sem restrições de peso para equipes capazes de operar sua própria infraestrutura.
Onde ainda é preciso ter cautela
- Não foi verificada a cobertura de benchmarks independentes para o Flash de produção exato.
- Os resultados dos fornecedores do Flash-Next devem manter exatamente o mesmo rótulo e a nota sobre a metodologia.
- As rotas de terceiros podem apresentar limites, ferramentas e sistemas de contabilização de uso diferentes.
- O mapeamento exato do plano Flash GlobalGPT para Qwen3.8 ainda está pendente.
- Três pequenas tarefas iniciais não garantem confiabilidade, desempenho em condições reais nem segurança na produção.
Uma sequência prática de avaliação
Comece com uma tarefa recorrente, em vez de um amplo “concurso de beleza”. Defina os dados de entrada, os critérios de sucesso e o formato de saída antes da primeira execução. Para um fluxo de trabalho de documentos, exija referências bibliográficas e uma lista de questões não resolvidas. Para código, use testes executáveis. Para análise visual, inclua pelo menos um conflito ou ambiguidade deliberada, de modo que o modelo tenha que fazer mais do que apenas transcrever rótulos.
Em seguida, teste a rota e também o modelo. Registre o ID exato, a latência, o uso, as ferramentas disponíveis e quaisquer limites de arquivos. Uma plataforma hospedada pode oferecer recursos úteis de pesquisa, armazenamento ou colaboração, mas também pode alterar a contabilidade de tokens e os limites máximos de saída. É por isso que a anomalia no limite de uso em nossas execuções do Anywhere se enquadra nas limitações da rota, e não em uma afirmação sobre a inteligência do Qwen.
Por fim, repita o processo somente após as evidências da primeira saída terem sido preservadas. Um estudo de estabilidade deve apresentar todas as execuções, tipos de falha e variação; ele nunca deve substituir um primeiro resultado fraco pela amostra mais atraente. Esta revisão não realizou um lote de estabilidade, portanto, a confiabilidade continua sendo uma questão em aberto para a produção.
Utilize o Qwen3.8 Flash quando o preço, o contexto e os dados multimodais justificarem um teste controlado. Evite a migração para produção se precisar de uma classificação de desempenho estabelecida de forma independente, de certeza quanto ao faturamento por rota ou de um recurso que ainda não tenha sido confirmado na plataforma escolhida.
Qual rota de acesso você deve escolher?
| Sua prioridade | Melhor rota inicial | Por que |
|---|---|---|
| Controles da API nativa e faturamento por token | Qwen Cloud | Documentação oficial, tarifas básicas e características do serviço |
| Uma assinatura para várias modelos de chat | GlobalGPT | Troca mais simples entre modelos interativos; plataforma independente |
| Hospedagem própria e controle do nível de peso | Flash-Next | Artefato de peso aberto, com responsabilidade pela infraestrutura |
| Reproduzindo as recomendações desta resenha | Em qualquer lugar | Apenas rota testada; semântica não resolvida entre “dollar” e “cap” no domínio público |
Uma regra de rota simples
- Precisa de controles de API nativos? Comece com o Qwen Cloud.
- Precisa de um único espaço de trabalho para vários modelos? Considere o GlobalGPT, ao mesmo tempo em que confirma o acesso ao plano atual.
- Precisa de pesos que você mesmo possa levantar? Avaliar o Flash-Next e definir o orçamento para a infraestrutura.
- Precisa de testes reproduzíveis? Anote o caminho exato, pois os limites e as ferramentas da plataforma podem variar.
Se você estiver em dúvida entre um modelo mais rápido e com boa relação custo-benefício e um modelo top de linha da mesma linha, leia o Análise do Qwen3.8 Max. Para uma lista de opções mais abrangente entre os fornecedores, consulte nosso guia sobre o os melhores modelos de IA para tarefas do mundo real.
Perguntas frequentes
O Qwen3.8 Flash é o mesmo que o Qwen3.8 Flash-Next?
O nº Qwen descreve o Qwen3.8 Flash como a versão de produção gerenciada, baseada no artefato Qwen3.8-Flash-Next de peso aberto. Mantenha os nomes separados ao discutir pesos, ferramentas ou benchmarks.
Quanto custa a API Flash Qwen3.8?
A Qwen Cloud divulgou, em 27 de agosto de 2026, as taxas básicas de $0,15 por milhão de tokens de entrada e $0,47 por milhão de tokens de saída. As taxas relacionadas a cache, ferramentas e plataformas de terceiros podem seguir uma estrutura de preços diferente.
O Qwen3.8 Flash suporta imagens e vídeos?
Sim. A página oficial do Qwen Cloud indica a entrada de texto, imagem e vídeo, com saída de texto. O manuseio de arquivos e os limites da interface do usuário podem variar de acordo com a rota.
O que é a janela de contexto do Flash Qwen3.8?
O Qwen Cloud apresenta uma janela de contexto de 1 milhão de tokens, com limites máximos de entrada e saída específicos para cada rota. O teste de 15 páginas desta análise não avalia o desempenho com o contexto máximo.
Onde posso testar o Qwen3.8 Flash?
O Qwen Cloud é a rota oficial da API. O GlobalGPT oferece um espaço de trabalho multimodelo independente; abrir GlobalGPT e confirme o acesso ao modelo atual do seu plano. O “Anywhere” foi utilizado apenas como a rota da API testada para esta análise.
Conclusão
O Qwen3.8 Flash apresenta uma combinação documentada bastante atraente: baixas taxas básicas de tokens, uma lista de contexto de 1 milhão, entrada multimodal e um amplo conjunto de recursos de produção. A conclusão responsável não é que ele seja universalmente o melhor. As evidências independentes para o modelo gerenciado exato ainda são escassas, o comportamento das rotas de terceiros varia e as evidências práticas aqui apresentadas abrangem apenas três primeiras saídas delimitadas.
Para desenvolvedores, o Qwen Cloud é o ponto de partida mais simples. Para quem deseja comparar vários modelos de chat sem precisar gerenciar APIs separadas, o GlobalGPT é a opção prática e independente — após confirmar o acesso ao plano ativo. De qualquer forma, teste um prompt com uma regra de aceitação que você possa verificar.
Teste a decisão, não o nome do modelo
Use uma solicitação do seu fluxo de trabalho real, mantenha os critérios de entrada e de aceitação fixos e compare o resultado com o modelo que você já utiliza.
Teste sua instrução no GlobalGPT