O DeepSeek V4.1 Flash é a versão lançada pela DeepSeek em 10 de setembro de 2026, que traz entrada nativa de imagens, menor ocupação de cache, pontuações mais altas dos agentes relatadas pelos fornecedores e taxas de API mais baixas. É mais adequado para desenvolvedores que executam agentes com grande volume de trabalho ou que exigem muita entrada de dados. A principal ressalva: o DeepSeek executou os testes de desempenho publicados, e o V4 Pro ainda lidera em testes selecionados de raciocínio de ponta.

O que é o firmware DeepSeek V4.1?
O DeepSeek V4.1 Flash é um modelo multimodal de pesos abertos desenvolvido para codificação, uso de ferramentas, compreensão visual e fluxos de trabalho de agentes com contexto extenso. O DeepSeek lançou-o em 10 de setembro de 2026 e publica os pesos como DeepSeek-V4.1-Flash, e expõe o modelo hospedado por meio do deepseek-flash Nome da API.
O lançamento é importante porque traz mudanças que vão além dos resultados dos benchmarks. O Flash aceita texto e imagens, oferece uma janela de contexto de um milhão de tokens e reduz substancialmente a memória necessária para seu cache de chave-valor. O DeepSeek também reduziu suas tarifas de API hospedada em comparação com a tarifa V4 Pro, que está sendo descontinuada. Essa combinação visa resolver um gargalo prático: manter a viabilidade financeira de agentes de longa duração à medida que prompts, contexto do repositório, capturas de tela e histórico de ferramentas se acumulam.
deepseek-flashO modo de raciocínio está ativado por padrão, embora o modo sem raciocínio também esteja disponível. São oferecidos suporte à saída em JSON e a chamadas de ferramentas. O DeepSeek também oferece compatibilidade com as APIs Responses e Anthropic, o que reduz o trabalho de migração para aplicativos já estruturados em torno dessas interfaces.
Quais são as novidades do DeepSeek V4.1 Flash?
Uma estrutura central 552B MoE com capacidade de computação assimétrica
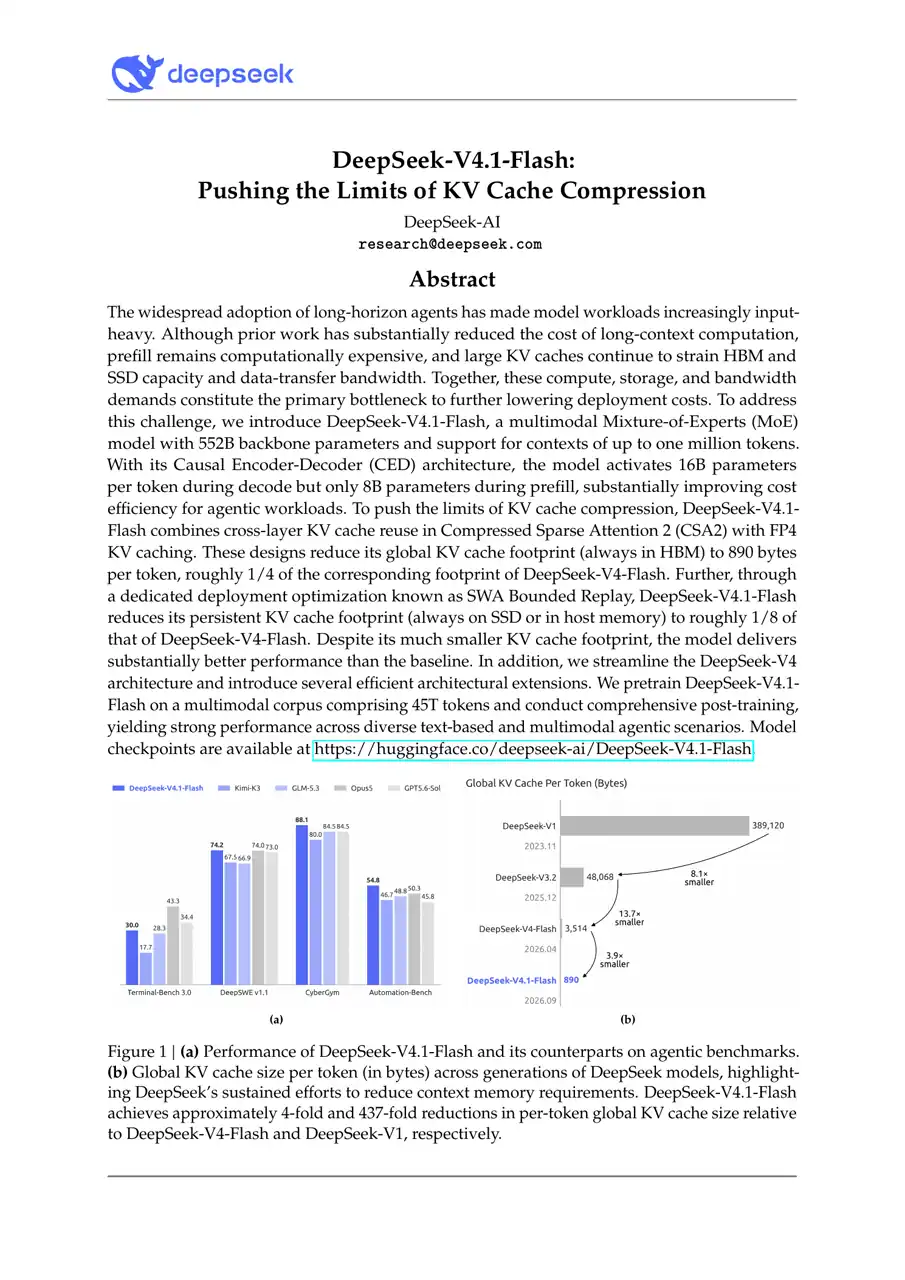
De acordo com o Relatório técnico do DeepSeek V4.1, o modelo utiliza uma estrutura base do tipo “mistura de especialistas” com 552 bilhões de parâmetros, composta por um codificador causal de 20 camadas e um decodificador de 20 camadas. A contagem total de parâmetros não corresponde à quantidade utilizada para cada token: o DeepSeek relata aproximadamente 8 bilhões de parâmetros ativos durante o pré-preenchimento e 16 bilhões durante a decodificação.
Esse design assimétrico atribui orçamentos de computação diferentes às etapas de pré-preenchimento e geração. O pré-preenchimento é a etapa que absorve o prompt, os documentos, as imagens e a conversa anterior; a decodificação produz a resposta, token por token. O menor consumo de computação ativa durante o pré-preenchimento é particularmente relevante para cargas de trabalho em escala de repositório e de agentes de pesquisa, que dedicam grande parte do tempo à leitura antes da gravação.
Um cache KV bem menor
O relatório indica um tamanho global do cache KV de 890 bytes por token, cerca de um quarto do cache do V4 Flash na memória de alta largura de banda. O DeepSeek afirma que a necessidade de cache persistente é de cerca de um oitavo da geração anterior. Para um contexto de um milhão de tokens, isso é uma característica de implantação, e não um detalhe abstrato de arquitetura: o tamanho do cache afeta quantas sessões longas um servidor pode manter e quanta memória cada uma delas consome.
Entrada de imagens nativas e pré-treinamento multimodal
A versão 4.1 do Flash aceita imagens de forma nativa, em vez de utilizar um endpoint separado da marca Vision. O DeepSeek afirma que o modelo foi pré-treinado em um corpus multimodal de 45 trilhões de tokens. Na prática, isso faz com que capturas de tela, gráficos, tabelas digitalizadas, estados de interface e entradas de depuração visual façam parte da mesma conversa do agente, assim como código e texto.
Um contexto de 1 milhão de tokens pode conter grandes repositórios, conjuntos de documentos extensos e um histórico amplo do agente, sujeito ao limite combinado de entrada e saída.
Arquivos nos formatos JPEG, PNG, GIF e WebP podem ser combinados com texto para extração de tabelas, análise de capturas de tela e resposta a perguntas visuais.
A chamada de ferramentas, a saída JSON estruturada e o treinamento orientado a agentes tornam o modelo adequado para fluxos de trabalho que precisam inspecionar, decidir e alterar o estado.
Tests de desempenho do DeepSeek V4.1: o que mostram os resultados oficiais
Os principais argumentos a favor do Flash V4.1 da DeepSeek concentram-se nos benchmarks de codificação e de agentes. O fornecedor avaliou o modelo de instruções com um esforço experimental de 100, divulgado publicamente como o esforço máximo de raciocínio, utilizando temperatura=1,0 e top_p=0,95. Os testes do agente de código utilizaram harnesses nomeados e um contexto de um milhão de tokens; os testes do agente visual utilizaram o Claude Code com um contexto de 512 mil tokens.
| Referência | V4.1 Flash | V4 Pro | V4 Flash | Líder |
|---|---|---|---|---|
| Codeforces classificação | 3471 | 3348 | 3289 | V4.1 Flash |
| Banco de terminais 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 resolvido | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Bancada de automação Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| Diamante GPQA Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE somente texto Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Fonte: Relatório técnico DeepSeek V4.1, Tabela 3. Quanto maior o valor, melhor, dentro de cada linha. O Codeforces é uma classificação; os demais valores exibidos utilizam as métricas nomeadas do relatório, expressas em porcentagem. Não compare as magnitudes entre as linhas.

Esse padrão é útil, mas mais restrito do que uma afirmação genérica de que se trata de um “modelo melhor”. O V4.1 Flash supera o V4 Pro nas cinco categorias de programação, terminais, segurança e automação mostradas acima. O V4 Pro continua à frente no GPQA Diamond e no subconjunto apenas de texto do “Humanity’s Last Exam”. Desenvolvedores que estejam comparando uma lista mais ampla de modelos de codificação podem usar nosso Guia sobre o melhor modelo de IA para programação, mas a avaliação no nível do aplicativo ainda é mais importante do que uma tabela.
O esforço de raciocínio também altera o custo e o resultado. No relatório da DeepSeek, aumentar o esforço experimental de 25 para 100 elevou o DeepSWE v1.1 de 66,0 para 74,2 e o Terminal-Bench 2.1 de 82,4 para 90,6, ao mesmo tempo em que consumiu aproximadamente 2,5 vezes mais tokens de saída. As oito configurações de agentes do relatório também produziram resultados significativamente diferentes a partir do mesmo ponto de verificação; portanto, a escolha da estrutura faz parte do sistema avaliado.
O DeepSeek afirma que a robustez diante de entradas extremas ainda não foi totalmente caracterizada. O relatório observa que erros na seleção do CSA2 e a reconstrução aproximada do estado por meio da atenção de janela deslizante podem reduzir a capacidade em casos-limite fora do conjunto de testes. Ele também reconhece uma lacuna remanescente no raciocínio de fronteira mais complexo e nas tarefas de casos-limite. Essas ressalvas devem ser consideradas ao analisar as pontuações principais.
Duas tarefas reproduzíveis para avaliar o Flash V4.1
As tarefas a seguir testam comportamentos concretos sem apresentar um prompt não executado como evidência. Utilize o prompt exato, mantenha as configurações do modelo e do esforço em seu registro e avalie a resposta com base nos critérios listados. Os resultados de uma execução devem ser relatados como uma observação datada, e não como um parâmetro de referência geral.
Preços do Flash DeepSeek V4.1
A tabela de preços da API DeepSeek utiliza duas faixas de preços, e todos os valores abaixo estão em dólares americanos por um milhão de tokens. Os períodos de pico são 01h00-04h00 UTC e 06h00-10h00 UTC, de segunda a sexta-feira. Nos demais horários, considera-se horário fora do pico. Entradas em cache, entradas fora do cache e saídas são cobradas a tarifas diferentes.
As menores tarifas para APIs hospedadas
- Entrada em cache
- $0.003
- Entrada não armazenada em cache
- $0.15
- Saída
- $0.60
Por 1 milhão de tokens; fora dos horários de pico nos dias úteis.
O dobro da tarifa fora do horário de pico
- Entrada em cache
- $0.006
- Entrada não armazenada em cache
- $0.30
- Saída
- $1.20
Por 1 milhão de tokens; das 01h00 às 04h00 e das 06h00 às 10h00 UTC, nos dias úteis.
Para dar um exemplo aritmético simples, uma solicitação fora do horário de pico com 800.000 tokens de entrada não armazenados em cache e 20.000 tokens de saída custaria cerca de $0.132: $0,12 para entrada mais $0,012 para saída. O mesmo número de contagens de tokens nas taxas de pico custaria cerca de $0,264. Esse cálculo é meramente ilustrativo, não uma fatura de carga de trabalho real; acertos de cache, novas tentativas, trocas de ferramentas e duração do raciocínio alteram o total.
A entrada em cache é cinquenta vezes mais econômica do que a entrada sem cache em ambas as tarifas, tornando os prefixos de prompt estáveis e o contexto reutilizável economicamente significativos. A tarifa da API pública do DeepSeek é independente do acesso e do faturamento do GlobalGPT. Não interprete esses preços de tokens como preços de assinatura ou de crédito do GlobalGPT.
API, visão e limites do DeepSeek V4.1
A API direta DeepSeek utiliza deepseek-flash. Os desenvolvedores podem acessar o endpoint padrão em https://api.deepseek.com, a API de respostas na mesma base ou a base compatível com Anthropic em https://api.deepseek.com/anthropic. As ferramentas de função são compatíveis com o Responses. O DeepSeek também documenta o aplicar_patch ferramenta personalizada; os tipos de ferramentas integradas do “Outras respostas” são ignorados, em vez de serem executados.
deepseek-flashAs predefinições de modo de pensamento estão ativadas; estão disponíveis as predefinições de esforço baixo, alto e máximo.
Escolha a camada de compatibilidade que corresponda ao aplicativo existente.
Mantenha a entrada e a saída totais dentro da janela de contexto de 1 milhão de tokens.
Formatos de imagens e regras de posicionamento
O DeepSeek aceita imagens nos formatos JPEG, PNG, GIF e WebP. Uma imagem embutida pode ter até 32 MiB, enquanto uma imagem em arquivo pode ter até 64 MiB. O limite compartilhado documentado permite até 600 imagens em uma única solicitação. Esse limite máximo não é uma recomendação: lotes grandes aumentam o tamanho do prompt, a latência e a dificuldade de rastrear qual imagem serviu de base para uma resposta.
Na API de respostas, o conteúdo das imagens deve constar nas mensagens dos usuários. Imagens inseridas em sistema ou assistente As mensagens retornam o código HTTP 400. A camada de compatibilidade não aceita arquivos gerais como itens de entrada; portanto, os aplicativos devem seguir os formatos de entrada de imagem documentados, em vez de presumir compatibilidade total com o recurso de respostas OpenAI.
Limites de contexto, saída e concorrência
O contexto máximo é de um milhão de tokens, e a saída máxima é de 384.000 tokens. A entrada e a saída, juntas, devem caber na janela de contexto. O Flash permite 2.500 conexões simultâneas por conta; solicitações que excedam esse limite de conta recebem o código de erro HTTP 429. O planejamento de capacidade deve, portanto, monitorar a ocupação das conexões ativas e o comportamento de repetição de tentativas.
DeepSeek V4.1 Flash x V4 Pro
O V4.1 Flash é a opção padrão mais prática para agentes de codificação de alto volume, entradas visuais e aplicações com contexto extenso. O V4 Pro continua sendo relevante como referência de raciocínio durante o curto período de transição, mas não oferece suporte à visão e apresenta menor capacidade de simultaneidade documentada. Nossa versão anterior Análise do DeepSeek V4 Pro aborda esse ponto de verificação de acordo com seus próprios critérios; seus resultados práticos não devem ser reclassificados como evidência da versão 4.1.
| Fator decisivo | V4.1 Flash | V4 Pro antes da mudança de roteamento |
|---|---|---|
| Melhor ajuste | Agentes, programação, entradas longas, visão computacional | Tarefas selecionadas de raciocínio de ponta |
| Entrada de imagem | Suportado | Não suportado |
| Concorrência/conta | 2.500 conexões | 500 conexões |
| Entrada fora do horário de pico não armazenada em cache | $0,15 / 1M | $0,66 / 1M |
| Produção fora do horário de pico | $0,60 / 1M | $1,98 / 1M |
| Modelo oficial de pontuação | Leads exibidos nas linhas de agente/codificação | Leads GPQA Diamond e HLE (somente texto) |
Os preços correspondem às tarifas da API DeepSeek, e não aos preços da GlobalGPT. As tarifas Pro se aplicam antes da mudança de roteamento anunciada para 14 de setembro.
Nas tarifas fora do horário de pico, a entrada não armazenada em cache do Flash é cerca de 77% mais barata do que a tarifa Pro listada, e a saída do Flash é cerca de 70% mais barata. Essas porcentagens são cálculos aritméticos com base na tabela oficial, e não economias medidas. A economia real depende da reutilização do cache, do comprimento da saída, das tentativas de repetição e se a carga de trabalho necessita dos resultados mais robustos do Pro nas linhas de raciocínio selecionadas.
A distinção mais urgente é de natureza operacional. O DeepSeek está mantendo o deepseek-v4-pro nome, ao mesmo tempo em que altera temporariamente o modelo subjacente. Um nome de API estável não garante um comportamento estável na saída. Preserve respostas representativas do V4 Pro, rastros de ferramentas, latência e casos de falha anteriores a 14 de setembro e, em seguida, execute o mesmo conjunto de testes de aceitação após as alterações de roteamento. Para a estrutura de comparação de pontos de verificação mais antiga, consulte DeepSeek V4 Pro x Flash.
O que dizem os desenvolvedores
As primeiras reações são positivas em relação à taxa de processamento, à eficiência do cache e às pontuações dos agentes, mas as evidências são inconsistentes. Alguns comentários referem-se a um ponto de avaliação preliminar, e não ao ponto de verificação final em produção, e alguns relatórios resumem demonstrações em vez de testes controlados. A discussão pública mais útil, portanto, é sobre onde realizar os testes, e não se um único número divulgado no dia do lançamento resolve a questão.
A análise de lançamento recomenda manter uma configuração de referência do V4 Pro e testar o modelo Flash lançado antes da mudança de roteamento prevista para 14 de setembro. Ela também ressalta que os ganhos variam de acordo com o benchmark, o framework e a configuração de esforço.
Leia a análiseAo resumir as demonstrações antecipadas do World of AI, a publicação destacou uma velocidade máxima observada de 427 tokens por segundo e observou um excesso de reflexão, além de um comportamento mais fraco na simulação física. Isso não constitui uma garantia oficial de velocidade.
Leia o artigo de préviaNo tópico de lançamento, o comentarista se opôs ao redirecionamento silencioso de fluxos de trabalho Pro validados para outro modelo e defendeu a definição de um período de descontinuação. Trata-se de uma opinião específica da comunidade, não de um consenso.
Abrir o comentárioO líder de testes de penetração de IA do Aikido relatou melhorias na taxa de recuperação em uma única execução, na taxa de recuperação “pass@3”, na precisão e na taxa de acertos em cache em um teste de desempenho de cibersegurança. Sua publicação menciona um endpoint de pré-visualização com prazo de validade, portanto, não serve como prova para o ponto de verificação final.
Visualizar o relatório de pré-visualizaçãoEssas reações apontam para três verificações que vale a pena realizar em qualquer implantação real: comparar a qualidade da saída com uma configuração de esforço fixa, observar se o raciocínio extenso aumenta o custo da saída e reexecutar os casos de regressão quando um alias altera o modelo por trás de um endpoint. A visualização prévia dos resultados de throughput e segurança pode orientar o projeto dos testes, mas não deve ser combinada com a Tabela 3 do DeepSeek como se provinham de um único benchmark controlado.
Como acessar o firmware DeepSeek V4.1
Existem três formas distintas de acesso. Escolha de acordo com o que você precisa: controle direto via API, pesos auto-hospedados ou um espaço de trabalho no navegador que facilite a troca de modelos. Os termos, os preços e a responsabilidade operacional variam de acordo com a forma de acesso escolhida.
API DeepSeek
Use o site oficial deepseek-flash modelo para integrações nativas, do tipo “Responses” ou compatíveis com Anthropic.
Categorias de peso aberto
Baixe o cartão do modelo e os pesos licenciados pelo MIT. Verifique a compatibilidade com o Serving Stack e os requisitos de infraestrutura antes de prosseguir.
Abrir o repositório de modelosGlobalGPT
Utilize a entrada dedicada do Flash V4.1 dentro de um espaço de trabalho multimodelo. A cobrança do GlobalGPT é separada da tarifa da API do DeepSeek.
Experimente o DeepSeek V4.1 Flash
A API direta é a opção mais clara quando você precisa de controles programáticos, contabilização de uso e acesso às interfaces documentadas do DeepSeek. Os pesos abertos são destinados a equipes capazes de validar o suporte à inferência e operar um modelo MoE de grande porte. O GlobalGPT é a opção mais simples para uso interativo e comparações dentro de um fluxo de trabalho com modelo de IA “tudo em um”.
A publicação oficial sobre o lançamento do DeepSeek afirma que a empresa trabalhará com a comunidade de código aberto no suporte à inferência e explorará mais opções de implantação. Considere isso como uma declaração do roteiro de desenvolvimento, e não como prova de que todas as pilhas de servidores locais já oferecem suporte eficiente ao V4.1 Flash.
Quem deve usar o firmware DeepSeek V4.1?
Priorize o V4.1 Flash quando o trabalho no terminal, a navegação no repositório, a automação, o uso de ferramentas e prompts longos forem predominantes. As pontuações oficiais do agente e as taxas de entrada mais baixas justificam a realização de um projeto-piloto específico para essa carga de trabalho.
A importação direta de imagens torna o Flash a opção mais prática em relação ao V4 Pro para capturas de tela, gráficos, tabelas e evidências de interface. Verifique a precisão da extração comparando-a com respostas conhecidas.
O V4 Pro lidera as linhas exibidas do GPQA Diamond e do HLE, que contêm apenas texto. Compare as instruções fixas e as configurações de esforço antes de substituir um fluxo de trabalho de raciocínio validado.
A licença MIT é permissiva, mas um backbone de 552B MoE não é um modelo local leve. Verifique o hardware, a estratégia de cache, a quantização e o suporte à entrega.
Para uma seleção mais ampla de modelos, o Comparação entre GPT-5.5 e DeepSeek V4 coloca o contexto de um milhão de tokens e a posição de preço ao lado de outra opção de fronteira. Equipes focadas no estilo de produção de código também podem consultar o Teste de código Python: DeepSeek vs ChatGPT. Esses artigos respondem a perguntas relacionadas; nenhum deles substitui o teste do endpoint exato do Flash V4.1 utilizado em produção.
Os usuários em geral que estão decidindo entre ecossistemas podem achar que o mais abrangente Comparação entre DeepSeek e ChatGPT mais útil do que uma análise no nível da arquitetura. O Flash V4.1 se mostra mais atraente quando suas vantagens específicas — entrada longa, compreensão de imagens, ferramentas e baixo custo por token — se encaixam em um fluxo de trabalho real.
Veredicto
Suas taxas de API mais baixas, contexto de 1 milhão, entrada nativa de imagens, limite de 2.500 conexões e os ganhos de desempenho dos agentes relatados pelo DeepSeek constituem fortes argumentos a favor de sua avaliação. Não se trata de um substituto universal para o Pro: o V4 Pro ainda lidera em determinadas linhas de raciocínio, as pontuações de esforço máximo implicam maior uso de tokens de saída e alterações no roteamento de endpoints podem afetar o comportamento validado.
Ativar o firmware DeepSeek V4.1 no GlobalGPTComece com um pequeno conjunto de testes de aceitação: uma tarefa representativa de codificação, uma tarefa de extração baseada em imagens, um caso de contexto extenso e um fluxo de trabalho de ferramentas. Defina a configuração de raciocínio, registre o percurso do modelo e compare os modos de falha, bem como a qualidade média. Isso leva a uma decisão que você pode defender sem considerar os benchmarks dos fornecedores ou as reações no dia do lançamento como garantia do desempenho da aplicação.
Perguntas frequentes
O que é o Flash DeepSeek V4.1?
O DeepSeek V4.1 Flash é um modelo multimodal de “mistura de especialistas” com pesos abertos, lançado em 10 de setembro de 2026. Ele suporta entrada de texto e imagem, saída de texto, uma janela de contexto de um milhão de tokens, modos de raciocínio e sem raciocínio, saída em JSON e chamadas de ferramentas.
Quanto custa a API Flash DeepSeek V4.1?
As tarifas da API DeepSeek fora do horário de pico são $0,003 por 1 milhão de tokens de entrada armazenados em cache, $0,15 por 1 milhão de tokens de entrada não armazenados em cache e $0,60 por 1 milhão de tokens de saída. As taxas de pico são $0,006, $0,30 e $1,20, respectivamente. Esses são os preços da API DeepSeek, e não os preços da API GlobalGPT.
Que nome de modelo de API devo usar para o Flash DeepSeek V4.1?
Uso deepseek-flash com a API oficial do DeepSeek. O DeepSeek também oferece suporte a chamadas da API de respostas em https://api.deepseek.com e chamadas compatíveis com Anthropic em https://api.deepseek.com/anthropic.
Quais são os limites de contexto, saída e concorrência?
O DeepSeek V4.1 Flash possui uma janela de contexto de um milhão de tokens e uma saída máxima de 384.000 tokens; a entrada e a saída devem caber dentro do contexto. O DeepSeek suporta 2.500 conexões simultâneas por conta, retornando o código HTTP 429 quando esse limite é ultrapassado.
O Flash DeepSeek V4.1 é melhor do que o V4 Pro?
Isso depende da tarefa. Na tabela elaborada pelo fornecedor do DeepSeek, o V4.1 Flash supera o V4 Pro nos parâmetros de referência exibidos para codificação, terminal, segurança e automação, enquanto o V4 Pro supera o GPQA Diamond e o HLE (somente texto). O Flash também custa menos, oferece suporte à visão computacional e permite mais conexões simultâneas.
O DeepSeek V4.1 Flash suporta imagens?
Sim. Ela aceita arquivos nos formatos JPEG, PNG, GIF e WebP e gera texto. A API DeepSeek documenta até 32 MiB para imagens embutidas, 64 MiB para imagens em arquivo e 600 imagens por solicitação, dentro dos limites compartilhados. As imagens da API de respostas devem ser inseridas nas mensagens do usuário.
Os pesos do Flash DeepSeek V4.1 estão disponíveis para download?
Sim. O DeepSeek publica os pesos do modelo DeepSeek-V4.1-Flash no Hugging Face sob a licença MIT. A licença permissiva não dispensa a necessidade de infraestrutura: as equipes ainda precisam de um software de servidor compatível e hardware suficiente para a estrutura MoE de 552 bilhões.
Posso usar o firmware DeepSeek V4.1 no GlobalGPT?
Sim. O GlobalGPT possui uma entrada dedicada no DeepSeek V4.1 Flash para uso em navegadores. Seu acesso e faturamento são independentes da tarifa da API direta do DeepSeek, e a disponibilidade da plataforma não verifica de forma independente os resultados de benchmark publicados pelo DeepSeek.