Comparação entre os modelos Claude: Haiku x Sonnet x Opus, e onde o Fable se encaixa
Ariette Wynn
Última atualização em 09/09/2026
Um guia prático para 2026 sobre como escolher com base na velocidade, no custo da API, no contexto, na complexidade da tarefa e no custo de uma resposta errada.
Para a maioria das tarefas cotidianas de redação, análise, programação e uso de ferramentas, comece com o Claude Sonnet 5. Escolha o Haiku 4.5 quando a baixa latência e o alto volume forem mais importantes do que lidar com casos extremos complexos. Escolha o Opus 5 quando a tarefa for complexa, difícil de verificar ou cujos erros possam acarretar custos elevados. O Fable 5.1 está acima do Opus como uma opção especializada para casos mais complexos, não como padrão.
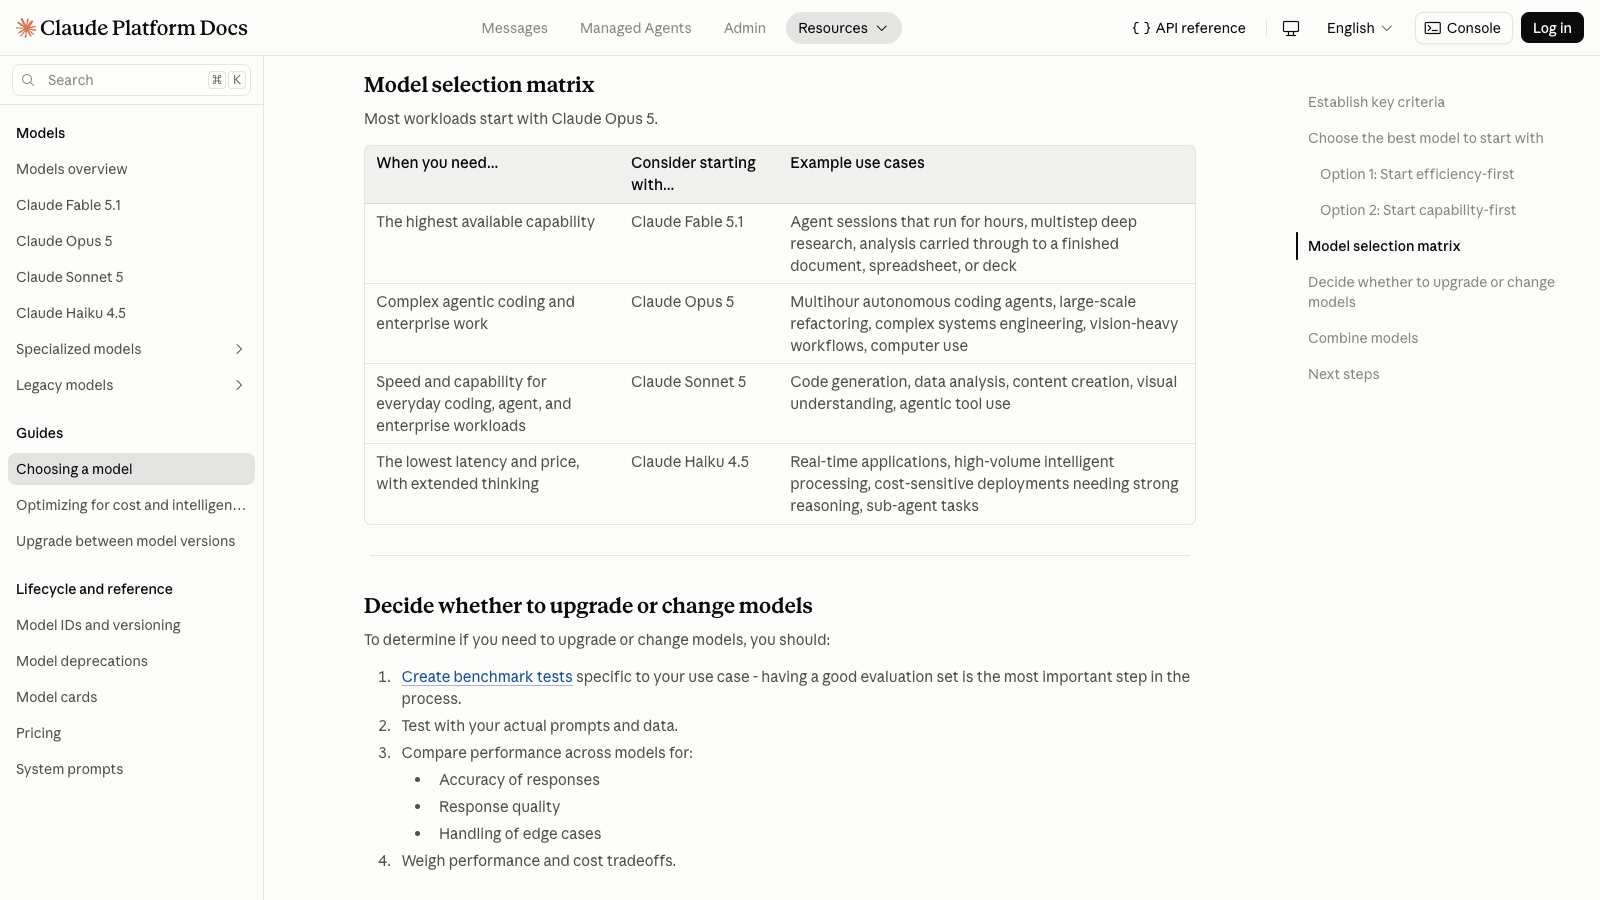
Essas recomendações se aplicam a cargas de trabalho mistas em geral. As orientações de produção do Anthropic indicam que a maioria das cargas de trabalho deve começar com o Opus 5, enquanto sua própria matriz de tarefas posiciona separadamente o Sonnet para trabalhos cotidianos que exigem velocidade e capacidade. O ponto de partida correto, portanto, depende da sua tolerância ao risco e do seu processo de avaliação, e não apenas do nome do modelo.
O GlobalGPT amplia o fluxo de trabalho Prático com uma assinatura acessível: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 e diversas funções de IA compartilham um único painel para pesquisa, redação, análise, programação e aperfeiçoamento. Sua interface de linha de comando (CLI) também permite integrar esse acesso aos modelos em seu terminal, fluxo de trabalho de desenvolvimento e ferramentas de produção existentes. Comparar resultados é uma parte útil do fluxo de trabalho; para uma visão mais ampla das opções disponíveis na família de produtos, consulte nosso Comparação entre ChatGPT, Claude e Gemini. O restante deste guia se concentra na escolha dentro da configuração Claude.
Os quatro níveis atuais resolvem diferentes problemas econômicos. A chamada mais barata nem sempre representa a tarefa concluída com menor custo, e o modelo mais robusto não significa automaticamente o melhor uso do orçamento.
Guia de decisão para o modelo Claude
Escolha com base na carga de trabalho e no custo de falha
Use o Sonnet para tarefas cotidianas equilibradas; opte por uma configuração mais simples quando for preciso priorizar a eficiência; e opte por uma configuração mais avançada quando a verificação for difícil ou os erros custarem caro.
Haiku 4.5
A eficiência em primeiro lugar
Comece por aqui para tarefas de alto volume, sensíveis à latência e com limites bem definidos, cujos erros sejam baratos de detectar e corrigir.
Avance quandoCasos extremos ou o tempo de correção dos revisores anulam a vantagem do preço do token.
Soneto 5
Equilíbrio no dia a dia
Utilize para trabalhos que combinem redação, análise, programação, compreensão visual e uso de ferramentas, os quais ainda serão avaliados normalmente.
Avance quandoO raciocínio de longo prazo, a verificação ou o custo da falha tornam-se o fator limitante.
Opus 5
A capacidade em primeiro lugar
Comece por aqui para lidar com codificação agentiva complexa, projetos empresariais, diagnósticos difíceis ou decisões cujos erros podem custar caro.
Desça quandoUm modelo mais barato é aprovado repetidamente nas mesmas verificações de aceitação.
Fable 5.1
Caminho de exceção
Recorra a essa escalada apenas em casos de raciocínio complexo ou tarefas de agente demoradas, quando o Opus, que exige maior esforço, ainda não atender às suas expectativas.
Não presumaUm plano superior fica automaticamente mais barato depois que a qualidade, o tempo de revisão e as tentativas são levados em conta.
A regra prática
Defina uma tarefa representativa e suas verificações de aceitação. Escolha o modelo de menor custo que seja aprovado de forma confiável e, em seguida, calcule o tempo de correção e verificação antes de considerá-lo a opção mais econômica.
A linha atual de modelos Claude
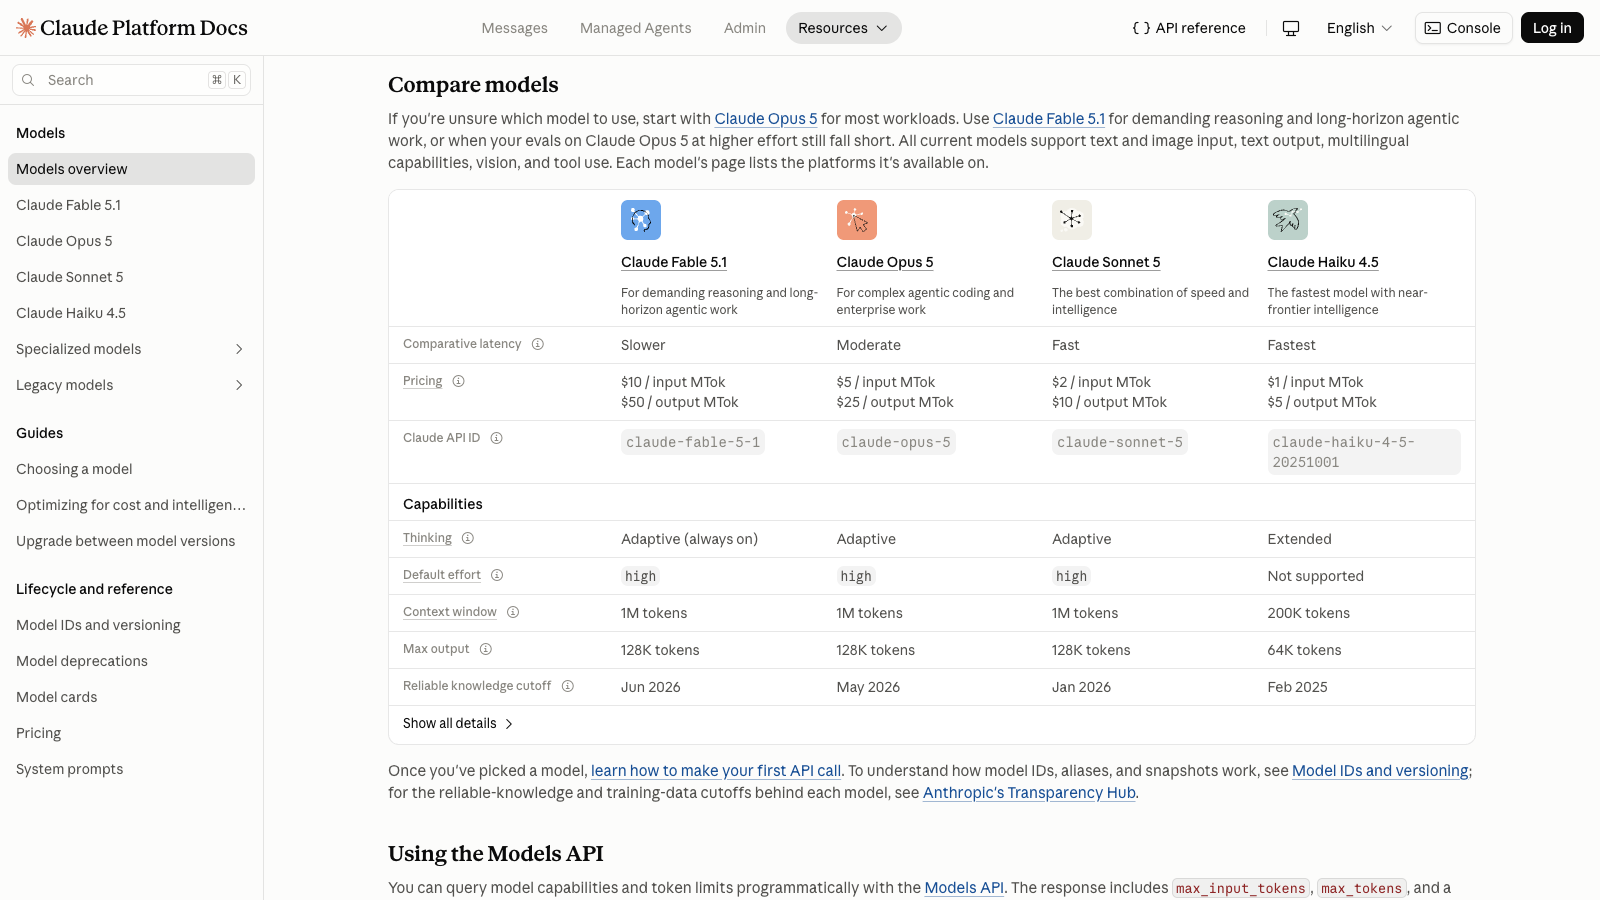
Em 8 de setembro de 2026, a linha ativa da Anthropic inclui Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 e Claude Fable 5.1. Haiku, Sonnet e Opus são nomes de famílias duradouros, mas a versão associada a cada família muda com o tempo. Salve o ID exato do modelo que você avaliou em produção, em vez de presumir que um nome de família sempre corresponderá ao mesmo instantâneo.
Modelo atual
Etiqueta oficial de velocidade
Contexto da API
Potência máxima
Entrada/saída da API básica
Haiku 4.5
Mais rápido
200 mil
64K
$1 / $5 por MTok
Soneto 5
Rápido
1M
128K
$2 / $10 por MTok
Opus 5
Moderado
1M
128K
$5 / $25 por MTok
Fable 5.1
Mais lento
1M
128K
$10 / $50 por MTok
A visão geral dos modelos da Anthropic lista o Haiku 4.5, o Sonnet 5, o Opus 5 e o Fable 5.1 como a linha atual em 8 de setembro de 2026.
O acesso ao Claude.ai não é o mesmo que as especificações da API
A tabela de planos do Claude.ai descreve o acesso para consumidores e, atualmente, indica uma janela de contexto de 200 mil para planos individuais. A documentação da API lista limites de contexto e de saída específicos para cada modelo, incluindo um contexto de 1 milhão para o Sonnet 5, o Opus 5 e o Fable 5.1. Não utilize a tabela da API para inferir o que um determinado plano Claude.ai inclui, nem utilize a tabela de planos do consumidor para inferir os limites de um modelo da API. Consulte o Guia de preços e planos do Claude para a distinção no nível do plano.
Claude Haiku x Sonnet x Opus: Principais diferenças
A principal escolha a ser feita não se resume a uma simples classificação de qualidade. Subir na lista proporciona maior capacidade para trabalhos complexos, mas também aumenta o custo básico em tokens e, em geral, reduz a velocidade. Os limites de contexto e os controles de raciocínio também variam.
As escolhas práticas
Etiquetas oficiais e especificações básicas da API, combinadas com pontos de partida práticos para cargas de trabalho comuns.
Dimensão
Haiku 4.5
Soneto 5
Opus 5
O melhor ponto de partida
Trabalho rápido, repetitivo e limitado
Trabalho intelectual misto do dia a dia
Trabalho complexo e de grande impacto
Etiqueta oficial de velocidade
Mais rápido
Rápido
Moderado
Contexto/saída da API
200 mil / 64 mil
1M / 128K
1M / 128K
Controle do raciocínio
Raciocínio manual ampliado
Pensamento adaptativo e esforço
Pensamento adaptativo e esforço
Preço base da API
$1 de entrada / $5 de saída
$2 de entrada / $10 de saída
Entrada $5 / saída $25
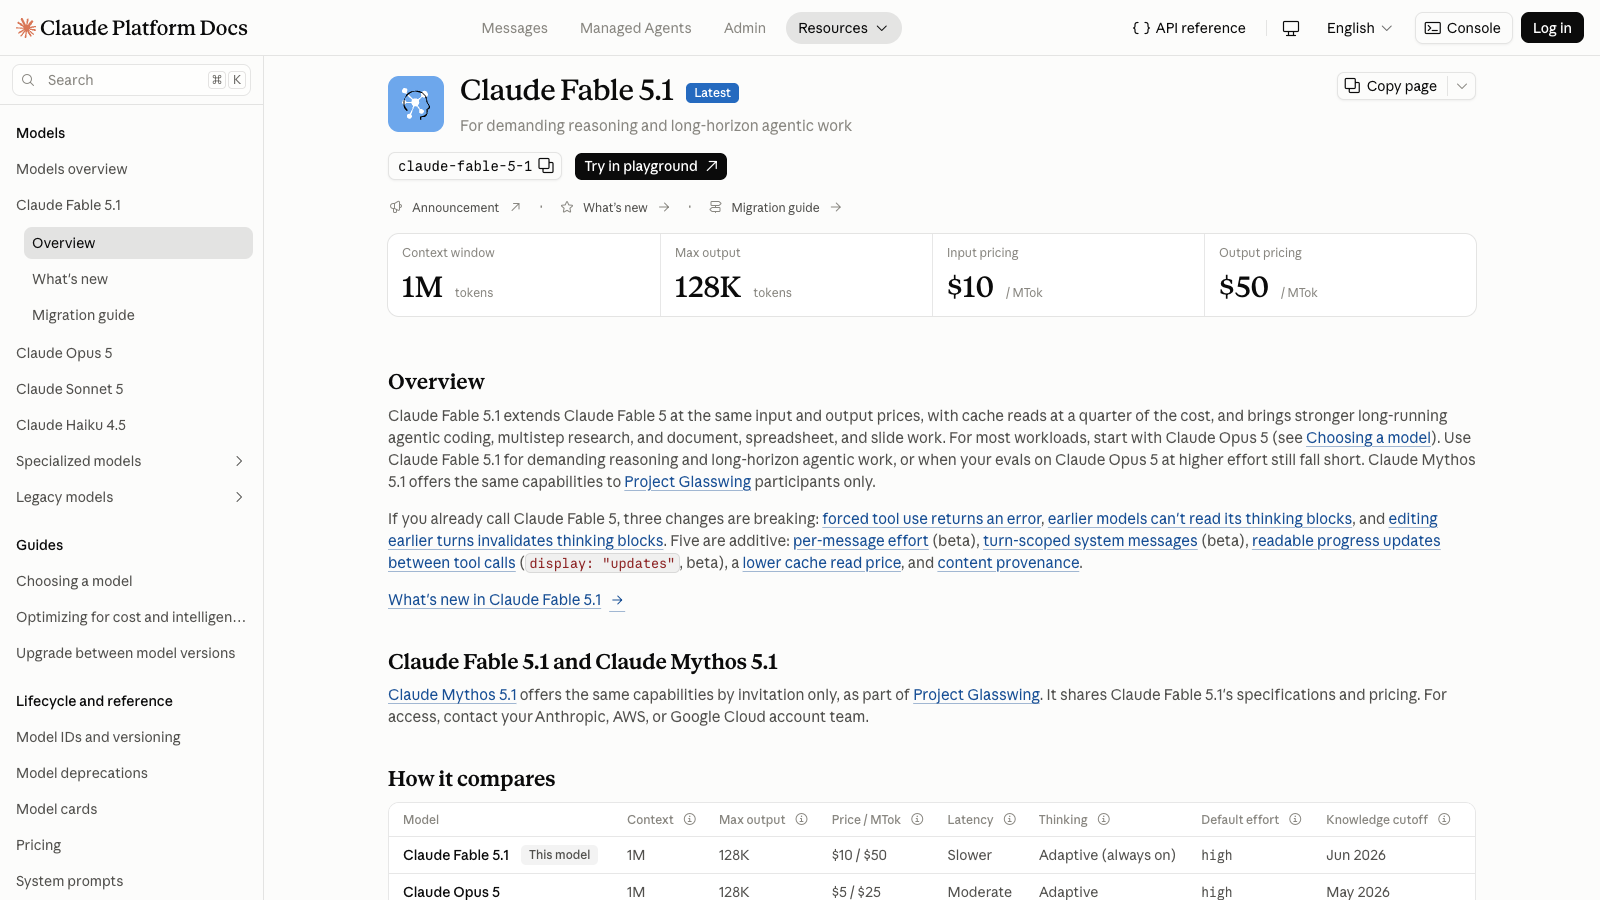
Onde o Fable se encaixa: O Fable 5.1 é oficialmente classificado como “Mais lento”, com contexto de 1M, saída máxima de 128K e preços básicos de entrada/saída de $10 / $50 por milhão de tokens. Considere-o como um nível de escalonamento quando o Opus, mesmo com maior esforço, ainda não atender às suas expectativas.
Velocidade e latência
As classificações Anthropic atribuem ao Haiku 4.5 o título de “Mais rápido”, ao Sonnet 5 o de “Rápido”, ao Opus 5 o de “Moderado” e ao Fable 5.1 o de “Mais lento”. Essas são classificações qualitativas dos produtos, não valores medidos em milissegundos ou tokens por segundo. A latência real depende do tamanho da solicitação, das configurações de raciocínio, das ferramentas, da carga e do modo de atendimento.
Controles de contexto, saída e raciocínio
O contexto de API menor do Haiku, de 200K, e a saída máxima de 64K ainda são substanciais para muitas tarefas limitadas. O Sonnet e o Opus ampliam ambos os limites para 1 milhão e 128 mil. O Haiku 4.5 utiliza raciocínio estendido manual, enquanto o Sonnet 5 e o Opus 5 oferecem suporte a raciocínio adaptativo e controle de esforço. Essa diferença é uma das razões pelas quais uma única configuração de raciocínio idêntica não consegue criar testes perfeitamente equivalentes em todos os modelos.
Qual modelo Claude você deve usar para cada tarefa?
Carga de trabalho
Comece com
Por que
Faça o upgrade quando
Classificação, extração, encaminhamento, triagem de atendimento
Haiku 4.5
A baixa latência e o baixo custo básico do token são ideais para tarefas claras e repetíveis.
Casos extremos ou o tempo de correção anulam a economia.
Redação, análise, compreensão visual, programação no dia a dia
Soneto 5
Equilíbrio entre velocidade, capacidade, contexto e custo para trabalhos mistos.
O raciocínio ou a verificação de longo prazo passa a ser o gargalo.
A capacidade é mais importante do que o menor preço por token.
Mesmo com um esforço maior, o Opus ainda não consegue passar por uma avaliação representativa e exigente.
Trabalhos excepcionais de longa duração ou que exijam muito raciocínio
Fable 5.1
É a trajetória de escalonamento atual acima do Opus.
Utilize-o somente quando o benefício mensurável justifique seu custo mais elevado.
Esses são pontos de partida, não soluções universais. Por exemplo, uma alteração de código curta, mas de alto risco, pode justificar o uso do Opus, enquanto um trabalho de extração longo, mas altamente estruturado, ainda pode ser adequado para o Haiku. Para exemplos práticos de fluxo de trabalho, consulte nosso guia sobre utilizando Claude para codificação.
Quando sua lista de finalistas vai além do Claude, o GlobalGPT permite que você execute o mesmo prompt representativo no Claude, no GPT-5.6 Sol, no Gemini 3 Pro e no Kimi K3 em um único espaço de trabalho. Mantenha a verificação de aceitação constante: a velocidade é importante para trabalhos repetitivos, enquanto a qualidade das respostas e o tempo de correção determinam se um resultado de menor custo é, de fato, mais barato.
Escolha com base no custo do fracasso, e não apenas no tipo de tarefa
Os rótulos das tarefas ocultam a variável mais importante: o que acontece quando a resposta está errada? O quadro a seguir é uma ferramenta de decisão editorial baseada nas orientações do Anthropic de “eficiência em primeiro lugar” e “capacidade em primeiro lugar”. Não se trata de um parâmetro de referência do Anthropic.
Escala de custos de falha
Comece com um nível mais baixo quando for barato detectar erros; comece com um nível mais alto quando a verificação for incompleta ou dispendiosa.
Baixo custo
Exemplos Etiquetagem, roteamento, limpeza de rascunhos, resumos reversíveis
Início Haiku 4.5
Escalar Quando o tempo de correção anula o ganho de eficiência
Material
Exemplos Rascunhos destinados aos clientes, análises revisadas, código de produção testado
Início Soneto 5
Escalar Quando a revisão não consegue identificar falhas importantes de maneira confiável
Caro
Exemplos Mudanças com alto grau de autonomia, diagnóstico complexo, decisões de grande impacto
Início Opus 5
Escalar Para o Fable somente após o Opus, de maior esforço, falhar em uma avaliação congelada
Quando fazer um upgrade ou um downgrade do seu modelo Claude
Avance apenas quando aparecer um limite medido
Do haicai ao soneto
Faça a atualização quando casos extremos, falhas nas instruções ou o tempo de correção do revisor excederem a economia obtida.
Soneto à Opus
Faça a atualização quando a execução em horizonte de longo prazo, o raciocínio complexo, a verificação ou o custo de falha se tornarem restrições.
Opus com maior esforço
Teste a carga de trabalho exigente com verificações de aceitação congeladas antes de passar para a camada superior.
De “Opus” a “Fable”
Só deve-se escalar quando o Opus, mesmo com maior esforço, ainda não for aprovado na avaliação representativa e o ganho justifique o custo.
Regra de rebaixamento: Volte a considerar modelos mais baratos quando um deles passar repetidamente nos mesmos testes de aceitação, atendendo aos requisitos de latência e confiabilidade exigidos.
A matriz da Anthropic mapeia quatro modelos atuais da Claude para diferentes necessidades de capacidade, velocidade e carga de trabalho.
Um exemplo de custo fixo da API Claude
Para uma carga de trabalho agregada fixa de 1 milhão de tokens de entrada mais 100.000 tokens de saída em várias solicitações de API padrão, o custo básico do token varia de $1,50 com o Haiku 4.5 a $15,00 com o Fable 5.1. Isso não se refere a uma única solicitação e não substitui os limites de saída por solicitação.
Uma carga de trabalho, quatro modelos Claude
O mesmo volume de tokens custa 2x, 5x ou 10x o valor total do Haiku à medida que você avança nos níveis atuais.
Carga de trabalho 1,0 milhão de entradas + 0,1 milhão de saídas em várias solicitações
Haiku 4.5
$1.50
Soneto 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Modelo
Cálculo de entrada
Cálculo da produção
Total
Haiku 4.5
1,0 x $1
0,1 x $5
$1.50
Soneto 5
1,0 x $2
0,1 x $10
$3.00
Opus 5
1,0 x $5
0,1 x $25
$7.50
Fable 5.1
1,0 x $10
0,1 x $50
$15.00
Incluído: Taxas padrão de entrada e saída de tokens com base em um instantâneo de preço Anthropic.
Excluídos: Armazenamento em cache de prompts, API em lote, modo rápido, localização geográfica, taxas de ferramentas, impostos, descontos e créditos GlobalGPT.
A tabela de preços indica o custo dos tokens, e não o custo de um resultado finalizado. Um modelo mais barato pode acabar saindo mais caro se as repetições, correções e verificações consumirem mais tempo da equipe do que a economia gerada pelos tokens.
Teste prático do modelo Claude: mesmos prompts, diferentes modos de falha
Em 9 de setembro de 2026, enviamos as mesmas três solicitações por meio da API do Anywhere para os modelos Claude Haiku 4.5, Sonnet 5, Opus 5 e Fable 5.1. As tarefas abrangiam triagem estruturada de suporte, redação baseada em evidências e depuração auditável de JavaScript. Mantivemos a primeira resposta válida de cada modelo e a avaliamos com base em regras definidas antes da revisão das respostas.
O resultado não foi uma simples classificação. Sonnet, Opus e Fable terminaram, cada um, com 26,5 de 30 pontos, embora seus pontos fortes e fracos fossem bem distintos. O Haiku retornou o código HTTP 503 nas duas tentativas permitidas para cada tarefa; portanto, a qualidade de sua saída permanece desconhecida neste teste.
Configuração do teste e resultado geral
Três prompts congelados, os mesmos limites de tokens por tarefa, sem uso de ferramentas ou pesquisa, e a primeira saída válida retida para cada modelo.
LocalAPI Anywhere
Data9 de setembro de 2026
TarefasTriagem estruturada, nota de lançamento, depuração de JavaScript
Regra de nova tentativaErro de transporte, 429/5xx, conteúdo vazio ou resposta com formato inválido
Modelo
Tarefas concluídas
Pontuação total de qualidade
Sinal mais útil
Claude Haiku 4.5
0/3
Sem pontuação
Todas as seis solicitações autorizadas retornaram o código 503; apenas disponibilidade de rota.
Claude Soneto 5
3/3
26.5/30
Único modelo que atende a todos os requisitos das notas de lançamento.
Claude Opus 5
3/3
26.5/30
Análise de depuração aprofundada; não foi detectada uma restrição de comprimento de gravação.
Claude Fable 5.1
3/3
26.5/30
Saídas estruturadas e limpas; a nota de lançamento foi truncada após uma resposta vazia.
Saída estruturada
Teste 1: Triagem de tickets de suporte
Resultado da tarefa: Fable 5.1, 10/10
O Fable foi o único modelo a retornar um JSON diretamente analisável, com todos os seis rótulos e ações corretos. O Opus e o Sonnet acertaram os rótulos, mas adicionaram delimitadores de Markdown; ambos também reforçaram um prazo fornecido, e o Sonnet prometeu prematuramente uma correção ou reembolso.
Modelo
Status
Pontuação
Latência em qualquer lugar
Tokens denunciados
O que aconteceu
Claude Haiku 4.5
Rota indisponível
Sem pontuação
Não disponível
Não disponível
Duas respostas 503; sem índice de qualidade.
Claude Soneto 5
Saída mantida
7.5/10
10,39 s
1005
Rótulos corretos, mas JSON entre aspas e um resultado inventado para reembolso/correção.
Claude Opus 5
Saída mantida
8.5/10
11,87 s
1051
Rótulos corretos e medidas enérgicas, mas JSON restrito e um prazo mais rígido.
Claude Fable 5.1
Saída mantida
10/10
8,55 s
680
JSON que pode ser analisado diretamente; todas as verificações de congelamento foram aprovadas.
Entrada completa do teste
Você gerencia uma caixa de entrada de suporte SaaS. Classifique cada ticket abaixo. Retorne JSON apenas com um campo de nível superior chamado tickets. tickets deve ser uma matriz na ordem original, e cada item deve conter exatamente ticket_id, category, urgency e action. category deve ser um dos seguintes: billing, access, bug, feature. urgency deve ser um dos seguintes: low, medium, high. Use apenas o texto do ticket; não invente resultados de políticas nem fatos sobre o cliente.

#481: Fomos cobrados duas vezes pela mesma renovação anual. O fechamento da folha de pagamento é na sexta-feira e preciso que isso seja investigado antes disso.
#482: A redefinição de senha indica que o e-mail foi enviado, mas nada chegou. Verifiquei a pasta de spam e tentei novamente uma vez.
#483: As exportações em CSV arredondam todos os valores em moeda para dólares inteiros, enquanto o painel de controle ainda mostra centavos.
#484: Por favor, adicionem um modo escuro ao painel de análises.
#485: Depois que o domínio da nossa empresa mudou esta manhã, todos os funcionários estão recebendo uma mensagem de acesso negado ao SSO.
#486: Você poderia me enviar uma cópia da fatura do mês passado?
Claude Haiku 4.5: resultado operacional total
Não foi gerado nenhum resultado do modelo. Ambas as tentativas permitidas da API Anywhere retornaram o código HTTP 503; portanto, essa rota foi marcada como indisponível e excluída da avaliação de qualidade.
Claude Sonnet 5: saída total
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "faturamento",
 "urgency": "alta",
 "action": "Investigar a cobrança duplicada da renovação anual e emitir uma correção/reembolso antes do fechamento da folha de pagamento do cliente na sexta-feira."
    },
    {
 "ticket_id": "#482",
      "category": "acesso",
 "urgency": "média",
 "action": "Verificar o endereço de e-mail da conta e a capacidade de entrega de e-mails e, em seguida, acionar manualmente ou reenviar o e-mail de redefinição de senha."
    },
    {
 "ticket_id": "#483",
      "categoria": "bug",
 "urgência": "média",
 "ação": "Encaminhar para a equipe de engenharia para corrigir o arredondamento na exportação de CSV, de modo que os valores monetários correspondam à precisão até os centavos exibida no painel."
    },
    {
 "ticket_id": "#484",
 "categoria": "recurso",
 "urgência": "baixa",
 "ação": "Registrar a solicitação do modo escuro para o painel de análises e adicioná-la à lista de recursos do produto."
    },
    {
 "ticket_id": "#485",
      "categoria": "acesso",
 "urgência": "alta",
 "ação": "Investigar imediatamente a configuração de SSO vinculada à mudança do domínio da empresa e restaurar o acesso para todos os funcionários afetados."
    },
    {
      "ticket_id": "#486",
 "category": "faturamento",
 "urgency": "baixa",
 "action": "Localizar a fatura do mês passado e enviar uma cópia ao cliente."
    }
  ]
}
```
Claude Opus 5: potência máxima
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "faturamento",
 "urgency": "alta",
 "action": "Encaminhar para o departamento de cobrança para verificar a cobrança duplicada da renovação anual e confirmar a resolução antes do fechamento da folha de pagamento do cliente na sexta-feira."
    },
    {
 "ticket_id": "482",
      "category": "acesso",
 "urgency": "média",
 "action": "Verifique os registros de entrega de e-mail para a mensagem de redefinição enviada para esse endereço e, caso não tenha sido entregue, acione um processo de redefinição verificado para o usuário."
    },
    {
 "ticket_id": "483",
      "categoria": "bug",
 "urgência": "média",
 "ação": "Registrar um bug sobre o arredondamento de moeda na exportação em CSV, observando a discrepância com os valores do painel, e solicitar etapas de reprodução ou uma amostra da exportação."
    },
    {
 "ticket_id": "484",
 "categoria": "recurso",
 "urgência": "baixa",
 "ação": "Registrar como uma solicitação de recurso para o modo escuro no painel de análises e confirmar o recebimento sem se comprometer com um prazo."
    },
    {
 "ticket_id": "485",
      "categoria": "acesso",
 "urgência": "alta",
 "ação": "Escalar como uma interrupção do SSO em toda a organização relacionada à mudança de domínio; solicitar que a equipe de identidade/autenticação revise a configuração do domínio do SSO imediatamente."
    },
    {
      "ticket_id": "486",
 "categoria": "faturamento",
 "urgência": "baixa",
 "ação": "Enviar a cópia da fatura do mês anterior solicitada ao contato verificado da conta."
    }
  ]
}
```
Claude Fable 5.1: potência máxima
{"tickets":[{"ticket_id":"481","category":"faturamento","urgency":"alta","action":"Investigar a cobrança duplicada de renovação anual relatada e responder antes do prazo final de pagamento do cliente, na sexta-feira."},{"ticket_id":"482","category":"acesso","urgency":"média","action":"Verifique os registros de entrega de e-mails de redefinição de senha para o endereço do usuário e reenvie ou forneça uma alternativa para a redefinição."},{"ticket_id":"483","categoria":"bug","urgência":"média","ação":"Reproduza o arredondamento dos valores em moeda para dólares inteiros na exportação para CSV e encaminhe para a equipe de engenharia para correção."},{"ticket_id":"484","categoria":"recurso","urgência":"baixa","ação":"Registrar a solicitação do modo escuro para o painel de análise junto à equipe de produto e confirmar o recebimento."},{"ticket_id":"485","categoria":"acesso","urgência":"alta","ação":"Encaminhar os erros de acesso negado ao SSO em toda a empresa decorrentes da mudança de domínio e revisar a configuração do domínio do SSO."},{"ticket_id":"486","categoria":"faturamento","urgência":"baixa","ação":"Localize e envie ao cliente uma cópia da fatura do mês passado."}]}
Política de “primeira saída válida”. A latência é o tempo real (relógio), calculado pelo Anywhere, e não a latência nativa do Anthropic. As contagens de tokens são informadas pelo provedor; nenhum custo direto da API é inferido a partir dessa rota.
Respeito às restrições
Teste 2: Nota de lançamento baseada em evidências
Resultado da tarefa: Sonnet 5, 10/10
O Sonnet foi o único modelo a atender a todos os requisitos definidos. O Opus produziu uma nota convincente, mas excedeu o limite de palavras e inferiu que todos os que não responderam eram alunos matriculados. A primeira resposta do Fable estava em branco; sua tentativa de repetição permitida retornou uma nota visivelmente truncada, sem a recomendação nem a ressalva.
Modelo
Status
Pontuação
Latência em qualquer lugar
Tokens denunciados
O que aconteceu
Claude Haiku 4.5
Rota indisponível
Sem pontuação
Não disponível
Não disponível
Duas respostas 503; sem índice de qualidade.
Claude Soneto 5
Saída mantida
10/10
9,94 s
796
Atendeu aos requisitos relativos às palavras “alcance”, “estrutura”, “evidência”, “recomendação” e “advertência”.
Claude Opus 5
Saída mantida
8/10
9,49 s
826
Análise sólida, mas 223 palavras a menos do que o permitido pelo método de contagem fixa e uma inferência sem fundamentação.
Claude Fable 5.1
Saída mantida
6.5/10
19,27 s
1685
A primeira resposta estava vazia; a tentativa de repetição foi interrompida antes da recomendação e da advertência.
Entrada completa do teste
Escreva uma nota interna de lançamento, com 180 a 220 palavras, destinada a um diretor de produto, utilizando apenas os fatos abaixo. Inclua: um assunto, um breve parágrafo de abertura, exatamente três pontos-chave, uma recomendação e uma ressalva claramente identificada. Não invente uma resolução orçamentária, porcentagens, significância estatística ou efeitos causais.

Fatos:
- O projeto-piloto contou com a participação de 120 alunos.
- Na avaliação de 31 de março, 96 alunos haviam participado de pelo menos três sessões.
- A pontuação média da pesquisa foi de 4,3 em 5, com 71 respondentes.
- A planilha de operações do programa indica um orçamento de $18.000.
- A nota de aprovação financeira indica $20.000. Não especifica se a diferença se deve a uma revisão ou a um erro de registro.
- Os participantes não foram designados aleatoriamente e não foi coletada nenhuma pontuação de referência.
- A decisão é se deve-se lançar um segundo projeto-piloto, e não se deve implementá-lo permanentemente.
Claude Haiku 4.5: resultado operacional total
Não foi gerado nenhum resultado do modelo. Ambas as tentativas permitidas da API Anywhere retornaram o código HTTP 503; portanto, essa rota foi marcada como indisponível e excluída da avaliação de qualidade.
Claude Sonnet 5: saída total
**Assunto: Resultados do Programa Piloto — Recomendação para dar continuidade ao segundo piloto**

O piloto inicial concluiu seu primeiro período de avaliação, e os indicadores iniciais de participação e satisfação são animadores. Antes de se comprometer com um segundo piloto, há alguns dados e questões pendentes que a equipe deve analisar em conjunto.

- Dos 120 alunos matriculados, 96 haviam participado de pelo menos três sessões até a avaliação de 31 de março.
- Uma pesquisa pós-sessão respondida por 71 participantes resultou em uma nota média de 4,3 em 5.
- Os valores orçamentários apresentam inconsistências entre os documentos: a planilha de operações do programa indica $18.000, enquanto a nota de aprovação financeira indica $20.000; não está claro se isso reflete uma revisão ou um erro de registro.

**Recomendação:** Considerando os resultados de frequência e da pesquisa, recomendamos prosseguir com um segundo projeto-piloto para coletar dados mais estruturados — idealmente com um grupo de comparação definido e uma medição de linha de base — antes de considerar qualquer decisão de implantação mais ampla. Esse segundo projeto-piloto também deve servir como uma oportunidade para reconciliar a discrepância orçamentária com o departamento financeiro antes que os recursos sejam finalizados.

**Advertência:** Esses resultados devem ser interpretados com cautela. Os participantes não foram selecionados aleatoriamente e nenhuma pontuação de referência foi coletada; portanto, não podemos atribuir os resultados da pesquisa ou os padrões de participação ao próprio programa. Trata-se de uma decisão sobre o escopo de um segundo projeto-piloto, não de uma decisão sobre a implementação permanente.
Claude Opus 5: potência máxima
**Assunto: Resultados do projeto-piloto e recomendação sobre uma segunda coorte piloto**

O primeiro projeto-piloto concluiu sua avaliação de 31 de março, e agora dispomos de informações suficientes para decidir se devemos realizar um segundo projeto-piloto. Esta nota resume o que observamos, o que recomendamos e a principal limitação para a interpretação. Nenhuma decisão definitiva sobre a implantação está em discussão neste momento.

- **Inscrições e participação:** 120 alunos se inscreveram. Até a avaliação de 31 de março, 96 deles haviam participado de pelo menos três sessões.
- **Feedback dos participantes:** A pesquisa pós-participação apresentou uma média de 4,3 em 5, com base em 71 respondentes. Os demais alunos inscritos não responderam, portanto a pontuação reflete apenas esse subconjunto.
- **Discrepância orçamentária:** A planilha de operações do programa indica um orçamento de $18.000, enquanto a nota de aprovação financeira indica $20.000. A nota financeira não especifica se a diferença reflete uma revisão ou um erro de registro, e ainda não determinamos qual valor é válido.

**Recomendação:** Prosseguir com o planejamento de um segundo projeto-piloto, condicionado à reconciliação dos dois valores orçamentários entre o Departamento Financeiro e o de Operações do Programa, bem como à confirmação de um único valor válido antes de autorizarmos os gastos. Um segundo projeto-piloto também deve coletar pontuações de referência no momento da admissão.

**ADVERTÊNCIA:** Os participantes não foram designados aleatoriamente e nenhuma pontuação de referência foi coletada. Os números relativos ao envolvimento e à pesquisa, portanto, descrevem o que esse grupo fez e relatou; eles não podem nos dizer o que o programa causou ou como ele se sairia com uma população diferente.
Claude Fable 5.1: potência máxima
**Assunto:** Resumo da avaliação do projeto-piloto e recomendação sobre a segunda fase do projeto-piloto

Olá, [Diretor],

Segue abaixo um resumo da situação atual do projeto-piloto na avaliação de 31 de março, juntamente com uma recomendação sobre a conveniência de prosseguir para uma segunda fase do projeto-piloto. Esta nota aborda apenas a decisão sobre a segunda fase do projeto-piloto, e não a implantação definitiva.

- **Matrículas e frequência:** 120 alunos matriculados. Na avaliação de 31 de março, 96 haviam participado de pelo menos três sessões.
- **Feedback dos participantes:** Uma pesquisa revelou uma nota média de 4,3 em 5, com base em 71 respondentes.
- **Registros orçamentários:** A planilha de operações do programa indica um orçamento de $18.000, enquanto a nota de aprovação financeira indica $20.000. A nota financeira não indica se a diferença se deve a uma revisão ou a um erro de registro.

**
Política de “primeira saída válida”. A latência é o tempo real (relógio), calculado pelo Anywhere, e não a latência nativa do Anthropic. As contagens de tokens são informadas pelo provedor; nenhum custo direto da API é inferido a partir dessa rota.
Correção do código
Teste 3: Depuração de JavaScript com histórico
Resultado da tarefa: Opus 5 e Fable 5.1 empataram, 10/10
Todos os três modelos disponíveis identificaram defeitos e geraram substituições que foram aprovadas em oito casos de teste. O Opus e o Fable retornaram JSON válido e empataram com 10/10. O código do Sonnet também foi aprovado, mas a delimitação em Markdown ao redor violou o requisito de JSON direto.
Modelo
Status
Pontuação
Latência em qualquer lugar
Tokens denunciados
O que aconteceu
Claude Haiku 4.5
Rota indisponível
Sem pontuação
Não disponível
Não disponível
Duas respostas 503; sem índice de qualidade.
Claude Soneto 5
Saída mantida
9/10
13,17 s
1471
A substituição foi aprovada em 8 dos 8 casos; a saída entre colchetes perdeu o ponto referente ao formato JSON.
Claude Opus 5
Saída mantida
10/10
20,17 s
1826
JSON válido, ambas as falhas identificadas e 8 de 8 casos executáveis aprovados.
Claude Fable 5.1
Saída mantida
10/10
15,89 s
1409
JSON válido, diagnóstico conciso e 8 de 8 casos de execução aprovados.
Entrada completa do teste
Diagnostique e corrija esta função JavaScript. Retorne apenas um JSON com exatamente quatro campos: root_cause (string), replacement (string contendo a função de substituição completa), tests (matriz de strings de casos de teste) e remaining_risk (string). Não afirme que você executou os testes. Faça a correção mais simples e clara que satisfaça o contrato.

Contrato:
- tasks é uma matriz de funções sem argumentos que retornam promessas.
- Retorne o primeiro valor cumprido na ordem de entrada, mesmo quando esse valor for 0, false ou uma string vazia.
- Ignore tarefas rejeitadas.
- Retorne null quando todas as tarefas forem rejeitadas ou a matriz estiver vazia.

Código atual:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: resultado operacional total
Não foi gerado nenhum resultado do modelo. Ambas as tentativas permitidas da API Anywhere retornaram o código HTTP 503; portanto, essa rota foi marcada como indisponível e excluída da avaliação de qualidade.
Claude Sonnet 5: saída total
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: potência máxima
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: potência máxima
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Política de “primeira saída válida”. A latência é o tempo real (relógio), calculado pelo Anywhere, e não a latência nativa do Anthropic. As contagens de tokens são informadas pelo provedor; nenhum custo direto da API é inferido a partir dessa rota.
Esses resultados do Anywhere mostram por que a escolha do modelo deve se basear na tarefa, e não em um único ranking. No GlobalGPT, você pode aplicar o mesmo método de comparação ao seu próprio prompt no Claude e em outros modelos líderes e, então, escolher a saída que melhor atenda aos seus padrões de qualidade, necessidades de velocidade e carga de trabalho de revisão.
Como fazer uma comparação imparcial
Congele uma tarefa representativa. Utilize as mesmas verificações de intenção, material de origem, acesso às ferramentas e aceitação de objetivos.
Registre a primeira saída válida. Não conceda discretamente a um modelo tentativas adicionais na comparação principal.
Distinga qualidade de disponibilidade. Falhas de autenticação, capacidade e rota devem constar em uma nota de disponibilidade, e não no índice de qualidade.
Avalie todo o fluxo de trabalho. Calcule o tempo decorrido, o esforço do revisor, o tempo de correção e a recuperação de tarefas com falha.
Escolha o modelo de passagem mais barato. Repita o teste quando houver alterações nas instruções, nas ferramentas, nas versões dos modelos ou nos custos de falha.
Onde o GlobalGPT se encaixa
O Anthropic posiciona o Fable 5.1 para trabalhos exigentes, quando as avaliações do Opus 5, que exigem maior esforço, ainda não são suficientes.
Em 8 de setembro de 2026, a linha de produtos ativa da Anthropic inclui o Claude Haiku 4.5, o Claude Sonnet 5, o Claude Opus 5 e o Claude Fable 5.1. As versões exatas e os IDs dos modelos podem sofrer alterações; portanto, verifique novamente a visão geral oficial dos modelos antes da implantação.
Qual é a diferença entre Claude Haiku, Sonnet e Opus?
O Haiku prioriza a velocidade e o baixo custo básico de tokens; o Sonnet equilibra velocidade e capacidade para o trabalho diário; e o Opus prioriza a capacidade para tarefas complexas ou de alto impacto. A escolha certa depende da sua carga de trabalho e do custo de verificação, e não de uma classificação absoluta.
Qual modelo Claude devo usar para a maioria das tarefas?
Comece com o Sonnet 5 para a maioria das tarefas cotidianas de redação, análise, programação, compreensão visual e uso de ferramentas. Opte pelo Opus 5 quando o erro acarretar custos elevados ou quando o trabalho exigir raciocínio mais profundo e verificação mais rigorosa.
Qual modelo Claude é o melhor para programação?
O Sonnet 5 é um ponto de partida prático para a codificação no dia a dia, com revisões e testes regulares. Use o Opus 5 para diagnósticos difíceis, codificação agênica complexa, execução de longo prazo ou mudanças cujos erros podem acarretar custos elevados.
Qual modelo Claude é o melhor para escrever?
O Sonnet 5 é o ponto de partida equilibrado para a maioria dos trabalhos de redação e edição. O Haiku 4.5 é adequado para textos extensos e bem estruturados, enquanto o Opus 5 pode valer a pena ser testado para sínteses complexas ou materiais de grande importância que sejam difíceis de verificar.
O Claude Sonnet é melhor que o Opus?
Não de forma generalizada. O Sonnet 5 é mais rápido e mais barato nas tarifas básicas da API, enquanto o Anthropic posiciona o Opus 5 para trabalhos mais complexos. O melhor modelo é a opção mais econômica que atenda de forma confiável aos seus próprios critérios de aceitação.
O Claude Fable está substituindo o Opus?
O nº Anthropic posiciona o Fable 5.1 como um nível de escalonamento para tarefas que exigem raciocínio complexo ou trabalho prolongado do agente, quando o Opus 5 — que requer maior esforço — ainda não é suficiente, e não como um substituto universal para o Opus.
O Claude.ai e a API do Claude têm a mesma janela de contexto?
Os limites do plano Claude.ai e as especificações do modelo da API são distintos. A tabela de planos individuais do Anthropic indica atualmente uma janela de contexto de 200 mil, enquanto a documentação da API indica um contexto de 1 milhão para o Sonnet 5, o Opus 5 e o Fable 5.1.
Quando devo atualizar do Haiku para o Sonnet ou o Opus?
Faça o upgrade quando as falhas nas verificações de aceitação, casos extremos complexos, tempo de correção, esforço de verificação ou o custo de um erro superarem a vantagem do modelo inferior em termos de velocidade e preço por token. Volte para o modelo anterior quando um modelo mais barato passar repetidamente nas mesmas verificações congeladas.
Quanto custam o Claude Haiku, o Sonnet e o Opus por meio da API?
De acordo com as taxas básicas do Anthropic verificadas em 8 de setembro de 2026, o Haiku 4.5 custa $1 de entrada e $5 de saída; o Sonnet 5 custa $2 e $10; e o Opus 5 custa $5 e $25 por milhão de tokens. Consulte o Anthropic’s página oficial de preços para conhecer as tarifas atuais e outras opções de cobrança.
Veredicto final: comece com o modelo mais barato que for aprovado
Para trabalhos mistos em geral, o Sonnet 5 continua sendo a opção padrão mais prática e foi o único modelo a atender a todas as restrições de notas de lançamento em nosso teste. O Opus 5 e o Fable 5.1 igualaram a pontuação total de 26,5/30 do Sonnet por meio de diferentes pontos fortes, enquanto o Haiku 4.5 não pôde ser avaliado porque a rota “Anywhere” retornou o erro 503 em todas as tentativas permitidas. Considere esses resultados como evidências de carga de trabalho, e não como um ranking universal definitivo.
Seu próximo passo é simples: escolha uma tarefa real, defina como seria um resultado satisfatório, teste cada candidato sério em condições comparáveis e inclua o tempo de correção no custo final. O modelo vencedor é aquele que, com menor custo, for capaz de passar no teste de forma confiável, e não aquele com a menor taxa de tokens ou o nome de nível mais alto.
O GlobalGPT integra esse método a um fluxo de trabalho de IA mais abrangente e acessível. Utilize o Claude, o GPT-5.6 Sol, o Gemini 3 Pro, o Kimi K3 e outros modelos líderes com múltiplas funções de IA em um único painel de controle e, em seguida, transfira o trabalho para seu terminal, fluxo de trabalho de desenvolvimento e ferramentas de produção existentes por meio da CLI do GlobalGPT. Os testes comparativos ajudam na escolha; a maior vantagem é manter todo o fluxo de trabalho conectado.
Entenda o que significa a palavra-chave “AI Motion Designer for After Effects GPT” e como o GLBGPT utiliza a Yukie, a editora de vídeo, prompts, efeitos, legendas, áudio e clipes gerados.
Aprenda a criar imagens para blogs com IA usando fontes atuais, testes práticos, limites claros e um caminho mais seguro, desde a primeira tentativa até a produção.
Conheça os planos anuais ilimitados de vídeo com IA, com fontes atualizadas, testes práticos, limites claros e um caminho mais seguro desde o primeiro teste até a produção.
Conheça as alternativas ao GPT Live 1 com fontes atualizadas, testes práticos, limites claros e um caminho mais seguro desde a primeira tentativa até a produção.