Muse Spark 1.3 is de krachtigste Muse Spark-release van Meta tot nu toe: het openbare xhigh-model scoort 61 op de Artificial Analysis Intelligence Index, hanteert een contextvenster van 1 miljoen tokens en heeft alle drie de programmeertaken van gemiddelde moeilijkheidsgraad doorstaan in onze API-test voor eerste reacties. Een belangrijk voorbehoud is dat Meta in zijn belangrijkste benchmarkgrafiek gebruikmaakt van ‘max reasoning’, terwijl ‘max’ op het moment dat deze beoordeling werd opgesteld nog in afwachting was van een bredere introductie na aanvullende veiligheidstests.

Recensie van de Muse Spark 1.3: kort oordeel
Ons oordeel
Muse Spark 1.3 is het proberen waard voor het programmeren van agents, taken met een lange context en kostengevoelige automatisering. Het openbare ‘xhigh’-resultaat is nu al concurrerend met de top, maar citeer de maximale scores van Meta niet alsof elke API-gebruiker die vandaag de dag kan evenaren.
Meta heeft op 2 september 2026 Muse Spark 1.3 uitgebracht, waardoor het geschikt wordt voor agentgebaseerde workflows met een lange termijnvisie, overzichtelijkere code en betrouwbaardere samenwerking. Hiermee wordt de verschuiving voortgezet in de richting van AI-agenten die zijn gebaseerd op modellen voor het gebruik van gereedschap. Meta geeft aan dat het verduidelijkende vragen stelt wanneer vereisten onduidelijk zijn, een melding geeft wanneer het vastloopt en bevestiging vraagt voordat er ingrijpende acties worden ondernomen. Bij interne vergelijkingen met versie 1.2 constateerden de ingenieurs van Meta ongeveer 20% minder tool-aanroepen en 25% minder tokens. Dit zijn beweringen van de aanbieder, geen resultaten van onze test.
Wat is er veranderd ten opzichte van Muse Spark 1.2?
Kunstmatige analyse: 57 tot 61 op xhigh.
Meta rapporteert 75,4 tegenover 55,0 op DeepSWE, maar vergelijkt 1,3 max met 1,2 xhigh.
Het 1M-venster blijft bestaan; de MRCR-scores in de hoge band stijgen sterk in de grafiek van Meta.
De token-percentages blijven stabiel, terwijl AA per geëvalueerde taak $0,55 noteerde tegenover $0,40.
Benchmarks van Muse Spark 1.3: ‘Max’ en ‘Xhigh’ zijn niet hetzelfde
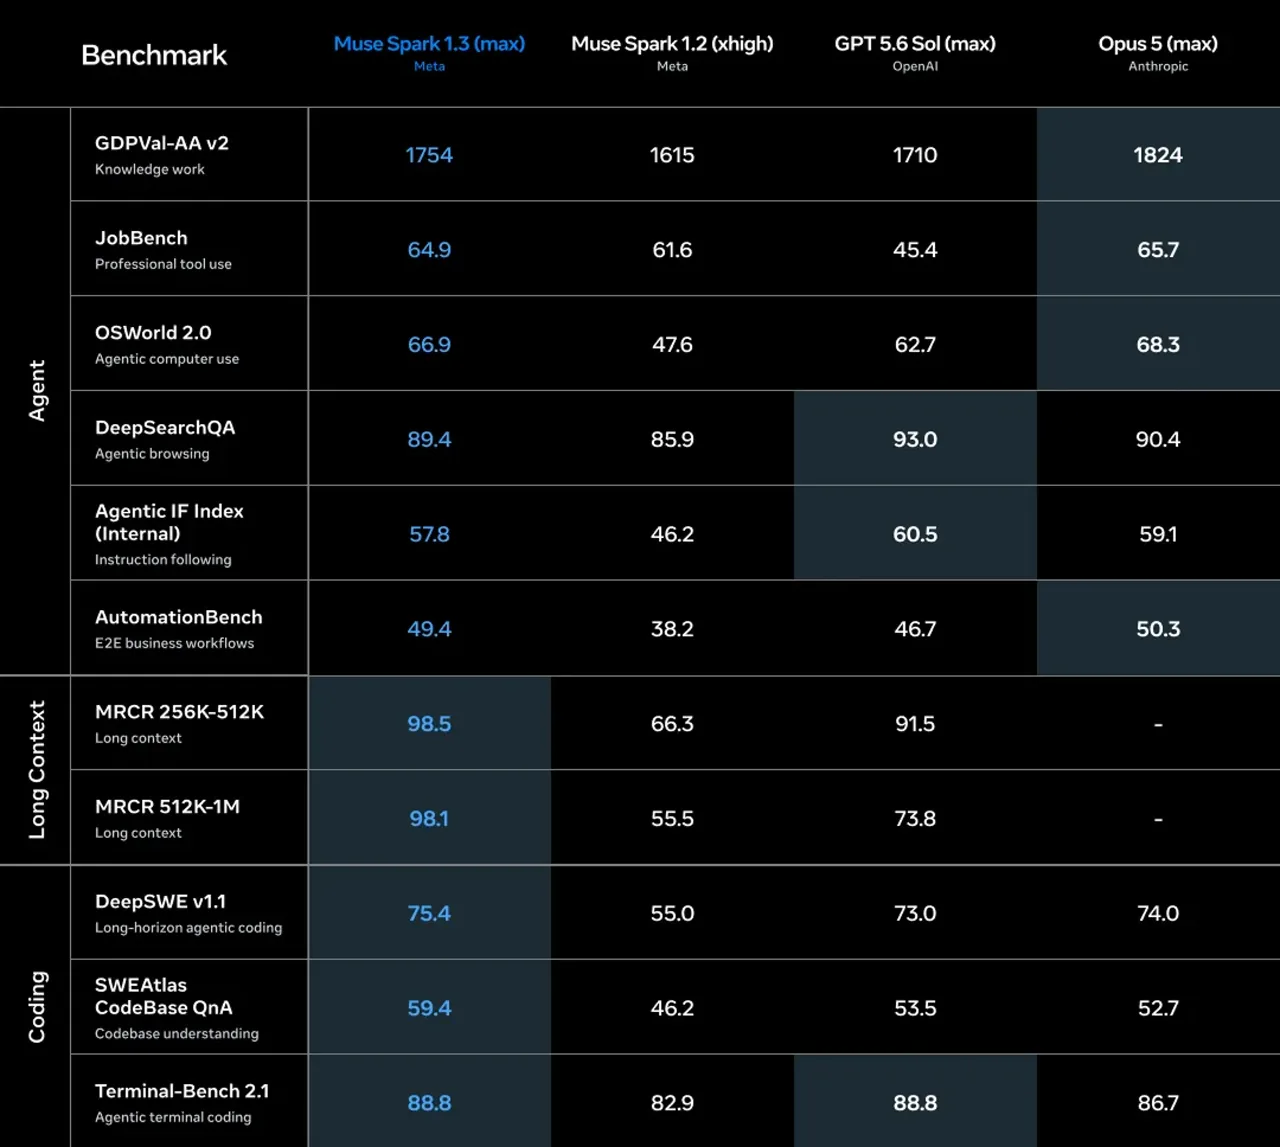
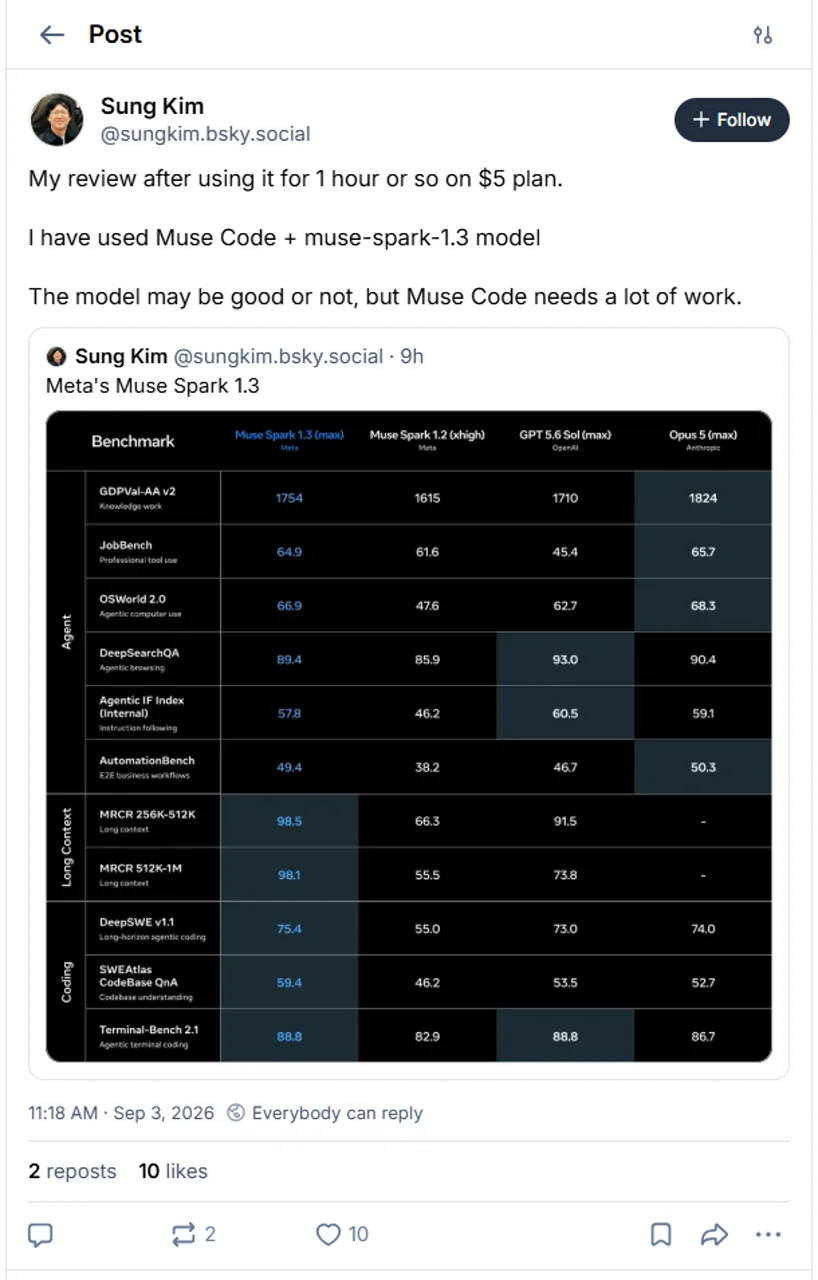
De officiële hitlijst van Meta is indrukwekkend. Muse Spark 1.3 behaalt een maximale score van 88,8 op Terminal-Bench 2.1, 75,4 op DeepSWE v1.1, 98,1 op MRCR 512K-1M en 66,9 op OSWorld 2.0. Het evenaart de topscore van GPT-5.6 Sol op Terminal-Bench en loopt voor op de weergegeven concurrenten op de twee MRCR-banden met lange context. Ontwikkelaars die de bredere markt willen vergelijken, kunnen gebruikmaken van onze Overzicht van Coding-Agent als aanvullende achtergrondinformatie.
META-GERAPPORTEERD, MAX-REDENERING
| Benchmark | maximaal 1,3 | 1,2 x hoog | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | N.V.T. |
Verschillende instellingen voor de inspanningsgraad, agent-harnassen en OSWorld-versies beperken de directe vergelijkbaarheid. Meta beschrijft de Agentic IF Index bovendien als een interne samengestelde index.
Hoe lees je de grafiek?
1.3, GPT-5.6 Sol en Opus 5 gebruiken ‘max’; 1.2 gebruikt ‘xhigh’.
De benoemde agenten en vaste harnassen verschillen per evaluatie.
De 1.3- en 1.2-runs maken gebruik van verschillende omgevingsversies.
De Agentic IF Index is een samengestelde index van Meta, en geen afzonderlijke openbare benchmark.
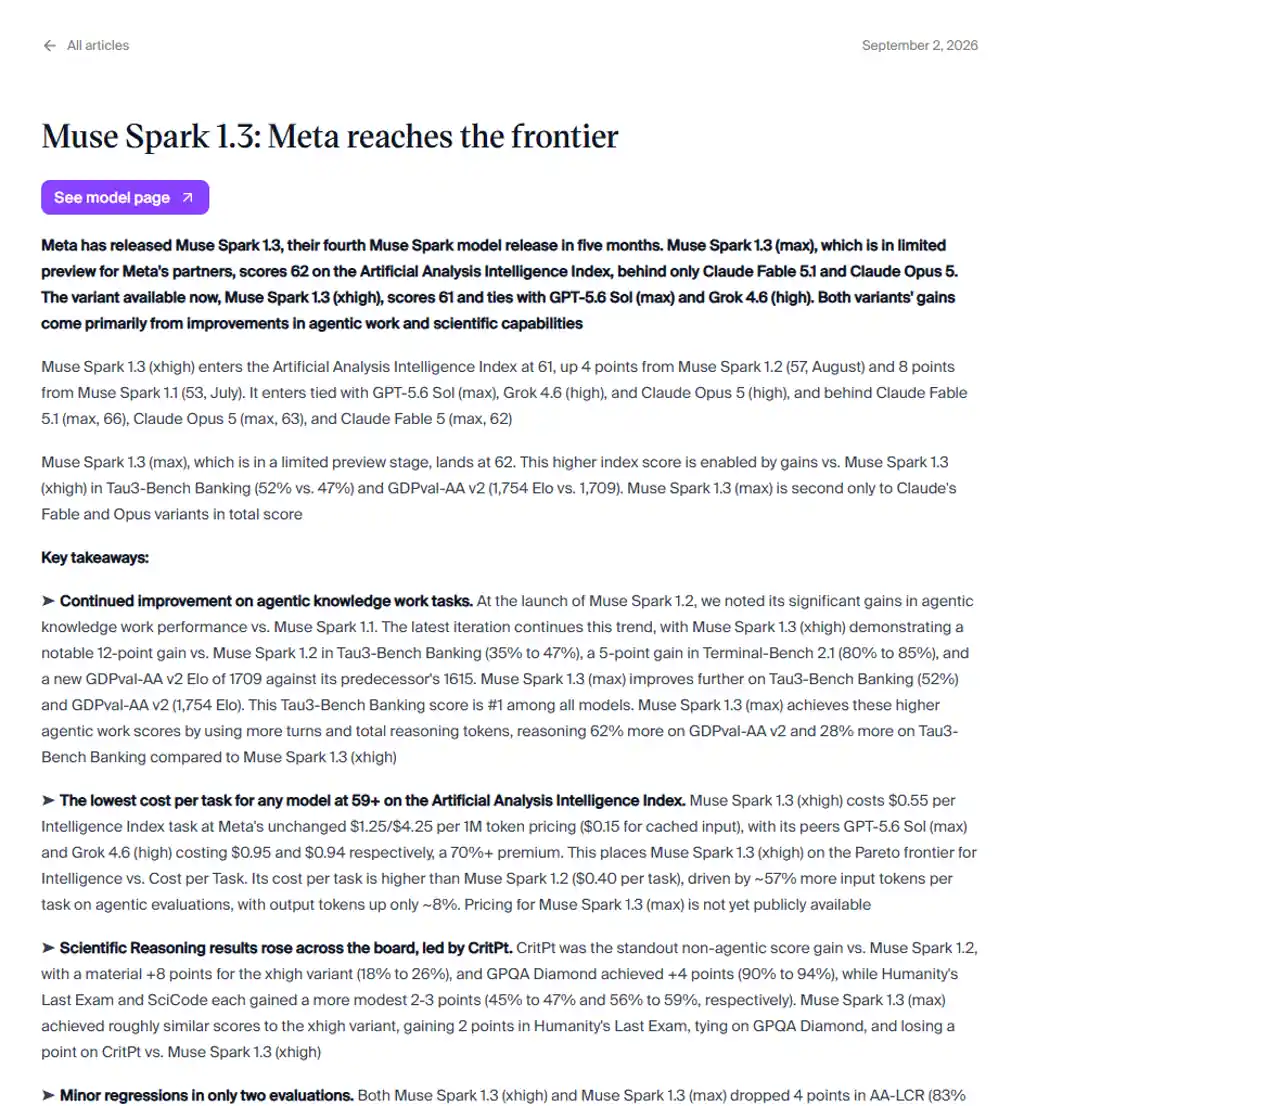
Artificial Analysis biedt een overzichtelijker beeld van wat gebruikers nu kunnen openen. Muse Spark 1.3 behaalt een xhigh-score van 61, een stijging ten opzichte van 57 voor versie 1.2. Het Terminal-Bench-resultaat is 85%, GDPval-AA v2 is 1709 Elo en Tau3-Bench Banking is 47%. De ‘limited-preview’ max-variant haalt een totaal van 62. Er zijn ook achteruitgangen: AA-LCR daalt van 83% naar 79%, terwijl AA-Omniscience Accuracy op xhigh daalt van 45% naar 42%.
Prijzen van Muse Spark 1.3
Bijdrager
muse-spark-1.3-bijdrager
$0.10 invoer / $0.002 in de cache / $0.20 uitvoer per miljoen tokens.
Er kunnen prompts worden gebruikt om Meta-producten te verbeteren.
Standaard
muse-spark-1.3
$1,25 invoer / $0,15 in cache / $4,25 uitvoer per miljoen tokens.
Meta zegt dat dit niveau niet wordt gebruikt om zijn producten te verbeteren.
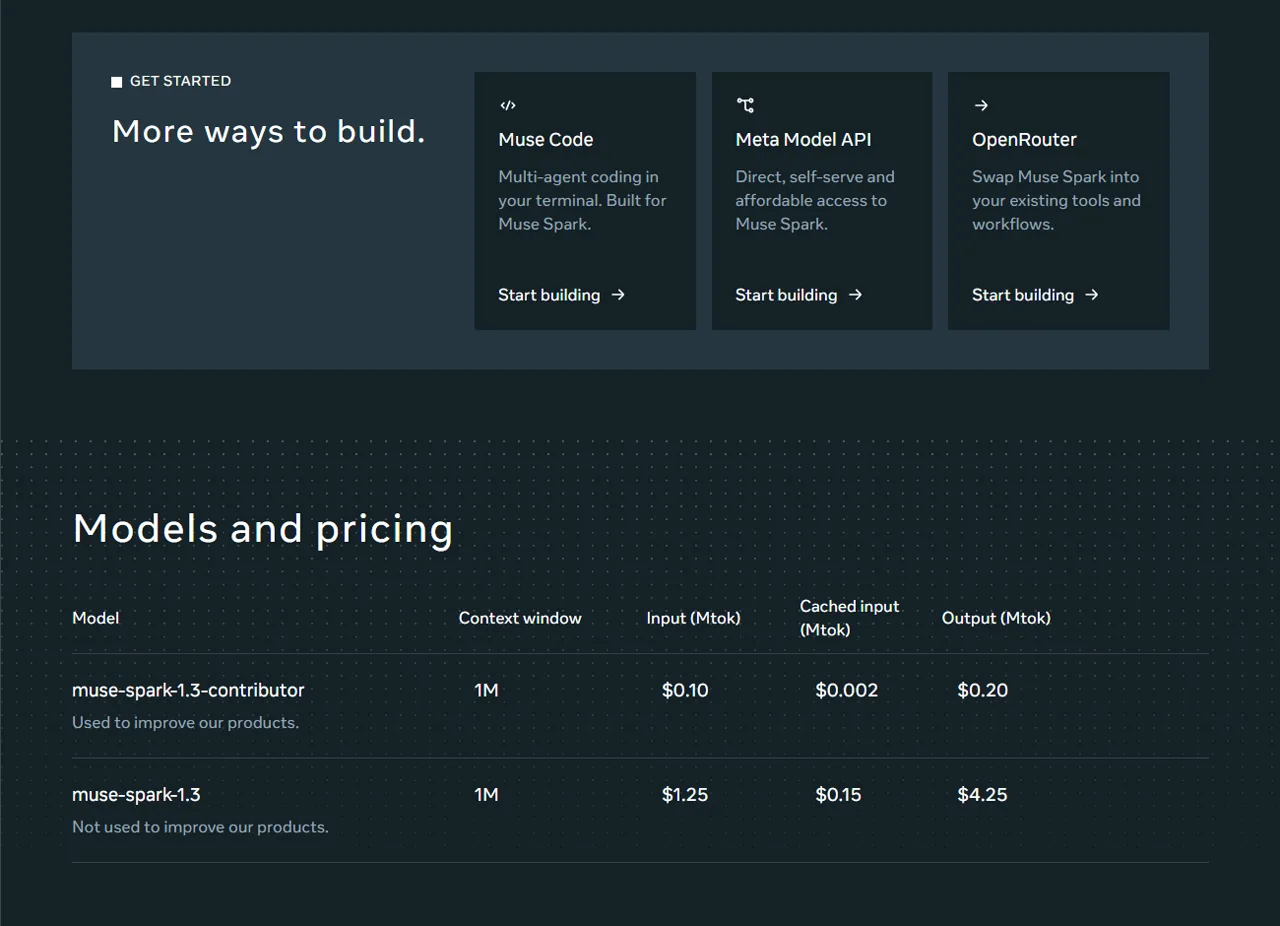
De officiële tokenprijzen zijn ongewijzigd ten opzichte van versie 1.2, maar de kosten per taak zijn dat niet. Onze Beoordeling van een alles-in-één AI-platform legt uit waarom de toegangsprijs en de workflowkosten afzonderlijk moeten worden beoordeeld. Artificial Analysis mat $0,55 per Intelligence Index-taak voor 1,3 xhigh, tegenover $0,40 voor 1,2, wat voornamelijk te wijten was aan ongeveer 57% meer invoertokens bij agentische evaluaties. Het ‘contributor’-niveau is uitzonderlijk goedkoop, maar de voorwaarde inzake gegevensgebruik is een echte productkeuze in plaats van een voetnoot.
Toegang tot de Muse Spark 1.3 API
Meta’s officieel kookboek gebruikt nu muse-spark-1.3 als standaardinstelling en ondersteunt een contextvenster van 1.048.576 tokens. De API is compatibel met de OpenAI SDK. Muse Code en Meta Model API zijn de huidige bevestigde toegangswegen. Op de modelpagina van Meta wordt ook OpenRouter weergegeven, hoewel de knop bij het aanklikken nog steeds naar een 1.2-URL verwees; controleer de route daarom vóór de implementatie. Zie voor achtergrondinformatie over de interoperabiliteit van agents onze gids over MCP- en AI-tools.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Controleer deze patch op regressies."}],
)

print(response.choices[0].message.content)
Praktische programmeertests: 3 van de 3 geslaagd
We hebben drie repository-taken van gemiddelde moeilijkheidsgraad getest via een API bij temperatuur nul, waarbij we per taak één antwoord hebben gebruikt. Elk antwoord moest volledige bestanden in gestructureerde JSON-indeling retourneren. Vervolgens hebben we die bestanden in tijdelijke mappen geplaatst en zowel openbare als verborgen controles uitgevoerd. Dit zijn kleine, gecontroleerde tests; ze vormen geen vervanging voor Terminal-Bench of een test met een productierepository.
5 van de 5 tests; 18,4 s; 2.473 tokens; $0,00905. Het model heeft de ongebruikte set van verwerkte ID's opgespoord, een vroege controle op duplicaten toegevoegd en een regressietest geschreven.
Type-controle en twee runtime-controles geslaagd; 47,6 s; 4.945 tokens; $0.01661. Validatie, persistentie en auditlogging werden gescheiden zonder de transactiegrens te doorbreken.
9 van de 9 tests; 20,3 s; 3.789 tokens; $0,01446. CSV-compatibiliteit, fouten met regelnummers, atomaire uitvoer, veiligheid bij droogdraaien, help en documentatie: allemaal geslaagd.
Totaal: 11.207 tokens en $0.04013. De tijden geven de totale verwerkingstijd van het verzoek weer, niet de native Meta API-latentie of TTFT.
Het resultaat was beter dan de kale score van “3/3” doet vermoeden: alle drie de eerste reacties waren toetsbaar en hielden rekening met de beperkingen. Dezelfde zorgvuldigheid bij het beoordelen van bewijsmateriaal is van belang bij het lezen van onze Recensie van GPT-5. Toch wordt in deze test geen rekening gehouden met de betrouwbaarheid bij herhaaldelijk gebruik van tools, het navigeren door grote repositories of de orkestratielaag van Muse Code. Lezers die goedkope alternatieven overwegen, kunnen ook onze vergelijking van begrotingscoderingmodellen handig.
Eerste reacties van ontwikkelaars
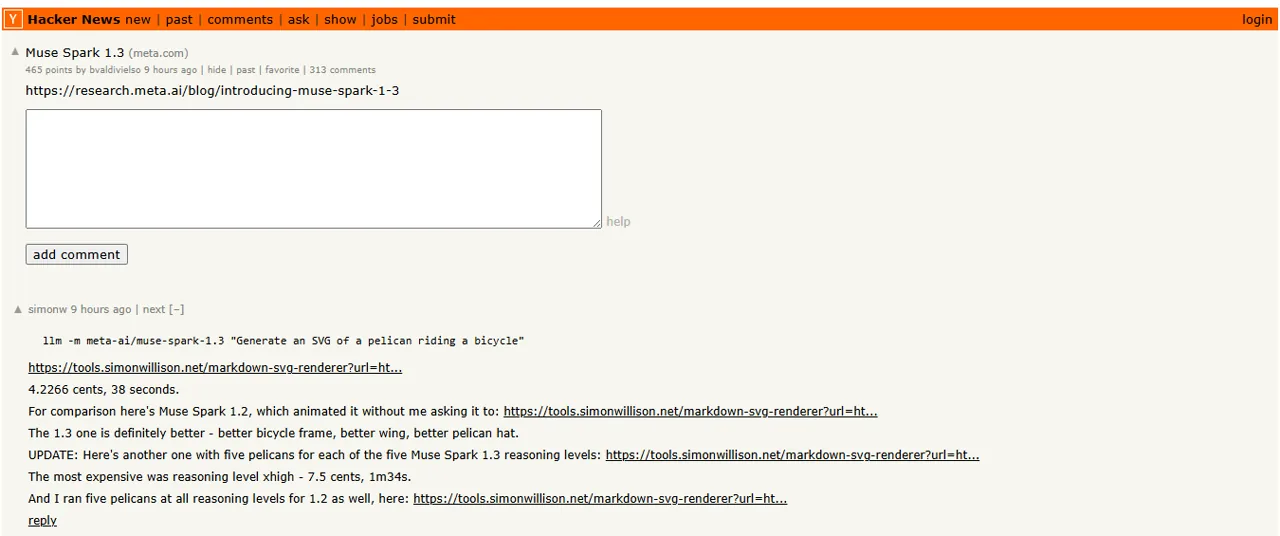
De eerste reacties zijn gemengd en te schaars om van een consensus te kunnen spreken. In een Hacker News-test, Simon Willison rapporteerde een SVG-run van 38 seconden en 4,2266 cent en beoordeelde het 1.3-resultaat als “absoluut beter” dan zijn 1.2-vergelijking. Dax gaf een toelichting op de release als herinnering aan hoezeer hij snelle modellen miste. Sung Kim, zei na ongeveer een uur met Muse Code dat het model weliswaar goed zou kunnen zijn, maar dat het product van Muse Code “nog veel werk nodig heeft”. Die laatste opmerking heeft betrekking op de ervaring van de agent, niet op een zuivere test van alleen het model.
Voor- en nadelen
Wat werkte
- Hoge score bij het publiek xhigh
- Contextvenster voor 1M-token
- OpenAI-compatibele API
- Alle drie de codeertaken zijn bij de eerste reactie goedgekeurd
- Zeer lage tokentarieven voor lagere bijdragersniveaus
Wat je kunt bekijken
- De maximale resultaten in de koptekst vormen niet de standaard openbare weergave
- De kosten van onafhankelijke taken zijn gestegen ten opzichte van 1,2
- Twee onafhankelijke maatstaven werden geregresseerd
- Gegevens van bijdragers kunnen de producten van Meta verbeteren
- De eerste reacties op Muse Code zijn gemengd
Voor wie is Muse Spark 1.3 bedoeld?
GEBRUIK HET VOOR
Evaluaties van programmeeragenten, werkzaamheden aan een repository met een brede context, toolgestuurde automatisering en kostenbewuste experimenten waarbij het gegevensbeleid aanvaardbaar is.
OVERSLAAN OF WACHT WANNEER
U hebt behoefte aan bewezen productiebetrouwbaarheid op de lange termijn, hebt vandaag nog het maximale nodig, of kunt geen genoegen nemen met het gegevensgebruik op contributorniveau en vindt de standaardprijzen niet concurrerend.
Muse Spark 1.3: conclusie van de recensie
Muse Spark 1.3 wordt aanbevolen voor evaluatie. Het combineert toonaangevende openbare x-prestaties, sterke resultaten bij het verwerken van lange contexten, een vertrouwde API-gebruiksvriendelijkheid en een scherpe prijsstelling. Onze drie coderingstaken voor eerste reacties bevestigen dat het programma rekening kan houden met beperkingen bij meerdere bestanden en testbare patches kan genereren.
Kies het standaardniveau voor gevoelige code. Zie voor een andere vergelijking van grenzen GPT-5 versus Claude 4. Beschouw de maximale benchmarkresultaten als voorlopige aanwijzingen totdat dat redeneerniveau op grote schaal beschikbaar is. En beoordeel Muse Code los van de model-API: de gebruikerservaring, de tool-loop en de repository-controle van een agent kunnen slagen of mislukken, onafhankelijk van het basismodel.
Veelgestelde vragen over Muse Spark 1.3
Wat is Muse Spark 1.3?
Muse Spark 1.3 is het model van Meta voor programmeer- en agentgebaseerde workflows, dat op 2 september 2026 is uitgebracht, met een contextvenster van 1 miljoen tokens en ingebouwde herkenning van afbeeldingen, video’s en documenten.
Hoeveel kost Muse Spark 1.3?
Het standaardmodel kost $1,25 per miljoen invoertokens, $0,15 voor in de cache opgeslagen invoer en $4,25 voor uitvoer. Het bijdragersmodel kost respectievelijk $0,10, $0,002 en $0,20, maar de gegevens ervan kunnen worden gebruikt om Meta-producten te verbeteren.
Is 'max reasoning' beschikbaar?
Meta heeft aangegeven dat de bestaande redeneringsmodi bij de lancering beschikbaar waren en dat de modus ‘max’ na aanvullende veiligheidstests zou volgen. Raadpleeg de huidige API-documentatie voordat u ervan uitgaat dat deze modus algemeen beschikbaar is.
Heeft Muse Spark 1.3 de coderingstests doorstaan?
Ja. De eerste resultaten voldeden aan alle uitvoerbaarheidstests in het kader van onze Python-bugfix, TypeScript-refactor en JSONL-functietests. Het voorbeeld bevat slechts drie gecontroleerde taken en geeft geen algemeen beeld van de betrouwbaarheid.
Is Muse Spark 1.3 beter dan 1.2?
Dit blijkt grotendeels uit de beschikbare gegevens. De score voor ‘Public xhigh intelligence’ steeg van 57 naar 61 en Meta meldt aanzienlijke verbeteringen op het gebied van agentic en long-context, maar Artificial Analysis constateerde ook hogere taakkosten en kleine achteruitgang bij het ophalen van informatie in een lange context en bij de feitelijke kalibratie.
Moet ik het ‘contributor’-model of het standaardmodel gebruiken?
Gebruik de standaardoptie voor gevoelige of vertrouwelijke prompts, omdat Meta aangeeft dat die gegevens niet worden gebruikt om zijn producten te verbeteren. De ‘Contributor’-optie is aanzienlijk goedkoper, maar de prompts die daarbij worden gebruikt, kunnen wel worden ingezet voor productverbetering.