De tests zijn uitgevoerd op 7 en 11 september 2026; de bronnen zijn op 16 september 2026 opnieuw gecontroleerd.
Er moet één ding over de naam worden verduidelijkt. Mensen zoeken nog steeds naar “Grok 4”, maar het model dat we hebben getest was Grok 4,6, en niet de oorspronkelijke releasedatum in juli 2025. De huidige xAI-modelcatalogus beveelt Grok 4.6 aan voor de code, terwijl de originele grok-4-0709 De API-naam is buiten gebruik gesteld. Ik zal deze producten en data in dit overzicht apart houden.
Als je verschillende assistenten met elkaar vergelijkt voordat je een keuze maakt, begin dan met het bredere het beste AI-model voor het vergelijken van programmeercodes. De meer specifieke vraag is hier of Grok een nauwkeurige opdracht kan omzetten in werk dat je daadwerkelijk kunt controleren.
Kort antwoord: is Grok 4 geschikt voor programmeren?
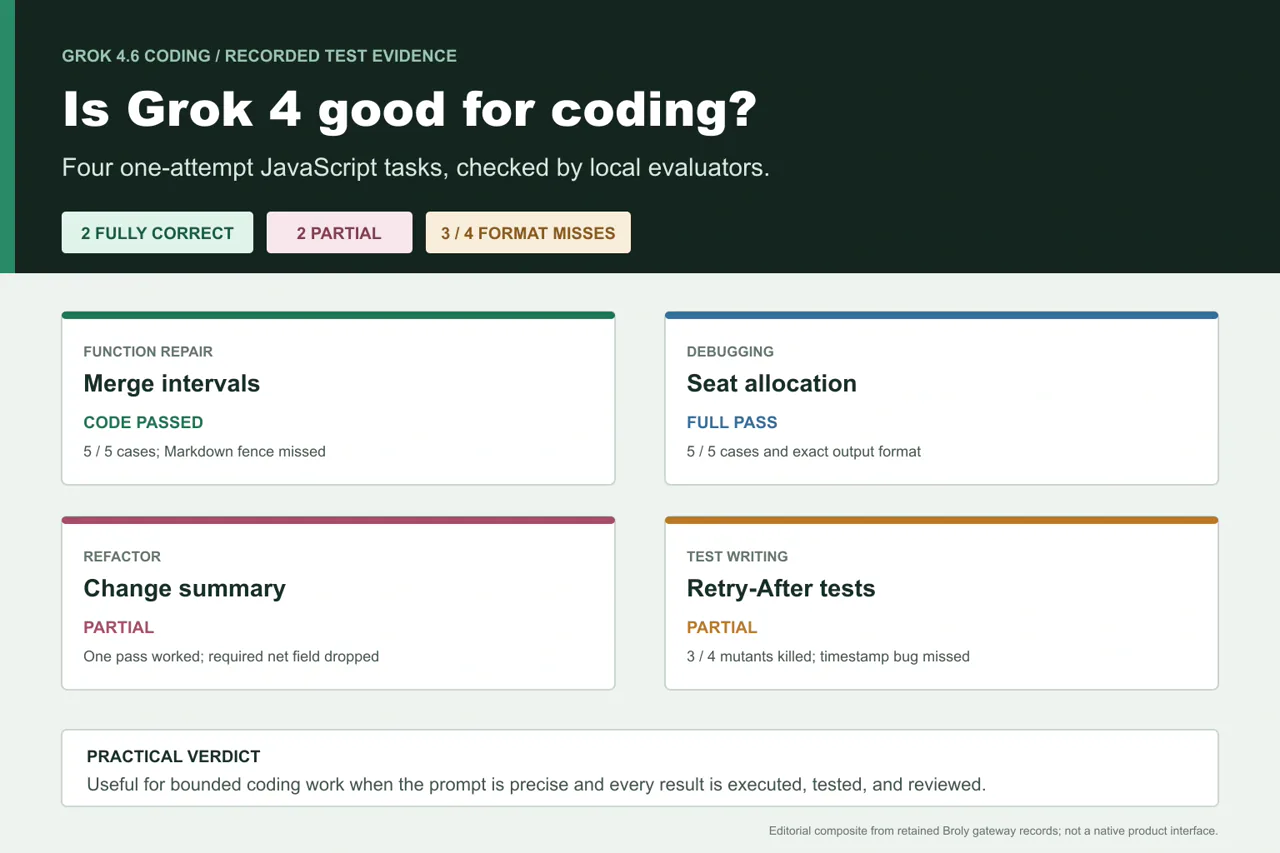
Grok 4.6 is goed genoeg om te gebruiken bij het opsporen van fouten in een afzonderlijke functie, het opstellen van een eerste implementatie, het uitleggen van onbekende code en het opstellen van tests. Het is echter niet betrouwbaar genoeg om zonder uitvoering te accepteren. De fouten in onze kleine testsuite waren geen obscure stijlverschillen: bij één refactor viel netto uit elk niet-leeg resultaat, en één gegenereerde testsuite slaagde er niet in om een vertraging te onderscheiden van een absolute tijdstempel.
De praktische richtlijn is simpel: stel een beperkte opdracht op, vraag om één wijziging en voer onafhankelijke controles uit. Een model dat snel plausibele code genereert, kan nog steeds één veld wissen, één invariant verzwakken of wel aan de code-eis voldoen maar de eis inzake het responsformaat negeren.
U kunt probeer Grok 4.6 op GlobalGPT voor begrensde prompts en zij-aan-zij-vergelijkingen. GlobalGPT is een onafhankelijk platform; het vormt geen vervanging voor Grok Build, een IDE, toegang tot de repository, de native API-console van xAI of uw CI-pijplijn.
Wat we daadwerkelijk hebben getest
We hebben vier kleine JavaScript-taken geëvalueerd: het herstellen van het samenvoegen van intervallen, het opsporen van fouten in de op prioriteit gebaseerde stoeltoewijzing, het herstructureren van een functie voor het samenvatten van wijzigingen en het schrijven van tests voor een Retry-After parser. Elke taak had een vaste prompt en een deterministische lokale evaluator. Drie daarvan werden op 11 september 2026 uitgevoerd; voor de intervaltaken werd gebruikgemaakt van een run van 7 september, die we opnieuw hebben gecontroleerd aan de hand van de opgeslagen prompt, het ruwe antwoord en de evaluator.
- Locatie: Door de gebruiker geautoriseerde Broly-aggregatie-API, Chat Completions.
- Aangevraagd en teruggezonden model:
grok-4.6. - Pogingen: één verzoek per taak, zonder herhalingspogingen.
- Uitvoering: Het geretourneerde JavaScript werd geïsoleerd en lokaal uitgevoerd op basis van vooraf gedefinieerde fixtures of mutanten.
- Niet beschikbaar voor het model: een IDE, een repository, internettoegang, de mogelijkheid om xAI-tools uit te voeren en productiesystemen.
Het gateway-label biedt nuttige informatie over de herkomst, maar vormt op zichzelf geen bewijs voor de implementatie stroomopwaarts. De verstreken tijd omvat netwerk- en gateway-overhead, en de gerapporteerde tokenaantallen vormen geen basis voor officiële xAI-facturering. Zie het afzonderlijke document voor een breder overzicht op productniveau: Grok 4.6: beoordeling en praktijktests.
De resultaten van de programmeertest in één oogopslag
netto.Het beste resultaat was niet het langste antwoord. Het was de oplossing voor de stoelentoewijzing: beknopt, correct opgemaakt en gedragsmatig volledig. De meest leerzame mislukking was de refactor, omdat de implementatie er netjes uitzag en voldeed aan de eis van één doorloop, terwijl het uitvoercontract ongemerkt werd gewijzigd.
Test 1: het repareren van een merge-interval-functie
De eerste functie wijzigde de invoer, liep vast bij een lege array, slaagde er niet in aangrenzende eindpunten samen te voegen en kon een groter interval verkleinen wanneer er later een genest interval verscheen. De prompt maakte die invarianten expliciet.
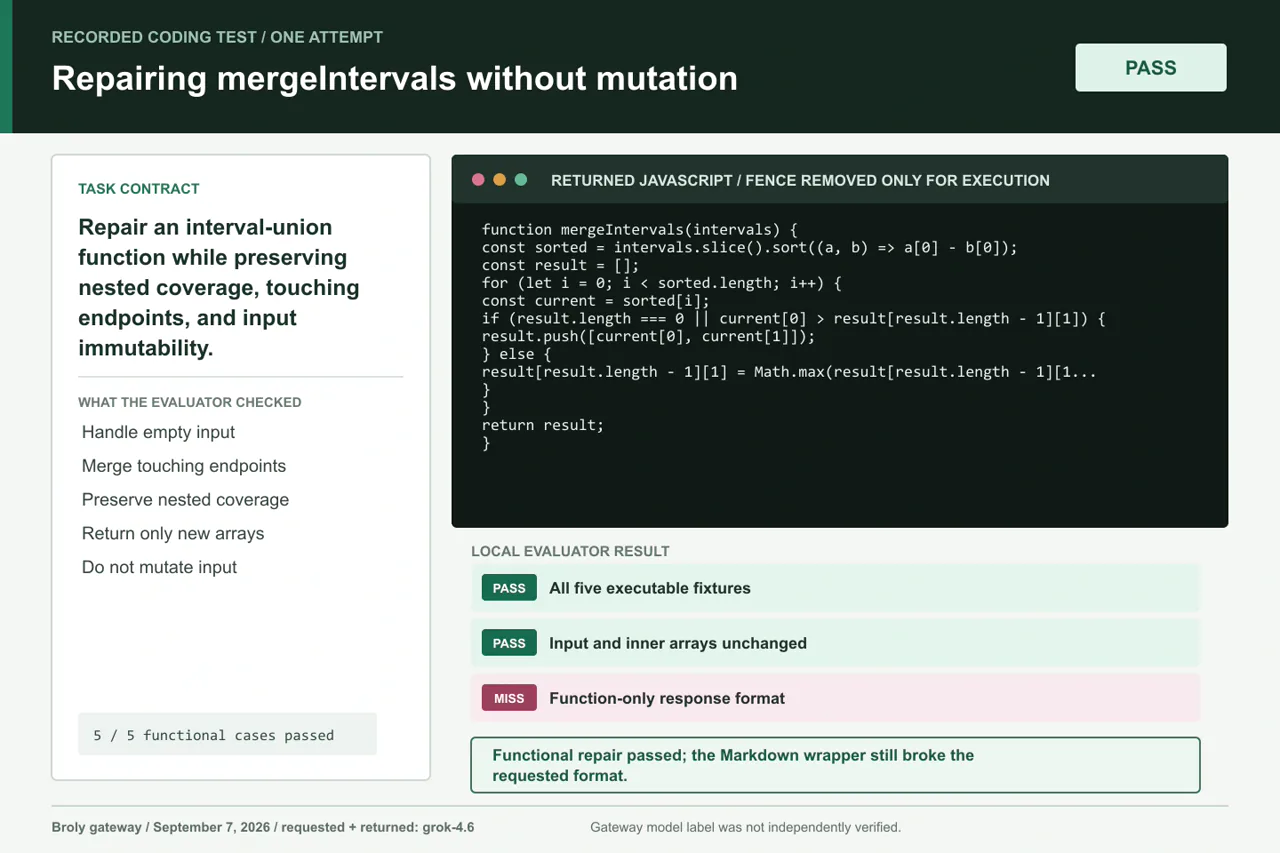
Belangrijke grens: De functionele reparatie is geslaagd nadat alleen de buitenste Markdown-omheining voor de uitvoering was verwijderd.
Resultaat: Alle vijf uitvoerbare gevallen zijn geslaagd. De functie retourneerde nieuwe arrays, bracht geen wijzigingen aan in de invoer, behield de geneste dekking en voegde aangrenzende eindpunten samen. Er mislukte nog steeds één expliciete instructie doordat de code in Markdown was ingepakt. Nadat alleen die buitenste afbakening voor de uitvoering was verwijderd, was het functionele resultaat correct.
Praktische tip: Grok kon een kleine reparatie goed aan toen de prompt de verborgen randgevallen noemde. De afwijking in het formaat is voor een mens onbeduidend, maar kan een pijplijn verstoren die direct uitvoerbare tekst verwacht.
Test 2: foutopsporing bij op prioriteit gebaseerde stoeltoewijzing
Deze opdracht combineerde het omgaan met gelijke waarden, aflopende prioriteit, geen mutaties, exacte capaciteit en een “overslaan en doorgaan”-regel. De oorspronkelijke code sorteerde in de verkeerde richting, wijzigde de invoerarray en stopte te vroeg toen één verzoek te groot bleek te zijn.
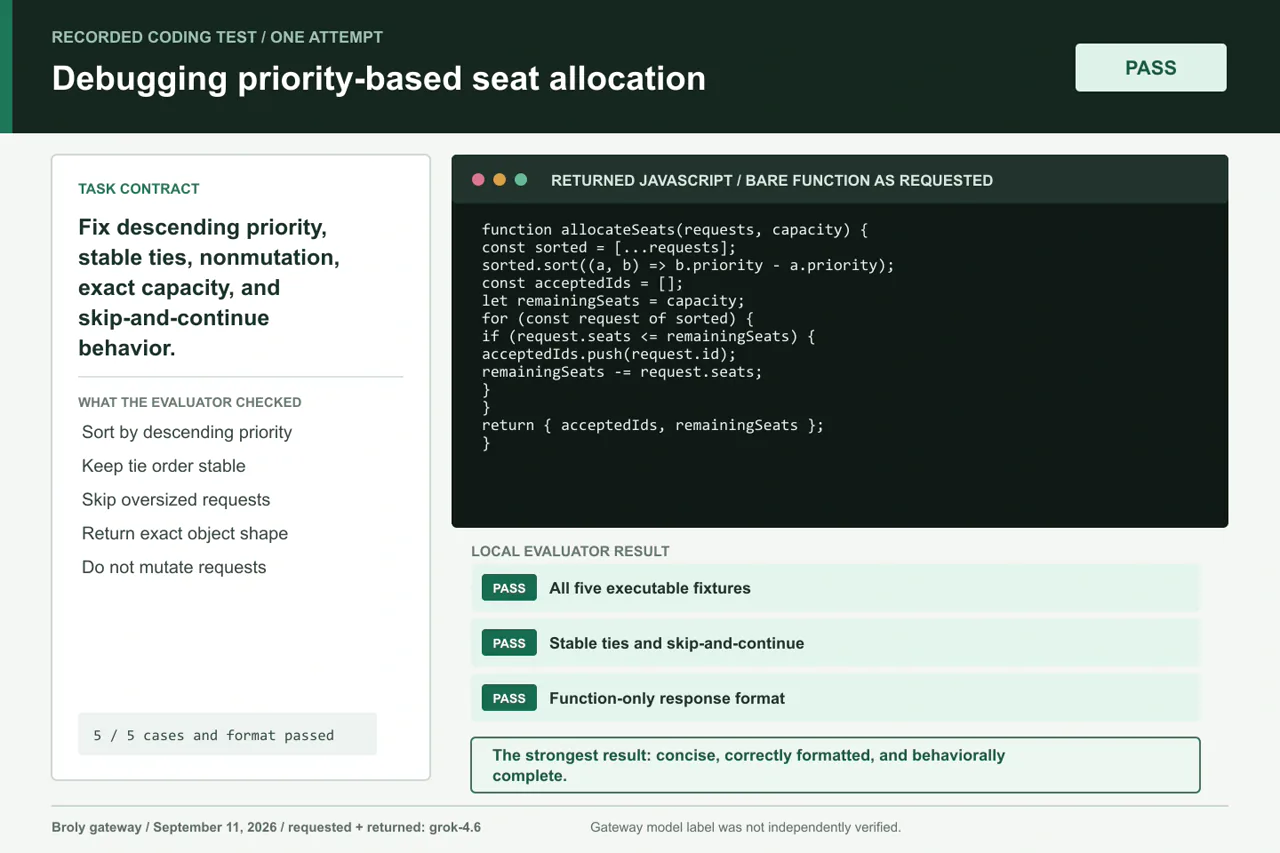
Belangrijke grens: Dit was het enige antwoord dat zowel aan de voorwaarden van het gedragscontract als aan het exacte uitvoerformaat voldeed.
Resultaat: alle vijf gevallen werden goedgekeurd, waaronder een volgorde met gelijke prioriteit, een te groot hoofdverzoek, exacte capaciteit, nulcapaciteit en een lege lijst. De invoer bleef ongewijzigd, geaccepteerde-ID's was een nieuwe array, en het model gaf alleen de gevraagde functie terug.
Praktische tip: Dit is precies het soort opdracht waar Grok uitstekend voor geschikt is: één functie, een duidelijk contract en randgevallen die direct kunnen worden uitgevoerd.
Test 3: refactoring zonder dat het gedrag verloren gaat
In de derde opdracht werd Grok gevraagd om herhaalde scans te vervangen door één aggregatieronde, met behoud van de volgorde, de ongebruikelijke bestandsnamen en de exacte vorm van de uitvoer. Dit is een realistisch risico bij het herstructureren van code: de code kan sneller en overzichtelijker worden, maar daarbij kan bepaald gedrag verloren gaan.
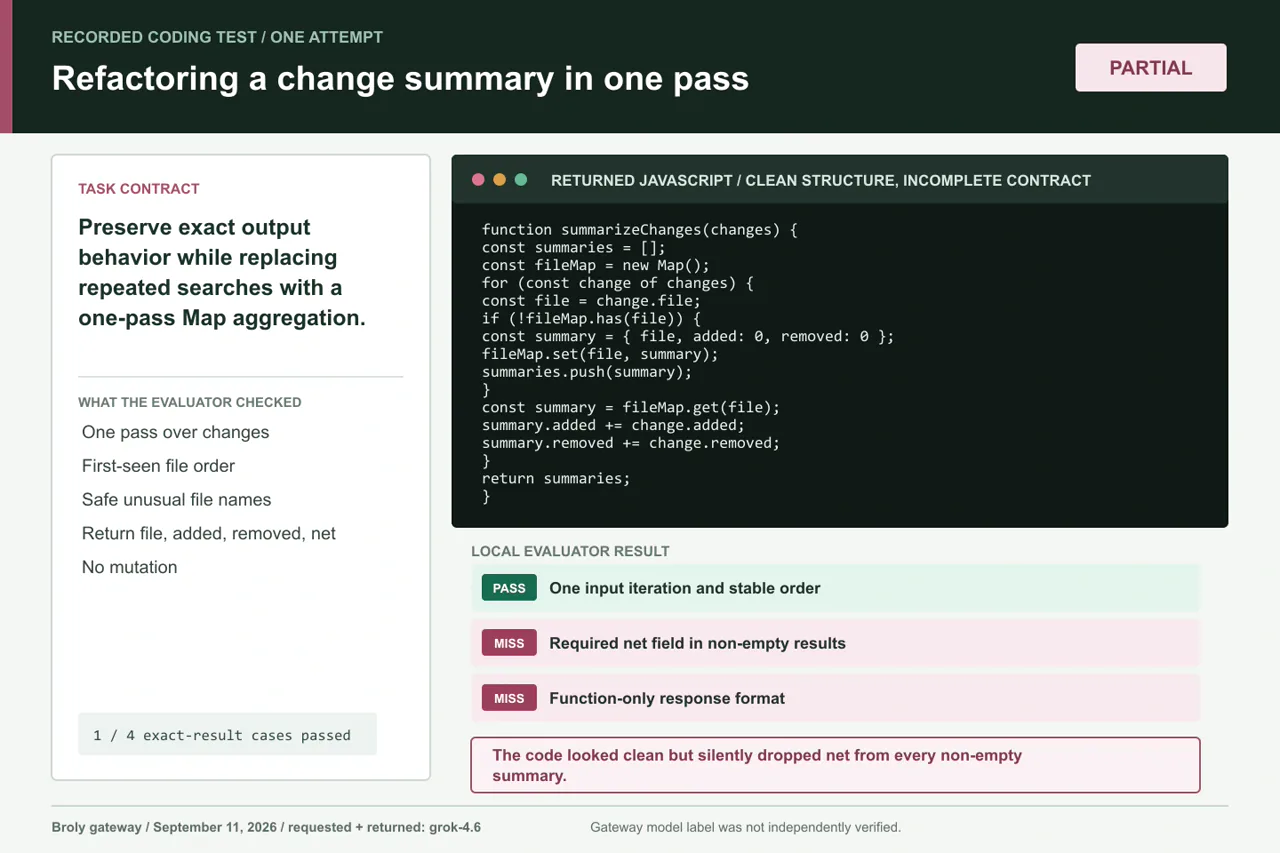
Belangrijke grens: De 'one-pass Map'-aanpak leek correct, maar liet het vereiste netveld ongemerkt weg.
Resultaat: de bewerking bestond uit één doorloop, een Kaart, de juiste volgorde bij de eerste weergave, veilige omgang met __proto__ en constructor, en er was geen invoermutatie. Maar het heeft nooit berekend of geretourneerd netto. Het lege geval werd goedgekeurd omdat het geen resultaatobjecten bevatte; alle drie de niet-lege gevallen voldeden niet aan de exacte vergelijking.
Praktische tip: Beoordeel een refactor nooit alleen op basis van algoritmische complexiteit of de netheid van de code. Maak een momentopname van de oude uitvoer, controleer of alle verplichte velden zijn ingevuld en vergelijk het gedrag voordat je de nieuwe versie accepteert.
Test 4: tests schrijven die aannemelijke fouten opsporen
Bij de laatste opdracht werd de gebruikelijke opzet omgedraaid: Grok schreef de tests, en ons testraamwerk voerde deze uit op één strikte referentie-implementatie en vier opzettelijk foutieve implementaties. Het doel was niet het bereiken van volledige dekking. Het ging erom of de gekozen invoergegevens onderscheid konden maken tussen semantiek die op het eerste gezicht op elkaar leek.
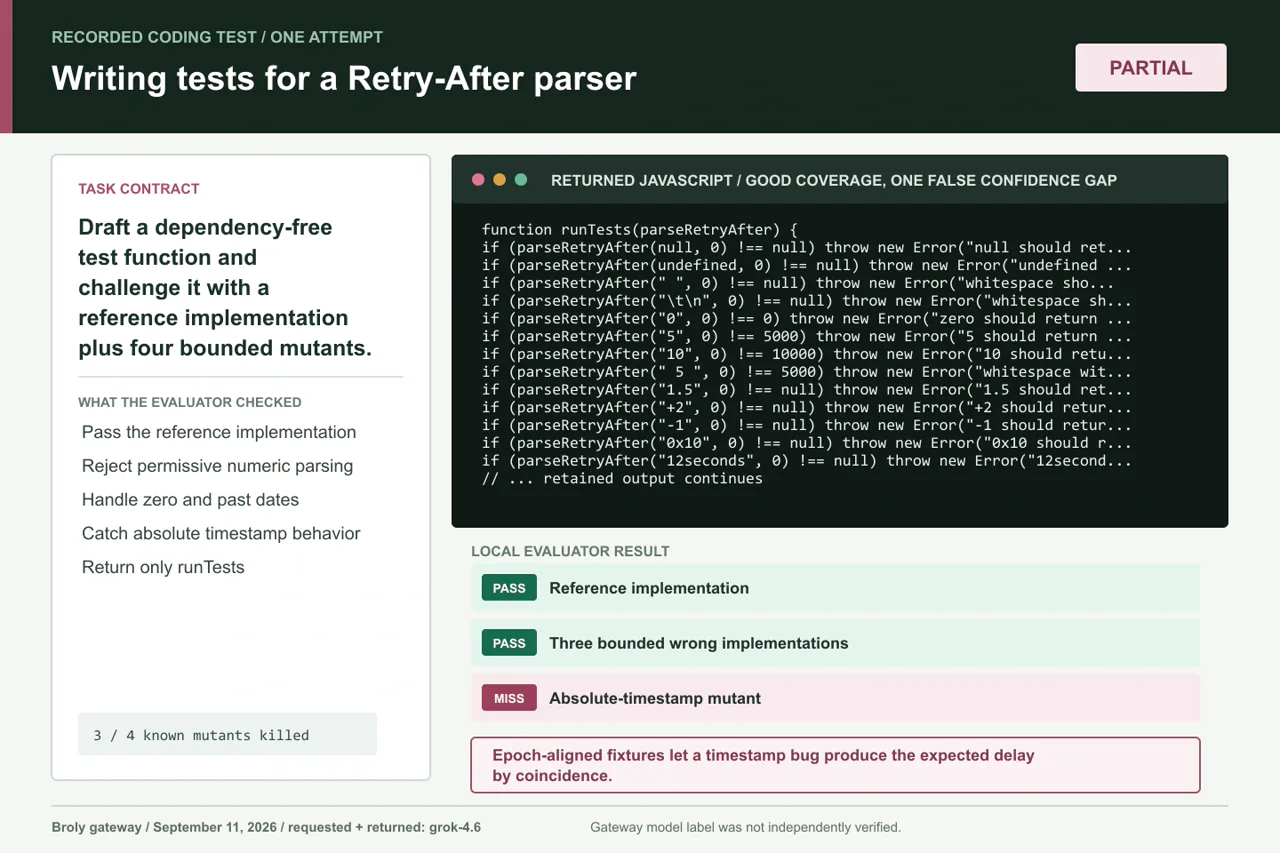
Belangrijke grens: Door op tijdperken afgestemde datumfuncties zorgt ervoor dat een bug met een absolute tijdstempel bij toeval blijft bestaan.
Resultaat: De suite slaagde voor de referentietest en detecteerde de tolerante numerieke parsering, waarbij nul als ‘falsy’ werd behandeld en een negatieve vertraging voor een datum in het verleden. De suite miste echter de afwijkende variant die de absolute tijdstempel van de geparseerde datum retourneerde. Bij beide datumtesten werden waarden gebruikt die waren uitgelijnd op de epoch, waardoor de verwachte vertraging toevallig gelijk was aan de tijdstempel.
Praktische tip: Door AI geschreven tests vormen een nuttige eerste stap, maar zijn geen bewijs van juistheid. Vraag jezelf af wat elke fixture precies onderscheidt. Mutatietests, eigenschapstests en opzettelijk niet-afgestemde waarden kunnen een testsuite blootleggen die alleen op het eerste gezicht grondig lijkt.
Grok 4, Grok 4.6 en Grok Build zijn niet hetzelfde
Lanceringscontext juli 2025. De oude API-slug werd later buiten gebruik gesteld.
Het label dat door de gateway wordt geretourneerd in deze vier afzonderlijke taken.
Een afzonderlijke agent die kan werken via een interactieve of headless repository-workflow.
Een Python-tool in een sandbox die moet worden ingeschakeld in een ondersteund verzoek.
De originele Grok 4 aankondiging betreft de historische context van de lancering. Het geeft geen beschrijving van het model dat bij onze tests in 2026 is gebruikt.
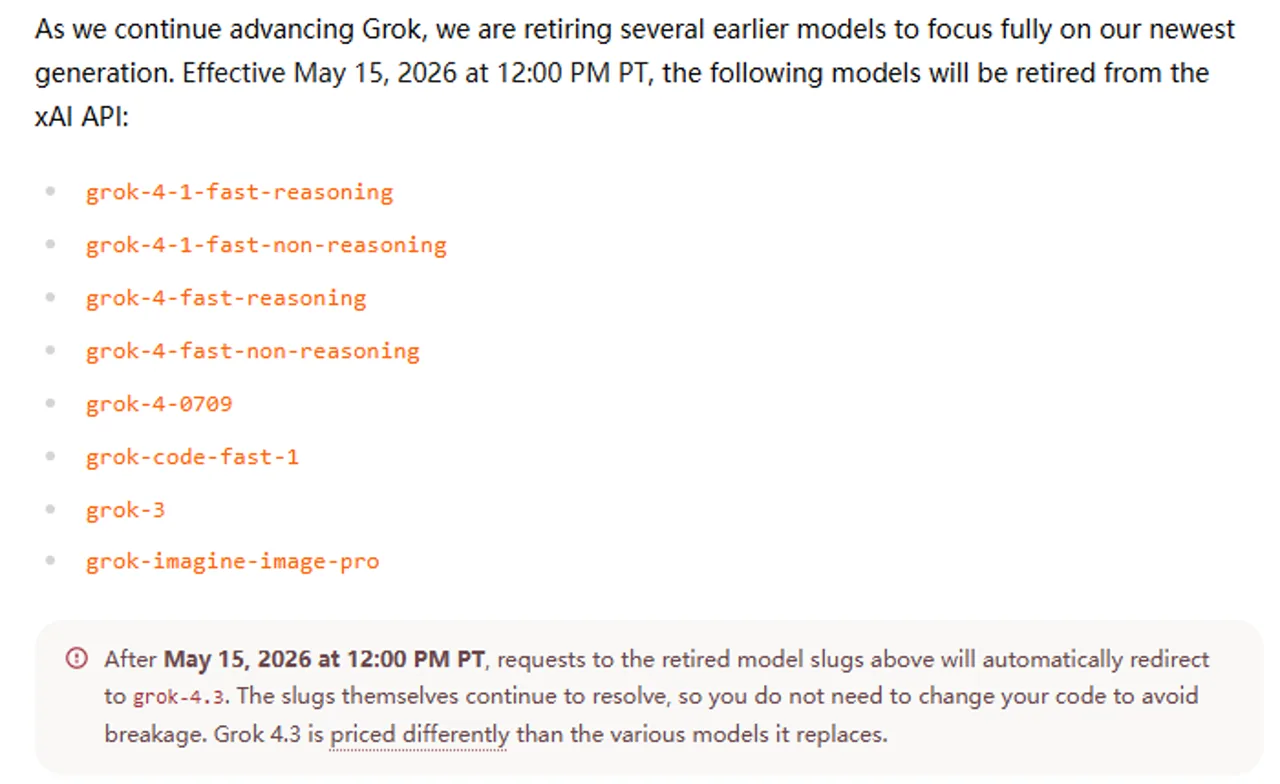
xAI’s Kennisgeving inzake migratie van 15 mei 2026 zegt grok-4-0709 leidt nu door naar Grok 4.3 met een lage redeneringsgraad. Dat betekent niet dat elk product met de naam Grok 4 uit de serie is verdwenen; het betekent dat het exacte modelnummer van belang is.
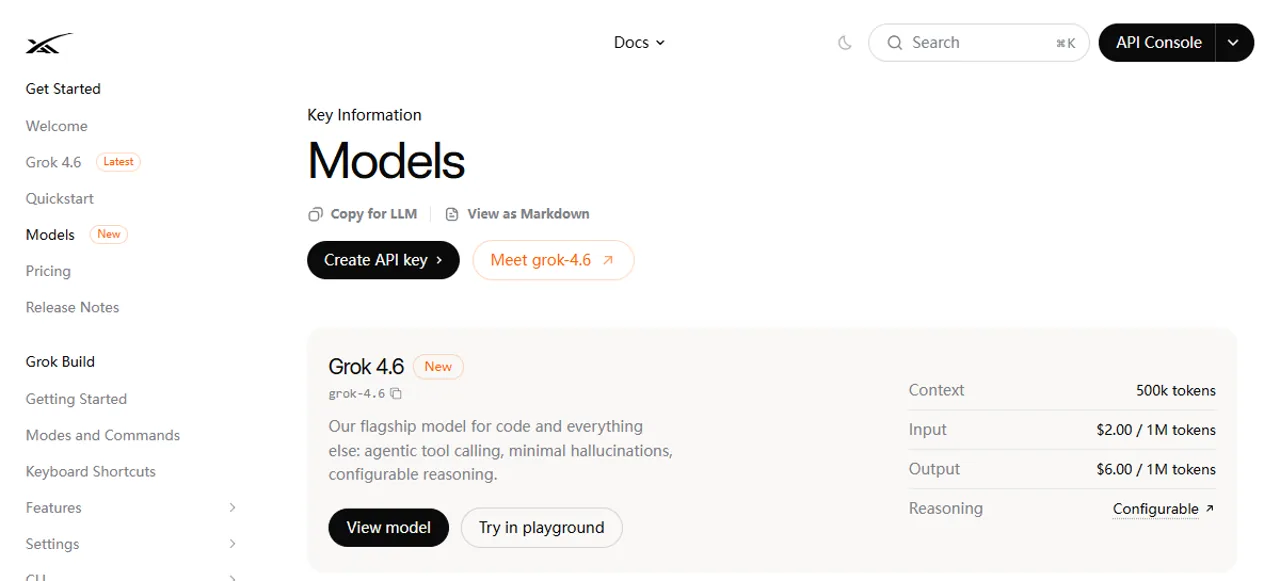
Grok 4.6 is het huidige model dat xAI aanbeveelt voor het schrijven van code. De officiële Grok 4.6 specificatie noemt onder de ondersteunde tools het aanroepen van functies, zoeken op het web, X-zoekopdrachten en het uitvoeren van code. Ondersteuning is niet hetzelfde als automatische activering: het aanroepende product of de API-aanvraag bepaalt nog steeds wat het model kan zien en doen.
De Aankondiging Grok 4.6 is het model geschikt voor langlopende agents en werkzaamheden aan de codebase. Dat is een officiële productclaim, niet iets wat onze vier afzonderlijke JavaScript-taken onafhankelijk van elkaar hebben gemeten.
Grok-uitvoering is het afzonderlijke coderingsprogramma. Dankzij de interactieve terminalinterface en de headless-modus kan het worden ingezet in een repository-workflow. Als je een keuze maakt uit modelnamen in plaats van coderingsproducten, dan is de het beste Grok-model per taak In deze gids wordt de huidige gezinssamenstelling uitgelegd.
De xAI-tool voor het uitvoeren van code is een optionele Python-omgeving in een sandbox. Deze was niet actief tijdens onze Broly-tests, waardoor het model geen eigen JavaScript uitvoerde en de feedback van de evaluator niet controleerde voordat het antwoord gaf.
De beste toepassingen voor Grok
Een geïsoleerde fout opsporen
Grok komt het best tot zijn recht wanneer het probleem kan worden teruggebracht tot een functie, een stacktrace, een defecte testcase of een korte diff. Geef aan wat er zou moeten gebeuren, wat er daadwerkelijk is gebeurd en welke grenzen je niet gewijzigd wilt zien. Het resultaat van de stoeltoewijzing laat zien hoe een specifiek randgeval een vaag verzoek als “los dit op” kan omzetten in een verifieerbare patch.
Een eerste implementatie maken
Voor adapters, parsers, transformatiefuncties en API-voorbeelden kan Grok de drempel van een lege pagina wegnemen. Vraag naar de kleinste complete eenheid en de versies van de pinbibliotheek, en voer het codefragment uit. De Grok 4 Handleiding voor API-integratie is de volgende stap wanneer het werk betrekking heeft op de API in plaats van op een op zichzelf staande codeoplossing.
Toetsen nakijken of opstellen
Vraag Grok om ontbrekende grensgevallen, invarianten en kandidaatmutanten. Controleer vervolgens of elke invoer het gedrag onderscheidt dat hij beweert te testen. De Retry-After-testsuite was op papier uitgebreid, maar door één paar uitgelijnde tijdstempels kon een semantische fout toch blijven bestaan.
Vergelijking van alternatieve benaderingen
Grok is ook nuttig als tweede mening over een algoritme, gegevensstructuur of hypothese voor het opsporen van fouten. Wanneer het gaat om de geschiktheid van een assistent in plaats van om één specifieke aanpassing, dan is de Vergelijking van de codering van Grok en ChatGPT voegt een modeloverschrijdend overzicht toe.
Wanneer de Grok-codering toezicht vereist
Refactoren waarbij het gedrag behouden blijft: Het model kan aan de vereisten van het algoritme voldoen, hoewel er één uitvoerveld ontbreekt. Voer regressietests uit en vergelijk de geserialiseerde uitvoer, fouten, volgorde, mutaties en neveneffecten.
Wijzigingen in de repository met meerdere bestanden: Ons bewijsmateriaal heeft geen betrekking op het opsporen van afhankelijkheden, buildsystemen, het doorzoeken van code, gegenereerde bestanden, migraties of gecoördineerde bewerkingen. Gebruik een echte codeeragent met beperkte toegang tot de repository en bekijk vervolgens de opdrachten en diff’s ervan. De Vergelijking tussen Codex en Claude-codeagent laat zien waarom de omringende workflow net zo belangrijk is als het model.
Beveiligings- en productieactiviteiten: Beschouw een bevestigend antwoord niet als een bedreigingsmodel, een afhankelijkheidscontrole of een goedkeuring voor implementatie. Houd CI, statische analyse, het scannen van vertrouwelijke gegevens, staging, rollback en menselijke controle in het proces betrokken.
Strikte machine-naar-machine-formaten: In drie van de vier onbewerkte reacties werd een Markdown-omranding gebruikt, ondanks expliciete instructies om geen Markdown te gebruiken. Controleer en analyseer de uitvoer aan de rand; geef modeltekst nooit rechtstreeks door aan de uitvoering omdat deze op code lijkt.
Kosten en lange redeneringsketens: onze gateway heeft 4.260 voltooiingstokens gerapporteerd voor een verzoek met max_tokens: 4096, voornamelijk als redeneer-tokens. Die constatering bewijst nog niet dat xAI een facturerings- of limietbeleid hanteert. Bekijk de huidige officiële website en vergelijk deze met de Grok 4: Handleiding voor prijsstelling en configuratie van de API voordat er een productiebudget wordt geraamd.
Een praktische werkwijze voor het gebruik van Grok in code
1. Het probleem beperken
Geef voor Grok de kleinst mogelijke stap waarmee de fout nog steeds optreedt. Vermeld de foutmelding, de relevante code en één verwacht resultaat. Verwijder niet-relevante projectgeschiedenis en vertrouwelijke gegevens.
2. Stel een contract op, geen verlanglijstje
Geef de functienaam, de toegestane invoer, de exacte vorm van de retourwaarde, de volgorde, de mutatieregels, de afhankelijkheidslimieten en het uitvoerformaat op. De Gebruiksaanwijzing voor de Grok 4-gids behandelt het bredere overzicht en de workflow voor het genereren van prompts.
3. Vraag om wat wisselgeld
Geef de voorkeur aan één functie of één gerichte aanpassing boven een ingrijpende herschrijving. Vraag of het openbare gedrag behouden blijft en geef aan welke aannames er moesten worden gedaan.
4. Voer onafhankelijke controles uit
Voer de code buiten de modelrespons uit. Voeg randgevallen toe die onderling vergelijkbare semantiek onderscheiden, controleer wijzigingen in de invoer, vergelijk elk uitvoerveld en test verwachte fouten. Voer bij gegenereerde testsuites bekende mutaties uit wanneer het risico dit rechtvaardigt.
5. Bekijk de verschillen en neem de beslissing
Lees de definitieve diff alsof deze afkomstig is van een menselijke bijdragende. Controleer wijzigingen in afhankelijkheden, beveiligingsgrenzen, observeerbaarheid en de mogelijkheid tot terugdraaien. De persoon die de wijzigingen samenvoegt of implementeert, blijft verantwoordelijk voor het resultaat.
Wat ontwikkelaars in het openbaar melden
De ervaringen van het publiek lopen uiteen en zijn sterk afhankelijk van de taak, het product, de vraag en de datum. Twee reacties op Hacker News illustreren deze verscheidenheid, maar geen van beide vormt een maatstaf of een representatief onderzoek.
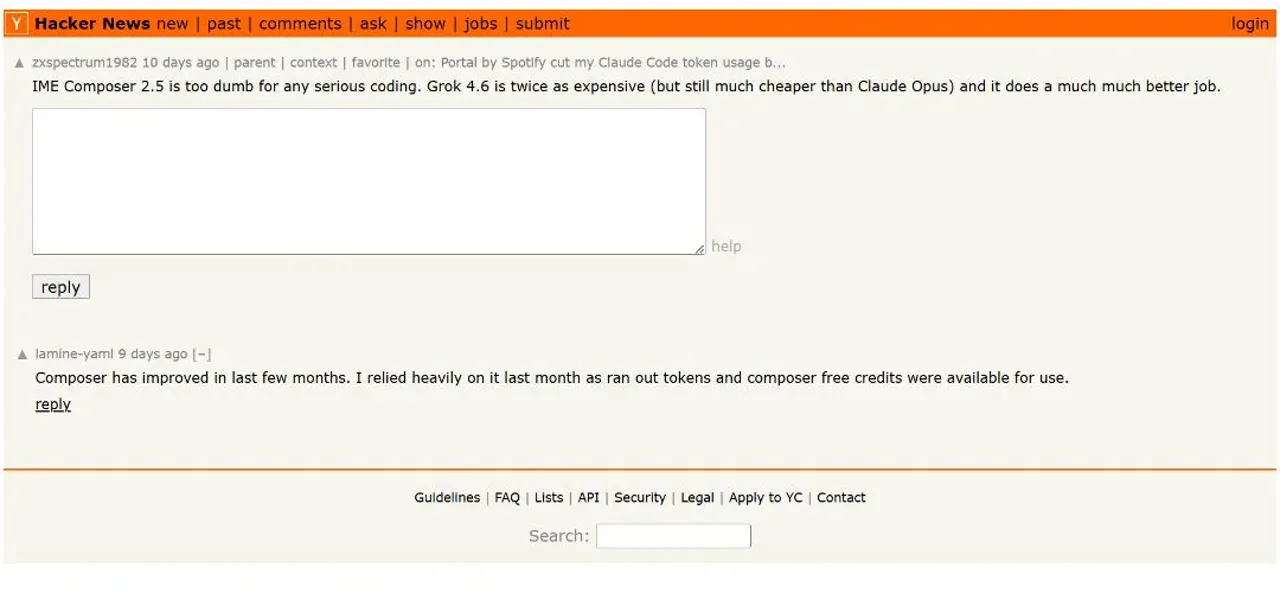
Op 5 september 2026 heeft een gebruiker van Hacker News zxspectrum1982 beschreef Grok 4.6 als een programma dat bij serieus programmeerwerk veel beter presteert dan Composer 2.5, maar merkte tegelijkertijd op dat het duurder is. Dit is de vergelijking van één gebruiker, geen algemene uitspraak over de prestaties.
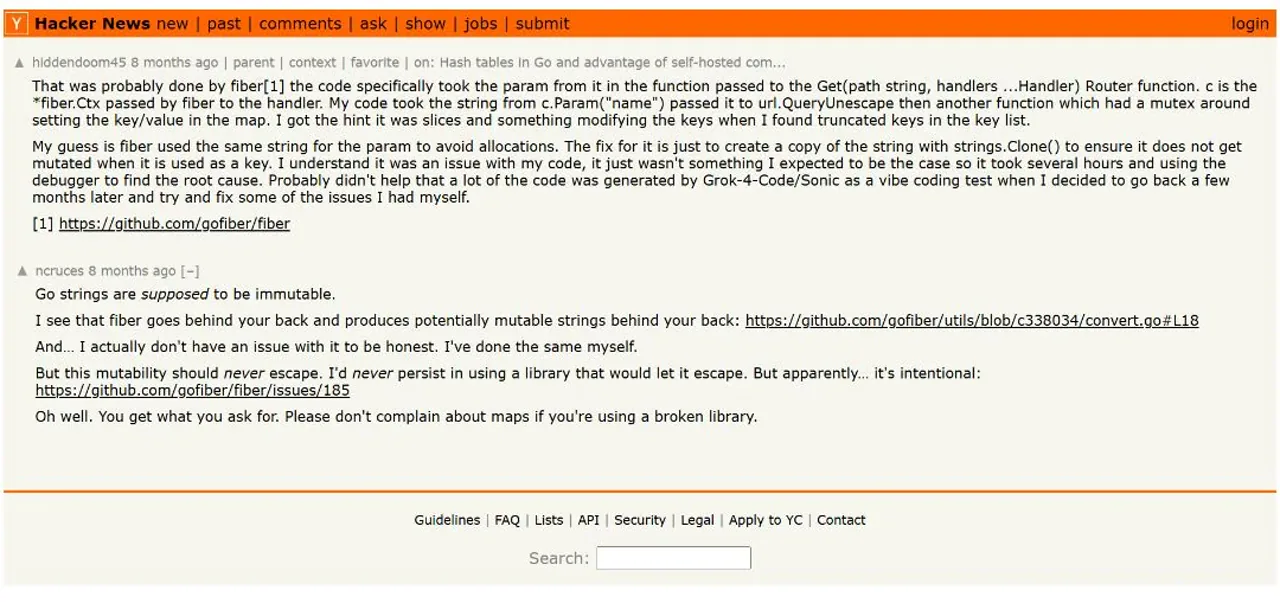
Op 20 december 2025 heeft een gebruiker van Hacker News hiddendoom45 beschreef hoe hij later met een debugger een subtiele bug in de levensduur van Go/Fiber-strings had ontdekt, nadat er code was gegenereerd tijdens een Grok-4-Code/Sonic-experiment. Dit historische verslag pleit voor handmatige debugging en beoordeling waarbij rekening wordt gehouden met de levensduur; het levert echter geen bewijs op voor een uitvalpercentage van Grok 4.6.
De rode draad is niet dat Grok altijd slaagt of mislukt. Het is dat de kwaliteit van de code pas zichtbaar wordt nadat de code is getoetst aan een concrete taak, toolchain en beoordelaar. Hetzelfde geldt voor de afzonderlijke ChatGPT: een realiteitscheck van de codering: Kwaliteitscontrole is onlosmakelijk verbonden met verificatie.
Veelgestelde vragen
Is de Grok 4 geschikt voor beginners op het gebied van programmeren?
Ja, voor uitleg, korte voorbeelden en begeleide foutopsporing. Beginners moeten toch elk codefragment uitvoeren, vragen wat elke regel verandert, en vermijden om vertrouwelijke gegevens te plakken of onbekende code te implementeren zonder deze eerst te controleren.
Welk Grok-model moet ik gebruiken voor het programmeren?
Op 11 september 2026 heeft xAI Grok 4.6 aanbevolen als code. Controleer de exacte model-ID van uw product, aangezien de oorspronkelijke API-slug „grok-4-0709“ niet meer wordt gebruikt.
Kan Grok 4.6 een volledige repository bewerken?
Het model kan ondersteuning bieden bij repository-werkzaamheden wanneer het wordt gebruikt binnen een agent met beperkte toegang tot bestanden en opdrachten. Onze tests bestonden uit afzonderlijke prompts; ze tonen dus niet aan dat het model geschikt is voor het autonoom verwerken van meerdere bestanden of voor gebruik in een productieomgeving.
Is ‘Grok Build’ hetzelfde als het gebruik van ‘Grok’ in de chat?
Nr. Grok Build is een afzonderlijke interactieve of headless codeeragent. Bij een gewone chat of API-afhandeling worden de repository-context, de terminal, de machtigingen of de tool-loop niet automatisch overgenomen.
Kan ik Grok 4.6 gebruiken voor het coderen op GlobalGPT?
Ja. GlobalGPT biedt een geverifieerde Grok 4.6-route voor begrensde coderingsopdrachten en modelvergelijkingen. Het is een onafhankelijk platform en vormt geen vervanging voor Grok Build, een IDE of de native API-tools van xAI.
Moet ik de door Grok gegenereerde code vertrouwen zonder deze te testen?
Nee. Voer de code uit, voeg randgevallen toe, bekijk het verschil en voer je gebruikelijke lint-, type-, beveiligings- en CI-controles uit. Onze refactor zag er netjes uit, maar in elk niet-leeg resultaat ontbrak een verplicht veld.
Eindoordeel
Is Grok 4 geschikt voor codering? Het huidige Grok 4.6-model is een capabele programmeerassistent voor beperkte reparaties, kleine functies, uitleg en eerste-ronde-tests. In onze reeks van vier taken leverde het twee volledig correcte oplossingen op, één refactor die het gedrag verstoorde en één onvolledige testsuite. Daarnaast negeerde het in drie antwoorden een strikte instructie om geen Markdown te gebruiken.
Gebruik dit waar het opsporen van fouten weinig kost: een beperkte reikwijdte, expliciete afspraken, uitvoerbare testopstellingen en menselijke controle. Beschouw dit bewijs niet als toestemming voor wijzigingen in de repository zonder toezicht, goedkeuring op het gebied van beveiliging of implementatie in de productieomgeving.
Voor een praktische proef, open Grok 4,6 op GlobalGPT, voer een van de bovenstaande volledige opdrachten uit en vergelijk de uitvoer met je eigen tests voordat je beslist of deze in je workflow thuishoort.