簡単な答え: 毎週繰り返す業務を確実に改善してくれるAIには、お金を払う価値があります。情報源が重要な場合、Perplexityスタイルのリサーチにはお金を払う価値があります。 一日中、戦略の策定や分析、執筆の修正に追われているなら、高性能な汎用モデルにお金を払う価値があります。コーディングモデルは、編集・テスト・レビューのループにうまく組み込めるなら、お金を払う価値があります。画像や動画のモデルは、その出力によって制作時間を短縮できるなら、お金を払う価値があります。.
このガイドは、公式の製品リファレンス、ある著名な独立系開発者メディアによる観察結果、および2026年9月1日に実施された小規模な実機比較をまとめたものです。テストは意図的に範囲を絞っており、各モデルにつき1つの共通プロンプトと1つの出力に限定されています。そのため、ワークフロー上の有用な違いを明らかにする一方で、 ない 普遍的な順位付けを証明する。. 開示事項:本出版物はGlobalGPTが運営しています。.
引用文献や最新の情報源を購入する。.
異議を申し立てられる修正サービスをご購入ください。.
実際のループ内でフィードバックを取得してください。.
生産に代わる成果物を購入する。.

AIを購入する際に、実際に何に対してお金を払っているのか
たまに作業をするだけなら、無料プランで十分です。有料プランでは、変更を行うと収益が得られます。 運営コスト 作業上のメリット:ブラウザのタブ数が減る、手作業による初稿の作成回数が減る、フィードバックのループが速くなる、最新情報へのアクセスが容易になる、あるいは最初から完成度に近い成果物が得られることなどです。大きな損失となるのは、利用料を支払ったにもかかわらず、そのサービスを単なる目新しさのある検索ボックスのようにしか使っていない場合です。.
どのAIにお金を払う価値があるかを見極める方法
「どのモデルが最も優れているか」という問いは誤りです。有用な問いは、「どのサブスクリプションなら、レビューにかかるオーバーヘッドを最小限に抑えつつ、繰り返し発生するボトルネックを解消できるか」というものです。競合調査の結果を引用する必要がある創業者は、リポジトリのデバッグを行うエンジニアや、毎週プロダクト資産を作成するマーケターとは、購入の判断基準が異なります。 まずは繰り返し行っているタスクを3つ挙げて、同じ実際の要件に基づいて各候補を検証することから始めましょう。.
少なくとも週に1回は課題をこなしています。.
良い結果と悪い結果は一目で区別できます。.
節約できる時間は、切り替えや確認にかかる時間を上回ります。.
調査:Perplexityは有料にする価値があるか?
市場に関するリアルタイムの質問については、洗練された文章よりも調査能力を優先して購入すべきです。Perplexityは「調査第一」のサービスであり、その価値は、出典が明記され、確認可能な回答にあるのであって、出典不明の自信満々な要約にあるのではありません。そのため、アナリスト、バイヤー、ライター、そして情報源を重視した報告書を作成するチームにとって、信頼性の高い有料サービスとなっています。 この点において、Perplexityの役割をGeminiと比較してみてください。 Gemini と Perplexity の機能比較, 、そしてこのリストを 当惑の代替案 別の研究ワークフローが必要な場合。.
単にメールを書いたり、すでにノートパソコンにあるメモを要約したりするためだけに、リサーチプランを購入してはいけません。その投資対効果は、根拠の乏しい、あるいは裏付けのない主張のコストが高くなるほど高まります。実際には、リサーチを活用して情報源を収集・検証し、その証拠を推論モデルに引き渡して意思決定メモを作成するようにしてください。こうした役割分担を行うことで、誤りを発見しやすくなります。.
GPT、Claude、Gemini:戦略テストが実際に示したこと
私たちは、GPT-5.6 Sol、Claude Sonnet 5、およびGemini 3.6 Flashの各チームに、同じ制約条件付き要件を提示しました。その内容は、「2名のエンジニア、固定予算、SSO導入に関する営業部門からの要望、およびオンボーディングの不備という条件下で、6週間以内にB2B分析機能を立ち上げる」というものでした。 各回答では、前提条件を明らかにし、6週間の計画を策定し、潜在的なリスクを特定し、経営陣向けの進捗報告を作成することが求められました。これは1回限りの作業サンプルであり、ベンチマークではありませんでした。.
“「実用可能な最小限の分析ワークフローを定義」し、チームを投入する前に、SSOを範囲に含めるか、パイロット限定とするか、あるいは延期するかを決定してください。.
“「新しい分析機能を開発し、原因が特定されていないオンボーディングの問題を解決し、さらにエンタープライズSSOを立ち上げるといったことを、すべて同じ期間内に、かつ最高品質で実現することはできません。」”
2人の開発者の役割を「オンボーディングの安定化」と「分析データの基盤構築」に分担し、その後数週間かけて統合する。.
コンプライアンス、リリース基準、成功指標などを盛り込んだ、最も包括的な前提条件リストを作成した。ただし、パフォーマンス指標を新たに策定したわけではない。.
容量面でのトレードオフを最も明確に判断した:カスタムSSO、分析機能、および未解決のオンボーディングを、2人のエンジニアによる1回のリリースに無理に詰め込まないこと。.
週ごとの開発者割り当てについて最も明確な説明を行いましたが、要件書には記載されていなかった「既成のダッシュボード」や「データの分離」を前提としていました。.
購入時の注意点: 幅広い前提条件の検証を重視する場合は、GPTが有力な第一候補となります。的確な編集判断が求められる場合はClaude、体系的な納品計画が重要となる場合はGeminiが適しています。決定する前に、ご自身のブリーフを改めて確認してください。GPTへのアクセス方法や計画の詳細については、 GPT-5.6 価格ガイド そして GPT-5.6モデルの比較.
現在のプランや機能の詳細を確認するには、公式製品ページが依然として最適な場所です: チャットGPT, クロード, そして ジェミニ. 各ベンダーが現在提供している内容については、製品ページで説明されています。上記のテストでは、この特定の制約付きプロンプトに対して、これら3つの実行がどのような結果を出したかを記録したに過ぎません。.
主要なモデルファミリーがさまざまな種類の業務にどのように適合するか
分析、草案作成、データ解釈、計画立案、問題解決といった業務を横断して取り組む人にとって最適な最初の計画です。その計画が前提条件を明確に示しているか、また直接的な批判を受けた後に改善されるかどうかを評価してください。.
注目すべき点: 出典の確認や専門分野による検証が必要な、洗練された回答。.
成果物が論証、概要、書き直し、方針、あるいは編集上の決定などであり、細かなニュアンスや明確なトレードオフが、単にタスクを最大限に列挙することよりも重要となる場合、このアプローチが適していることが多い。.
注目すべき点: 出典を確認せずに、雄弁な文章を事実に基づく研究として扱うこと。.
計画や表、タスクの細分化を望む人にとって便利なツールです。特に、すでにGoogleの各種サービスを活用して業務を行っている場合には適しています。実装の詳細を前提とせず、情報が不足している場合の処理方法をテストしてください。.
注目すべき点: 検証されていない前提に基づいた、一見妥当に見える計画。.
技術的な作業、コーディング、バイリンガルでの利用、およびコスト効率を重視した実験においては、比較検討する価値があります。どの方法が適切かは、使用する言語やインターフェース、そしてそのレスポンスがテストスイートに耐えられるかどうかによって異なります。.
注目すべき点: サブスクリプション費用を節約できる一方で、余分なレビューやツールとの適合性の悪さによって時間を浪費してしまう。.
タスクの開始時に、最新かつ出典が明記された回答があれば、その時点で支払います。その利点は、思考に取って代わるということではなく、証拠の収集や出典の確認をより迅速に行える点にあります。.
注目すべき点: 出典元を開かずに引用を受け入れること。.
繰り返し発生する企画書やブランドの制約、修正プロセスが整って初めて、専門家の存在価値が発揮されます。彼らが最初に提出するのは、通常、承認待ちの完成品ではなく、方向性です。.
注目すべき点: 単発のプロジェクトでは反復開発のコストが見合わない場合、モデルに費用をかけること。.
技術的な作業においても、同様のルールが当てはまります。大規模な自律的なタスクを実行する前に、小規模で代表的なタスクを実行してみましょう。診断、最小限の変更、テスト計画、そして未解決のリスクについて確認してください。優れたモデルの振る舞いとは、単にコードを生成することではなく、製品ポリシーやリポジトリのコンテキストが依然として必要とされる箇所を明らかにすることです。だからこそ、 DeepSeek V4 Pro レビュー そして GLMコーディング計画のレビュー これらは、単なる「最高のコーディングAI」といった一般的な主張よりも、次に読むのに役立つ記事です。.
コーディング:レビューのループを改善するモデルに投資する
コーディングにおいて、インターフェースはモデルとほぼ同等に重要です。そこで、GPT-5.6 SolとDeepSeek V4 Proに、あるJavaScriptの診断と最小限の修正を依頼しました。 合計(アイテム数) 機能。価格や数量の欠落、無効、または非正の値に対して明確なエラー表示を行い、3つのテストとリスクに関する注意事項を備えています。GPT-5.6 Solは、以下を用いてコンパクトな実装を行いました。 Number.isFinite, 、インデックス付きのエラーメッセージ、Nodeのアサーション、および小数に関する適切な注意事項。DeepSeek V4 Proは、 NaN trapは、当初やや手薄だった防御体制を修正し、 Number.isFinite, 、さらに、配列の検証が行われていない点についても指摘した。.
GPT-5.6 Sol:検証修正(テストが実行可能)
共有タスクの課題文
返された実装
GlobalGPTで確認された事項:出力には、残りのポリシー決定事項として小数点以下の数値が明示的に保持されていました。リリース前に、ご自身のリポジトリでテストを行ってください。.
だからといって、どちらかがコーディングにおいて万能な解決策だということにはなりません。これは、有能な有償のコーディングアシスタントであれば、検証の範囲を説明し、実行可能なテストを提供し、残された方針決定事項を隠すのではなく、それを明確に指摘すべきであることを示唆しています。続きを読む DeepSeek V4 Pro レビュー そして GLMコーディング計画のレビュー ルート固有のコンテキストについては、Kimi Codeの 公式コーディングページ CLIの利用が中心となる場合、検討する価値のあるもう一つのワークフローです。.
開発者は有料のコーディングAIをどのように評価すべきか
「ToDoアプリを作る」といった、まったくの白紙状態からのプロンプトを使って、コーディングAIを評価してはいけません。 自分が理解しているリポジトリから、範囲が限定されたタスクを選びましょう。例えば、失敗しているテスト、特定の部分に限られたバグ、不完全な検証ルール、あるいは実際のコードに関連するドキュメントの更新などです。アシスタントには、何かを変更する前に、それが必要だと考えている動作を改めて説明するよう求めましょう。そうすることで、タスクを注意深く読んだのか、それとも使い慣れたテンプレートを適用しているのかが明らかになります。.
次に、4つの点を確認してください。第一に、症状と根本原因を区別しているか。第二に、無関係なモジュールをリファクタリングするのではなく、最小限かつ首尾一貫した修正案を提案しているか。 第三に、元のバグでは失敗し、修正後は成功するテストを生成しているか?第四に、丸め処理、認証、下位互換性、エラーメッセージのポリシーなど、未決定の製品に関する決定事項を明記しているか?これらの質問は、単なる「コードが書けるか?」という一般的な評価よりも有用です。なぜなら、これらはレビューにかかる時間に直接結びつくからです。.
提供形態によって経済性は変わります。診断やコードの説明、短いスニペットのやり取りにはチャットウィンドウで十分です。一方、ファイル、コマンド、テストの間でコンテキストを安全に移動させる必要がある場合、エディタ、CLI、あるいはMCPと連携したワークフローの価値が高まります。 しかし、アクセス権限が深まることは、レビューのハードルも引き上げます。アシスタントが適切な用語を使ったという理由だけで、通常のテスト、権限設定、コードレビューを無条件に無効にしてはいけません。多くのチームにとって、最も費用対効果の高い仕組みとは、適切な草案作成と説明を行うモデルに加え、変更をリリースするかどうかを決定する既存のエンジニアリング管理策を組み合わせたものです。.
GPT Image 2 対 Nano Banana 2:製品画像テスト 1 件
両方のモデルに対して、同じ制作要件を適用しました。「マットなネイビー色の再利用可能なステンレス製ボトル、淡い石の色調、自然光、ほのかな結露、テキストやロゴなし」という、ECサイト用のシンプルなメインビジュアルです。 GPT Image 2は、ネイビーのボトル、ロゴなしという要件、および結露の表現は維持していましたが、シンプルなカタログ風のシーンというよりは、アウトドアや海を彷彿とさせるライフスタイルの背景へとシフトしていました。Nano Banana 2も、ボトルをネイビーでロゴなしの状態に保ち、より屋内的な製品写真の構図を採用していましたが、どちらの出力結果も、要求された淡い石の表面を厳密に再現できていませんでした。.
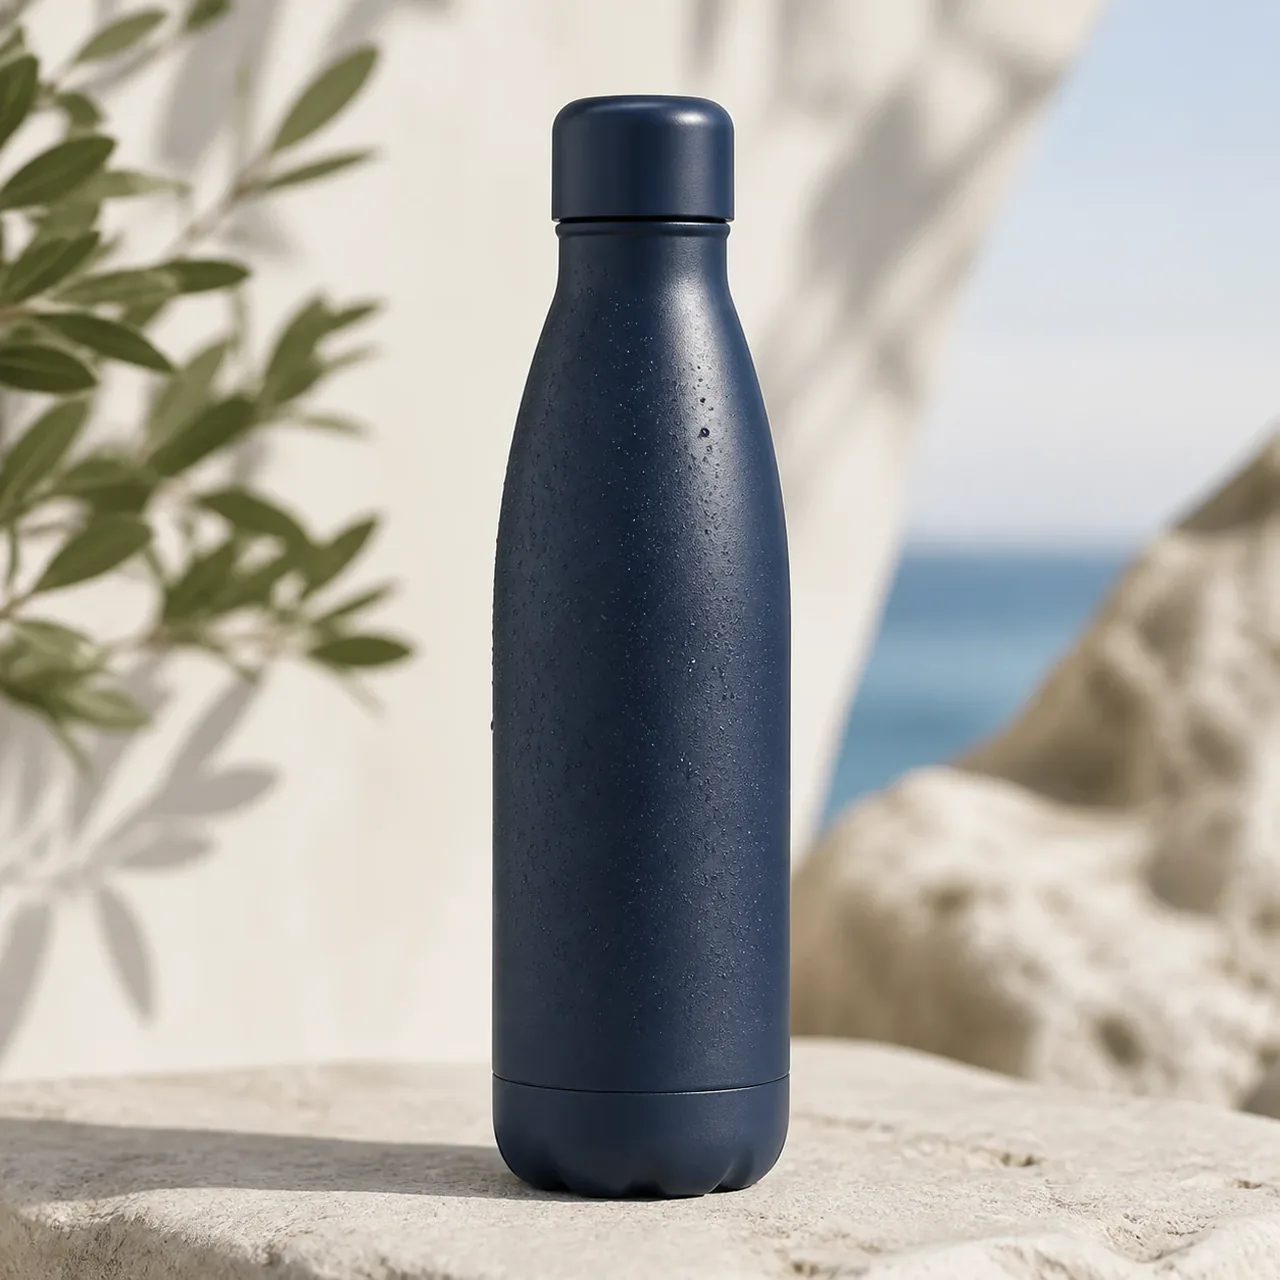
結露の描写がより精緻で、シーンの雰囲気はカタログ風というより、ライフスタイル寄りに仕上がっていた。.
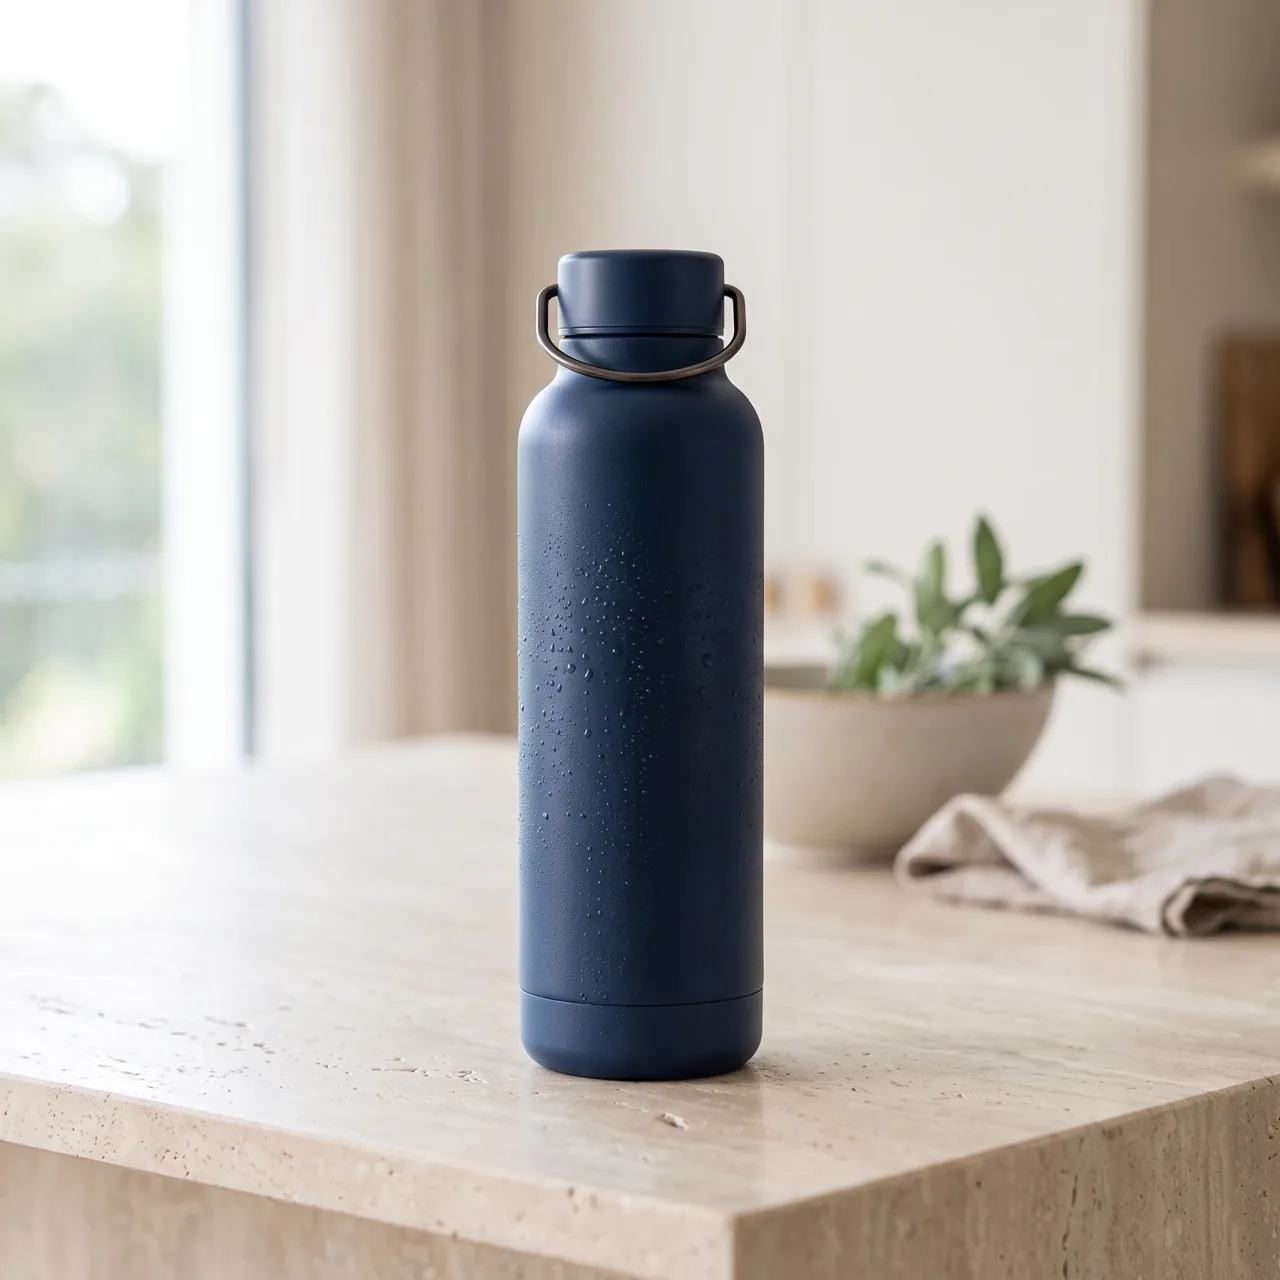
商品写真の構図についてさらに検討が必要だ。それでも、淡い色の石に関する指示を見落としてしまった。.
実用的な教訓としては、不具合が発生した際に迅速に修正できる画像モデルに投資すべきだということです。この1つのプロンプトについては、どちらの出力も修正なしでは公開できる状態ではありませんでした。プランを選択する前に、自社のブランドカラー、テキスト、参照画像、編集指示を必ずテストしてください。.
画像モデルに報酬を支払う前に確認すべきこと
クリエイティブの評価は、単にその画像が単独で見栄えが良いかどうかを問うだけにとどまらず、より厳格であるべきです。商用画像には、フィード上では見落としがちな要件があります。例えば、製品のシルエット、ラベルの正確性、ブランドカラー、照明の方向、コピーを配置するための余白、キャンペーンのアスペクト比、そして、すでに機能している要素を損なうことなく、意図的に変更を加えることができるかどうかなどです。 シンプルな商品写真1枚、ライフスタイルシーン1枚、タイポグラフィやパッケージの制約がある画像1枚、既存のアセットを編集した画像1枚を収録した、小規模なテストパックを作成してください。.
Veo 3.1 対 Seedance 2.0:ある製品動画のテスト
次に、5秒間のプレミアム商品のCMを依頼しました。内容は、淡い石を背景にマットなネイビーのボトルを中央に配置し、ゆっくりとズームインし、結露を写し込み、ロゴ、文字、人物は一切登場させないというものでした。 Veo 3.1の出力映像は8秒間続き、2秒目には製品の細部や結露が魅力的に映し出されていましたが、カメラが近づきすぎてしまい、要求された「ボトルを中央に配置した構図」を満たすには至りませんでした。 Seedance 2.0 の出力は 5.04 秒で、石のような表面の上にボトルが直立した状態がより完全に保たれていましたが、ボトルの上部が切り取られており、結露もあまり目立ちませんでした。.
生成された両方の結果に使用された共通のプロンプト
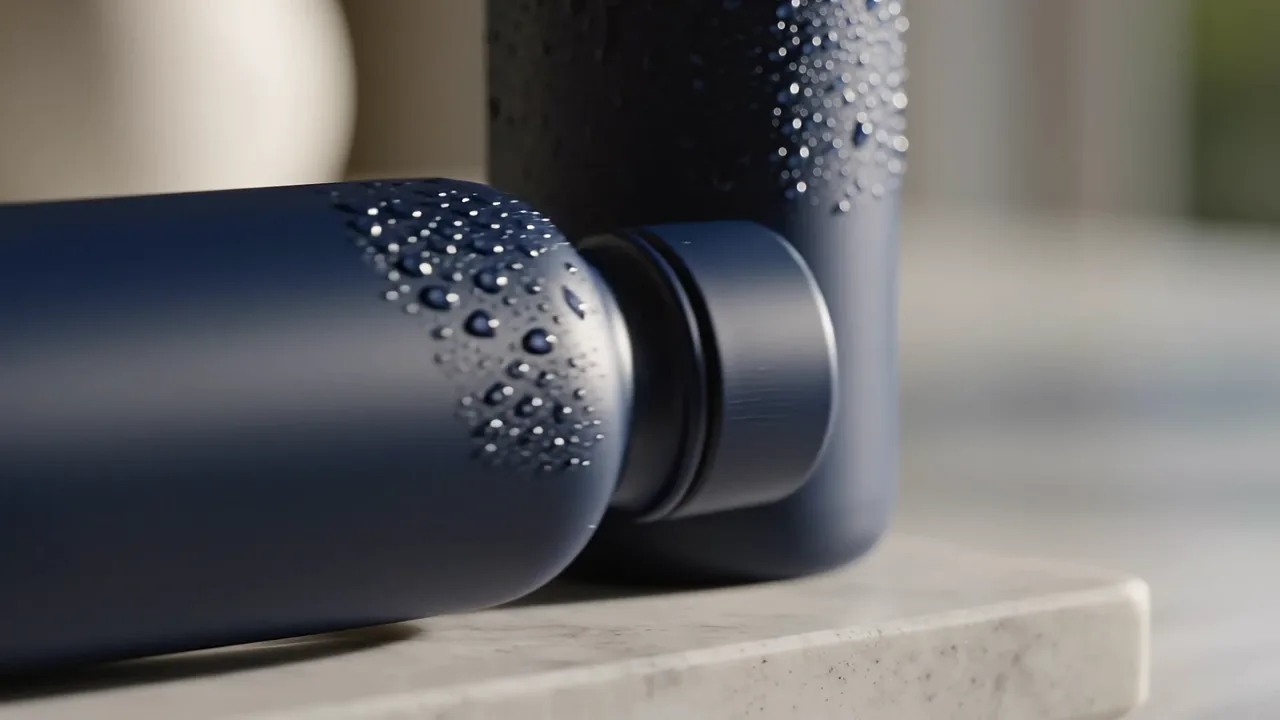
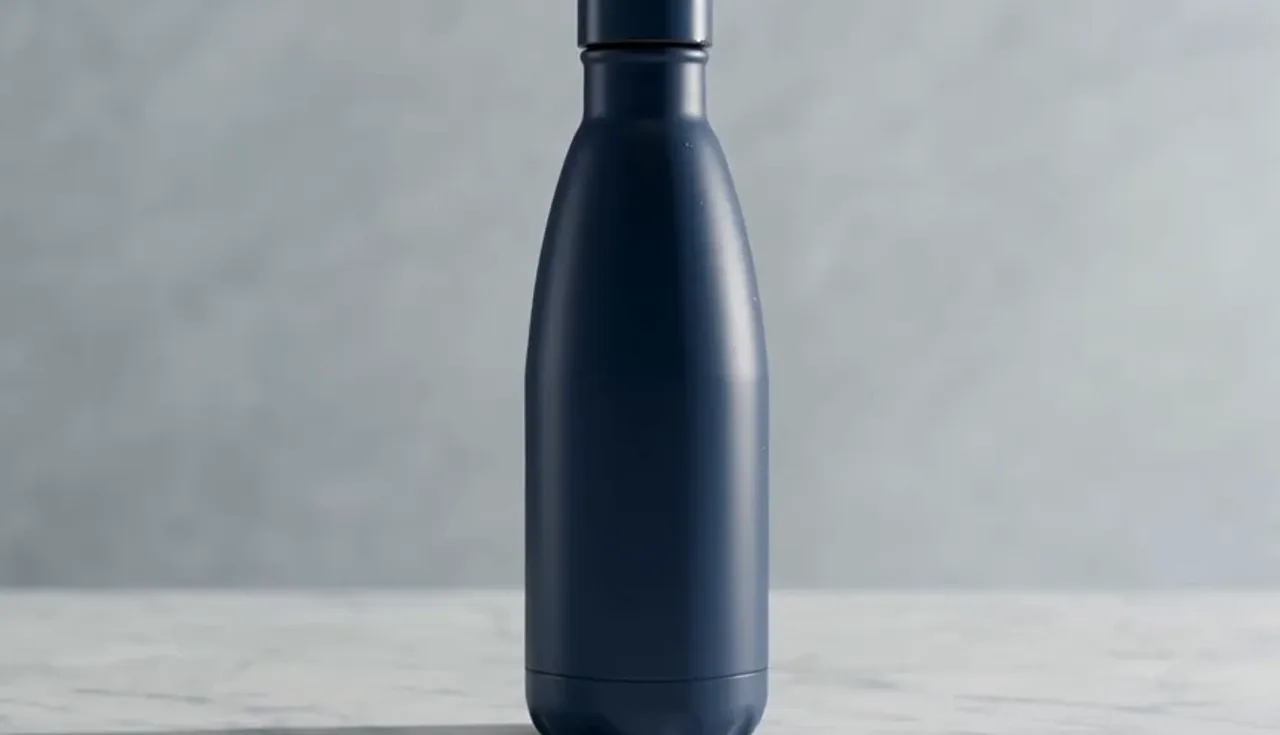
動画AIを選ぶ際は、単一の魅力的なフレームではなく、必要な構図、動き、修正管理にどれだけ迅速に到達できるかを基準にしてください。現在の権利やアクセス要件については、 Veo 3.1 商用利用ガイド そして Seedance 2.0 アクセスガイド. Agnes Videoには他にも 公式製品ドキュメント; 購入前に、プランの条件を必ずご確認ください。.
同じ業務に二重に費用をかけずにAI予算を策定する方法
ほとんどの人は、すべてのモデルカテゴリーのサブスクリプションを必要としているわけではありません。合理的な予算策定は、最もコストのかかる作業から始めるのが賢明です。 コンサルタントにとっては、それは調査や文書作成かもしれません。開発者にとっては、リポジトリを意識したレビューやデバッグかもしれません。クリエイティブチームにとっては、キャンペーン用アセットの作成や修正能力かもしれません。まずその主要なボトルネックにリソースを割り当て、実際のタスクで不足が明らかになった後にのみ、第二の手段を追加するようにしましょう。.
階層的に考えましょう。第1階層は、頻繁に利用する中核となるアシスタントです。第2階層は、情報源に基づいた調査や動画生成など、明らかに異なる業務に特化したスペシャリストです。第3階層は、実験、業務のオーバーフロー、セカンドオピニオンのための柔軟なアクセス手段です。 避けるべきなのは、3つの汎用チャットサービスに加入し、どれもほぼ同じ初稿を生成してしまう状況です。毎月の追加コストは明らかですが、それ以上に深刻な問題は、どの回答を信頼すべきか、あるいは最終版がどこにあるのかが誰にも分からなくなってしまうことです。.
確固たる論理的アプローチに加え、仕事上で情報源が必要な場合は調査を行う。画像や動画の追加は、実際に制作が行われている期間に限定する。.
最高だ: ライター、アナリスト、創業者、コンサルタント。.
エディタやCLIに適したコーディング対応のルートが1つ、難しいレビュー問題向けの2つ目のモデル、そして最終関門として既存のテスト。.
最高だ: 個人開発者や小規模なプロダクトチーム。.
十分な反復対応能力を備えた画像・動画の制作プロセス、コンセプトや企画書のための汎用モデル、そして繰り返し利用できる承認チェックリスト。.
最高だ: マーケティング担当者、Eコマースチーム、および代理店。.
チームの場合は、ライセンスを購入する前に責任の所在を明確にしておきましょう。クライアントからのクレームに対して、誰がライブウェブリサーチを利用できるのか?生成されたコードは誰がレビューするのか?ビジュアルアセットは誰が承認するのか?プロンプトや承認済みの出力結果はどこに保存されるのか?これらは単なる事務的な質問ではありません。これらによって、AIがチームの業務を効率化するか、それとも単に追跡不可能な下書きを増やすだけになるかが決まるのです。 明確なワークフローを定めた控えめな計画は、レビュー基準のないプレミアムアクセスよりも価値があります。.
AIを重要な業務に導入する前に確認すべき点
“「お金を払う価値がある」というのは、単に価格の問題だけではありません。エラーによる影響が大きければ大きいほど、サブスクリプションには明確な運用上の境界線が必要です。製品説明の草案と、顧客向けの財務上の推奨事項は、同じ未審査のプロセスを通すべきではありません。 モデルを本格的なワークフローに組み込む前に、そのモデルがどのような情報を受け取ることができるか、出力を誰がチェックするか、どのような情報を外部から取得する必要があるか、そして人間の責任者がいない限り決して公開してはならない情報は何かを定義しておく必要があります。.
- このサービスは、具体的にどのような業務を担当し、あるいはその業務を大幅に効率化するのでしょうか?
- その出力が十分に安全であり、使用しても問題ないことを証明しているのは、どのような情報源、試験、あるいは審査者なのでしょうか?
- そのモデルにはどのような情報が必要なのか、また、その情報を共有することは適切なのか。
- 他のチームメンバーは、非公開のチャット履歴をコピーせずに、そのワークフローを再現できますか?
- 30日後にこの定期購読を解約する理由として、どのようなことが考えられますか?
1つのマルチモデルワークスペースが、個別のサブスクリプションよりも価値がある場合
特定のベンダーの最新ファーストパーティ機能、エンタープライズレベルの管理機能、あるいはワークフローに深く組み込まれた機能が必要な場合には、直接サブスクリプションを契約するのが得策です。しかし、同じ週のうちに、文献調査からコードレビュー、さらには製品画像の作成へと業務内容が変化する場合、個別のサブスクリプション契約はコストがかさみ、煩わしくなってしまいます。 GlobalGPTの現在のホームページによると、1つのアカウントで、月額$5.80から100以上のAIモデルに加え、Perplexity、 Deep Research、Yukie、WebおよびCLIアクセス、さらにClaude Code、Codex、Cursor用のMCPサーバーも利用できます。.
実用的なマルチモデル・シーケンスは、次のような流れになります。まず、PerplexityやDeep Researchを用いて最新のエビデンスを収集し、汎用モデルを使ってメモの骨子をまとめます。次に、別のモデルに仮定の妥当性を検証してもらいます。既存の開発ワークフローにCLIやMCPが組み込まれている場合は、具体的な実装に関する質問をそれらに委ねます。そして、キャンペーンで映像制作が必要な場合にのみ、画像や動画の制作に移行します。 この一連の流れにより、ツールの選択基準が明確になります。また、どのステップに予算を割くべきかを見極める前に、反射的にすべてのベンダーから最上位プランを購入するよりも、コストを抑えることができます。.
作業内容が頻繁に変更される場合は、個別に支払いを続けるのはやめましょう
下書きを作成する前に調査を行い、戦略的な回答についてセカンドオピニオンが必要な場合はモデルを切り替え、コード作業はCLIまたはMCPを経由させ、その後、同じアカウントから画像や動画を作成する。.
GlobalGPTのマルチモデルワークスペースをお試しください有料化する最大の理由は、有名なモデル名を利用できることではありません。タスクが変更された瞬間に、サブスクリプション・スタックを再構築することなく、適切なルートを利用できるようにしておくことです。一般的なモデルのエントリポイントとして、GlobalGPTの検証済みGPT-5.6 Solルートは こちらからご覧いただけます.
よくあるご質問
どのAIに課金する価値が最も高いでしょうか?
最も費用対効果の高いAIとは、本業の時間を繰り返し節約してくれるものです。調査を多用する業務には引用検索が、分析には強力な汎用モデルが、開発にはレビューのループを改善するモデルとインターフェースが適しています。また、画像や動画のツールについては、実際の制作時間を削減できるものである必要があります。.
ChatGPTは購入する価値があるのでしょうか?
ChatGPTは、ドラフト作成、分析、反復的な問題解決を行う主な環境として利用する場合、その費用を払う価値があるでしょう。自社の定期的なブリーフをこのツールと別のモデルの両方で処理し、レビューにかかる時間と最初の回答を比較してみてください。.
Perplexityは有料にする価値があるのでしょうか?
Perplexityは、情報源や検証可能な引用が研究の質に実質的な影響を与える場合に、最もその重要性が際立ちます。一方、作業が主にオフラインでの執筆、コーディング、あるいはアセット作成である場合は、それほど重要ではありません。.
プログラミングに最適なAIはどれですか?
最高のコーディングAIとは、リポジトリの関連コンテキストを理解し、レビュー可能な変更案を提案し、実行可能なテストを生成し、さらに使用しているエディタやCLIに適合するものです。通常のテストやレビューに合格するまでは、自動生成されたコードを「下書き」として扱ってください。.
画像や動画のAIツールにお金を払うべきでしょうか?
モデルが、撮影、デザイン、編集、あるいは代理店の手間を省くような草案を定期的に作成してくれる場合にのみ、報酬を支払うようにします。ブランドに配慮した同じプロンプトを複数のサービスで比較し、最初の出力では構図や素材の詳細が見落とされる可能性があるため、修正作業の費用も予算に組み込んでおきましょう。.
マルチモデルAIのサブスクリプションは、その価値があるのでしょうか?
研究、執筆、コーディング、画像、動画といった作業を頻繁に切り替える場合や、重要な回答の妥当性を検証するために2つ目のモデルが必要な場合には、マルチモデルサブスクリプションが役立ちます。ただし、特定のファーストパーティ制御が必須である場合は、ベンダー直契約の方が依然として適している場合があります。.
GPT-5.6 SolをGlobalGPTで使用することはできますか?
GlobalGPTは、現在のモデルカタログに「GPT-5.6 Sol」を掲載しています。本記事で紹介しているGlobalGPTのルート追跡機能を利用して、現在利用可能なインターフェースを確認し、ご自身のワークフローに適したアクセスオプションを選択してください。.