どの業務においても、万能な選択肢というものは存在しません。ChatGPTは最も汎用性の高いスタンドアロン型アシスタントであり、Claudeは長文の文書や緻密なコーディング作業において特に優れており、Geminiは、Google製品やマルチモーダルファイルがすでにワークフローに組み込まれている場合に最も適しています。.
実際にどのモデルを選ぶかは、作業がどこから始まるか、そして回答の後に何を行う必要があるかによって決まります。 ChatGPTは、調査、ファイル、音声、画像、コーディングツールを一箇所にまとめて管理できます。Claudeは、ソースコードを多用する分析や大規模なコードベースに適しています。Geminiは、Gmail、Docs、Drive、Sheets、Search、NotebookLMと自然に連携します。.
業務で複数のモデルファミリーを日常的に使用している場合は、, GlobalGPTは、GPT、Claude、Geminiの各モデルを1つのオールインワンワークスペースに統合します. 1つのアカウントでこれらのワークフローを一元管理できるため、タスクが変更されるたびに個別のサブスクリプションを契約したり、プロバイダーのURL間を何度も行き来したりする必要がありません。.

ChatGPT 対 Claude 対 Gemini:簡単な比較
ChatGPTは最も汎用性の高いスタンドアロン型アシスタントであり、Claudeは綿密な文書作成やコーディング作業を中核としており、GeminiはGoogle製品との連携が最も深いものです。 主な違いは、同じプロンプトに答えられるかどうかではありません。結果を別の場所に移動させる必要が生じるまでに、各製品がどれだけの有用な作業を完了できるかという点にあります。.
| カテゴリー | チャットGPT | クロード | ジェミニ |
|---|---|---|---|
| 最適な標準的な使い方 | 一般的な文書作成、コーディング、ファイル処理、分析、調査、音声、画像のワークフローを、1つのスタンドアロン製品に統合しました。. | 長文、ソースに即した統合、入念な編集、アーティファクト、およびClaude Codeを通じたリポジトリ作業。. | Gmail、Docs、Drive、Sheets、検索、Android、NotebookLM、またはGoogle Cloudで開始または終了するタスク。. |
| 執筆と統合 | 柔軟な出力形式を備え、レポート、草案、分析、およびさまざまな種類のファイルを扱う作業において、広く親しまれている選択肢です。. | 特に、矛盾や依存関係、ソース間の関係を容易に確認できるようにすることに優れています。. | 明確で体系化されており、ソースデータがすでにGoogleの製品内に存在している場合には特に大きなメリットがあります。. |
| コーディング | 多くの言語にわたる強力な汎用的なコーディング、デバッグ、説明、およびコード生成機能を備えており、特にコーディングと分析、ファイル処理、その他のタスクが混在する場合に有用です。. | 大規模なコードベースの理解、依存関係の追跡、複雑なロジックの解説、そして詳細な根拠に基づいた丁寧な修正を行うことに長けている。. | コード生成、複雑な推論、および長文を扱うコーディングタスクに強みがあり、特にマルチモーダル入力やGoogleのテクノロジースタックにおいて優れた能力を発揮します。. |
| 調査と検索 | ウェブ上の情報源、アップロードされたファイル、連携アプリを統合し、体系化された引用付きのレポートとしてまとめる、強力なオールラウンドな研究統合機能。. | 特に、膨大な資料を精読し、主張を比較検討し、ニュアンスを的確に捉え、調査結果を資料に基づいた明快な分析へと昇華させることに長けている。. | 現在のウェブ情報、Google検索、およびGmail、ドライブ、ドキュメント、NotebookLMのコンテンツを統合する必要がある場合に、その真価を発揮します。. |
| マルチモーダルワークフロー | ChatGPT製品ファミリーに含まれるテキスト、ファイル、画像、音声、および生成ツール。. | 会話、文書、およびアーティファクトを中心としたインターフェースによるマルチモーダル理解。. | GeminiおよびGoogleのメディア製品における、テキスト、画像、音声、動画の機能。. |
| 原生の生態系 | ChatGPT、プロジェクト、コネクタ、Codex、およびOpenAIのクリエイティブツール。. | Claudeのアプリ、プロジェクト、成果物、統合機能、およびClaudeのコード。. | Gmail、Docs、Drive、Sheets、Meet、検索、Android、NotebookLM、AI Studio、およびVertex AI。. |
最新のChatGPT、Claude、Geminiモデルとはどのようなものですか?
ここで比較しているモデルルートは以下の通りです。 GPT-5.6 Sol (このテストで使用したGlobalGPT GPTルート)、, Claude Opus 5 Claudeについては、および ジェミニ3.1プロプレビュー Gemini用。.
| 製品 | この比較対象の中で最新のモデル | 現在の状況 | どのような用途に対応するように設計されているか |
|---|---|---|---|
| チャットGPT | GPT-5.6 Sol | この比較に使用されている現在のGPTルート | 一般的な論理的思考、コーディング、調査、ファイル管理、およびマルチツールを使った作業。. |
| クロード | Claude Opus 5 | 2026年7月24日に導入 | コーディング、専門的な知識を要する業務、検索、コンピュータの使用、および多段階のエージェントタスク。. |
| ジェミニ | ジェミニ3.1プロプレビュー | プレビュー;2026年2月19日公開 | Googleの製品エコシステムに関連する、複雑な推論やマルチモーダルな業務。. |
モデルの世代交代は急速に進むため、最新の名称はあくまで出発点に過ぎません。より広い意味での 最高のAIモデルの比較 フラッグシップモデルの品質よりも、速度やコスト、あるいは専門的なワークフローがより重要となる場合、他の現行モデルがどのような位置づけにあるかを示しています。.
Geminiには、ワークフロー重視の高速モデルも用意されています。その Gemini 3.5 フラッシュレビュー Proモデルの高度な推論処理よりも、応答性やGoogle関連の繰り返し作業が重視される場合には、こちらの方が次のステップとして適しています。.
選択はタスクによって変わる可能性があります。特定のモデル名を絶対的な最良の選択肢とみなすのではなく、完成した成果物、ネイティブツール、および計画上の制約を比較検討してください。製品レベルでのより広範な視点については、現在の AIアシスタントの比較とランキング.
ベンチマーク結果:実際には何を示しているのか?
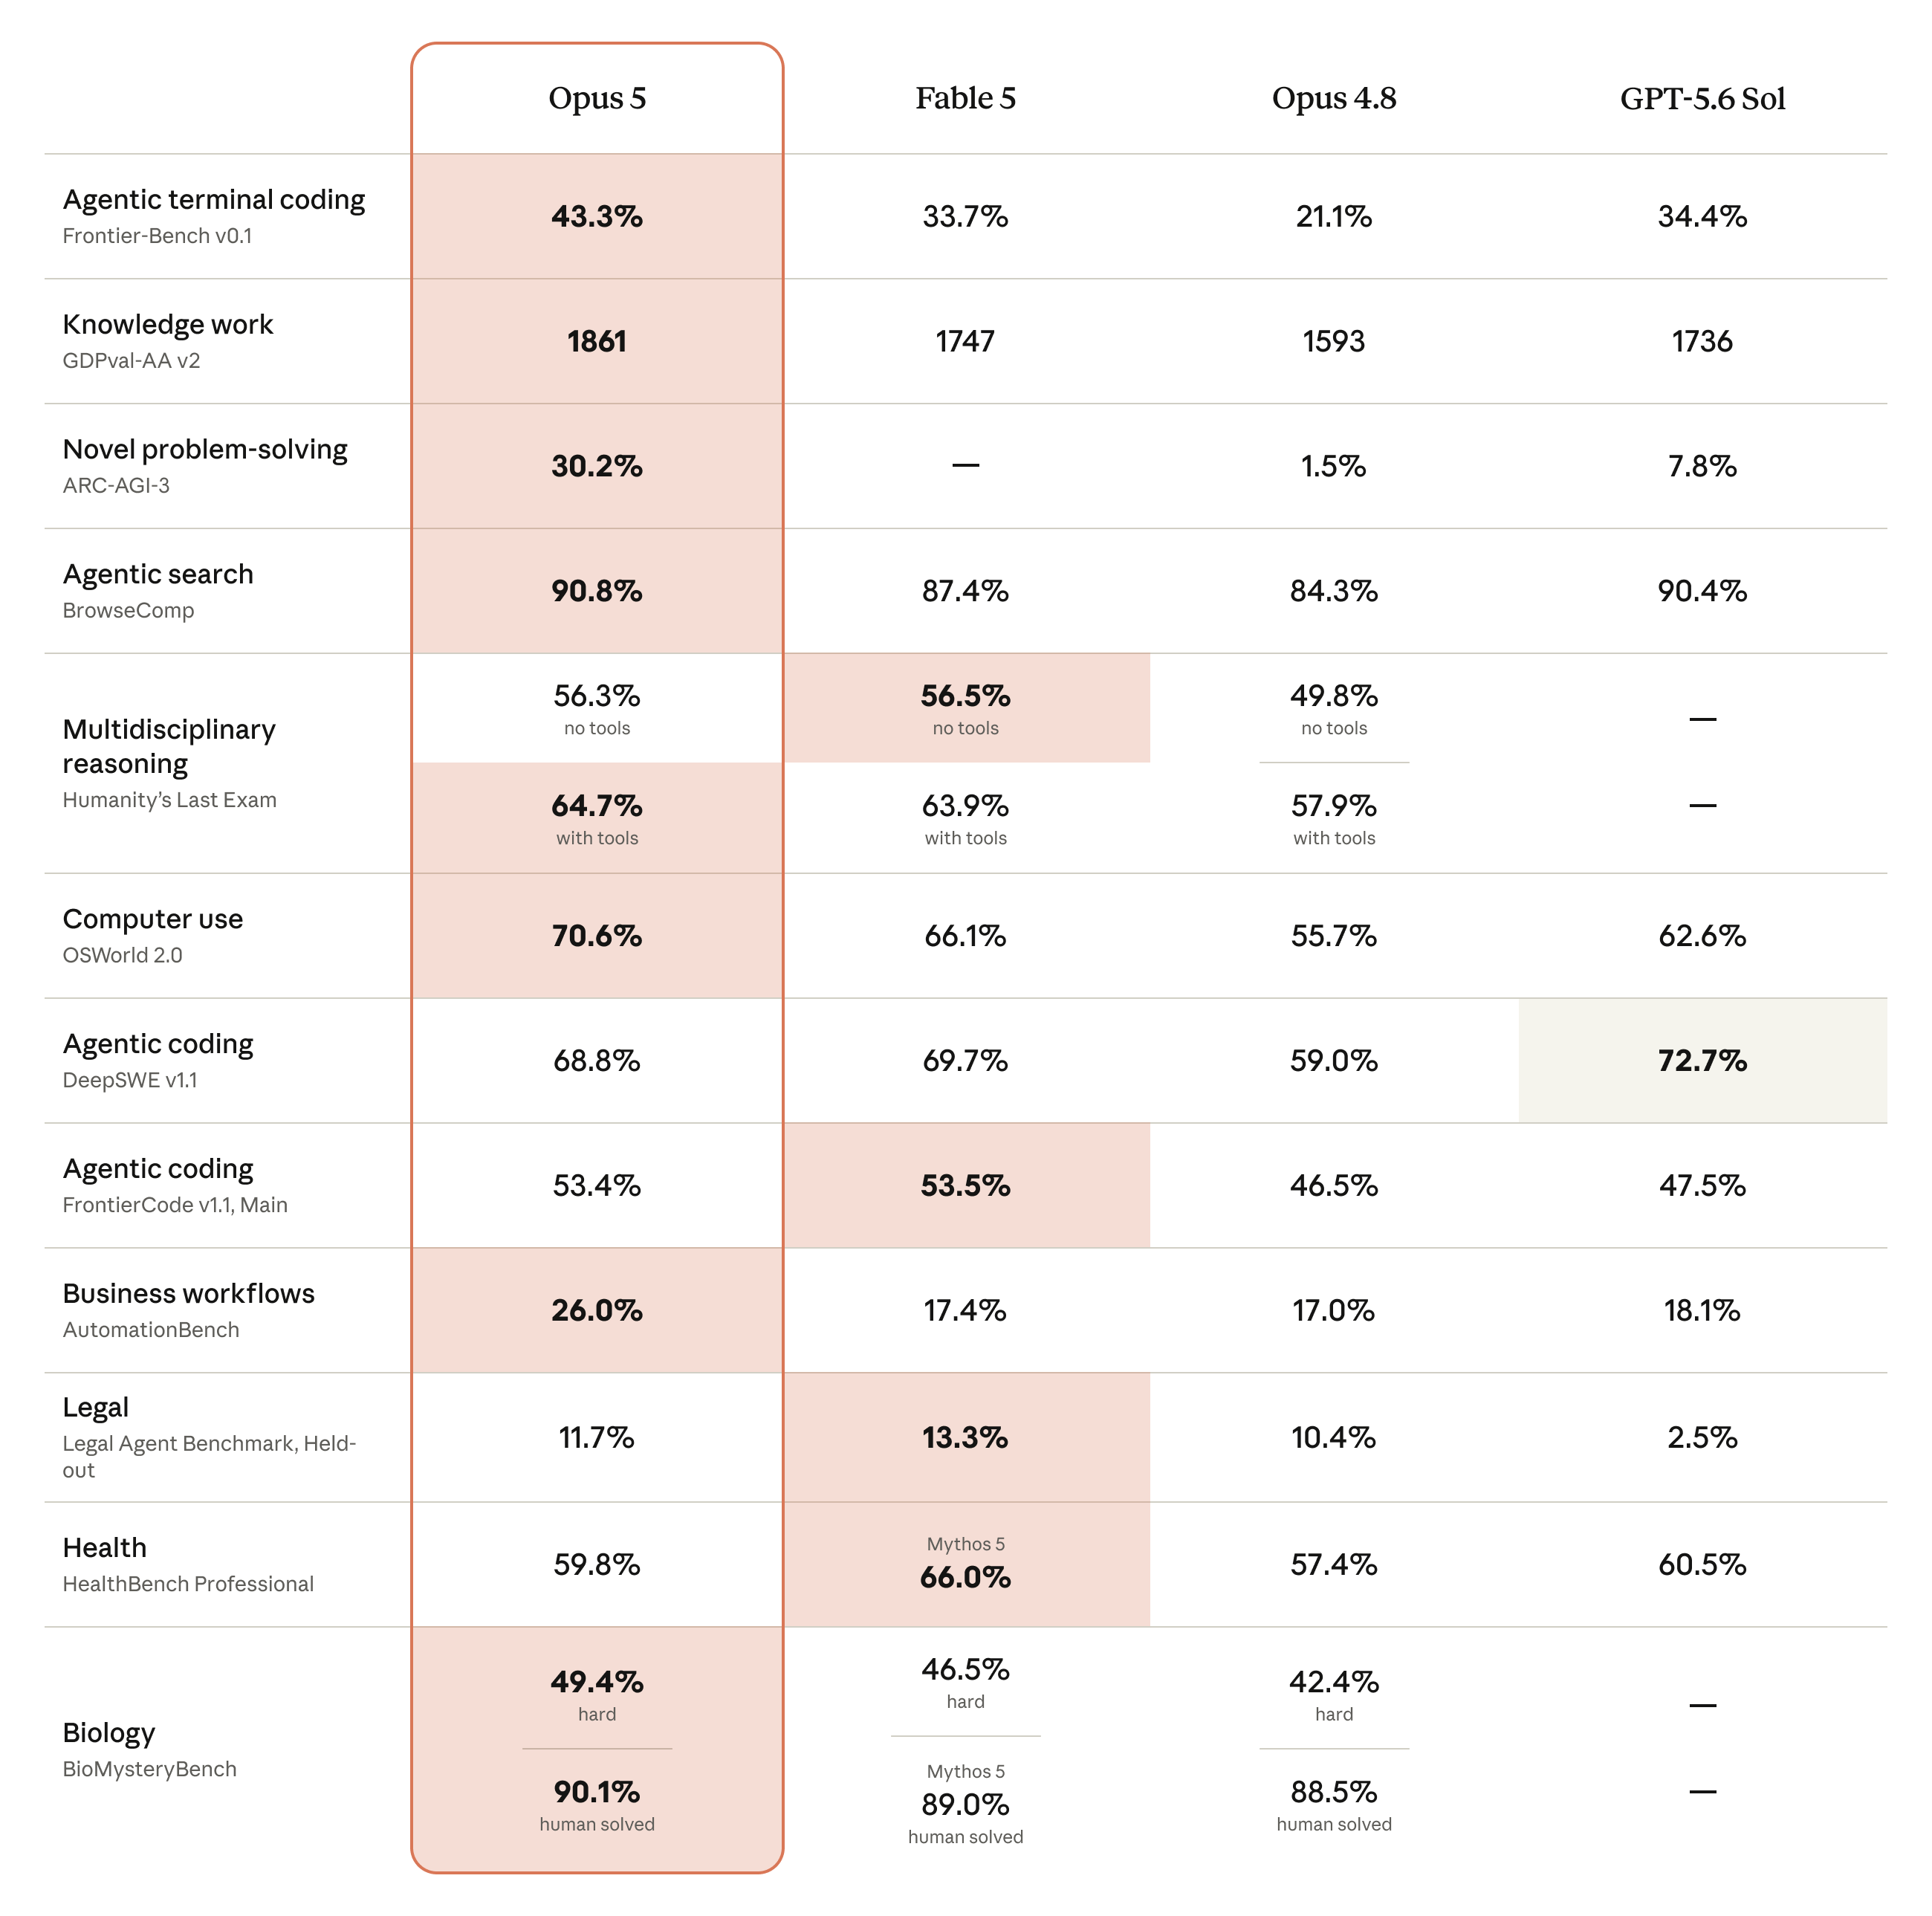
ベンチマークは実機でのテストに代わるものではありませんが、各モデルがどのような負荷の高い作業に最も適しているかを示してくれます。 現時点で最も有用なデータは、Anthropicの公式「Claude Opus 5」テーブル(この比較にはGPT-5.6 Solも含まれている)と、Googleの公式「Gemini 3.1 Pro」の結果から得られます。.
ベンチマークの全体像
Claude Opus 5は、この比較に使用された証拠において、より強力な総合的なベンチマーク実績を示しています。専門的な知識作業、ウェブリサーチ、コンピュータ利用、自動化、および多段階のエージェントタスクに関するAnthropicの公表済み評価の多くで、Claude Opus 5が上位を占めています。 GPT-5.6 Solには、範囲は狭いものの重要な強みがあります。それは、ソフトウェアエンジニアリングの項目でトップの成績を収めている点です。Gemini 3.1 ProについてはGoogleが別途資料を公開しており、特に不慣れな視覚的・論理的推論において最も優れた実績を示しています。.
Claude Opus 5は、ベンチマークに対する優位性が最も大きい
Claude Opusは、エージェント型端末作業のFrontier-Benchで43.3%、専門知識作業のGDPval-AAで1,861、難易度の高いWeb調査のBrowseCompで90.8%、 コンピュータ利用を評価するOSWorldで70.6%、AutomationBenchで26.0%を記録した。また、ARC-AGI-3推論の項目でも30.2%を記録し、トップに立っている。.
購入者にとって、これらは単なる同じ知能テストの6つのバージョンというわけではありません。これらは全体として、情報を収集し、専門的な資料を処理し、ソフトウェアを操作し、一連の関連する手順を完了するというモデルを体現しています。したがって、Claudeの利点は、1つの課題にこれらの要件のいくつかが組み合わされている場合に、最も発揮されます。.
GPT-5.6 Solがソフトウェアエンジニアリングの成果を牽引
GPT-5.6 Solは、DeepSWE v1.1において72.7%を記録し、この表のソフトウェア工学の項目において最高の結果を出しました。 また、BrowseCompでは90.4%を記録しており、この研究用ベンチマークにおいてClaude Opus 5にわずか0.4ポイント差で迫っている。.
購入者にとって、この点はGPTを単なる「ツールキットの選択肢の一つ」以上の存在にしています。その最も明確なベンチマーク上の優位性は、実際のソフトウェア開発作業の完了に最も近い評価において現れており、一方でウェブ検索の結果についても依然として競争力があります。もしコーディングが購入の主な理由であるならば、その点については、Claudeが他の分野でより多くの勝利を収めているという事実よりも、より重視すべきでしょう。.
クローザー Claude Opus 5 と GPT-5.6 の比較 Geminiのエコシステムに関する追加の疑問を排除しつつ、これら2つのモデルを区別している。.
Gemini 3.1 Proは、Google Workspaceモデルであるだけではありません
Googleは、ARC-AGI-2における「Gemini 3.1 Pro」の検証済みスコアとして77.1%を報告しており、これはGoogleが「Gemini 3 Pro」について報告したスコアの2倍以上である。この評価では、既知の解答パターンを単に思い出すだけでは解決できない、未知の問題に焦点を当てている。.
つまり、Gemini 3.1 Proは単なるエコシステムの追加機能ではなく、本格的な推論モデルであると言えます。 購入者にとって重要な点は、Gmail、Docs、Drive、あるいはNotebookLM用にGeminiを選択しても、フラッグシップ級の推論モデルを諦めることにはならないということです――もっとも、Googleが別途発表した結果は、Anthropicテーブルとの直接的な比較スコアとして扱うことはできませんが。.
「ベンチマーク」のセクションが、製品選びにおいてどのような意味を持つのか
研究、コンピュータの利用、専門的な分析、そして多段階の実行を組み合わせた業務を行う場合、Claudeが最も優れたベンチマーク結果を示しています。ソフトウェアエンジニアリングを優先する場合、GPTが最も関連性の高い「行単位の勝率」を記録しており、難易度の高いウェブリサーチにおいてもClaudeと拮抗しています。 業務がGoogle中心でありながら、高度な推論も求められる場合は、Geminiを単なる統合レイヤーとして軽視すべきではありません。これらの結果をもとに候補を絞り込み、以下の実機テストを用いて完成した成果物を比較してください。.
実際の試験:コーディング、ライティング、リサーチ
機能一覧やベンチマーク結果の主張にとどまらず、GPT-5.6 Sol、Claude Opus 5、および Gemini 3.1 Pro Preview に対して、コーディング、長文作成、および証拠調査に関する同一の課題を出題しました。以下の比較では、提出された成果物を直接示した上で、実際のタスクに影響を与える可能性のある違いについて解説します。.
結果は点数や総合優勝者には換算されませんでした。コーディングについては、提出された関数を実行して検証しました。文章については、同じ文字数、構成、および証拠に関するルールに基づいて比較しました。調査については、販売、契約、信頼性、事象、価格設定、監査証拠など、矛盾する情報を含む同じ9つの情報源の資料セットに基づいて検証しました。.
コーディングテスト:どの解答が最も信頼でき、再利用しやすいでしょうか?
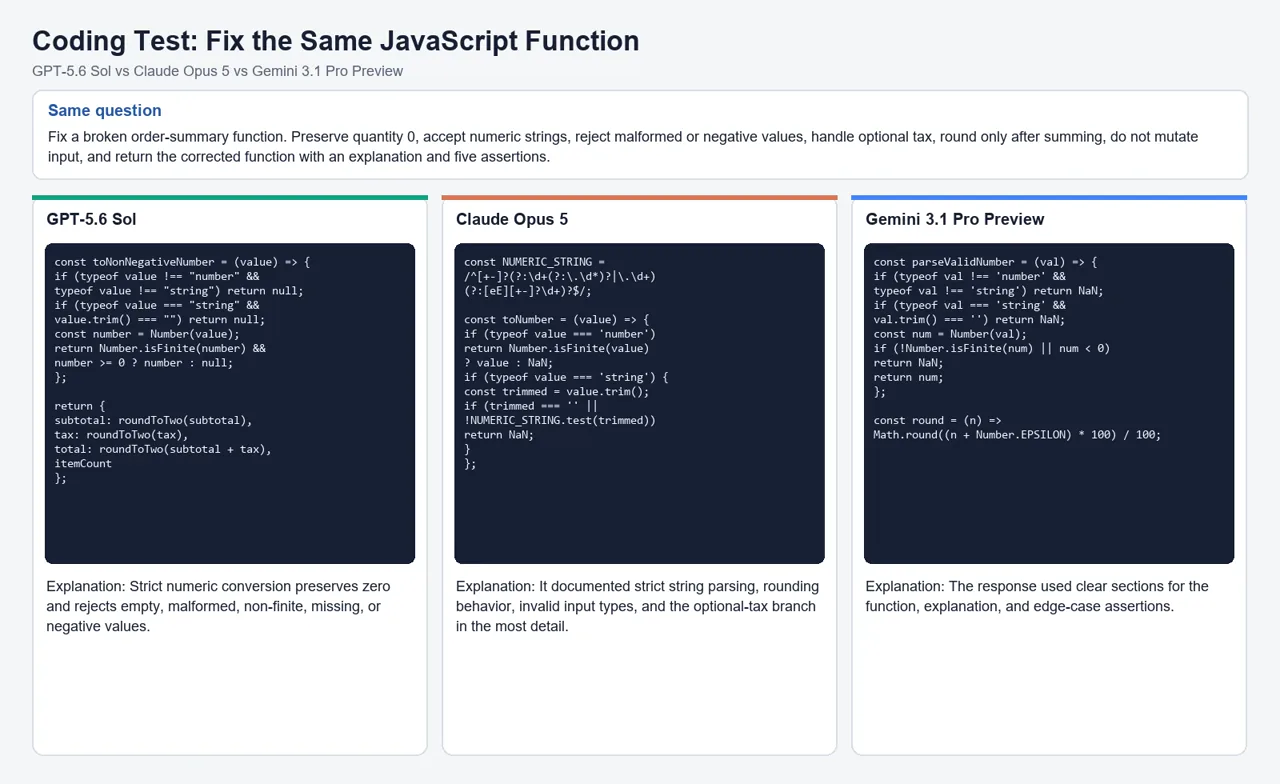
質問: 同じ JavaScript の order-summary 関数を修正し、エッジケースが正常に動作することを確認してください。.
function summarizeOrders(orders, taxRate) {
  // 数量がゼロの場合はそのまま保持し、有効な数値文字列を受け入れる。
  // 形式不備、負の数、非有限の値は拒否する。
  // オプションの税金を処理し、丸め処理の前に合計を算出し、入力値を変更しない。
  // 少なくとも5つのエッジケースのアサーションを含む修正値を返す。
}
| モデル | 客観的な結果 | 特に印象に残ったのは | このテストの結果から最も適しているもの |
|---|---|---|---|
| GPT-5.6 Sol | 8つのチェックをすべてクリアしました | 最もコンパクトな完全な修正。検証ヘルパーは再利用しやすかった。. | 高速なコピー&適用によるデバッグ。. |
| Claude Opus 5 | 8つのチェックをすべてクリアしました | 文字列の妥当性チェック、無効な型、および丸め処理について、最も詳細に解説しています。. | 綿密な審査を経ても維持されなければならない修正。. |
| ジェミニ3.1プロプレビュー | 8つのチェックをすべてクリアしました | 機能、説明、テストが最も明確に区分されている。. | 解答を部分ごとにスキャンまたはコピーすること。. |
ワークフロー別に選択: 最も手っ取り早く再利用可能な修正には「GPT」、最も詳細なレビュー履歴を残したい場合は「Claude」、最も明確なセクション構成を求める場合は「Gemini」をお選びください。.
1つの関数の範囲を超える処理については、 Codex と Claude のコード比較 ファイルの検査、コマンドの実行、コードベースの全範囲にわたる処理が可能な、リポジトリレベルのツールについて解説します。.
ライティングテスト:どのモデルが、最も出版に適した長文の草稿を生成するか?
質問: 合成データセットのみを用いて、Eコマース事業の責任者を対象とした1,800~2,200語の意思決定に関する記事を作成してください。相反する証拠はそのまま残し、相関と因果関係を区別し、7つの所定の見出しに従い、指定された意思決定の要約とフレームワーク表を含めてください。また、欠落している事実や閾値をでっち上げてはいけません。.
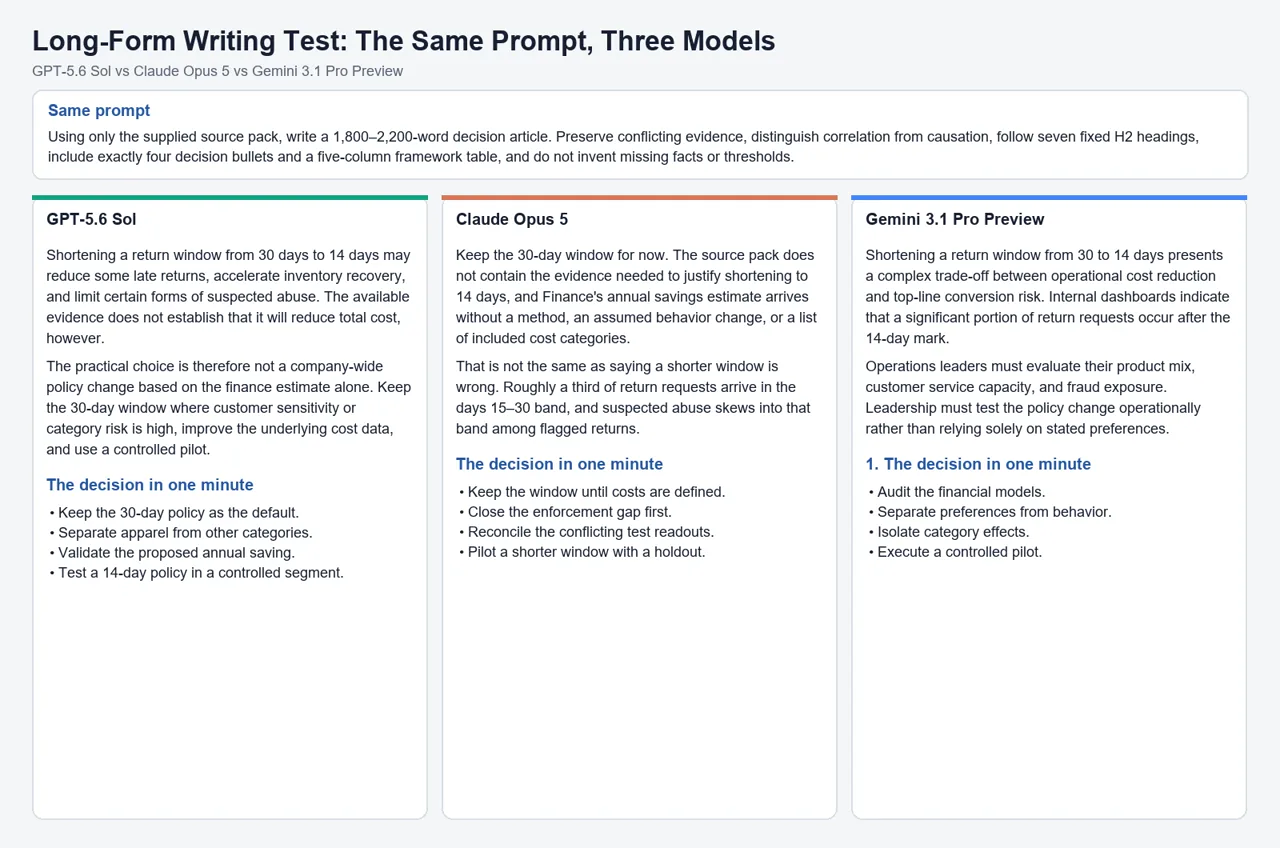
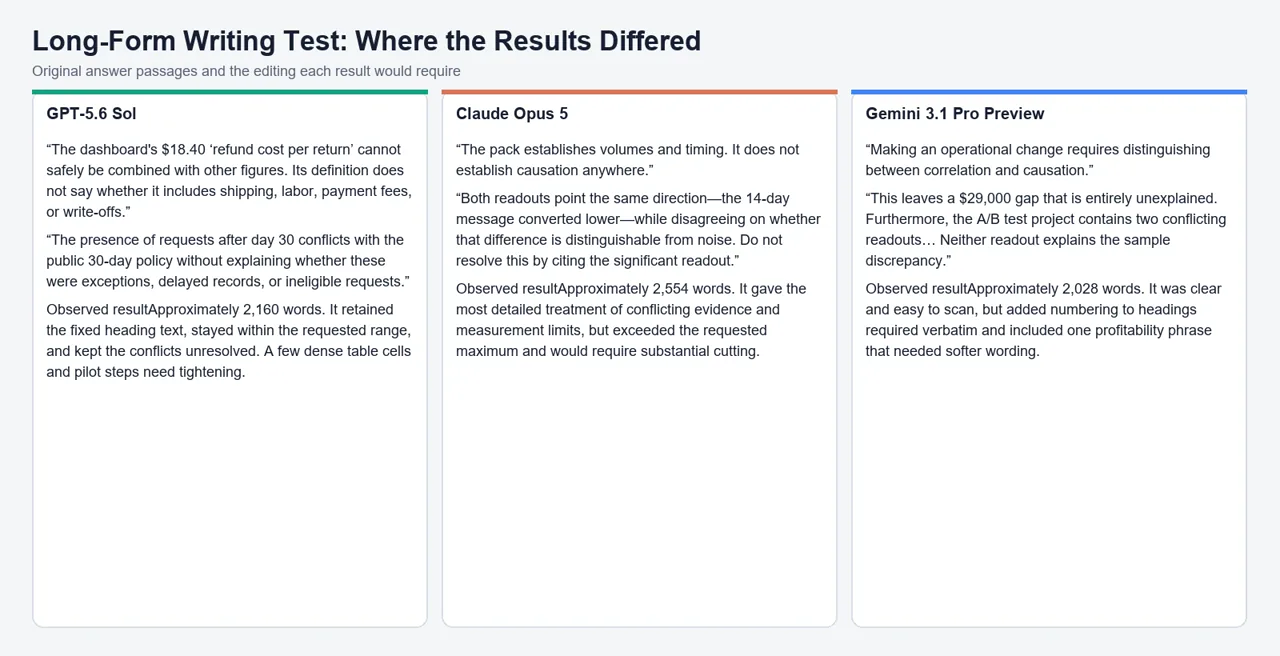
| モデル | 長さの結果 | 証拠と構成 | 主な編集が必要 |
|---|---|---|---|
| GPT-5.6 Sol | 約2,160語。1,800~2,200語の範囲内 | 固定された見出しを維持し、矛盾する証拠もそのまま残した。. | 文章や表の密度を下げてください。. |
| Claude Opus 5 | 約2,554語。制限を超えています。 | 数値の不一致や測定期間に関する最も詳細な説明。. | 出版前に大幅な削り込みが行われた。. |
| ジェミニ3.1プロプレビュー | 約2,028語。範囲内 | 明確な判断基準を設けたが、見出しの固定テキストを変更し、出典よりも一歩踏み込んだ主張を1つ強調した。. | 見出しを元に戻し、根拠のない表現を和らげる。. |
編集コストで選択: 要件を厳密に遵守する必要がある場合は「GPT」、証拠の深さをさらに掘り下げる価値がある場合は「Claude」、明確な草案に対して最終的な指示の確認を行う場合は「Gemini」を使用します。.
検証テスト:相反する証拠に対して、どのモデルが最も慎重に対処するか?
質問: 従業員45名のソフトウェア企業が、9つのソースが固定されたパッケージを使用したチーム向け製品を購入すべきかどうかを判断してください。 モデルのトレーニング、データの削除、稼働時間、セキュリティインシデント、米国限定のストレージ、初年度のコスト、およびSOC 2の適用範囲に関する7つの主張を確認してください。各主張について、「裏付けがある」「矛盾している」「未解決」のいずれかに分類し、情報源間の矛盾を特定し、価格の算出過程を示し、結論付けられない点を明記してください。また、欠落している事実をでっち上げてはいけません。.
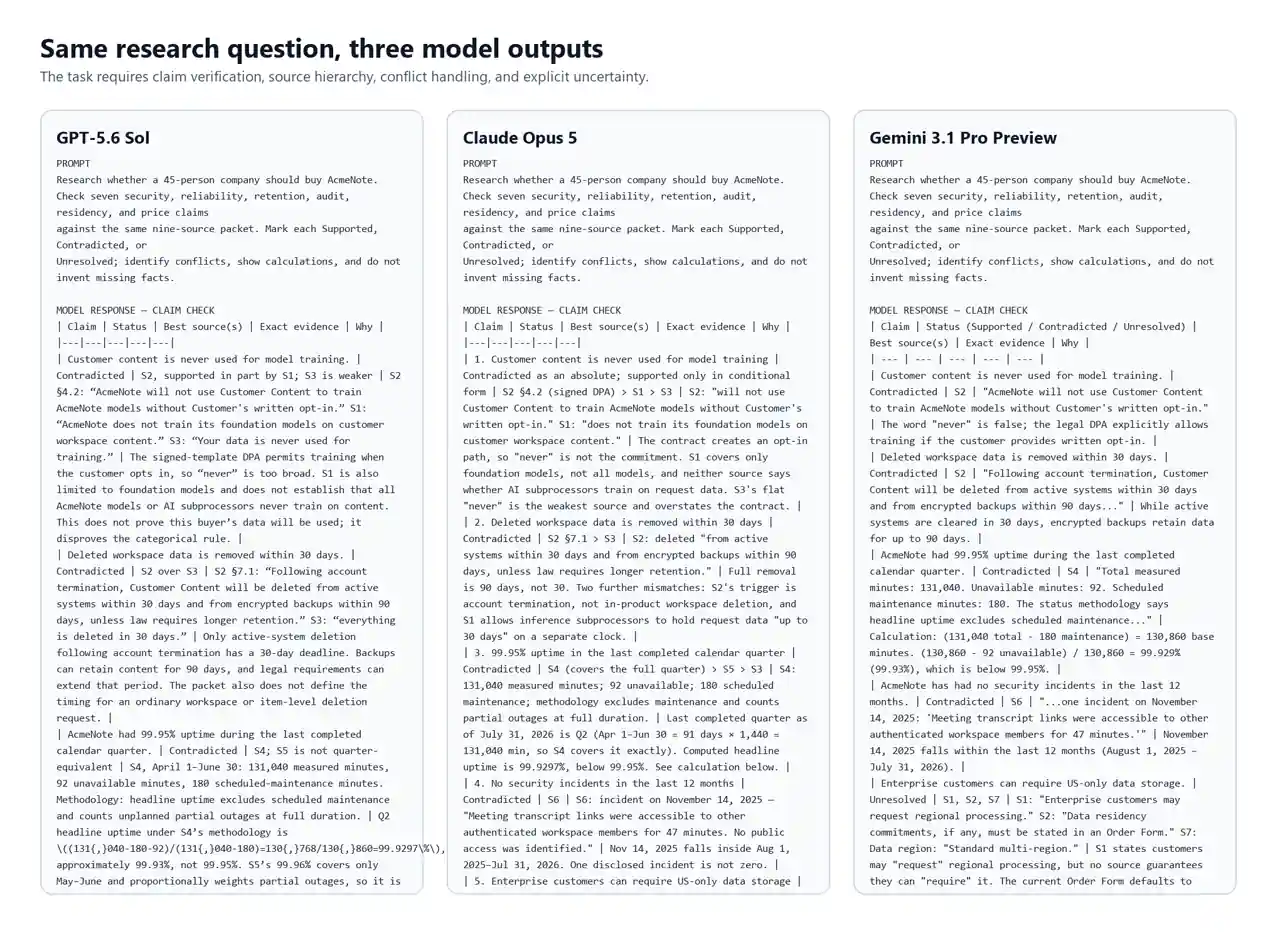
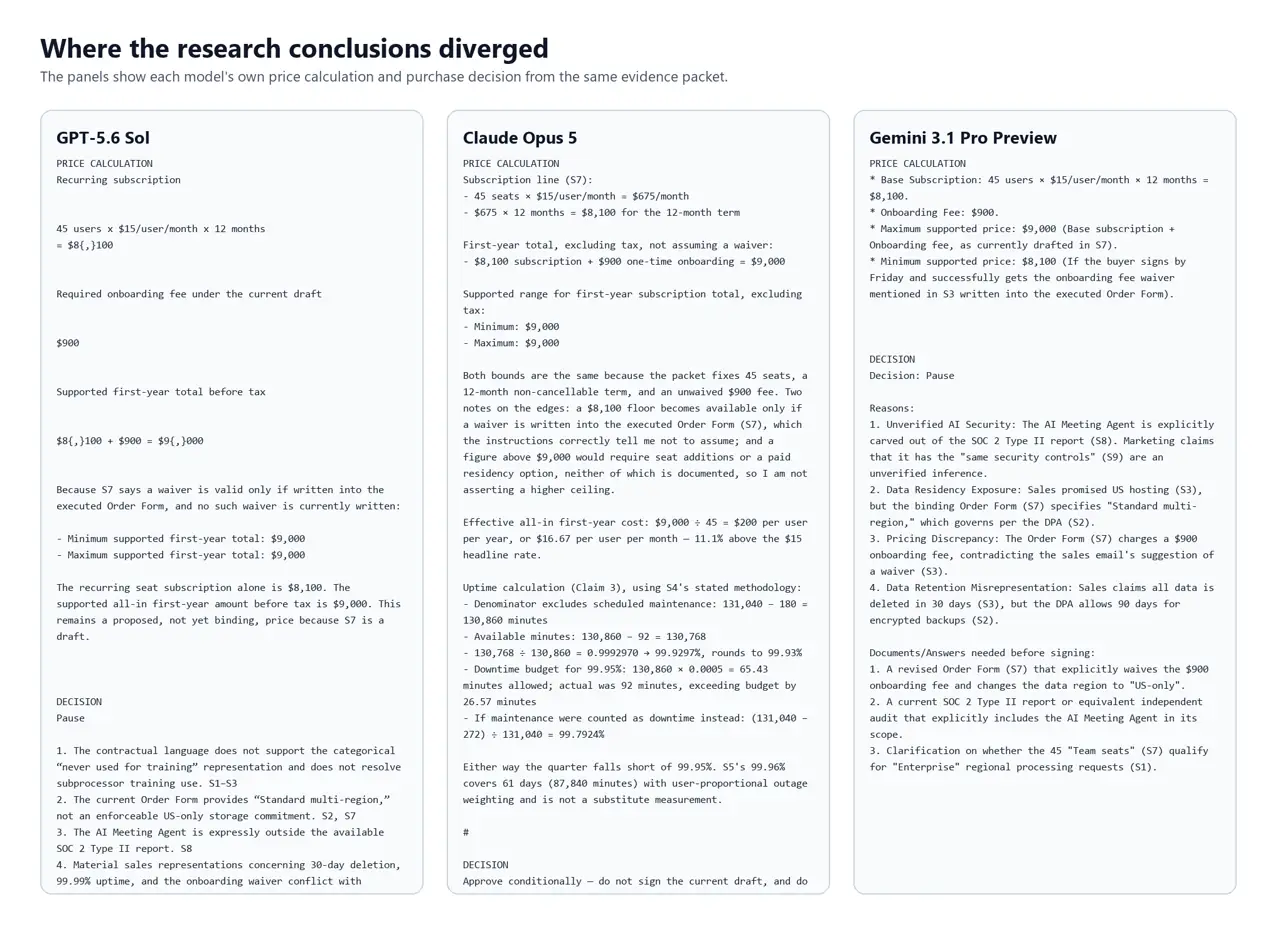
| モデル | 共有された証拠の調査結果 | 価格結果 | 決定 |
|---|---|---|---|
| GPT-5.6 Sol | トレーニング、削除、稼働時間、インシデント、保存期間、価格、および監査に関する問題が見つかりました。. | $9,000が1年目の総額を支えた | 一時停止;直接計算および検証リスト。. |
| Claude Opus 5 | 同じ問題点を見つけ、定義の不一致や未解決の疑問点を主に追加しました。. | $9,000~$9,000(免除不可の規定に基づく) | 条件付きで承認する。現在の草案には署名しない。. |
| ジェミニ3.1プロプレビュー | 最も短い回答の中から、主な対立点を見つけました。. | $8,100–$9,000;最低基準において、将来的な免除を誤って認めていた | 一呼吸置く。その方が、その後の質問が少なくて済む。. |
研究スタイルから選ぶ: 最も網羅的なソース監査には「Claude」、証拠から意思決定への直接的なプロセスには「GPT」、慎重な計算チェックを経た簡潔な一次審査には「Gemini」をご利用ください。.
価格比較:ChatGPT 対 Claude 対 Gemini 対 GlobalGPT
料金は、実際に購入する内容によって異なります。公式サブスクリプションでは、1つのプロバイダーのアプリとネイティブエコシステムの利用料を支払います。API課金では、自社が開発した製品内での利用に対して料金を支払います。. GlobalGPTは、GPT、Claude、およびGeminiへのアクセスを1つのワークスペースに統合しています, 、これは、プロバイダーごとの個別のサブスクリプションやモデルURLではなく、1つのアカウントを使いたい場合に、よりシンプルな方法です。.
| オプション | 2026年7月31日時点で確認された公表消費者価格 | このプランが最も適しているのは |
|---|---|---|
| チャットGPT | 無料:$0。追加:$20/月。機能およびモデルへのアクセスは地域や展開状況によって異なります。お支払い前に、GPT-5.6へのアクセス、Deep Research、Projects、スケジュールされたタスク、カスタムGPT、およびCodexの利用がアカウントに含まれているかどうかをご確認ください。 Proプランの提供状況およびチェックアウト時の価格についても、実際にサイト上でご確認ください。. | リサーチ、ファイル、音声、画像、プロジェクト、コネクタ、コーディングワークフローを1つの製品で利用したい方に向けた、最も包括的なスタンドアロン型ツールキットです。. |
| クロード | 無料:$0。プロ版:年払いの場合、$17/月。上限:$100/月以上。. | Claudeのネイティブドキュメント、アーティファクト、プロジェクト、およびClaudeコードのワークフロー。. |
| ジェミニ | プラス:$4.99/月。プロ:$19.99/月。ウルトラ:$99.99/月~。. | Geminiに加え、プランに応じたGoogleストレージおよびWorkspaceの特典が利用可能です。. |
| グローバルGPT | 取得時点での年間プラン換算額:Basic $5.80/月、Pro $10.80/月、Unlimited $25/月。. | 3つの別々のAIサブスクリプションを契約することなく、1つのアカウントからサポート対象のモデルファミリーを利用できます。. |
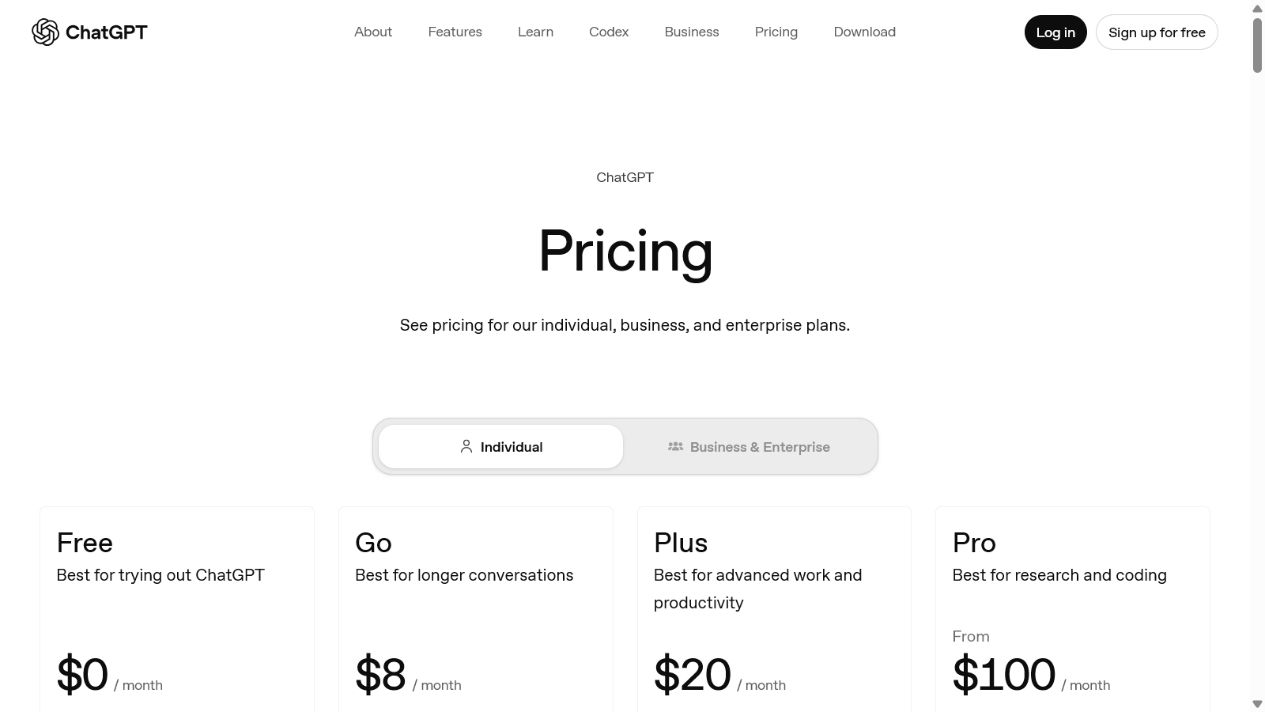
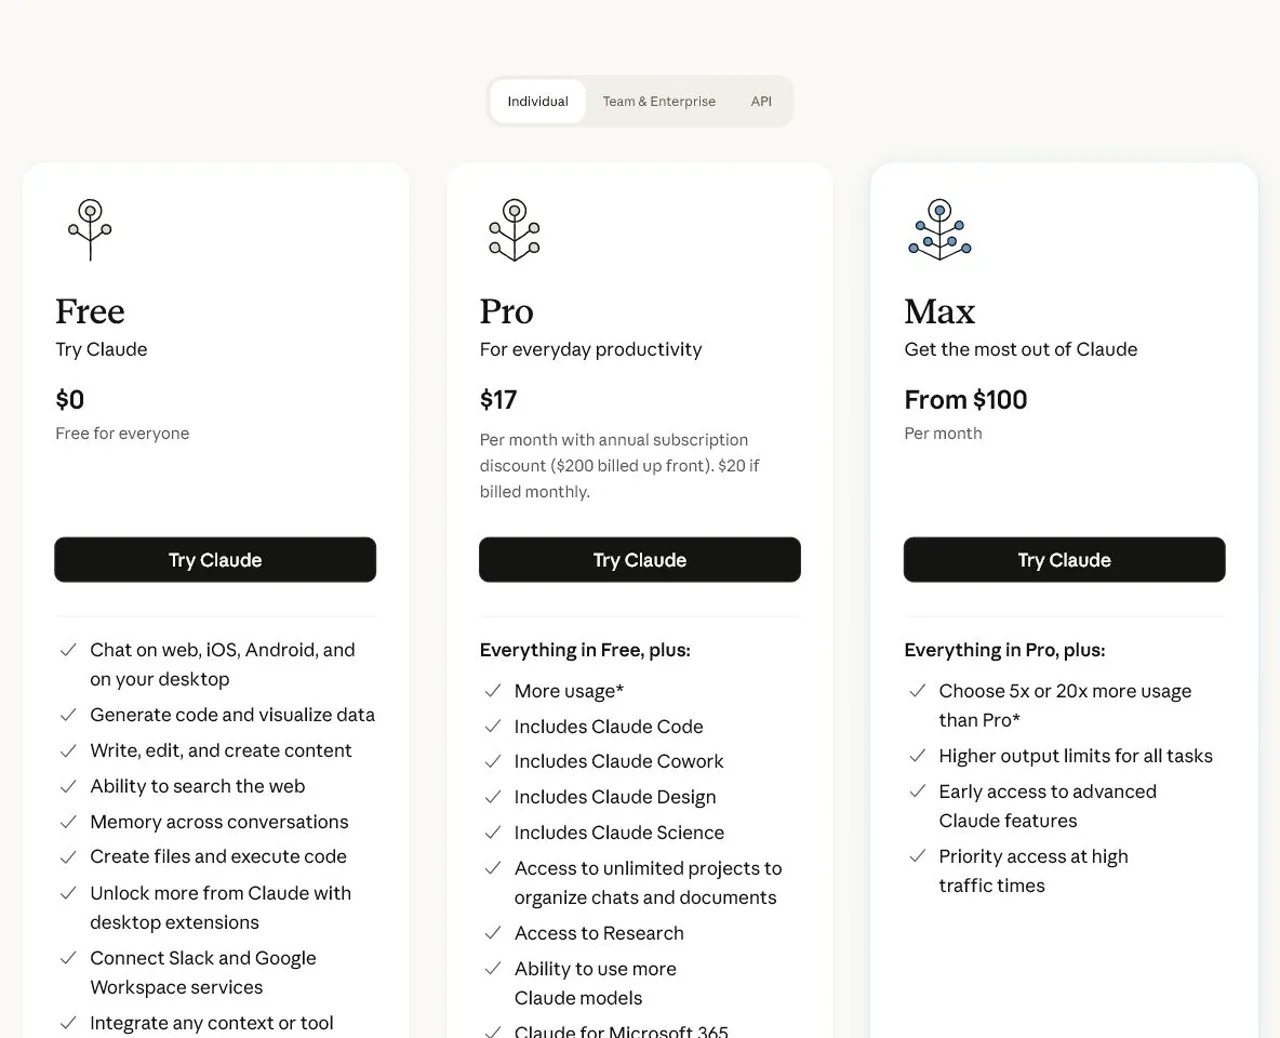
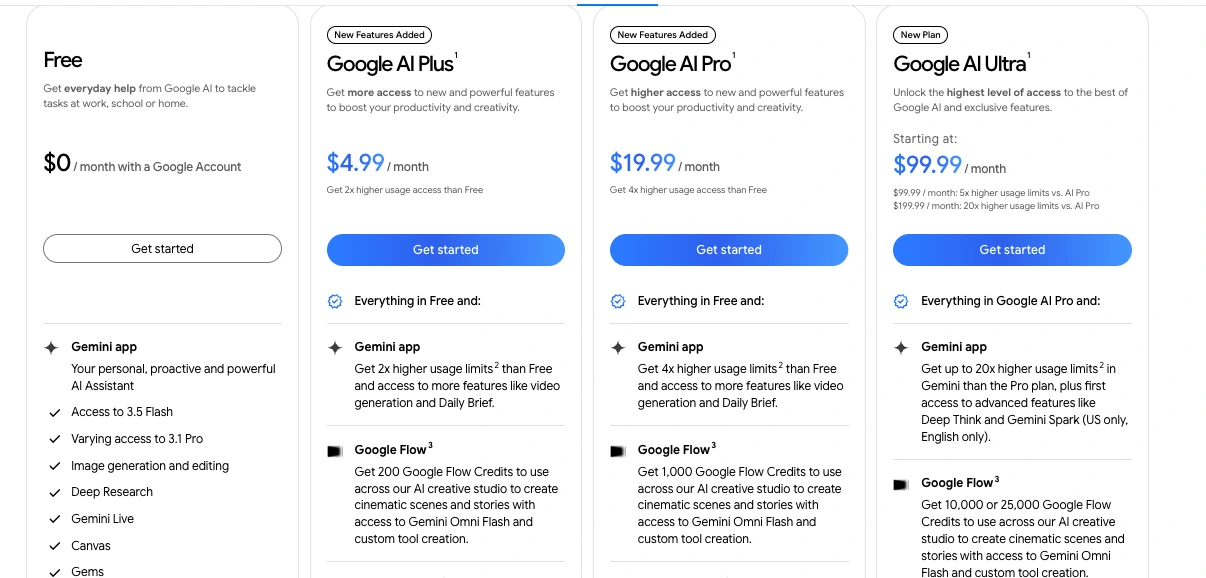
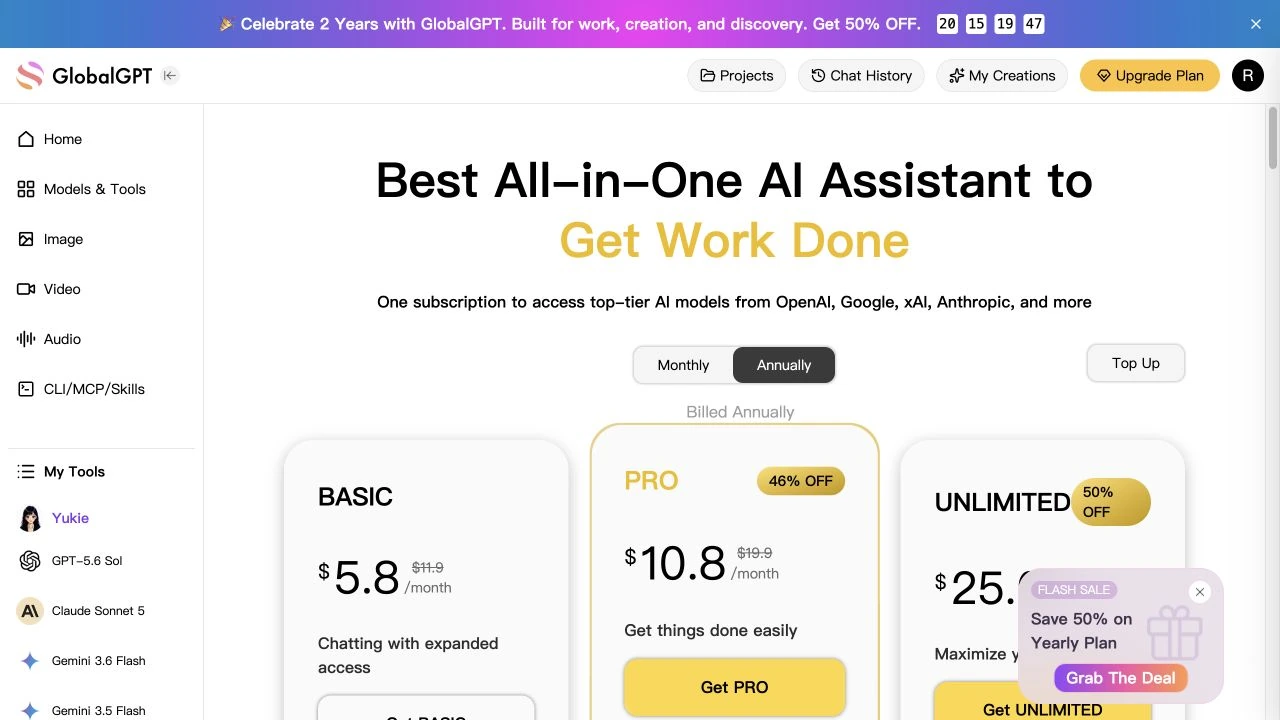
業務においてネイティブ機能が中心となる場合は、公式プランを選択してください。具体的には、ChatGPTの完全な製品ツールキット、Claude Code、またはGoogle Workspace内のGeminiなどです。 単一のプロバイダーのネイティブエコシステムよりも、オールインワンでのアクセス、1つのアカウント、個別のサブスクリプションやプロバイダーURLの削減が重要である場合は、GlobalGPTを選択してください。APIの料金は各コンシューマーサブスクリプションとは別料金であり、アプリケーションや自動化のワークロードについてのみ比較する必要があります。詳細は ChatGPTの公式価格ページ 現在のコンシューマープランのカードについて。.
より詳細な内訳を確認するには、現在の GPT-5.6の価格プラン そして クロードAI計画. コンテキストウィンドウに関する制限も、この厳密なモデルとインターフェースに属します。APIのコンテキスト制限は、コンシューマーアプリのファイル容量制限とは異なります。.
さまざまなユーザー向けのChatGPT、Claude、Geminiの比較
まずは、自分がすでに担当している業務に最も近い説明から始めてください。一般的なモデルの順位付けよりも、関連するファイル、ツール、同僚、納品形式といった要素の方が、通常は重要になります。.
| ユーザー | 最適な出発点 | なぜ |
|---|---|---|
| 学生と教育関係者 | ChatGPT または Gemini | ChatGPTは、柔軟に活用できる汎用的な学習パートナーです。Geminiは、Docs、Drive、Gmail、NotebookLMを中核としたコースに適しています。 |
| 開発者 | ChatGPT または Claude | ChatGPTは幅広いコーディング支援に対応しています。一方、より広範なコードの文脈における詳細な推論が重要となる場合には、Claudeが適しています。 |
| ライターとマーケター | ChatGPT または Claude | フォーマットの制御と、ソース間の関係のより詳細な処理のどちらを選ぶか |
| アナリストおよびコンサルタント | クロードまたはChatGPT | Claudeは資料量の多いレビューに適しており、ChatGPTは簡潔で形式が混在する成果物に適しています。 |
| Google Workspace チーム | ジェミニ | Gmailやドライブからドキュメント、スプレッドシート、検索、Meetへとつながる流れこそが、決定的な強みです |
| タスクごとに切り替える人 | マルチモデル・ワークフロー | コーディング、執筆、調査、計画の各段階によって、最良の結果は異なる場合があります。 |
学生と教育関係者
説明やエッセイの構成案、資料の要約、コーディングのサポートが必要な学生にとって、ChatGPTは通常、最も使いやすい総合的な学習パートナーとなるでしょう。 授業ですでにGoogle Docs、Drive、Gmail、またはNotebookLMが活用されている場合は、Geminiが魅力的です。長文の読解資料を、出典間の関連性を損なうことなく綿密なアウトラインにまとめる必要がある場合は、Claudeと比較してみる価値があります。.
開発者
コンパクトな修正や簡潔なデバッグの説明を求める開発者は、ChatGPTから始めるのがよいでしょう。エッジケースやその根拠を詳細に文書化する必要がある場合は、Claudeが最適です。コード、説明、テストを明確に分離すること、あるいはGoogleの開発スタックが重要な場合には、Geminiが役立ちます。その コーディング比較に最適なAIモデル より幅広いプログラミング上の判断を網羅しています。.
ライターとマーケター
詳細な構成に沿った下書きを作成し、修正の手間を最小限に抑えたい執筆者は、まず「ChatGPT」から始めることをお勧めします。「Claude」は、厳格な文字数制限よりも論拠の深さが重視される場合に役立ちます。一方、「Gemini」は、構成が明確な初稿を作成し、その後、課題の指示書と照らし合わせて確認するのに適しています。.
アナリストおよびコンサルタント
矛盾する証拠を分析するアナリストは、Claudeが仮定や測定の限界について詳細に扱っている点を好むかもしれません。一方、固定された要件に基づいてクライアントに提出可能な成果物を作成するコンサルタントは、GPTのより厳格なコンプライアンス対応を好むでしょう。Geminiは、意思決定の枠組みを特に一目で把握しやすい形にする必要がある場合に役立ちます。.
Google Workspace チーム
Gmail や Drive で作業を開始し、Docs、Sheets、または Meet で完了するチームは、Gemini から始めることをお勧めします。Google の Workspace AIの概要 は、テキストのみのモデルテストでは測定できないネイティブな統合性を示しており、一方、 ChatGPTとGeminiの比較 中央にClaudeを含まない選択肢について検討する。.
タスクごとにモデルを切り替える人
コーディング、執筆、分析の各段階ごとに、好む手法が変わる人は、 同じ素材を、GlobalGPT内のGPT、Claude、およびGeminiで処理する. 最も有用な回答とは、正解であり、課題の指示に従っており、その課題において修正が必要となる部分が最も少ない回答のことです。.
どのモデル名であっても、プライバシーや事実の正確性を保証するものではありません。データの利用方法は製品やアカウントの種類によって異なります。企業や顧客に関する機密性の高い業務については、組織が保存期間、トレーニング、アクセス権限、管理者による管理について確認済みのプランで扱う必要があります。正確性は主張ごとに確認する必要があります。今回のテストでは、コードを実行し、記述や調査に関するすべての主張について、提供された証拠と照らし合わせて確認を行いました。.
最終的な結論:ChatGPT、Claude、それともGemini?
実用的な結論
無関係な主張を最も多く勝ち取る製品ではなく、ワークフロー全体を短縮できる製品を選びましょう。まずは、幅広い対応が必要な場合はChatGPT、綿密な長文推論が必要な場合はClaude、Googleを中心とした作業にはGemini、あるいはタスクごとに最適な答えが1つに絞れない場合はマルチモデルワークスペースから始めてみてください。.
- 最も幅広い機能を備えたスタンドアロン型アシスタントを利用し、文章作成、ファイル管理、リサーチ、音声、画像、コーディングのサポートに至るまで、使い慣れた操作性を求める場合は、「ChatGPT」をお選びください。.
- 出典資料が長文であったり、詳細であったり、あるいは矛盾していたりする場合、かつ推論の過程が容易に検証できる状態を維持する必要がある場合は、Claudeを選択してください。.
- Gmail、Docs、Drive、Sheets、Search、Android、またはNotebookLMによってチームのワークフローがすでに定義されている場合は、「Gemini」を選択してください。.
- タスクごとに最適な答えが予測可能に変化し、ツールの切り替えにかかるコスト自体が問題になりつつある場合は、マルチモデルワークフローを選択してください。.
よくある質問:ChatGPT、Claude、Geminiの比較
全体として、ChatGPT、Claude、Geminiのどれが優れているでしょうか?
これ一択という答えはありません。ChatGPTは単独で使用する場合の選択肢として最も汎用性が高く、Claudeは長文や矛盾を含むソース資料の処理に特に役立ち、GeminiはGoogleを中心とした作業に最適です。回答を取り巻くワークフロー全体を考慮して選択してください。.
プログラミングにはどれが最適ですか?
広範かつコンパクトなコーディングの支援が必要な場合はChatGPTから始め、より広い文脈における詳細な推論が重要な場合はClaudeを活用しましょう。マルチモーダルな入力やGoogleの開発ツールが中心となる場合は、Geminiを検討する価値があります。モデル名だけを鵜呑みにせず、常にコードとテストを実行するようにしてください。.
長文を書くにはどれが最適でしょうか?
書式や要約の正確さが重視される場合は、ChatGPTが有力な選択肢となります。一方、情報源との関係性やニュアンスを詳しく説明する必要がある場合は、Claudeが適しています。Geminiは、Googleドキュメントで執筆を開始する場合や、Workspaceを活用するチームにとって明確な枠組みが必要な場合に適しています。.
研究の統合にはどれが最適でしょうか?
Claudeは、矛盾を慎重に扱うための有力な出発点であり、ChatGPTは直接的な複数情報源の要約に適しており、GeminiはSearch、Drive、Docs、またはNotebookLMと連携したワークフローに適しています。重要な主張については、元となる情報源と照らし合わせて確認してください。.
ChatGPT、Claude、Geminiの価格はいくらですか?
価格、プラン名、対象モデル、請求期間、対象地域、トライアル、利用制限は変更される場合があります。各プロバイダーの、同日時点での一般ユーザー向け実際のチェックアウト画面を比較し、APIの価格設定と一般ユーザー向けサブスクリプションは区別して扱うようにしてください。.
GlobalGPTで、ChatGPT、Claude、およびGeminiを使用することはできますか?
2026年8月28日のチェックにおいて、GlobalGPTはGPT-5.6 Sol、Claude Opus 5、およびGemini 3.1 Proのルートを表示しました。モデルの可用性やプランの消費量は変更される可能性があるため、特定のルートを前提とする前に、実際のワークスペースとプランを確認してください。.
AIモデルを複数使うべきでしょうか?
タスクによって最適なモデルが変わる場合や、別の回答によって見落としが明らかになる場合は、複数のモデルを使用してください。ワークフローを厳格に管理し、同じソース資料を使用し、主張を検証し、修正の必要が最も少ない結果を選択するようにしてください。.