I test sono stati effettuati il 7 e l'11 settembre 2026; le fonti sono state ricontrollate il 16 settembre 2026.
Il nome richiede una precisazione. Gli utenti continuano a cercare “Grok 4”, ma il modello che abbiamo testato era Grok 4,6, e non la data di uscita originaria del luglio 2025. L'attuale Catalogo dei modelli xAI consiglia Grok 4.6 per il codice, mentre l'originale grok-4-0709 Il nome dell'API è stato dismesso. In questa recensione terrò distinti tali prodotti e date.
Se stai valutando diversi assistenti prima di sceglierne uno, inizia da quello più generico Il miglior modello di IA per il confronto dei codici. In questo caso, la questione più specifica è se Grok sia in grado di trasformare un brief di programmazione preciso in un lavoro che si possa effettivamente verificare.
Risposta veloce: il modello Grok 4 è adatto alla programmazione?
Grok 4.6 è sufficientemente valido da risultare utile per il debug di una funzione contenuta, la generazione di una prima implementazione, la spiegazione di codice non familiare e la stesura di test. Non è però abbastanza affidabile da poter essere accettato senza essere eseguito. Gli errori rilevati nella nostra piccola suite non erano semplici divergenze di stile: una rifattorizzazione ha eliminato netto da ogni risultato non vuoto, e una suite di test generata non è riuscita a distinguere un ritardo da un timestamp assoluto.
La regola pratica è semplice: assegnare un contratto ristretto, richiedere una modifica ed eseguire verifiche indipendenti. Un modello che produce rapidamente codice plausibile può comunque cancellare un campo, indebolire un’invariante o rispettare il requisito relativo al codice ignorando quello relativo al formato della risposta.
È possibile prova Grok 4.6 su GlobalGPT per prompt limitati e confronti affiancati. GlobalGPT è una piattaforma indipendente; non sostituisce Grok Build, un IDE, l’accesso al repository, la console API nativa di xAI né la vostra pipeline di CI.
Cosa abbiamo effettivamente testato
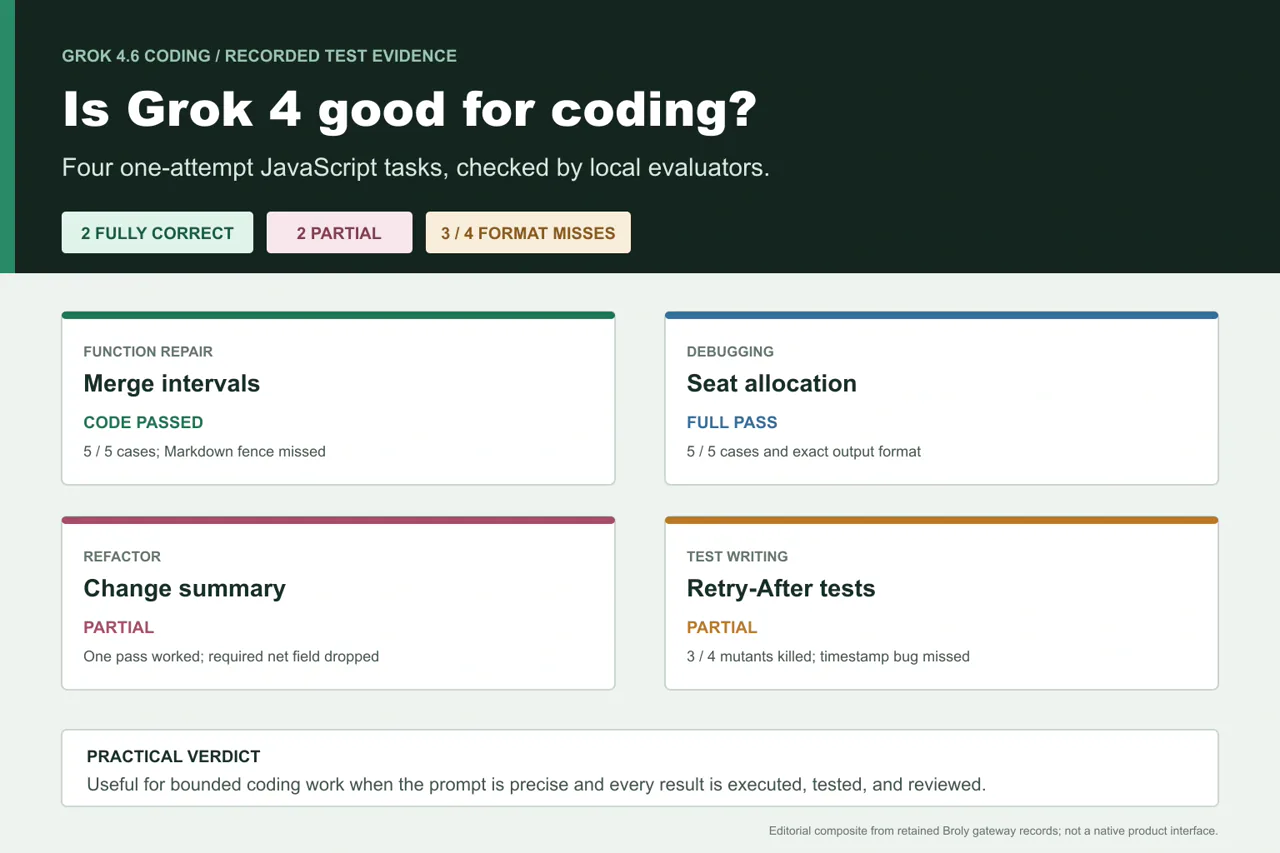
Abbiamo valutato quattro piccoli compiti in JavaScript: la correzione della fusione degli intervalli, il debug dell’assegnazione dei posti in base alle priorità, la rifattorizzazione di una funzione di riepilogo delle modifiche e la scrittura di test per un Retry-After parser. Ogni attività presentava un prompt fisso e un valutatore locale deterministico. Tre di esse sono state eseguite l'11 settembre 2026; l'attività a intervalli ha riutilizzato un'esecuzione del 7 settembre, che abbiamo ricontrollato confrontandola con il prompt, la risposta grezza e il valutatore memorizzati.
- Luogo: API di aggregazione Broly autorizzata dall'utente, completamenti chat.
- Modello richiesto e restituito:
grok-4.6. - Tentativi: una richiesta per ogni attività, senza tentativi di ripetizione.
- Esecuzione: il codice JavaScript restituito veniva isolato ed eseguito localmente utilizzando fixture o mutant predefiniti.
- Non disponibile per il modello: un IDE, un repository, l'accesso a Internet, l'esecuzione di strumenti xAI e i sistemi di produzione.
L'etichetta del gateway costituisce un'utile indicazione della provenienza, ma non dimostra di per sé l'effettiva implementazione a monte. Il tempo trascorso include il sovraccarico di rete e del gateway, e il conteggio dei token riportato non costituisce una fatturazione ufficiale di xAI. Per una visione più ampia a livello di prodotto, consultare il documento separato Recensione e test reali del Grok 4.6.
I risultati del test di programmazione in sintesi
netto.Il risultato migliore non è stato quello con la risposta più lunga. È stata la correzione relativa all’assegnazione dei posti: concisa, formattata correttamente e completa dal punto di vista comportamentale. Il fallimento più istruttivo è stato il refactoring, perché l’implementazione appariva pulita e soddisfaceva il requisito dell’esecuzione in un unico passaggio, pur modificando silenziosamente il contratto di output.
Test 1: correzione di una funzione di intervallo di unione
La prima funzione modificava il proprio input, andava in crash in presenza di un array vuoto, non riusciva a unire gli estremi contigui e poteva ridurre un intervallo più ampio quando in seguito compariva un intervallo annidato. Il prompt ha reso esplicite tali invarianti.
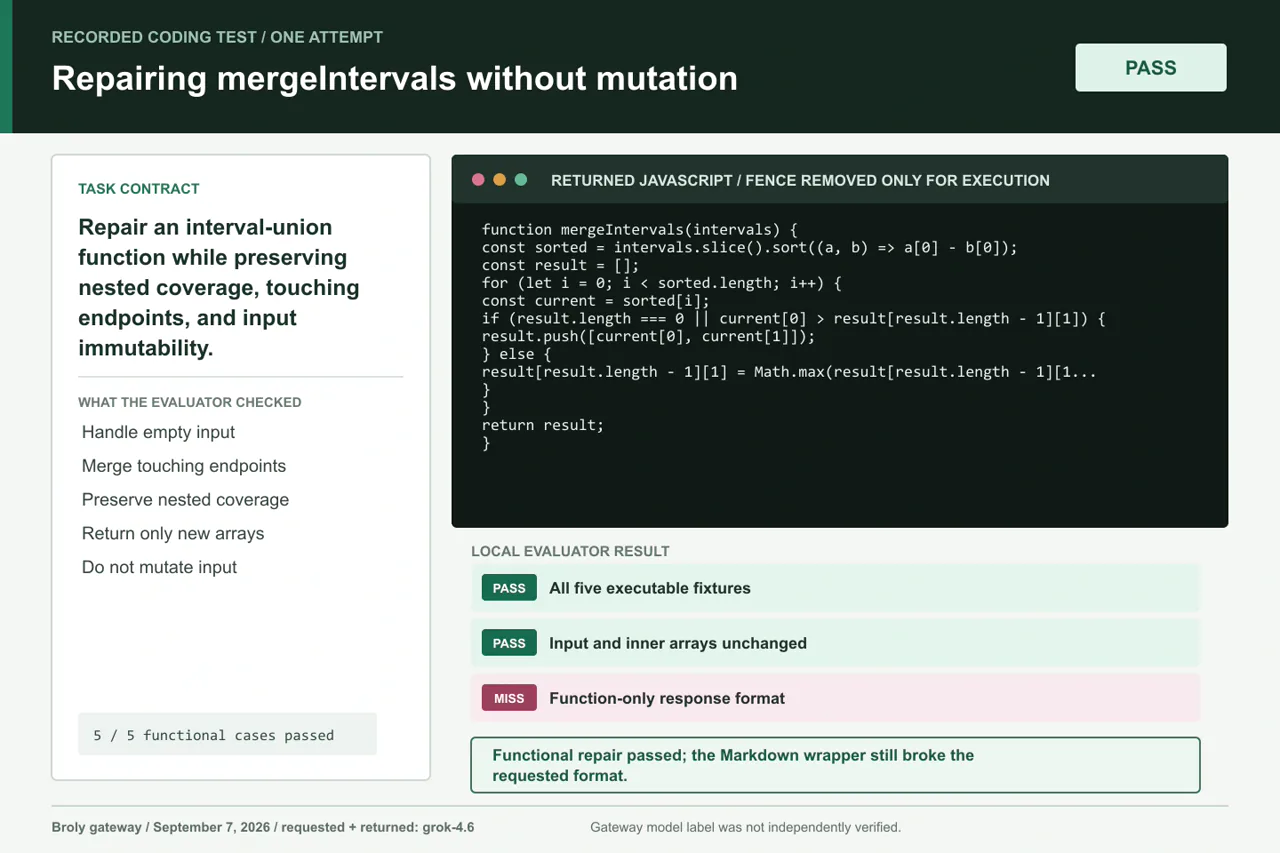
Confine chiave: La riparazione funzionale è stata superata dopo aver rimosso solo il contenitore Markdown esterno per l'esecuzione.
Risultato: Tutti e cinque i casi di esecuzione sono stati superati. La funzione ha restituito nuovi array, non ha modificato i dati di input, ha preservato la copertura annidata e ha unito gli endpoint adiacenti. Ha comunque fallito un’istruzione esplicita a causa dell’incapsulamento del codice in Markdown. Dopo aver rimosso solo quella barriera esterna all’esecuzione, il risultato funzionale è risultato corretto.
Conclusione pratica: Grok ha gestito bene una correzione compatta quando il prompt ha indicato i casi limite nascosti. L'errore di formato è minimo per una persona, ma può compromettere il funzionamento di una pipeline che si aspetta testo direttamente eseguibile.
Test 2: debug dell'assegnazione dei posti in base alle priorità
Questo esercizio combinava la gestione stabile dei pari, la priorità discendente, l'assenza di mutazioni, la capacità esatta e una regola di “salto e proseguimento”. Il codice originale eseguiva l'ordinamento nella direzione sbagliata, modificava l'array di input e si interrompeva troppo presto quando una richiesta risultava di dimensioni eccessive.
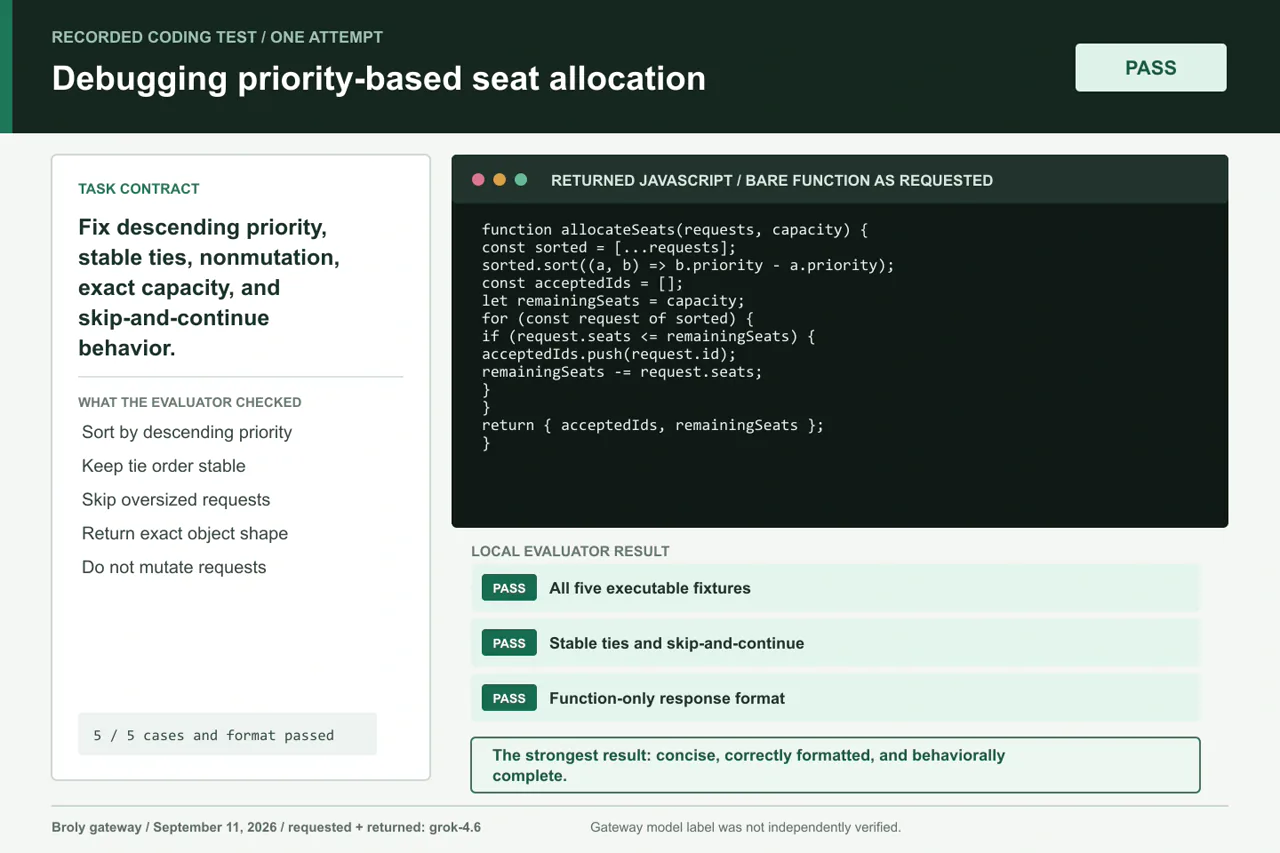
Confine chiave: Questa è stata l'unica risposta che ha soddisfatto sia i requisiti del contratto comportamentale sia il formato di output esatto.
Risultato: tutti e cinque i casi sono stati superati, compresi quelli con ordine di priorità uguale, una richiesta principale di dimensioni eccessive, capacità esatta, capacità pari a zero e un elenco vuoto. L'input è rimasto invariato, ID accettati era un nuovo array e il modello ha restituito solo la funzione richiesta.
Conclusione pratica: Questo è proprio il tipo di lavoro per cui Grok è particolarmente adatto: una sola funzione, un contratto chiaro e casi limite che possono essere eseguiti immediatamente.
Test 3: rifattorizzazione senza compromettere il funzionamento
La terza richiesta chiedeva a Grok di sostituire le scansioni ripetute con un unico passaggio di aggregazione, preservando al contempo l'ordine, i nomi insoliti dei file e la struttura esatta dell'output. Si tratta di un rischio realistico legato alla rifattorizzazione: il codice può diventare più veloce e pulito, ma perdendo al contempo alcune funzionalità.
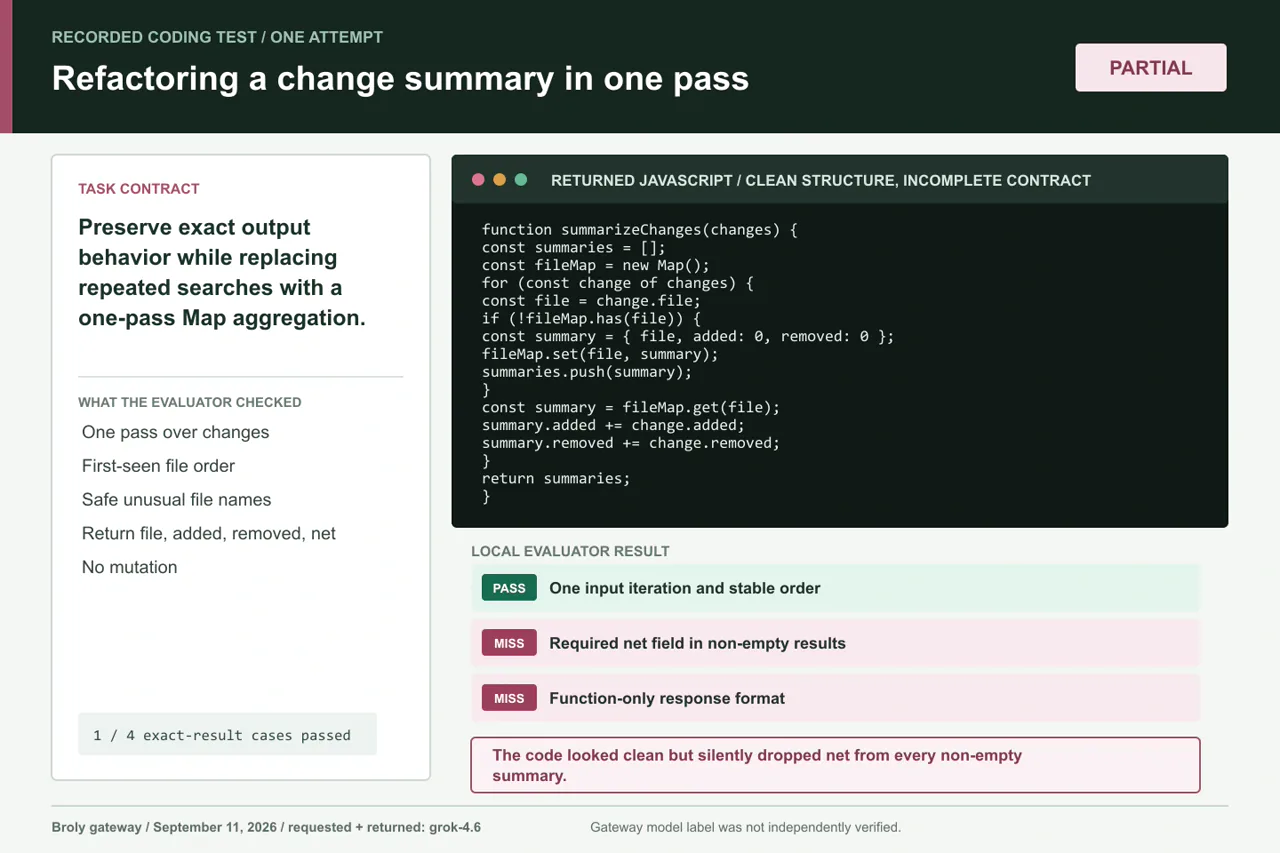
Confine chiave: L'approccio "Map" a passaggio singolo sembrava corretto, ma ometteva silenziosamente il campo "net" richiesto.
Risultato: la risposta ha utilizzato un passaggio, un Mappa, ordinamento corretto in base alla prima apparizione, gestione sicura di __proto__ e costruttore, e nessuna mutazione nei dati di input. Tuttavia, non ha mai calcolato né restituito netto. Il caso vuoto è stato superato perché non conteneva oggetti risultato; tutti e tre i casi non vuoti hanno fallito il confronto esatto.
Conclusione pratica: Non giudicare mai una rifattorizzazione solo in base alla complessità algoritmica o alla pulizia del codice. Esegui uno snapshot dei vecchi risultati, verifica tutti i campi obbligatori e confronta il comportamento prima di accettare la nuova versione.
Test 4: scrivere test in grado di individuare bug plausibili
L'ultimo compito ha ribaltato la consueta configurazione: Grok ha scritto i test e il nostro harness li ha eseguiti su un'implementazione di riferimento rigorosa e su quattro implementazioni volutamente errate. L'obiettivo non era la copertura di linea, bensì verificare se gli input scelti fossero in grado di distinguere semantiche apparentemente simili.
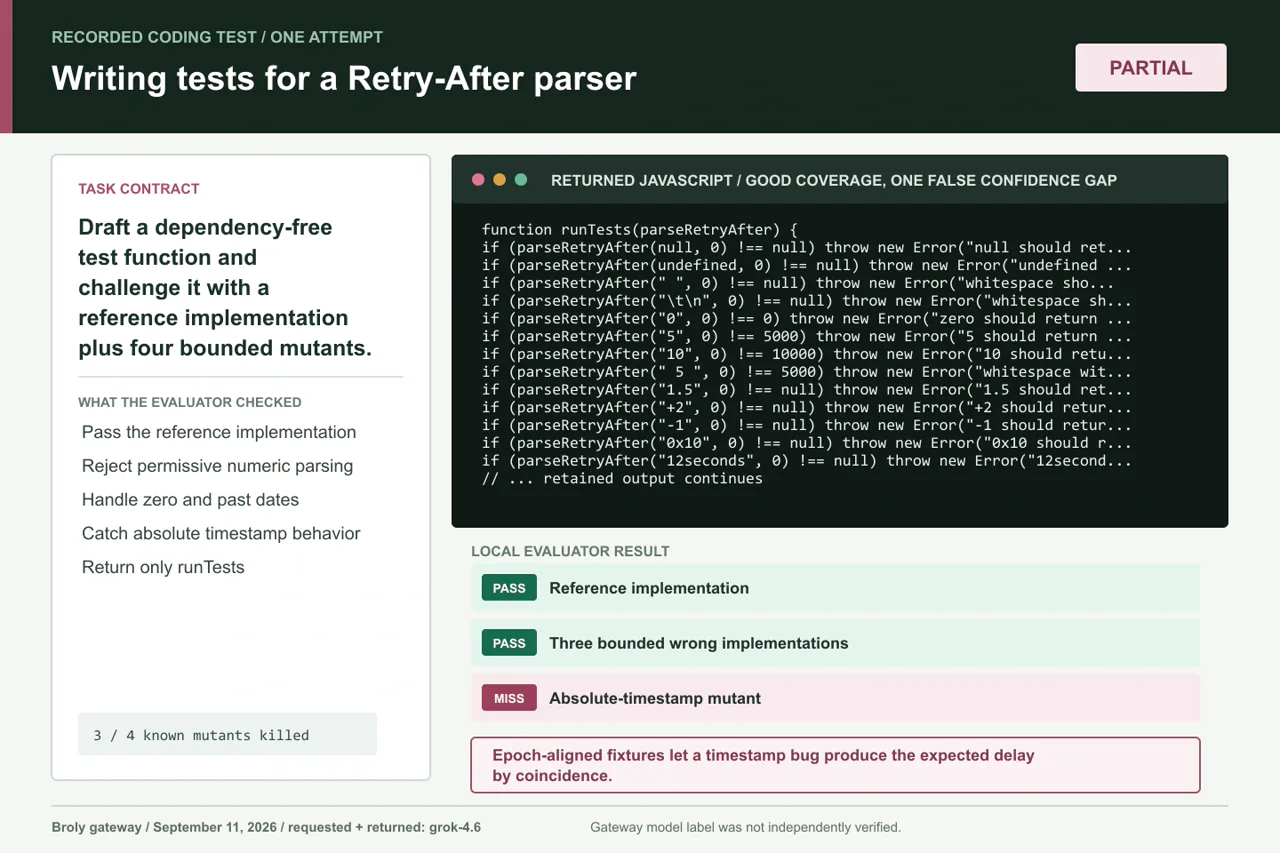
Confine chiave: I fixture di data allineati all’epoca consentono, per caso, a un bug relativo al timestamp assoluto di passare inosservato.
Risultato: La suite ha superato il test di riferimento e ha rilevato l'analisi numerica permissiva, il trattamento dello zero come valore falso e un ritardo negativo per una data passata. Non ha invece rilevato il caso anomalo che restituiva il timestamp assoluto della data analizzata. Entrambi i test relativi alle date utilizzavano valori allineati all'epoca, quindi il ritardo previsto coincideva casualmente con il timestamp.
Conclusione pratica: I test scritti dall'IA rappresentano un utile primo approccio, ma non costituiscono una prova di correttezza. Chiediti cosa distingue ogni fixture. I test di mutazione, i test di proprietà e i valori volutamente non allineati possono mettere in luce una suite che sembra solo completa.
Grok 4, Grok 4.6 e Grok Build non sono la stessa cosa
Contesto del lancio di luglio 2025. Il vecchio slug dell'API è stato successivamente dismesso.
L'etichetta restituita dal gateway in queste quattro attività isolate.
Un agente indipendente in grado di operare nell'ambito di un flusso di lavoro del repository interattivo o headless.
Uno strumento Python in ambiente sandbox che deve essere abilitato in una richiesta supportata.
Il Annuncio originale Grok 4 Si tratta del contesto storico del lancio. Non descrive il modello utilizzato nei nostri test del 2026.
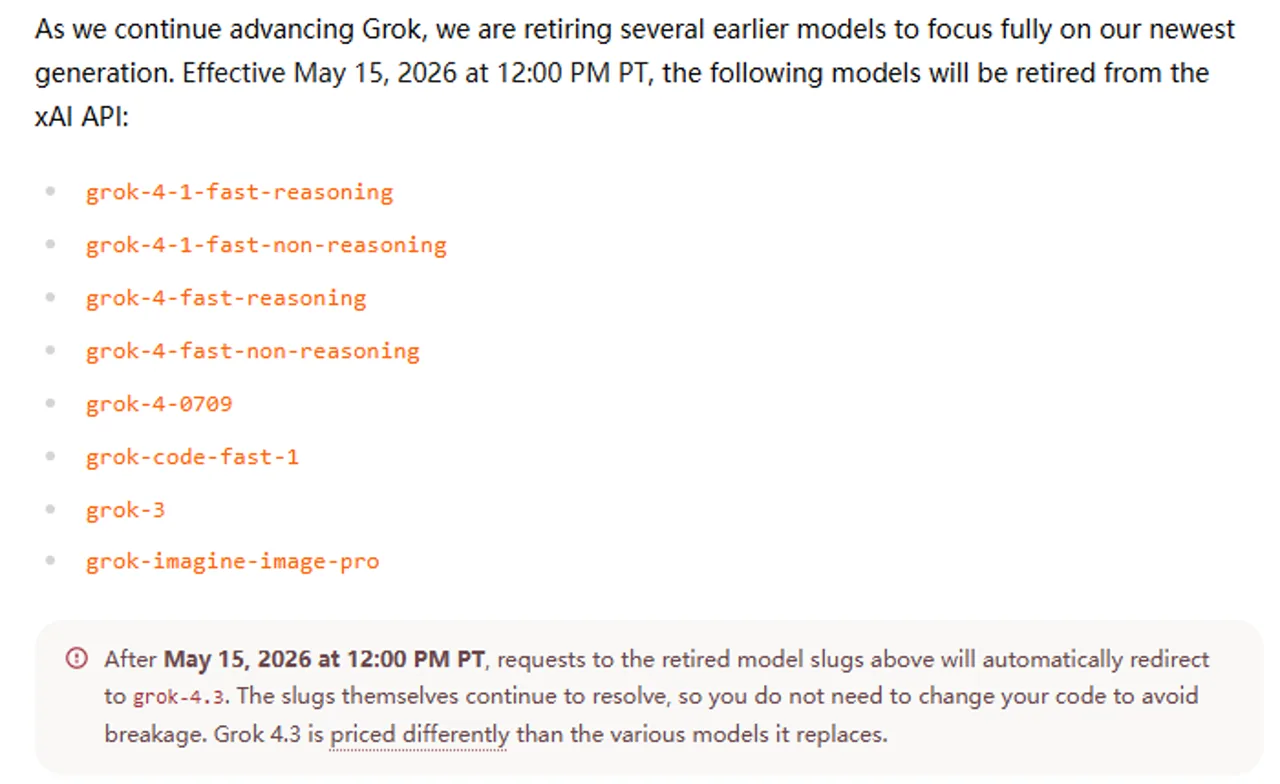
xAI’s Avviso di migrazione del 15 maggio 2026 dice grok-4-0709 ora reindirizza a Grok 4.3 con un livello di ragionamento basso. Ciò non significa che tutti i prodotti che recano il nome della famiglia Grok 4 siano scomparsi; significa che è importante l'ID esatto del modello.
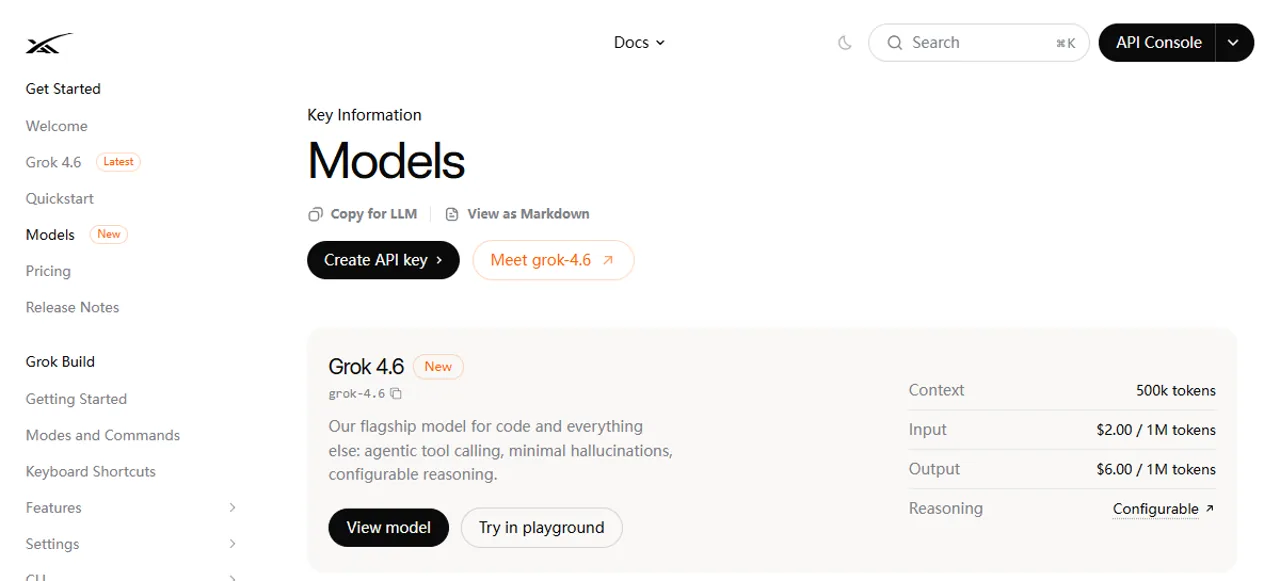
Grok 4.6 è il modello attuale consigliato da xAI per la scrittura di codice. Il sito ufficiale Specifiche Grok 4.6 tra gli strumenti supportati figurano la chiamata di funzioni, la ricerca sul web, la ricerca X e l'esecuzione di codice. Il supporto non equivale all'attivazione automatica: è comunque il prodotto chiamante o la richiesta API a determinare ciò che il modello può vedere e fare.
Il Annuncio relativo al modello Grok 4.6 definisce il modello per agenti a esecuzione prolungata e attività relative al codice sorgente. Si tratta di una dichiarazione ufficiale relativa al prodotto, non di qualcosa che le nostre quattro attività JavaScript isolate hanno misurato in modo indipendente.
Versione Grok è l'agente di codifica autonomo. La sua interfaccia terminale interattiva e la modalità headless consentono di operare all'interno di un flusso di lavoro basato su repository. Se si sta scegliendo tra nomi di modelli anziché tra prodotti di codifica, il Il miglior modello Grok in base all'attività La guida illustra la situazione attuale della famiglia.
Il Strumento per l'esecuzione di codice xAI è un ambiente Python opzionale in modalità sandbox. Nei nostri test su Broly non era attivo, quindi il modello non ha eseguito il proprio codice JavaScript né ha analizzato il feedback del valutatore prima di rispondere.
I migliori casi d'uso di codifica per Grok
Risoluzione di un errore circoscritto
Grok è particolarmente utile quando il problema può essere ricondotto a una funzione, a una traccia dello stack, a un fixture difettoso o a un breve diff. Indica cosa dovrebbe accadere, cosa è effettivamente accaduto e i limiti che non desideri vengano modificati. Il risultato dell'assegnazione dei posti mostra come un caso limite ben preciso possa trasformare una vaga richiesta del tipo “risolvi questo problema” in una patch verificabile.
Creazione di una prima implementazione
Per quanto riguarda adattatori, parser, funzioni di trasformazione ed esempi di API, Grok è in grado di eliminare gli ostacoli legati alle pagine vuote. Richiedi l’unità completa più piccola, le versioni della libreria dei pin ed esegui lo snippet. Il Guida all'integrazione API Grok 4 è il passo successivo quando il lavoro riguarda l'API anziché una soluzione di codice isolata.
Revisione o stesura di prove
Chiedi a Grok quali siano i casi limite mancanti, gli invarianti e i mutanti candidati. Verifica quindi se ciascun input mette in evidenza il comportamento che dichiara di testare. La suite Retry-After era ampia sulla carta, eppure una coppia di timestamp allineati ha permesso a un bug semantico di sfuggire al controllo.
Confronto tra approcci alternativi
Grok è utile anche come secondo parere su un algoritmo, una struttura dati o un'ipotesi di debug. Quando la decisione riguarda l'idoneità di un assistente piuttosto che una singola correzione, il Confronto tra i codici Grok e ChatGPT aggiunge una vista trasversale ai modelli.
Quando la codifica Grok richiede supervisione
Rifatturazioni che preservano il comportamento: Il modello è in grado di soddisfare l'algoritmo richiesto pur non disponendo di un campo di output. Eseguire i test di regressione e confrontare gli output serializzati, gli errori, l'ordinamento, le mutazioni e gli effetti collaterali.
Modifiche al repository con più file: Le nostre prove non riguardano l'individuazione delle dipendenze, i sistemi di compilazione, la ricerca nel codice, i file generati, le migrazioni o le modifiche coordinate. Utilizzate un vero e proprio agente di codifica con accesso limitato al repository, quindi esaminate i suoi comandi e il diff. Il Confronto tra Codex e Claude: analisi degli agenti dimostra perché il flusso di lavoro circostante è importante tanto quanto il modello stesso.
Attività relative alla sicurezza e alla produzione: Non considerare una risposta positiva come un modello di minaccia, un audit delle dipendenze o un’approvazione della distribuzione. Assicurati di integrare nel processo la CI, l’analisi statica, la scansione delle informazioni riservate, lo staging, il rollback e la revisione umana.
Formati rigorosamente machine-to-machine: Tre delle quattro risposte grezze utilizzavano una barriera Markdown nonostante le istruzioni esplicite che vietavano l'uso di Markdown. Convalida e analizza l'output ai margini; non trasmettere mai il testo del modello direttamente all'esecuzione solo perché sembra codice.
Costi e lunghe tracce di ragionamento: il nostro gateway ha segnalato 4.260 token di completamento per una richiesta con max_tokens: 4096, principalmente come token di ragionamento. Tale osservazione non dimostra il comportamento di fatturazione o di limitazione di xAI. Controlla la piattaforma ufficiale attuale e confrontala con la Grok 4: Guida ai prezzi e alla configurazione dell'API prima di stimare il budget di produzione.
Una procedura pratica per l'utilizzo di Grok nel codice
1. Ridurre il problema
Indica per Grok il caso di riproduzione più semplice in cui l'errore si verifica ancora. Includi il messaggio di errore, il codice pertinente e un risultato atteso. Rimuovi la cronologia del progetto non pertinente e le informazioni riservate.
2. Scrivi un contratto, non un desiderio
Indicare il nome della funzione, gli input accettati, la struttura esatta del risultato, l’ordinamento, le regole di mutazione, i limiti di dipendenza e il formato dell’output. Il Guida all'uso del Grok (4 pagine) tratta il flusso di lavoro più ampio relativo alla creazione dei resoconti e alla generazione di richieste.
3. Chiedi un piccolo resto
Preferisci una singola funzione o una modifica mirata piuttosto che una riscrittura radicale. Chiedi di mantenere il comportamento pubblico e di indicare eventuali ipotesi che è stato necessario formulare.
4. Effettuare controlli indipendenti
Eseguire il codice al di fuori della risposta del modello. Aggiungere casi limite che distinguano semantiche simili, verificare le mutazioni degli input, confrontare ogni campo di output e testare gli errori previsti. Per le suite di test generate, eseguire mutanti noti quando il rischio lo giustifica.
5. Esaminare le differenze e assumersi la responsabilità della decisione
Leggi il diff finale come se provenisse da un collaboratore in carne e ossa. Verifica le modifiche alle dipendenze, i limiti di sicurezza, l'osservabilità e la possibilità di rollback. La persona che esegue il merge o la distribuzione rimane responsabile del risultato.
Cosa dichiarano pubblicamente gli sviluppatori
Le esperienze dell'utenza sono contrastanti e dipendono in larga misura dall'attività, dal prodotto, dalla richiesta e dalla data. Due commenti su Hacker News ne illustrano l'ampiezza, ma nessuno dei due costituisce un punto di riferimento né un sondaggio rappresentativo.
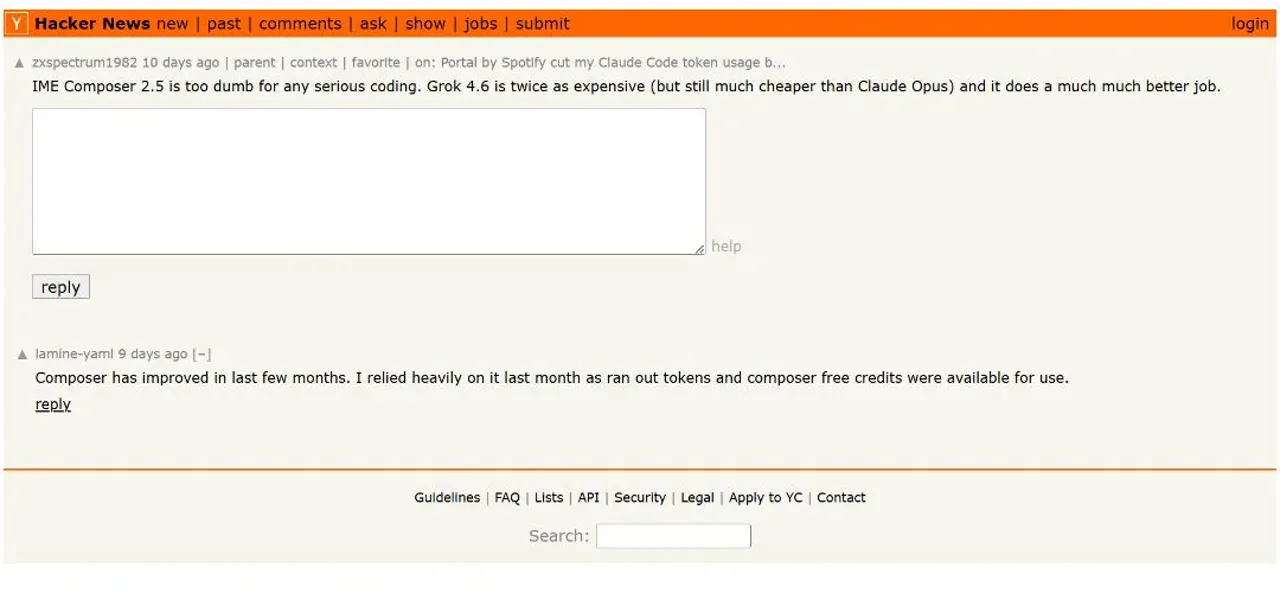
Il 5 settembre 2026, un utente di Hacker News zxspectrum1982 ha descritto Grok 4.6 come uno strumento molto più efficace di Composer 2.5 per la programmazione complessa, pur sottolineando che è più costoso. Si tratta del confronto di un singolo utente, non di un'affermazione generale sulle prestazioni.
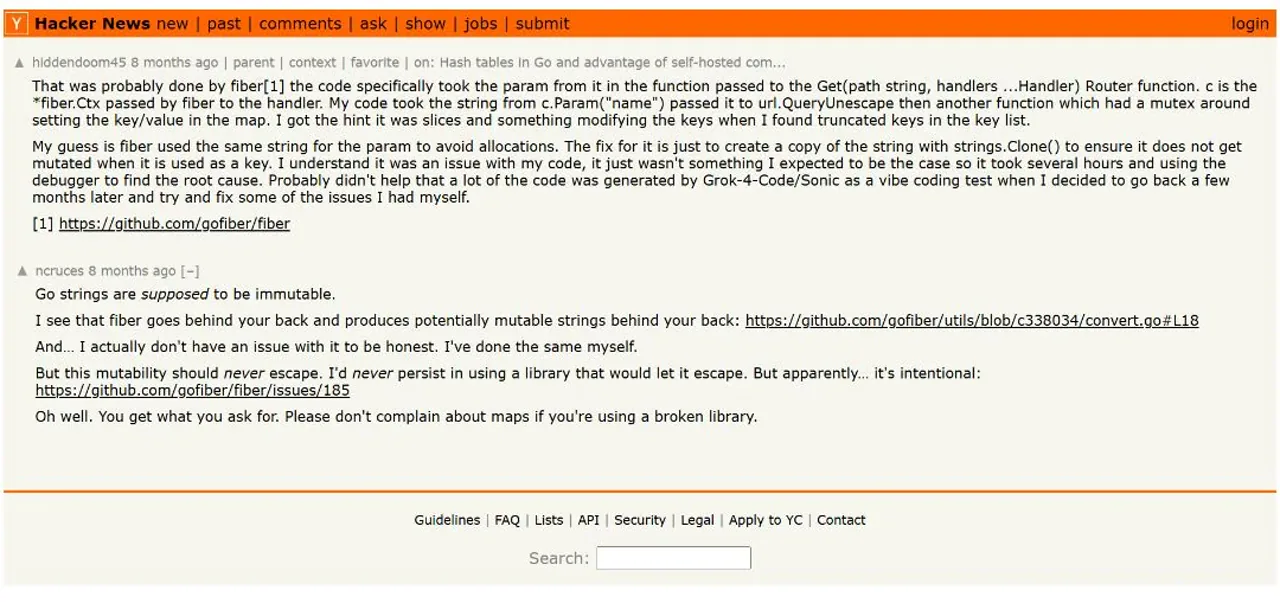
Il 20 dicembre 2025, un utente di Hacker News hiddendoom45 ha descritto come, in un secondo momento, sia stato individuato con un debugger un bug sottile relativo alla durata delle stringhe in Go/Fiber, dopo che il codice era stato generato nel corso di un esperimento Grok-4-Code/Sonic. Questo resoconto storico avvalora l’importanza del debug manuale e di una revisione che tenga conto della durata delle stringhe; non stabilisce tuttavia un tasso di fallimento del Grok pari al 4,6%.
Il filo conduttore non è che Grok abbia sempre successo o fallisca. È piuttosto che la qualità del codice diventa evidente solo dopo che il codice ha affrontato un compito concreto, una catena di strumenti e un revisore. Lo stesso vale nel caso a parte Analisi realistica della codifica ChatGPT: la qualità dell'assistenza è indissolubilmente legata alla verifica.
Domande frequenti
Il modello Grok 4 è adatto ai principianti della programmazione?
Sì, per le spiegazioni, i piccoli esempi e il debug guidato. I principianti dovrebbero comunque eseguire ogni frammento di codice, chiedere cosa cambia in ogni riga ed evitare di inserire informazioni riservate o di implementare codice che non conoscono senza averlo prima verificato.
Quale modello Grok dovrei utilizzare per la programmazione?
In base ai dati verificati l'11 settembre 2026, xAI raccomanda Grok 4.6 per il codice. Verifica l'ID esatto del modello nel tuo prodotto, poiché lo slug API originale grok-4-0709 è stato dismesso.
Grok 4.6 è in grado di modificare un intero repository?
Il modello può supportare le attività relative al repository se utilizzato all'interno di un agente con accesso limitato a file e comandi specifici. I nostri test consistevano in richieste isolate, pertanto non dimostrano l'idoneità all'uso autonomo su più file né la prontezza per l'ambiente di produzione.
L'uso di "Grok Build" equivale a utilizzare "Grok" nella chat?
No. Grok Build è un agente di programmazione autonomo, interattivo o headless. Una normale chat o un'operazione di completamento tramite API non riceve automaticamente il contesto del repository, il terminale, le autorizzazioni o il ciclo dello strumento.
Posso usare il modello Grok 4.6 per la codifica sul modello GlobalGPT?
Sì. GlobalGPT offre un percorso verificato Grok 4.6 per prompt di codifica con vincoli e confronti tra modelli. Si tratta di una piattaforma indipendente che non sostituisce Grok Build, un IDE o gli strumenti API nativi di xAI.
Devo fidarmi del codice generato da Grok senza testarlo?
No. Esegui il codice, aggiungi i casi limite, controlla le differenze e esegui i tuoi normali controlli di lint, tipo, sicurezza e CI. Il nostro refactoring sembrava corretto, ma ometteva un campo obbligatorio in ogni risultato non vuoto.
Il verdetto finale
Il modello Grok 4 è adatto alla programmazione? L'attuale modello Grok 4.6 è un valido assistente alla programmazione per correzioni circoscritte, piccole funzioni, spiegazioni e test di prima fase. Nella nostra suite di quattro compiti ha prodotto due soluzioni completamente corrette, una rifattorizzazione che ha compromesso il funzionamento del codice e una suite di test incompleta. Inoltre, in tre risposte ha ignorato un'istruzione che vietava espressamente l'uso di Markdown.
Utilizzatela nei casi in cui individuare un errore non comporti costi elevati: ambito ristretto, contratti espliciti, fixture eseguibili e revisione umana. Non considerate questa prova come un’autorizzazione a modificare il repository senza supervisione, a ottenere l’approvazione in materia di sicurezza o a effettuare l’implementazione in produzione.
Per una prova pratica, apri Grok 4,6 su GlobalGPT, esegui uno dei comandi completi riportati sopra e confronta il risultato con i tuoi test prima di decidere se inserirlo nel tuo flusso di lavoro.
Prova il modello Grok 4.6 con il tuo dispositivo di fissaggio