L'attuale limite di utilizzo dell'API Gemini 3.1 Pro di Google è di $2 per milione di token in ingresso e di $12 per milione di token in uscita per prompt fino a 200.000 token. Al di sopra della soglia di 200k token in ingresso, le tariffe pubblicate salgono a $4 per milione di token in ingresso e a $18 per milione di token in uscita. L'input memorizzato nella cache ha un costo di $0,20/M o $0,40/M, più $4,50 per milione di token memorizzati nella cache all'ora per lo spazio di archiviazione.
La pagina del modello identifica l'endpoint come gemini-3.1-pro-preview, con un limite di input di 1.048.576 token e un limite di output di 65.536 token. Supporta il ragionamento, la chiamata di funzioni, il grounding delle ricerche, il contesto URL, l’esecuzione di codice, l’API Batch, Flex e le opzioni di priorità. Queste funzionalità spiegano perché il disegno di legge necessiti di più di un dato saliente.
Se il tuo lavoro è di natura interattiva — analizzare un brief, confrontare modelli, scrivere codice e poi consegnare il risultato a un agente —GlobalGPT ti offre uno spazio di lavoro in abbonamento che abbraccia diversi modelli e funzioni di intelligenza artificiale. Gli sviluppatori possono inoltre avvalersi dell’API, della CLI, dell’MCP e dell’agente Yukie quando è necessario trasferire il lavoro da una chat a un flusso di lavoro ripetibile. Il prezzo dell’API indicato di seguito rimane quello a consumo applicato da Google.
- Che cos’è Gemini 3.1 Pro e cosa significa il limite di contesto
- Prezzi dell'API Gemini 3.1 Pro per milione di token
- Esempi di costi dell'API Gemini 3.1 Pro
- In che modo la memorizzazione nel cache del contesto incide sul conto
- I piani per i consumatori sono diversi dalla fatturazione tramite API
- Quando è opportuno utilizzare API, CLI, MCP o un'area di lavoro multimodello
- I piani per i consumatori e la fatturazione tramite API risolvono esigenze diverse
- Trasforma il listino prezzi in un vero e proprio preventivo
- Cosa cambia nella pratica quando si considera un contesto più ampio
- Quando uno spazio di lavoro è meglio di un registro simbolico
- FAQ
Che cos’è Gemini 3.1 Pro e cosa significa il limite di contesto
La pagina dedicata al modello pubblicata da Google descrive Gemini 3.1 Pro Preview come un modello ottimizzato per un ragionamento più approfondito, l’ingegneria del software, l’uso preciso degli strumenti e i flussi di lavoro degli agenti in più fasi. Il modello accetta input sotto forma di testo, immagini, video, audio e PDF, per poi restituire un testo.
| Dettagli del modello | Valore pubblicato | Perché è importante dal punto di vista dei costi |
|---|---|---|
| ID modello | gemini-3.1-pro-preview | Utilizza l'ID esatto quando associ una fattura o una configurazione SDK. |
| Limite di immissione | 1.048.576 token | È possibile un contesto ampio, ma i token continuano a essere considerati come input. |
| Limite di uscita | 65.536 gettoni | I dati di output di grandi dimensioni possono rappresentare la parte più consistente del costo di una richiesta. |
| Strumenti | Ragionamento, chiamata di funzioni, fondazione della ricerca, contesto URL, esecuzione del codice, memorizzazione nella cache | L'uso degli strumenti può comportare richieste o un utilizzo di token che va oltre un semplice prompt. |
Prezzi dell'API Gemini 3.1 Pro per milione di token
La pagina dei prezzi di Google distingue tra le modalità Standard, Batch, Flex, Priority e Contributor. La tabella sottostante riporta l'attuale piano a pagamento standard indicato per Gemini 3 Pro Preview, il cui link al modello identifica gemini-3.1-pro-preview.
| Piano a pagamento standard | Prompt ≤ 200.000 token | Prompt > 200.000 token |
|---|---|---|
| Token di input | $2.00 / 1M | $4.00 / 1M |
| Token di output, compreso il ragionamento | $12,00 / 1M | $18,00 / 1M |
| Input memorizzato nella cache | $0,20 / 1M | $0,40 / 1M |
| Memorizzazione nella cache | $4,50 / 1 milione di token all'ora | |
| Ricerca Google a terra | 5.000 richieste al mese ripartite tra i modelli Gemini 3 e successivi; successivamente, $14 ogni 1.000 richieste | |
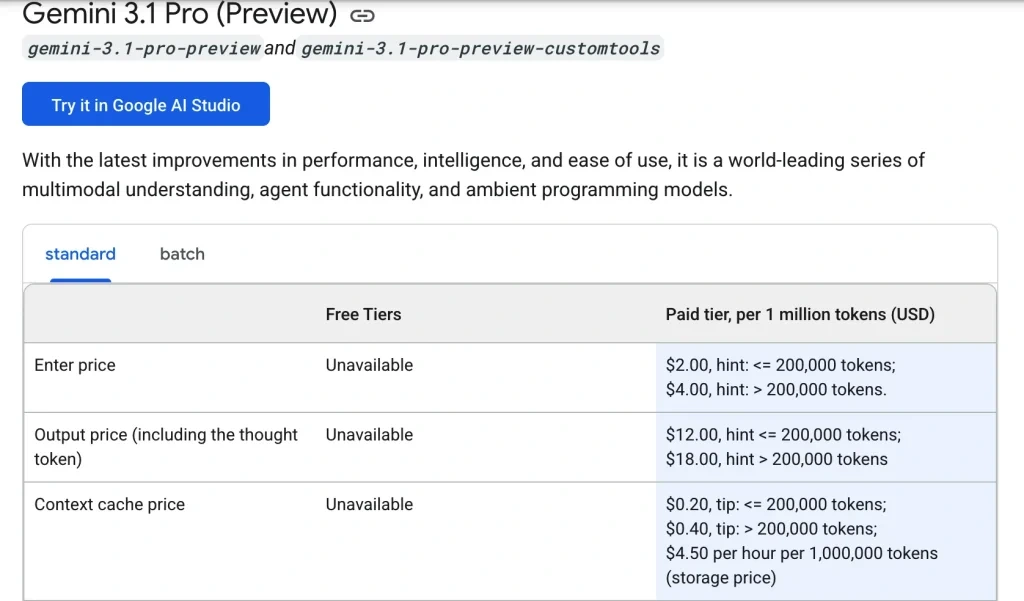
Ci sono due dettagli che possono facilmente sfuggire. Innanzitutto, nella tabella pubblicata la voce “output” include anche i token di elaborazione. In secondo luogo, una richiesta che attiva il grounding di Google Search può comportare addebiti per la ricerca una volta esaurito il credito mensile condiviso. Una risposta modello di per sé non costituisce una fattura completa.
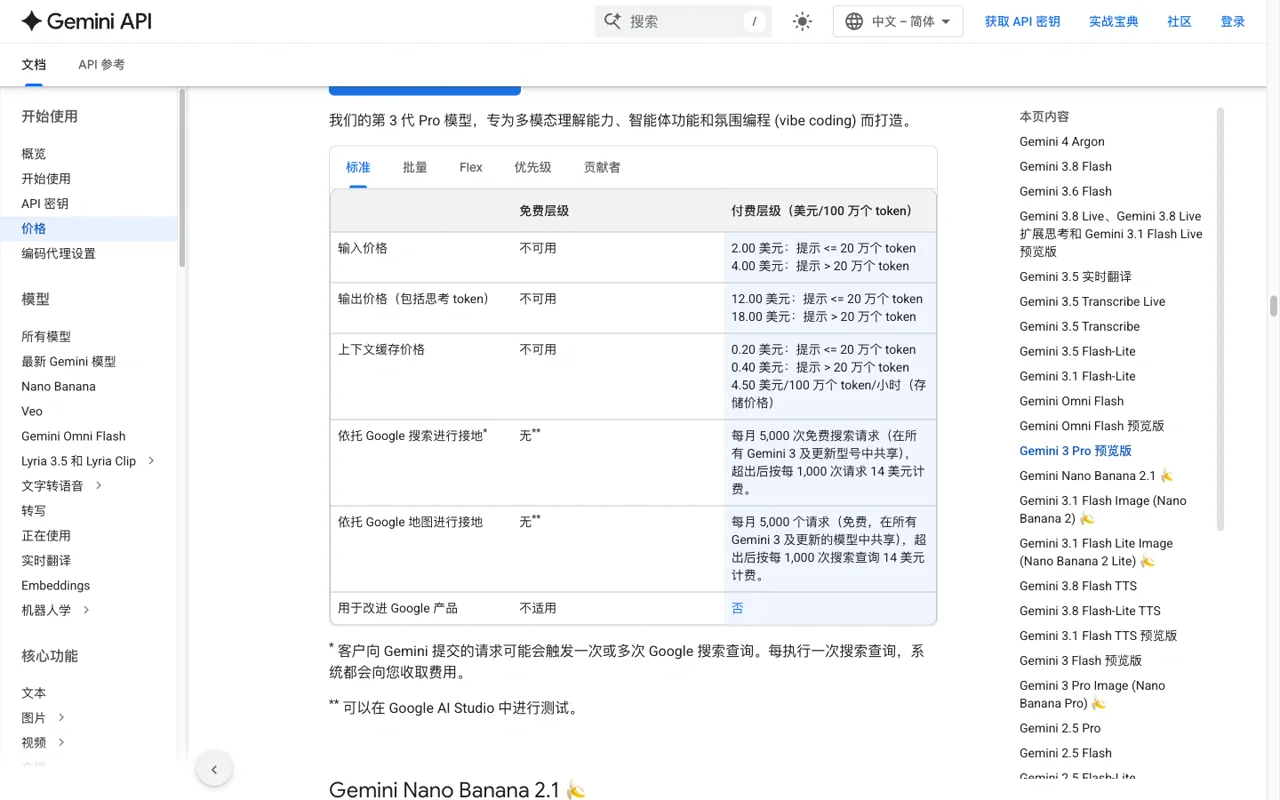
È proprio quel limite a trasformare una stima approssimativa in un costo diverso. Se una richiesta comporta un codice sorgente di grandi dimensioni o un contesto ricorrente, valuta le dimensioni del prompt prima di scegliere il modello o la modalità di memorizzazione nella cache.
Esempi di costi dell'API Gemini 3.1 Pro
Utilizzare i token ÷ 1.000.000 × la tariffa applicabile. Gli esempi riportati di seguito non includono tasse, crediti e costi specifici per gli strumenti.
| Scenario | Ingresso | Uscita | Costo stimato del token |
|---|---|---|---|
| Vendita allo scoperto | 50.000 × $2/M = $0,10 | 8.000 × $12/M = $0,096 | $0.196 |
| Prompt tecnico lungo | 250.000 × $4/M = $1,00 | 20.000 × $18/M = $0,36 | $1.36 |
| Contesto: 1 milione di token, output: 50.000 | 1.000.000 × $4/M = $4,00 | 50.000 × $18/M = $0,90 | $4.90 |
costo stimato = (token in ingresso ÷ 1.000.000 × tasso di ingresso) + (token in uscita ÷ 1.000.000 × tasso di uscita) + costi relativi agli strumenti/alle ricerche ammissibili
L'esempio da 250k supera la soglia dei 200k, quindi alla richiesta si applicano le tariffe più elevate. Se l'applicazione invia un prefisso ripetuto di grandi dimensioni, la memorizzazione nella cache può modificare la parte relativa agli input nella fattura, ma solo per i token che rientrano effettivamente nella categoria degli input memorizzati nella cache.
In che modo la memorizzazione nel cache del contesto incide sul conto
La memorizzazione nella cache è utile quando vengono inviati ripetutamente le stesse istruzioni lunghe, lo stesso contesto del codice o lo stesso materiale di riferimento. Per il livello standard mostrato sopra, l'input memorizzato nella cache costa $0,20/M al di sotto della soglia dei 200k e $0,40/M al di sopra di essa, mentre i token memorizzati nella cache costano $4,50/M token all'ora.
Si tratta di un'opzione prevista dal listino prezzi, non di uno sconto garantito su ogni richiesta ripetuta. Tieni traccia dell'utilizzo dei token memorizzati nella cache nei dati di fatturazione del fornitore e includi il tempo di conservazione nel preventivo.
I piani per i consumatori sono diversi dalla fatturazione tramite API
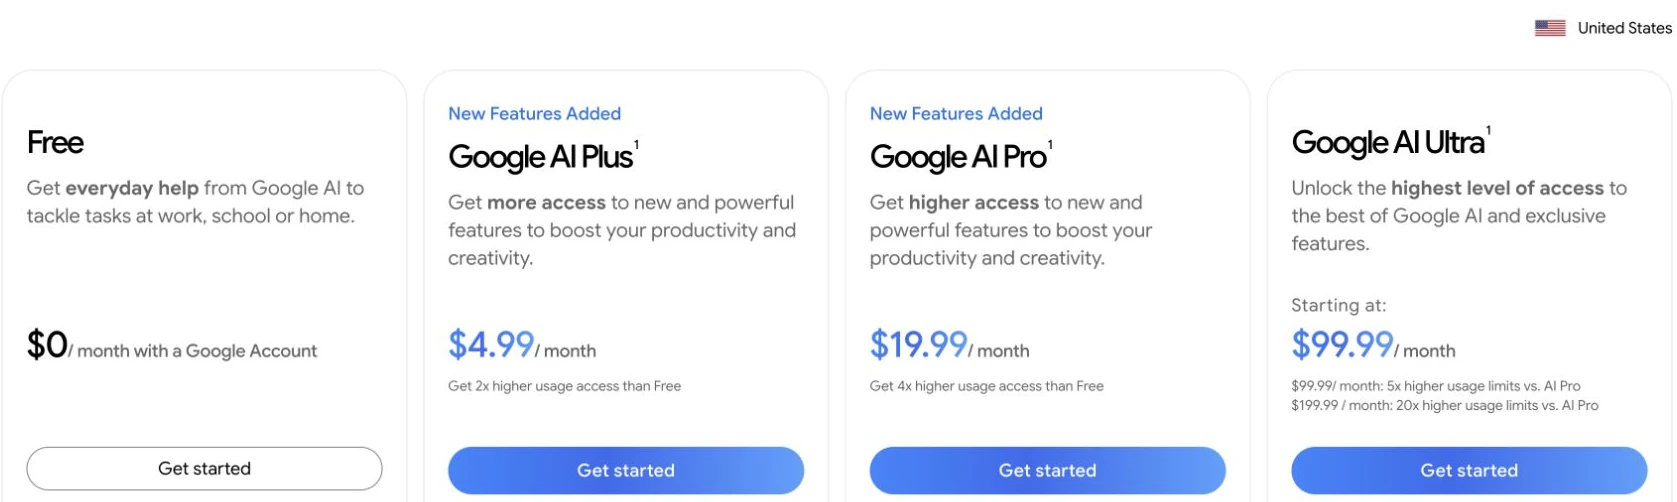
Un abbonamento a Google AI Pro o Ultra è un piano per utenti privati che prevede funzionalità dell'app e regole di accesso. La fatturazione dell'API Gemini viene calcolata in base ai token e agli strumenti utilizzati. Un abbonamento per utenti privati non si trasforma automaticamente in credito API, e un progetto API non include automaticamente i vantaggi riservati alle app per utenti privati.
Quando è opportuno utilizzare API, CLI, MCP o un'area di lavoro multimodello
Scegli l'API quando il tuo software richiede chiamate prevedibili e misurate, una chiave del provider e una fattura calcolabile dai log dei token. Scegli un percorso CLI o MCP quando il modello deve funzionare in combinazione con un terminale, un repository o un server di strumenti esistente. Un percorso tramite agente Yukie è utile quando il lavoro consiste in un'attività in più fasi che richiede pianificazione e passaggi di consegne, piuttosto che un completamento isolato.
GlobalGPT risponde alla dimensione interattiva di tale decisione: confrontare modelli, creare bozze, esaminare i risultati e passare alla codifica o ad altre funzioni di IA in un’unica dashboard. Il prezzo e i termini del piano costituiscono una decisione di prodotto a sé stante; il listino prezzi di Google riportato sopra rimane il riferimento per il costo dell’API Gemini.

I piani per i consumatori e la fatturazione tramite API risolvono esigenze diverse
Gemini 3.1 Pro può comparire sia in un piano per utenti finali che in un flusso di lavoro API per sviluppatori, ma non si tratta della stessa fattura. Un piano per utenti finali garantisce l’accesso a un’applicazione e ai limiti in essa inclusi. L’API addebita i token, lo spazio di archiviazione nella cache e l’utilizzo di eventuali strumenti o servizi di base nell’ambito di un progetto per sviluppatori.
| Se hai bisogno di… | Utilizza il percorso corrispondente | Budget di circa |
|---|---|---|
| Accesso all'app interattiva | Piano per i consumatori | Prezzo del piano, accesso incluso e limiti di utilizzo attuali. |
| Uno script o un'integrazione di prodotto | API Gemini | Costi di input, output, input memorizzato nella cache, archiviazione e strumenti. |
| Lavoro con il repository accanto a un terminale | CLI o uno strumento collegato tramite API | Le chiamate ai modelli e il flusso di lavoro che le invoca. |
| Un percorso in più fasi dalla ricerca alla produzione | MCP o un agente Yukie | Modalità di utilizzo del modello, strumenti approvati e numero di passaggi di consegne. |
Non descrivere un abbonamento per i consumatori come “credito API” e non utilizzare le tariffe dei token API per promettere l’accesso a una funzionalità dell’app.
Trasforma il listino prezzi in un vero e proprio preventivo
Inizia dalla dimensione del prompt, non dal nome del modello. Conta i token di input, verifica se la richiesta supera il limite di 200.000 token, stima l'output includendo i token di riflessione qualora il listino prezzi li preveda e aggiungi eventuali costi di ricerca o di contestualizzazione.
- Richiesta breve: token immessi ÷ 1.000.000 × il tasso di immissione più basso.
- Richiesta lunga: applicare le velocità di ingresso e di uscita più elevate alla richiesta che supera la soglia.
- Contesto ripetuto: contare solo i token che soddisfano i criteri per essere considerati input memorizzati nella cache e includere il tempo di permanenza nella cache.
- Condizioni di ricerca: aggiungere il costo pubblicato per ogni richiesta dopo la quota condivisa, ove applicabile.
- Previsione di produzione: aggiungere i tentativi successivi e le chiamate agli strumenti invece di moltiplicare solo la prima risposta.
Un calcolatore di token è utile quando i dati inseriti sono visibili. Tieni il limite, l'unità di fatturazione e la data accanto al risultato, in modo che chi leggerà in futuro possa capire il significato di quel numero.
Cosa cambia nella pratica quando si considera un contesto più ampio
Un limite di input di un milione di token non significa che ogni richiesta debba includere l'intero repository. I prompt di grandi dimensioni aumentano i costi e possono rendere più difficile identificare il file pertinente. Inizia con un indice, invia la porzione pertinente più piccola e aggiungi il file successivo solo quando la prima risposta dimostra che è necessario.
- Prima di inviare i file sorgente, crea una breve mappa del repository.
- Separare le istruzioni stabili dal cambio di contesto dell'attività.
- Memorizzare nella cache un prefisso ripetuto solo quando il rapporto sull'utilizzo conferma una corrispondenza.
- Chiedi i nomi dei file e i riferimenti alle righe, in modo da poter verificare il risultato.
- È preferibile effettuare una seconda revisione per i test o i casi limite, piuttosto che richiedere una riscrittura senza limiti.
È qui che API, CLI e MCP si rivelano utili: il modello può funzionare parallelamente al progetto, mentre il flusso di lavoro determina quale contesto viene inviato e quale strumento viene richiamato.
Quando uno spazio di lavoro è meglio di un registro simbolico
Utilizza l'API quando hai bisogno di chiamate applicative prevedibili e di un monitoraggio a livello di token. Utilizza la CLI quando lo sviluppo avviene in un terminale. Utilizza MCP quando l'attività richiede l'uso di strumenti esterni approvati. Utilizza un agente Yukie quando il lavoro comprende la pianificazione, l'uso di strumenti e i passaggi di consegne.
Per la ricerca interattiva e le opere multimediali, Area di lavoro Gemini 3.1 Pro di GlobalGPT ti offre uno spazio in cui confrontare un modello, scrivere codice e passare alle fasi relative a immagini, video, audio o agenti. Il vantaggio in termini di costi deriva dal fatto che una singola sottoscrizione copre una parte più ampia del flusso di lavoro; la tariffa dell'API di Google rimane un costo a parte addebitato dal fornitore.
FAQ
Quanto costa Gemini 3.1 Pro per ogni milione di token?
Per il piano a pagamento standard, Google indica un input di $2/M e un output di $12/M quando il prompt è pari o inferiore a 200k token. Superati i 200k, le tariffe sono $4/M in ingresso e $18/M in uscita.
Esiste un livello gratuito dell'API Gemini 3.1 Pro?
La pagina dei prezzi di Google mostra un piano gratuito con accesso limitato a modelli specifici. Controlla la riga corrispondente al modello in questione prima di dare per scontato che il modello Gemini 3.1 Pro disponga di accesso gratuito alle API.
L'API applica un costo per il grounding di Google Search?
L'attuale pagina dei prezzi indica 5.000 richieste di ricerca gratuite al mese, ripartite tra i modelli Gemini 3 e successivi, e successivamente $14 per ogni 1.000 richieste. Ogni query di ricerca può essere fatturata separatamente una volta esaurita la quota gratuita.
L'abbonamento a Google AI Pro include crediti API?
Non dare nulla per scontato. I prezzi dei piani per i consumatori e la fatturazione dei token API sono due cose distinte e vanno verificati nelle rispettive pagine ufficiali.
Qual è il modo più economico per utilizzare Gemini 3.1 Pro?
Per le chiamate di produzione programmabili, confronta la stima dei token, la memorizzazione nella cache e le opzioni batch o Flex che puoi effettivamente utilizzare. Per il lavoro interattivo su più modelli e funzioni, confronta separatamente un piano di spazio di lavoro corrente anziché considerarlo come credito API.
Usa il listino prezzi come uno strumento di calcolo, non come uno slogan: identificare l'ID esatto del modello, verificare il limite di 200k, contare i token di pensiero generati e tenere separati i piani dei consumatori dalla spesa per l'API.