Confronto tra i modelli Claude: Haiku, Sonnet e Opus, e dove si colloca Fable
Ariette Wynn
Ultimo aggiornamento: 9 settembre 2026
Una guida pratica per il 2026 alla scelta in base alla velocità, al costo dell’API, al contesto, alla complessità dell’attività e al costo di una risposta errata.
Per la maggior parte delle attività quotidiane di scrittura, analisi, programmazione e utilizzo di strumenti, inizia con Claude Sonnet 5. Scegli Haiku 4.5 quando la bassa latenza e l’elevato volume di dati sono più importanti della gestione di casi limite complessi. Scegliete Opus 5 quando l’attività è complessa, difficile da verificare o quando un errore comporta costi elevati. Fable 5.1 si colloca al di sopra di Opus come percorso di escalation specialistico, non come impostazione predefinita.
Tali raccomandazioni si riferiscono a carichi di lavoro misti generici. Le linee guida di produzione di Anthropic indicano che la maggior parte dei carichi di lavoro dovrebbe partire da Opus 5, mentre la sua matrice delle attività posiziona separatamente Sonnet per le attività quotidiane che richiedono velocità e prestazioni. Il punto di partenza corretto dipende quindi dalla vostra tolleranza al rischio e dal vostro processo di valutazione, non solo dal nome del modello.
GlobalGPT amplia il flusso di lavoro Tutto questo con un unico abbonamento conveniente: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 e numerose funzioni di intelligenza artificiale condividono un’unica dashboard per la ricerca, la scrittura, l’analisi, la programmazione e la messa a punto. La sua interfaccia a riga di comando (CLI) consente inoltre di integrare l’accesso a tali modelli nel proprio terminale, nel flusso di lavoro di sviluppo e negli strumenti di produzione esistenti. Il confronto dei risultati è una parte utile del flusso di lavoro; per una scelta più ampia a livello di famiglia, consultare la nostra Confronto tra ChatGPT, Claude e Gemini. Il resto di questa guida si concentra sulla scelta all'interno della configurazione Claude.
I quattro livelli attuali risolvono problemi economici diversi. La chiamata più economica non è sempre l’attività completata al minor costo, e il modello più potente non rappresenta automaticamente l’utilizzo ottimale di un budget.
Guida alla scelta del modello Claude
Scegli in base al carico di lavoro e al costo dei guasti
Utilizza Sonnet per un lavoro quotidiano equilibrato, passa a un livello inferiore per garantire l’efficienza e a uno superiore quando la verifica risulta complessa o gli errori comportano costi elevati.
Haiku 4.5
L'efficienza prima di tutto
Inizia da qui per attività ad alto volume, sensibili alla latenza e chiaramente delimitate, i cui errori sono economici da individuare e correggere.
Avanzare quandoI casi limite o i tempi di correzione da parte dei revisori annullano il vantaggio in termini di prezzo dei token.
Sonetto 5
Equilibrio quotidiano
Da utilizzare per attività che combinano scrittura, analisi, programmazione, comprensione visiva e utilizzo di strumenti, che vengono comunque sottoposte alla normale revisione.
Avanzare quandoIl ragionamento a lungo termine, la verifica o il costo dei fallimenti diventano il fattore limitante.
Opus 5
La capacità prima di tutto
Inizia da qui se devi affrontare una codifica complessa e articolata, attività aziendali, diagnosi difficili o decisioni in cui un errore può comportare costi elevati.
Scorri verso il basso quandoUn modello più economico supera ripetutamente gli stessi controlli di accettazione.
Fable 5.1
Percorso di eccezione
Ricorrere all'escalation solo in caso di ragionamenti complessi o attività degli agenti di lunga durata, qualora Opus, nonostante richieda uno sforzo maggiore, non soddisfi comunque i tuoi criteri di valutazione.
Non dare nulla per scontatoUn livello superiore risulta automaticamente più conveniente una volta presi in considerazione la qualità, i tempi di revisione e i tentativi.
La regola pratica
Selezionare un’attività rappresentativa e i relativi controlli di accettazione. Scegliere il modello meno costoso che superi i test in modo affidabile, quindi calcolare il tempo necessario per la correzione e la verifica prima di definirlo l’opzione più economica.
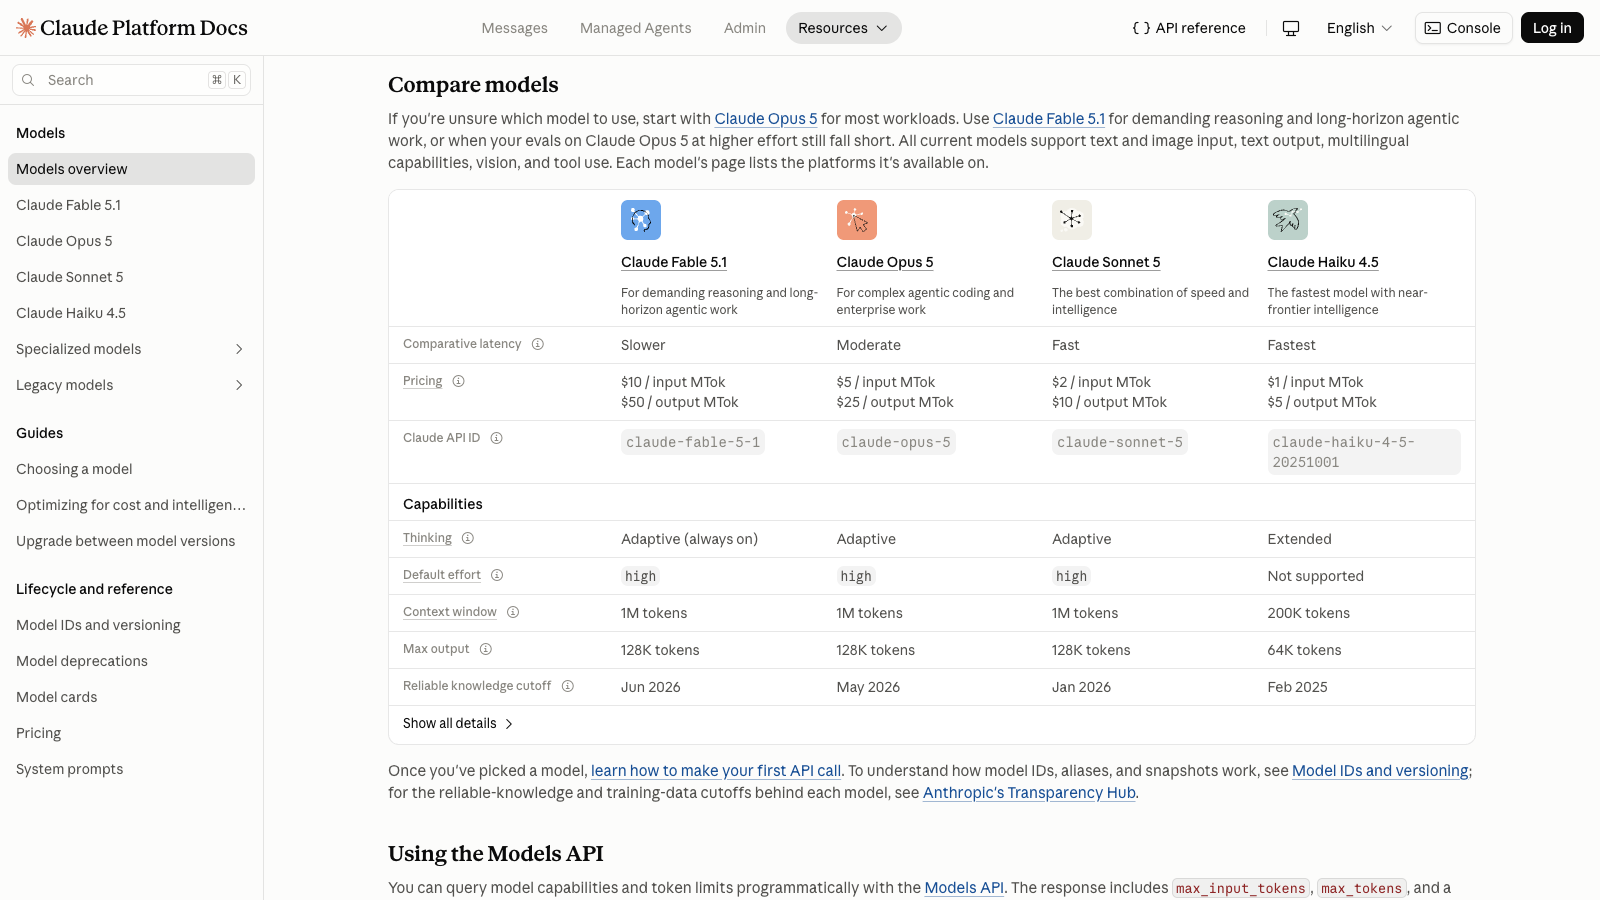
L'attuale gamma di modelli Claude
All'8 settembre 2026, la gamma attiva di Anthropic comprende Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 e Claude Fable 5.1. Haiku, Sonnet e Opus sono nomi di famiglia consolidati, ma la versione associata a ciascuna famiglia cambia nel tempo. È consigliabile annotare l’ID esatto del modello valutato in produzione, anziché dare per scontato che un’etichetta di famiglia rimandi sempre allo stesso snapshot.
Modello attuale
Etichetta ufficiale relativa alla velocità
Contesto API
Potenza massima
Input/output dell'API di base
Haiku 4.5
Il più veloce
200K
64K
$1 / $5 per MTok
Sonetto 5
Veloce
1M
128K
$2 / $10 per MTok
Opus 5
Moderato
1M
128K
$5 / $25 per MTok
Fable 5.1
Più lento
1M
128K
$10 / $50 per MTok
La panoramica dei modelli di Anthropic elenca Haiku 4.5, Sonnet 5, Opus 5 e Fable 5.1 come gamma attuale all'8 settembre 2026.
L'accesso a Claude.ai non corrisponde alle specifiche dell'API
La tabella dei piani Claude.ai descrive l’accesso per gli utenti consumer e attualmente indica una finestra di contesto di 200K per i singoli piani. La documentazione dell’API elenca i limiti di contesto e di output specifici per ciascun modello, tra cui una finestra di contesto di 1M per Sonnet 5, Opus 5 e Fable 5.1. Non utilizzare la tabella delle API per dedurre cosa includa un particolare piano Claude.ai, né utilizzare la tabella dei piani per gli utenti per dedurre i limiti di un modello API. Vedere la Guida ai prezzi e ai piani di Claude per quanto riguarda la distinzione a livello di piano.
Claude Haiku vs Sonnet vs Opus: differenze principali
Il compromesso principale non consiste in una semplice classifica di qualità. Salendo di livello si ottengono maggiori capacità per lavori complessi, ma aumentano anche il costo base in gettoni e, in generale, si riduce la velocità. Anche i limiti di contesto e i controlli di ragionamento variano.
I compromessi pratici
Specifiche ufficiali delle etichette e delle API di base, accompagnate da punti di partenza pratici per i carichi di lavoro più comuni.
Dimensione
Haiku 4.5
Sonetto 5
Opus 5
Il punto di partenza ideale
Lavoro veloce, ripetuto e limitato
Lavoro intellettuale misto di tipo quotidiano
Lavoro complesso e dalle conseguenze rilevanti
Etichetta ufficiale relativa alla velocità
Il più veloce
Veloce
Moderato
Contesto API / output
200K / 64K
1M / 128K
1M / 128K
Controllo del ragionamento
Riflessione approfondita sul manuale
Pensiero adattivo e impegno
Pensiero adattivo e impegno
Prezzo base dell'API
Ingresso $1 / Uscita $5
Ingresso $2 / Uscita $10
Ingresso $5 / uscita $25
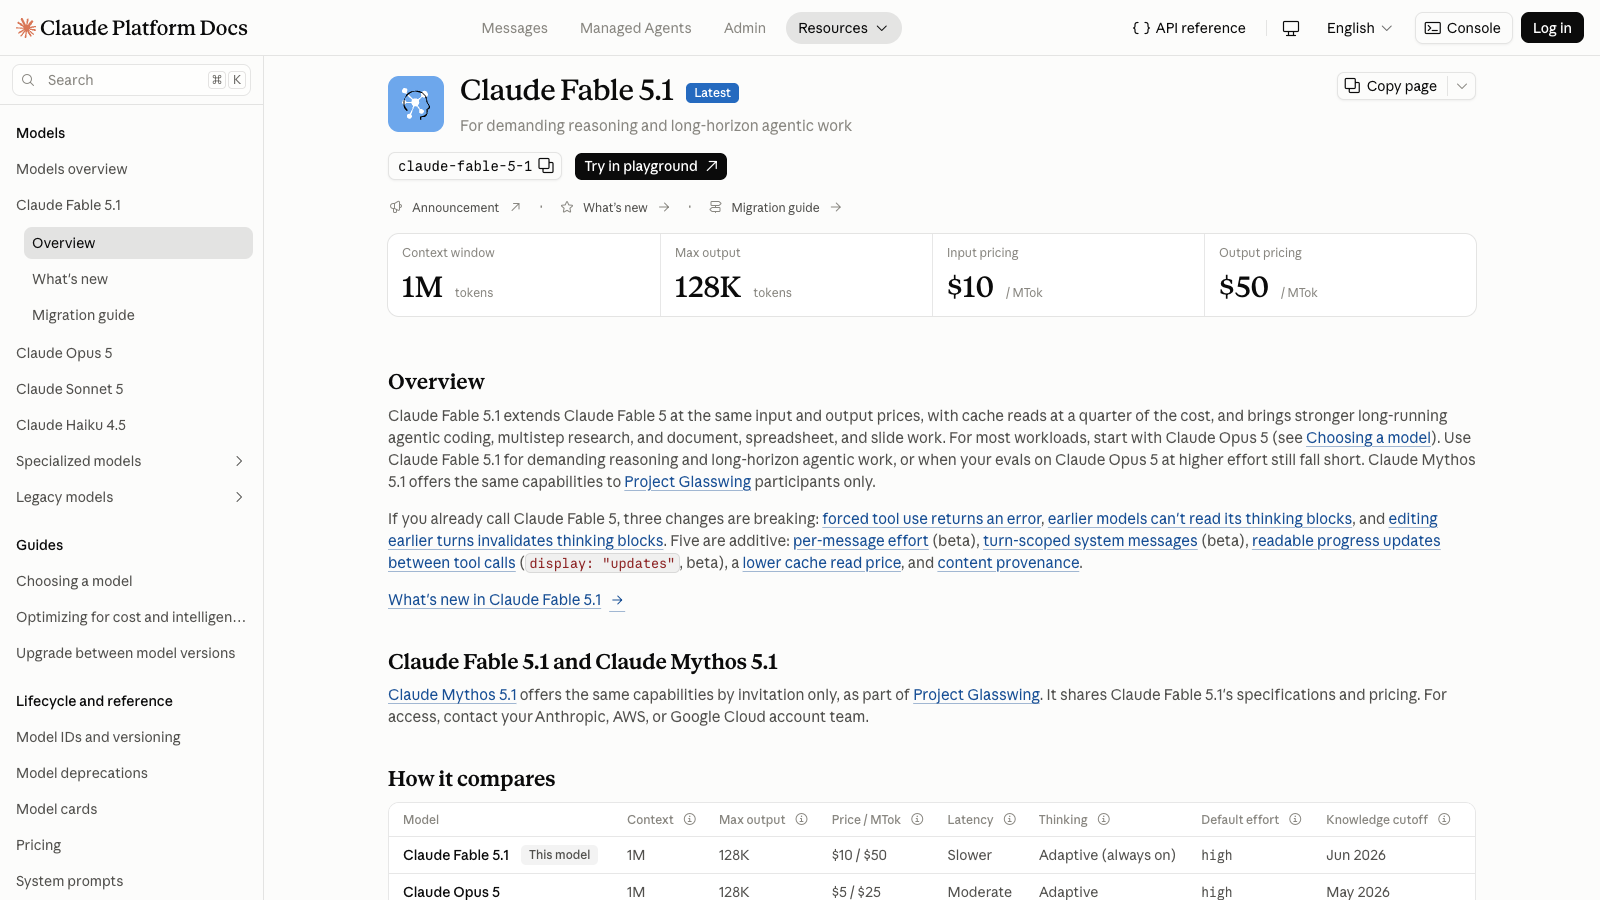
Dove si colloca Fable: Fable 5.1 è ufficialmente classificato come "Slower", con un contesto di 1M, un output massimo di 128K e prezzi di base di ingresso/uscita pari a quelli dei modelli $10 / $50 per milione di token. Consideratelo come un livello superiore a cui ricorrere quando Opus, anche con un livello di sforzo maggiore, non soddisfa comunque i vostri requisiti di valutazione.
Velocità e latenza
Anthropic definisce Haiku 4.5 “Il più veloce”, Sonnet 5 “Veloce”, Opus 5 “Moderato” e Fable 5.1 “Più lento”. Si tratta di etichette qualitative dei prodotti, non di valori misurati in millisecondi o token al secondo. La latenza effettiva dipende dalle dimensioni della richiesta, dalle impostazioni di ragionamento, dagli strumenti, dal carico e dalla modalità di servizio.
Controlli relativi al contesto, all'output e al ragionamento
Il contesto API ridotto di Haiku (200K) e l’output massimo di 64K sono comunque più che sufficienti per molti lavori con limiti prestabiliti. Sonnet e Opus estendono entrambi i limiti rispettivamente a 1M e 128K. Haiku 4.5 utilizza il ragionamento esteso manuale, mentre Sonnet 5 e Opus 5 supportano il ragionamento adattivo e il controllo dello sforzo. Questa differenza è uno dei motivi per cui un’unica impostazione di ragionamento identica non può creare test perfettamente equivalenti su tutti i modelli.
Quale modello Claude dovresti utilizzare per ciascuna attività?
Carico di lavoro
Iniziare con
Perché
Aggiornamento quando
Classificazione, estrazione, instradamento, valutazione dei casi
Haiku 4.5
La bassa latenza e il basso costo di base dei token si adattano bene a attività chiare e ripetibili.
I casi limite o i tempi di correzione annullano i risparmi.
La qualità è più importante del prezzo più basso per token.
Opus, nonostante il maggiore impegno profuso, continua a non superare una valutazione rappresentativa particolarmente rigorosa.
Lavori eccezionali che richiedono un impegno prolungato o un intenso lavoro di ragionamento
Fable 5.1
È l'attuale percorso di escalation al di sopra di Opus.
Utilizzarlo solo quando i benefici misurati ne giustificano il costo più elevato.
Si tratta di spunti di partenza, non di soluzioni universali. Ad esempio, una modifica al codice breve ma di grande importanza potrebbe giustificare l’uso di Opus, mentre un’operazione di estrazione lunga ma altamente strutturata potrebbe comunque adattarsi meglio a Haiku. Per esempi pratici di flussi di lavoro, consulta la nostra guida a utilizzando Claude per la codifica.
Quando la tua lista ristretta va oltre Claude, GlobalGPT ti permette di eseguire lo stesso prompt rappresentativo su Claude, GPT-5.6 Sol, Gemini 3 Pro e Kimi K3 in un unico spazio di lavoro. Mantieni costante il controllo di accettazione: la velocità è importante per i lavori ripetitivi, mentre la qualità delle risposte e il tempo di correzione determinano se un risultato a basso costo sia effettivamente più conveniente.
Scegli in base al costo del fallimento, non solo al tipo di attività
Le etichette degli esercizi nascondono la variabile più importante: cosa succede quando la risposta è sbagliata? Il quadro riportato di seguito è uno strumento decisionale editoriale basato sulle linee guida di Anthropic che privilegiano l’efficienza e le capacità. Non si tratta di un benchmark Anthropic.
Scala dei costi di fallimento
Inizia da un livello più basso quando individuare gli errori è poco costoso; inizia da un livello più alto quando la verifica è incompleta o costosa.
A basso costo
Esempi Etichettatura, instradamento, pulizia delle bozze, sintesi reversibili
Inizio Haiku 4.5
Inoltrare Quando il tempo dedicato alle correzioni annulla il guadagno in termini di efficienza
Materiale
Esempi Bozze destinate ai clienti, analisi revisionate, codice di produzione testato
Inizio Sonetto 5
Inoltrare Quando la revisione non è in grado di individuare in modo affidabile errori significativi
Costoso
Esempi Cambiamenti che richiedono un’elevata autonomia, diagnosi complesse, decisioni con conseguenze significative
Inizio Opus 5
Inoltrare A Fable solo dopo che Opus, con uno sforzo maggiore, non supera una valutazione congelata
Quando effettuare l'aggiornamento o il downgrade del modello Claude
Avanzare solo quando compare un limite misurato
Dall'haiku al sonetto
Effettuare l'aggiornamento quando i casi limite, le istruzioni mancanti o il tempo impiegato dai revisori per le correzioni superano i risparmi ottenuti.
Sonetto a Opus
Effettuare l'aggiornamento quando l'esecuzione a lungo termine, il ragionamento complesso, la verifica o il costo dei guasti diventano fattori limitanti.
Opus a un livello di sforzo più elevato
Verificate il carico di lavoro impegnativo con controlli di accettazione "congelati" prima di passare al livello superiore.
Da “Opus” a “Fable”
Passare al livello successivo solo se Opus, pur con uno sforzo maggiore, continua a non superare la valutazione rappresentativa e se il beneficio giustifica il costo.
Regola di declassamento: Torna indietro quando un modello più economico supera ripetutamente gli stessi controlli di accettazione con la latenza e l'affidabilità richieste.
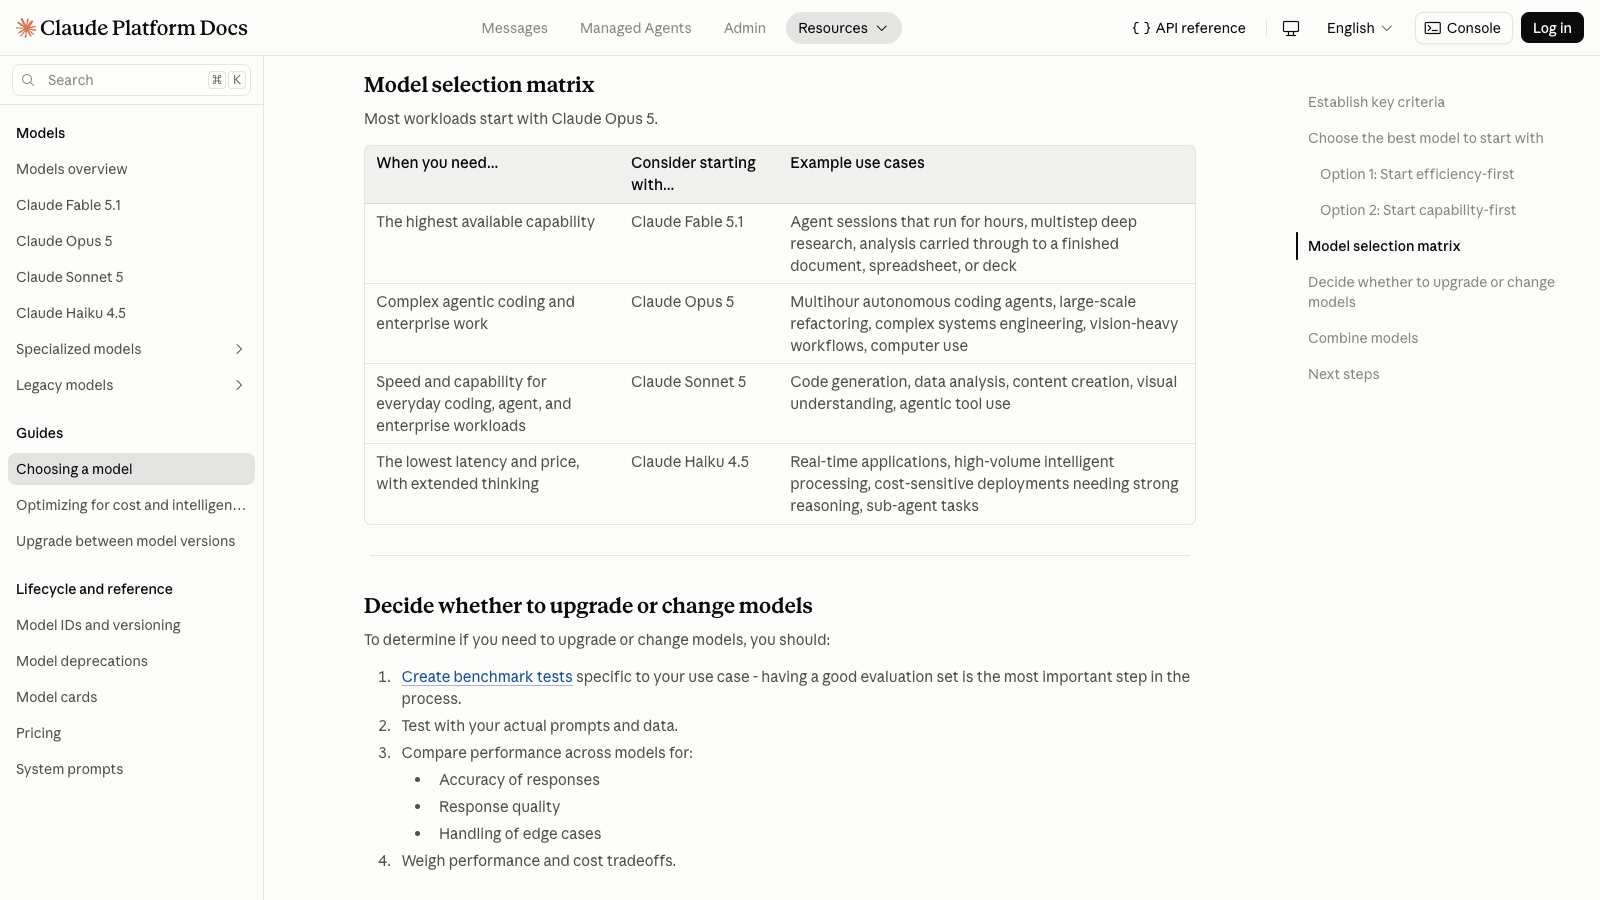
La matrice di Anthropic mette in relazione i quattro attuali modelli Claude con diverse esigenze in termini di capacità, velocità e carico di lavoro.
Esempio di costo fisso dell'API Claude
Per un carico di lavoro complessivo fisso di 1 milione di token in ingresso più 100.000 token in uscita distribuiti su più richieste API standard, il costo base dei token varia da $1,50 con Haiku 4.5 a $15,00 con Fable 5.1. Non si tratta di una singola richiesta e ciò non supera i limiti di output per singola richiesta.
Un carico di lavoro, quattro modelli Claude
Lo stesso volume di token costa 2, 5 o 10 volte il totale di Haiku man mano che si sale di livello.
Carico di lavoro 1,0 M in ingresso + 0,1 M in uscita su più richieste
Haiku 4.5
$1.50
Sonetto 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Modello
Calcolo dei dati di input
Calcolo della produzione
Totale
Haiku 4.5
1,0 x $1
0,1 x $5
$1.50
Sonetto 5
1,0 x $2
0,1 × $10
$3.00
Opus 5
1,0 × $5
0,1 x $25
$7.50
Fable 5.1
1,0 x $10
0,1 × $50
$15.00
Inclusi: Tassi standard di ingresso e uscita dei token ricavati da un'istantanea dei prezzi Anthropic.
Sono esclusi: Caching dei prompt, API batch, modalità veloce, dati geografici, commissioni per gli strumenti, tasse, sconti e crediti GlobalGPT.
La tabella dei prezzi indica il costo dei token, non il costo di un risultato finale. Un modello più economico può rivelarsi più costoso se i tentativi ripetuti, le correzioni e la verifica richiedono un impiego di tempo da parte del personale superiore al risparmio ottenuto sui token.
Test pratico sul modello Claude: stessi prompt, diverse modalità di errore
Il 9 settembre 2026 abbiamo inviato gli stessi tre prompt tramite l’API Anywhere ai modelli Claude Haiku 4.5, Sonnet 5, Opus 5 e Fable 5.1. I compiti riguardavano il triage strutturato dell’assistenza, la scrittura basata su prove e il debug di codice JavaScript verificabile. Abbiamo conservato il primo output valido di ciascun modello e lo abbiamo valutato in base a regole stabilite prima della revisione delle risposte.
Il risultato non è stato una semplice classifica. Sonnet, Opus e Fable hanno totalizzato ciascuno 26,5 punti su 30, mentre i loro punti di forza e le loro carenze presentavano notevoli differenze. Haiku ha restituito un errore HTTP 503 in entrambi i tentativi consentiti per ogni attività, pertanto la qualità dei suoi risultati rimane sconosciuta in questo test.
Configurazione del test e risultato complessivo
Tre prompt fissi, gli stessi limiti di token a livello di compito, nessun strumento né ricerca, e per ciascun modello viene conservato il primo output valido.
SedeAPI Anywhere
Data9 settembre 2026
CompitiTriage strutturato, nota di avvio, debug di JavaScript
Regola di riprovaErrore di trasporto, 429/5xx, contenuto vuoto o risposta non valida
Modello
Attività completate
Punteggio di qualità complessivo
Il segnale più utile
Claude Haiku 4.5
0/3
Non valutato
Tutte e sei le richieste autorizzate hanno restituito un codice di errore 503; disponibilità del percorso soltanto.
Claude Sonetto 5
3/3
26.5/30
L'unico modello in grado di soddisfare tutti i requisiti indicati nelle note di lancio.
Claude Opus 5
3/3
26.5/30
Elevata profondità di debug; è sfuggito un vincolo relativo alla lunghezza di scrittura.
Claude Fable 5.1
3/3
26.5/30
Risultati chiari e strutturati; la nota di avvio è stata troncata dopo una risposta vuota.
Output strutturato
Test 1: Smistamento dei ticket di assistenza
Risultato dell'attività: Fable 5.1, 10/10
Fable è stato l’unico modello a restituire un JSON direttamente analizzabile con tutte e sei le etichette e le azioni corrette. Opus e Sonnet hanno riportato correttamente le etichette, ma hanno aggiunto i tag Markdown; entrambi hanno inoltre rafforzato una scadenza indicata, e Sonnet ha promesso prematuramente una correzione o un rimborso.
Modello
Stato
Punteggio
Latenza ovunque
Token segnalati
Cosa è successo
Claude Haiku 4.5
Percorso non disponibile
Non valutato
Non disponibile
Non disponibile
Due risposte 503; nessun punteggio di qualità.
Claude Sonetto 5
Dati di output conservati
7.5/10
10,39 s
1005
Etichette corrette, ma JSON racchiuso tra virgolette e un esito di rimborso/correzione inventato.
Claude Opus 5
Dati di output conservati
8.5/10
11,87 s
1051
Etichette corrette e misure incisive, ma JSON "recintato" e una scadenza più rigida.
Claude Fable 5.1
Dati di output conservati
10/10
8,55 s
680
JSON analizzabile direttamente; tutti i controlli "frozen" superati.
Dati di test completi
Gestisci una casella di posta dedicata all’assistenza SaaS. Classifica ogni ticket riportato di seguito. Restituisci un oggetto JSON contenente un solo campo di primo livello denominato "tickets". Il campo "tickets" deve essere un array nell'ordine originale e ogni elemento deve contenere esattamente i campi ticket_id, category, urgency e action. Il campo category deve assumere uno dei seguenti valori: billing, access, bug, feature. Il campo urgency deve assumere uno dei seguenti valori: low, medium, high. Utilizza solo il testo del ticket; non inventare esiti relativi alle politiche aziendali né fatti riguardanti i clienti.

#481: Ci è stato addebitato due volte lo stesso rinnovo annuale. La chiusura dei libri contabili è prevista per venerdì e ho bisogno che la questione venga verificata prima di allora.
#482: La procedura di reimpostazione della password indica che l’e-mail è stata inviata, ma non è arrivata nulla. Ho controllato la cartella dello spam e ho riprovato una volta.
#483: Le esportazioni in formato CSV arrotondano ogni importo in valuta a dollari interi, mentre la dashboard mostra ancora i centesimi.
#484: Si prega di aggiungere una modalità scura alla dashboard di analisi.
#485: Dopo che questa mattina è cambiato il dominio della nostra azienda, tutti i dipendenti ricevono un messaggio di accesso SSO negato.
#486: Potreste inviarmi una copia della fattura del mese scorso?
Claude Haiku 4.5: risultato operativo complessivo
Non è stato generato alcun risultato dal modello. Entrambi i tentativi autorizzati tramite l'API Anywhere hanno restituito un codice di stato HTTP 503, pertanto questa rotta è stata contrassegnata come non disponibile ed esclusa dalla valutazione della qualità.
Claude Sonnet 5: uscita completa
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "fatturazione",
 "urgency": "alta",
 "action": "Verificare l'addebito duplicato relativo al rinnovo annuale ed emettere una rettifica/un rimborso prima della chiusura del libro paga del cliente venerdì."
    },
    {
 "ticket_id": "#482",
      "categoria": "accesso",
 "urgenza": "media",
 "azione": "Verificare l'indirizzo e-mail dell'account e la recapitabilità della posta, quindi attivare manualmente o inviare nuovamente l'e-mail di reimpostazione della password."
    },
    {
 "ticket_id": "#483",
      "categoria": "bug",
 "urgenza": "media",
 "azione": "Inoltrare al reparto tecnico per correggere l’arrotondamento nell’esportazione CSV, in modo che i valori valutari corrispondano alla precisione al centesimo mostrata sulla dashboard."
    },
    {
 "ticket_id": "#484",
 "categoria": "funzionalità",
 "urgenza": "bassa",
 "azione": "Registrare la richiesta relativa alla modalità scura per la dashboard di analisi e aggiungerla al backlog delle funzionalità del prodotto."
    },
    {
 "ticket_id": "#485",
      "categoria": "accesso",
 "urgenza": "alta",
 "azione": "Indagare immediatamente sulla configurazione SSO legata al dominio aziendale modificato e ripristinare l’accesso per tutti i dipendenti interessati."
    },
    {
      "ticket_id": "#486",
 "category": "fatturazione",
 "urgency": "bassa",
 "action": "Individuare la fattura del mese scorso e inviarne una copia al cliente."
    }
  ]
}
```
Claude Opus 5: potenza massima
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "fatturazione",
 "urgency": "alta",
 "action": "Inoltrare al reparto fatturazione per verificare l'addebito duplicato relativo al rinnovo annuale e confermare la risoluzione prima della chiusura del ciclo paghe del cliente prevista per venerdì."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "Controllare i registri di consegna delle e-mail per il messaggio di reimpostazione inviato a quell'indirizzo e, se non consegnato, avviare una procedura di reimpostazione verificata per l'utente."
    },
    {
 "ticket_id": "483",
      "categoria": "bug",
 "urgenza": "media",
 "azione": "Segnalare un bug relativo all’arrotondamento della valuta nell’esportazione CSV, indicando la discrepanza con i valori della dashboard, e richiedere i passaggi per riprodurre il problema o un esempio di esportazione."
    },
    {
 "ticket_id": "484",
 "categoria": "funzionalità",
 "urgenza": "bassa",
 "azione": "Registrare come richiesta di funzionalità per la modalità scura della dashboard di analisi e confermare la ricezione senza impegnarsi su una tempistica."
    },
    {
 "ticket_id": "485",
      "categoria": "accesso",
 "urgenza": "alta",
 "azione": "Inoltrare come interruzione del SSO a livello di organizzazione legata alla modifica del dominio; far verificare immediatamente dalla squadra Identità/Autenticazione la configurazione del dominio SSO."
    },
    {
      "ticket_id": "486",
 "categoria": "fatturazione",
 "urgenza": "bassa",
 "azione": "Inviare la copia della fattura del mese precedente richiesta al referente verificato dell’account."
    }
  ]
}
```
Claude Fable 5.1: potenza massima
{"tickets":[{"ticket_id":"481","category":"fatturazione","urgency":"alta","action":"Verificare il addebito per il rinnovo annuale segnalato come duplicato e rispondere prima della scadenza prevista per il pagamento dello stipendio del cliente, fissata per venerdì."},{"ticket_id":"482","categoria":"accesso","urgenza":"media","azione":"Controllare i registri di consegna delle e-mail di reimpostazione della password per l'indirizzo dell'utente e inviare nuovamente l'e-mail o fornire un percorso alternativo per la reimpostazione."},{"ticket_id":"483","categoria":"bug","urgenza":"media","azione":"Riprodurre l'arrotondamento degli importi in valuta a dollari interi durante l'esportazione in CSV e segnalare il problema al team di ingegneria per una correzione."},{"id_ticket":"484","categoria":"funzionalità",""urgenza":"bassa","azione":"Registrare la richiesta relativa alla modalità scura per la dashboard di analisi presso il team di prodotto e confermarne la ricezione."},{"id_ticket":"485","categoria":"accesso","urgency":"high","action":"Segnalare gli errori di accesso SSO negato a livello aziendale a seguito del cambio di dominio e verificare la configurazione del dominio SSO."},{"ticket_id":"486","category":"billing","urgency":"low","action":"Individuare e inviare al cliente una copia della fattura del mese scorso."}]}
Politica "First-valid-output". La latenza è espressa in tempo reale (wall-clock) attraverso Anywhere, non nella latenza nativa Anthropic. Il conteggio dei token è riportato dal provider; da questa rotta non è possibile dedurre alcun costo diretto dell'API.
Rispetto dei vincoli
Test 2: Nota di lancio basata sui dati
Risultato dell'attività: Sonnet 5, 10/10
Sonnet è stato l'unico modello a soddisfare tutti i requisiti fissati. Opus ha generato una nota convincente, ma ha superato il limite di caratteri e ha dedotto che tutti coloro che non avevano risposto fossero studenti iscritti. La prima risposta di Fable era vuota; il suo tentativo di riprova consentito ha restituito una nota visibilmente troncata, priva della raccomandazione o dell'avvertenza.
Modello
Stato
Punteggio
Latenza ovunque
Token segnalati
Cosa è successo
Claude Haiku 4.5
Percorso non disponibile
Non valutato
Non disponibile
Non disponibile
Due risposte 503; nessun punteggio di qualità.
Claude Sonetto 5
Dati di output conservati
10/10
9,94 s
796
Ha soddisfatto i requisiti relativi ai termini “ambito”, “struttura”, “prove”, “raccomandazioni” e “avvertenze”.
Claude Opus 5
Dati di output conservati
8/10
9,49 s
826
Analisi convincente, ma 223 parole in meno rispetto al metodo del conteggio "fisso" e una deduzione non suffragata da prove.
Claude Fable 5.1
Dati di output conservati
6.5/10
19,27 s
1685
La prima risposta era vuota; il tentativo di recupero è stato troncato prima della raccomandazione e dell'avvertenza.
Dati di test completi
Scrivi una nota interna di lancio di 180-220 parole destinata a un direttore di prodotto, utilizzando esclusivamente i dati riportati di seguito. Includi: un oggetto, un breve paragrafo introduttivo, esattamente tre punti elenco, una raccomandazione e un’avvertenza chiaramente indicata. Non inventare dati relativi al bilancio, percentuali, significatività statistica o effetti causali.

Dati:
- Il progetto pilota ha coinvolto 120 studenti.
- Al checkpoint del 31 marzo, 96 studenti avevano frequentato almeno tre sessioni.
- Il punteggio medio del sondaggio è stato di 4,3 su 5 su un totale di 71 intervistati.
- Il foglio operativo del programma riporta un budget di $18.000.
- La nota di approvazione finanziaria riporta $20.000. Non è specificato se la differenza sia dovuta a una revisione o a un errore di registrazione.
- I partecipanti non sono stati assegnati in modo casuale e non è stato raccolto alcun punteggio di riferimento.
- La decisione riguarda l’opportunità di avviare un secondo progetto pilota, non quella di implementarlo in modo permanente.
Claude Haiku 4.5: risultato operativo complessivo
Non è stato generato alcun risultato dal modello. Entrambi i tentativi autorizzati tramite l'API Anywhere hanno restituito un codice di stato HTTP 503, pertanto questa rotta è stata contrassegnata come non disponibile ed esclusa dalla valutazione della qualità.
Claude Sonnet 5: uscita completa
**Oggetto: Risultati del programma pilota — Raccomandazione di procedere con un secondo programma pilota**

Il programma pilota iniziale ha concluso il suo primo periodo di verifica e i primi indicatori di coinvolgimento e soddisfazione sono incoraggianti. Prima di impegnarsi in un secondo programma pilota, vi sono alcuni dati e questioni in sospeso che il team dovrebbe esaminare insieme.

- Dei 120 studenti iscritti, 96 avevano partecipato ad almeno tre sessioni alla data di verifica del 31 marzo.
- Un sondaggio post-sessione compilato da 71 partecipanti ha prodotto un punteggio medio di 4,3 su 5.
- I dati di bilancio non sono coerenti tra i vari documenti: il foglio operativo del programma riporta $18.000, mentre la nota di approvazione finanziaria riporta $20.000; non è chiaro se ciò rifletta una revisione o un errore di registrazione.

**Raccomandazione:** alla luce dei risultati relativi alla partecipazione e al sondaggio, raccomandiamo di procedere con una seconda fase pilota per raccogliere dati più strutturati — idealmente con un gruppo di confronto definito e una misurazione di riferimento — prima di prendere in considerazione qualsiasi decisione relativa a un’implementazione più ampia. Questa seconda fase pilota dovrebbe inoltre rappresentare un’opportunità per appianare la discrepanza di bilancio con l’ufficio finanziario prima che i fondi vengano definiti definitivamente.

**Avvertenza:** Questi risultati devono essere interpretati con cautela. I partecipanti non sono stati assegnati in modo casuale e non è stato raccolto alcun punteggio di riferimento, pertanto non è possibile attribuire i risultati del sondaggio o i modelli di partecipazione al programma stesso. Si tratta di una decisione preliminare per un secondo progetto pilota, non di una decisione sull’implementazione definitiva.
Claude Opus 5: potenza massima
**Oggetto: Risultati del progetto pilota e raccomandazioni su una seconda coorte pilota**

Il primo progetto pilota ha completato la fase di verifica prevista per il 31 marzo e ora disponiamo di informazioni sufficienti per decidere se avviare un secondo progetto pilota. La presente nota riassume quanto osservato, le nostre raccomandazioni e i principali limiti interpretativi. In questa fase non è stata presa alcuna decisione definitiva in merito all’implementazione su larga scala.

- **Iscrizioni e partecipazione:** si sono iscritti 120 studenti. Al momento della verifica del 31 marzo, 96 di loro avevano partecipato ad almeno tre sessioni.
- **Feedback dei partecipanti:** il sondaggio post-partecipazione ha registrato una media di 4,3 su 5, sulla base di 71 rispondenti. Gli altri studenti iscritti non hanno risposto, pertanto il punteggio riflette solo quel sottogruppo.
- **Discrepanza di bilancio:** il foglio operativo del programma riporta un bilancio di $18.000, mentre la nota di approvazione finanziaria indica $20.000. La nota finanziaria non specifica se la differenza sia dovuta a una revisione o a un errore di registrazione, e non abbiamo ancora stabilito quale cifra sia quella valida.

**Raccomandazione:** Procedere con la pianificazione di un secondo progetto pilota, a condizione che i reparti Finanze e Gestione del programma riconciliino le due cifre di bilancio e confermino un unico importo di riferimento prima di impegnare la spesa. Un secondo progetto pilota dovrebbe inoltre raccogliere i punteggi di riferimento al momento dell’ammissione.

**AVVERTENZA:** I partecipanti non sono stati assegnati in modo casuale e non è stato raccolto alcun punteggio di riferimento. I dati relativi al coinvolgimento e al sondaggio descrivono quindi ciò che questo gruppo ha fatto e riportato; non possono dirci quali siano stati gli effetti del programma né come funzionerebbe con una popolazione diversa.
Claude Fable 5.1: potenza massima
**Oggetto:** Riepilogo del punto di controllo del progetto pilota e raccomandazione sulla seconda fase pilota

Salve [Direttore],

di seguito è riportato un riepilogo dello stato di avanzamento del progetto pilota al punto di controllo del 31 marzo, insieme a una raccomandazione sull’opportunità di procedere con una seconda fase pilota. La presente nota riguarda esclusivamente la decisione relativa alla seconda fase pilota, non l’implementazione definitiva.

- **Iscrizioni e frequenze:** 120 studenti iscritti. Al checkpoint del 31 marzo, 96 avevano frequentato almeno tre sessioni.
- **Feedback dei partecipanti:** un sondaggio ha registrato un punteggio medio di 4,3 su 5 da parte di 71 intervistati.
- **Documentazione di bilancio:** il foglio operativo del programma riporta un bilancio di $18.000, mentre la nota di approvazione finanziaria indica $20.000. La nota finanziaria non specifica se la differenza sia dovuta a una revisione o a un errore di registrazione.

**
Politica "First-valid-output". La latenza è espressa in tempo reale (wall-clock) attraverso Anywhere, non nella latenza nativa Anthropic. Il conteggio dei token è riportato dal provider; da questa rotta non è possibile dedurre alcun costo diretto dell'API.
Correttezza del codice
Test 3: Debug di JavaScript verificabile
Risultato dell'attività: Opus 5 e Fable 5.1 a pari merito, 10/10
Tutti e tre i modelli disponibili hanno individuato dei difetti e generato sostituzioni che hanno superato otto casi di test. Opus e Fable hanno restituito un JSON valido, ottenendo entrambi un punteggio di 10/10. Anche il codice di Sonnet ha superato il test, ma il tag Markdown circostante ha violato il requisito del JSON diretto.
Modello
Stato
Punteggio
Latenza ovunque
Token segnalati
Cosa è successo
Claude Haiku 4.5
Percorso non disponibile
Non valutato
Non disponibile
Non disponibile
Due risposte 503; nessun punteggio di qualità.
Claude Sonetto 5
Dati di output conservati
9/10
13,17 s
1471
La versione sostitutiva ha superato 8 casi su 8; l'output recintato ha perso il punto relativo al formato JSON.
Claude Opus 5
Dati di output conservati
10/10
20,17 s
1826
JSON valido, entrambi i difetti individuati e 8 casi eseguibili su 8 superati.
Claude Fable 5.1
Dati di output conservati
10/10
15,89 s
1409
JSON valido, diagnosi concisa e 8 casi eseguibili su 8 superati.
Dati di test completi
Diagnostica e correggi questa funzione JavaScript. Restituisci un oggetto JSON contenente esattamente quattro campi: root_cause (stringa), replacement (stringa contenente la funzione di sostituzione completa), tests (array di stringhe che rappresentano i casi di test) e remaining_risk (stringa). Non dichiarare di aver eseguito i test. Effettua la correzione più piccola e chiara che soddisfi il contratto.

Contratto:
- tasks è un array di funzioni senza argomenti che restituiscono promesse.
- Restituisci il primo valore soddisfatto nell’ordine di input, anche se tale valore è 0, false o una stringa vuota.
- Ignora i task rifiutati.
- Restituisci null quando tutti i task vengono rifiutati o l’array è vuoto.

Codice attuale:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: risultato operativo complessivo
Non è stato generato alcun risultato dal modello. Entrambi i tentativi autorizzati tramite l'API Anywhere hanno restituito un codice di stato HTTP 503, pertanto questa rotta è stata contrassegnata come non disponibile ed esclusa dalla valutazione della qualità.
Claude Sonnet 5: uscita completa
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: potenza massima
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: potenza massima
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Politica "First-valid-output". La latenza è espressa in tempo reale (wall-clock) attraverso Anywhere, non nella latenza nativa Anthropic. Il conteggio dei token è riportato dal provider; da questa rotta non è possibile dedurre alcun costo diretto dell'API.
Questi risultati di Anywhere dimostrano perché la scelta del modello dovrebbe basarsi sul compito da svolgere piuttosto che su una singola classifica. In GlobalGPT, è possibile applicare lo stesso metodo di confronto al proprio prompt su Claude e altri modelli di punta, per poi scegliere l'output che meglio si adatta ai propri standard di qualità, alle esigenze di velocità e al carico di lavoro di revisione.
Come effettuare un confronto equo
Blocca un'attività rappresentativa. Utilizzare gli stessi controlli relativi all’intento, al materiale di partenza, all’accesso agli strumenti e all’accettazione degli obiettivi.
Registra il primo risultato valido. Non concedere silenziosamente a un modello un numero maggiore di tentativi nel confronto principale.
Distinguere la qualità dalla disponibilità. I problemi relativi all'autenticazione, alla capacità e ai percorsi devono essere riportati in una nota sulla disponibilità, non nel punteggio di qualità.
Misura l'intero flusso di lavoro. Calcolare il tempo trascorso, l'impegno del revisore, il tempo necessario per le correzioni e il tempo impiegato per il recupero in caso di attività non riuscita.
Scegli il modello di passaggio meno costoso. Ripetere il test quando cambiano le indicazioni, gli strumenti, le versioni dei modelli o i costi di un eventuale fallimento.
Il ruolo di GlobalGPT
Il modello Anthropic si posiziona come alternativa al Fable 5.1 per i lavori più impegnativi, quando anche le valutazioni Opus 5, più complesse, risultano ancora insufficienti.
Quali sono i modelli Claude attualmente disponibili?
All’8 settembre 2026, la gamma attiva di Anthropic comprende i modelli Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 e Claude Fable 5.1. Le versioni esatte e gli ID dei modelli possono subire variazioni, pertanto si raccomanda di ricontrollare la panoramica ufficiale dei modelli prima della distribuzione.
Qual è la differenza tra Claude Haiku, Sonnet e Opus?
Haiku privilegia la velocità e un basso costo base in token, Sonnet bilancia velocità e prestazioni per il lavoro quotidiano, mentre Opus privilegia le prestazioni per attività complesse o di grande importanza. La scelta giusta dipende dal carico di lavoro e dai costi di verifica, non da una classifica assoluta.
Quale modello Claude dovrei utilizzare per la maggior parte delle attività?
Inizia con Sonnet 5 per la maggior parte delle attività quotidiane di scrittura, analisi, programmazione, comprensione visiva e utilizzo di strumenti. Passa invece a Opus 5 quando gli errori comportano costi elevati o quando il lavoro richiede un ragionamento più approfondito e una verifica più rigorosa.
Qual è il modello Claude più adatto alla programmazione?
Sonnet 5 rappresenta un pratico punto di partenza per la programmazione quotidiana, con le consuete revisioni e test. Utilizza Opus 5 per diagnosi difficili, codifiche agentiche complesse, esecuzioni a lungo termine o modifiche il cui errore comporta costi elevati.
Qual è il modello Claude più adatto alla scrittura?
Sonnet 5 rappresenta il punto di partenza equilibrato per la maggior parte delle attività di stesura e revisione. Haiku 4.5 è adatto a testi voluminosi e dalla struttura rigida, mentre Opus 5 può valere la pena di essere provato per sintesi complesse o materiale di grande importanza che risulta difficile da verificare.
Claude Sonnet è migliore di Opus?
Non in tutti i casi. Il modello Sonnet 5 è più veloce e più economico alle tariffe API di base, mentre il modello Anthropic consente a Opus 5 di gestire attività più complesse. Il modello migliore è l’opzione meno costosa che superi in modo affidabile i vostri criteri di accettazione.
Claude Fable sta sostituendo Opus?
Il n. Anthropic definisce la posizione Fable 5.1 come un livello superiore a cui ricorrere in caso di ragionamenti complessi o attività degli agenti di lunga durata, quando Opus 5, che richiede uno sforzo maggiore, non è ancora sufficiente, e non come sostituto universale di Opus.
Claude.ai e l’API Claude hanno la stessa finestra di contesto?
I limiti del piano n. Claude.ai e le specifiche del modello API sono distinti. La tabella dei piani individuali di Anthropic indica attualmente una finestra di contesto di 200K, mentre la documentazione API riporta una finestra di contesto di 1M per Sonnet 5, Opus 5 e Fable 5.1.
Quando dovrei passare da Haiku a Sonnet o Opus?
Effettuare l'aggiornamento quando i controlli di accettazione falliti, i casi limite complessi, i tempi di correzione, lo sforzo di verifica o il costo di un errore superano i vantaggi offerti dal modello inferiore in termini di velocità e prezzo dei token. Tornare al modello precedente quando un modello più economico supera ripetutamente gli stessi controlli "congelati".
Quanto costano Claude Haiku, Sonnet e Opus tramite l’API?
In base alle tariffe base di Anthropic verificate l’8 settembre 2026, Haiku 4.5 costa $1 in ingresso e $5 in uscita, Sonnet 5 costa $2 e $10, mentre Opus 5 costa $5 e $25 per milione di token. Vedi Anthropic’s pagina ufficiale dei prezzi per conoscere le tariffe attuali e le modalità di pagamento disponibili.
Verdetto finale: inizia con il modello più economico che soddisfi i requisiti
Per un utilizzo misto generico, il Sonnet 5 rimane l’opzione predefinita più pratica ed è stato l’unico modello a superare tutti i vincoli relativi alle note di lancio nel nostro test. Opus 5 e Fable 5.1 hanno eguagliato il punteggio totale di Sonnet (26,5/30) grazie a punti di forza diversi, mentre Haiku 4.5 non ha potuto essere valutato perché il percorso Anywhere restituiva un errore 503 a ogni tentativo consentito. Considerate questi risultati come un'indicazione relativa al carico di lavoro, non come una classifica universale definitiva.
Il prossimo passo è semplice: individuate un compito concreto, definite quali siano i criteri di superamento del test, valutate ogni candidato serio in condizioni comparabili e includete il tempo necessario per la correzione nel costo finale. Il modello vincente è quello meno costoso che superi il test in modo affidabile, non quello con il costo unitario più basso o il nome più altisonante.
GlobalGPT integra tale metodo in un flusso di lavoro di intelligenza artificiale più ampio e conveniente. Utilizza Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 e altri modelli leader con molteplici funzioni di IA in un'unica dashboard, quindi trasferisci il lavoro sul tuo terminale, nel flusso di lavoro di sviluppo e negli strumenti di produzione esistenti tramite la CLI di GlobalGPT. I test comparativi ti aiutano a scegliere; il vantaggio maggiore è mantenere interconnesso l’intero flusso di lavoro.
Scopri le funzionalità ufficiali di Eleven v4 Turbo, i prezzi delle API e le istruzioni di configurazione, con sei campioni audio reali, i risultati dei test di tempo e un calcolatore del costo per carattere.
Localizza gli annunci video andando oltre la semplice traduzione: adatta copioni, voci, sottotitoli, offerte e formati, con tre versioni concettuali e un flusso di lavoro pratico GlobalGPT.
Crea un flusso di lavoro basato sull'intelligenza artificiale per la gestione di cataloghi e video, con manifesti SKU, riferimenti ai prodotti, controlli di generazione e trasferimento a Shopify, oltre a un vero e proprio progetto pilota su due prodotti.
Confronta gli avatar generati dall’intelligenza artificiale e i creatori di contenuti generati dagli utenti (UGC) in base alla prova di prodotto, ai costi di produzione, ai diritti e alle revisioni, con un approccio sintetico e un flusso di lavoro pratico GlobalGPT.