DeepSeek V4.1 Flash adalah rilis DeepSeek pada tanggal 10 September 2026, yang menghadirkan fitur input gambar bawaan, ukuran cache yang lebih kecil, skor agen yang dilaporkan oleh vendor lebih tinggi, serta tarif API yang lebih rendah. Solusi ini paling cocok untuk pengembang yang menjalankan agen dengan volume tinggi atau yang membutuhkan banyak masukan. Catatan penting: DeepSeek telah menjalankan serangkaian uji kinerja yang dipublikasikan, dan V4 Pro masih memimpin dalam beberapa tes penalaran terdepan yang dipilih.

Apa Itu Flash DeepSeek V4.1?
DeepSeek V4.1 Flash adalah model multimodal dengan bobot terbuka yang dirancang untuk pemrograman, penggunaan alat, pemahaman visual, dan alur kerja agen dalam konteks panjang. DeepSeek merilisnya pada 10 September 2026, dan mempublikasikan bobot-bobotnya sebagai DeepSeek-V4.1-Flash, dan menampilkan model yang dihosting melalui deepseek-flash Nama API.
Rilis ini penting karena tidak hanya mengubah skor benchmark. Flash kini dapat memproses teks dan gambar, menawarkan jendela konteks sebesar satu juta token, serta secara signifikan mengurangi penggunaan memori yang dibutuhkan untuk cache kunci-nilai-nya. DeepSeek juga memangkas tarif API yang dihostingnya dibandingkan dengan tarif V4 Pro yang akan dihentikan. Kombinasi tersebut bertujuan mengatasi kendala praktis: menjaga agar agen yang berjalan dalam waktu lama tetap terjangkau saat prompt, konteks repositori, tangkapan layar, dan riwayat alat menumpuk.
deepseek-flashMode pemikiran diaktifkan secara default, meskipun mode non-pemikiran juga tersedia. Keluaran JSON dan Panggilan Alat didukung. DeepSeek juga menyediakan kompatibilitas dengan API Respons dan API Anthropic, yang mengurangi beban migrasi bagi aplikasi yang sudah dirancang berdasarkan antarmuka-antarmuka tersebut.
Apa Saja yang Baru di DeepSeek V4.1 Flash?
Backbone 552B MoE dengan komputasi asimetris
Menurut Laporan Teknis DeepSeek V4.1, model ini menggunakan arsitektur dasar “mixture-of-experts” dengan 552 miliar parameter, yang terdiri dari encoder kausal berlapis 20 dan decoder berlapis 20. Jumlah parameter keseluruhan bukanlah jumlah yang digunakan untuk setiap token: DeepSeek melaporkan sekitar 8 miliar parameter aktif selama tahap prefill dan 16 miliar selama tahap decoding.
Desain asimetris tersebut memberikan alokasi daya komputasi yang berbeda untuk tahap prefill dan tahap generasi. Prefill adalah tahap yang memproses prompt, dokumen, gambar, dan percakapan sebelumnya; sedangkan tahap decoding menghasilkan jawaban token demi token. Penggunaan daya komputasi aktif yang lebih rendah selama tahap prefill sangat relevan bagi beban kerja berskala repositori dan agen penelitian yang menghabiskan banyak waktu untuk membaca sebelum menulis.
Cache KV yang jauh lebih kecil
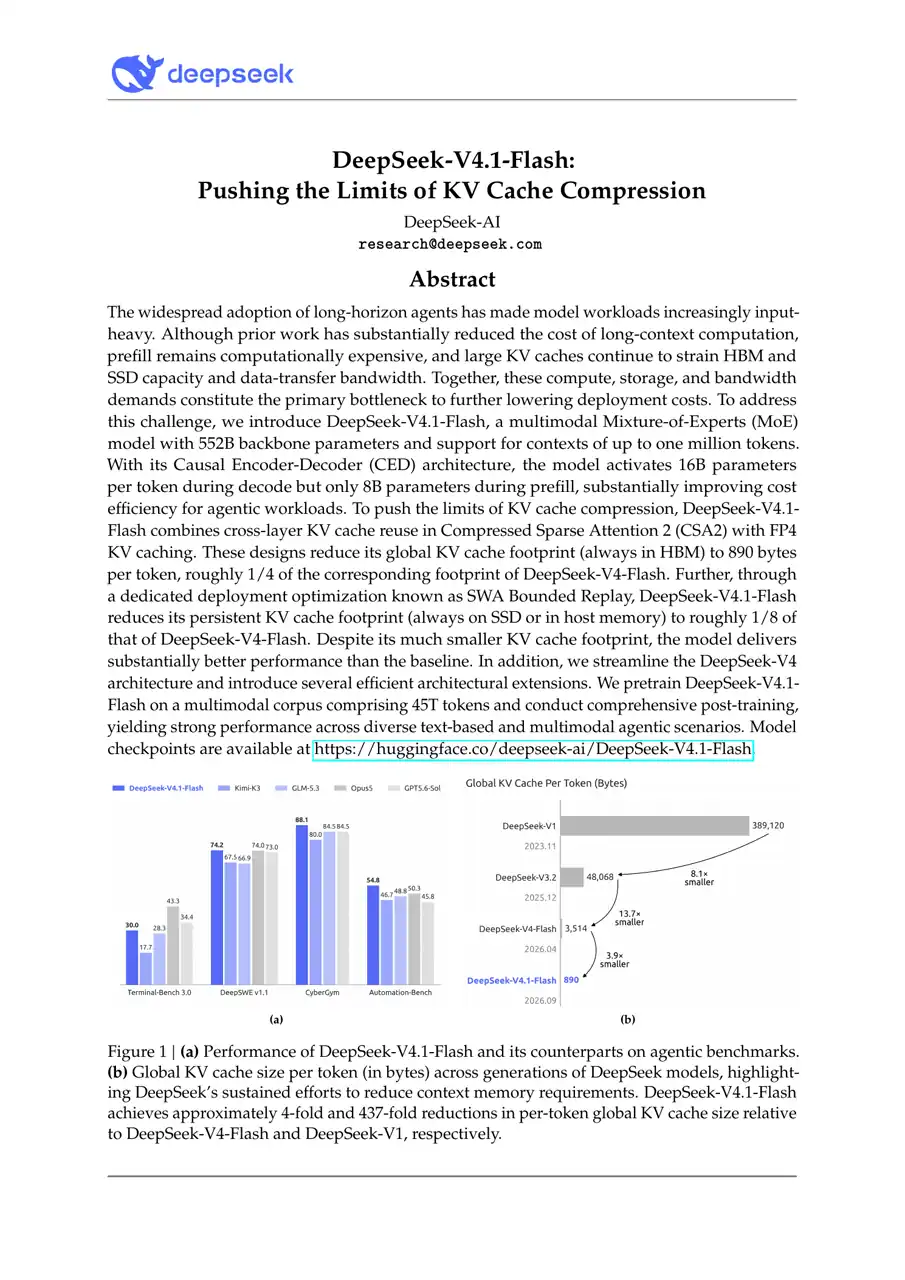
Laporan tersebut mencantumkan ukuran cache KV global sebesar 890 byte per token, sekitar seperempat dari cache V4 Flash dalam memori bandwidth tinggi. DeepSeek menyatakan bahwa kebutuhan cache persistennya sekitar seperdelapan dari generasi sebelumnya. Untuk konteks satu juta token, hal ini merupakan fitur penerapan, bukan sekadar detail arsitektur abstrak: ukuran cache memengaruhi berapa banyak sesi panjang yang dapat ditangani oleh sebuah server dan berapa banyak memori yang dikonsumsi oleh masing-masing sesi.
Masukan gambar asli dan prapelatihan multimodal
V4.1 Flash dapat memproses gambar secara langsung tanpa perlu menggunakan titik akhir (endpoint) terpisah dari Vision. DeepSeek menyebutkan bahwa model tersebut telah dilatih sebelumnya menggunakan korpus multimodal sebesar 45 triliun token. Dalam praktiknya, hal ini menjadikan tangkapan layar, bagan, tabel yang dipindai, status antarmuka, dan masukan debugging visual sebagai bagian dari percakapan agen yang sama dengan kode dan teks.
Konteks sebesar 1 juta token dapat menampung repositori besar, kumpulan dokumen yang panjang, dan riwayat agen yang luas, dengan tetap tunduk pada batas gabungan input-output.
Masukan dalam format JPEG, PNG, GIF, dan WebP dapat digabungkan dengan teks untuk ekstraksi tabel, analisis tangkapan layar, dan penjawaban pertanyaan berbasis visual.
Pemanggilan alat, keluaran JSON terstruktur, dan pelatihan berorientasi agen menjadikan model ini cocok untuk alur kerja yang harus memeriksa, mengambil keputusan, dan mengubah status.
Uji Kinerja DeepSeek V4.1: Apa yang Ditunjukkan oleh Hasil Resmi
Keunggulan utama V4.1 Flash dari DeepSeek terlihat terutama pada uji kinerja pemrograman dan agen. Pihak vendor mengevaluasi model instruksi tersebut dengan tingkat upaya eksperimental sebesar 100, yang dipublikasikan sebagai tingkat upaya penalaran maksimum, dengan menggunakan suhu=1,0 dan top_p=0,95. Uji coba agen kode menggunakan rangkaian uji yang diberi nama dan konteks sebesar satu juta token; uji coba agen visual menggunakan Claude Code dengan konteks sebesar 512 ribu token.
| Patokan | V4.1 Flash | V4 Pro | V4 Flash | Pemimpin |
|---|---|---|---|---|
| Codeforces peringkat | 3471 | 3348 | 3289 | V4.1 Flash |
| Terminal-Bangku 2.1 Lulus@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 telah diselesaikan | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Lulus@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Meja Otomatisasi Lulus@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| Berlian GPQA Lulus@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE teks saja Lulus@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Sumber: Laporan teknis DeepSeek V4.1, Tabel 3. Semakin tinggi nilainya, semakin baik dalam setiap baris. Codeforces merupakan nilai peringkat; nilai-nilai lain yang ditampilkan menggunakan metrik berbasis persentase yang disebutkan dalam laporan tersebut. Jangan membandingkan besaran nilai antar baris.

Pola ini memang berguna, namun cakupannya lebih sempit daripada klaim umum bahwa V4.1 Flash adalah “model yang lebih baik” secara menyeluruh. V4.1 Flash unggul dibandingkan V4 Pro pada lima kategori pemrograman, terminal, keamanan, dan otomatisasi yang ditampilkan di atas. V4 Pro tetap unggul pada GPQA Diamond dan subset teks saja dari Humanity’s Last Exam. Pengembang yang membandingkan daftar pendek pemrograman yang lebih luas dapat menggunakan Panduan Memilih Model AI Terbaik untuk Pemrograman, namun evaluasi pada tingkat aplikasi tetap lebih penting daripada satu tabel.
Upaya penalaran juga memengaruhi biaya dan hasil. Dalam laporan DeepSeek, peningkatan upaya eksperimental dari 25 menjadi 100 menyebabkan nilai DeepSWE v1.1 naik dari 66,0 menjadi 74,2 dan Terminal-Bench 2.1 dari 82,4 menjadi 90,6, sambil mengonsumsi sekitar 2,5 kali lebih banyak token keluaran. Delapan konfigurasi agen dalam laporan tersebut juga menghasilkan hasil yang secara signifikan berbeda dari titik pemeriksaan yang sama, sehingga pilihan kerangka kerja merupakan bagian dari sistem yang diukur.
DeepSeek menyatakan bahwa ketahanan terhadap masukan ekstrem belum sepenuhnya teridentifikasi. Laporan tersebut mencatat bahwa kesalahan seleksi CSA2 dan rekonstruksi keadaan dengan metode sliding-window-attention yang bersifat perkiraan dapat mengurangi kemampuan sistem pada kasus-kasus batas di luar rangkaian pengujian. Laporan tersebut juga mengakui masih adanya kesenjangan pada tugas-tugas penalaran tingkat tertinggi dan kasus-kasus batas. Keterbatasan-keterbatasan tersebut perlu diperhatikan bersamaan dengan skor-skor utama yang diumumkan.
Dua tugas yang dapat diulang untuk mengevaluasi V4.1 Flash
Tugas-tugas berikut ini menguji perilaku konkret tanpa menyertakan prompt yang tidak dijalankan sebagai bukti. Gunakan prompt yang persis sama, catat model dan pengaturan upaya dalam catatan Anda, lalu nilai jawaban berdasarkan kriteria yang tercantum. Hasil dari satu kali eksekusi harus dilaporkan sebagai pengamatan yang dilengkapi tanggal, bukan sebagai tolok ukur umum.
Harga Flash DeepSeek V4.1
Penetapan harga API DeepSeek menggunakan dua skema, dan semua angka di bawah ini dinyatakan dalam dolar AS per satu juta token. Periode puncak adalah 01:00–04:00 UTC dan 06:00–10:00 UTC, Senin hingga Jumat. Waktu-waktu lainnya termasuk dalam jam-jam di luar jam sibuk. Masukan yang disimpan dalam cache, masukan yang tidak disimpan dalam cache, dan keluaran dikenakan tarif yang berbeda-beda.
Tarif API yang dihosting paling murah
- Masukan yang disimpan dalam cache
- $0.003
- Masukan yang tidak disimpan dalam cache
- $0.15
- Output
- $0.60
Per 1 juta token; di luar jam-jam sibuk hari kerja.
Dua kali lipat tarif di luar jam sibuk
- Masukan yang disimpan dalam cache
- $0.006
- Masukan yang tidak disimpan dalam cache
- $0.30
- Output
- $1.20
Per 1 juta token; pukul 01.00–04.00 dan 06.00–10.00 UTC, hari kerja.
Sebagai contoh perhitungan sederhana, permintaan di luar jam sibuk dengan 800.000 token masukan yang tidak tersimpan dalam cache dan 20.000 token keluaran akan memakan biaya sekitar $0.132: $0.12 untuk input ditambah $0.012 untuk output. Jumlah token yang sama pada tarif puncak akan berharga sekitar $0.264. Perhitungan ini bersifat ilustratif, bukan tagihan beban kerja yang diukur; hit cache, percobaan ulang, pergantian alat, dan panjang penalaran memengaruhi totalnya.
Input yang disimpan dalam cache lima puluh kali lebih murah daripada input yang tidak disimpan dalam cache pada kedua skema tersebut, sehingga prefiks prompt yang stabil dan konteks yang dapat digunakan kembali menjadi signifikan secara ekonomi. Tarif API DeepSeek untuk umum terpisah dari akses dan penagihan GlobalGPT. Jangan mengartikan harga token ini sebagai harga langganan atau harga kredit GlobalGPT.
API, Visi, dan Batasan DeepSeek V4.1
API DeepSeek langsung menggunakan deepseek-flash. Para pengembang dapat memanggil titik akhir standar di https://api.deepseek.com, API Respons di basis yang sama, atau basis yang kompatibel dengan Anthropic di https://api.deepseek.com/anthropic. Alat-alat fungsi didukung di Responses. DeepSeek juga mendokumentasikan terapkan_patch alat khusus; jenis alat bawaan lainnya diabaikan, bukan dijalankan.
deepseek-flashFitur "Thinking" aktif secara default; tersedia pengaturan pra-set untuk tingkat usaha rendah, tinggi, dan maksimum.
Pilih lapisan kompatibilitas yang sesuai dengan aplikasi yang sudah ada.
Pastikan total input dan output tetap berada di dalam jendela konteks 1 juta token.
Format visi dan aturan penempatan
DeepSeek mendukung masukan gambar dalam format JPEG, PNG, GIF, dan WebP. Ukuran gambar inline dapat mencapai 32 MiB, sedangkan ukuran gambar berkas dapat mencapai 64 MiB. Batas gabungan yang tercantum dalam dokumentasi memungkinkan hingga 600 gambar dalam satu permintaan. Batas tersebut bukanlah rekomendasi: batch yang besar akan meningkatkan ukuran prompt, latensi, serta kesulitan dalam melacak gambar mana yang mendukung suatu jawaban.
Untuk API Respons, konten gambar harus dimasukkan ke dalam pesan pengguna. Gambar yang ditempatkan di sistem atau asisten Pesan tersebut mengembalikan kode status HTTP 400. Lapisan kompatibilitas tidak menerima file umum sebagai item masukan, sehingga aplikasi harus mengikuti bentuk masukan gambar yang telah didokumentasikan, alih-alih mengasumsikan kesetaraan fitur yang sepenuhnya sama dengan Respons OpenAI.
Kontekstual, keluaran, dan batasan koncurrency
Konteks maksimum adalah satu juta token, dan keluaran maksimum adalah 384.000 token. Masukan dan keluaran secara keseluruhan harus muat dalam jendela konteks. Flash mengizinkan 2.500 koneksi bersamaan per akun; permintaan yang melebihi batas akun tersebut akan menerima respons HTTP 429. Oleh karena itu, perencanaan kapasitas harus memantau tingkat keterisian koneksi aktif dan perilaku percobaan ulang.
DeepSeek V4.1 Flash vs V4 Pro
V4.1 Flash merupakan pilihan default yang lebih praktis untuk agen pemrograman dengan volume tinggi, masukan visual, dan aplikasi dengan konteks panjang. V4 Pro tetap relevan sebagai acuan dasar penalaran selama periode transisi singkat ini, namun tidak mendukung pengenalan gambar dan memiliki tingkat koncurrency yang lebih rendah berdasarkan dokumentasi. Versi kami sebelumnya Ulasan DeepSeek V4 Pro menangani titik pemeriksaan tersebut sesuai dengan kriteria sendiri; hasil uji coba langsungnya tidak boleh diklasifikasikan ulang sebagai bukti versi 4.1.
| Faktor penentu | V4.1 Flash | V4 Pro sebelum perubahan rute |
|---|---|---|
| Paling cocok | Agen, pemrograman, input panjang, pengenalan gambar | Tugas-tugas penalaran perbatasan terpilih |
| Masukan gambar | Didukung | Tidak didukung |
| Konkuren/akun | 2.500 koneksi | 500 koneksi |
| Masukan di luar jam sibuk yang tidak disimpan dalam cache | $0,15 / 1M | $0,66 / 1M |
| Produksi di luar jam sibuk | $0,60 / 1M | $1,98 / 1M |
| Pola penilaian resmi | Prospek yang ditampilkan pada baris agen/kode | Prospek GPQA Diamond dan HLE (hanya teks) |
Harga-harga tersebut merupakan tarif API DeepSeek, bukan harga GlobalGPT. Tarif Pro berlaku sebelum perubahan rute yang diumumkan pada 14 September.
Pada tarif di luar jam sibuk, input Flash yang tidak disimpan dalam cache sekitar 77% lebih murah daripada tarif Pro yang tercantum, dan output Flash sekitar 70% lebih murah. Persentase tersebut merupakan perhitungan aritmatika berdasarkan tarif resmi, bukan penghematan yang terukur. Penghematan aktual bergantung pada tingkat pemanfaatan cache, panjang output, jumlah percobaan ulang, serta apakah beban kerja memerlukan hasil yang lebih kuat dari Pro pada baris penalaran yang dipilih.
Perbedaan yang lebih mendesak adalah dari segi operasional. DeepSeek mempertahankan deepseek-v4-pro nama sambil mengubah model di baliknya untuk sementara waktu. Nama API yang stabil tidak menjamin perilaku keluaran yang stabil. Simpan respons V4 Pro yang representatif, jejak alat, latensi, dan kasus kegagalan sebelum 14 September, lalu jalankan rangkaian pengujian penerimaan yang sama setelah perubahan perutean. Untuk kerangka kerja perbandingan checkpoint yang lebih lama, lihat DeepSeek V4 Pro vs Flash.
Apa Kata Para Pengembang
Tanggapan awal menunjukkan respons positif terkait throughput, efisiensi cache, dan skor agen, namun bukti yang ada masih tidak merata. Beberapa komentar mengacu pada titik akhir pratinjau, bukan titik pemeriksaan produksi akhir, dan beberapa laporan merangkum demonstrasi, bukan uji coba terkontrol. Oleh karena itu, diskusi publik yang paling bermanfaat adalah mengenai di mana pengujian harus dilakukan, bukan apakah satu angka pada hari peluncuran sudah cukup untuk menentukan keputusan.
Analisis peluncurannya merekomendasikan untuk mempertahankan konfigurasi dasar V4 Pro dan menguji model Flash yang telah dirilis sebelum perubahan rute pada 14 September. Analisis tersebut juga menekankan bahwa peningkatan kinerja bervariasi tergantung pada benchmark, kerangka kerja, dan pengaturan upaya.
Baca analisisnyaDalam merangkum demonstrasi pratinjau World of AI, publikasi tersebut menyoroti kecepatan puncak yang tercatat sebesar 427 token per detik serta mencatat adanya kecenderungan untuk berpikir berlebihan serta perilaku simulasi fisika yang kurang optimal. Ini bukanlah jaminan kecepatan resmi.
Baca artikel pratinjauDi utas peluncuran, si pengomentator keberatan dengan pengalihan alur kerja Pro yang telah divalidasi ke model lain tanpa pemberitahuan, dan mengusulkan agar ditetapkan periode penghentian penggunaan. Ini hanyalah salah satu pendapat dari komunitas, bukan konsensus.
Buka komentarPimpinan Pengujian Penetrasi AI Aikido melaporkan peningkatan dalam hal recall satu kali uji, recall pass@3, presisi, dan tingkat cache hit pada sebuah benchmark keamanan siber. Postingannya menyebutkan titik akhir pratinjau yang akan kedaluwarsa, sehingga hal ini belum dapat dijadikan bukti untuk titik pemeriksaan akhir.
Lihat laporan pratinjauReaksi-reaksi ini mengindikasikan tiga langkah pemeriksaan yang perlu dilakukan pada setiap penerapan nyata: bandingkan kualitas keluaran pada pengaturan upaya yang tetap, perhatikan apakah penalaran yang panjang meningkatkan biaya keluaran, dan jalankan kembali kasus regresi ketika sebuah alias mengubah model di balik sebuah titik akhir. Pratinjau hasil throughput dan keamanan dapat menjadi panduan dalam merancang pengujian, tetapi hasil tersebut tidak boleh digabungkan dengan Tabel 3 dari DeepSeek seolah-olah berasal dari satu benchmark terkontrol.
Cara Mengakses Flash DeepSeek V4.1
Terdapat tiga jalur akses yang berbeda. Pilihlah sesuai dengan kebutuhan Anda: apakah Anda memerlukan kendali langsung atas API, bobot yang dihosting sendiri, atau ruang kerja berbasis browser yang memudahkan pergantian model. Ketentuan, harga, dan tanggung jawab operasional berbeda-beda tergantung pada jalur yang dipilih.
DeepSeek API
Gunakan situs resmi deepseek-flash model untuk integrasi native, Responses, atau yang kompatibel dengan Anthropic.
Kelas berat terbuka
Unduh kartu model dan bobot yang dilisensikan di bawah lisensi MIT. Pastikan dukungan tumpukan layanan dan persyaratan infrastruktur terpenuhi sebelum melanjutkan.
Buka repositori modelGlobalGPT
Gunakan entri Flash V4.1 khusus di dalam ruang kerja multi-model. Penagihan GlobalGPT terpisah dari tarif API DeepSeek.
Coba DeepSeek V4.1 Flash
API langsung merupakan pilihan paling tepat ketika Anda membutuhkan kontrol programatik, pelacakan penggunaan, dan akses ke antarmuka DeepSeek yang terdokumentasi. Open weights ditujukan bagi tim yang mampu memverifikasi dukungan inferensi dan mengoperasikan model MoE berskala sangat besar. GlobalGPT merupakan opsi yang lebih mudah digunakan untuk penggunaan interaktif dan perbandingan di dalam sebuah alur kerja model AI serba guna.
Postingan peluncuran resmi DeepSeek menyebutkan bahwa perusahaan akan bekerja sama dengan komunitas open-source dalam hal dukungan inferensi serta menjajaki lebih banyak opsi penerapan. Anggaplah hal itu sebagai pernyataan peta jalan, bukan bukti bahwa setiap tumpukan penyajian lokal sudah mendukung V4.1 Flash secara efisien.
Siapa yang Sebaiknya Menggunakan Flash DeepSeek V4.1?
Prioritaskan V4.1 Flash ketika pekerjaan terminal, navigasi repositori, otomatisasi, penggunaan alat, dan prompt yang panjang menjadi hal utama. Skor agen resmi dan tingkat input yang lebih rendah menjadi alasan yang tepat untuk melakukan uji coba yang disesuaikan dengan beban kerja.
Kemampuan memasukkan gambar asli menjadikan Flash sebagai pilihan yang lebih praktis dibandingkan V4 Pro untuk tangkapan layar, grafik, tabel, dan bukti antarmuka. Periksa keakuratan ekstraksi dengan membandingkannya terhadap jawaban yang sudah diketahui.
V4 Pro memimpin pada baris teks saja GPQA Diamond dan HLE yang ditampilkan. Bandingkan prompt tetap dan pengaturan upaya sebelum mengganti alur kerja penalaran yang telah divalidasi.
Lisensi MIT bersifat permisif, namun backbone 552B MoE bukanlah model lokal yang ringan. Pastikan spesifikasi perangkat keras, strategi cache, kuantisasi, dan dukungan penyajiannya.
Untuk pemilihan model yang lebih luas, Perbandingan GPT-5.5 vs DeepSeek V4 menempatkan konteks satu juta token dan posisi harga tersebut di samping opsi frontier lainnya. Tim yang berfokus pada gaya pengodean juga dapat merujuk ke Uji kode Python DeepSeek vs ChatGPT. Artikel-artikel tersebut menjawab pertanyaan-pertanyaan terkait; namun, tidak ada satupun yang dapat menggantikan pengujian terhadap titik akhir Flash V4.1 yang tepat yang digunakan dalam lingkungan produksi.
Pengguna umum yang sedang mempertimbangkan pilihan antara berbagai ekosistem mungkin akan menemukan bahwa Perbandingan DeepSeek vs ChatGPT lebih bermanfaat daripada tinjauan pada tingkat arsitektur. Flash V4.1 paling menarik ketika keunggulan-keunggulannya yang spesifik—masukan yang panjang, pemahaman gambar, alat bantu, dan biaya token yang rendah—dapat diterapkan pada alur kerja yang sebenarnya.
Putusan
Tarif API yang lebih rendah, konteks 1 juta, input gambar asli, kuota 2.500 koneksi, serta peningkatan kinerja agen yang dilaporkan oleh DeepSeek menjadi alasan kuat untuk mengevaluasinya. Ini bukanlah pengganti universal untuk versi Pro: V4 Pro masih unggul dalam baris penalaran tertentu, skor upaya maksimum memerlukan penggunaan token keluaran yang lebih tinggi, dan perubahan rute titik akhir dapat memengaruhi perilaku yang telah divalidasi.
Buka file Flash DeepSeek V4.1 di GlobalGPTMulailah dengan rangkaian uji penerimaan yang sederhana: satu tugas pemrograman yang representatif, satu tugas ekstraksi berbasis gambar, satu kasus dengan konteks panjang, dan satu alur kerja alat. Tetapkan pengaturan penalaran, catat jalur pemrosesan model, dan bandingkan pola kegagalan serta kualitas rata-rata. Hal ini akan menghasilkan keputusan yang dapat Anda pertanggungjawabkan tanpa menganggap tolok ukur vendor atau reaksi pada hari peluncuran sebagai jaminan kinerja aplikasi.
Pertanyaan yang Sering Diajukan
Apa itu DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash adalah model “mixture-of-experts” multimodal dengan bobot terbuka yang dirilis pada 10 September 2026. Model ini mendukung masukan teks dan gambar, keluaran teks, jendela konteks sebesar satu juta token, mode “thinking” dan “non-thinking”, keluaran JSON, serta panggilan alat (Tool Calls).
Berapa harga API Flash DeepSeek V4.1?
Tarif API DeepSeek pada jam-jam di luar puncak adalah $0,003 per 1 juta token masukan yang disimpan dalam cache, $0,15 per 1 juta token masukan yang tidak disimpan dalam cache, dan $0,60 per 1 juta token keluaran. Tarif puncak masing-masing adalah $0.006, $0.30, dan $1.20. Ini adalah harga API DeepSeek, bukan harga GlobalGPT.
Nama model API apa yang sebaiknya saya gunakan untuk Flash DeepSeek V4.1?
Gunakan deepseek-flash dengan API resmi DeepSeek. DeepSeek juga mendukung panggilan API Responses di https://api.deepseek.com dan panggilan yang kompatibel dengan Anthropic di https://api.deepseek.com/anthropic.
Apa saja konteks, hasil, dan batasan koncurrency-nya?
DeepSeek V4.1 Flash memiliki jendela konteks sebesar satu juta token dan output maksimum sebesar 384.000 token; input dan output harus muat di dalam jendela konteks tersebut. DeepSeek mendukung 2.500 koneksi bersamaan per akun, dan akan mengembalikan kode status HTTP 429 jika melebihi batas tersebut.
Apakah DeepSeek V4.1 Flash lebih baik daripada V4 Pro?
Hal itu tergantung pada tugasnya. Dalam tabel yang disusun oleh vendor DeepSeek, V4.1 Flash unggul dibandingkan V4 Pro dalam tolok ukur pemrograman, terminal, keamanan, dan otomatisasi yang ditampilkan, sementara V4 Pro unggul dibandingkan GPQA Diamond dan HLE (hanya teks). Flash juga lebih murah, mendukung fitur penglihatan, dan memungkinkan lebih banyak koneksi bersamaan.
Apakah DeepSeek V4.1 Flash mendukung gambar?
Ya. API ini mendukung masukan berformat JPEG, PNG, GIF, dan WebP, serta menghasilkan teks. DeepSeek mendukung dokumen hingga 32 MiB untuk gambar yang disematkan, 64 MiB untuk gambar berkas, dan 600 gambar per permintaan sesuai batas bersama. Gambar yang dihasilkan oleh API harus disertakan dalam pesan pengguna.
Apakah data bobot Flash DeepSeek V4.1 tersedia untuk diunduh?
Ya. DeepSeek mempublikasikan bobot model DeepSeek-V4.1-Flash di Hugging Face di bawah lisensi MIT. Lisensi yang fleksibel ini tidak menghilangkan persyaratan infrastruktur: tim tetap memerlukan perangkat lunak penyajian yang kompatibel serta perangkat keras yang memadai untuk backbone MoE berkapasitas 552 miliar.
Apakah saya bisa menggunakan firmware DeepSeek V4.1 pada GlobalGPT?
Ya. GlobalGPT memiliki entri Flash khusus DeepSeek V4.1 untuk penggunaan berbasis browser. Akses dan penagihannya terpisah dari tarif API langsung DeepSeek, dan ketersediaan platform tidak secara independen memverifikasi hasil benchmark yang dipublikasikan oleh DeepSeek.